논문 개요와 전체 구조
언어 모델의 답변을 다른 언어 모델로 평가하는 LLM-as-a-judge는 대량 평가를 가능하게 하지만, 어려운 문제를 추론하는 판정기를 모든 입력에 호출하면 비용과 응답 시간이 커집니다. 이 논문은 자연어 설명을 생성하지 않고 정해진 라벨과 확률만 반환하는 TypeSafe의 JEV를 먼저 호출한 뒤, 확신도가 낮은 입력만 강한 추론 판정기로 넘기는 방식을 조사합니다. 연구의 핵심은 새로운 라우팅 알고리즘보다 어떤 판정은 저렴한 모델이 처리할 수 있고, 어떤 오류는 그 모델의 확신도로 찾아낼 수 있는가라는 실증적 질문입니다.
분석 대상은 Yubo Li, Yidi Miao, Ramayya Krishnan, Rema Padman의 arXiv:2609.26550v2입니다. 이하의 모델명, 요금, 성능은 이 버전의 수집 조건을 가리킵니다. 저자들은 JEV와 생성형·보상 모델 판정기 16개 구성을 비교하고, 사람이 일부 불일치를 재판정하며, 사전에 규칙을 고정한 캐스케이드와 새로운 작업의 실시간 실험을 구분합니다. 캐스케이드는 여러 판정기를 순차적으로 연결하되 앞 단계에서 충분히 확실한 입력은 바로 끝내는 구조입니다.
원문은 본문 10절, 별도의 한계·윤리·감사·참고문헌, 부록 A–P로 구성됩니다. 전체 순서는 다음과 같습니다.
| 순서 | 원문 절 | 논리적 역할 |
|---|---|---|
| 1–2 | Introduction → Related work | 평가 비용 문제와 기존 판정·보정·라우팅 연구의 관계 |
| 3–4 | Tasks, data, and protocol → Judges and measurement | 작업, 분할, 공통 출력 계약과 측정 기준 |
| 5–6 | Overall performance, cost, and latency → Where JEV keeps pace and where it falls short | 전체 성능과 능력·난도·표현별 경계 |
| 7 | Does confidence track correctness? | 오류 위치 → 확률 품질 → 안정성 → 신호의 약화 |
| 8–9 | Accept when confident, escalate when unsure → A prospective live test | 임계값 탐색·고정 정책·실시간 재현 → 새로운 작업 검증 |
| 10 및 후속 항목 | Conclusion → Limitations → Ethical considerations → Acknowledgments → References | 결론과 연구 범위 명시 |
| A–D | Data… → Judge configurations… → Human adjudication… → Per-domain results… | 데이터·설정·사람 판정·세부 성능 |
| E–H | Follow-up benchmark checks → Answer format… → Natural free-response evaluation → Output validity… | 문체, 답안 형식, 자연문, 실패 처리 |
| I–L | Stability… → Confidence under presentation order… → Probability quality… → Open-weight typed decisions: Laya | 인터페이스·순서·확률·오픈 모델 대조 |
| M–P | Prospective live test… → Live replication… → Illustrative cases… → Supplementary reproducibility package | 사전 계획 실험, 재현, 사례, 재현 자료의 범위 |
핵심 기여와 혁신성
첫 번째 기여는 판정기의 정확도·확률 품질·가격·지연시간을 함께 측정한 것입니다. 저렴함만으로 유용성을 판단하지 않고, 판단을 텍스트에서 읽어낼 수 있는 작업과 계산·논리 검증으로 도출해야 하는 작업을 나눕니다. JEV는 일반 선호와 근거 기반 사실성에서 비교 모델에 근접하지만, 코드·수학·논리 문제에서는 차이가 큽니다. 저자들은 이를 단순한 답변 길이 선호로 설명할 수 있는지도 따로 확인합니다. 원문 §5–6
두 번째는 확률을 출력한다는 사실과 쓸 만한 불확실성 신호를 갖는다는 사실을 분리한 점입니다. JEV의 낮은 확신도에는 오류가 모이지만, 문체가 오도하거나 근거 없는 자연문을 평가할 때에는 이 관계가 약해집니다. 동일한 유형의 인터페이스를 가진 Laya가 거의 무작위 수준의 선호 판정을 내린다는 대조 실험도 있습니다. 따라서 출력 형식 자체가 정확도나 보정을 보증하지는 않습니다. 원문 §7·부록 L
세 번째는 탐색 결과와 검증 결과의 구분입니다. 96개 선택용 쌍에서 고른 규칙을 고정하고 1,610개 별도 쌍에 적용한 결과와, 새 작업마다 100개 라벨로 임계값을 정해 570개 쌍에서 실제 호출한 결과가 따로 제시됩니다. 리뷰어의 해석으로는, 이 연구의 학습 가치는 단일 최고 성능보다 어려운 작업에서는 절감 폭이 줄어드는 것을 허용하면서 품질을 유지하는 평가 절차에 있습니다. 원문 §8–9
기술적 세부사항
JEV의 입력은 자연어 평가 지침, 구조화된 상태, 허용 출력 유형입니다. 주 실험은 정해진 라벨 중 하나를 선택하는 Choice를 요청마다 하나씩 사용합니다. 생성형 비교 모델도 판정과 모든 라벨의 확률만 반환하며 설명은 출력하지 않습니다. 다만 추론 모델의 내부 추론에 쓰인 계산과 청구 토큰까지 사라지는 것은 아닙니다. 학습 방법이나 비공개 JEV의 내부 구조를 역추정하는 연구도 아닙니다. 원문 §4
확신도는 라벨 확률 중 최댓값입니다. 두 후보 A와 B의 순서를 바꿔 평가할 때에는 위치가 아니라 같은 답변의 정체성으로 확률을 정렬해야 합니다. 원문 식 (1)을 줄바꿈하여 쓰면 다음과 같습니다.
$p_1(A,B)$는 A를 먼저 보여주었을 때 첫 위치의 답변이 낫다는 확률입니다. 반대로 B를 먼저 보여준 호출에서 A의 확률은 $1-p_1(B,A)$입니다. 두 값을 평균한 $\bar p(A)$를 이용해 더 높은 확률의 답변을 선택하고, $q\geq\tau$이면 수용합니다. $\tau$는 선택용 라벨에서 정한 임계값입니다. 둘 중 하나라도 무효 출력이면 상위 판정기로 넘기며, 평균 확률이 정확히 0.5인 동률은 수용 시 절반 점수를 줍니다. 이는 단순히 두 호출의 최댓값을 평균하는 것과 다릅니다. 원문 §8, 식 (1)
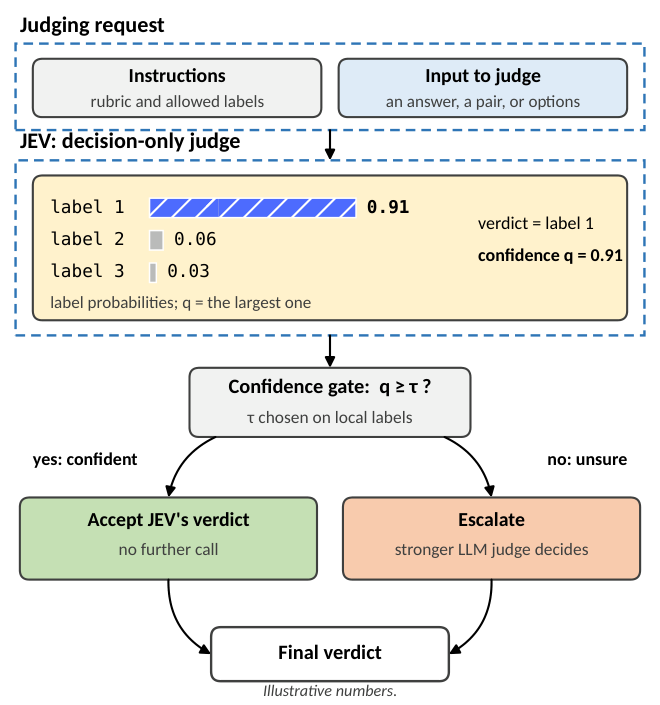
원문 Figure 2, PDF 2쪽. 2609.26550v2에서 그림 영역을 크롭했으며 번역·수치 수정은 없습니다. 그림의 확률은 설명용 예시입니다.
정확도는 무효 호출까지 분모에 포함합니다. 반면 확률 평가에는 유효 출력만 사용합니다. Brier 점수는 모든 클래스에서 예측 확률과 정답 지시값 사이 제곱오차를 더한 값이고, 음의 로그우도(NLL)는 실제 정답에 낮은 확률을 줄수록 커집니다. NLL 계산에서는 확률 하한을 $10^{-6}$으로 둡니다. ECE는 확신도를 10개 구간으로 나누어 확신도와 관측 정확도의 차이를 측정합니다. 오류 탐지 AUROC는 $1-q$로 오답을 높은 순위에 놓는 능력입니다. 확률이 실제 빈도와 맞는 보정 성질과 오류 순위화 능력은 서로 다른 평가 대상입니다. 원문 §4·7
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 사람의 세밀한 평가와 자동 지표의 확장성 사이에서 LLM 판정기가 등장한 맥락으로 시작합니다. BLEU 같은 과제별 지표는 자연어 루브릭, 즉 평가 기준을 자유롭게 바꾸기 어렵지만, 언어 모델은 이를 입력으로 받아 새로운 답변 집합을 평가할 수 있습니다. 강한 추론 모델은 어려운 항목에서 유리한 대신 모든 평가에 비용을 부과합니다. 논문의 시간 측정 패널에서 GPT-6 low-effort 판정의 비용은 1,000건당 약 12달러로, 같은 작업을 백만 건에 적용하면 약 12,000달러에 해당합니다.
이어서 저자들은 비용과 함께 자기 확신의 신뢰성을 문제 삼습니다. JEV는 판정과 확률을 반환하며, 최댓값을 이용해 판정을 끝낼지 다른 모델을 호출할지 결정합니다. Figure 1은 인터페이스의 차이를 나타내지만 실제 실험에서는 생성형 모델도 설명 없이 같은 계약으로 응답합니다. 따라서 설명을 길게 쓰도록 한 모델과 라벨만 내는 모델의 출력 길이를 직접 비교한 실험으로 읽어서는 안 됩니다.
서론 후반은 전체 기여를 저비용 판정, 능력별 격차, 오류를 찾는 확신도, 고정 캐스케이드, 새 작업의 실시간 검증으로 나열합니다. 5,172개 기본 판정과 후속 표본은 서로 다른 역할을 갖습니다. 핵심 주장은 모든 문제의 대체가 아니라 첫 단계가 모르는 입력을 식별할 수 있는 범위의 측정이며, 다음 절은 이를 기존 판정·선택적 예측 연구 안에 놓습니다. 원문 §1
📖 Chapter 2: Related work
첫 소주제는 LLM 판정기의 위치·장황함·자기 선호 편향입니다. 저자들은 후보 순서를 균형 있게 바꾸는 평가와 루브릭 표현 변화가 기존 연구 주제임을 인정하고, 동일 출력 계약 안에서 순서·의역·문체에 대한 민감도를 측정합니다. 두 번째 소주제는 BEM, PEDANTS, BERT-as-a-Judge, MiniCheck, Luna-2 등 효율적·전문화된 판정기입니다. 이 논문의 차별점은 새 소형 모델을 학습하는 데 있지 않고, 호스팅된 JEV의 작업별 성능과 비용을 동시에 밝히는 데 있습니다.
세 번째는 보상 모델과 벤치마크입니다. 오래된 쌍별 순위 모델 PairRM만으로 비교 기준을 삼지 않도록 Skywork-Reward-V2도 포함합니다. RewardBench의 선호, JudgeBench의 정답성, HaluEval의 근거 기반 사실성, RewardBench 2의 다중 선택, RM-Bench의 문체 조작은 판정 능력의 서로 다른 축입니다.
마지막으로 확신도 보정, 선택적 분류, FrugalGPT·RouteLLM과 판정기 라우팅 연구를 연결합니다. 자신 없는 입력을 넘기는 발상 자체를 새로운 알고리즘으로 주장하지 않습니다. 사전에 고정한 임계값과 실제 측정한 요금으로 의사결정 전용 첫 단계의 운영 특성을 보여주는 것이 기여이며, 이를 검증할 데이터 설계가 다음 절의 주제입니다. 원문 §2
📖 Chapter 3: Tasks, data, and protocol
이 절은 판정기의 출력이 라벨이라는 사실과 평가 대상 답변의 형식이 별개임을 먼저 설명합니다. 긴 자연어 두 답변의 우열도 A/B로 반환할 수 있으므로, 짧은 출력이 쉬운 작업을 뜻하지 않습니다. 공개 기본 데이터는 RewardBench 1,500쌍, JudgeBench GPT-4o 분할 전체 350쌍, HaluEval 3,000개 답변입니다. HaluEval은 1,500개 질문마다 정상 답변과 환각 답변을 모두 평가하므로 질문 단위와 판정 단위를 구별해야 합니다. RewardBench 표본은 공식 하위 집합 가중치를 그대로 재현하지 않습니다.
다음으로 최종 답안 판정 150개와 통제군을 추가합니다. 최종 답안의 라벨은 정답 99개, 오답 25개, 답 없음 26개이며, 과거 다회차 실험에서 여섯 생성 모델이 낸 답변입니다. 주석자 출처가 완전히 문서화되지 않았으므로 저자들은 검증된 정답 정확도 대신 기존 라벨과의 일치도를 보고합니다. 12개 GSM8K 대화의 9회차씩인 108개 답안은 모두 기준 정답과 같아 양성 통제군이며, 16개 출처–주장 계열의 64개 합성 판정은 기본적인 근거 처리를 확인합니다.
분할은 기본 5,172개 중 pilot 642개와 held-out 4,530개입니다. 공개 작업 pilot은 원 질문을 묶어 선택용 40%, pilot test 60%로 나눕니다. 별도 질문으로 이루어진 held-out은 보정이나 임계값 적합에 들어가지 않으며, 이 중 선호 1,610쌍이 고정 라우팅 평가에 쓰입니다. 수집은 초기 비교, 확대 모델 비교, 후속 진단, 최종 prospective 실험 순입니다. 고정 두 순서 정책, 사람 재판정의 주요 결과, 새 작업 실험만 평가 자료를 보기 전에 정했고 나머지 비교·탐색은 탐색적입니다.
마지막 진단에서는 선호 1,850쌍을 역순으로도 평가하고, 공개 작업별 16개씩 총 48개에 반복 두 번과 의역 루브릭 한 번을 적용합니다. 이 설계는 정확도 외에 출력 안정성을 분리할 근거이며, 다음 절이 같은 데이터에 적용할 모델과 측정 계약을 정의합니다. 원문 §3·Table 6–7
📖 Chapter 4: Judges and measurement
JEV 1.13.0은 Choice, yes/no 확률을 내는 Noul, 순서 있는 수준별 확률을 내는 Score를 제공합니다. 48개 인터페이스 진단 외에는 Choice 하나를 사용합니다. 제공자 고유 확신도와 최대 라벨 확률 사이 Spearman 상관은 RewardBench 0.976, JudgeBench 0.999, HaluEval 0.958이므로 비교 가능한 공통 신호로 최댓값을 채택합니다. 수집 시 가격은 입력 백만 토큰당 0.042달러, 출력 요금 0달러입니다.
비교는 JEV를 포함한 호스팅 13개와 로컬 4개 구성입니다. 생성형 모델은 동일한 지침·상태와 라벨별 확률 출력 계약을 사용합니다. 추론 모델은 대체로 low effort이고 Qwen3.6은 기본 설정, GPT-4.1 계열은 온도 0입니다. 로컬 Qwen3·3.5는 non-thinking으로 실행합니다. PairRM과 Skywork는 루브릭을 읽지 않는 독립 보상 모델이며, Skywork의 스칼라 점수를 확률처럼 보정 지표에 넣지 않습니다. Laya 두 체크포인트는 부록에서 추가 대조합니다.
유효성 검사는 필드, 허용 라벨, 유한 확률, 합이 1에 가까운지, 판정과 최대 확률 라벨이 일치하는지를 확인합니다. 반올림을 고려한 확률합 허용 오차는 0.025입니다. 더 좋은 답을 얻기 위한 수정·재호출은 없고 일시적 통신 장애에만 최대 세 번 시도합니다. 정확도 차이의 구간은 원 질문 단위 2,000회 부트스트랩으로 구하며, 같은 질문의 HaluEval 두 답변과 후보의 여러 제시 순서를 함께 재표집합니다.
지연시간은 비용 기록 때문에 클라이언트가 느려졌던 대량 품질 수집에서 가져오지 않습니다. 대신 작업당 40건인 120건 고정 패널을 사용합니다. 네트워크·제공자·재시도 시간을 포함한 결과 도착 시간으로, 순수 추론 시간이나 처리량이 아닙니다. 요금은 캐시 할인과 청구된 추론 토큰을 반영한 추정치이며 청구서 실측은 아닙니다. 이렇게 고정한 측정 조건이 다음 절의 비교를 해석하는 기준입니다. 원문 §4·부록 B
📖 Chapter 5: Overall performance, cost, and latency
Table 1은 작업별 정확도와 동일 시간 패널의 가격·중앙 지연시간을 함께 보여줍니다. 핵심 비교를 원문의 분모와 함께 옮기면 다음과 같습니다. 최종 답안 열은 기존 라벨과의 일치도이며, 무효 결과는 모두 오류로 계산됩니다.
| 판정기 | RewardBench 1,500쌍 | JudgeBench 350쌍 | HaluEval 3,000답변 | 최종 답안 150개 | 패널 요금, 달러/1,000건 | 패널 중앙 지연, 초 |
|---|---|---|---|---|---|---|
| JEV 1.13 | 92.5% | 78.6% | 87.3% | 94.0% | 0.044 | 0.15 |
| GPT-4.1 mini | 89.1% | 64.0% | 86.1% | 84.0% | 0.390 | 0.55 |
| GPT-5.6 Sol | 92.9% | 93.1% | 89.9% | 95.3% | 6.087 | 1.74 |
| GPT-6 Astra | 92.5% | 93.1% | 88.4% | 96.7% | 12.182 | 1.89 |
| Gemini 3.1 Pro | 94.3% | 87.4% | 87.4% | 94.7% | 5.043 | 3.14 |
| Skywork V2 8B, 로컬 | 94.0% | 71.1% | 해당 없음 | 해당 없음 | API 환산 없음 | 패널 비교 없음 |
GPT-6는 가장 비싸고 순서 변화에 안정적이며 최종 답안과 JudgeBench에서 강하기 때문에 주 비교 대상으로 선택됐지만, 모든 작업의 최고 모델은 아닙니다. 공개 4,850개 판정을 합치면 GPT-5.6이 GPT-6보다 1.1%p 높고 요금은 약 절반입니다. JEV는 15개 LLM 판정기 중 8위로 GPT-6보다 1.7%p 낮습니다. 따라서 논문이 보여주는 것은 정확도 최상위라는 결과가 아닙니다.
비용과 속도에서는 극단적인 차이가 납니다. JEV는 패널에서 GPT-6 대비 약 277배 저렴하고 중앙 지연시간은 약 13배 짧습니다. p95는 0.24초 대 3.86초입니다. 1,000건당 1달러 미만인 호스팅 모델 중에는 세 공개 작업 모두 JEV가 가장 정확하지만, HaluEval에서 GPT-OSS와의 차이는 0.1%p에 불과합니다. 이 절의 전체 평균은 다음 절에서 작업별 능력과 오류 위치로 분해됩니다. 원문 §5·Table 1·Figure 3
📖 Chapter 6: Where JEV keeps pace and where it falls short
Ordinary preference, factuality, and final answers. 먼저 일반 작업의 근접 성능을 확인합니다. RewardBench에서 JEV와 GPT-6는 모두 92.5%이며, paired 차이의 95% 구간은 [−1.4, 1.4]%p입니다. HaluEval은 87.3% 대 88.4%, 차이는 −1.1%p [−1.9, −0.3]입니다. 최종 답안은 94.0% 대 96.7%, macro-F1은 0.923 대 0.947입니다. 라벨 잡음을 확인하는 사람 재판정은 990개 부분집합에서 두 판정기 중 하나 이상이 기존 라벨과 다른 163개와 통제 20개를 대상으로 합니다. 사람 결과에서는 RewardBench와 HaluEval의 GPT-6 우위가 각각 3.0%p와 2.5%p로 더 커집니다.
Difficult correctness. JudgeBench의 JEV 78.6%와 GPT-6 93.1% 사이 차이는 −14.6%p [−18.9, −10.3]입니다. 69개 불일치 중 사람은 GPT-6 편에 57번, JEV 편에 1번 동의하며 11개는 결론을 유보합니다. 따라서 이 차이를 단순한 라벨 잡음으로 지울 수 없습니다. 답변 길이가 약 15% 이내로 비슷한 169쌍에서도 JEV 75.1%, GPT-6 94.1%로 차이가 유지됩니다.
Reading versus deriving. 여러 벤치마크를 능력별로 묶으면 일반 대화, 유해 요청 거절, 응답해야 하는 요청, 근거 기반 사실성은 대체로 2%p 안팎입니다. 반면 전문 지식 −7.0%p, 코드 −12.9%p, 수학 −14.3%p, 논리 퍼즐 −27.6%p입니다. 코드도 오류가 텍스트에 드러나는 RewardBench 코드 수정에서는 두 모델 모두 99–100%인 반면, 실행 논리를 따라가야 하는 LiveCodeBench에서는 21.4%p 차이가 납니다. 이로부터 저자들은 답을 읽어내는 판정과 답을 도출·검증하는 판정을 구분합니다.
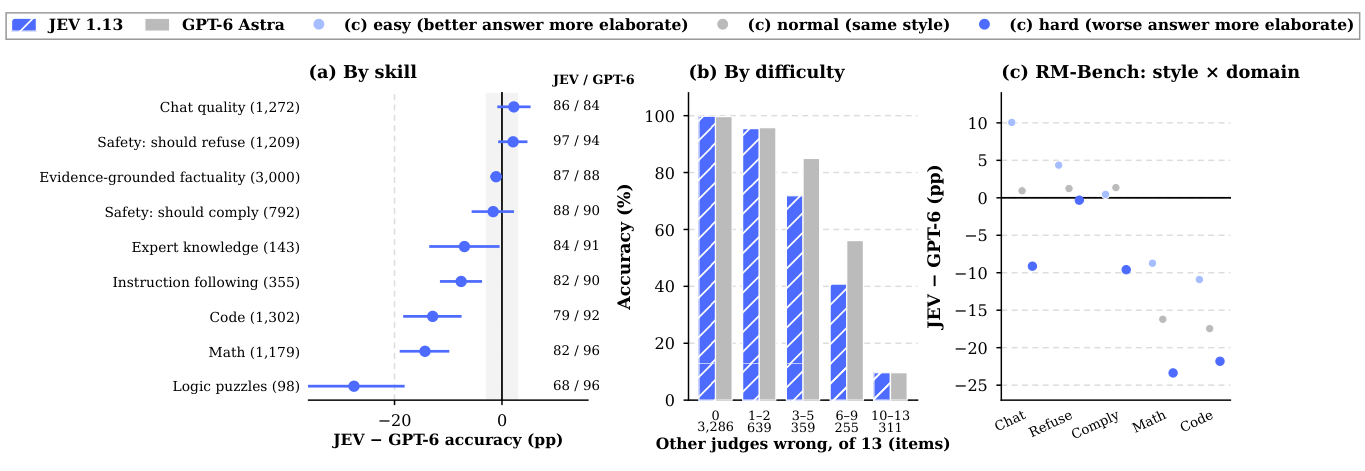
원문 Figure 4, PDF 7쪽. v2 그림을 크롭했으며 번역·수치 수정은 없습니다. 왼쪽은 능력별 차이와 95% 구간, 가운데는 다른 13개 모델의 오답 수에 따른 난도, 오른쪽은 RM-Bench의 문체 조건입니다.
The gap sits at middle difficulty. JEV와 GPT-6를 제외한 13개 모델의 오답 개수로 난도를 정의합니다. 모두 맞힌 3,286개에서는 JEV 99.8%, GPT-6 99.7%이고, 10개 이상이 틀린 311개에서는 둘 다 9.6%입니다. 차이는 3–5개 모델이 틀린 구간의 13.1%p, 6–9개가 틀린 구간의 15.3%p에 집중됩니다. 쉬운 문제의 불규칙한 실패보다 추론 모델은 여전히 풀지만 JEV는 어려워하는 중간 난도가 주된 차이입니다.
Misleading style and harder selection. RM-Bench 500개 질문을 세 문체의 9가지 조합과 두 순서로 제시하면 모델당 9,000판정입니다. 같은 문체에서는 JEV 85.4%, GPT-6 91.8%이지만, 틀린 답변이 더 정교하게 쓰인 hard 조건에서는 76.6% 대 90.1%입니다. JEV의 조건 간 감소는 −8.8%p [−10.6, −7.1]로 GPT-6의 −1.7%p보다 큽니다. 네 후보를 고르는 RewardBench 2의 100문항에서는 JEV 73%, GPT-6 75%, Skywork 79%입니다. 선택 능력과 문체에 흔들리지 않는 능력을 같은 축으로 볼 수 없는 이유입니다.
Which way JEV errs → Length is not the driver. HaluEval의 환각 답변 탐지는 JEV 80.1%, GPT-6 79.6%로 비슷하고, 차이는 정상 답변을 잘못 거절하는 쪽에서 생깁니다. JudgeBench의 위치 영향도 있어 양방향 평균의 동기가 됩니다. 길이를 벤치마크 안에서 나누면 RewardBench와 HaluEval의 격차는 거의 변하지 않습니다. JudgeBench의 가장 긴 구간과 RM-Bench의 정교한 문체에서 차이가 커지지만, 전체 자료에서 긴 답변이 어려워 보이는 현상에는 데이터 구성의 영향이 섞입니다.
Answer format → Natural prose. 최종 선택지를 정답 없이 추출한 다음 코드로 비교하면 더 나아지는지도 시험합니다. ambiguous를 추가한 4분류 계약에서 JEV의 직접 판정 일치도는 91.3%, 추출 후 비교는 86.0%로 개선되지 않습니다. 이는 앞선 3분류의 94.0%와 직접 비교하면 안 됩니다. 또 긴 자연문으로 확장한 400개 문서 기반 요약에서는 JEV 69.8%, GPT-5.4 69.3%인 반면, 근거 없는 일반 응답 200개에서는 53.5%와 56.0%로 모두 우연 수준에 가깝습니다. JEV의 평균 확신도는 0.91이지만 오류 AUROC는 0.498입니다. 두 표본의 내용·라벨 출처가 다르므로 근거 유무만의 순수한 인과 효과는 아닙니다.
Output validity → The operating envelope. JEV는 기본 5,172건 모두 계약을 만족하지만 일부 생성형 모델도 마찬가지입니다. Qwen3.6은 유효 4,998건으로, 통신·제공자·계약 실패를 판정 오류와 분리해서 읽어야 합니다. 통제군은 대부분 포화합니다. 마지막 Table 2는 일반 선호·근거 사실성을 저비용 후보, 최종 답안·네 후보 선택·요약을 우선 검증 대상, 어려운 정답성과 문체 공격을 상위 호출 대상, 근거 없는 자연문을 지원되지 않는 영역으로 정리합니다. 이는 해당 표본의 운영 지도이며 배포 보증이 아닙니다. 다음 절은 이 경계를 확신도로 식별할 수 있는지 검사합니다. 원문 §6·Table 2
📖 Chapter 7: Does confidence track correctness?
7.1 Confidence locates JEV’s errors. 공개 4,850개 항목에서 선호 쌍은 두 순서 평균, HaluEval은 단일 호출을 사용합니다. 확신도 0.9 이상인 3,744개에서 JEV와 GPT-6의 정확도는 94.7%와 94.4%이고, 나머지 1,106개에서는 67.7%와 75.0%입니다. 높은 구간에서 둘이 비슷하고 낮은 구간에서 강한 모델의 이점이 커지는 것이 라우팅의 근거입니다. 다만 JudgeBench의 인접 구간은 표본 변동으로 단조롭지 않습니다.
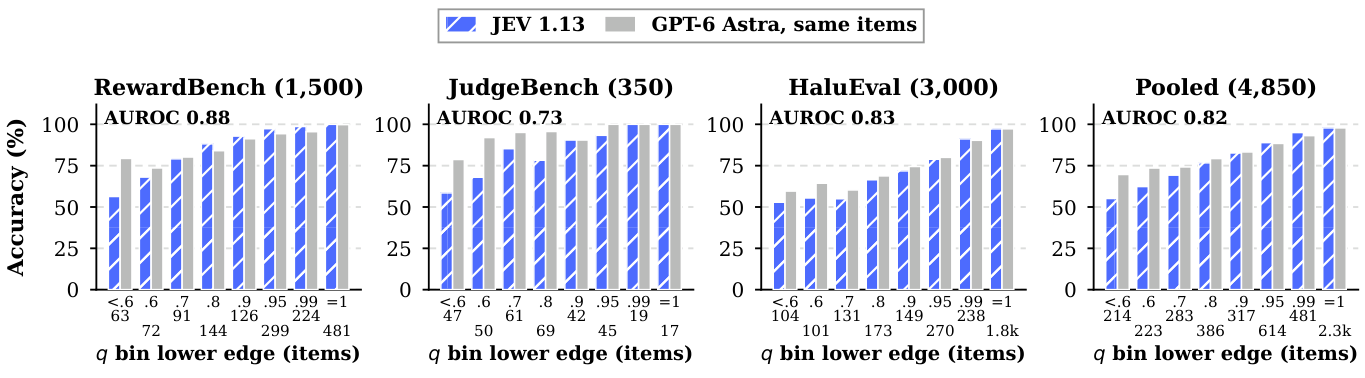
원문 Figure 5, PDF 10쪽. v2 그림을 크롭했으며 번역·수치 수정은 없습니다. 두 모델을 각자 다른 확신도 구간에 넣은 비교가 아니라 JEV 확신도로 선택한 동일 항목의 비교입니다.
Who is confidently wrong?은 분모의 중요성을 보여줍니다. 단일 호출에서 JEV의 확신도 0.9 이상 오답률은 RewardBench 24/1,155=2.1%, JudgeBench 9/138=6.5%입니다. 이 오답이 전체 JEV 오류에서 차지하는 비중은 각각 21%, 12%입니다. 고확신 항목 중 오류율과 전체 오류 중 고확신 오류의 비율은 다릅니다. JudgeBench에서는 오류 대부분을 넘길 수 있어도 남겨 둔 항목이 GPT-6보다 안전하다고 단정할 수 없습니다.
7.2 Probability quality. Brier 점수는 RewardBench에서 JEV 0.113, GPT-6 0.115로 비슷하지만 JudgeBench에서는 0.297 대 0.095입니다. HaluEval 전체에서는 JEV가 0.196 대 0.213으로 좋아 보이지만, 사람이 재판정한 240개에서 라벨만 바꾸면 0.062 대 0.032로 순위가 뒤집힙니다. 확률 품질 평가는 정답 라벨의 품질에 의존합니다. 이어 온도 보정을 선택용 표본에 맞추면 held-out HaluEval NLL은 0.496→0.304로 좋아지지만 RewardBench는 0.192→0.216, JudgeBench는 0.449→0.475로 나빠집니다. 하나의 보정값이 작업 전체에 통하는 결과가 아닙니다.
7.3 Is the signal stable? 순서는 반복·의역, 출력 유형의 동등성, 후보 제시 순서, 변화 크기, 임계값과 불안정성의 관계, 평균의 효과입니다. JEV는 반복 96번에서는 결정이 바뀌지 않았지만 루브릭 의역 48개 중 4개가 바뀌었습니다. 의미가 같은 이진 질문을 Choice와 Noul로 물었을 때 확률 차이 평균은 0.055이고, 문장과 그 부정의 yes 확률이 합계 1에서 벗어나는 잔차 평균은 0.045입니다. 임계값을 정할 때 출력 유형도 고정해야 한다는 근거입니다.
순서를 뒤집으면 JEV 판정은 RewardBench 3.7%, JudgeBench 11.1%에서 바뀝니다. 그러나 유효 두 호출에서 생긴 전체 95개 뒤집힘 중 기본 순서 확신도 0.9 이상은 3개뿐입니다. 즉 임계값 0.9의 단일 호출 게이트도 대부분의 순서 불안정을 상위 호출 영역으로 보냅니다. 네 후보를 네 위치에 회전시킨 별도 100문항에서는 87문항의 선택이 모두 같고, 선택이 바뀐 13문항은 평균 확신도 0.56 미만입니다.
두 순서 확률 평균은 선호 전체 정확도를 89.89%→90.65%로 올리고 Brier를 0.148→0.141로 줄이지만 AUROC는 0.863→0.858로 개선하지 않습니다. 네 순서 평균에서도 정확도는 72.0%→70.0%, AUROC는 0.815→0.854, ECE는 0.046→0.106으로 서로 다른 방향입니다. 평균이 모든 품질 지표를 일괄 개선하는 것은 아니며, JEV에서는 확신도 게이트가 이미 많은 불안정을 걸러냅니다.
7.4 Where the signal weakens. RM-Bench 두 순서 평균의 AUROC는 easy 0.870, 같은 문체 0.839, hard 0.764입니다. 확신도 0.9 이상인 hard 720쌍에서도 57개를 틀립니다. 임계값 0.99까지 올리면 hard 정확도가 GPT-6와 같아지지만 76%를 넘겨야 합니다. 근거 없는 자연문에서는 AUROC 0.498로 임계값 자체가 도움이 되지 않습니다. 이 절은 신뢰도가 모를 때 낮아지는 경우와 잘못 믿을 때도 높아지는 경우를 구별하고, 다음 절은 전자의 신호를 실제 정책으로 만듭니다. 원문 §7
📖 Chapter 8: Accept when confident, escalate when unsure
도입부는 오류의 상보성을 확인합니다. JudgeBench에서 GPT-6는 JEV 오류 75개 중 60개를 고치지만, JEV도 GPT-6 오류 24개 중 9개를 맞힙니다. 정답을 미리 아는 이상적 선택기는 95.7%까지 갈 수 있으나, 실제 정책은 판단 순간에 이용 가능한 확신도만 읽어야 합니다.
Threshold sweep → Per task → A cheaper fallback. 먼저 전체 공개 항목에서 여러 임계값을 사후 탐색합니다. 0.9에서는 4,850개 중 약 23%를 넘겨 정확도 90.2% 대 GPT-6 90.0%, 요금 비율 33%를 얻습니다. 같은 예상 비용으로 무작위 호출하면 89.0%입니다. 입력마다 호출 가격이 다르므로 무작위 대조군은 호출 개수 대신 달러 지출을 맞춥니다. 작업별로는 일반 선호에서 상보성의 이득이 크고 JudgeBench에서 더 많이 넘깁니다. GPT-5.6을 fallback으로 사용한 더 저렴한 조합도 좋지만, 여기까지의 임계값은 평가할 자료에서 직접 읽었으므로 독립 검증 결과가 아닙니다.
Frozen two-order policies. 실제 고정 정책은 96개 선택용 선호 쌍에서 fallback보다 정확도가 2%p 넘게 낮아지지 않는 범위 안에서 수용률을 최대화합니다. 선택 자료는 RewardBench 64쌍, JudgeBench 32쌍입니다. 규칙과 탐색 격자는 held-out 결과를 보기 전에 고정했고, GPT-6에 대해 선택된 임계값은 0.9입니다. 별도 1,610쌍에서는 68.5%를 수용하고 31.5%를 넘기며, 넘긴 쌍에 JEV 오류의 85%가 들어 있습니다.
| held-out 평가 단위 | JEV 단독, 두 순서 | 캐스케이드 | GPT-6 | 차이와 95% 구간, %p | 상위 호출률 | 요금 비율, 보고/보수 상한 |
|---|---|---|---|---|---|---|
| RewardBench 1,340쌍 | 92.8% | 93.7% | 92.4% | +1.27 [0.45, 2.03] | 24.8% | 0.267 / 0.308 |
| JudgeBench 270쌍 | 81.3% | 92.2% | 93.0% | −0.74 [−2.22, 0.74] | 64.8% | 0.668 / 0.668 |
| 전체 1,610쌍 | 90.9% | 93.4% | 92.5% | +0.93 [0.24, 1.66] | 31.5% | 0.414 / 0.440 |
Table 4의 요금 분자는 모든 쌍의 JEV 두 호출과 넘긴 쌍의 GPT-6 호출을 합친 값이고, 분모는 같은 쌍 전부에 GPT-6를 호출하는 비용입니다. 전체의 83%가 RewardBench이므로 41.4%라는 통합 요금만 일반화해서는 안 됩니다. JudgeBench에서는 격차의 94%를 메우지만 비용은 약 3분의 1만 절감합니다. GPT-5.6 fallback의 선택 임계값 0.7은 RewardBench에서는 좋으나 JudgeBench에서는 −4.81%p로 허용 손실을 초과합니다. 선택용 32쌍에서 만족한 조건은 독립 자료의 보증이 아닙니다.
Why JEV as the first stage. 같은 규칙을 다른 일곱 저비용·오픈 모델 첫 단계에 소급 적용합니다. GPT-4.1 mini는 정확도를 유지하지만 JudgeBench 비용이 GPT-6 단독의 98.3%라 절감이 작습니다. GPT-OSS, Gemini Flash, Skywork는 RewardBench에서는 유리하지만 JudgeBench에서 허용 손실을 넘습니다. 로컬 모델의 비용 비율에는 GPU 비용이 빠집니다. 이 비교가 뒷받침하는 것은 시험한 구성에서 JEV가 유용한 운영 지점을 제공한다는 것이며, 모든 가능한 모델의 최적 경계를 증명한 것은 아닙니다.
Live replication. 이미 분석한 held-out 510쌍에서 정책을 실제 실행합니다. JEV 양방향을 동시에 호출하고 필요할 때만 GPT-6를 이어 호출합니다. 게이트 결정은 오프라인과 98.6% 일치하고, 정확도는 92.5% 대 93.1%, 비용 비율은 57.2%입니다. 중앙 지연시간은 0.27초 대 2.10초로 짧지만, 넘긴 입력은 JEV 다음 GPT-6를 기다려 중앙 2.50초가 걸립니다. p95는 4.26초 대 4.49초로 큰 변화가 없습니다. 이것은 호출 파이프라인의 재현이지 새로운 작업에 대한 일반화 검증은 아닙니다.
How many local labels does a threshold need? 마지막으로 1,850쌍에서 선택용 $k$개를 뽑고 나머지에 평가하는 2,000회 재표집을 수행합니다. 점 추정치만으로 2%p 허용 손실을 맞추면 손실 초과가 40–50%의 시행에서 생깁니다. 부록 K의 개선 규칙은 다음 조건을 사용합니다.
여기서 $d$는 각 항목에서 캐스케이드와 fallback의 정답 점수 차이이며, $\bar d$는 평균, $s_d$는 표준편차, $k$는 선택용 라벨 수입니다. 1.645는 단측 95% 하한에 쓰인 계수입니다. 평균이 기준을 만족하는지만 보지 않고 추정 불확실성까지 고려합니다. $k=96$에서 단일 임계값의 손실 초과율은 44.0%에서 5.2%로 줄고, 작업별 임계값을 따로 고르면 0.6%입니다. 다만 같은 자료 집합을 재사용한 탐색적 모의실험이므로 분포 이동을 반영하지 않습니다. 다음 절이 새 작업에서 이 절차를 검증합니다. 원문 §8·Table 3–4·부록 K Table 30
📖 Chapter 9: A prospective live test
이 절은 모델을 한 번도 호출하기 전에 프로토콜을 고정한 별도 실험입니다. PPE 정답성 500쌍은 MMLU-Pro·MATH·GPQA·MBPP-Plus·IFEval에서 각 100쌍을 뽑고, JudgeBench Claude-3.5-Sonnet 분할은 전체 270쌍을 사용합니다. 후자의 답변은 새롭지만 질문 91개는 앞선 GPT-4o 분할과 겹칩니다. 이를 감추지 않고 별도 분석합니다.
작업마다 100쌍에서 하한 규칙으로 임계값을 고릅니다. 격자는 0.5, 0.6, 0.7, 0.8, 0.9, 0.95, 0.99입니다. 선택된 값은 PPE 0.95, JudgeBench 0.99로 이전보다 엄격합니다. 남은 400쌍과 170쌍에서 실제 캐스케이드를 실행한 뒤, JEV가 수용했던 쌍에도 별도 GPT-6 비교 호출을 더해 같은 항목으로 다른 임계값을 계산할 수 있게 합니다.
| 새 작업 held-out | JEV 단독 | 실제 캐스케이드 / GPT-6 | 상위 호출률 | GPT-6 대비 요금 | 캐스케이드 중앙 / p95, 초 |
|---|---|---|---|---|---|
| PPE 400쌍 | 78.2% | 88.2% / 88.2% | 67.8% | 69.3% | 1.76 / 3.76 |
| JudgeBench Claude 170쌍 | 70.9% | 94.7% / 94.7% | 89.4% | 91.0% | 2.41 / 5.97 |
| 합계 570쌍 | 76.1% | 90.2% / 90.2% | 74.2% | 75.5% | 1.87 / 4.95 |
두 작업 모두 관측 정확도가 GPT-6와 같습니다. 합계 차이의 95% 구간은 [−0.70, 0.70]%p입니다. 본 실험에서 잡힌 JEV 오류는 93%이며, 비용은 1,000쌍당 12.5달러 대 16.6달러입니다. 여기의 75.5%는 기존 1,610쌍의 41.4%와 다른 표본·선택 정책에서 나온 수치입니다. 어려운 정답성에서는 대부분을 넘겨야 정확도가 유지됩니다.
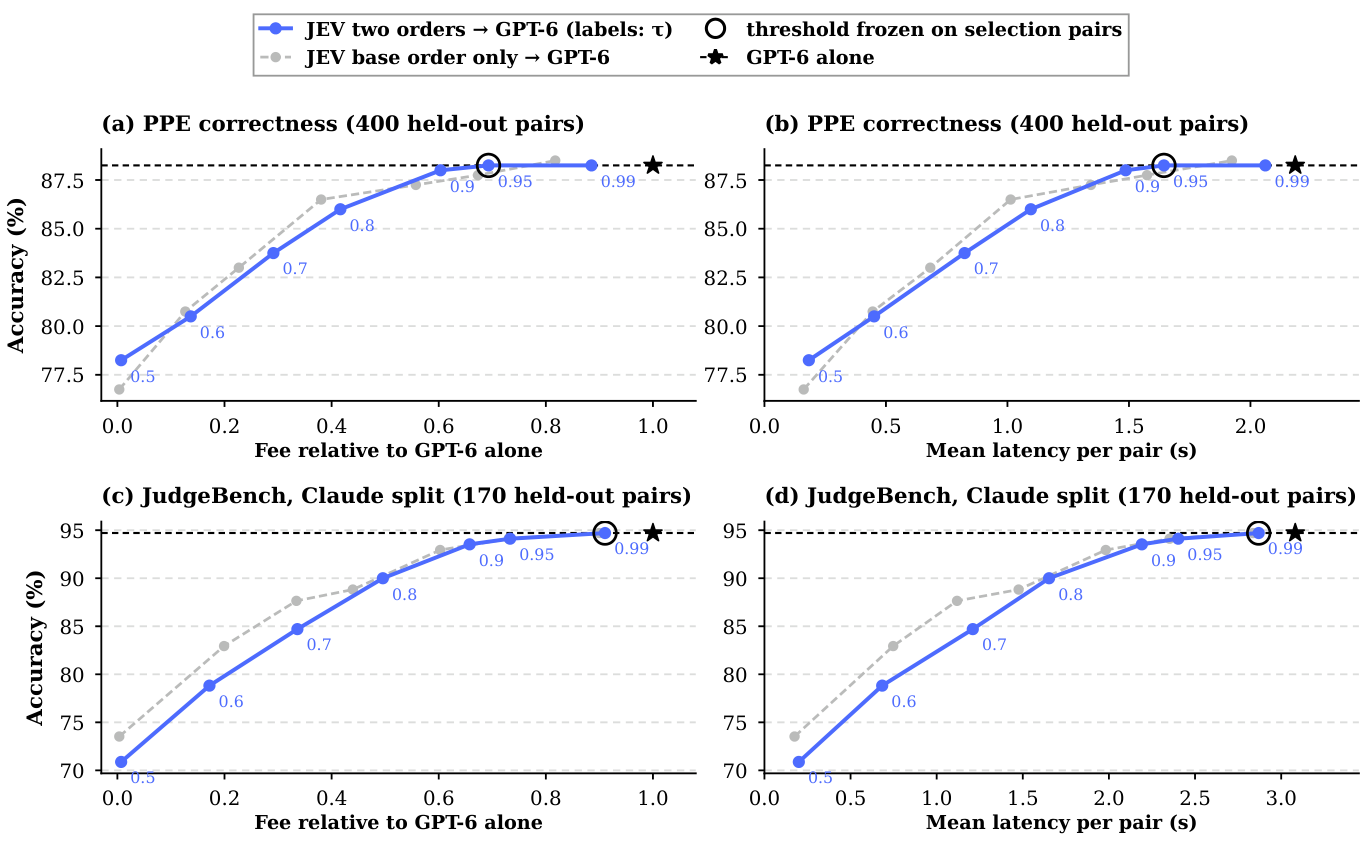
원문 Figure 9, PDF 16쪽. v2 그림을 크롭했으며 번역·수치 수정은 없습니다. 원으로 표시한 임계값만 실제 정책으로 실행했고, 나머지 점은 동일 출력의 재계산입니다. 오른쪽 가로축은 중앙값이 아닌 평균 지연시간입니다.
일반 임계값 0.9를 그대로 쓰는 반사실적 계산에서는 전체 59.8%를 넘겨 비용 61.9%, 정확도 89.6%로 GPT-6보다 0.53%p 낮아집니다. 더 낮은 0.8에서는 3.0%p를 잃습니다. IFEval의 확신도 AUROC는 0.57로 다른 PPE 출처 0.69–0.81보다 약합니다. 알려진 질문 57쌍과 새로운 질문 113쌍에서 배포 정책의 동률이 모두 유지된 점도 확인합니다. 이 절의 결론은 저비용 단계가 약할 때 더 많이 지출하도록 한 절차가 실제 새 표본에서도 작동했다는 것입니다. 원문 §9·Table 5
📖 Chapter 10: Conclusion
결론은 JEV의 용도를 텍스트에서 판정을 읽을 수 있는 영역과 결과를 도출해야 하는 영역으로 다시 정리합니다. 전자는 저렴한 첫 단계가 유용하고 후자는 상위 추론 판정기의 계산이 값을 합니다. 낮은 확신도에 오류가 모일 때 캐스케이드가 품질을 회복하며, 문체에 자신 있게 속거나 근거 없는 자연문을 평가할 때에는 경계가 깨집니다.
저자의 실용적 권고는 후보 양방향 확률 평균, 목표 작업의 약 100개 라벨, 점 추정치 대신 정확도 차이의 하한을 쓰는 임계값 선택, 같은 작업의 별도 항목 검증입니다. 이는 새 라우팅 알고리즘의 이론적 보장이라기보다 본 실험이 뒷받침한 절차입니다. 이후 원문은 한계·윤리와 재현 세부사항으로 이 주장의 범위를 제한합니다. 원문 §10
📖 Chapter 후속 항목: Limitations → Ethical considerations → Acknowledgments → References
Limitations. 저자가 명시한 범위는 네 갈래입니다. 하나의 비공개 JEV 버전을 평가했으며 모델 크기·추론량·서빙이 달라 계산량을 맞춘 비교가 아니고 학습 데이터 중복도 모릅니다. 전문 직역은 시험하지 않았고 Laya는 작업별 미세조정 없이 사용했습니다. 일부 정책과 주요 사람 판정 및 prospective 실험 외 분석은 사후적이며, 기존 held-out은 적합 자료와 같은 벤치마크 계열이고 JudgeBench는 270쌍뿐입니다. 신뢰구간에는 다중 비교 보정이 없습니다.
라벨 면에서는 990개 부분집합의 183개를 불일치 중심으로 감사했고 연구팀 한 사람이 일차 판정했습니다. 확률 점수는 라벨 품질에 따라 바뀝니다. 비용과 지연은 하나의 클라이언트 위치·수집 기간과 문서화된 가격에 의존하며, 실제 재현과 prospective 배포 지점 외 캐스케이드는 오프라인 시뮬레이션입니다. 새로운 작업 검증도 두 종류 570쌍입니다.
Ethical considerations. 외부 크라우드 작업자는 없었고 연구팀이 공개 항목을 판정했습니다. 데이터 재배포의 출처·라이선스를 검토해야 하며 GPQA 질문 본문, 인증정보, 계정 메타데이터는 공개 파일에서 제외합니다. 확신한 오답을 고려해 중요한 의사결정에서 자동 판정기를 유일한 결정권자로 쓰지 말아야 한다고 명시합니다. Acknowledgments는 NIST·CMU AIMSEC 지원과 OpenAI Researcher Access Program의 API 크레딧을 밝힙니다. 이어진 References는 관련 모델·벤치마크·보정·라우팅 연구와 제공자 자료의 서지 목록이며, 이 리뷰가 그 참고문헌 전체를 별도로 검증했다는 뜻은 아닙니다. 이후 부록은 앞선 결과의 조건과 근거를 확장합니다. 원문 한계 및 후속 항목
📖 Chapter A: Data, collection rounds, rubrics, and request examples
부록 A는 분할과 수집 순서를 먼저 제시합니다. RewardBench pilot 160쌍은 선택 64·test 96, JudgeBench 80쌍은 32·48, HaluEval 80판정은 32·48입니다. 최종 답안과 통제군 322개는 held-out 없이 pilot에 속합니다. 초기 모델 비교를 본 뒤 추가한 다중 모델·후속 실험과, 사전에 계획한 정책을 구분하는 자료 계보입니다.
다음 Sample expansion and earlier reported figures는 과거 결과와 현재 결과의 차이를 해명합니다. 이전 기본 표본은 1,312개였고 held-out 선호는 RewardBench 240+JudgeBench 270=510쌍이었습니다. 그 표본의 오프라인 92.5% 대 93.1%, 비용 56.8%는 바뀌지 않습니다. 이후 RewardBench 1,100쌍과 HaluEval 2,760판정 등을 추가하되 임계값은 다시 맞추지 않았습니다. 전체 held-out에서 JudgeBench 비중이 53%에서 17%로 줄어든 것이 통합 비용 41.4%로의 변화에 큰 영향을 줍니다.
루브릭은 PAIR→HALL→FINAL→EVIDENCE 순으로 명세합니다. PAIR는 정답성·추론·지시 준수·관련성·안전을 평가하며 길이나 자신 있는 문체만 선호하지 말라고 합니다. HALL은 제공된 근거만 사용합니다. FINAL은 신뢰 기준을 다시 풀지 않고 최종적으로 확정한 답만 판정합니다. EVIDENCE는 지지·모순·정보 부족을 구분합니다. 이어 생성형 출력 계약, 각 상태 필드와 라벨 의미, 실제 요청·응답을 제시합니다. 숨은 정답과 생성 모델·분할 식별자는 전달하지 않습니다.
마지막으로 150개 최종 답변이 119개 원 질문 군집에 속함을 밝히고, GSM8K 100개 대화 중 완결된 96개에서 12개를 고르는 과정을 설명합니다. 108개가 전부 정답인 통제군은 변화하는 대화 맥락에서의 기본 처리 확인이며 오답 분류 능력을 입증하지 않습니다. 이 데이터 명세를 받아 부록 B가 모델 실행 조건을 고정합니다. 원문 부록 A
📖 Chapter B: Judge configurations and measurement
Table 8은 요청한 정확한 모델 식별자, 호스트, effort, 백만 토큰당 입력·출력 가격을 남깁니다. 로컬 Qwen3/3.5는 H100 한 장, BF16, vLLM 0.29.0, 온도 0, non-thinking, 32,768 토큰 문맥, 출력 256 토큰으로 실행합니다. PairRM은 2,048 토큰 쌍 토크나이저 때문에 RewardBench 15쌍과 JudgeBench 59쌍이 잘리지만, 잘리지 않은 자료에서도 성능이 낮습니다. Skywork는 후보별 점수를 저장하므로 순서 불변성이 구조적으로 생기며 반복 요청 안정성의 증거로 사용하지 않습니다.
Laya는 배포된 SDK와 기본 보정을 사용하고 English 512, Typed-decisions 1,024 토큰 한도에서 오른쪽 상태를 자릅니다. 이어 시간 패널은 작업당 40개, 지속 클라이언트, worker 8개, 요청 시작 간격 최소 0.12초로 설명합니다. 비용 기록은 시간 측정 루프 밖으로 옮겼습니다. Groq 쿼터·재시도가 긴 꼬리에 영향을 줄 수 있습니다. 마지막 요금은 캐시 읽기 할인·쓰기·추론 토큰을 한 번씩 계산하며 사용량 누락은 보수적 예약량으로 채웁니다. 이 조건은 다음 사람 감사가 다루는 판정 품질과 별개의 측정 기반입니다. 원문 부록 B
📖 Chapter C: Human adjudication of judge disagreements
Items and blinding은 표본을 S1 한 모델만 라벨과 일치한 108개, S2 둘 다 불일치한 55개, S3 둘 다 일치한 통제 20개로 나눕니다. 총 183개는 180개 원 질문 군집이며, 판정자는 모델 출력·라벨·층·원 ID를 보지 않습니다. 후보 순서도 바꾸고 계산기·참고자료·로컬 코드는 허용하되 LLM 보조와 정답 파일은 금지했습니다.
Annotators and adjudication은 계획과 실제의 차이를 밝힙니다. 두 명의 사람 대신 연구팀 한 명의 전체 판정과 Claude Fable 5.1의 전체 판정을 비교했습니다. 둘이 다른 39개는 항목별 정답 키를 보지 않은 저자가 최종 판정했으며, 모든 최종 라벨은 사람 결정입니다. 결론 불가 36개는 유보로 남깁니다. Cohen의 카파는 사람 대 LLM의 사전 합의도이지 두 독립 사람 판정자의 신뢰도가 아닙니다.
Pre-specified outcomes → Findings에서 주요 결과는 JudgeBench 사람 판정에 따른 JEV−GPT-6 차이 −16.0%p [−20.0, −12.3]입니다. 불일치에서 사람의 JEV 지지는 +1, GPT-6 지지는 −1, 유보는 0으로 두고 전체 해당 부분집합 분모로 나눕니다. 사람이 결정한 일부 라벨만 바꾼 정확도는 민감도 분석입니다. HaluEval에서 두 모델이 모두 틀린 것으로 표시된 26개 중 24개는 사람이 모델 쪽에 동의해 기존 라벨의 문제를 드러냅니다.
Probability-score sensitivity는 240개 중 28개 라벨만 바꾸고 확률은 고정하여 Brier·NLL·ECE 순위가 뒤집힘을 보여줍니다. 마지막 What this study cannot claim은 무작위 감사도 독립 외부 평가도 아니라는 점을 명시합니다. 이 부록은 사람 판정을 절대적 새 정답으로 확대하지 않으며, 다음 부록의 세부 성능도 기본적으로 제공 라벨 기준이라는 해석을 지지합니다. 원문 부록 C·Table 9–10
📖 Chapter D: Per-domain results and quality–efficiency trade-offs
먼저 Figure 11은 영역별 정확도, Figure 12는 전체 작업 요금과 시간 패널 지연을 정확도에 연결합니다. Every slice의 Table 11은 본문 Figure 4를 능력·다른 모델의 오답 수·문체·정답 위치·길이별로 펼칩니다. 단일 기본 순서 호출의 비교이므로 이후 두 순서 평균 정책 수치와 섞으면 안 됩니다. 코드 1,302개, 수학 1,179개, 논리 퍼즐 98개 등 능력별 분모가 다르고 새 prospective 자료는 포함하지 않습니다.
Answer length는 틀린 답변의 길이를 정답 대비 다섯 구간으로 나눕니다. JudgeBench에서 길이가 다른 181쌍 중 JEV가 더 긴 답변을 고르는 비율은 45.9%이고 실제 정답이 더 긴 비율은 49.7%입니다. 길이가 비슷한 경우에도 격차가 커서 장황함 선호만으로 설명할 수 없다는 근거입니다. 이 표는 탐색적이고 구간 추정이 없으며, 내용은 유지하고 문체를 직접 조작한 다음 RM-Bench 실험과 역할이 다릅니다. 원문 부록 D
📖 Chapter E: Follow-up benchmark checks
후속 표본은 RewardBench 2의 동률 아닌 5개 범주에서 각 20문항, RM-Bench는 500개 질문입니다. 전자는 네 후보 top-1 정확도이고 공식 전체 평가나 이진 RewardBench와 동일한 점수가 아닙니다. 후자는 문체 세 종류의 모든 조합과 양방향 순서를 유지합니다. GPT-6의 콘텐츠 필터 거절 3개는 고쳐서 재시도하지 않고 오류 분모에 남깁니다.
Table 13–15와 Figure 13–14는 조건별 정확도, paired 차이, 확률 진단, 9개 문체 조합을 순서대로 제시합니다. Skywork는 네 후보 선택에서 79%로 가장 높지만 hard 문체에서 70.6%로 JEV보다 낮습니다. 같은 질문 안 hard−normal 효과는 JEV −8.8%p, GPT-6 −1.7%p, Skywork −16.8%p입니다. 방향 선호, 순서 뒤집힘, 문체 민감도는 다른 성질입니다.
Routing on RM-Bench에서는 두 순서를 평균한 조건당 1,500쌍을 씁니다. 고확신 hard 오류율 57/720=7.9%는 두 순서를 각각 센 Table 15의 153/1,535=10.0%와 분모가 다릅니다. Routing on RewardBench 2에서는 100문항의 20%를 넘기는 임계값 0.5가 GPT-6의 75%를 맞추지만, 같은 문항에서 사후에 읽은 임계값이고 2%p가 두 문제에 불과합니다. 이 부록은 성능의 형식 의존성을 다음 답안 형식 실험으로 연결합니다. 원문 부록 E
📖 Chapter F: Answer format and gold-blind extraction
각 모델에 1,020개 요청을 보내 직접 정답 판정과 정답을 보지 않는 선택지 추출을 비교합니다. 자연 답변 150개를 두 방식으로 평가하고, 합성 통제는 직접 판정 480개와 추출 240개입니다. 추출기는 질문과 답변만 보고 최종 선택지를 내며, 이후 코드가 기준 답과 비교합니다. ambiguous는 일치 점수를 받지 않고 답 없음·무효와 구분합니다. 자연 자료에는 완전한 선택지가 없는 질문 5개도 남겨 두며, 독립된 선택지 수준 정답이 없으므로 추출 정확도 자체를 측정했다고 하지 않습니다.
Matched format controls는 HaluEval 40질문의 정답·오답 텍스트를 이용해 정답, 오답, 오답→정답 수정, 정답→오답 수정, 답 없음, 미결 대안의 여섯 형식을 만듭니다. 객관식과 자유응답은 같은 내용이지만 객관식은 대안도 보여주므로 형식 전체의 효과입니다. JEV는 객관식 직접·추출 모두 100%, 자유응답 92.5%입니다. 일부 차이는 “1930s”와 대공황 시기 같은 의미 동등성을 기존 환각 라벨이 배척하는 데서 생깁니다. 포화 표본의 [100,100] 구간을 미래 위험 0으로 해석하지 않습니다.
이후 자연 HaluEval 240개를 길이로 나눈 서술적 비교, 인프라 중단 처리, 직접 판정·정답 비노출 추출의 정확한 지침을 제시합니다. 중단된 요청의 응답·지연을 임의 대체하지 않으며 과금과 최종 판정 기록을 분리합니다. 의미 판정과 문자열 일치의 차이를 확인한 다음 부록은 실제 긴 자연문으로 범위를 넓힙니다. 원문 부록 F
📖 Chapter G: Natural free-response evaluation
문서 기반 요약은 200–1,000단어 문서 중 중복을 제거하고, 20–160단어의 정상·환각 요약을 가진 200개 문서를 고른 400판정입니다. 라벨은 새 사람이 검증한 사실성이 아니라 기존 생성 과정의 구성 라벨입니다. 일반 응답은 실제 배포본 4,507개에서 길이·중복 조건을 적용하고 기존 사람 환각 라벨별 100개씩 균형 표집합니다. 자연 발생 환각 비율을 측정한 자료가 아닙니다.
Table 18의 JEV 요약 정확도 69.8% [65.5,74.0]와 일반 응답 53.5% [46.5,60.5]는 서로 내용과 라벨 출처가 달라 직접적인 근거 제공 효과로 볼 수 없습니다. 일반 응답의 Brier 0.821, NLL 3.302, AUROC 0.498은 잘못된 높은 확신의 문제를 구체화합니다. GPT-4.1 mini와 GPT-5.4도 낮은 일치도를 보여 생성형 인터페이스만으로 해결된다는 증거는 없습니다.
끝의 요약 지침은 누락 자체를 환각으로 보지 않고 문서와의 모순·지원되지 않는 주장에 집중합니다. 근거 없는 지침은 검색·도구 없이 모델 지식으로 구체적 사실을 판단하게 하며 인용 부족이나 의견만으로 거절하지 않습니다. 다음 부록은 이렇게 수집한 출력이 유효하지 않을 때 점수에 어떻게 반영하는지 명시합니다. 원문 부록 G
📖 Chapter H: Output validity and additional metrics
Table 19는 제공자 생성 실패, HTTP 200이지만 계약을 어긴 응답, 통신·기타 HTTP 실패를 분리합니다. Qwen3.6의 유효 출력만 보면 JudgeBench 87.5%지만 전체 시도 정확도는 72.3%이므로, 서비스 가용성과 의미 판정 품질을 동시에 읽어야 합니다. 확률 지표는 유효 출력에 한정하고 정확도는 전체 시도를 유지합니다.
Table 20은 최종 답안 macro-F1, 108개 대화 답안과 64개 근거 통제군, 작업별 오류 AUROC를 보완합니다. 숨은 정답·생성 모델·분할 메타데이터를 바꾸어도 직렬화 입력이 같다는 검사도 기록합니다. FINAL에서 신뢰 기준 답을 보여주는 것은 작업 정의상 의도된 입력입니다.
Edge cases는 무효 첫 단계는 항상 넘기고 무효 fallback은 오답, 평균 동률은 절반 점수, 스칼라 동률은 기대 무작위 점수, 문맥 초과는 모델별 절단 수 보고, 유보 사람 라벨은 차이 계산에서 0 기여로 처리한다고 정리합니다. 원 결과를 더 좋아 보이게 고치지 않는 계약을 정리한 뒤 다음 부록은 유효한 출력끼리의 안정성을 분석합니다. 원문 부록 H
📖 Chapter I: Stability and interface diagnostics
Table 22는 유효한 두 순서에서의 불일치율과, 실패까지 포함한 양쪽 모두 정답 비율을 구분합니다. Table 23은 첫 위치 선택률 및 순서를 바꿔도 항상 첫째·항상 둘째를 고르는 쌍의 수를 보여줍니다. 첫 위치 평균이 50%여도 개별 답변 선택은 자주 뒤집힐 수 있습니다. JEV의 JudgeBench 불안정 39쌍은 항상 첫째 14개와 항상 둘째 25개로 구성됩니다.
Native confidence and primitives에서는 제공자의 고유 확신도도 오류 AUROC가 최대 확률과 비슷하다고 보고하되, 공개되지 않은 구현을 반올림된 출력에서 추정하지 않습니다. 48개 진단에서 Choice–Score 확률 차이 평균은 0.015, Noul 부정 쌍 잔차 최대는 0.19, 묶음 질문과 단독 Choice 차이는 평균 0.011입니다. 공동 질문 맥락과 확률 변동이 함께 작용합니다. 12개 GSM8K 궤적의 높은 확률은 모두 정답인 양성 통제 결과라는 경계도 다시 표시합니다. 다음 부록은 순서별 확신도를 전체 자료에서 정량화합니다. 원문 부록 I
📖 Chapter J: Confidence under presentation order: details
Two orders는 모든 확률을 답변 정체성으로 역매핑하고, 하나라도 무효면 뒤집힘 비율에서는 flip으로 세되 확률 지표와 고확신 flip에서는 제외합니다. 이 때문에 GPT-6 RewardBench의 유효 쌍 불일치 1.3%와 무효 포함 flip 1.5%는 서로 모순이 아닙니다. Table 24는 기본 1,850쌍에서 모델별 단일·평균 정확도, Brier, AUROC를 나란히 제시합니다. JEV의 고확신 flip 3/95와 일부 다른 모델의 큰 비중이 대비됩니다.
Four rotations는 각 후보가 네 위치를 한 번씩 차지하도록 100문항×4=400호출을 만듭니다. 모든 호출이 첫 시도에 유효했고 비용은 0.04달러였습니다. 원래 순서를 나흘 뒤 재호출한 결과 99/100의 판정이 같았으며 확률분포의 총변동거리 평균은 0.02입니다. 범주가 다른 동일 ID 두 개는 범주와 ID를 묶어 구별한 수정 기록도 남깁니다. 단일 회전들의 평균 정확도 72%보다 네 회전 평균 판정 70%가 낮아, 확률 평균이 언제나 성능을 높인다는 해석을 막습니다. 다음 부록은 이 신호를 보정과 선택 정책으로 평가합니다. 원문 부록 J
📖 Chapter K: Probability quality and selective prediction
Temperature scaling은 선택용 RewardBench 64쌍, JudgeBench 32쌍, HaluEval 16질문의 32판정만 적합에 사용합니다. 온도는 각각 0.651, 2.148, 4.452이고 별도 검증에서 이득과 악화를 모두 보고합니다. 선택적 오류–수용률 곡선은 동일 수용 범위에서의 오류를 보여주며 동률 확신도는 내부 기대 오류로 처리합니다. Brier·NLL·ECE와 함께 제공 라벨의 민감도도 읽어야 합니다.
Threshold sweeps의 Table 27은 사후 캐스케이드의 실제 정확도와 GPT-6 정확도 대비 유지 비율을 구분합니다. 유지 비율 100.2%는 정확도가 100%라는 뜻이 아닙니다. 무작위 대조군은 같은 예상 fallback 지출로 정하며 모든 정책이 첫 단계 비용을 냅니다. Frozen two-order policies의 Table 28은 12개 fallback 결과를 전부 보입니다. 임계값 0.5를 선택하면 모든 쌍을 수용하므로 이름이 캐스케이드여도 실제 fallback 호출은 없습니다.
Alternative first stages는 같은 96개 선택 자료와 규칙을 소급 적용합니다. Skywork는 확률 대신 두 보상 점수 차의 절댓값을 사용하며 기준은 4입니다. 로컬 첫 단계는 API 가격이 없어서 표의 요금 비율이 GPU 비용을 제외한다는 점이 특히 중요합니다. Confident errors는 높은 확신도의 오류율과 전체 오류에서 차지하는 몫을 별도로 세어, 거의 확신하지 않는 판정기가 높은 안전성을 보이는 것처럼 읽지 않게 합니다.
마지막 Label budget for threshold selection은 총 1,850쌍에서 매번 $k$개를 뽑아 나머지 $1850-k$개를 평가합니다. 96개를 작업별로 나누고 하한 규칙을 적용한 손실 초과율 0.6%, 192개에서 0.1%, 요금 중앙 비율 0.34는 같은 풀의 탐색적 재표집 결과입니다. 100개라는 숫자를 분포 이동에서도 성립하는 보증으로 읽지 않도록 부록 자체가 경고합니다. 다음 부록은 같은 출력 계약을 가진 다른 모델 계열을 대조합니다. 원문 부록 K
📖 Chapter L: Open-weight typed decisions: Laya
Laya는 ModernBERT-large 인코더 기반의 독립 오픈 가중치 계열이며 JEV 가중치 공개본이 아닙니다. English와 Typed-decisions를 기본 SDK·보정, 미세조정 없이 사용합니다. 각 체크포인트 18,006호출은 모두 유효하고 반복 확률도 같지만, RewardBench 47.3%·49.6%, JudgeBench 48.9%·49.1%로 거의 무작위입니다. 문맥이 완전히 들어간 RewardBench에서도 49.2%·50.0%여서 절단만으로 설명되지 않습니다.
문체 공격에서는 34–41%로 우연보다 낮고 확신도 AUROC도 약 0.48–0.53입니다. 결과적으로 안전한 캐스케이드는 거의 전부를 넘기며 JudgeBench에서는 아무것도 수용하지 않습니다. 로컬 중앙 29.8·30.2ms와 호스팅 JEV 152ms는 하드웨어·네트워크가 달라 아키텍처 속도 비교가 아닙니다.
부분적 예외는 답안 추출입니다. 합성 통제에서 정답 비노출 추출이 직접 판정보다 English 22.9%p, Typed-decisions 36.2%p 낫습니다. 선택지 추출과 의미의 옳고 그름 판정은 다른 능력이라는 앞선 형식 실험의 해석을 보완합니다. 다음 부록은 권장 정책을 새 자료에서 실행한 전체 프로토콜을 제시합니다. 원문 부록 L
📖 Chapter M: Prospective live test on PPE and JudgeBench
Protocol은 호출 전에 표본·요청·runner를 고정하고 임계값 파일에 해시를 기록합니다. PPE는 같은 모델이 같은 질문에 만든 정답·오답 쌍에서 질문당 하나를 뽑습니다. 다른 실험과 겹친 MMLU-Pro 25행, MATH 28행은 표집 전에 제외합니다. JudgeBench Claude 분할의 질문 중복 91개는 유지하되 별도 보고합니다. PPE는 출처당 20쌍, JudgeBench는 출처·기존 질문 여부를 고려하여 총 100쌍씩 선택용으로 둡니다.
Table 32에서 점 추정 규칙은 두 작업 모두 0.9를 고르지만 하한 규칙은 PPE 0.95와 JudgeBench 0.99를 선택합니다. 허용 손실 −2%p를 평균만으로 가까스로 만족하는 후보를 하한이 배제한 결과입니다. 조건을 만족하는 임계값이 없으면 모두 넘기는 fallback도 프로토콜에 있습니다.
Results의 Table 33은 실제 두 순서 정책과 단일 순서 대안의 모든 임계값을 비교하되, 실제 실행된 것은 선택된 지점뿐입니다. Table 34는 출처별 19–113쌍의 작은 하위 표본이므로 보조 결과입니다. JudgeBench LiveCodeBench 19쌍은 전부 넘겨 비용 비율이 1.01로, 첫 단계의 부가 비용 때문에 GPT-6만 쓰는 것보다 조금 비쌉니다. 이 결과도 숨기지 않고 어려운 작업에서 정확도를 유지하는 비용으로 드러냅니다. 전체 실행 비용은 12.77달러이며 무효 출력은 없었습니다. 다음 부록의 실시간 재현은 이 새 작업 실험과 다른 표본입니다. 원문 부록 M
📖 Chapter N: Live replication of the frozen policy
프로토콜은 이미 분석한 510쌍의 두 순서 1,020요청을 원 요청과 바이트 단위로 같게 하고 임계값 0.9를 유지합니다. 동시에 처리 중인 쌍은 최대 8개이며 두 JEV 호출 중 느린 시간에, 넘겼다면 GPT-6 시간을 더해 쌍별 지연을 정의합니다. 로컬 호출 간격 대기는 제외하지만 재시도 시간은 포함합니다. 수용한 쌍에도 실험 후 GPT-6를 별도로 호출해 비교군을 완성합니다.
Table 35에서 RewardBench 240쌍의 캐스케이드와 GPT-6는 93.3%로 같고, JudgeBench 270쌍은 91.9% 대 93.0%입니다. 두 작업 합계의 중앙 0.27초는 절반 이상이 빨리 수용되기 때문에 낮아지지만, JudgeBench 중앙은 2.02초 대 2.16초로 감소 폭이 작습니다. GPT-6 기준 호출 한 건의 콘텐츠 필터 거절은 GPT-6 오류로 남고 해당 캐스케이드는 JEV 판정을 사용합니다. 비용 8.81달러의 이 실험은 시뮬레이션과 실제 파이프라인의 일치를 확인하며, 다음 사례 부록은 숫자 뒤의 판정 의미를 해설합니다. 원문 부록 N
📖 Chapter O: Illustrative cases and rubric alignment
세 사례는 사후 층별 해시 규칙으로 선택한 예시이며 오류 빈도를 추정하는 표본은 아닙니다. 첫째 낙하산 문제에서 질량 80, 저항 계수 0.27, 종단 속도의 95%라는 조건을 이차 항력으로 적분하면 높이는 다음과 같습니다.
여기의 $m$은 질량, $k$는 이 사례의 항력 계수, $h$는 정지 상태에서 해당 속도에 이르기까지의 낙하 거리입니다. 앞서 임계값 선택 식의 라벨 수 $k$와는 다른 문맥의 기호입니다. A는 잘못된 유도 과정으로 정답 345m를 고르고 B는 270m로 끝나지만, JEV는 B에 0.91, GPT-6는 A에 0.94를 줍니다. 최종 답과 유도 과정의 충실성은 다른 평가 목표입니다. 최종 답을 우선하라는 JEV 루브릭 실험은 기본 정확도를 78.6%→79.4%로만 바꾸며 차이 구간 [−1.14,3.14]%p는 0을 포함합니다.
두 번째는 HaluEval의 “President López” 사례입니다. 사람은 근거에 복구 행위의 주체가 없다는 이유로 환각 판정에 동의해, 축약된 이름이라는 표면만으로 모델 오류나 라벨 오류를 단정할 수 없음을 보입니다. 세 번째는 시 한 줄을 추가하라는 요청에 JEV가 여섯 줄 답변을 고확신으로 택한 사례입니다. 저자는 이를 명시적 지시 불이행의 예로 한정하고 일반적 장황함 편향의 증거로 확대하지 않습니다. 마지막 부록은 이런 분석을 어느 범위까지 재현할 수 있는지 명시합니다. 원문 부록 O
📖 Chapter P: Supplementary reproducibility package
저자들이 설명한 보충 패키지는 공개 작업의 표집 입력·루브릭·판정·비용 기록·보상 점수·출처 해시와 주요 오프라인 분석 스크립트를 포함합니다. 사람 감사의 수정 프로토콜·블라인드 패킷·최종 판정, 순서 회전 실험, 실시간 재현, 확대 표집, Laya, prospective 실험의 요청·runner·기록이 각각 나뉩니다. API 호출이나 GPU 없이 보존 출력에서 주요 결과를 계산할 수 있도록 설계했습니다.
반면 과거 보정 전이·반복·인터페이스·루브릭 실험은 일부 보존 표 형태이고, 전체 적합 파이프라인이나 논문의 모든 그림이 재생성되지는 않습니다. 비공개 답변·대화 원자료, 원시 API 로그, 계정 정보와 인증정보도 제외됩니다. 이 리뷰는 v2 본문과 PDF에 서술된 재현 범위를 분석했으며 보충 패키지를 실행하거나 모델을 다시 평가하지 않았습니다. 원문의 마지막 부록은 공개 범위와 제외 범위를 함께 밝히며 분석을 마칩니다. 원문 부록 P
실험 결과 심층 분석
가장 중요한 구분은 기본 판정기의 성능, 고정 정책의 오프라인 성능, 동일 자료의 실제 재현, 새 작업의 실제 검증입니다. 첫 비교의 JEV 0.044달러/1,000건과 중앙 0.15초는 120건 시간 패널 값입니다. 1,610쌍에서 캐스케이드가 GPT-6보다 0.93%p 높고 비용이 41.4%라는 결과에는 양방향 JEV 호출이 이미 포함됩니다. 반면 510쌍의 실제 중앙 0.27초와 570개 새 쌍의 1.87초는 각각 다른 표본의 파이프라인 측정입니다. 서로 다른 열에서 가장 좋은 숫자만 골라 하나의 운영 성능처럼 결합할 수 없습니다. 원문 Table 1·4·5·35
통계적으로는 원 질문을 묶은 2,000회 paired 부트스트랩이 같은 질문의 답변·문체·순서 사이 의존성을 반영합니다. 고정 1,610쌍의 차이 구간 [0.24,1.66]%p는 0을 제외하지만 JudgeBench만의 [−2.22,0.74]%p는 포함합니다. 새 570쌍에서 관측 정확도가 같아도 [−0.70,0.70]%p라는 불확실성이 있습니다. 저자는 탐색 분석의 다중 비교를 보정하지 않았다고 명시합니다. 별도 p값 기반 유의성 검정은 보고하지 않으며, 신뢰구간과 사전 계획 여부를 함께 읽는 편이 적절합니다. 원문 §4·Limitations
비교군 선택도 결과를 바꿉니다. GPT-6는 가장 비싼 기준 모델이며 모든 작업의 최고 정확도 모델은 아닙니다. GPT-5.6을 쓰면 더 저렴한 조합이 나오지만 선택용 표본에서 고른 임계값이 JudgeBench에서 허용 손실을 넘는 사례가 있습니다. 동일 인터페이스의 Laya와 강한 보상 모델 Skywork도 서로 다른 실패 양상을 보여, 싼 모델의 단독 평균 정확도만으로 첫 단계의 가치를 예측할 수 없고 오류를 찾아내는 신호까지 평가해야 한다는 결론이 뒷받침됩니다. 원문 Table 3·부록 L
사람 재판정은 JudgeBench 격차의 방향을 강화하는 동시에 HaluEval의 확률 점수 순위를 뒤집습니다. 이는 정답 라벨을 바꾸는 민감도 분석과 전체 벤치마크를 새로 정답화하는 작업이 다르다는 좋은 사례입니다. 한 명의 연구팀 판정자와 LLM 보조 재검토라는 실제 프로토콜, 불일치 중심 표집, 유보 처리까지 고려해야 하며, 보정 우위나 사람 수준 성능을 광범위하게 주장할 근거로 쓰지 않습니다. 원문 부록 C
기술적 함의와 응용
저자들의 결과는 반복적인 답변 평가에서 비용을 줄이려면 판정 작업의 성격부터 분해해야 함을 보여줍니다. 제공 근거와 답변의 일치, 일반 선호처럼 판정을 읽어낼 수 있는 영역에서는 JEV가 많은 입력을 끝낼 수 있습니다. 코드 실행 논리나 수학적 정답 검증에서는 더 강한 판정기의 몫이 커집니다. 이는 설명을 출력하지 않는 인터페이스가 곧 모든 평가에 적합한 소형 모델을 뜻하지 않는다는 결과와 연결됩니다.
리뷰어의 해석으로는 실무적으로 중요한 산출물이 특정한 전역 임계값보다 목표 작업의 라벨에서 규칙을 고르고 별도 자료에서 검증하는 절차입니다. 첫 단계의 출력 유형, 후보 순서 평균, 무효 응답 처리, fallback의 설정이 달라지면 이미 선택한 임계값의 의미도 달라집니다. 저자가 권고한 약 100개 로컬 라벨과 하한 규칙은 이 실험의 근거를 가진 출발점이며, 절감률이나 손실 상한의 보편적 보장은 아닙니다.
특히 새 작업에서 74.2%를 넘겨 24.5%의 요금을 절감한 결과는 기존 표본의 큰 절감률보다 약한 성공이 아니라, 어려운 입력에서 더 많은 계산을 사용하도록 한 정책의 관측 결과입니다. 반대로 근거 없는 자연문에서 높은 확신과 우연 수준 정확도가 공존한 결과는 강한 모델로 넘길 대상을 확신도만으로 찾을 수 없는 경계를 보여줍니다. 이 논문이 지지하는 적용 범위는 저렴한 판정기를 보편적으로 대체 투입하는 것이 아니라, 확신도가 실제 오류와 연결되는 작업에서 판정을 수용하고 나머지는 검증된 상위 단계로 보내는 평가 구조입니다. 원문 §9–10
검토 범위: v2의 본문 1–10절과 한계·윤리 항목, 부록 A–P의 구조와 주요 논증을 모두 다루었습니다. 17개 주 비교 구성의 개별 수치 전부, 모든 표의 행, 평가 프롬프트 전문과 참고문헌 원문 전체를 재수록하지는 않았습니다. 보충 패키지의 코드를 실행하거나 API 판정을 재현하지 않았으며, 재현 가능성은 원문이 명시한 공개 범위를 기준으로 설명했습니다.