논문 개요와 전체 구조
웹 에이전트가 매번 화면을 읽고 클릭할 위치를 추론하면, 같은 일을 반복해도 관찰·추론·행동 비용이 계속 발생합니다. 반복되는 동작을 프로그램으로 묶어 도구로 제공하면 이 비용을 줄일 수 있습니다. 그러나 도구가 수천 개로 늘어나면 모델이 읽어야 하는 설명도 길어지고, 비슷한 도구 사이에서 선택하기도 어려워집니다. AutoTailor는 도구를 많이 만드는 문제에서 한 단계 더 나아가, 어떤 도구를 실제로 배포하고 유지할지를 다룹니다.
Xinyun Cao, Adriana Szekeres, Fazle Elahi Faisal의 이 논문은 웹 행동 기록을 재사용 가능한 MCP API로 바꾸고, 품질과 예상 사용 가능성에 따라 줄인 뒤, 실제 요청·실패·사용 기록으로 다시 선택하는 시스템을 제안합니다. MCP(Model Context Protocol)는 모델과 외부 도구를 연결하는 인터페이스입니다. 여기서 API는 웹사이트가 공식 제공하는 서버 API만을 뜻하지 않습니다. 브라우저를 조작하는 프로그램을 MCP 도구로 노출한 실행 단위입니다. 이 글은 2026년 9월 11일 제출된 arXiv v1 원문을 분석합니다.
주요 실험은 WebArena의 Postmill 환경 106개 과제입니다. 초기 1,283개 API를 정적 필터로 87개까지 줄이고, 사용 기록 기반 재선택으로 최종 33개를 얻습니다. ReAct fallback을 함께 사용할 때 correctness는 90.6%입니다. 다만 106개 과제로 도구 집합을 보정한 뒤, 그 집합을 고정하여 같은 106개 과제에서 평가한 결과입니다. 새로운 사용자나 별도 테스트 분포에서의 일반화 성능과 구분해서 읽어야 합니다. §4.1–4.3
원문에는 별도의 결론 절 없이 다음 순서로 본문과 부록이 구성됩니다. 온라인 재선택은 원문 번호 그대로 3.1.1에 놓여 있습니다.
| 순서 | 원문 구조 | 읽을 내용 |
|---|---|---|
| 1 | Introduction | 웹 에이전트의 도구 집합 관리 문제 |
| 2 | Related Work — 2.1 Web trajectory generation, 2.2 Tool and skill synthesis, 2.3 Meta-agent optimization | 궤적 생성·도구 합성·메타 최적화와의 관계 |
| 3 | System Architecture — 3.1 Offline Selection Module, 3.1.1 Online Dynamic Reselection (DR) | 생성, 품질 필터, 사용 가능성 필터, 추가와 가지치기 |
| 4 | Evaluation — 4.1 Resulting API sets, 4.2 Dynamic Calibration Protocol, 4.3 Evaluation on WebArena-Postmill, 4.4 Results | API 집합 크기와 보정 절차, fallback 유무 비교 |
| 5 | Discussion, Limitations, and Future Work — 5.1–5.3 | 도구 관리의 의미, 실제 사용자 평가, 오프라인 검증 |
| References | 참고문헌 | 본문에서 인용한 선행연구 |
| Appendix A | Technical appendices and supplementary material — A.1–A.4 | 세 가지 필터 판단과 동적 재선택 프롬프트 |
핵심 기여와 혁신성
문제의 중요성은 에이전트의 능력과 도구 목록의 크기가 같은 개념이 아니라는 데 있습니다. 도구를 많이 제공하면 지원하는 기능은 넓어질 수 있지만, 중복된 설명을 매번 읽는 비용과 선택 부담도 커집니다. 반대로 과감하게 줄이면 드물지만 필요한 기능이 사라져 일반 브라우저 추론으로 되돌아가야 합니다. 저자들은 이 상충관계를 실행 비용과 기능 범위의 문제로 다룹니다. §1
기존 연구가 궤적을 수집하거나 재사용 가능한 행동을 합성하는 데 집중했다면, AutoTailor의 중심 대상은 배포 도구 집합의 구성원입니다. 모델 가중치를 학습시키기보다 어떤 API를 넣고 뺄지 바꿉니다. 품질 필터로 기본 후보 풀을 만들고, 예상 수요로 초기 배포 목록을 정한 뒤, 관측된 미지원 요청으로 필요한 후보를 되살리는 구성이 핵심입니다. §2–3
실험적 기여는 도구 수를 줄이는 것만으로 전체 비용이 반드시 줄지는 않는다는 점을 보여준 데 있습니다. 정적 필터 이후 도구 처리 비용은 내려가도 fallback 비용이 증가할 수 있습니다. 동적 재선택은 87개보다 작은 33개 집합으로 직접 처리 범위를 회복했습니다. 리뷰어 관점에서 이 결과는 에이전트 최적화의 단위를 프롬프트 길이나 추론 횟수뿐 아니라, 사용자 분포에 맞춘 도구 구성까지 넓힙니다. 그 적용 범위는 원문의 단일 환경·모의 사용자 평가 조건 안에서 판단해야 합니다.
기술적 세부사항
실행하는 에이전트와 도구를 관리하는 계층
AutoTailor의 관리 계층은 웹 행동 기록을 프로그램으로 만들고 도구 목록을 갱신합니다. 사용자 과제를 수행하는 worker는 현재 노출된 도구를 골라 인자를 넣고 실행합니다. 지원 도구가 부족하면, 실험 조건에 따라 화면 상태를 반복 관찰하며 행동하는 ReAct 에이전트를 호출합니다. 관리 계층의 재선택과 과제 수행 중의 fallback은 서로 다른 기능입니다.
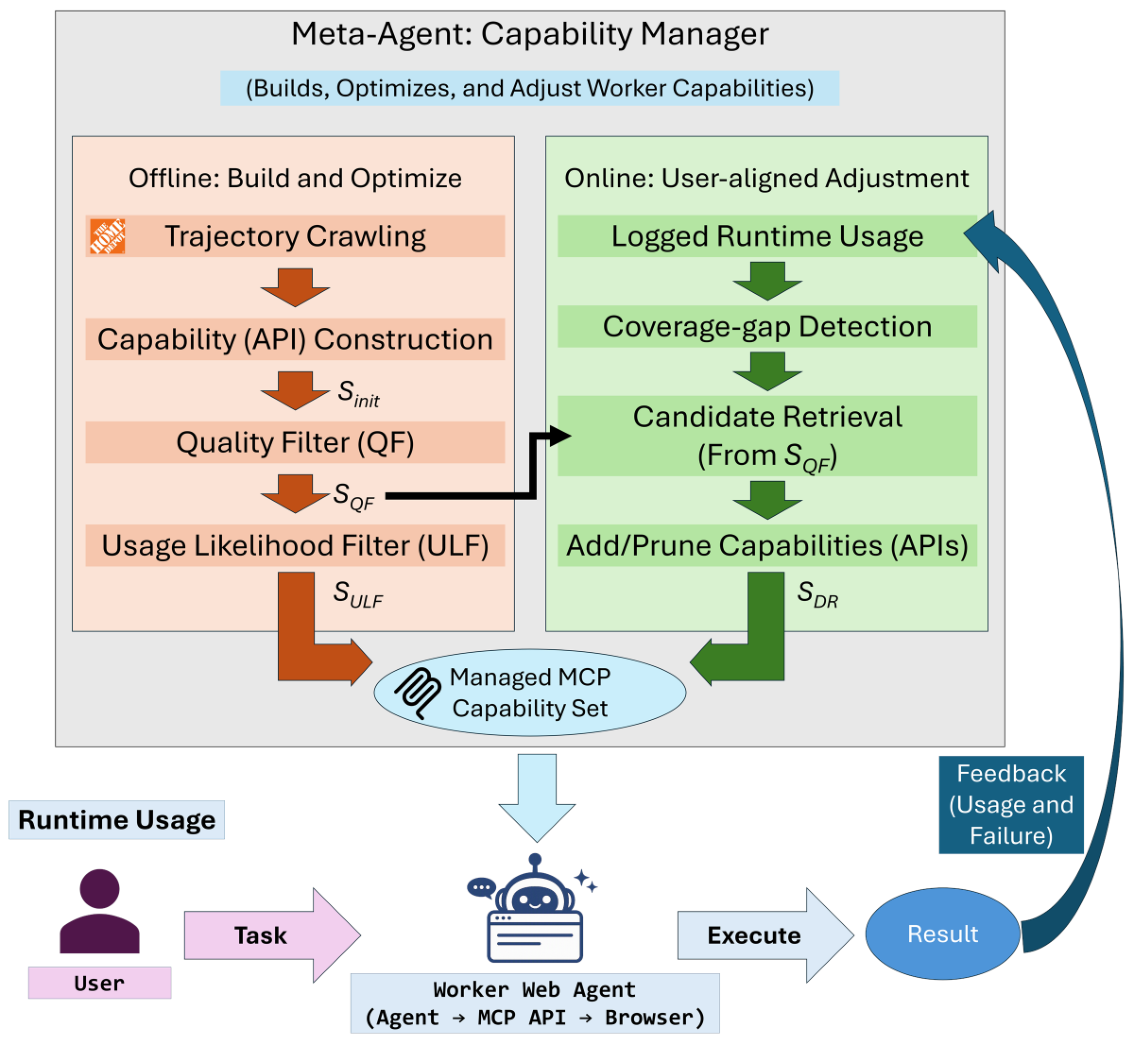
Figure 1, PDF 2쪽. 왼쪽은 오프라인 생성·필터링, 오른쪽은 실행 기록에 따른 재선택입니다. 그림 영역만 크롭했으며 번역하거나 재배열하지 않았습니다. v1 원문, CC BY 4.0.
그림의 검은 화살표가 중요합니다. 온라인 후보는 처음 만든 모든 API가 아니라 품질 필터를 통과한 집합에서 가져옵니다. 사용 가능성 필터에서 빠진 API도 후보 풀에는 남으므로, 초기에는 낮게 평가했던 기능을 나중에 복원할 수 있습니다. 반면 품질 필터에서 제거한 모든 동작을 온라인 단계가 새로 합성하는 구조로 설명되지는 않습니다.
네 집합과 측정값을 읽는 법
다음 식은 원문 §3–4의 표기와 집합 크기를 한 줄로 정리한 것이며, 새로운 최적화 목적함수를 제안한 것은 아닙니다.
$S_{\mathrm{init}}$은 생성된 전체 API, $S_{\mathrm{QF}}$는 품질·중복 필터 통과 집합, $S_{\mathrm{ULF}}$는 사용 가능성 필터까지 통과한 초기 활성 집합, $S_{\mathrm{DR}}$는 동적으로 보정한 최종 집합입니다. 세로 막대는 집합에 포함된 API 개수입니다. DR은 추가와 삭제를 모두 수행하므로, 최종 집합을 단순히 ULF 집합의 부분집합이라고 해석하면 안 됩니다.
Correctness는 106개 과제의 평균 benchmark score입니다. 이를 임의로 이진 성공 건수로 역산하지 않습니다. 원문 표의 All은 모든 과제 평균, Succ.는 성공 과제만의 평균입니다. 두 평균은 분모가 다릅니다. 또한 Request Token Cost는 금액이 아니라 요청 토큰 소비량이며, 논문은 도구 처리와 fallback의 토큰을 구분합니다. 이 글의 비교 표는 모두 All 열을 사용합니다. §4.3
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할: 도구를 활용하는 웹 에이전트가 왜 별도의 도구 관리 시스템을 필요로 하는지 설명합니다.
저자들은 먼저 자연어 목표를 이해하고 클릭·입력·스크롤로 과제를 수행하는 웹 에이전트를 정의합니다. 복잡한 사이트의 작업 효율이나 비시각적 접근성을 개선할 수 있다는 활용 맥락을 제시한 뒤, 초기 ReAct 방식의 비용을 설명합니다. 화면이나 DOM(Document Object Model)을 보고 다음 행동을 추론하는 반복은 매 단계 모델 호출과 상태 확인을 요구합니다.
다음에는 재사용 도구가 이 반복 비용을 줄일 수 있지만, 도구를 만드는 방식에도 문제가 있다고 설명합니다. 수작업으로 만들면 비용이 높고, 자동 발견만으로는 기능 범위가 부족할 수 있습니다. 광범위한 크롤링으로 이 문제를 보완하면 이번에는 중복되거나 수요와 잘 맞지 않는 행동 기록이 늘어납니다. 따라서 많이 발견하는 것과 잘 배포하는 것을 분리해야 합니다.
이 문제를 해결하기 위해 오프라인 선택과 온라인 재선택을 차례로 소개합니다. 오프라인은 궤적 수집 → API 구성 → 품질·사용 가능성 필터이고, 온라인은 기록 → 미지원 요청 탐지 → 후보 검색 → 추가·가지치기입니다. 실행 중 얻은 피드백이 다음 과제에서 노출할 도구 목록을 바꾸는 순환 구조입니다.
마지막에는 106개 Postmill 과제에서 정제 전·정적 선택·동적 선택 집합을 비교하겠다고 밝힙니다. 본문은 33개 API와 ReAct를 결합한 결과, 그리고 ReAct 없이도 초기 집합에 가까운 성능을 유지한 결과를 함께 제시합니다. 핵심 기여는 작은 목록과 넓은 기능 범위를 동시에 추구하는 관리 문제의 설정입니다. 다음 절은 이 문제를 기존 연구가 어디까지 다루었는지 구분합니다. §1
📖 Chapter 2: Related Work
위치와 역할: 궤적을 얻는 단계, 도구로 바꾸는 단계, 실행 주변 구조를 최적화하는 단계를 구별하고 AutoTailor의 위치를 정합니다.
2.1 Web trajectory generation
저자들은 먼저 행동 기록을 넓고 신뢰성 있게 얻는 연구를 설명합니다. OS-Genesis는 GUI를 먼저 탐색하고 과제를 역으로 구성하며, Explorer는 넓은 탐색과 의도 정제를 결합합니다. SynthAgent는 합성 과제와 시연을 함께 정제하고, AutoSurfer는 체계적 탐색과 궤적 기반 과제 합성으로 사이트 기능 범위를 확장합니다.
이 연구들이 제공하는 것은 후보 행동의 원재료입니다. AutoTailor가 이어받는 질문은 “수천 개 기록 가운데 어떤 행동을 배포 가능한 도구로 남길 것인가”입니다. 이 글에서는 해당 선행연구 자체를 재평가하지 않고, 원문이 설정한 역할 구분을 따릅니다.
2.2 Tool and skill synthesis
다음으로 저자들은 저수준 동작을 재사용 가능한 상위 도구로 묶는 연구를 검토합니다. ASI는 기본 행동을 프로그램으로 합성하고, SkillWeaver는 상호작용을 발견·연습하여 API 라이브러리를 늘립니다. WALT는 사이트에 이미 존재하는 기능을 도구로 드러내고, WebXSkill은 궤적 부분열에서 프로그램과 자연어 안내를 함께 얻습니다. The Tool Illusion은 도구 출처·설계·부작용에 따라 효용이 달라질 수 있음을 분석한 관련 연구로 소개됩니다.
여기에서 저자들이 강조하는 차이는 도구 합성 이후의 재고 관리입니다. AutoTailor는 폭넓은 후보에서 중복을 제거하고, 사용 가치에 따라 목록을 정하며, 수요에 맞춰 다시 선택합니다. 도구를 만들어 보유하는 것과 worker에게 지금 노출하는 것을 구분합니다.
2.3 Meta-agent optimization 및 Research space
마지막으로 GEPA의 프롬프트 진화, AlphaEvolve의 프로그램 개선, Meta-Harness의 harness 코드 최적화를 연결합니다. 공통점은 기반 모델 가중치를 직접 바꾸지 않고 주변 산출물을 개선한다는 것입니다. AutoTailor는 그 산출물을 “배포된 도구 집합의 구성원”으로 잡습니다. 요청, 사용 기록, fallback 호출, 실패가 어떤 도구를 유지할지 결정하는 자료가 됩니다.
이어지는 Research space 문단은 앞선 세 흐름을 통합합니다. 궤적 생성은 행동을 공급하고, 합성은 실행 가능하게 만들며, 메타 최적화는 적응을 제공합니다. 핵심 기여는 이 흐름을 도구 집합 선택·유지 문제로 연결하는 것입니다. 다음 절에서 이를 실제 필터와 갱신 규칙으로 구체화합니다. §2
📖 Chapter 3: System Architecture
위치와 역할: 실행 가능한 API를 만드는 과정부터 사용 기록에 따른 갱신까지, 시스템의 입출력과 판단 기준을 설명합니다.
3.1 Offline Selection Module — Trajectory Crawling
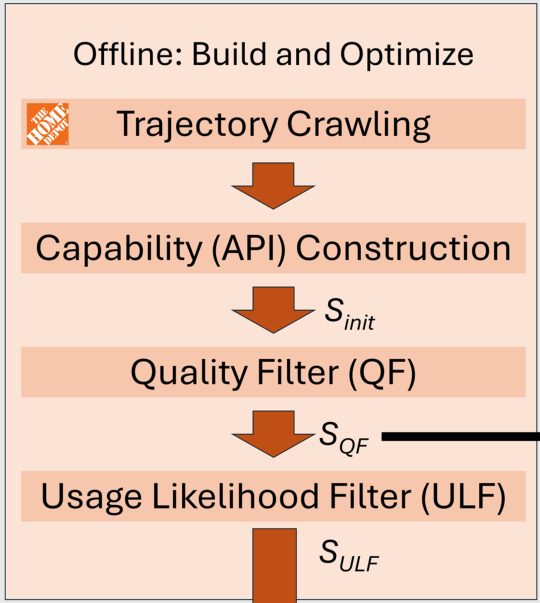
Figure 1 오프라인 패널 상세, PDF 2쪽. 위 전체 그림을 유지하고 읽기 쉽게 해당 패널만 추가 크롭했습니다. 패널 밖 연결은 전체 그림에서 확인할 수 있습니다. 번역·재배열 없음. v1 원문, CC BY 4.0.
오프라인 입력은 기존 크롤링 방법으로 수집한 웹 궤적입니다. 각 기록에는 과제 설명, 문맥, 순서가 있는 브라우저 행동이 들어 있습니다. 동작의 순서와 과제 목적을 함께 갖고 있어야, 단순한 클릭 기록을 사용자 수준의 기능으로 바꿀 수 있습니다.
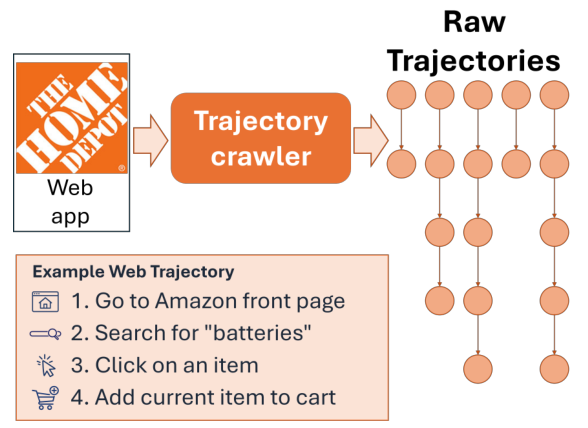
Figure 2, PDF 6쪽. 웹 궤적 수집 개요입니다. 원문의 쇼핑 예시는 탐색 방식을 설명하는 도식이며, 이 논문의 정량 평가 환경은 Postmill입니다. 그림 영역만 크롭했으며 번역·재배열하지 않았습니다. v1 원문, CC BY 4.0.
그림의 예시는 페이지 이동, 검색, 항목 선택, 장바구니 조작이 하나의 순서 있는 기록이 되는 과정을 보여줍니다. 길이가 서로 다른 기록이 생기므로, 이후 단계는 어느 정도 크기의 기능을 하나의 도구로 볼지도 판단해야 합니다.
Capability (API) Construction
코드 생성 LLM은 각 궤적을 Playwright로 UI를 조작하는 비동기 함수로 변환합니다. 사용자 이름·검색어·제목·자유 텍스트처럼 실행 사례마다 바뀌는 값은 의미 있는 함수 인자로 바꿉니다. 반면 고정 UI 라벨, 내장 선택지, URL은 리터럴로 유지합니다. 따라서 산출물은 한 번의 행동을 그대로 재생하는 기록보다, 인자를 바꿔 재사용할 수 있는 과제 템플릿에 가깝습니다.
함수 이름, 시그니처, docstring에는 과제, 인자, 실행 단계, 반환값을 명시하도록 합니다. 이 설명은 단순한 문서가 아닙니다. 뒤의 임베딩·중복 판정·사용 가능성 평가·MCP 노출에서 반복적으로 사용됩니다. 원문에는 이 생성 프롬프트의 전문이나 전체 구현 코드가 실려 있지는 않습니다.
Quality Filter (QF)
QF의 첫 기준은 granularity, 즉 한 기능으로 묶은 작업의 크기입니다. 단순 이동이나 클릭만 제공하면 사용자 목표를 완결하지 못하고, 서로 다른 일을 지나치게 묶으면 재사용하기 어렵습니다. 부록 A.1의 1–5 점수는 “높을수록 좋음”이 아닙니다. 1은 지나치게 원자적이고, 3이 적절하며, 5는 과도하게 많은 과제를 묶은 상태입니다. 본문은 적절한 추상화 수준을 남긴다고 설명하지만, 점수별 정확한 통과 구간은 명시하지 않습니다.
그다음에는 기능 중복을 제거합니다. 인자화된 docstring을 임베딩하고 cosine similarity 0.75를 기준으로 탐욕적 중심점 군집화를 합니다. 같은 군집에서 유사도 0.80을 넘는 쌍은 LLM verifier가 과제 설명, 행동 순서, 실행 코드를 비교합니다. 문장 의미가 가깝다는 것만으로 삭제하지 않고, 기능적으로 같은지 한 번 더 판단합니다.
중복으로 확인한 쌍에서는 더 완전한 궤적을 남깁니다. 동률이면 상호작용 단계가 더 적은 쪽, 그래도 같으면 원래 수집 순서가 앞선 쪽을 선택합니다. 결과 집합이 $S_{\mathrm{QF}}$이고, 군집 정보는 이후 의미적 범위 보존에 재사용합니다. §3.1 및 A.1–A.2
Usage Likelihood Filter (ULF)
ULF는 사이트 설명과 API의 인자화된 설명을 보고 실제 사용자가 얼마나 원할 법한지 LLM에 1–5로 평가하게 합니다. 이 점수는 클릭 로그에서 계산한 빈도나 실측 확률이 아닙니다. 배포 전에 모델이 추정한 사용 가능성입니다.
4점과 5점은 기본적으로 남깁니다. 이 조건만 적용하면 일부 기능 범주가 통째로 없어질 수 있으므로, 아직 대표 API가 없는 의미 군집에서는 최고 점수 API가 3점 이상일 경우 하나를 추가로 남깁니다. 이 보완 조건은 다양성을 지키기 위한 것이지만, 모든 과제를 실행할 수 있음을 보장하는 검증은 아닙니다. 실제로 §4에서 ULF만 적용한 직접 처리 성능은 내려갑니다.
MCP Capability Set Synthesis
선정된 프로그램은 동적 MCP 서버가 읽고 도구로 등록합니다. 함수 이름은 식별자, docstring은 도구 설명, 의미적 인자는 입력 스키마가 됩니다. worker가 인자를 지정해 호출하면 서버가 해당 프로그램과 실행 문맥을 연결해 실행합니다.
초기 활성 집합은 $S_{\mathrm{ULF}}$입니다. 더 넓은 $S_{\mathrm{QF}}$는 비활성 후보를 포함한 풀로 남습니다. 이 분리는 전체 후보를 매번 worker의 활성 목록에 넣지 않으면서, 필요할 때 복원할 경로를 제공합니다.
3.1.1 Online Dynamic Reselection (DR) — Logged Runtime Usage
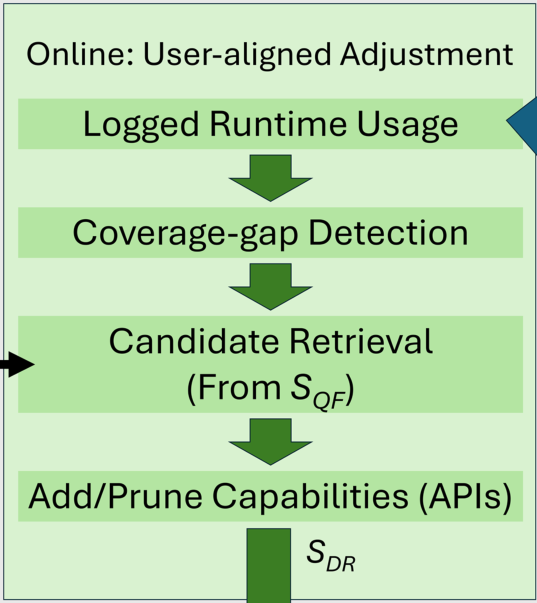
Figure 1 온라인 패널 상세, PDF 2쪽. 위 전체 그림을 유지하고 읽기 쉽게 해당 패널만 추가 크롭했습니다. 패널 밖 연결은 전체 그림에서 확인할 수 있습니다. 번역·재배열 없음. v1 원문, CC BY 4.0.
원문은 온라인 재선택을 네 단계로 설명합니다. 먼저 매 과제가 끝난 뒤 사용자 의도, 도구 호출 순서, 과제 결과, 누적 API 사용량을 기록합니다. 과제 단위 로그는 “무엇을 못했는가”를, 누적 사용량은 “어떤 도구가 실제로 쓰였는가”를 판단하는 근거입니다.
Coverage-Gap Detection
현재 API가 과제에 실패하거나, worker가 적절한 API가 없다고 판단하면 미지원 과제로 표시합니다. 과제별 값은 인자로 바꿔 의도를 정규화한 뒤, 임베딩과 의미 유사도로 묶어 반복되는 공백을 찾습니다. 같은 종류의 요청이 이름이나 숫자만 달리하여 들어왔을 때 하나의 수요 패턴으로 볼 수 있게 하는 단계입니다.
실험에서는 최근 100개 과제의 rolling window를 사용하고, 의도 군집 유사도 임계값은 0.82입니다. 재선택은 주기적으로 또는 설정된 수의 미지원 과제가 쌓였을 때 촉발됩니다. 원문은 이 조건이 배포 환경에 달린다고 설명하며, 평가 중 실제 trigger 횟수나 단계별 변화는 보고하지 않습니다.
Candidate Retrieval and Capability Addition
각 미해결 군집에 대해 대표 정규화 의도와 비활성 후보 API 설명을 LLM에 줍니다. 모델은 그 공백을 해결할 수 있는 API를 군집당 최대 5개 고릅니다. 없는 기능을 임의로 만들어내는 단계가 아니라 $S_{\mathrm{QF}}$ 안에서 재선택하는 단계입니다. 적절한 후보가 없으면 공백은 미해결로 남고, 추가 실행 근거가 생겼을 때 다시 고려합니다.
선택된 API를 활성 집합에 넣고 MCP 서버가 등록 도구를 다시 읽으면, 이후 과제부터 사용할 수 있습니다. 재선택이 현재 실패한 과제를 반드시 다시 해결해 준다고 원문이 보장하는 것은 아닙니다.
Capability Pruning
추가와 제거는 대칭적으로 처리하지 않습니다. 공백이 발견되면 도구를 추가할 수 있지만, 제거는 충분한 미사용 근거를 기다립니다. 한 번이라도 호출된 API는 가지치기에서 보호하고, 한 번도 사용되지 않은 API는 설정된 기간이 지나야 제거 후보가 됩니다. 실험에서는 미사용 50개 과제, 신규 API의 유예기간 50개 과제, 최소 활성 집합 크기 10개를 사용합니다.
여기서 기간의 단위는 시간이 아니라 처리한 과제 수입니다. 또한 사용된 API를 단지 오래 호출하지 않았다는 이유로 제거한다고 읽으면 원문 규칙과 다릅니다. 이 절의 핵심 기여는 품질 후보 풀과 활성 목록을 분리하고, 부족한 기능의 추가와 지속적 미사용 기능의 제거에 서로 다른 근거를 요구하는 설계입니다. 다음 절은 이 설계가 만든 최종 집합의 효용을 비교합니다. §3.1.1
📖 Chapter 4: Evaluation
위치와 역할: 정제 단계별 집합의 크기와 실제 과제 처리 결과를 연결합니다. 도구 자체의 범위와 fallback을 포함한 최종 시스템을 나누어 평가합니다.
4.1 Resulting API sets
초기 API는 1,283개이며 QF 이후 215개, ULF 이후 87개입니다. 동적 보정으로 얻은 최종 집합은 33개입니다. 단계를 지날수록 개수는 줄지만, DR에는 추가도 있으므로 “87개에서 54개를 단순 삭제했다”는 설명은 성립하지 않습니다. 원문은 중간 집합과 추가·삭제 개수의 상세 경로를 보고하지 않습니다.
4.2 Dynamic Calibration Protocol
106개 Postmill 과제를 무작위 순서로 배치해 모의 사용자 요청 시퀀스로 사용합니다. 시스템은 이 요청을 처리하며 수요, 사용량, 기능 공백을 관찰합니다. 이렇게 얻은 최종 33개 API를 고정한 후 뒤의 평가에 사용합니다.
따라서 결과는 계속 적응하는 과정 전체의 누적 성능이 아니라, 보정 후 얻은 집합의 품질입니다. 원문은 단계별 보정 정확도, trigger 횟수, 과제 계열 통계, 중간 API 수를 보고하지 않는다고 명시합니다. 또한 보정 이후 사용자 관심과 상대적 빈도가 대체로 안정적이라는 가정을 둡니다. 이 조건을 생략하고 변화하는 실제 사용자에게 자동으로 일반화했다고 설명해서는 안 됩니다. §4.2
4.3 Evaluation on WebArena-Postmill
실험의 tooling agent와 fallback agent는 모두 Copilot에서 Claude Opus 4.8을 사용합니다. tooling agent는 선택된 API를 노출한 MCP 서버에 연결되고, fallback agent는 Playwright MCP에 연결됩니다. tooling agent는 필요한 API를 고르고 인자를 공급하며, 여러 호출을 순서대로 조합할 수 있습니다. 부족하면 fallback을 호출하고, fallback은 웹 상태를 보며 저수준 행동을 반복합니다.
네 집합을 각각 fallback 유무로 비교하며, 궤적 기반 API가 없는 ReAct only를 참고 조건으로 둡니다. fallback을 켜면 최종 시스템의 효과를 보고, 끄면 합성된 API가 직접 지원하는 범위와 실행 효율을 봅니다. 이 분리는 ULF가 기능을 잘 보존했는지, 아니면 fallback이 빠진 부분을 대신 처리했는지 구별하는 데 필요합니다.
지표는 correctness, 지연시간, MCP 호출 수, LLM 호출 수, 요청·완료 토큰입니다. tooling과 fallback을 따로 집계하고 전체 토큰도 합칩니다. 원문 표는 MCP 호출 수가 클수록 좋은 방향으로 강조하지만, 호출 수 자체를 과제 성공과 동일시할 수는 없습니다. 재사용 API를 얼마나 활용했는지 보여주는 활동 지표로 함께 읽는 편이 적절합니다. §4.3
4.4 Results — Results with ReAct Fallback
아래는 원문 Table 1의 All 열에서 핵심 지표를 옮긴 것입니다. k는 천 토큰, m은 백만 토큰이며, correctness만 백분율로 바꾸었습니다.
| 조건 | API 수 | Correctness | 평균 지연(초) | Tooling 요청 토큰 | Fallback 요청 토큰 | 전체 요청 토큰 |
|---|---|---|---|---|---|---|
| ReAct only | 궤적 API 없음 | 87.5% | 102.63 | 29.70k | 3.10m | 3.13m |
| 초기 집합 + ReAct | 1,283 | 88.0% | 93.31 | 2.39m | 970.96k | 3.36m |
| QF + ReAct | 215 | 83.5% | 85.97 | 403.30k | 1.01m | 1.42m |
| ULF + ReAct | 87 | 87.3% | 86.91 | 205.13k | 1.31m | 1.52m |
| DR + ReAct | 33 | 90.6% | 72.45 | 98.46k | 1.22m | 1.32m |
Table 1, PDF 9쪽. 모든 과제 평균입니다. 표의 반올림 때문에 구성 요소의 합이 전체 표시값과 정확히 일치하지 않을 수 있습니다.
저자들은 먼저 초기 집합과 QF를 비교합니다. QF는 tooling 요청을 2.39m에서 403.30k로 크게 줄이고 지연도 낮추지만, correctness는 88.0%에서 83.5%로 내려갑니다. 다음 ULF 단계는 tooling 요청을 205.13k까지 줄이면서 correctness를 87.3%로 회복합니다. 그러나 fallback LLM 호출은 4.25회에서 5.33회로 늘어나고, 전체 요청 토큰은 1.42m에서 1.52m로 증가합니다.
도구 목록을 줄여서 아낀 비용이 fallback으로 이동할 수 있다는 것이 이 비교의 핵심입니다. ULF가 QF보다 작은 목록이라고 해서 end-to-end 비용도 항상 낮은 것은 아닙니다. DR은 이보다 나은 절충을 보여 줍니다. 33개로 correctness 90.6%, 전체 과제 평균 지연 72.45초, 전체 요청 1.32m를 기록합니다. 다만 전체 요청의 약 1.22m는 여전히 fallback에서 발생합니다. 작은 API 집합이 범용 브라우저 추론을 완전히 대체한 결과는 아닙니다.
Results without ReAct
저자들은 이어 fallback을 제거해 직접 실행 범위를 확인합니다. 아래는 Table 2의 All 열입니다.
| 조건 | Correctness | 평균 지연(초) | 평균 tooling LLM 호출 | Tooling 요청 토큰 |
|---|---|---|---|---|
| 초기 집합 | 60.4% | 99.11 | 4.05 | 2.78m |
| QF | 59.9% | 84.48 | 4.27 | 452.58k |
| ULF | 50.2% | 86.85 | 4.35 | 225.07k |
| DR | 60.1% | 79.50 | 4.66 | 142.86k |
Table 2, PDF 10쪽. 모든 과제 평균입니다. 이 조건에서는 fallback 토큰이 없습니다.
QF는 초기 correctness를 거의 유지하며 요청 토큰을 크게 줄입니다. ULF는 여기서 9.7%p 내려갑니다. 덜 자주 쓰일 것이라고 예상한 기능이라도 일부 과제에는 필수였음을 보여주는 결과라고 저자들은 설명합니다. 반면 DR은 60.1%까지 회복합니다. 초기의 60.4%와 가까운 수치이지만, 통계적 동등성이 입증되었다는 뜻은 아닙니다.
이 표는 모델 호출 수와 토큰 수가 다른 지표라는 사실도 보여 줍니다. DR의 평균 tooling LLM 호출은 4.66회로 초기 4.05회보다 많지만, 요청 토큰은 훨씬 적습니다. 리뷰어 해석으로는 “모델을 적게 불러서만 빨라진다”보다, 호출에 노출되는 도구 문맥과 실행 분담을 함께 봐야 하는 결과입니다. 이 절의 핵심 기여는 정적 선택의 기능 손실과 동적 선택의 회복을 fallback 유무로 나누어 확인한 것입니다. 다음 절에서는 이를 실제 운영으로 확장할 때의 경계를 논의합니다. §4.4
📖 Chapter 5: Discussion, Limitations, and Future Work
위치와 역할: 실험이 보여 준 도구 관리의 의미를 설명하면서, 저자들이 인정한 적용 범위와 향후 과제를 명시합니다.
5.1 Web Agent Capability Management As a First-Class Component
저자들은 도구 집합 구성 자체가 효율과 효과에 큰 영향을 주므로, 계획·추론 능력 개선과 함께 독립적인 관리 대상으로 볼 필요가 있다고 주장합니다. 정적 필터는 중복 문맥을 줄이고, 동적 선택은 관측된 수요에서 중요한 기능을 복원합니다. 향후에는 개인별 적응뿐 아니라, 비슷한 과제 분포를 가진 사용자 집단의 공통 프로필을 학습하면서 개인화도 유지하는 방향을 제시합니다. 이는 이 논문에서 평가한 기능이 아니라 저자들의 향후 연구 방향입니다.
5.2 Evaluation Realism Through Real World Usage
현재 평가는 템플릿 기반 WebArena 과제로 반복 사용자 상호작용을 모사합니다. 실제 요청은 더 시끄럽고 불규칙하며 문맥 의존적일 수 있고, benchmark에는 현실에서 드문 과제도 들어갈 수 있다고 저자들은 설명합니다. 따라서 결과를 안정적인 모의 과제 분포에 적응할 수 있다는 근거로 읽어야 하며, production 동작 전체를 규명한 것으로 보지 말라고 명시합니다.
향후 평가에는 장기간의 실제 사용자 상호작용, 관심 변화, 서로 다른 과제 빈도, 자연 발생하는 실패가 포함되어야 한다고 제안합니다. 이는 본문에서 명시된 외적 타당성의 경계입니다. 새 환경이나 변동하는 수요에서 성능을 보장한다는 주장은 이 평가로 뒷받침되지 않습니다.
5.3 Verification for Compact Capability Sets
마지막으로 웹 행동에는 되돌리기 어렵거나 안전에 민감한 효과가 있을 수 있다고 지적합니다. 열린 브라우저 상호작용을 매번 온라인으로 형식 검증하거나 모든 행동 순서를 검증하는 것은 비쌀 수 있습니다. 반면 자주 쓰는 동작을 작은 프로그램 집합으로 정리하면, 배포 전 검사·테스트·형식 검증의 대상으로 삼기 쉬워질 가능성이 있습니다.
저자들은 동적 관리와 오프라인 검증, 정책 검사, sandbox 테스트의 결합을 향후 방향으로 제안합니다. 검증 가능한 단위가 작아진다는 가능성과, 이미 안전성이 검증되었다는 주장은 다릅니다. 이 절의 기여는 도구 압축을 비용 절감뿐 아니라 신뢰성 관리의 단위로 해석한 점입니다. 본문 이후 참고문헌을 거쳐 부록에서는 주요 판단 프롬프트를 제공합니다. §5
📖 Chapter A: Technical appendices and supplementary material
위치와 역할: 필터 이름만으로는 알기 어려운 판단 기준을 프롬프트 수준에서 명시합니다. 다음 순서는 원문 A.1–A.4를 따릅니다.
A.1 Task Granularity Evaluation Prompt
입력은 고수준 지시와 행동 이력입니다. 평가 목표는 단일하고 의미 있으며 자체 완결적인 사용자 과제인지 판정하는 것입니다. 판단 축은 목표 완결성, 최소성, 집중도입니다. 목표를 끝내는 데 필요한 동작만 포함하고, 관계없는 일을 끼워 넣지 않아야 합니다.
점수 1은 이동·클릭 수준의 지나치게 원자적인 동작, 2는 의미 있는 결과 전에 멈춘 불완전한 과제, 3은 적절한 하나의 과제, 4는 주목표에 불필요한 단계가 일부 붙은 상태, 5는 여러 독립 과제를 과도하게 묶은 상태입니다. 이 순서는 일반적인 품질 점수와 다르므로 구현자가 5점을 우수 사례로 선택하면 의도를 뒤집게 됩니다.
사용자 질문에 답하는 궤적에는 예외 규칙이 있습니다. 마지막 행동이 generate_answer이면 그 단계에서 요청한 답을 얻은 것으로 취급합니다. 별도의 답 생성 행동이 상세히 없다는 이유만으로 불완전하다고 감점하지 않습니다. 출력은 판단 이유와 정수 점수입니다. A.1
A.2 Functional Deduplication Detection Prompt
두 궤적의 ID, 설명, 행동, 코드를 함께 제공합니다. 같은 사용자 과제를 본질적으로 같은 방식으로 달성하면 기능적 중복으로 봅니다. 표현 차이, 동등한 단계 사이의 순서 차이, 특정 입력값 차이는 무시하도록 합니다.
출력은 중복 여부의 불리언과 이유입니다. 중요한 점은 임베딩 유사도만으로 결론내리지 않고, 실행 코드와 행동까지 대조하도록 했다는 것입니다. 다만 LLM 판정을 형식적 프로그램 동치 증명으로 설명하지는 않습니다. A.2
A.3 Usage Likelihood Evaluation Prompt
입력은 웹사이트 설명과 인자화된 궤적 설명입니다. 5점은 검색·댓글 작성·추천처럼 사이트의 핵심적이고 흔한 목표, 4점은 정렬·구독·자신의 댓글 수정과 같은 흔한 목표, 3점은 프로필 소개 변경이나 게시물 저장 같은 간헐적 목표로 예시를 듭니다. 2점은 특수한 상황의 기능, 1점은 매우 드물거나 부자연스럽게 결합한 목표입니다.
출력은 정수 rating과 이유입니다. 이 기준이 사이트 사용에 대한 일반적 예상이라는 점이 중요합니다. 특정 사용자가 실제로 자주 수행하는 작업은 일반적 인기와 다를 수 있고, 그 차이를 실행 기록 기반 DR이 보완하도록 설계되었습니다. A.3
A.4 Dynamic API Reselection Prompt
마지막 프롬프트는 현재 도구 집합이 처리하지 못한 사용자 요청 템플릿과 구체적 예시, 후보 API ID와 docstring을 제공합니다. <val>은 이름·설명·인용문 같은 값, <list>는 값 목록, <num>은 숫자를 가리는 자리표시자입니다. 값이 다르더라도 구조적 의도가 같은 요청을 함께 볼 수 있게 합니다.
모델은 적절한 인자를 넣으면 미지원 요청을 실제로 달성할 수 있는 API만 선택하고, 우선순위대로 ID를 반환해야 합니다. 원문 식별자를 그대로 쓰며, 적합한 후보가 없으면 빈 목록을 반환합니다. 최대 개수는 프롬프트 변수로 주어지고 본문 실험 설정은 5개입니다. 출력은 선택된 API 목록과 이유입니다.
부록의 핵심 기여는 granularity, 중복, 예상 수요, 공백 해소를 서로 다른 판단으로 분리해 공개한 것입니다. 필터 하나로 모든 품질을 평가하지 않고, 목적이 다른 판단을 단계별로 적용한다는 점이 시스템을 이해하는 데 중요합니다. A.4
실험 결과 심층 분석
두 가지 절감률은 비교 기준이 다릅니다
논문 초록의 57.8%는 ReAct를 포함한 DR과 ReAct only 사이의 전체 요청 토큰 비교입니다. 94.9%는 fallback이 없는 DR과 초기 API 집합 사이의 요청 토큰 비교입니다. 이를 같은 기준의 연속 절감률처럼 곱하거나, 94.9%의 비용 절감으로 correctness 90.6%를 얻었다고 묶으면 안 됩니다.
다음은 Table 1·2의 반올림된 값을 사용한 설명용 계산입니다. 원문에는 별도의 번호식이 없으며, 원시 수치로 계산한 저자 보고율과 미세한 반올림 차이가 있습니다.
$T_{\mathrm{before}}$와 $T_{\mathrm{after}}$는 각 비교 조건의 과제당 평균 요청 토큰입니다. $r$은 줄어든 비율이고, 두 분수는 모두 백만 토큰 단위로 맞췄습니다. 첫 비교에서는 지연도 102.63초에서 72.45초로 29.4% 감소합니다. correctness 차이는 90.6−87.5=3.1%p입니다. 이 수치들은 관측된 차이이며 유의성 검정 결과가 아닙니다.
정적 필터와 수요 적응은 다른 역할입니다
QF는 중복과 부적절한 작업 크기를 줄여 직접 처리 correctness를 60.4%에서 59.9%로 거의 유지합니다. ULF는 일반적으로 유용해 보이는 것에 더 집중하면서 50.2%로 내려갑니다. DR은 관측된 요청을 이용해 60.1%로 회복합니다. 이 결과는 “일반적으로 인기 있어 보이는 기능”과 “이 요청 분포를 지원하는 기능” 사이의 차이를 보여 줍니다.
다만 이 평가에서 요청 분포는 별도 사용자 데이터가 아니라 보정에도 사용한 106개 benchmark 과제입니다. 따라서 33개가 모든 사용자를 위한 최적 크기라는 결론이나, 보지 않은 요청의 성능까지 유지한다는 결론으로 확장하지 않습니다. 33은 제약식에서 고정한 목표 개수가 아니라, 이 보정 절차가 만든 최종 크기입니다.
신뢰도와 재현 범위
원문은 주요 차이에 대한 신뢰구간, 통계적 유의성 검정, 반복 실행 분산을 보고하지 않습니다. 60.1%와 60.4%가 가깝다고 해서 통계적 동등성을 주장할 수 없고, 90.6%가 87.5%보다 높다는 관측만으로 유의한 개선이라고 단정하지 않습니다.
재현에 도움이 되는 정보는 군집 임계값 0.75·0.80·0.82, ULF 기준, rolling window 100개, 가지치기·유예기간 50개, 최소 API 10개, 후보 최대 5개와 부록 프롬프트입니다. 반면 원문만으로는 생성·검증에 사용한 모든 모델 설정, granularity 통과 구간, 실제 보정 trigger와 중간 변화, 전체 코드·API 목록을 완전히 복원할 수 없습니다. 이는 확인 가능한 정보의 범위이며, 그 자체로 시스템이 실패한다고 주장하는 것은 아닙니다.
기술적 함의와 응용
AutoTailor를 이해하는 핵심은 도구를 소유하는 것과 현재 모델에게 노출하는 것을 분리하는 데 있습니다. 넓은 품질 후보 풀을 유지하면서 활성 목록은 좁게 두고, 실제 미지원 요청으로 필요한 기능을 복원합니다. 리뷰어 관점에서 이 구분은 웹 에이전트의 도구 구성뿐 아니라, 반복 업무를 처리하는 에이전트의 운영 기록을 어떻게 활용할지 생각하는 데도 유용합니다. 다른 도메인에서 같은 개선이 난다는 실험 결과로 제시하는 것은 아닙니다.
실제 운영에 가져올 때 원문이 강조한 경계도 함께 가져와야 합니다. 일반적인 사용 가능성 추정은 사용자별 관측을 대신하지 않고, 작은 도구 목록이 성공률과 전체 토큰을 자동으로 개선하지도 않습니다. fallback까지 합쳐 측정해야 하며, 프로그램화한 동작의 안전성은 별도로 검토해야 합니다. 저자들이 제안한 실제 장기 사용 평가와 오프라인 검증은 이 연구의 향후 방향입니다.
이 논문이 제시한 것은 특정 도구 수를 정답으로 고르는 규칙보다, 좋은 도구 후보를 만들고, 관측된 수요로 배포 구성을 갱신하고, 최종 실행 비용으로 판단하는 절차입니다. 보고된 결과는 그 절차가 안정적인 Postmill 모의 요청 분포에서 작은 API 집합을 구성할 수 있음을 보여 줍니다.
분석 범위: v1의 본문 1–5절, Figure 1–2, Table 1–2, 부록 A.1–A.4를 확인했습니다. 표의 성공 과제 전용 열과 완료 토큰·일부 호출 수는 모두 재수록하지 않았으며, 핵심 비교는 전체 과제 평균으로 한정했습니다. 참고문헌에 실린 개별 선행 논문 전체를 별도로 검증하지 않았고, 구현이나 실험을 실행하지 않았습니다.