논문 개요와 전체 구조
프롬프트를 개선할 때는 보통 후보 지시문을 만들고, 에이전트를 다시 실행하고, 검증 점수가 좋아진 후보를 남깁니다. Coding-Agent Skill Distillation(CASD)은 이미 수집한 실행 기록을 코딩 에이전트에게 분석하게 한 뒤, 행동 규칙을 담은 Markdown 스킬 파일을 한 번 작성하는 방식입니다. 여기서 증류는 모델 가중치 학습이 아니라 실행 경험을 재사용 가능한 지시문으로 압축하는 과정을 뜻합니다. 코딩 에이전트는 기록 전체의 통계를 코드로 집계하고, 그 결과가 가리키는 사례를 자세히 읽습니다. 원문 초록·1절
이 논문의 핵심 질문은 “프롬프트 후보를 얼마나 많이 탐색하는가”와 함께 “한 번의 분석에서 얼마나 넓은 경험을 근거로 삼는가”를 비교해야 한다는 것입니다. 저자들은 후자를 reflection scope, 즉 성찰의 범위라고 부릅니다. 동일한 과제 풀을 제공한 네 벤치마크에서 CASD는 GEPA보다 세 곳, SkillOpt보다 네 곳에서 높은 평균 점수를 보였습니다. 다만 추가 검증 자료를 허용한 비교, 표준편차의 정의, 비용 집계 범위는 서로 다르므로 하나의 숫자로 합쳐 읽으면 안 됩니다. 이 리뷰는 2609.26261v1의 HTML과 9쪽 PDF를 기준으로 작성했습니다.
원문의 구조는 다음과 같습니다. 부록은 없으며, 8절 다음에 참고문헌이 이어집니다.
| 순서 | 원문 절과 소절 |
|---|---|
| 1 | Introduction |
| 2 | Related Work |
| 3 | Method: Coding-Agent Skill Distillation → 3.1 Problem Setup → 3.2 The Distillation Pass → 3.3 Inside the distillation process |
| 4 | Prompt Optimization Through Corpus-Scale Reflection → 4.1 A Unified View of Prompt Optimization → 4.2 Bias–Variance Analysis of Prompt Optimization → 4.3 Operating Regimes |
| 5 | Experimental Setup |
| 6 | Results → 6.1 Matched data access: one pass beats the loops → 6.2 Head-to-head: search buys back some ground, at a price → 6.3 Cost → 6.4 Why does corpus-scope reflection win? → 6.5 Ablation: does the skill recover thinking? |
| 7 | Limitations |
| 8 | Conclusion → References |
핵심 기여와 혁신성
에이전트의 시스템 프롬프트는 도구 선택, 정보 확인, 종료 판단에 영향을 줍니다. 후보를 바꿀 때마다 환경과 사용자 시뮬레이터를 다시 실행하는 방식은 반복 평가 비용을 요구합니다. 저자들은 이에 더해, 소수 실행 기록만 보고 수정안을 만들면 전체 자료에서 드러나는 반복 호출이나 특정 과제군의 실패를 놓칠 수 있다고 지적합니다. 1절
CASD의 독창성은 기성 코딩 에이전트가 집계 코드를 작성하는 능력 자체를 프롬프트 최적화에 사용한다는 점입니다. 모든 기록을 긴 문맥에 넣어 요약하는 대신, 정확한 건수와 비율을 계산한 뒤 문제가 집중된 기록을 읽습니다. 분석 절차나 중간 표현을 고정하지 않으며, 완성된 스킬을 추가 검증 게이트 없이 최종 프롬프트로 사용합니다. 따라서 “한 번의 패스”는 도구를 한 번만 호출한다는 뜻이 아니라, 후보 프롬프트를 환경에서 반복 시험하는 외부 최적화 루프가 없다는 뜻입니다. 3절
리뷰어 관점에서 이 기여는 프롬프트 최적화를 로그 분석 문제로 연결한다는 데 있습니다. 이미 보유한 실행 이력이 있다면 실패 유형과 도구 사용 습관을 분석하는 작업이 직접적인 행동 지침으로 이어집니다. 저자들은 이를 저예산 최적화에 적합한 방식으로 해석하며, 충분한 상호작용 예산이 있을 때의 탐색까지 불필요하다고 주장하지는 않습니다. 4.3절
기술적 세부사항
롤아웃(rollout)은 에이전트가 과제를 한 번 수행한 전체 실행 기록입니다. 이 논문의 코퍼스(corpus)는 메시지, 도구 호출과 반환값, 보상, 실행 메타데이터를 포함한 롤아웃의 집합입니다. 대상 에이전트의 모델 가중치는 고정하고 시스템 프롬프트만 바꿉니다. 입력은 초기 프롬프트와 정적인 기록 모음이며, 출력은 이후 과제에 공통으로 적용할 행동 규칙입니다. 대상 모델과 프롬프트를 개선하는 분석용 모델은 별개입니다.
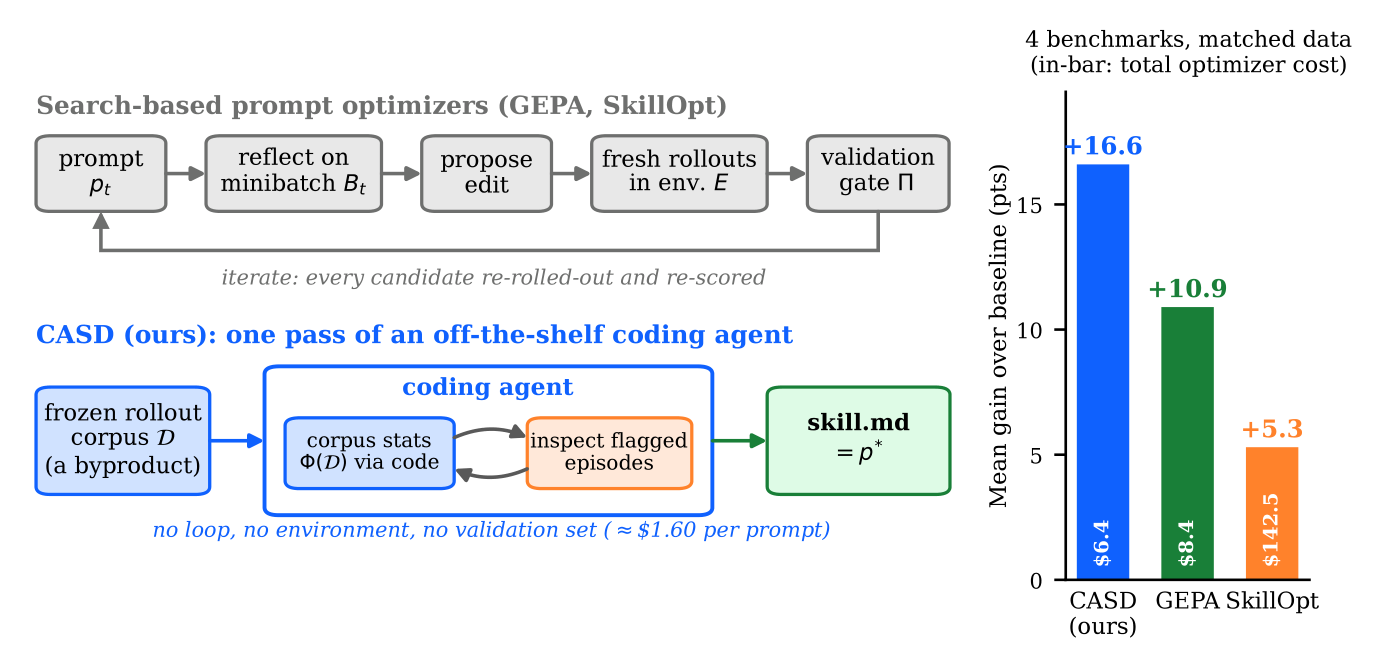
Figure 1, PDF 2쪽. 2609.26261v1 원문 PDF의 그림 영역을 크롭했으며 번역이나 수치 변경은 하지 않았습니다. 오른쪽 정확도 개선은 limited-data 결과이고, 막대 안 비용은 일부 head-to-head 실행을 포함하는 Table 3의 합계입니다.
그림에서 CASD 안의 왕복 화살표는 통계 계산과 사례 확인이 여러 번 이어짐을 보여줍니다. 단일 분석 세션 안의 반복과 후보 프롬프트를 재평가하는 탐색 루프를 구별해야 합니다. 오른쪽의 +16.6은 네 과제 점수의 평균 개선량으로, 상대 개선율 16.6%가 아니라 16.6퍼센트포인트입니다. 아래 챕터 리뷰에서는 원문의 수식, 실제 도구 사용 분석, 평가 설계를 순서대로 살펴봅니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
도입부는 에이전트의 프롬프트 민감성에서 출발하여 기존 최적화의 공통 구조를 설명합니다. 후보 수정안을 만든 다음 새로운 롤아웃으로 평가하고, 검증 목적함수가 개선된 경우에만 채택하는 방식입니다. GEPA는 여기에 자연어 성찰을 넣지만, 반복 실행과 후보 선택이라는 기본 구조는 유지합니다.
저자들은 두 문제를 차례로 제시합니다. 첫째는 매 후보마다 환경, 사용자 시뮬레이터, 평가 지표가 필요하여 비용이 누적된다는 점입니다. 둘째는 개별 수정이 작은 기록 표본에 의존해 전체적인 행동 패턴을 보기 어렵다는 점입니다. 도구 호출 284회 중 123회가 정확히 중복되었다는 사실이나, 한 과제 범주가 24회 모두 실패했다는 사실은 전체를 세어야 확인할 수 있다는 예를 듭니다. 이는 CASD가 모든 과제에서 이런 패턴을 발견한다는 보장이 아니라, 전체 자료 집계가 제공하는 정보의 종류를 설명합니다.
해결책은 실행 기록 디렉터리와 짧은 자연어 지시를 기성 코딩 에이전트에게 제공하는 것입니다. 에이전트는 범주별 성공률, 도구 호출 히스토그램, 중복 횟수, 근거 없는 인자 생성 빈도를 계산하고 사례를 읽어 규칙을 만듭니다. 저자들이 강조하는 세 기여는 성찰 범위라는 설계 축, 반복 검증 없는 CASD 절차, 네 벤치마크에서의 성능·비용 평가입니다. 이 절은 다음 관련 연구에서 CASD를 탐색 및 경험 기반 학습과 비교할 기준을 마련합니다. 1절
📖 Chapter 2: Related Work
Prompt optimization as search. 먼저 자동 프롬프트 최적화의 흐름을 정리합니다. 토큰 탐색에서 시작하여 APE·OPRO의 지시문 후보 생성, ProTeGi의 자연어 수정 신호, TextGrad·Trace의 복합 시스템 업데이트, DSPy/MIPRO의 지시문·예시 공동 최적화로 이어집니다. 이후 Promptbreeder·EvoPrompt의 진화적 변형, PromptAgent의 트리 탐색, GEPA의 성찰과 Pareto 기반 후보 선택을 설명합니다. Pareto 선택은 여러 평가 항목에서 어느 후보가 다른 후보에 일방적으로 뒤지는지를 고려하는 접근입니다. 저자들은 이 계열의 공통점을 후보 실행과 점수화에 둡니다.
Learning from experience without weight updates. 다음에는 모델 가중치를 바꾸지 않고 경험을 활용하는 연구를 다룹니다. Reflexion·Self-Refine은 개별 실행의 피드백을 다음 시도에 쓰고, Voyager·ExpeL·Agent Workflow Memory는 여러 실행의 스킬이나 워크플로를 축적합니다. Dynamic Cheatsheet·ReasoningBank·ACE처럼 테스트 시점에 문맥을 갱신하는 방법도 소개합니다. CASD의 차이는 저장된 경험을 소화하는 방식입니다. 언어 모델의 문맥 창에 모든 계산을 맡기지 않고, 인터프리터가 전체 집계를 수행하며 모델은 집계 결과에 따라 읽을 사례를 선택합니다.
Coding agents. 이어 파일 탐색, 코드 실행, 편집을 결합한 코딩 에이전트를 범용 분석가로 재사용한다고 설명합니다. CASD에서 수정 대상은 소프트웨어 프로그램 대신 프롬프트이며, 참고하는 시험 자료는 고정된 실행 이력입니다. 별도 에이전트 구조를 학습하는 연구가 아니라 이미 존재하는 능력의 용도를 바꾸는 연구입니다.
Offline improvement and conservatism. 마지막은 오프라인 강화학습과의 유추입니다. 고정된 자료만으로 정책을 개선할 때 데이터가 지지하지 않는 행동을 과대평가하는 문제가 있으며, 보수적인 업데이트나 한 번의 개선을 사용하는 연구가 있습니다. 저자들은 CASD를 고정 코퍼스에 근거한 한 번의 텍스트 정책 개선으로 연결합니다. 이 유추가 CASD에 강화학습의 이론적 보장을 부여하는 것은 아닙니다. 관련 연구의 핵심 역할은 CASD가 무엇을 새로 학습하는지보다 어떤 피드백 표현을 사용하는지 구별하는 데 있으며, 다음 절에서 그 입력과 출력을 정의합니다. 2절
📖 Chapter 3: Method: Coding-Agent Skill Distillation
3.1 Problem Setup
대상 에이전트는 고정 가중치 $\theta$와 프롬프트 $p$로 정해지는 $\pi_{\theta}(p)$입니다. 초기 프롬프트 $p_0$로 수집한 $N$개 실행 기록을 다음처럼 표시합니다.
$\tau_i$는 한 과제의 전체 궤적, $\mathcal{D}$는 고정된 기록 집합, $p^{\star}$는 개선된 프롬프트입니다. 이 정의의 제약은 프롬프트를 만드는 동안 추가 궤적을 수집하거나 환경과 상호작용하지 않는다는 것입니다. 원래 코퍼스를 만드는 실행과 개선된 프롬프트의 사후 테스트까지 없다는 뜻은 아닙니다. 3.1절
3.2 The Distillation Pass
코딩 에이전트에게 주어지는 지시는 실행 결과 파일을 직접 분석하고, 향후 에이전트가 더 정확하고 토큰·단계를 효율적으로 사용하도록 행동 규칙을 Markdown 파일로 작성하라는 내용입니다. 저자들은 분석 파이프라인, 최적화 절차, 평가 지표, 중간 표현을 미리 지정하지 않습니다. 방법 선택을 에이전트에게 맡기고, 스킬 파일을 쓰면 절차를 끝냅니다. 그 산출물을 곧바로 최종 프롬프트로 사용하므로 후보 채택을 위한 별도의 검증 점수는 계산하지 않습니다. 3.2절
3.3 Inside the distillation process
이 소절은 실제로 무엇이 일어났는지 도구 추적을 분석합니다. 저자들은 24회 증류 실행의 총 816개 도구 호출을 직접 분류했습니다. 코퍼스 구조 탐색 94회, 전체 통계 계산 184회, 개별 실행 확인 510회, 최종 스킬 작성 28회입니다. 한 번의 실행은 16–51개 호출, 평균 34.0개 호출을 사용했고, 스킬 파일은 5–8KB였습니다. Figure 2·3.3절
첫 번째 관찰은 탐색이 앞에, 작성이 끝에 집중된다는 것입니다. 구조 탐색의 첫 발생 위치 중앙값은 실행 시작을 뜻하는 0.0이며, 작성 위치 중앙값은 종료를 뜻하는 1.0입니다. 이는 탐색·분석·산출물 작성이라는 흐름이 강제된 절차 없이 나타났음을 보여줍니다.
두 번째 관찰은 통계가 자세히 읽을 사례를 고른다는 것입니다. 낮은 범주별 성공률, 긴 궤적, 반복 도구 호출, 조기 종료를 찾고 해당 사례를 읽습니다. 통계 계산과 개별 기록 확인 사이 전환의 중앙값은 5회이고 최대 16회입니다. 모든 실행에서 보상·성공률과 에피소드 길이를 계산했으며, 96%는 종료·실패 유형, 92%는 도구 사용, 79%는 과제 범주별 성능을 분석했습니다. 중복 호출을 명시적으로 찾은 실행은 약 3분의 1입니다. 이 수치는 에이전트가 선택한 분석 행동의 빈도이며 최종 과제 성공률과는 다른 지표입니다.
세 번째 관찰은 규칙에 계량 근거가 남는다는 것입니다. 12개 CASD 스킬에는 분수·백분율·측정 건수 형태의 근거 54개가 있었고, 1,000단어당 4.6개였습니다. 비교 대상 GEPA 프롬프트 4개에는 없고 SkillOpt 프롬프트 4개에는 1개였습니다. “50개 중 16개에서 신원 조회 인자를 만들어냈다”, “284회 중 123회가 중복 조회였다”와 같은 관찰이 행동 교정 규칙으로 이어집니다. 도구 추적 24회와 산출물 비교 12개는 서로 다른 집계 대상이므로 혼동하지 않아야 합니다. 이 절의 기여는 CASD를 막연한 자동 요약이 아니라 통계와 사례 확인을 결합한 분석 과정으로 구체화한 것이며, 다음 절은 이 피드백 구조를 수식으로 비교합니다.
📖 Chapter 4: Prompt Optimization Through Corpus-Scale Reflection
4.1 A Unified View of Prompt Optimization
저자들은 방법들의 목적은 같고, 개선을 추론하는 근거가 다르다고 정리합니다. 목적은 과제 분포에서 기대 보상을 높이는 것입니다.
$x$는 과제, $P_X$는 과제 분포, $R$은 대상 에이전트가 받은 보상입니다. 이 기대값은 한 번의 테스트 점수와 구별되는 목표량입니다. 원문의 식 (1)은 업데이트를 다음처럼 공통 표현합니다.
$\rho$는 실행 피드백 $\phi_t$를 바탕으로 수정안을 제안하고, $\oplus$는 이를 프롬프트에 적용하며, $\Pi$는 수정된 프롬프트의 수락 여부를 결정합니다. 탐색 방법은 이 과정을 반복하지만 CASD는 분석 후 직접 결과를 사용합니다. 4.1절·식 (1)
탐색 방법의 피드백은 식 (2)처럼 표본 실행과 검증 점수를 결합합니다.
$B_t$는 해당 단계의 과제 묶음, $\tau$와 $r$은 궤적과 보상, $D_{\mathrm{val}}$은 검증 집합입니다. 표본 평균 $\widehat r_{\mathrm{val}}$로 후보의 성능을 추정합니다. 반면 CASD의 식 (3)은 다음과 같습니다.
$\Phi(\mathcal{D})$는 전체 코퍼스의 집계 통계이며, $\mathcal{I}(\Phi)$는 통계가 가리킨 대표 궤적의 인덱스 집합입니다. 실제 적용에서는 도구별 호출 수나 실패 유형 빈도를 계산한 뒤, 해당 통계와 관련된 실행을 골라 읽는 구조입니다. 숫자만 사용하는 것도, 모든 사례를 순서대로 읽는 것도 아닙니다. 식 (2)·(3)
4.2 Bias–Variance Analysis of Prompt Optimization
검증 보상의 표본 평균은 표본 수에 따른 분산을 갖습니다. 원문은 에피소드 보상 분산을 $\sigma^2$라 놓고 다음 관계를 사용합니다.
검증 에피소드가 늘면 추정 변동이 줄지만 추가 실행 비용이 듭니다. CASD의 통계는 이미 관측한 $\mathcal{D}$가 고정되면 결정적인 함수이므로, 같은 코퍼스에서 작은 묶음을 계속 뽑아 생기는 표본 변동을 제거합니다. 다만 이것은 코퍼스가 모집단을 완벽하게 대표한다거나, 스킬 생성의 확률적 변동까지 사라진다는 뜻은 아닙니다. 저자들은 중요한 행동이 코퍼스에 없을 때 편향이 생긴다고 설명합니다. 고정 자료 안에서 정확한 집계와 미래 과제에 대한 정확한 예측을 구분하는 것이 이 분석의 핵심입니다. 4.2절
4.3 Operating Regimes
적은 실행 예산에서는 표본 변동을 줄이는 이점이 클 수 있어, 한 번의 코퍼스 분석이 비용과 성능 모두에 유리할 수 있습니다. 반대로 새 자료와 환경 접근이 충분해지면 탐색의 추정 분산은 감소하지만 고정 코퍼스가 갖는 편향은 그대로 남습니다. 저자들은 이때 탐색의 상대적 매력이 커질 것으로 예상합니다. 이는 예산에 따른 작동 영역을 설명하는 논의이지, 모든 예산에서 CASD가 우세함을 증명한 정리는 아닙니다. 이 절은 두 평가 조건을 구분할 이유를 제공하고, 다음 실험 설계로 이어집니다. 4.3절
📖 Chapter 5: Experimental Setup
Benchmarks. 원문은 먼저 네 평가 환경을 정의합니다. ALFWorld는 ReAct 방식의 추론·행동 틀에서 가사 과제를 수행하며 보류된 50개 게임의 승률을 측정합니다. τ²-bench retail·telecom은 언어 모델 사용자 시뮬레이터와 도구를 사용해 고객 서비스를 수행하며, 각 40개 보류 과제의 pass@1, 즉 한 번의 시도에서 통과한 비율을 측정합니다. SpreadsheetBench-Verified(SSB)는 스프레드시트 조작 과제 50개에서 modified accuracy를 사용합니다. 원문은 이 수정 정확도의 상세 채점 규칙을 이 절에서 추가 정의하지 않습니다.
Models. 대상 에이전트와 해당되는 사용자 시뮬레이터는 모두 reasoning을 끈 GPT-5.4-mini이며, 모든 방법의 최적화·성찰 모델은 Claude Sonnet 5입니다. CASD의 코딩 에이전트는 한계 절에서 Claude Code로 명시됩니다. 따라서 본문에서 비교하는 성능은 여러 대상 모델을 평균한 결과가 아닙니다.
Methods. Baseline은 스킬이 없는 설정입니다. CASD는 벤치마크마다 독립적으로 스킬 3개를 만들고 각각 평가한 평균을 보고합니다. GEPA는 진화적 성찰 최적화, SkillOpt는 검증 선택 게이트를 둔 성찰 탐색입니다. 저자들은 테스트 결과를 3회 평균과 표본 표준편차로 제시하지만, CASD의 변동은 스킬 간 차이, 다른 방법의 변동은 하나의 프롬프트에 대한 시드 간 차이라는 구별이 있습니다. 표본 표준편차는 분모에 $n-1$을 사용하는 값이며, 표의 ±를 신뢰구간으로 읽으면 안 됩니다.
Data regimes. limited-data 조건은 retail 35개, telecom 50개, SSB 50개 과제, ALFWorld 50개 게임이라는 같은 고정 풀을 각 최적화 방법에 제공합니다. GEPA는 Pareto 집합을 학습 풀과 같게 두며 SkillOpt는 풀 안에서 학습·검증을 나눕니다. head-to-head 조건에서는 GEPA·SkillOpt에 별도 검증 집합을 추가 제공합니다. CASD는 이 자료를 사용하지 않습니다. 원문의 “같은 자료 접근”은 과제 풀과 외부 검증 자료에 관한 비교입니다. 5절은 탐색법의 후보 롤아웃 환경 접근을 계속 허용한다고 설명하므로, 모든 방법의 환경 호출까지 동일하게 금지한 실험으로 해석하지 않습니다.
Optimizer settings and hyperparameters. GEPA의 예산은 metric call 120회이며, telecom을 240회까지 재개해도 프롬프트 바이트가 같아 120회 결과를 사용합니다. SkillOpt는 3–5 epoch, 학습 분할 크기에 따른 미니배치 8–40개, 단계별 편집 예산 4개에서 코사인 방식으로 2개까지 감소하는 설정입니다. limited-data 내부 분할은 retail 25/10, 나머지 35/15입니다. 이런 설정을 함께 보아야 “한 번의 분석”과 “여러 후보의 탐색”이 어떤 계산량을 비교하는지 이해할 수 있습니다. 다음 절은 이 조건에서의 성능, 비용, 행동 사례를 순서대로 설명합니다. 5절
📖 Chapter 6: Results
6.1 Matched data access: one pass beats the loops
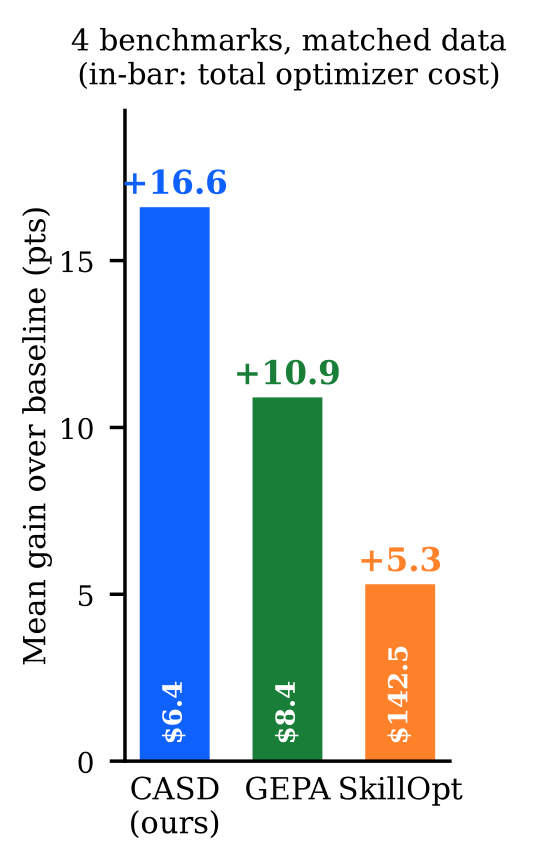
Figure 1 오른쪽 패널 상세, PDF 2쪽. 2609.26261v1 원문 PDF에서 축·범례를 포함해 크롭했습니다. 막대 높이는 limited-data 평균 개선량이며, 막대 안 달러 금액은 일부 head-to-head 실행을 포함하는 Table 3 합계입니다. 원본 전체 그림은 앞의 기술적 세부사항에 유지했습니다.
아래는 원문 Table 1의 평균과 표준편차를 옮긴 것입니다. 수치는 모두 %이며 CASD와 다른 방법의 표준편차가 가리키는 변동원은 앞 절처럼 다릅니다.
| 벤치마크 | Baseline | CASD | SkillOpt | GEPA |
|---|---|---|---|---|
| ALFWorld | 56.7 ± 1.2 | 83.3 ± 2.3 | 68.0 ± 2.0† | 74.0 ± 2.0 |
| τ² retail | 32.5 ± 2.5 | 40.0 ± 2.5 | 38.3 ± 10.1 | 39.2 ± 7.2 |
| τ² telecom | 19.2 ± 5.2 | 39.2 ± 8.0 | 25.8 ± 3.8 | 17.5 ± 4.3 |
| SSB-Verified | 39.3 ± 3.1 | 51.3 ± 3.1 | 38.7 ± 2.3 | 60.7 ± 3.1 |
| 원문 보고 평균 개선량 | — | +16.6 | +5.3 | +10.9 |
† ALFWorld SkillOpt는 자체 실행 틀을 사용하며 자체 Baseline이 58.7%이므로 같은 행의 56.7%와 직접 같은 조건으로 비교할 수 없습니다. Table 1
CASD는 ALFWorld·retail·telecom에서 가장 높고 SSB에서는 GEPA가 높습니다. Baseline 대비 CASD의 개선은 각각 26.6, 7.5, 20.0, 12.0퍼센트포인트입니다. retail에서 GEPA와의 차이는 0.8포인트에 불과하지만 telecom에서는 21.7포인트입니다. 따라서 “3승”이라는 개수뿐 아니라 어떤 과제가 평균 향상을 만들었는지 보아야 합니다.
저자들은 telecom에서 GEPA가 19.2% Baseline보다 낮은 17.5%가 된 것을 같은 풀에서 성찰과 선택을 수행한 과적합으로 해석합니다. 이에 비해 CASD는 동일한 자료로부터 전체 실패 패턴을 집계했다고 설명합니다. 이는 저자의 결과 해석이며, 그 자체가 성찰 범위만의 인과 효과를 완전히 분리한 검정은 아닙니다. 6.1절
6.2 Head-to-head: search buys back some ground, at a price
추가 검증 집합을 제공하면 GEPA의 retail 점수는 46.7 ± 8.0, SkillOpt의 telecom은 44.2 ± 5.2가 됩니다. CASD는 각각 40.0 ± 2.5와 39.2 ± 8.0으로 그대로입니다. SSB에서는 GEPA 56.7 ± 1.2, CASD 51.3 ± 3.1, SkillOpt 48.0 ± 2.0입니다. ALFWorld 행은 새 head-to-head 실험이 아니라 limited-data 실행을 재사용한 값입니다. Table 2
원문 서술과 표를 구별할 부분이 있습니다. 초록과 도입부는 추가 자료를 제공한 비교에서도 CASD가 네 벤치마크 중 두 곳에서 앞선다고 기술합니다. 그러나 Table 2에서 각 행의 최고 평균을 직접 비교하면 CASD가 단독으로 가장 높은 곳은 ALFWorld 한 곳입니다. telecom에서는 SkillOpt가 더 높으며, 6.2절 본문은 CASD가 표준편차를 고려할 때 최고 셀의 잡음 범위 안에 있다고 표현합니다. 이 리뷰에서는 이를 두 번째 승리로 바꾸어 세지 않고 표의 값을 그대로 해석합니다. GEPA의 telecom은 추가 검증 후에도 15.8 ± 5.2로 낮습니다. 탐색이 어느 영역에서 유효한지는 데이터와 과제에 따라 달랐다는 결과입니다. 초록·6.2절
6.3 Cost
Table 3은 토큰 캐싱을 켠 상태에서 각 프롬프트를 만드는 최적화 비용을 달러로 보고합니다.
| 방법 | ALFWorld | Retail | Telecom | SSB | 원문 합계 |
|---|---|---|---|---|---|
| CASD | 1.6 | 1.6 | 1.56 | 1.6 | 6.4 |
| GEPA | 2.1 | 1.1 | 4.5 | 0.74 | 8.4 |
| SkillOpt | 15.9 | 13.9 | 74.7 | 38.0 | 142.5 |
GEPA·SkillOpt의 telecom과 SkillOpt의 SSB 비용은 head-to-head 실행에서 가져온 값입니다. 소수점 반올림된 셀과 합계도 원문 그대로 유지했습니다. 약 22배의 비용 차이는 SkillOpt 합계 142.5달러와 CASD 합계 6.4달러의 비교입니다. GEPA 대비 22배가 아니며, 개별 retail·SSB에서는 GEPA 비용이 CASD보다 낮습니다. Table 3
CASD의 약 1.60달러는 이미 생성된 코퍼스를 분석하는 세션의 비용입니다. 저자들은 코퍼스가 기존 롤아웃의 부산물이므로 이 단계에는 롤아웃 청구액이 없다고 설명합니다. 처음부터 자료를 수집하고 최종 테스트하는 전체 비용이 1.60달러라는 뜻은 아닙니다. 또한 개선된 프롬프트는 배포 비용에도 영향을 줍니다. telecom의 3시드 평가에서 SkillOpt 프롬프트는 입력 프롬프트 토큰 20.1M, GEPA는 11.9M을 유도했습니다. 이 수치는 최적화 비용 표와 구별되는 테스트 시점 입력량입니다. 6.3절
6.4 Why does corpus-scope reflection win?
저자들은 설명 근거를 세 가지로 제시합니다. 첫째, telecom의 50개 에피소드 중 16개에서 근거 없는 신원 조회 인자가 나타난다는 계량적 패턴입니다. 둘째, get_details_by_id의 284회 호출 중 123회가 중복이라는 효율성 문제입니다. 셋째, 작은 검증 풀에서 채택 결정을 반복하는 게이트가 없다는 점입니다. 저자들은 GEPA telecom의 성능 하락과 SkillOpt retail의 표준편차 10.1을 게이트의 과적합·변동 문제와 연결합니다. CASD는 네 과제 중 세 곳에서 스킬 간 표준편차가 3.1 이하였습니다. 6.4절
Figure 4는 telecom의 단일 테스트 사례로 이를 구체화합니다. “서비스 없음” 문제를 해결하려면 기기 쪽 문제와 계정 청구 쪽 문제를 모두 해결해야 보상을 받습니다. 기기 문제는 개별 궤적에도 드러나 세 방법 모두 규칙에 반영했습니다. 반면 기록 풀 전체에 make_payment 호출이 한 번도 없다는 사실은 전체 집계에서 확인됩니다. CASD만 청구 문제 해결 규칙을 작성했고 해당 사례를 성공했습니다. 이는 일어난 행동의 빈도뿐 아니라 필요한 호출의 부재도 분석 단서가 된다는 예입니다. 다만 필요한 도구와 업무 맥락 안에서 누락을 식별한 사례이며, 데이터에 없는 모든 행동을 발견할 수 있다는 일반 보장으로 확장하지 않습니다. 뒤의 한계 절은 기록에 없는 행동을 학습하는 제약을 별도로 명시합니다. Figure 4
6.5 Ablation: does the skill recover thinking?
마지막 실험은 대상 모델에서 reasoning을 켠 think 모드와, reasoning을 끈 채 CASD 스킬을 넣은 모드를 비교합니다. 목적은 에피소드마다 다시 추론하던 행동 방침을 고정 규칙으로 옮길 수 있는지 살펴보는 것입니다.
| 벤치마크 | no-think | no-think + CASD | think | 원문 보고 회복 비율 | 에피소드당 출력 토큰 think → CASD |
|---|---|---|---|---|---|
| ALFWorld | 56.7 | 83.3 | 71.3 ± 1.2 | 100% 초과 | 3.7k → 0.8k |
| τ² retail | 32.5 | 40.0 | 35.0 ± 6.6 | 100% 초과 | 1.6k → 0.6k |
| τ² telecom | 19.2 | 39.2 | 45.0 ± 2.5 | 78% | 2.1k → 0.6k |
| SSB-Verified | 39.3 | 51.3 | 61.3 ± 1.2 | 55% | 3.3k → 0.8k |
회복 비율은 no-think에서 think로 증가한 정확도 차이 중 CASD가 회복한 몫입니다. 예를 들어 telecom의 표 수치를 사용하면 (39.2−19.2)/(45.0−19.2)가 약 78%입니다. 이것은 추론 능력 전체의 78%를 얻었다는 뜻이 아닙니다. Table 4
저자들은 ALFWorld·retail에서 CASD가 think 평균을 넘으며, telecom·SSB에서는 각각 격차의 78%·55%를 회복했다고 보고합니다. 하지만 각주에 따르면 think 정확도와 에피소드당 토큰 수는 이전 연구 실행에서 왔고, SSB think는 실행 하네스도 달라 참고 성격입니다. 따라서 모든 셀을 이번 실험의 동일 조건 재실행으로 표현하지 않습니다. 저자들의 해석은 진단 순서, 부당한 조회 인자 방지, 중도 포기 방지 같은 재사용 가능한 정책이 매번의 추론 일부를 대신한다는 것입니다.
이어서 이전 실행에서 think·no-think 코퍼스로 각각 스킬을 만들었던 비교를 제시합니다. 원문 순서대로 ALFWorld 81.3 대 78.7, retail 45.8 대 40.8, telecom 32.5 대 33.3, SSB 46.0 대 56.0이며 일관된 승자는 없습니다. 이 숫자는 Table 1의 현재 실행과 섞지 않아야 합니다. 저자들은 실패가 충분한 no-think 기록만으로도 신호를 얻을 수 있으며, 비싼 추론 기록이 필수는 아니라고 해석합니다. telecom·SSB의 남은 격차가 재사용 정책보다 개별 사례에 특화된 추론과 관련될 수 있다는 설명과, 그 격차를 줄이는 향후 과제도 이 소절에서 직접 제시합니다. 다음 절은 이런 결과를 일반화할 때의 명시적 제약을 정리합니다. 6.5절
📖 Chapter 7: Limitations
저자들이 명시한 한계는 세 가지입니다. 첫째, CASD는 독립적으로 증류한 스킬 3개를 각각 한 번 평가하므로 표준편차가 스킬 간 변동을 나타내지만, 베이스라인들은 하나의 프롬프트를 여러 시드로 평가한 변동입니다. 두 양은 유사해도 같지 않습니다. 둘째, 대상 모델은 GPT-5.4-mini no-think 하나이고 증류기는 Claude Sonnet 5/Claude Code 하나이므로, 증류기 역량에 따른 민감도는 시험하지 않았습니다. 셋째, CASD는 코퍼스를 그대로 물려받습니다. 기록에 없는 행동을 발견할 수 없으며, 너무 작거나 실패가 없는 코퍼스에는 증류할 내용이 충분하지 않을 수 있습니다. 7절
마지막 제약은 앞의 make_payment 사례와 함께 좁게 읽을 필요가 있습니다. 알려진 업무 맥락에서 어떤 호출이 전혀 없었다고 집계하는 것과, 관측 자료가 제공하지 않는 행동을 일반적으로 알아내는 것은 같은 주장으로 취급할 수 없습니다. 이 리뷰에서는 Figure 4의 성공 사례와 7절의 저자 한계를 모두 유지합니다. 이 절은 결과를 과도하게 일반화하지 않도록 경계를 정하고 마지막 결론으로 이어집니다.
📖 Chapter 8: Conclusion
결론은 기성 코딩 에이전트가 고정 롤아웃 디렉터리와 짧은 지시만으로 강한 프롬프트 최적화기가 될 수 있다는 주장으로 돌아옵니다. 핵심 차이는 모델 가중치 변경이나 더 복잡한 탐색 구조가 아니라, 전체 기록에 분석 코드를 실행하는 성찰 범위입니다. 제한된 자료 조건에서 GEPA보다 네 곳 중 세 곳의 평균 점수가 높았고, 프롬프트당 약 1.60달러의 오프라인 분석 비용을 보고합니다. 8절
저자들은 코딩 에이전트의 역량이 좋아지면 코퍼스 전체 성찰이 프롬프트 최적화의 첫 단계가 되고, 추가 상호작용이 저렴할 때 마지막 개선을 탐색에 맡기는 방식이 가능하다고 전망합니다. 이는 미래 사용 방식에 관한 저자의 전망입니다. 이후 References는 앞선 탐색, 에이전트 메모리, 코딩 에이전트, 오프라인 학습, 평가 변동 논의의 출처를 제공합니다. 이 리뷰는 해당 참고문헌들을 모두 별도로 분석한 결과가 아니라, 지정 논문이 그 연구를 배치한 논리를 설명한 것입니다.
실험 결과 심층 분석
이 결과에서 가장 분명한 관찰은 제한된 과제 풀에서 반복 탐색이 항상 더 높은 평균 성능을 주지는 않았다는 점입니다. ALFWorld의 CASD–GEPA 차이는 9.3포인트, telecom은 21.7포인트였지만, retail은 0.8포인트이며 SSB는 GEPA가 9.4포인트 높았습니다. 과제별 지표와 표본 수가 다르므로 평균 +16.6은 네 벤치마크의 비가중 개선량 요약으로 읽어야 합니다. 모든 테스트 항목을 합친 하나의 정확도는 아닙니다. Table 1
통계적 해석에서는 원문이 보고한 것과 보고하지 않은 것을 구별해야 합니다. 저자들은 표본 크기상 시드 하나의 이항 표준오차만으로도 약 7포인트가 될 수 있다고 설명하고, 3회 평가의 표본 표준편차를 제공합니다. 별도의 유의성 검정이나 신뢰구간은 논문에 보고되지 않았습니다. 특히 CASD와 베이스라인의 표준편차가 서로 다른 변동원을 측정하므로, 오차 막대의 겹침만으로 승패의 통계적 유의성을 확정할 수 없습니다. 이는 원문에 제시된 통계 보고 범위를 설명하는 것이며 새로운 실패 원인을 추정하는 것은 아닙니다. 5·7절
비용의 실용적 의미는 기존 로그를 가진 상황에서 큽니다. CASD는 새 후보의 환경 평가 없이 프롬프트를 생산하지만, Table 3은 일부 추가 검증 실험 비용을 포함합니다. 따라서 이를 완전히 같은 실행 예산을 통제한 비용 곡선으로 볼 수는 없습니다. 또한 프롬프트 작성 비용과 프롬프트 적용 후의 입력·출력 토큰 비용은 서로 다른 항목입니다. 이 구별을 유지하면 “전체 코퍼스 분석을 저렴한 초기 개선 단계로 사용한다”는 저자의 메시지를 정확하게 이해할 수 있습니다. Table 3·6.3절
기술적 함의와 응용
저자들이 제시하는 기술적 함의는 에이전트의 경험을 읽는 단위를 개별 사례에서 코퍼스 전체로 넓히는 것입니다. 언어 모델이 직접 큰 자료의 빈도를 짐작하게 하는 대신, 코드는 집계를 담당하고 모델은 맥락과 행동 규칙을 해석합니다. 이 결합이 작은 예산에서 프롬프트 개선을 시작하는 방법이 될 수 있다는 주장입니다. 충분한 환경 상호작용이 가능한 경우 탐색의 장점이 커질 수 있다는 4절의 논의도 함께 유지해야 합니다.
리뷰어의 응용 해석으로는, 고객 지원이나 반복적인 도구 업무의 실행 로그가 이미 있는 경우 과제군별 실패율, 불필요한 반복 조회, 근거 없는 인자 생성 같은 관찰을 공통 지침으로 바꾸는 절차를 생각할 수 있습니다. 근거는 이 논문이 실제로 분석한 통계와 행동 사례이며, 새로운 산업 환경에서의 성능을 실증했다는 뜻은 아닙니다. 핵심은 집계 통계가 규칙의 근거가 되고, 대표 궤적을 읽는 단계가 그 규칙의 맥락을 보완한다는 연결입니다.
CASD는 모델의 모든 추론을 제거하는 결과가 아니라, 경험에 반복해서 나타나는 행동 방침 일부를 오프라인 규칙으로 정리한 결과입니다. 성능을 읽을 때에는 코퍼스의 범위, 평가 조건, 스킬 간 변동, 비용의 포함 범위를 함께 보아야 합니다. 그 조건을 지킨다면 이 논문은 프롬프트 최적화를 더 많은 후보 탐색뿐 아니라 더 넓은 근거 분석의 문제로 이해하게 합니다.