논문 개요와 전체 구조
AI Agent에게 SKILL.md를 제공하면 작업 절차를 알려줄 수 있습니다. 그러나 문서를 읽을 수 있다는 사실과 실제로 복잡한 작업을 끝낼 수 있다는 사실은 다릅니다. 파일을 확인하고, 여러 도구를 연결하고, 실패를 수정한 뒤, 결과가 요구사항을 만족하는지 확인하는 능력이 필요합니다. SkillGym은 이처럼 여러 단계에 걸쳐 절차를 수행하는 능력, 즉 procedural competence를 모델 학습으로 얻을 수 있는지 탐구합니다.
논문의 접근은 사람이 작성한 skill을 실행 가능한 연습 문제로 바꾸는 것입니다. 각 문제에는 입력 자료, 실행 환경, 요구사항, 결과를 검사하는 코드가 들어갑니다. 여러 모델이 서로 다른 agent harness에서 문제를 풀게 하고, 검사에 통과한 실행 기록을 지도 미세조정(supervised fine-tuning, SFT)에 사용합니다. 여기서 harness는 모델의 응답을 실제 도구 호출로 연결하고, 실행 결과를 다시 모델에 전달하는 소프트웨어 환경을 뜻합니다. 이 연구에서는 Codex와 Claude Code 기반 구성을 사용합니다.
리뷰 대상은 arXiv 2609.27717v2 원문입니다. 학습 환경은 2,756개이고 성공 실행 기록은 8,364개입니다. Qwen3.5-35B-A3B를 학습한 SkillGym-Agent는 평가한 두 harness에서 기본 모델보다 높은 점수를 기록했습니다. 다만 외부 모델의 공개 점수와는 평가 설정이 다르고, Codex의 기본 모델 대비 비교에는 system prompt 변경도 포함됩니다. 따라서 성능 수치와 그 수치를 해석할 수 있는 범위를 함께 읽어야 합니다.
원문 구조는 다음과 같습니다. 본문과 부록 모두 아래 순서대로 상세히 다룹니다.
| 원문 구분 | 구성과 읽을 내용 |
|---|---|
| 1 Introduction | skill을 학습 경험으로 전환해야 하는 이유와 연구 질문 |
| 2 Related Work | Agent Skills → Agent Environments → Agent Training |
| 3 SkillGym | 3.1 Skill-Aware Template Construction → 3.2 Environment Construction and Validation → 3.3 Multi-Harness Trajectory Sampling |
| 4 Dataset Analysis and Quality Assessment | 4.1 환경 범위와 검증 → 4.2 실행 기록과 skill 사용 → 4.3 기존 데이터셋과 비교 |
| 5 Experiments | 5.1 실험 설정 → 5.2 주요 결과 → 5.3 교사 모델과 harness 분석 |
| 6 Conclusion and Future Work | 결과 정리와 저자가 명시한 강화학습 후속 연구 |
| Appendix A | Dataset Coverage and Category Statistics |
| Appendix B | B.1 길이 분포 → B.2 저장 텍스트 구성 → B.3 상호작용 밀도 → B.4 토큰 분포와 집중도 |
| Appendix C | C.1 템플릿에서 과제로 → C.2 Payment Approval Sync → C.3 네 가지 실행 사례 |
| Appendix D | D.1 평가 설정 → D.2 상세 벤치마크 결과 |
핵심 기여와 혁신성
첫 번째 기여는 skill을 설명 자료에서 학습 환경의 설계 재료로 바꾸는 것입니다. 기존 skill 활용은 주로 추론 중 문서를 찾아 읽고 지시를 따르는 방식입니다. SkillGym은 그 문서에 담긴 의사결정과 제약을 구체적인 과제로 옮깁니다. 좋은 답변 문장을 흉내 내는 대신, 실제 산출물과 실행 상태를 검사할 수 있도록 학습 문제를 구성합니다. 원문 §1–3
두 번째 기여는 환경의 실행 가능성과 skill 의존성을 나누어 평가하는 것입니다. 동작하는 환경이라고 해서 해당 skill을 배우는 데 적합한 것은 아닙니다. 연구진은 기준 agent가 skill을 제공받으면 성공하고 제공받지 못하면 실패하는지 비교합니다. 이 조건을 만족하는 환경에만 Skill-Dep. 라벨을 부여합니다. 다만 이는 해당 agent 설정에서 관측한 의존성이며, 모든 모델에 그 skill이 반드시 필요하다는 증명은 아닙니다.
세 번째 기여는 검증 가능한 환경과 긴 실행 기록을 함께 제공한다는 점입니다. 성공 기록 하나에는 평균 49회 도구 호출과 35.2 interaction steps가 포함됩니다. 이 기록은 최종 답변만이 아니라 입력 조사, 행동, 관찰, 실행 피드백의 연결을 담습니다. 여러 교사 모델과 harness를 사용하여 하나의 agent 구성에 한정되지 않는 경험을 수집합니다.
리뷰어 해석: 데이터과학 관점에서는 학습 데이터의 단위를 질문과 정답에서 검증 가능한 작업 과정으로 확장했다는 의미가 있습니다. 다만 실험이 직접 보여주는 것은 수집한 실행 기록으로 수행한 SFT의 결과입니다. 환경이 outcome reward 기반 강화학습(reinforcement learning, RL)을 지원한다는 설명을 RL 학습 성능을 검증했다는 주장으로 바꾸어 읽어서는 안 됩니다.
기술적 세부사항
입력 skill에서 실행 환경으로
논문의 식 (1)은 환경을 다음과 같이 정의합니다. 함수 이름은 GitHub 수식 표시와 호환되는 동등한 직립체로 표기했습니다.
$K_i$는 skill $s_i$의 설명·예제·스크립트·제약을 정리한 skill card입니다. $c(i)$는 skill의 세부 분류이고, $\mathcal{T}_{c(i)}$는 해당 분류에 맞추어 사람이 작성한 재사용 템플릿입니다. 결과 환경 $E_i$는 과제 지시문 $x_i$, 입력 자산 $A_i$, 실행 명세 $\rho_i$, 결과 검사기 $V_i$로 구성됩니다. 실행 명세에는 파일 구조, 의존성, 접근 인터페이스, 실행 제약이 포함됩니다.
이 구분은 실제 제작 방식과 연결됩니다. skill card가 어떤 절차를 연습할지 정한다면, 템플릿은 그 절차를 실행하고 평가할 과제의 형식을 제공합니다. Docker는 해당 과제를 실행하는 환경의 패키징 수단이고, verifier는 과제별 성공 조건을 코드로 검사합니다. 원문 식 (1), §3.1–3.2
실행 가능성과 skill 의존성의 구분
식 (2)의 $F_i=1$은 설계·구조·종단 간 실행 검사에 통과했고, 동작하는 verifier와 그 검사에 통과하는 해법이 있음을 뜻합니다. $r_i^{+}$는 기준 agent에 skill을 제공했을 때, $r_i^{-}$는 제공하지 않았을 때의 성공 여부입니다. 두 값은 0 또는 1입니다. $\ell_i$는 이 조건으로 결정하는 환경 수준 라벨입니다.
Verifier-Passed는 불량 환경이라는 뜻이 아닙니다. 실행과 결과 검증은 통과했으나 추가적인 대조 조건을 만족하지 못한 fallback 환경입니다. 예를 들어 skill이 없어도 기준 agent가 풀었다면 skill 의존성을 확인한 환경에는 넣지 않지만, 검증 가능한 훈련 과제로는 남깁니다.
실행 기록과 보상
식 (3)에서 $\mathcal{P}$는 수집에 사용하는 harness와 모델 조합의 집합입니다. $\pi_{h,m}$은 harness $h$와 모델 $m$으로 구성한 agent이고, $\tau_i^{h,m}$는 그 agent가 환경에서 남긴 행동·관찰 기록입니다. $z(\tau_i^{h,m})$는 실행 결과물과 최종 실행 상태를 가리킵니다. verifier가 이를 검사하여 개별 실행의 보상 $r_i^{h,m}$를 결정합니다.
여기서 환경 라벨과 실행 보상은 서로 다른 변수입니다. Skill-Dep. 과제라도 다른 모델의 실행은 실패할 수 있습니다. 또한 성공 기록의 문장이 기준 답안과 비슷한지를 평가하는 것이 아니라 산출물과 상태가 요구사항을 만족하는지를 검사합니다. 이 구조에서 성공 기록은 SFT의 시연 데이터가 되고, 환경과 verifier는 향후 RL의 보상원을 제공할 수 있습니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할: 서론은 LLM의 추론 능력이나 개별 도구 사용 능력만으로는 실제 업무의 완수를 충분히 설명할 수 없다는 문제에서 출발합니다. 다음 장의 관련 연구와 이후의 환경 설계가 필요한 이유를 제시합니다.
저자는 먼저 웹 탐색, 데이터 분석, 소프트웨어 엔지니어링에서 agent 활용이 확대되었지만, 실제 과제는 여러 단계를 조정하고 실패에서 회복하며 결과를 검증하는 절차적 능력을 요구한다고 설명합니다. 이때 사람이 작성한 skill은 워크플로 지침, 스크립트, 예제, 실행 제약을 재사용 가능한 형태로 모은 지식입니다. 단순한 도구의 인자 설명을 넘어 어떤 순서와 판단으로 작업해야 하는지가 들어 있습니다.
이어 현재의 skill 사용이 추론 시점의 외부 지식 접근에 의존한다는 점을 짚습니다. 필요한 skill을 잘 검색하고, 문맥에 유지하며, 지시를 충실히 따라야 유용합니다. 같은 skill을 반복해서 읽는 일이 곧 모델 파라미터에 재사용 가능한 능력을 학습시키는 것은 아닙니다. 따라서 연구 질문은 사람이 쓴 절차를 agent가 연습하고 피드백받는 환경으로 바꿀 수 있는지가 됩니다.
이 전환에는 두 문제가 있습니다. 첫째, 일반적인 절차 설명을 구체적 입력과 목표가 있는 문제로 바꾸어야 합니다. 둘째, 그 문제의 성공 여부는 skill 문서와 비슷하게 답했는지가 아니라 과제별 요구사항 충족으로 판정해야 합니다. 저자는 이 두 조건을 실행 가능한 과제 구성과 결과 검증이라는 설계 원칙으로 연결합니다.
마지막으로 환경 2,756개, 성공 기록 8,364개와 기본 모델 대비 성능 향상을 예고합니다. 특히 추론 시 skill을 제공하지 않아도 학습된 모델이 skill을 제공받은 기본 모델보다 높은 SkillsBench 점수를 보였다는 점을 강조합니다. 이는 외부 문서 활용과 별도로 학습에 남은 절차적 역량을 조사하려는 문제의식과 연결됩니다.
핵심 기여와 다음 연결: 서론은 skill을 제공하는 방법이 아니라 skill에서 학습 경험을 만드는 방법을 연구 대상으로 설정합니다. 2장은 기존 skill 라이브러리, 실행 환경, agent 학습과의 차이를 구체화합니다. §1
📖 Chapter 2: Related Work
위치와 역할: 관련 연구는 Agent Skills, Agent Environments, Agent Training의 순서로 연구의 위치를 정합니다.
Agent Skills: 첫 소주제에서는 사람이 작성한 실행 절차와 스크립트, 언어 기반 계획, 실행 가능한 프로그램, 경험을 축적하는 skill 라이브러리 등을 다룹니다. Voyager와 AutoSkill은 skill의 획득·재사용이라는 맥락에서, Reflexion은 파라미터 업데이트 없이 언어 피드백을 기억하여 후속 시도를 개선하는 맥락에서 소개됩니다. SkillGym의 차이는 새로운 skill 저장소를 제안하는 데 있지 않습니다. 기존 skill을 모델 훈련용 상호작용 과제를 구성하는 재료로 사용합니다.
Agent Environments: 다음으로 웹, 데스크톱, 소프트웨어 수정, 도구를 통한 사용자 상호작용을 평가하는 환경을 살펴봅니다. 이들 역시 현실적인 실행 환경과 프로그램 기반 성공 검사를 제공할 수 있습니다. SkillGym이 추가하는 축은 과제를 어디에서 가져오는가입니다. 특정 플랫폼에 이미 존재하는 문제를 수집하는 방식에 더해, 사람이 작성한 skill과 범주별 템플릿에서 과제를 구성합니다.
Agent Training: 마지막으로 도구 선택과 유효한 호출을 학습하는 연구, 여러 API를 연결하는 데이터셋, 실행 결과와 검증 가능한 보상으로 학습하는 연구를 연결합니다. SkillGym은 이러한 학습 패러다임을 완전히 교체하지 않습니다. 사람이 쓴 워크플로를 실행 가능한 환경으로 만들고, 그 환경에서 SFT용 실행 기록과 RL용 결과 보상을 얻는 방식으로 지도 신호의 출처를 확장합니다.
핵심 기여와 다음 연결: 관련 연구의 세 축은 이후 방법론의 세 재료인 절차 지식, 실행 환경, 학습 신호에 대응합니다. 3장에서는 이 재료들을 실제로 연결하는 파이프라인을 설명합니다. §2
📖 Chapter 3: SkillGym
위치와 역할: 이 장은 연구의 핵심 방법입니다. skill과 템플릿을 만들고, 실행 환경을 검증한 뒤, 여러 agent 구성으로 실행 기록을 모으는 순서로 전개합니다.
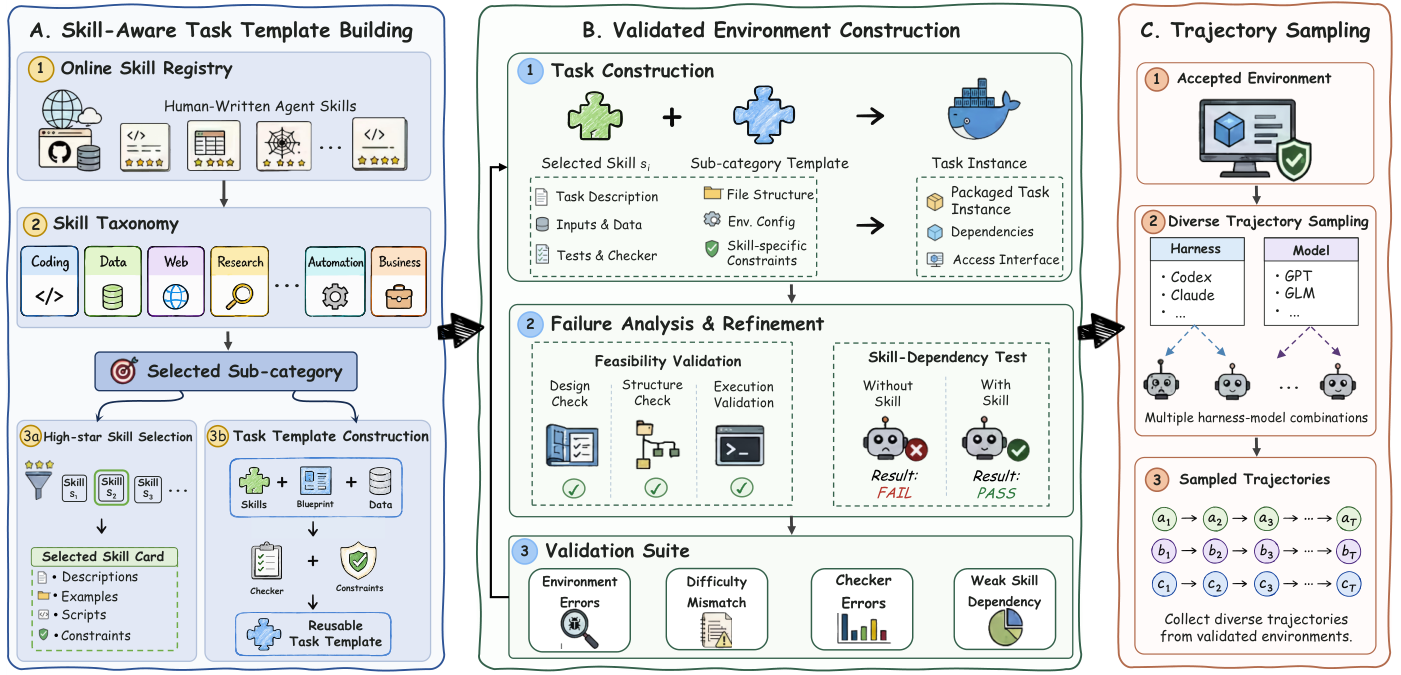
Figure 2. (A) skill 카드와 세부 범주별 템플릿, (B) 실행 가능성과 skill 의존성을 검증하는 환경 구성, (C) 여러 harness–model 조합의 실행 기록 수집입니다. PDF 3쪽의 그림 영역을 크롭했으며 내용 변경이나 번역은 하지 않았습니다. 원문 라이선스는 CC BY 4.0입니다. 버전 고정 원문.
3.1 Skill-Aware Template Construction
Skill organization and selection. 저자는 온라인의 사람이 작성한 skill을 12개 대분류와 63개 세부분류로 조직합니다. 각 세부분류에서 높은 star를 받은 skill을 선택하고 설명, 사용 예, 의사코드 또는 스크립트, 실행 제약을 skill card에 정리합니다. 카드는 재사용 절차에 대한 구조화된 설명이며, 아직 특정 입력을 풀어야 하는 문제 자체는 아닙니다.
Reusable task templates. 이어 세부분류마다 사람이 재사용 템플릿을 설계합니다. 템플릿에는 과제의 청사진, 입력 자산, 파일 구조, 런타임 요구사항, checker 명세, 실행 제약이 포함됩니다. 하나의 범주에 공통적인 작업 구조는 유지하되, 개별 skill에 따라 입력과 지시문, 기대 결과, 성공 조건을 바꿀 수 있게 합니다. 저자가 의도하는 것은 모든 skill을 똑같은 문제로 환원하는 것도, 제약 없이 자동 생성에 맡기는 것도 아닙니다.
Outcome-oriented task specifications. 마지막으로 템플릿이 무엇을 성공으로 볼지 정합니다. 콘텐츠 생성에서는 섹션, 길이, 형식, 키워드 포함, 파일명 등이 검사 대상입니다. 소프트웨어와 데이터 처리에서는 실행 테스트, 파일 조사, 구조화 결과 비교, schema 검사, 최종 상태 검사를 사용할 수 있습니다. 원문은 이 검사가 인코딩된 과제 요구사항을 다루며, 결과의 모든 품질을 판단하는 것은 아니라고 범위를 명시합니다. 예를 들어 형식 검사를 통과했다는 사실을 문서의 전반적 품질에 대한 보증으로 확대하면 안 됩니다.
3.2 Environment Construction and Validation
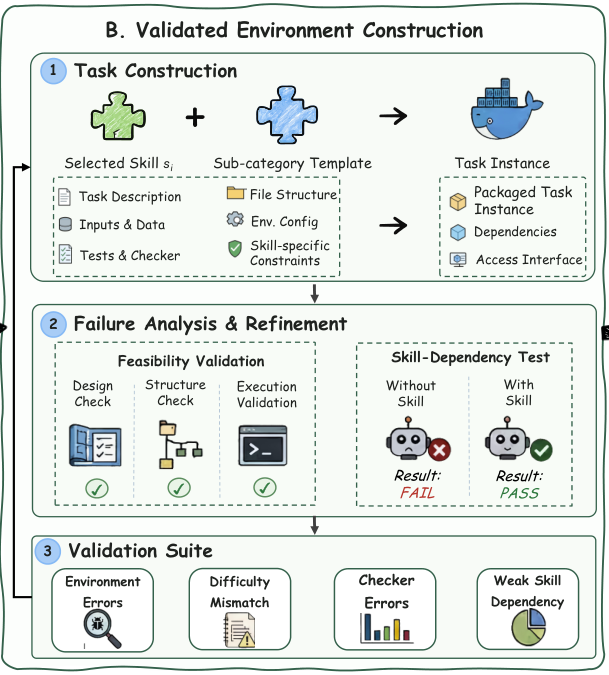
Figure 2(B) 상세. PDF 3쪽에서 B 패널만 크롭했으며 내용은 변경하지 않았습니다. 실행 가능성과 skill 의존성의 두 검증 단계를 보여줍니다. CC BY 4.0. 버전 고정 원문.
Executable instantiation. skill card와 범주별 템플릿을 조합해 지시문·입력·실행 명세·verifier를 생성하고 Docker로 패키징합니다. 검사에는 적용 가능한 경우 입력 변조, 답안 복사, 요구사항 우회, 결과 조작을 막는 조건도 포함합니다. 그러므로 단순히 어떤 파일이 생겼는지만 확인하는 구조라고 이해하기보다는, 각 과제에 정의한 조건을 실행 결과에 대조하는 구조로 읽는 것이 정확합니다.
Two-level acceptance. 먼저 실행 가능한 환경과 동작하는 검사기가 있는지 확인합니다. 이후 기준 agent에 skill을 제공한 실행과 제공하지 않은 실행을 비교합니다. skill이 있을 때만 성공하면 Skill-Dep.로, 환경 검증만 통과하고 이 대조 조건을 만족하지 못하면 Verifier-Passed로 남깁니다. 두 그룹을 분리하는 이유는 skill에서 생성했다는 출처와 그 skill에 실제로 의존한다는 관측이 서로 다르기 때문입니다.
Failure-driven refinement. 실패는 환경 오류, checker 오류, 난도 불일치, 약한 skill 의존성으로 나눕니다. 생성 기록, 실행 로그, verifier 결과, reflection 기록을 이용해 런타임, 요구사항, 검사 로직을 수정합니다. 난도와 의존성 문제는 과제의 요구 수준과 목표 절차의 연결을 조정하는 데 사용합니다. 과제별 구성 예산 안에서 수정과 재검사를 반복하고, 유효한 실행과 검증을 확보하지 못한 환경은 버립니다. 의존성 증거만 부족하면 fallback으로 남깁니다.
이 설계에서 refinement는 학습 대상 모델의 RL 업데이트와 구별됩니다. 환경을 생성하고 검사하는 단계의 반복 개선이며, 이후 학습용 실행 기록을 모으기 전에 이루어집니다.
3.3 Multi-Harness Trajectory Sampling
Diverse agent configurations. 통과한 환경에서 Codex와 Claude Code 기반의 여러 모델을 실행합니다. agent는 입력 파일을 살피고 행동을 수행하며 결과를 관찰한 뒤 산출물을 제출합니다. 최종 산출물뿐 아니라 그 결과에 도달한 의사결정과 피드백의 순서를 보존합니다. 동일한 모델 API를 호출하는 것과 실제 harness 안에서 과제를 푸는 것은 구분되며, 수집 구성을 다양화할 때 두 요소를 함께 바꿉니다.
Trajectories and outcome rewards. 각각의 실행은 동일한 과제별 verifier로 평가합니다. 환경의 Skill-Dep. 라벨은 구성 시점의 대조 검사 결과이고, 성공 보상은 지금 실행한 agent의 결과입니다. 이 구분 때문에 skill 의존성을 검증한 과제에서 실패 기록이 나오는 것은 모순이 아닙니다.
Trajectory records and learning uses. 기록에는 지시문, skill 메타데이터, 환경 설정, 행동, 관찰, 최종 출력, 검증 결과, 로그, 확보 가능한 실패 사유가 연결됩니다. 성공 실행은 SFT 시연으로 사용하고, 실패 실행은 실패 양상 분석에 활용할 수 있습니다. 환경과 검사기는 결과 보상 기반 RL에도 사용할 수 있지만, 뒤의 성능 실험은 성공 기록을 사용한 SFT입니다.
핵심 기여와 다음 연결: 3장은 절차 지식과 최종 점수 사이에 실행 가능한 과제와 검증된 경험이라는 연결을 놓습니다. 4장은 이 파이프라인으로 실제 어떤 규모와 분포의 데이터를 얻었는지 분석합니다. §3
📖 Chapter 4: Dataset Analysis and Quality Assessment
위치와 역할: 데이터가 얼마나 많고 어떤 성질을 가지는지 설명하는 장입니다. 환경의 분포, 성공 기록의 특성, 기존 자료와의 관계를 순서대로 다룹니다.
4.1 Environment Coverage and Validation
총 2,756개 환경 중 1,081개, 즉 39.2%가 Skill-Dep.이고, 1,675개는 Verifier-Passed입니다. 모든 채택 환경은 실행과 결과 검증을 통과했습니다. 다만 분포는 균일하지 않습니다. development 552개, business 542개, tools 358개가 큰 비중을 차지합니다. skill 의존성 라벨의 비율도 blockchain 15.6%에서 business 58.3%까지 다릅니다.
이 수치에서 저자가 강조하는 것은 세 가지 분모의 구별입니다. 전체 생성 시도와 채택된 환경은 다르고, 채택 환경 중 skill 의존성이 확인된 부분집합도 따로 있습니다. skill에서 출발한 모든 환경을 skill 의존적이라고 부를 수 없고, 의존성 검사에 통과하지 못했다는 이유만으로 실행 가능한 훈련 환경을 무효라고 판단해서도 안 됩니다.
GPT-5.4로 채택 환경을 구성하는 데 걸린 시간은 평균 4.5시간입니다. research는 2.6시간, documentation은 6.3시간입니다. documentation의 구성 시간이 가장 길지만 실제 성공 실행의 평균 길이는 development가 가장 깁니다. 환경을 만드는 비용과 agent가 문제를 푸는 상호작용 길이는 서로 다른 성질을 측정합니다. 여기의 시간은 논문이 보고한 환경 구성 시간이며, 사용자에게 청구될 API 비용으로 환산하지 않습니다.
4.2 Trajectory Characteristics and Skill Usage
수집 구성과 성공 기록 수는 다음과 같습니다. 같은 환경을 여러 구성이 풀 수 있으므로 기록 수를 고유 과제 수와 혼동하면 안 됩니다.
| Harness | 교사 모델 | 성공 기록 수 | 목표 skill 명시적 사용 |
|---|---|---|---|
| Claude Code | DeepSeek V4 Pro | 1,722 | 17.1% |
| Claude Code | GLM-5.2 | 1,769 | 33.8% |
| Codex | GPT-5.4 | 1,967 | 57.4% |
| Codex | Nex-N2-Pro | 2,906 | 36.3% |
| 전체 | 네 구성 합계 | 8,364 | 36.8% |
총 48,152회 시도 가운데 8,364회가 통과하여 성공률은 17.4%입니다. 성공 기록은 2,302개 고유 과제를 덮고, 12개 대분류와 63개 중 62개 세부분류를 포함합니다. 이 가운데 3,722개 기록은 Skill-Dep. 환경, 4,642개는 fallback 환경에서 나왔습니다. 채택한 모든 환경에 성공 기록이 있다는 뜻은 아닙니다.
성공 기록당 평균은 도구 호출 49.0회, 저장된 텍스트 63.4k tokens, interaction steps 35.2회입니다. 최대값은 각각 350회, 342.9k tokens, 318회입니다. development의 평균은 70.1회 호출, 85.1k tokens, 52.2 steps로 가장 큽니다. 단일 요청 문맥 길이나 API 과금 토큰을 측정한 것이 아니라는 점은 부록 B에서 다시 명확히 설명합니다.
목표 skill을 명시적으로 호출한 성공 기록은 3,077개입니다. 따라서 성공 실행의 대다수가 반드시 목표 skill 파일을 읽었다고 요약할 수 없습니다. 또한 구성별 명시적 사용률이 다르다는 관찰만으로 특정 모델의 일반적인 skill 활용 능력 순위를 확정하지 않습니다. 구성별로 성공한 과제 집합 자체가 다르기 때문입니다.
4.3 Comparison with Existing Datasets
저자는 API 중심 데이터셋과 상호작용 벤치마크를 나누어 비교합니다. API-Bank, ToolAlpaca, APIBench, ToolBench가 도구 인터페이스와 호출 순서를 중심으로 지도 신호를 구성한다면, SkillGym은 재사용 워크플로를 입력·운영 제약·검증 가능한 결과물로 연결합니다. 평균 49회 호출이라는 길이는 짧은 단일 API 선택 이상의 실행 경험을 제공한다는 설명에 사용됩니다.
WebShop, WebArena, VisualWebArena, OSWorld, SWE-bench 등은 현실적인 환경과 결과 평가라는 축에서 관련됩니다. GAIA와 τ-bench는 일반적 보조 작업 및 도구·agent·사용자 상호작용과 연결됩니다. SkillGym은 이를 대체하는 유일한 벤치마크라기보다 skill에서 과제를 생성하고, 경험적 의존성을 검사하고, 여러 모델과 harness에서 실행 기록을 모으는 자원으로 위치를 잡습니다.
핵심 기여와 다음 연결: 4장은 환경의 다양성과 긴 실행 경험을 수치로 보여주면서도 환경 수, 성공 기록 수, 명시적 skill 사용을 구분합니다. 5장은 이렇게 모은 경험이 실제 모델 성능으로 이어지는지 평가합니다. §4, Tables 1–3
📖 Chapter 5: Experiments
위치와 역할: 이 장은 평가 설정을 먼저 설명하고, 기본 모델·외부 모델 비교를 제시한 뒤, 교사 구성과 harness에 따른 차이를 분석합니다.
5.1 Experimental Setup
Benchmarks. GDPval-AA v2는 9개 산업, 44개 직업에 걸친 220개 전문 업무 과제를 평가합니다. 문서, 스프레드시트, 프레젠테이션 등 산출물을 블라인드 쌍대 비교하여 Elo로 보고합니다. Terminal-Bench 2.1은 컨테이너 기반 명령행 환경의 디버깅·보안 수정 등 복잡한 실행 과제를 다룹니다. SkillsBench v1.1은 8개 도메인의 87개 과제로 구성되고, 과제별 skill 패키지를 제공하는 조건과 제공하지 않는 조건을 나눕니다. 뒤 두 벤치마크의 지표는 성공률입니다.
Baselines. 비교는 기본 checkpoint Qwen3.5-35B-A3B와 비슷한 규모의 agent 모델, 그리고 공개 참조 모델의 점수로 구성됩니다. 비교 규모 그룹에는 TerminalTraj-32B, OpenThinkerAgent-32B, Nemotron-Terminal-32B, Agents-A1이 포함됩니다. 공개 참조 그룹은 성능의 위치를 살피기 위한 자료이며, 부록 D에서 harness와 checkpoint 차이를 별도로 설명합니다.
Implementation Details. SFT는 ms-swift의 Megatron backend와 NVIDIA H200 16개를 사용하여 언어 모델의 모든 파라미터를 업데이트합니다. Claude Code 평가에는 temperature 0.6, top_p 0.95, top_k 20을 사용하고, Codex는 기본 sampling 설정을 유지합니다. 두 harness 모두 max_tokens=65536, 문맥 창 262,144 tokens를 사용합니다. Terminal-Bench와 SkillsBench는 Harbor의 공식 구현 및 제공 환경 설정을 사용하되 OpenSandbox 기반 자체 sandbox에서 실행하고, GDPval은 NVIDIA NeMo Gym 구현 기반 파이프라인을 사용합니다.
5.2 Main Results
Comparison with Base Model. Table 4를 아래에 옮겼습니다. GDPval의 숫자는 Elo이고, 나머지는 성공률(%)입니다. 마지막 열은 추론 시 skill을 제공하지 않은 결과입니다.
| Harness / 모델 | GDPval Elo | Terminal-Bench | SkillsBench, skill 제공 | SkillsBench, skill 미제공 |
|---|---|---|---|---|
| Codex / Base | 942 | 10.11 | 5.33 | 0.69 |
| Codex / SkillGym-Agent | 979 | 46.07 | 33.02 | 21.08 |
| Claude Code / Base | 974 | 39.33 | 23.34 | 12.13 |
| Claude Code / SkillGym-Agent | 1173 | 58.43 | 51.47 | 26.81 |
Claude Code에서는 GDPval이 199 Elo, Terminal-Bench가 19.10%p, SkillsBench의 skill 제공·미제공 조건이 각각 28.13%p와 14.68%p 상승합니다. Codex의 Terminal-Bench 상승은 35.96%p입니다. 이들은 상대 증가율이 아니라 절대 차이입니다.
저자가 특히 주목하는 비교는 학습 모델의 skill 미제공 점수와 기본 모델의 skill 제공 점수입니다. Claude Code에서는 26.81% 대 23.34%, Codex에서는 21.08% 대 5.33%입니다. 결과는 외부 skill을 읽는 능력뿐 아니라 학습 후 남는 절차적 능력을 시사합니다. 동시에 학습 모델도 skill을 제공받으면 더 높은 점수를 얻으므로, 내부화된 능력과 외부 절차 지침은 보완 관계입니다.
Comparison with SOTA Models. 논문은 Claude Code의 SkillGym-Agent가 비교한 동급 규모 모델 중 네 지표에서 가장 높은 점수를 얻었다고 보고합니다. Agents-A1 대비 차이는 GDPval 189 Elo, Terminal-Bench 14.61%p, SkillsBench 두 조건에서 21.18%p와 13.44%p입니다.
공개 참조 점수와 비교하면 skill 제공 SkillsBench에서 51.47%는 Claude Sonnet 4.6의 47.2%, GPT-5.4 Mini의 41.4%, DeepSeek V4 Pro Preview의 50.1%보다 높습니다. 그러나 이 비교는 동일한 harness와 예산을 고정한 대결이 아닙니다. 특히 Codex 내부 비교에서도 기본 모델과 학습 모델의 system prompt가 다르다는 부록 D의 조건을 함께 적용해야 합니다.
5.3 Ablation Studies
Influence of Teacher Models. Codex에서 GPT-5.4와 Nex-N2-Pro 기록을 합치면 각 지표의 더 높은 단일 교사 학생 대비 Terminal-Bench가 6.74%p, SkillsBench 두 조건이 5.91%p와 0.98%p 개선됩니다. Claude Code에서 DeepSeek와 GLM을 합치면 각각 2.24%p, 1.83%p, 3.31%p 개선됩니다. 단일 교사만 비교하면 GLM이 더 높은 학생 성능을 내지만, DeepSeek 기록을 추가했을 때 실행 지표가 더 좋아진다는 점이 상호 보완성의 근거입니다.
반대로 GDPval은 두 교사를 합쳤을 때 더 높은 단일 교사 학생 대비 각각 98 Elo와 51 Elo 낮아집니다. 모든 교사를 합쳐도 GDPval 최고점은 단일 교사 구성에 남습니다. 따라서 교사 수가 늘면 모든 능력이 동일하게 향상된다는 결론은 원문과 맞지 않습니다.
Influence of Harness. 모든 교사 데이터를 합친 Codex 학생은 GPT+Nex 구성보다 GDPval 3 Elo, Terminal-Bench 5.62%p, SkillsBench 두 조건에서 13.11%p와 7.49%p 높습니다. 특히 skill 제공 조건은 19.91%에서 33.02%로 상승합니다. Claude Code에서는 DeepSeek+GLM 대비 모든 교사 구성이 GDPval 12 Elo, Terminal-Bench 1.13%p, skill 제공 SkillsBench 4.14%p 높지만, skill 미제공 성능은 28.41%에서 26.81%로 낮아집니다.
이러한 비대칭을 저자는 유용한 cross-harness transfer의 증거로 해석합니다. 다만 harness 다양성과 함께 교사 구성 및 데이터 양도 바뀌므로, harness 다양성만의 효과를 분리한 실험은 아니라는 점을 직접 명시합니다.
핵심 기여와 다음 연결: 실험은 skill에서 얻은 실행 경험의 학습 가치를 보여주고, 교사 혼합의 이득이 평가 능력에 따라 다르다는 사실을 함께 제시합니다. 6장은 이를 정리하고 실제로 수행한 SFT와 향후 RL 연구를 구분합니다. §5, Tables 4–5
📖 Chapter 6: Conclusion and Future Work
위치와 역할: 결론은 skill-to-task 구성, 코드 기반 결과 검증, 대조적 skill 의존성 평가를 하나의 프레임워크로 정리합니다. 환경 2,756개와 성공 기록 8,364개, 평균 49회 도구 호출 및 최대 318 steps라는 자원 규모를 다시 확인합니다.
저자는 35B 모델의 전문 업무·터미널·skill 활용 성능 개선과, skill을 제공하지 않아도 기본 모델의 skill 제공 점수보다 높았다는 결과를 절차적 역량 학습의 근거로 요약합니다. 그러나 결론에서 강화학습을 이미 완료한 결과로 제시하지는 않습니다. 명시한 후속 연구는 환경의 verifier 기반 결과 보상으로 RL을 수행하여 긴 계획, 도구 조정, 실패 회복을 시연 학습 이후에도 개선하는 것입니다.
핵심 기여와 다음 연결: 본문은 검증 가능한 경험을 통한 학습이라는 주장으로 마무리됩니다. 이어지는 부록은 데이터 분포, 로그 해석, 실제 환경 예제, 평가 조건을 제공하여 본문 수치의 의미를 구체화합니다. §6
📖 Chapter Appendix A: Dataset Coverage and Category Statistics
위치와 역할: 부록 A는 Table 1의 대분류 통계를 Figure 3과 Table 6의 세부분류 통계로 확장합니다.
먼저 skill 의존성 비율, 환경 구성 시간, 성공 실행 길이가 서로 다른 특성임을 강조합니다. Figure 3은 전체 skill 의존성 비율 39.2%와 평균 구성 시간 4.5시간을 기준선으로 표시합니다. 실행 길이 패널의 평균 색상은 전체 평균 대비 범주 평균을, 최대값 패널의 색상은 해당 범주 평균 대비 최대값을 표현합니다. 같은 색의 강도를 서로 다른 통계의 절대값으로 읽으면 안 됩니다.
Table 6은 63개 세부분류 전체를 제시합니다. Total은 채택 환경 수이고 Num.은 성공 실행 수입니다. 성공률의 분모는 해당 세부분류에서 시도한 실행이며, 길이 통계는 성공한 실행만 대상으로 합니다. 예를 들어 culinary-arts에는 채택 환경이 하나 있지만 성공 실행은 없습니다. 이 때문에 환경은 63개 세부분류를 포함하면서 성공 데이터는 62개만 포함합니다.
데이터과학 관련 세부분류를 보면 data-analysis는 환경 40개, 성공 기록 45개, 관측 성공률 4.3%입니다. data-engineering은 환경 48개, 성공 기록 163개, 성공률 25.8%입니다. 이 수치들은 서로 다른 과제와 agent 구성에서 얻었으므로 일반적으로 데이터 분석이 데이터 엔지니어링보다 어렵다는 순위로 바꾸지 않습니다. 원문 역시 과제가 적은 세부분류의 성공률을 표본과 구성의 맥락에서 읽도록 설명합니다.
핵심 기여와 다음 연결: 이 부록은 환경 채택과 실행 성공을 통계적으로 분리합니다. 부록 B는 성공 기록 자체의 길이와 내부 구성으로 분석 단위를 더 좁힙니다. Appendix A
📖 Chapter Appendix B: Detailed Trajectory Analysis
위치와 역할: 부록 B는 저장한 성공 기록 8,364개를 대상으로 합니다. 기록 수 $N$, 저장된 assistant 메시지 수 $M$, 구조화 도구 호출 수 $C$, 저장 텍스트의 토큰 수 $T$를 정의합니다. $M$은 복원한 API 응답 단계가 아니고, $T$는 API 사용량이나 단일 요청 문맥 길이가 아닙니다. 또한 구성마다 성공한 과제 집합이 달라 실행 효율을 동일 과제에서 비교한 분석도 아닙니다.
B.1 Trajectory Length Distributions
Table 7은 중앙값, 90백분위수, 95백분위수를 보고하고 Figure 4는 호출 수와 토큰 수를 구간으로 나눈 분포를 보여줍니다. 도구 호출 중앙값은 Codex+GPT-5.4의 28회부터 Claude Code+GLM-5.2의 50회까지입니다. 저장 텍스트의 95백분위수는 구성별로 74.91k에서 174.14k tokens입니다.
128k tokens 이상을 저장한 성공 기록은 Nex-N2-Pro에서 15.21%, GPT-5.4에서 0.31%입니다. 이는 저장 기록의 분포 차이입니다. 어떤 모델이 단일 요청마다 128k 문맥을 필요로 했다거나, 모델과 무관하게 그 과제가 그만큼 어렵다는 뜻은 아닙니다. 토큰 수는 o200k_base로 계산하며, 1k는 1,000 tokens, 분위수는 선형 보간으로 구합니다.
B.2 Saved-Text Token Composition
Figure 5(a)는 명시적으로 저장된 reasoning, 도구 출력, 도구 호출 이름·인자의 비율을 구분합니다. 전체 저장 텍스트에서 각각 35.9%, 34.0%, 19.6%를 차지하고 나머지는 잔여 부분입니다. 이 비율은 개별 기록의 비율을 평균낸 값이 아니라 그룹 내 토큰을 합친 뒤 계산합니다.
GPT-5.4 기록에서는 도구 출력이 55.59%이고, Claude Code의 두 모델에서는 명시적 reasoning이 세 주요 구성 요소 중 가장 큽니다. 원문은 이것이 저장된 텍스트의 성질이지 관측하지 못한 내부 추론량이나 각 구성 요소의 학습 기여를 측정한 것은 아니라고 구분합니다.
B.3 Interaction Density and Tool-Call Structure
Table 8은 각 기록에서 $C/M$, $T/M$, $T/C$를 계산한 뒤 중앙값과 95백분위수를 집계합니다. 각각 메시지당 호출 수, 메시지당 토큰 수, 호출당 토큰 수입니다. 전체 호출 수를 전체 메시지 수로 나눈 값과 동일한 집계 방식이 아닙니다.
Figure 5(b)는 각 기록 안에서 도구 호출 0개·1개·2개 이상인 assistant 메시지의 비중을 계산하고, 기록마다 같은 가중치로 평균냅니다. 모든 구성에서 단일 호출 메시지의 평균 비중이 가장 크며 64.54~81.43%입니다. 다중 호출 메시지는 14.05~31.21%입니다. 메시지 하나가 도구 호출 하나라는 가정은 성립하지 않습니다. 그러나 여러 호출이 같은 메시지에 있다는 사실만으로 병렬 실행했다고 판단할 수도 없습니다. 이 역시 원문이 명시적으로 제한한 해석입니다.
B.4 Token-Volume Distribution and Concentration
Figure 6은 메시지 수로 나눈 그룹의 기록 비중과 토큰 비중을 비교합니다. Nex-N2-Pro에서 메시지가 60개보다 많은 기록은 15.28%이지만 전체 저장 토큰의 30.69%를 차지합니다. DeepSeek V4 Pro의 대응 값은 10.45%와 19.69%입니다. 긴 기록의 비중을 건수로만 보면 텍스트 분량에서 차지하는 비중을 놓칠 수 있습니다.
Table 9는 구성별로 저장 토큰이 많은 순서대로 정렬하여 상위 1%, 5%, 10%의 토큰 비중을 계산합니다. 상위 10%의 비중은 19.68~23.90%로, 고르게 분포하지는 않지만 어느 구성에서도 과반은 아닙니다. 선택할 기록 수는 올림하므로 정확한 선택 비율이 명목 비율보다 조금 높을 수 있습니다. 원문은 토큰 비중이 곧 모델 성능 개선에 대한 기여도는 아니라고 설명합니다.
핵심 기여와 다음 연결: 부록 B의 가치는 긴 기록을 보고하는 데 더해 토큰, 메시지, 호출의 의미와 집계 단위를 구분한다는 데 있습니다. 부록 C는 그 통계가 가리키는 실제 과제와 실행 모습을 사례로 보여줍니다. Appendix B
📖 Chapter Appendix C: Environment and Trajectory Examples
위치와 역할: 부록 C는 템플릿에서 생성된 하나의 환경과 그 환경을 성공적으로 푼 네 구성을 따라가며 추상적인 프레임워크를 구체화합니다.
C.1 From a Seed Template to a Generated Task
seed task는 지시문 instruction.md, 설정 task.toml, 계획 PLAN.json, 설명 문서, Docker 환경과 skill, tests, solution을 포함합니다. 이 seed를 목표 skill과 결합해 계획, 파일 생성, 검증, 실패 기반 수정을 수행합니다. 예제 payment_electric-deployment__task1은 business__payment__template_new 계열 템플릿과 electric-deployment skill에서 생성됩니다.
핵심은 skill 원문을 과제 지시문으로 그대로 복사하는 것이 아니라, 재사용 가능한 환경·검사·참조 해법의 틀에 구체적 초기 상태와 성공 조건을 부여한다는 점입니다.
C.2 Generated Task Example: Payment Approval Sync
Task package. 생성 과제에는 계획, 지시문, task 설정, skill, Compose와 Kubernetes 설정, 데이터, 스크립트, 독립 검사용 runtime, 구성 단계의 참조 해법이 포함됩니다. agent가 볼 과제와 최종 검사에 사용할 구성 요소를 구분한 패키지입니다.
Task setting. 문제는 결제 backend의 업데이트가 pooler와 Electric 유사 동기화 계층을 거쳐 지급 승인 dashboard로 전달되는 환경을 수정하는 것입니다. agent는 업데이트의 전달, 완전한 동기화 상태를 반영하는 readiness, 재시작 후 필요한 동기화 상태의 보존을 복구해야 합니다. 환경은 로컬 Python 서비스로 이 동작을 재현합니다. 실제 운영 Electric·PostgreSQL·Kubernetes 클러스터를 구축한 실험은 아닙니다.
Table 10의 초기 오류는 다섯 축입니다. 복제 연결이 pooler를 가리키므로 직접 backend 연결과 별도의 pooled query URL로 나누어야 합니다. insecure 설정을 끄고 secret을 구성해야 합니다. PostgreSQL의 wal_level=logical은 이미 맞지만 replication slots와 WAL senders는 각각 1과 2이므로 최소 4로 늘려야 합니다. /var/lib/electric 저장 경로와 Compose volume의 불일치를 수정해야 합니다. 마지막으로 HTTP 202를 반환할 수 있는 준비 상태 endpoint에 대해 완전히 준비된 HTTP 200 상태를 구별하는 readiness 방식이 필요합니다.
Executable verification. 과제에는 배포 및 acceptance entrypoint가 있고 deployment_audit.json, cutover_note.md 산출물도 요구합니다. 최종 검사는 agent가 수정 가능한 보조 스크립트와 분리된 tests/trusted_runtime/에서 수행합니다. 새 stack을 시작하고 기존 결제 레코드의 동기화를 확인한 뒤, 새 업데이트를 주입하여 실시간 전달을 검사합니다. 동기화 서비스를 재시작한 후에는 HTTP 200 readiness를 기다리고 다시 업데이트를 넣어 재시작 이후 전달과 저장 cache의 재사용까지 확인합니다.
원문이 특히 구분하는 부분은 Kubernetes probe 검사입니다. 정적 검사는 httpGet 대신 exec를 사용했는지 확인하지만 probe 내부 shell command 자체를 실행하지 않습니다. 별도의 trusted runtime은 health endpoint를 직접 호출하여 정확히 HTTP 200인지 검사합니다. 따라서 manifest 내부 명령 전체를 실제 Kubernetes에서 검증했다고 설명하면 범위를 넘어섭니다.
C.3 Trajectory Examples
Claude Code + DeepSeek V4 Pro. 설정, runtime 스크립트, 서비스, 운영 기록, 결제 데이터를 폭넓게 조사합니다. 이어 연결과 인증, 복제 용량, 저장 경로, readiness를 수정하고, 새 stack과 live acceptance 검사를 수행한 뒤 산출물과 최종 상태를 확인합니다.
Claude Code + GLM-5.2. 이 사례는 먼저 electric-deployment skill을 명시적으로 호출합니다. 이후 설정을 조사하고 같은 핵심 수정 축을 처리하며, 실행 검사와 저장 상태 확인, 산출물 작성, 최종 재검사를 수행합니다.
Codex + GPT-5.4. 배포 설정과 runtime 구현을 조사하고 SKILL.md를 명시적으로 읽습니다. 구성 수정 후 JSON 및 assertion 방식의 acceptance 검사를 실행하고 인수인계 산출물을 작성합니다.
Codex + Nex-N2-Pro. 설정, runtime, 운영 메모, 결제 입력을 넓게 조사한 후 수정합니다. 수정된 설정을 확인하고 새 stack에서 검증을 수행하며, 최종 산출물과 과제 상태를 검사합니다.
이 네 예시는 원저자가 중간 파일 확인과 명령 출력을 생략해 정리한 순서입니다. 전체 로그를 그대로 인용한 전사본이 아닙니다. GLM과 GPT의 요약에는 명시적 skill 사용이 드러나지만, 다른 둘의 요약에 없다는 이유만으로 보이지 않는 실행까지 단정하지 않습니다.
Availability. 저자는 재사용 템플릿, 생성 환경과 verifier, 구성·검증 파이프라인, 실행 기록, 재현 문서를 공개한다고 설명합니다. 이 리뷰는 해당 소프트웨어를 실행하여 성능을 재현한 결과가 아니라 논문 원문에 대한 분석입니다.
핵심 기여와 다음 연결: 부록 C는 산출물의 존재뿐 아니라 실시간 전달과 재시작 후 상태까지 검사하는 구체적인 예를 보여줍니다. 마지막 부록 D는 성능 표를 해석할 때 필요한 평가 조건을 보완합니다. Appendix C
📖 Chapter Appendix D: Benchmark Evaluation Details and Results
위치와 역할: 부록 D는 본문의 점수표에 포함된 비교가 어디까지 통제되어 있는지 설명합니다. 성능 주장과 함께 읽어야 할 평가 조건입니다.
D.1 General-Agent Benchmark Evaluation Details
공개 참조 모델의 점수는 harness, 추론 예산, runtime, 평가 설정이 다를 수 있습니다. GDPval의 다수 공개 점수는 Stirrup harness를 사용하는 공통 Artificial Analysis snapshot에서 가져옵니다. 정확한 v2 설정을 확인하지 못한 결과는 기재하지 않습니다.
Terminal-Bench의 공개 결과도 Codex CLI, DeepSeek Harness, Terminus-2, NexAU, Claude Code 등 서로 다른 환경을 사용합니다. SkillsBench는 87개 전체 과제에 대해 skill 제공·미제공 각 조건에서 과제당 세 번의 시도를 목표로 한 release 정렬 평가를 설명합니다. 공개 평가는 별도 명시가 없으면 OpenHands를 사용하며 Gemini 3.1 Pro는 Gemini CLI입니다. DeepSeek V4 Pro의 SkillsBench 점수는 Preview checkpoint의 결과여서 이후 DeepSeek-V4-Pro-0813 행으로 옮기지 않습니다.
자체 비교에서는 Qwen3.5-35B-A3B를 두 harness의 기본 모델로 사용합니다. Terminal-Bench는 전체 89개, SkillsBench는 전체 87개 과제를 평가합니다. 가장 중요한 차이는 Codex Base는 standard system prompt, SkillGym-Agent는 no-applypatch system prompt를 사용한다는 사실입니다. Claude Code에서는 두 모델 모두 standard prompt를 사용합니다. 같은 backbone과 같은 harness라는 조건만 보고 prompt까지 같았다고 추정해서는 안 됩니다.
D.2 Detailed Benchmark Results
Table 11은 기본 모델 대비 결과, 동급 규모 agent, 공개 참조 모델을 함께 제시합니다. 괄호 안 차이는 GDPval에서는 Elo points, 나머지는 percentage points입니다. 표의 대시 기호는 해당 모델·벤치마크·설정에 대해 검증 가능한 공개 결과를 찾지 못했다는 뜻이며, 성능 0을 뜻하지 않습니다.
저자는 Codex 비교에서 system prompt도 바뀌었으므로 성능 차이를 미세조정만의 효과로 돌릴 수 없다고 명시합니다. Claude Code 비교는 같은 standard prompt이므로 이 구체적인 혼입 요인을 갖지 않습니다. 공개 참조와의 비교 역시 동일 조건의 직접 비교로 해석하지 않습니다.
핵심 기여: 부록 D는 수치가 큰 개선을 보여도 어떤 개입이 함께 바뀌었는지 확인해야 한다는 해석 기준을 제공합니다. 이 부록이 원문의 마지막 분석 단위이며, 이후 존재하지 않는 실험이나 후속 장을 가정하지 않습니다. Appendix D
실험 결과 심층 분석
가장 직접적인 결과는 동일한 Claude Code standard prompt 아래에서 기본 모델 대비 네 지표가 모두 상승했다는 사실입니다. Terminal-Bench 39.33%→58.43%, SkillsBench의 skill 제공 조건 23.34%→51.47%는 검증된 실행 경험이 서로 다른 작업 평가로 이어졌다는 근거입니다. GDPval의 974→1173은 Elo 변화이며 성공률 변화와 같은 단위로 합산할 수 없습니다. Tables 4·11
skill 미제공 결과도 중요합니다. Claude Code의 학습 모델은 26.81%로 skill을 제공받은 기본 모델의 23.34%보다 3.47%p 높습니다. 이 차이는 표의 값에서 계산한 절대 차이입니다. 그러나 학습 모델에 skill을 제공하면 51.47%로 더 올라갑니다. 따라서 이 실험의 의미는 skill 문서가 더 이상 필요 없다는 선언이 아니라, 학습한 절차와 외부 지침이 서로 보완한다는 관찰입니다.
교사 혼합 실험은 모든 지표를 하나로 요약하지 않아야 하는 이유를 보여줍니다. 모든 교사를 사용한 Claude Code 학생은 터미널과 skill 제공 과제에서 가장 높지만, GDPval은 GLM 단일 교사 학생의 1212 Elo보다 낮은 1173입니다. skill 미제공 점수 역시 DeepSeek+GLM의 28.41%가 전체 교사의 26.81%보다 높습니다. 저자가 보고한 이 상충을 지우고 데이터나 교사가 많을수록 항상 좋다고 결론낼 수 없습니다.
통계적 신뢰도와 관련해, 원문은 해당 성능 차이에 대한 유의성 검정이나 신뢰구간을 보고하지 않습니다. SkillsBench의 반복 시도 설정과 성공률은 제시되지만, 그 사실이 개별 차이의 통계적 유의성을 대신하지 않습니다. Codex의 큰 상승은 prompt 변화가 포함된 결과이고, 교차 harness 혼합의 차이는 교사 구성과 데이터 양의 변화까지 포함합니다. 이는 리뷰어가 새로 추정한 결함이 아니라 원문이 직접 명시한 해석 범위입니다.
재현성 측면에서는 benchmark 버전과 과제 수, harness별 sampling 설정, 하드웨어와 학습 backend, 환경 구성 방식, verifier 예제, 자원 공개 설명이 제공됩니다. 이 리뷰에서는 공개 코드 실행이나 모델 재학습, benchmark 재실행을 수행하지 않았으므로 보고 점수를 독립 재현했다고 주장하지 않습니다. 또한 관련 연구에 인용된 논문 전체를 별도로 읽어 검증한 것은 아닙니다.
기술적 함의와 응용
원문이 보여주는 의미는 사람이 작성한 업무 절차를 모델의 학습 경험으로 바꾸는 하나의 구체적 경로입니다. 지시문만 수집하는 대신 실행 환경, 입력, 관찰, 산출물, 검사 결과를 연결하면 모델이 어떤 과정을 통해 목표를 달성했는지 학습할 자료를 얻을 수 있습니다. SkillGym은 이를 12개 분야의 환경과 여러 교사·harness 조합에서 구성하고 SFT 결과로 평가했습니다.
데이터과학 관점의 해석으로는 데이터의 양만큼이나 라벨의 의미와 분모가 중요하다는 교훈이 남습니다. 환경 채택, 기준 agent의 skill 의존성, 개별 실행 성공, 목표 skill의 명시적 사용은 모두 다릅니다. 저장된 토큰 수 역시 비용이나 단일 문맥 길이와 다릅니다. 이러한 측정 대상을 구분해야 어떤 데이터가 학습에 들어갔고 어떤 능력을 평가했는지 정확히 설명할 수 있습니다.
업무 적용을 생각할 때도 원문 예제가 제공하는 구분이 유용합니다. Payment Approval Sync는 재시작 후의 상태와 업데이트 전달까지 검사하지만, 실제 운영 클러스터 자체를 재현한 것은 아닙니다. 마찬가지로 콘텐츠 과제의 형식·키워드 검사는 해당 명세의 충족을 확인하며 모든 품질을 보증하지 않습니다. 이는 결과를 자동 검사할 때 검사의 통과 범위와 그 밖의 의미를 분리해야 한다는 해석으로 이어집니다.
저자가 명시한 향후 연구는 verifier 결과 보상을 활용한 강화학습입니다. 현재 논문의 입증 범위는 검증된 실행 기록으로 학습한 SFT이며, RL을 통한 장기 계획·도구 조정·실패 회복 개선은 다음 과제로 남습니다. SkillGym의 중심은 skill을 더 많이 읽히는 데서 멈추지 않고, skill이 요구하는 절차를 실행하고 결과를 확인할 수 있는 경험으로 구성했다는 데 있습니다.
분석 범위는 v2 본문 1–6장과 부록 A–D 전체입니다. 부록 표의 모든 행과 그래프의 모든 구간을 재전사하지는 않았으며, 핵심 분포·계산 단위·과제 예제·평가 조건을 중심으로 설명했습니다. 본문의 그림과 수치는 같은 버전 원문에 근거합니다.