논문 개요와 전체 구조
마트에서 탄산수를 보고 있다고 해 보겠습니다. 집에 탄산수가 있는지 물었다면, AI는 과거 기록을 찾아 답하면 됩니다. 그런데 아무것도 묻지 않았는데 AI가 먼저 “어제 마지막 병을 마셨으니 지금 보충하세요”라고 알려 주려면 어떨까요? 탄산수가 보인다는 사실만으로는 부족합니다. 집에 남은 양을 기억해야 하고, 지금 말을 걸어도 되는지 판단해야 하며, 같은 말을 반복하지도 않아야 합니다.
MemoProAgent는 이 기억에 기반한 선제적 도움을 다룹니다. Shenglai Zeng 등은 1인칭 영상과 약 1년 분량의 합성 개인 기억을 결합한 MemoProBench를 만들고, 필요한 기억의 내용과 전달 시점을 분리해 실험합니다. 그 진단을 바탕으로 기억 그래프와 게이트를 결합한 하네스, 즉 모델 주변의 검색·판단 절차를 제안합니다. 하네스만 적용한 결과와 생성기를 강화학습한 결과를 구분하는 것도 이 논문의 중요한 부분입니다. 원문 v2
이 리뷰는 2026년 10월 21일 수정된 arXiv:2610.22671v2를 읽었습니다. 최초 제출일은 10월 15일이며, 이 글의 작성일과는 다릅니다. 연구의 주 평가 대상은 일상 영상을 보는 보조 에이전트입니다. 로봇 조작이나 이동 제어를 평가하는 논문은 아닙니다. 원문의 구조는 다음과 같습니다.
| 원문 순서 | 주요 내용 |
|---|---|
| 1 Introduction | 질문에 답하는 기억과 먼저 말을 거는 기억의 차이 |
| 2 Related Work | 기억 증강, 선제적 도움의 설정·평가·방법 비교 |
| 3 The MemoProBench Benchmark | 3.1 문제 정의, 3.2 데이터 통계, 3.3 평가 지표 |
| 4 Preliminary Findings | 4.1 윈도·스트리밍 방식, 4.2 기억만 있으면 충분한가, 4.3 내용과 시점의 분리 |
| 5 Method | 5.1 하네스, 5.2 후속 학습 |
| 6 Experimental Results | 6.1 실험 설정, 6.2 주 결과, 6.3 일반화·알림 불필요 사례·구성요소 제거 실험 |
| 7 Conclusions | 올바른 기억을 올바른 시점에 전달한다는 결론 |
| 본문 뒤 진술 | Limitations → AI Use Statement → Reproducibility Statement → Ethics Statement → References |
| 부록 A–C | 에이전트 구현, 비교군 구현, 데이터 생성·사람 검수 |
| 부록 D–F | 데이터 상세, 스트리밍 진단, GPT-5.3-Chat 적용 |
| 부록 G–J | 학습 설정, 판정기 프롬프트, 기억 그래프 구축, 전체 결과표 |
핵심 기여와 혁신성
첫 번째 기여는 “무엇을 말할까”와 “언제 말할까”를 함께 평가하는 문제 설정입니다. 검색 증강 생성(RAG)은 대체로 사용자의 질문을 검색어로 삼습니다. 이 연구에서는 질문이 없습니다. 현재 보이는 물체에서 검색의 출발점을 만들고, 긴 과거에서 개입할 이유를 찾아야 합니다. 맞는 알림을 한 번 했더라도 그 전후에 불필요한 알림을 쏟아냈다면 실패로 봅니다.
두 번째는 실패 원인을 분리하는 실험입니다. 정답 근거를 뜻하는 오라클 기억과 정답 전달 시점을 각각 제공하거나 제공하지 않는 네 조건을 비교합니다. GPT-5.3-Chat은 둘 다 제공받으면 Perfect가 96.0%이지만, 기억만 정확하고 시점을 스스로 고르면 38.0%입니다. 시점은 제공하되 기억을 일반 RAG로 바꾸면 15.3%입니다. 이 수치는 150클립 진단 실험의 결과이지, 제안 시스템이 실사용에서 96% 성공했다는 뜻이 아닙니다. §4.3, Table 4
세 번째는 이 진단을 구현으로 연결한 점입니다. 그래프는 알릴 근거를 찾고, 게이트는 그 근거가 지금 개입할 이유인지 걸러 냅니다. 생성기는 정제된 근거와 현재 장면, 이미 말한 내용을 함께 보고 최종적으로 발화하거나 침묵합니다. 이후 강화학습은 생성기에만 적용해 이른 발화와 반복 발화를 줄입니다. 필자가 읽기에 이 연구의 학습 가치는 기억 저장량을 늘리는 데서 끝나지 않고, 검색 결과가 사용자의 주의를 끊을 만큼 필요한지를 별도 판단으로 만든 데 있습니다.
기술적 세부사항
답변이 없는 상태도 정답입니다
시점 $t$의 출력은 다음과 같습니다. 원문 §3.1의 정책식을 그대로 옮겼습니다.
$\mathcal{M}$은 장기 기억, $\mathcal{V}_{t-n:t}$는 지금까지 관측한 최근 영상 구간, $\pi$는 판단 정책입니다. $\mathcal{A}$는 자연어 알림들의 집합이고, $\varnothing$는 침묵입니다. 모델은 미래 프레임을 미리 보는 것이 아니라 현재까지의 정보로 결정합니다. 구현에서는 침묵을 NO_REMINDER로 표현합니다.
알림이 필요한 구간을 트리거 윈도라고 부릅니다. 커피 머신을 켜기 전 컵을 놓아야 하는 장면이라면, 컵과 머신을 확인할 수 있고 아직 행동을 바꿀 수 있는 구간에 해당합니다. 각 양성 클립은 트리거 윈도를 하나만 갖습니다. 평가의 핵심 지표인 Perfect는 알림의 내용·시점·횟수를 모두 요구합니다.
$t_s,t_e$는 윈도의 시작과 끝, $f_1$은 첫 발화 시점, $a_{f_1}$은 그 내용, $k$는 클립 전체의 발화 횟수입니다. $\mathrm{Good}$은 올바른 기억에 근거하고 현재 상황에서 정확하며 유용하다는 판정입니다. $\delta=2$초는 기본 시간 허용치입니다. 원문은 윈도 방식이 2초마다 결정하므로 끝 직후 첫 결정도 허용하기 위해 이 값을 둡니다. $k$는 뒤의 RAG 검색 개수 표기에도 쓰이므로 문맥을 구분해야 합니다. §3.3
같은 정답 알림이라도 두 번 말하면 Perfect가 아닙니다. 리뷰어 작성 도식이며, 색칠한 구간은 트리거 윈도와 끝의 2초 허용치입니다. 정의: 원문 §3.3
검색에서 발화까지의 흐름
아래는 원문 Algorithm 1을 설명용으로 다시 쓴 의사코드입니다. 실제 배포 코드나 직접 실행한 예시는 아닙니다.
1
2
3
4
5
6
7
8
입력: 현재까지의 영상, 에피소드·의미 기억, 이미 말한 알림
1. 현재 집중하는 물체를 관찰한다.
2. 물체와 가까운 그래프 개체를 검색의 시작점으로 고른다.
3. 연결된 경험·지속적인 사용자 사실을 모으고 그래프 경로로 보완한다.
4. 게이트가 같은 물체의 아직 유효한 필요를 한 가지 근거로 정제한다.
   그런 근거가 없으면 none을 반환한다.
5. 생성기가 현재 장면 + 근거 + 이미 말한 내용을 보고 판단한다.
출력: 지금 필요한 구체적 알림 한 문장 또는 NO_REMINDER
여기서 에피소드 기억은 “언제 어떤 일이 있었다”는 경험이고, 의미 기억은 여러 경험에서 유지되는 습관·선호·제약입니다. 오픈 루프(open loop)는 아직 해결되지 않은 의도나 문제를 가리킵니다. “다음에 우유를 사야겠다”는 오픈 루프이지만, 이후 우유를 샀다는 기록이 있으면 그대로 다시 알리면 안 됩니다. 이 관계를 게이트와 생성기가 판단합니다. §5.1 및 부록 A·I
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 사용자가 질문하는 반응형 보조와, 질문 없이 먼저 개입하는 보조를 대비합니다. 반응형 시스템에서는 “집에 탄산수가 남아 있나요?”라는 질문이 기억 검색의 방향을 정해 줍니다. 선제적 시스템에서는 현재 탄산수가 보인다는 관측과 과거의 소진 기록을 연결해야 비로소 말을 걸 이유가 생깁니다. 기억이 답변의 재료에서 개입을 시작하는 근거로 역할을 넓히는 셈입니다.
저자들은 짧은 사용자 프로필이나 목표를 미리 주는 설정과, 필요한 사실이 1년 분량 기록 속에 묻힌 설정을 구분합니다. 후자에서는 올바른 근거를 찾아내는 일 자체가 과제입니다. 관련 내용이 검색됐다고 모두 말하면 사용자가 제공하지 않은 주의를 계속 요구하게 됩니다. 따라서 대부분의 시점에 침묵해야 하며, 평가도 알림을 한 번 맞히는 능력과 불필요한 발화를 억제하는 능력을 함께 봐야 합니다.
이 문제를 측정하기 위해 MemoProBench를 제안하고, 내용과 시점을 분리한 통제 실험을 소개한 뒤, 그 결과에 대응하는 하네스와 후속 학습으로 연결합니다. 서론의 핵심은 강한 모델의 일반적인 생성 능력과 선제적 보조의 성공 조건이 다르다는 문제 제기입니다. 다음 장은 기존 연구가 어떤 조건을 이미 제공하고 있었는지 비교합니다. §1
📖 Chapter 2: Related Work
기억 증강 부분은 RAG와 장기 에피소드·의미 기억 계열을 먼저 정리합니다. 이 계열에서는 명시적 질의를 받아 기억을 검색하고 답변 품질을 평가하는 경우가 많습니다. MemoProAgent가 겨냥하는 설정에서는 검색 이전에 “무엇을 찾을 것인가”부터 현재 환경에서 만들어야 합니다.
이어 선제적 도움의 설정·평가·방법을 비교합니다. 원문 Table 1은 질의 유무, 개인 기억의 종류와 길이, 검색의 필요성, 시점 평가, 내용과 시점의 결합 평가를 축으로 삼습니다. StreamingBench·OvO-Bench 같은 질의 기반 영상 평가, 목표를 제공하는 ProAssist, 짧은 사용자 기억을 제공하는 EgoPro-Bench, 연속 영상과 기억을 다루는 동시기 EgoServe를 같은 문제로 뭉뚱그리지 않습니다.
저자들이 강조하는 차이는 “선제적”이라는 이름 자체보다 알림을 정당화할 내용이 사전에 주어지는가입니다. 내용을 제공받고 시점만 고르는 문제와, 긴 기억에서 내용을 찾아 시점까지 고르는 문제의 난도를 구분해야 한다는 주장입니다. EgoServe와는 통제 가능한 합성 기억을 이용한 원인 진단, 게이트와 후속 학습의 추가를 차이로 듭니다. 이 비교는 논문의 서술을 따른 것이며, 인용된 모든 선행 논문을 별도로 재평가한 결과는 아닙니다. 다음 장은 이 차이를 데이터와 지표로 구체화합니다. §2
📖 Chapter 3: The MemoProBench Benchmark
3.1 문제 정의에서는 항상 켜져 있는 인과적 정책을 정의합니다. 입력은 현재까지의 1인칭 영상과 장기 기억이며 명시적 질문은 없습니다. 출력은 시점과 내용이 짝을 이룬 드문 개입들입니다. 관측 대상이 잠깐 가려졌다가 다시 나타난 경우, 8초 이하의 간격은 하나의 등장으로 합칩니다. 더 늦게 같은 물체가 다시 보인다고 알림 기회가 새로 열리는 것은 아닙니다. 최초의 적절한 기회를 놓치고 뒤늦게 같은 내용을 꺼내면 늦은 개입입니다.
3.2 데이터 통계에서 양성 데이터는 총 1,804쌍이며 학습 904, 개발 100, 평가 800으로 나뉩니다. 영상은 Ego4D의 일상 장면을 사용하고, 기억은 합성한 사용자 생애 기록입니다. 평균 362일에 걸쳐 946개 이벤트와 약 28.1K개의 캡션을 담으며, 타임스탬프 포함 평균 길이는 618K토큰입니다. 정답 근거는 평균 1.2K토큰으로 전체 기억의 평균 0.19%에 불과합니다. 이 비율은 긴 기록에서 짧은 실마리를 찾아야 한다는 난도를 설명합니다. Table 2
기억은 눈에 보이는 행동을 나타내는 [V]와 대화 내용을 나타내는 [C]의 타임스탬프 캡션으로 전달됩니다. 실제 사용자의 1년치 영상을 수집한 것이 아닙니다. 주방·매장·작업장·거실·실외 등 여러 장면과, 과제 완료·확인·자원 관리·유지보수·물건 배치·안전 등의 알림 이유를 포함합니다. 추가로 정답 기억을 제거한 알림 불필요 클립(negative clips) 150개를 구성해 침묵해야 할 때 정말 침묵하는지도 봅니다.
원문 예시를 보면 과제의 성격이 분명해집니다. 커피 머신 앞 장면에는 “이전에 컵 없이 작동시켜 넘쳤다”는 경험과 “더러운 컵을 사용해 맛이 이상했다”는 경험이 연결됩니다. 정답 알림은 깨끗한 컵을 추출구 아래에 놓으라는 구체적 조언입니다. 보이는 물건을 묘사하는 문장과 과거 경험에 근거한 도움은 다릅니다.
3.3 평가 지표는 아래처럼 구분됩니다.
| 지표 | 클립에서 세는 행동 |
|---|---|
| Hit | 올바른 내용의 알림을 허용 구간 안에서 적어도 한 번 함 |
| Early-trigger | 트리거 윈도 전에 한 번이라도 발화함 |
| Late-trigger | 윈도 끝과 허용치를 지난 뒤 한 번이라도 발화함 |
| Over-trigger | 클립 전체에서 두 번 이상 발화함 |
| Perfect | 올바른 내용을 허용 구간 안에서 정확히 한 번만 말함 |
| Fires/clip | 클립당 평균 발화 횟수 |
Hit는 추가 오발화를 무시하지만 Perfect는 무시하지 않습니다. 예를 들어 정답을 한 번 말한 뒤 같은 말을 두 번 반복하면 Hit는 유지되고 Perfect는 실패합니다. 이 차이가 뒤의 RAG 실험을 해석하는 기준이 됩니다. 다음 장은 기억을 많이 제공하는 것만으로 이 지표를 높일 수 있는지 확인합니다. §3
📖 Chapter 4: Preliminary Findings
4.1 두 관측 방식은 시각 문맥을 보존하는 방법에서 다릅니다. 윈도 방식은 1초 간격으로 뽑은 최근 4프레임을 보고 2초마다 결정합니다. 각 결정은 독립적으로 처리하고 과거 알림은 Already spoken으로 전달합니다. 스트리밍 방식은 매초 새 프레임과 응답을 문맥에 추가하며 KV 캐시, 즉 이전 계산 결과를 재사용합니다. 최대 30턴을 유지하고 한도에 도달하면 최근 4턴을 남겨 새 청크를 시작합니다. 어느 쪽도 미래 영상을 제공받지는 않습니다.
4.2 기억만 있으면 충분한가에서는 네 방법을 비교합니다. None은 기억이 없고, All-history는 전체 기록을 넣되 문맥 길이를 넘으면 최근 부분으로 자릅니다. Summary는 200~300단어 요약입니다. Standard RAG는 현재 관측으로 검색한 원시 이벤트 상위 $k$개를 매 결정에 넣습니다. $k\in\{1,2,5,10,30,50\}$를 비교해 모델별 가장 좋은 결과를 보고합니다.
| 윈도 방식의 모델 | None | All-history | Summary | Standard RAG |
|---|---|---|---|---|
| Qwen3.8-27B | 0.0 | 1.5 | 0.0 | 7.0 |
| GPT-5.3-Chat | 0.0 | 0.0 | 1.5 | 10.0 |
| claude-sonnet-5 | 0.6 | 6.1 | 4.4 | 15.0 |
| gemini-3.1-flash-lite | 0.0 | 0.0 | 0.0 | 8.5 |
수치는 원문 Table 3의 Perfect(%)입니다. 여기서 All-history는 모든 모델이 618K토큰 전부를 실제 문맥에 보존했다는 뜻이 아닙니다. 원문이 명시한 길이 초과 시 절단 조건을 함께 읽어야 합니다. Table 3
GPT-5.3-Chat의 All-history는 부록 전체 표에서 Hit 83.9%이면서 Over-trigger 99.9%, Perfect 0%입니다. 정답을 한 번 찾는 것과 필요한 때에만 말하는 것이 얼마나 다른지 보여 줍니다. Qwen의 RAG도 Hit 42.5%이지만 Perfect는 7.0%에 그칩니다. 저자들은 이를 검색 능력만으로 내용·시점 결합 문제를 해결하지 못한다는 근거로 읽습니다.
4.3 내용과 시점 중 무엇이 부족한가는 150클립의 별도 진단입니다. 관측 창과 프롬프트, 관찰 단계, 과거 발화 전달은 동일하게 유지하고, 근거 슬롯에 어떤 기억을 언제 넣는지만 바꿉니다. “시점 제공”은 모델의 발화 버튼을 강제로 누르는 것이 아닙니다. 윈도 안에서만 근거를 넣고 밖에서는 none을 넣으며 모델은 여전히 매 단계 결정합니다.
| 기억 내용 | 기억을 넣는 시점 | Qwen3.8-27B Perfect | GPT-5.3-Chat Perfect |
|---|---|---|---|
| 오라클 | 정답 윈도 안에서만 | 77.3% | 96.0% |
| 오라클 | 매 단계, 시점은 모델 선택 | 26.0% | 38.0% |
| Standard RAG | 정답 윈도 안에서만 | 7.3% | 15.3% |
| Standard RAG | 매 단계, 시점은 모델 선택 | 5.3% | 8.0% |
출처는 Table 4입니다. 오라클과 정답 시점을 함께 제공하면 근거가 나타나는 것 자체가 발화 신호입니다. 따라서 96.0%는 자율 판단의 성능보다, 내용과 시점이 모두 준비됐을 때 생성기가 도달하는 상한 조건으로 읽어야 합니다. 오라클을 늘 보여 줘도 점수가 떨어지고, 시점을 알려 줘도 검색 근거가 부정확하면 점수가 떨어집니다. 이 장의 진단이 다음 장의 그래프와 게이트 설계를 각각 뒷받침합니다.
📖 Chapter 5: Method
5.1 하네스는 기존 윈도·스트리밍 관측 방식을 유지하면서 근거 슬롯을 채우는 절차를 바꿉니다. 첫 모델 호출은 지금 집중하는 물체를 짧은 명사구로 관찰합니다. 이어 기억 검색과 게이트가 실행되고, 두 번째 모델 단계가 정제된 근거·현재 장면·이전 알림을 받아 추론과 답을 냅니다. 학습 없는 하네스만 적용할 때는 모델 가중치를 바꾸지 않습니다.
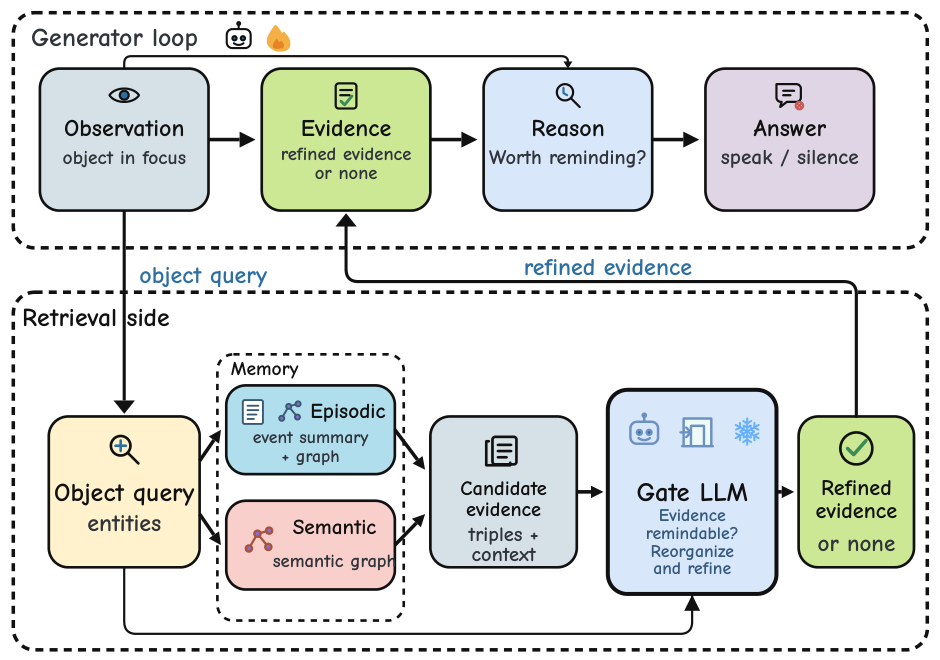
MemoProAgent의 생성 루프와 검색·게이트 연결. 원문 v2 PDF Figure 5(p.10), HTML Figure 8의 그림 영역만 크롭했으며 라벨·구조는 변경하지 않았습니다. 출처: Shenglai Zeng 외, PDF p.10 · HTML 그림
그림 아래쪽은 현재 물체 → 두 기억 층 → 후보 근거 → 게이트 → 정제된 근거 또는 없음의 경로입니다. 위쪽 생성 루프는 그 근거를 받아 현재 장면과 함께 판단한 뒤 알림 또는 침묵을 출력합니다.
기억은 에피소드와 의미의 두 층으로 구성됩니다. 에피소드에는 물체와 관련된 과거 사건 및 시각 정보를 붙이고, 의미 층에는 반복되는 선호·습관·제약을 둡니다. 해결되지 않은 의도나 주의사항에는 오픈 루프 표시를 붙입니다. 이 표시는 알림을 자동 확정하는 규칙이 아니라 찾아볼 가치가 있는 후보라는 단서입니다.
검색은 관찰한 물체를 임베딩으로 가까운 개체 노드에 연결하는 데서 시작합니다. 한 홉으로 연결된 경험과 의미 사실을 모으고, Personalized PageRank로 그래프를 전파해 직접 같은 이름을 쓰지 않는 관련 경험까지 찾습니다. PageRank는 연결망을 따라 관련 노드에 점수를 분배하는 방법이며, 여기서는 관찰 물체에 가까운 노드에서 출발한다는 점이 중요합니다.
게이트는 한 번의 LLM 호출로 후보를 읽습니다. 기억이 사실이더라도 지금 물체와 관계없는 문제이거나 이미 해결된 필요라면 발화 근거로 쓰지 않습니다. 남은 내용은 특정 사실 한 가지로 정제하거나 none을 반환합니다. 다만 게이트가 발화를 직접 확정하는 것은 아닙니다. 생성기가 현재 물체가 실제로 보이는지, 지금 행동 가능한 필요인지, 같은 필요를 이미 알렸는지 판단합니다. 기억의 관련성 → 개입의 정당성 → 최종 발화가 나뉘어 있습니다.
5.2 후속 학습은 하네스가 완벽하지 않고 생성기도 올바른 시점을 놓친다는 진단에서 출발합니다. 생성기는 관찰→도구 호출→도구 근거 수신→추론·응답의 궤적을 만듭니다. 검색기가 주입한 근거 토큰은 생성기의 출력이 아니므로 손실 계산에서 마스킹하고, 생성기가 실제로 쓴 관찰·추론·응답 토큰만 정책 기울기에 기여하게 합니다.
정답 행동 $g_t$는 현재가 트리거 윈도 안이고 이전에 발화하지 않았으면 fire, 그 외에는 silent입니다. 원문 보상식은 다음과 같습니다.
$y_t$는 모델이 택한 발화·침묵 행동, $a$는 발화한 알림입니다. 침묵해야 할 때 침묵하거나, 말해야 할 때 올바른 알림을 내면 +1입니다. 그 외에는 −1입니다. 이미 발화한 뒤 반복하면 같은 윈도 안이어도 벌점을 받습니다. 시점을 잘못 고른 발화는 내용 판정기에도 보내지 않습니다. 상태마다 4개 궤적을 만들고 GRPO로 학습합니다. GRPO는 같은 상태의 여러 응답 보상을 상대적으로 비교하는 정책 최적화 방식입니다. §5.2
📖 Chapter 6: Experimental Results
6.1 설정은 학습 904클립과 평가 800클립을 구분합니다. 윈도 방식에서는 Qwen3.8-27B가 생성기와 게이트를 맡고, GPT-5.3-Chat을 두 역할에 적용한 학습 없는 결과도 별도로 제시합니다. 스트리밍에서는 Qwen 외 VideoLLM-online과 MMDuet2를 비교합니다. RAG 비교군은 검색 개수를 바꿔 가장 좋은 설정을 택합니다. 따라서 제안 방식은 임의의 불리한 RAG 설정 하나와만 비교된 것은 아닙니다.
6.2 주 결과에서 Qwen의 윈도 Perfect는 RAG 7.0% → 하네스 37.5% → GRPO 42.4%입니다. 스트리밍은 1.0% → 33.3% → 40.6%입니다. 학습 없는 하네스의 개선과 그 위에 더한 학습 효과를 분리해서 읽어야 합니다. GPT-5.3-Chat의 학습 없는 하네스는 부록 F에서 38%를 보고합니다. 이는 §4.3의 오라클 기억·자율 시점 조건이 우연히 같은 38%인 것과 다른 실험입니다.
강화학습 전후 윈도 Hit는 54.6%에서 54.0%로 거의 그대로인 반면 Over-trigger는 22.3%에서 13.5%로 줄어듭니다. 저자들은 내용 판정기를 만족시키는 문장만 학습했다기보다, 언제 얼마나 자주 말할지의 규율이 좋아진 것으로 해석합니다. 이 해석의 근거는 시점·횟수 지표의 변화입니다. 독립된 새 내용 판정기로 결과를 검증했다는 보고는 아닙니다. 보상과 평가에 같은 판정기가 쓰였다는 조건은 남겨 두어야 합니다.
검색 개수 변화도 같은 설명을 지지합니다. 원문 PDF Figure 6, HTML Figure 12에서는 RAG의 검색 개수를 늘릴수록 Hit는 일부 좋아지지만 발화 횟수와 반복이 함께 늘어 Perfect가 떨어집니다. 여기서 검색 재현율을 높이는 것만으로 사용자의 관점에서 더 좋은 에이전트가 되지는 않습니다. 아래 핵심 수치 표에서 발화 횟수를 함께 제시한 이유입니다.
6.3 추가 분석은 세 부분으로 이어집니다. 첫째, 보지 못한 EPIC-KITCHENS의 100사례에 추가 적응 없이 적용합니다. RAG의 Perfect는 최대 11.0%인 반면 하네스는 윈도 41.0%, 스트리밍 37.0%이고, Ego4D로 학습한 생성기까지 쓰면 49.0%, 41.0%입니다. 이는 보고한 교차 데이터셋 전이 결과이지 모든 실환경의 보장은 아닙니다.
둘째, 기억 속 정답 근거를 제거한 알림 불필요 클립 150개에서 한 번이라도 잘못 발화한 비율을 측정합니다. RAG는 윈도 77.3%, 스트리밍 84.0%이고 하네스는 두 방식 모두 15.3%입니다. GRPO 이후에는 각각 14.0%, 14.7%입니다. 양성 클립의 Perfect와 알림 불필요 클립의 오발화율은 분모와 의미가 다릅니다.
셋째, 평가셋 중 별도로 뽑은 150사례에서 구성요소를 제거합니다. 윈도 하네스 기준 Perfect 37.3%에서 게이트를 빼면 24.0%로 13.3%p 하락합니다. 게이트를 유지해도 그래프를 일반 RAG로 바꾸면 16.6%p 하락하고, 이전 발화 기록을 숨기면 8.0%로 떨어집니다. 검색·게이트·이전 발화 정보가 서로 다른 역할을 맡는다는 결과입니다. 37.3%를 전체 800클립의 37.5%와 같은 실험의 불일치로 읽으면 안 됩니다. §6
📖 Chapter 7: Conclusions
결론은 기억이 무엇을 말할지만 아니라 언제 말할지를 결정한다는 문제로 돌아옵니다. 내용·시점 통제 실험이 난점을 드러내고, 그래프와 게이트를 갖춘 하네스가 두 축에 대응하며, 후속 학습이 반복·조기 발화를 더 억제한다는 흐름입니다. 저자들은 하네스만으로 37.5%, 학습을 더해 42.4%의 엄격한 성공률을 얻었다고 정리합니다. 이 수치는 Qwen3.8-27B의 윈도 평가 조건에 해당합니다. §7
📖 Chapter 본문 뒤 진술: Limitations → AI Use Statement → Reproducibility Statement → Ethics Statement
Limitations는 세 가지 범위를 명시합니다. 첫째, 장기 기억은 실제 다중모달 기록이 아닌 합성 텍스트 캡션입니다. 이를 통해 정답 근거와 시점을 통제할 수 있었지만 자연스러운 다중모달 기억으로 확장하는 것은 후속 과제입니다. 둘째, 과제 성능을 평가했으며 하드웨어·인프라·네트워크에 영향을 받는 종단 간 지연은 평가하지 않았습니다. 불필요한 검색 생략이나 빠른 모델과 느린 모델의 결합도 저자들이 남긴 과제입니다. 셋째, 클립당 트리거가 하나이므로 여러 트리거와 더 다양한 상황, 장기 기억 안의 적대적 콘텐츠로 확장할 여지가 있다고 적습니다.
AI Use Statement는 기억 근거·사용자 페르소나·1년 이벤트·캡션 합성에 생성형 AI를 사용했다고 공개합니다. 모델 품질 검수와 32명의 훈련된 주석자의 독립 검토를 통과한 사례를 포함했으며, 논문 문장 윤문에도 생성형 AI를 사용했다고 명시합니다. Reproducibility Statement는 데이터 구성, 구현 프롬프트, 게이트·판정기, 학습 설정을 각 부록에 연결합니다. 원문에는 코드와 평가셋을 출판 시 공개한다는 문구와 함께 코드·데이터 링크가 실려 있습니다. 이 리뷰는 링크로 안내된 산출물을 직접 실행해 결과를 재현한 것은 아닙니다.
Ethics Statement에서는 합성 개인 기록이 실제 개인을 가리키지 않음을 밝힙니다. 동시에 주변을 계속 관측하고 장기 활동 기록을 남기는 보조 시스템은 배포 시 프라이버시 문제를 해결해야 한다고 적습니다. 잘못된 개입이 부과하는 방해 비용을 연구하는 것이 상시 촬영을 권장한다는 뜻은 아니라는 경계도 둡니다. 이어지는 References는 본문 주장과 선행 연구의 연결을 제공하며, 개별 참고문헌 전체를 이 리뷰에서 다시 검증하지는 않았습니다. 원문 본문 뒤 진술
📖 Chapter Appendix A: MemoProAgent Details
A.1 개요는 Algorithm 1과 공통 게이트 프롬프트를 공개합니다. 게이트는 원시 이벤트 문장, 지속적인 규칙, 에피소드 트리플을 받습니다. 과거의 불편·실수·미해결 필요가 현재 물체와 같은 계열에 속하면 구체적인 사실로 살리고, 뒤의 기록이 명확히 해결했다면 none을 출력합니다. 결과는 FACT: ... 또는 FACT: none 한 줄입니다. 이 프롬프트는 “과거 이야기처럼 쓰였다”는 이유만으로 유용한 필요를 버리지 않도록 높은 회수율도 요구합니다. 따라서 단순히 모든 기억을 보수적으로 삭제하는 장치는 아닙니다.
A.2 윈도 구현은 첫 호출에서 <observe>를 만들고, 검색 근거를 주입한 같은 대화의 다음 단계에서 <reason>과 <answer>를 내도록 합니다. 네 프레임의 시각 문맥은 결정마다 새로 처리하지만 이미 한 알림은 명시적으로 전달합니다. A.3 스트리밍 구현은 현재 프레임을 중심으로 같은 두 단계를 수행하되 최근 영상·응답 문맥을 누적합니다. 30턴 한도와 최근 4턴 보존 조건이 여기서 구체화됩니다. 두 구현 모두 근거가 없거나 지금 행동할 수 없거나 이미 알린 필요면 NO_REMINDER를 요구합니다. 부록 A
📖 Chapter Appendix B: Baseline Implementation Details
B.1 윈도 비교군에서 None·All-history·Summary는 기억 블록만 달리하여 한 번의 호출로 추론과 답을 냅니다. Standard RAG는 관찰 출력으로 원시 문장을 검색한 뒤 근거를 넣는 두 단계입니다. 후자의 검색 결과에는 MemoProAgent의 게이트와 정제가 없습니다. MemoProAgent와 비교할 때 호출 단계의 존재 자체와 게이트의 존재를 혼동하지 않아야 합니다.
B.2 스트리밍 비교군은 Qwen의 누적 문맥과 30턴 청크 처리를 설명한 뒤 VideoLLM-online·MMDuet2의 조정 방식을 공개합니다. 두 모델은 원래 스트리밍 상태와 시스템 프롬프트를 유지합니다. 별도 현재 프레임 관찰기가 검색어를 만들고 원시 문장 상위 3개를 현재 결정에만 주입합니다. Qwen의 두 단계 프로토콜을 두 비교군에도 그대로 실행했다고 쓰면 정확하지 않습니다. 부록 B
📖 Chapter Appendix C: Data Construction Pipeline
데이터 생성은 네 단계로 이어집니다. 1단계 트리거 위치 결정에서는 영상에서 대상 물체를 골라 전체 클립의 가시 구간을 추적하고, 8초 이하로 떨어진 구간을 합쳐 시작과 끝을 정합니다. 2단계 기억 버블 생성에서는 그 물체를 보는 순간 도움을 줄 만한 과거 경험·사용자 사실을 합성하고, 근거성·대상 특이성·알릴 필요를 검사합니다.
3단계 긴 생애 기록 생성에서는 사용자 페르소나와 1년 이벤트를 만듭니다. 큰 삶의 사건, 페르소나에 맞는 관심사, 일상 방해 정보, 정답 근거를 섞어 시간표시 행동·대화 캡션으로 풀어냅니다. 4단계 검수는 영상과 기억의 일치, 시점의 타당성, 무관한 물체의 오염 여부를 모델로 확인한 뒤 사람이 유지·수정·기각합니다. 긴 기억을 만든 뒤 우연히 트리거를 찾는 순서가 아니라, 트리거와 작은 근거를 먼저 만들고 그것을 긴 기록에 넣는 순서입니다.
C.1 사람 주석에서는 후보 2,168개 중 2,153개가 적어도 한 번 판단을 받았고, 32명이 5,982개 판단을 제공했습니다. 1,889개, 즉 검토 사례의 87.7%가 세 명에게 독립 검토됐습니다. 질문은 물체의 가시성, 트리거 경계, 알림 이유, 기억·이벤트 일치 여부입니다. 윈도 판단의 82.7%는 유지, 14.2%는 조정, 3.1%는 사용할 수 없음으로 분류됐습니다. 다수결로 수용된 1,804개는 검토된 2,153개 중 83.8%입니다. 2,168개 전체를 분모로 한 수용률로 옮기지 않았습니다. 부록 C
📖 Chapter Appendix D: Data Details
D.1은 장면과 알림 이유, 전체 영상과 짧은 트리거 구간의 시간 분포를 보여 줍니다. D.2는 과거 기억과 실제 발화 시점 주변 프레임을 짝지은 사례들을 제시합니다. 올바른 알림은 일반적인 생활 조언이 아니라 특정한 기억과 현재 기회의 연결이어야 한다는 정의를 사례로 확인하는 부분입니다.
D.3 캡션 예시에서는 큰 삶의 사건·관심사·무관한 일상·정답 근거가 같은 형식으로 섞입니다. 바질 화분 가운데 물을 부어 흙이 패였던 경험은 물이 고임→흙이 내려앉음→“다음에는 가장자리에”라는 발언으로 풀립니다. 핵심 사실이 한 문장 메모로 이미 정리돼 주어지는 것이 아니라 긴 행동·대화 속에 들어갑니다.
D.4 요약과 기억 비교는 사과가 다 떨어진 사례를 사용합니다. 200~300단어 요약은 사용자의 성향·루틴·일반적인 보충 필요를 담지만, 마지막 사과를 먹었고 다음 과일 가게에서 사야 한다는 구체적 의도는 빠집니다. 이는 해당 예시에서 요약이 놓친 것을 보여 주며, 모든 요약 모델이 항상 이 사실을 잃는다는 증명은 아닙니다. 부록 D
📖 Chapter Appendix E: Preliminary Study under the Streaming Paradigm
부록 E는 §4의 진단을 스트리밍에서도 반복합니다. RQ1에서 Qwen의 요약·RAG Perfect는 각각 0%, 1.0%이고 MMDuet2는 둘 다 0%입니다. 별도 150클립의 내용·시점 통제 실험에서는 Qwen의 오라클·시점 제공 72.7%, 오라클·자율 시점 18.0%, RAG·시점 제공 6.7%, RAG·자율 시점 1.3%입니다. 주 평가의 Qwen RAG 1.0%와 마지막 1.3%는 평가 범위가 다릅니다. 시각 문맥을 더 오래 보존해도 내용·시점 두 축이 필요하다는 진단은 유지됩니다. 부록 E, Tables 15–16
📖 Chapter Appendix F: MemoProAgent on a Frontier Model
GPT-5.3-Chat에 가중치 변경 없이 하네스를 적용한 윈도 평가를 제시합니다. 기억 비교군은 Perfect 최대 10%이고 MemoProAgent는 38%입니다. 이 결과는 하네스의 이득이 학습한 Qwen에만 나타나는 것은 아니라는 근거입니다. 다만 GPT까지 GRPO로 후속 학습한 결과를 제시한 것은 아닙니다. 부록 F
📖 Chapter Appendix G: Post-Training Details
학습 입력은 평가 UID와 겹치지 않는 904클립에서 추출한 시점 수준 상태 3,465개입니다. 윈도 안 발화 상태 1,283개, 이른 상태 642개, 이미 발화한 상태 1,283개, 근거 없는 보호 상태 257개로 구성합니다. 해당 시점 이전의 응답 이력은 오라클 이력으로 제공합니다. 따라서 모든 학습 데이터가 에이전트의 처음부터 끝까지 자율 실행으로 생성됐다고 해석하지 않습니다.
최적화는 MS-Swift GRPO와 LoRA rank/alpha 16/16을 사용하며 시각 인코더와 정렬 모듈은 고정합니다. 상태당 4개 롤아웃으로 963업데이트를 수행합니다. BF16·AdamW, 학습률 $10^{-6}$, weight decay 0.01, gradient clipping 1.0, GRPO clipping 0.2, KL 계수 0.01을 보고합니다. 롤아웃은 temperature 1.0, top-p 0.95, 응답 총 528토큰 예산이며 관찰 48토큰·최종 답 160토큰을 둡니다. H100 7대에서 14.6시간이 보고됐습니다. 이는 논문 학습 구성의 비용이며 배포 지연 측정은 아닙니다. 부록 G
📖 Chapter Appendix H: LLM Judge Prompt
판정기는 GPT-4o이며, 발화·현재 프레임·정답 기억을 보고 memory_grounded, correct, useful을 판단합니다. 기억에 근거하지 않으면 NON_MEMORY, 정확하지 않으면 BAD, 정확해도 구체적으로 도움이 되지 않으면 BASIC, 세 조건을 충족하면 GOOD입니다. 내용 정답으로 세는 것은 GOOD뿐입니다.
현재 화면에 보이는 상품명을 말하는 것만으로는 기억을 사용했다고 인정하지 않습니다. 반대로 기억 속 사실을 왜곡하지 않고 현재 상황에 적절한 행동을 제시해야 합니다. 시점·횟수의 정답은 트리거 주석으로 확인하고 내용의 적절성은 LLM 판정으로 확인한다는 평가 분업을 이해해야 결과를 해석할 수 있습니다. 부록 H
📖 Chapter Appendix I: MemoProAgent Memory Construction Details
I.1 그래프 구축에서는 60초를 넘는 시간 간격으로 이벤트를 나누고, 물체·상태·장소·직접 발언·의도·결과를 보존한 1인칭 사건 문장으로 다시 씁니다. 이어 OpenIE로 주어–관계–목적어 트리플을 추출하고 날짜·시간·이벤트 ID·원시 캡션 출처를 붙입니다. 의미 사실은 40개 이벤트 묶음에서 습관·선호·안전 규칙처럼 재사용할 사실만 추출합니다. 개체 동시 등장, 의미의 공동 언급, 임베딩 기반 동의 관계를 그래프 간선으로 사용합니다.
I.2 추론 시 검색은 개체명 임베딩에 가까운 노드를 시작점으로 삼습니다. 한 홉 에피소드와 의미 트리플, PageRank로 찾은 관련 사건을 합칩니다. 에피소드 순위에는 개체 유사도·오픈 루프·최근성을 쓰고, 범용 허브 개체의 영향은 낮춥니다. 게이트에는 사건 문장→지속적 의미 사실→개별 에피소드 트리플 순으로 렌더링해 인과적 이야기와 짧은 사실을 함께 줍니다.
I.3 예시의 우유 기록은 이 변환을 잘 보여 줍니다. “우유통이 거의 비었고 다음 장보기 때 사야겠다”는 경험에서 사용자 의도와 물체 상태를 추출하고, [우유통, 필요, 다음 장보기 때 보충]이라는 물체 중심 오픈 루프도 만듭니다. 그 덕분에 눈앞의 우유통→개체 검색→거의 빈 상태와 보충 의도→원래 사건 문장으로 이어집니다. 이 오픈 루프의 복제는 사람이 말한 의도를 눈에 보이는 물체에서 다시 찾기 쉽게 만드는 처리입니다. 부록 I
📖 Chapter Appendix J: Full Main-Result Tables
마지막 부록은 본문의 축약 표에서 빠진 None·All-history·Summary와 각 스트리밍 모델의 전체 행동 지표를 제공합니다. 예를 들어 Qwen 스트리밍 None은 Perfect 0%, Over-trigger 99%, 클립당 24회 발화입니다. VideoLLM-online Summary는 클립당 발화가 0.10회로 적지만 Perfect도 0%입니다. 많이 말하는 실패와 거의 말하지 않아 필요한 기회까지 놓치는 실패가 모두 존재한다는 뜻입니다. 아래의 주 결과 표는 이 전체 표 중 Qwen의 동일 조건 비교를 추려 다시 작성한 것입니다. 부록 J, Tables 20–21
실험 결과 심층 분석
하네스의 효과와 후속 학습의 효과를 나눠 읽기
아래는 원문 Table 5 및 부록 J에서 Qwen3.8-27B 결과를 옮긴 표입니다. Perfect·Hit·반복·이른 발화·늦은 발화는 %, 마지막 열은 횟수입니다. 주 평가셋은 800클립이며, 별도 150클립의 오라클 진단·구성요소 제거 실험과 구분합니다.
| 방식 | 방법 | Perfect ↑ | Hit ↑ | 반복 ↓ | 이른 발화 ↓ | 늦은 발화 ↓ | 발화/클립 ↓ |
|---|---|---|---|---|---|---|---|
| 윈도 | Standard RAG | 7.0 | 42.5 | 67.5 | 59.5 | 28.5 | 3.58 |
| 윈도 | MemoProAgent 하네스 | 37.5 | 54.6 | 22.3 | 20.9 | 5.8 | 1.06 |
| 윈도 | 하네스 + GRPO | 42.4 | 54.0 | 13.5 | 19.3 | 4.0 | 0.90 |
| 스트리밍 | Standard RAG | 1.0 | 53.5 | 90.0 | 73.0 | 52.5 | 10.17 |
| 스트리밍 | MemoProAgent 하네스 | 33.3 | 60.0 | 32.8 | 26.1 | 6.4 | 1.38 |
| 스트리밍 | 하네스 + GRPO | 40.6 | 60.4 | 25.3 | 24.0 | 7.0 | 1.25 |
윈도 하네스의 RAG 대비 개선은 30.5%p, 그 위에 더한 GRPO 개선은 4.9%p입니다. 두 값을 모두 학습의 효과라고 부르면 하네스의 기여를 놓칩니다. 스트리밍에서도 하네스가 32.3%p를 높이고 GRPO가 추가 7.3%p를 높입니다. 서로 다른 관측 방식의 최종 점수를 단순한 모델 우열로 읽기보다, 각 방식 안에서 동일 백본의 절차 변화로 비교하는 편이 정확합니다.
강화학습 후 모든 지표가 일제히 좋아지는 것도 아닙니다. 윈도 Hit는 0.6%p 낮아지고 스트리밍 Late-trigger는 6.4%에서 7.0%로 높아집니다. 그럼에도 Perfect가 높아지는 것은 클립 전체의 내용·시점·한 번만 발화라는 조건을 더 자주 함께 만족하기 때문입니다. 오발화를 억제하는 것과 필요한 기회를 전부 잡는 것은 같은 목표가 아닙니다.
진단 실험이 말하는 것과 말하지 않는 것
오라클 실험은 정확한 근거와 전달 시점이 성능을 좌우한다는 직접적인 진단입니다. 그러나 오라클 윈도 안에서만 근거를 넣으면 근거의 존재가 정답 시점을 드러내므로, 이를 실제 배포 성능과 같은 숫자로 비교하지 않아야 합니다. 합성 기억을 사용했기 때문에 가능한 통제이자, 그 실험이 측정하는 조건입니다.
구성요소 제거 실험은 게이트·그래프·발화 이력 각각이 결과에 기여함을 보입니다. 다만 해당 점수 차이만으로 모든 개선이 특정 한 구성요소의 보편적 인과 효과라고 확대하지 않습니다. 결과는 논문이 정한 150사례와 프롬프트·백본·기억 구축에 대한 것입니다. 유의성 검정이나 신뢰구간은 논문에 보고되지 않았습니다. 수치 차이를 통계적으로 유의하다고 표현하지 않았습니다.
재현에 필요한 정보로는 학습·평가 분리, 주요 프롬프트, 판정 규칙, 그래프 구축 단계, 학습 하이퍼파라미터가 제공됩니다. 이 리뷰에서는 원문과 표·수식을 대조했으며 자체 벤치마크를 실행하지 않았습니다. 종단 간 지연과 실제 개인 데이터 기반의 장기 배포 결과는 저자들도 이번 평가 범위에 넣지 않았습니다.
기술적 함의와 응용
이 연구가 보여 주는 변화는 기억의 검색 성공을 사용자의 도움받은 경험과 구분해야 한다는 것입니다. 질문에 답하는 시스템에서는 적절한 근거를 한 번 꺼내는 일이 주목받지만, 먼저 개입하는 시스템에서는 그 근거가 아직 유효한지, 지금 행동할 수 있는지, 이미 말한 내용인지를 추가로 판단해야 합니다. Perfect와 알림 불필요 클립의 오발화율은 이 차이를 서로 다른 측면에서 측정합니다.
필자의 해석으로는 그래프와 게이트의 역할 분리가 특히 유용합니다. 그래프는 물체에서 과거 의도·제약으로 이어지는 길을 만들고, 게이트는 그 길 끝의 정보가 지금 개입할 이유인지 확인합니다. 생성기에는 정제된 근거를 주되 최종 발화 판단과 이력 확인은 남겨 둡니다. 정보가 많이 검색됐다는 이유로 곧바로 알림을 보내는 구조보다, 각 단계가 어떤 판단을 맡는지 드러납니다.
적용 범위를 판단할 때는 합성 텍스트 기억, 클립당 하나의 트리거, 지연 미평가라는 원문 조건을 함께 보아야 합니다. MemoProAgent는 기억을 많이 보유하는 보조자보다 필요한 기억을 찾아 적절한 순간에 한 번만 말하는 보조자를 평가하고 설계하는 방법을 제시합니다.