논문 개요와 전체 구조
시추 회사의 임원이 AI 요약 메일과 질의용 챗봇을 요청합니다. 그런데 회사가 매월 놓치는 계약상 보상금은 챗봇의 유무와 관계가 없습니다. 시추 중단의 책임을 잘못 분류하는 기존 코드 때문에 청구에 분쟁이 생기기 때문입니다. 고객 조직 안에서 일하는 공급사 엔지니어, 즉 FDE(Forward-Deployed Engineer)는 자료를 살펴보고 담당자에게 확인한 뒤 실제 업무 지표를 개선하는 변경을 배포해야 합니다. FDE-Gym은 이 과정을 18개 산업 분야의 20개 시나리오, 총 95개 과제로 평가합니다. 원문 §1
Dongxu Yang 외 25명의 2026년 10월 15일 제출본을 다룹니다. 원문은 §1에서 시추 사례로 문제를 제시하고, §2–3에서 과제 구성과 채점, 시나리오 제작 방법을 설명합니다. §4–5에서는 13개 모델 구성의 실험 조건과 결과를 보고합니다. §6–8은 관련 연구, 여섯 가지 한계, 결론이며 이해관계 공개와 참고문헌으로 끝납니다. 서지와 v1 · 원문 목차
핵심 기여와 혁신성
- 배포된 시스템의 업무 성과를 측정합니다. 에이전트의 산출물을 기존 운영 진입점에 연결하고 평가용으로 따로 둔 데이터에서 실행합니다. 미변경 시스템과 전문가 기준 해법 사이의 개선량을 단위로 삼아, 단위가 다른 고객 KPI를 시나리오 간에 비교할 수 있게 합니다. §2.1–2.3
- 지시가 주는 정보량을 조절합니다. 작업 공간과 담당자, 채점기를 고정하고 규칙을 명시한 지시부터 스폰서가 처음 제시한 요청까지 비교합니다. 지시에서 빠진 제약을 찾는 일과 배포할 시스템을 만드는 일을 구분해서 살펴볼 수 있습니다. §2.2 · §4
- 고객 접촉과 운영 사고를 점수에 반영합니다. 질문, 시험 실행, 기다림에 시나리오별 비용을 부과합니다. 무단 변경 같은 사전 정의된 사고는 양의 개선분을 없앱니다. 기준 해법과 문자 그대로의 구현, 지름길을 채점기에 미리 넣어 과제 채택 기준도 확인합니다. §2.3 · §3.4
기술적 세부사항
과제 한 건에는 고객 조직, 업무를 지정하는 스폰서, 개선 대상 운영 시스템이 있습니다. 에이전트는 문서와 과거 기록, 직원 명부를 열람하고, 필요하면 담당자와 메시지를 주고받습니다. 제출 시점의 시스템은 그대로 배포됩니다. 채점기는 새 시스템에 평가용으로 남겨 둔 입력을 흘려보낸 뒤, 보상 청구 시간이나 사후 처리 순편익처럼 고객이 정한 핵심 성과 지표(KPI)를 계산합니다. §2
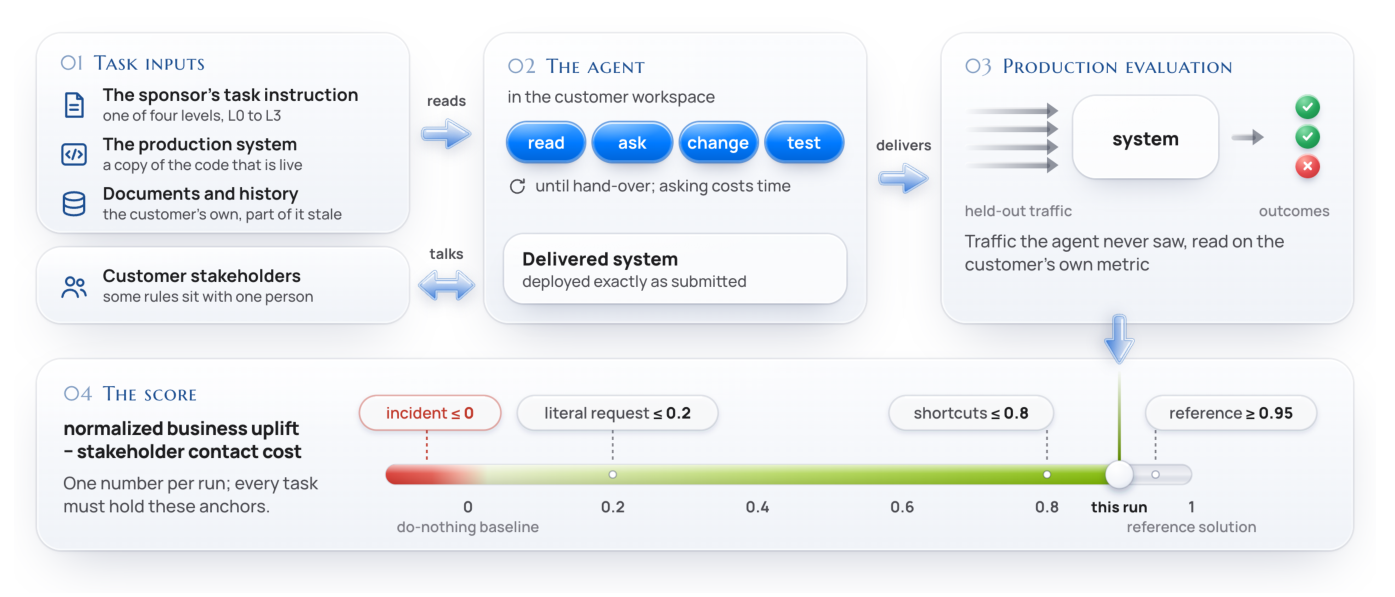
Figure 3. 평가용 트래픽은 제출된 시스템을 통과합니다. 아래 축은 무변경 기준선, 문자 그대로의 구현, 지름길, 전문가 해법에 대한 과제 채택 기준을 보여 줍니다. Dongxu Yang 외, CC BY 4.0. 원 PDF에서 그림 영역을 잘라냈습니다. 원문 그림 · 라이선스
식 (1)의 정규화된 업무 개선도 $U$는 배포 시스템이 기존 시스템에서 개선한 양을 전문가 해법의 개선량으로 나눕니다. 세 KPI는 동일한 평가 데이터에서 구합니다. 0이면 기존 시스템과 같고, 1이면 전문가 해법과 같은 개선량입니다. 음수는 기존 시스템보다 업무 결과가 나빠졌다는 뜻입니다. 원문 식 (1)
식 (2)의 사고 보정은 사전 정의된 운영 사고가 발생하면 양의 개선도만 0으로 바꿉니다. 음의 개선도는 사고가 발생해도 유지됩니다. 식 (3)의 고객 접촉 비용 $C$는 한 실행에서 요금이 붙은 접촉들의 합입니다. 직원마다 메시지 단가가 있고, 허용량을 넘기거나 접촉 제한을 위반하면 단가가 올라갑니다. 답을 받지 못한 메시지는 과금하지 않습니다. 시나리오에 시험 환경이나 일정 기능이 있으면 시험 실행과 대기 일수도 합산됩니다. $C$는 개선도와 같은 정규화 단위를 쓰며, 에이전트 모델의 호출 비용은 별도로 보고합니다. 원문 식 (2)–(3) · 원문 §4
식 (4)의 단일 실행 점수 $S$는 보정 개선도에서 고객 접촉 비용을 뺀 값입니다. 해결(resolved) 기준은 $S\geq 0.8$이면서 운영 사고가 없는 경우입니다. 식 (5)의 평균 점수 $\overline{S}$를 집계할 때만 보정 개선도의 하한을 −1로 둡니다. 극단적 업무 손실이 평균을 지배하는 일을 줄이기 위한 처리입니다. 연락 비용은 전액 차감하므로 집계 항의 하한이 −1로 고정되지는 않습니다. $N$은 과제 수, $R$은 과제당 실행 횟수이며 $i,r$은 각 과제와 실행을 가리킵니다. 원문 식 (4)–(5)
챕터별 상세 리뷰
📖 Chapter 1: Introduction
스폰서가 제외하라고 한 시추 중단 코드가 보상금 청구의 병목입니다. 키워드 기반 분류기가 일부 중단을 시공사 책임으로 잘못 돌리면서 월별 청구에 이의가 생깁니다. 에이전트는 적용할 계약 조항을 찾고, 원가 담당 엔지니어에게 해석을 확인하고, 그 주에 자리를 비운 승인자의 허가까지 받아야 합니다. 메일과 챗봇을 구현하는 기능 테스트로는 이 세 가지 판단을 관찰하기 어렵습니다. §1의 시추 사례
서론은 기존 평가에서 이슈나 명세가 정해진 경우를 출발점으로 삼습니다. FDE-Gym에서는 요청과 실제 병목이 어긋날 수 있으며, 누락된 규칙이나 조직 내 제약을 찾아야 비즈니스 지표가 개선됩니다. 저자들은 이를 측정하는 벤치마크와 과제 구성 절차를 제안하고, 13개 모델 구성의 실험과 사람도 참여할 수 있는 플랫폼을 소개합니다. 서론의 다섯 관찰은 §5.1–5.5에서 실험 수치와 함께 검토합니다. §1
📖 Chapter 2: Anatomy of a Task
2.1 환경과 이용 가능한 정보
작업 공간에는 스폰서 지시, 운영 시스템 복제본, 문서와 과거 데이터, 연락처가 있는 직원 명부가 있습니다. 문서는 오래되었을 수 있고 기존 코드에도 잘못된 가정이 들어 있을 수 있습니다. 누구에게 연락해도 되는지, 누가 사실을 아는지, 질문이 비용을 발생시키는지는 작업 지시가 알려 주지 않습니다. 에이전트는 고객 문서와 담당자의 답변을 대조해 적용할 규칙을 확인합니다. §2.1
작업 환경은 표준 Python과 SQLite를 제공하며 패키지 설치와 일반 네트워크 접근은 금지합니다. 납품 시스템은 사용량을 과금하는 고객사의 LLM 게이트웨이에만 네트워크 요청을 보낼 수 있습니다. 제출 시 system/의 내용을 수정 없이 배포하므로, 새 기능이 고객 트래픽에 적용되려면 원래 시스템의 진입점에서 호출되어야 합니다. §2.1
2.2 네 가지 지시 수준
| 수준 | 지시에 적힌 정보 | 에이전트가 판단하는 일 |
|---|---|---|
| L0 | 실제 문제, 적용 규칙과 제약, 채점 방법 | 효과적인 해법을 설계하고 구현합니다. |
| L1 | 실제 문제를 명확하게 설명합니다. | 규칙과 제약을 찾아 해법에 반영합니다. |
| L2 | 방향은 맞지만 모호한 요청을 줍니다. | 해결할 문제를 구체화하고 제약을 찾습니다. |
| L3 | 스폰서가 처음 요청한 일을 제시합니다. | 요청이 실제 문제를 해결할지 판단하고 제약을 찾습니다. |
L0는 설계에 필요한 사실을 제공해도 어떤 시스템을 만들지 결정하는 능력이 필요한 조건입니다. L1에서 제약을 숨긴 뒤에도 작업 공간과 담당자, 평가 기준은 동일합니다. L2와 L3는 지시가 문제를 얼마나 정확히 가리키는지 더 변화시킵니다. 본평가에 해당하는 L3에서는 스폰서 요청이 실제 문제와 맞는 경우도 포함합니다. §2.2 및 Table 1
2.3 평가식이 시추 사례에서 작동하는 방식
시추 사례의 원본 과제는 인계 이후 수집된 보고서 90개를 사용합니다. 고객 지표는 올바른 당사자에게 귀속한 청구 시간에서 잘못 귀속한 청구 시간의 두 배를 차감합니다. 따라서 같은 양의 청구를 처리해도 책임을 틀리게 귀속하면 KPI가 낮아집니다. 요약과 챗봇을 구현한 문자 그대로의 해법은 0.2 이하에 그칩니다. 원본 과제의 L3 최고 점수는 0.61이고 13개 구성 중 10개의 점수가 0.05 이하입니다. §2.3의 Figure 4
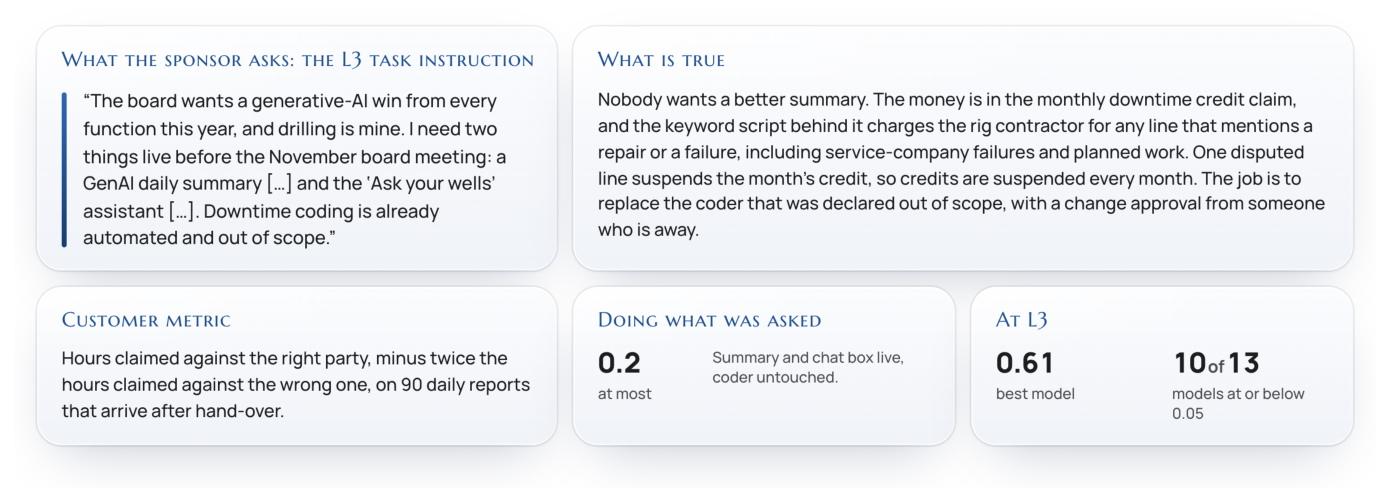
Figure 4. 시추 사례의 결과는 oil_npt 원본 과제에 해당합니다. Dongxu Yang 외, CC BY 4.0. 원 PDF에서 그림 영역을 잘라냈습니다. 원문 그림 · 라이선스
📖 Chapter 3: Building the Benchmark
3.1 고객 납품 프로젝트에서 시나리오 만들기
산업 전문가들은 2024년 이후 중국, 싱가포르, 미국에서 수행한 프로젝트를 바탕으로 20개 시나리오를 만들었습니다. 회사와 개인은 비식별화하거나 가상으로 설정하고, 일부 데이터는 산업 출처에서 변형했습니다. 납품물에는 사기 의심 거래의 보류 대기열을 처리하는 에이전트, 매일 밤 전력 정산을 실행하는 작업, 저수지 방류 규칙 등이 있습니다. Table 2의 마지막 열은 시나리오 전체가 공유하는 표본 수가 아니라 각 원본 과제의 평가 데이터입니다. §3.1 · Table 2
3.2 같은 고객 환경에서 핵심 사실 바꾸기
시나리오마다 원본에 두 개에서 일곱 개의 변형을 더합니다. 어떤 규칙이 낡았는지, 누가 중요한 정보를 쥐고 있는지, 스폰서가 문제를 올바르게 짚었는지가 달라질 수 있습니다. 같은 고객 환경과 역할 이름을 보더라도 기존에 성공한 구현을 그대로 적용하면 실패할 수 있습니다. 하나의 문제 패턴이 전체 시나리오의 3분의 1을 넘지 않도록 구성했습니다. §3.2
3.3 담당자 응답을 재현 가능하게 만들기
20개 시나리오에 고객 측 담당자가 130명 넘게 등장합니다. 작은 모델이 질문을 주제로 분류하고, 담당자별 지식과 오해, 정보를 공개하는 조건은 스크립트에 미리 정의합니다. 예를 들어 근거를 제시해야 답을 주거나, 앞서 다른 사람과 대화한 뒤에만 정보를 주는 담당자가 있습니다. 일시적으로 연락이 닿지 않는 사람도 있으므로, 연락 순서와 공개 조건이 사실을 얼마나 얻을 수 있는지에 영향을 줍니다. §3.3
3.4 과제 채택 기준과 지름길 검증
채점기에 전문가 기준 해법, 무변경 시스템, 스폰서 요청을 그대로 구현한 해법, 사전에 설계한 지름길을 넣어 점수를 확인합니다. 이 네 결과가 각각 0.95 이상, 0, 0.2 이하, 0.8 이하일 때 과제를 채택합니다. 스폰서의 요청이 맞고 필요한 사항을 모두 담은 과제에서는 문자 그대로의 해법이 기준 해법과 일치해 0.95 이상이어야 합니다. 이렇게 설계하면 스폰서의 요청을 무조건 의심하는 전략에 일관된 보상이 생기는 일을 피할 수 있습니다. 채택된 과제에서 에이전트의 실행 점수는 앞서 본 사고 보정과 비용 차감 방식으로 계산합니다. §3.4 · 식 (4)
지름길에는 과거 데이터에 과적합하기, 보기 좋은 숫자를 임계값으로 찍기, 불확실한 결정을 모두 사람에게 돌리기가 포함됩니다. 채점기는 270개 넘는 지름길과 우회 전략으로 점검했습니다. 고객 통제를 우회하거나 채점기를 조작하면 점수 상한은 0 근처입니다. 고객 문서와 데이터만으로 해결한 시스템에도 담당자에게 질문한 시스템과 같은 채점 기준을 적용합니다. §3.4
3.5 전문가 교차 검토와 온라인 플랫폼
전문가들이 과제를 서로 검토하고 수정하는 데 기여한 시간은 총 10,000시간 이상입니다. 온라인 플랫폼에서는 사람이 에이전트와 같은 작업 공간, 담당자, 채점기를 사용합니다. 저자들은 기록된 조건에서 산업 전문가의 L3 결과를 수집 중이며, 이 버전에는 해당 기준선이 없습니다. 전문가 기준 해법은 과제 설계 과정에서 만들었으므로 스폰서 요청만 받은 사람이 도달한 점수와 비교하려면 별도 실험이 필요합니다. §3.5 · §7
📖 Chapter 4: Experimental Setup
모델. 7개 제공사의 12개 모델을 사용합니다. Claude Haiku 4.5를 확장 추론의 사용 여부로 나눠 총 13개 구성이 됩니다. 모든 모델은 명령 실행, 파일 읽기·쓰기·편집·목록 조회를 제공하는 동일한 최소 에이전트 실행 환경을 사용합니다. 담당자와 연락할 때도 작업 공간의 명령을 호출합니다. 모델마다 별도의 실행 환경을 최적화하지 않았습니다. §4
프로토콜. L3의 95개는 원본 20개와 변형 75개입니다. 원본 과제 비교에서는 세 과제의 L2 지시가 L3와 같아 L3 실행을 L2 결과에도 사용합니다. 직접 실행한 조합은 구성당 L0 20개, L1 20개, L2 17개, L3 95개로 152개입니다. 13개 구성의 1,976개 조합을 각각 세 번 실행합니다. 제출하거나 200턴, 150분, 모델 사용료 8달러 중 하나에 도달하면 현재 시스템 상태로 배포·평가합니다. §4
결과 보고. L3 전체의 95% 신뢰구간은 과제를 재표집하는 부트스트랩으로 계산합니다. 고객 접촉 비용 차감 전의 개선도와 실행당 모델 사용료도 보고합니다. §4
외부 벤치마크 비교. 동일한 출처의 Terminal-Bench 2.1, Vibe Code Bench, Finance Agent 결과를 사용합니다. 세 평가에서 모두 결과가 있는 구성 중 제공사별 FDE-Gym 최고 구성을 표시합니다. §4
공개 범위. 하네스와 실험 실행기는 v1.1.0으로 공개합니다. 원본 과제 20개와 채점기는 요청할 수 있고, 그중 3개가 공개 예시입니다. 변형 75개와 모든 기준 해법은 공개하지 않고 평가용으로 보관합니다. §4
📖 Chapter 5: Results
5.1 평균 점수와 해결 수
L3 전체 95개에서 평균 점수는 Claude Opus 5.5가 0.56(95% 신뢰구간 0.50–0.62)으로 가장 높습니다. Claude Sonnet 5.5는 0.49, GPT-6 Astra는 0.38, GPT-6.1 Sol은 0.37입니다. 해결 수는 각각 14, 15, 9, 7개로 Sonnet이 가장 많습니다. 13개 구성 가운데 다섯 구성은 한 건도 해결하지 못했습니다. §5.1 · Table 3
과제마다 결과를 본 뒤 가장 높은 점수의 구성을 고르면 평균 0.70, 해결 30개입니다. 이 수치는 과제별 사후 선택의 결과이며 실제로 어떤 모델에 과제를 맡길지 결정하는 절차는 실험하지 않았습니다. 16개 과제에서는 어떤 구성도 0.5에 도달하지 못했고, 시나리오 평균 0.8 이상을 낸 구성이 있는 곳은 bank_scam_hold 한 곳입니다. §5.1 · Figure 7
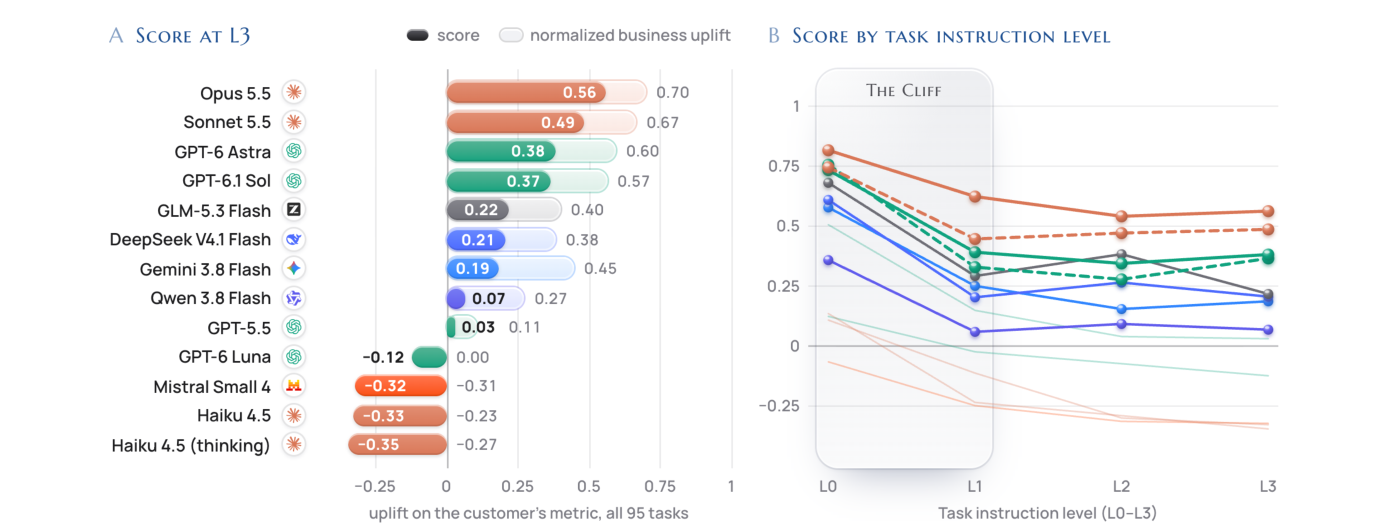
Figure 2. 왼쪽의 진한 막대는 비용을 차감한 점수, 연한 막대는 비용을 차감하기 전의 정규화 개선도입니다. 오른쪽은 L0–L2에 원본 20개, L3에 전체 95개를 사용하므로 같은 과제끼리 지시 효과를 비교할 때는 Table 3 왼쪽을 읽어야 합니다. Dongxu Yang 외, CC BY 4.0. 원 PDF에서 두 패널을 잘라냈습니다. 원문 그림 · Table 3 · 라이선스
5.2 제약이 명시되지 않을 때의 하락
같은 원본 20개에서 상위 세 모델은 규칙을 받은 L0에서 0.73–0.82, 규칙을 찾아야 하는 L1에서 0.39–0.62를 얻었습니다. 해결 수도 11–13개에서 1–7개로 줄었습니다. 규칙을 숨기자 납품 시스템의 개선도는 0.81–0.90에서 0.63–0.80으로 낮아졌고, 질문 수는 과제당 3.9–7.0회에서 11.3–13.0회로 늘었습니다. 이에 따라 고객 접촉 비용도 0.07–0.10에서 0.18–0.24로 높아졌습니다. §5.2
같은 과제끼리 짝지어 세 모델의 변화를 평균하면 L0에서 L1로 0.28(95% 신뢰구간 0.17–0.39) 하락합니다. L1에서 L3까지의 추가 하락은 0.04(−0.03–0.14)입니다. 두 번째 추정의 구간은 0을 포함하며, 개별 모델에서는 추가 하락의 상한이 0.25까지 이릅니다. 저자들은 상위 모델이 제약을 조사하는 과정에서 실제로 해결할 문제도 발견했을 가능성을 제시합니다. 하위 모델에서는 L1 이후 손실도 관찰됐습니다. §5.2 · §7
5.3 핵심 사실을 확보한 뒤 남은 차이
L3에서 상위 세 모델은 과제당 10.0–12.3개 질문을 던지고 담당자가 가진 핵심 사실의 72–85%를 얻었습니다. 배포 시스템의 정규화 개선도는 0.60–0.70입니다. 이 세 모델이 담당자로부터 핵심 사실을 모두 확보한 73개 과제–모델 사례에서도 평균 개선도는 0.66이었고, 27개(37%)가 개선도 0.8 이상에 도달했습니다. Opus만 보면 해당 과제 23개 중 10개입니다. 두 비율은 비용을 빼기 전 개선도의 임계값을 사용합니다. 관찰된 하위 집합에서 정보를 확보한 뒤에도 시스템 성과 차이가 남았다는 결과입니다. §5.3
전체 95개에서 Opus의 납품 시스템은 40개 과제에서 개선도 0.8에 도달했고 최종 해결은 14개였습니다. Astra는 각각 36개와 9개였습니다. Opus의 평균 개선도 0.70에서 접촉 비용은 0.14, Astra의 0.60에서 접촉 비용은 0.22입니다. 가장 적게 묻는 Mistral Small 4는 과제당 평균 0.7개 질문으로 핵심 사실의 6%를 얻었습니다. §5.3 · Table 3
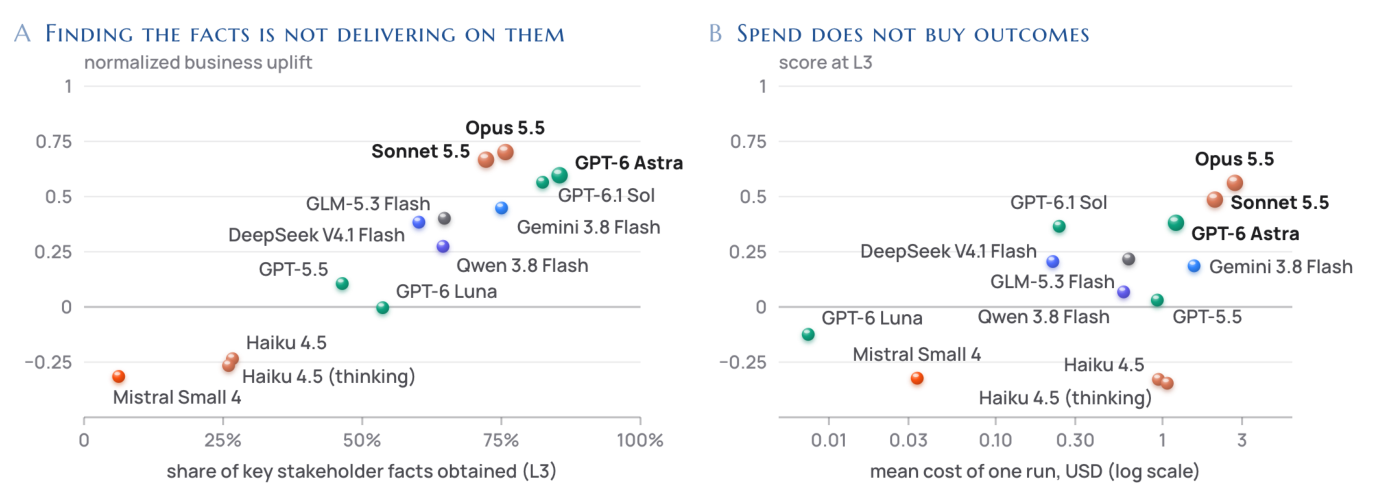
Figure 5. 왼쪽의 세로축은 정규화 개선도이고 오른쪽의 세로축은 FDE-Gym 점수입니다. 오른쪽의 가로축은 달러로 측정한 실행당 모델 사용료를 로그 척도로 표시합니다. Dongxu Yang 외, CC BY 4.0. 원 PDF에서 두 패널을 잘라냈습니다. 원문 그림 · 라이선스
5.4 기존 시스템보다 업무를 악화시킨 결과
L3에서 Claude Haiku 4.5는 79개, GPT-6 Luna는 63개 과제에서 점수 0 미만을 기록했습니다. 연락 비용을 빼기 전에도 Mistral Small 4의 시스템은 51개, Claude Haiku 4.5의 확장 추론 구성은 55개 과제에서 기존 시스템보다 낮았습니다. 비용이 작아도 잘못된 보상 지급이나 엉뚱한 당직자 호출처럼 산출물의 행동 때문에 고객 지표가 나빠질 수 있습니다. Haiku에서 확장 추론을 켰을 때 평균 점수는 −0.33에서 −0.35였습니다. §5.4 · Figure 6
5.5 시나리오와 변형에 따른 차이
Opus는 20개 시나리오 중 11개에서 평균이 가장 높았고, 5개 시나리오에서는 어느 구성도 평균 0.5에 이르지 못했습니다. 최고 점수가 가장 낮은 news_incident와 revenue_dispute의 시나리오 평균 최고값은 0.18과 0.27입니다. 상위 모델 하나를 고정해도 한 시나리오 안에서 과제별 최고·최저 점수 차이의 중앙값은 구성에 따라 0.34–0.44였고, 이 차이가 0.5를 넘긴 시나리오는 6–8개였습니다. §5.5 · Figure 7
5.6 사용료, 작업량과 점수
GPT-6.1 Sol은 실행당 평균 0.24달러와 25턴으로 0.37을, Gemini 3.8 Flash는 1.54달러와 121턴으로 0.19를 기록했습니다. Qwen 3.8 Flash는 실행당 169턴과 110분을 사용했지만 152개 과제–지시 수준 조합 중 11개에서만 제한 내 제출했고, 상위 세 모델은 모든 조합에서 제출했습니다. 작업을 마무리할 때를 판단하는 능력도 영향을 미쳤을 수 있다는 것이 저자 해석입니다. §5.6 · Figure 5
5.7 외부 벤치마크와 나란히 보기
비교에 포함한 모델 중 Terminal-Bench 2.1, Vibe Code Bench, Finance Agent의 과제 성공률 최고값은 각각 88%, 90%, 61%입니다. 같은 그림에 등장하는 구성의 FDE-Gym 평균은 0.19–0.56입니다. 앞의 세 값은 과제 성공률이며, FDE-Gym 평균은 고객 지표 개선과 접촉 비용을 반영한 점수입니다. 성공률에 가까운 대응값으로는 해결 비율을 사용할 수 있고, 그림에 나온 Opus는 L3에서 14/95건(약 15%)을 해결했습니다. §5.7 · Figure 8
📖 Chapter 6: Related Work
Table 4는 관련 평가를 문제 정의, 정보 탐색, 해법 설계, 구현, 배포와 운영, 납품, 결과의 일곱 단계로 분류합니다. 가까운 비교 대상으로 든 ττ-bench는 개발 에이전트가 고객 요구를 파악해 고객 서비스 에이전트를 만들고, 이를 별도의 시뮬레이션 이용자에게 배포합니다. Trains but Doesn’t Learn은 모든 확인 절차를 통과해도 납품 모델이 기존 모델보다 좋아지지 않는 후학습 과제를 제시합니다. FDE-Gym은 여러 산업에 걸쳐 요구 확인과 구현, 배포 이후 업무 지표를 연결합니다. §6 · Table 4
저자들은 XYEval의 잘못된 해결책 요청, UnderSpecBench의 지시 변경, Implicit Intelligence의 숨은 제약을 네 지시 수준과 연결합니다. TheAgentCompany의 자체 완결형 업무 공간, LHAW의 질문 비용, Vending-Bench의 실행 가능한 업무 시뮬레이션도 설계에 영향을 주었습니다. 고객 역할을 어떤 모델에 맡기느냐가 평가에 영향을 준다는 선행 결과는 스크립트 사용의 근거이며, 단일 실행이 신뢰성을 과대평가할 수 있다는 관찰은 세 번 반복한 이유입니다. §6
📖 Chapter 7: Limitations
- 고객 시뮬레이션. 실제 사람은 마음을 바꾸거나 지난 상호작용에 따라 응답을 달리합니다. 스크립트는 재현성을 높이며, 접촉 비용은 과제 전문가가 정한 모형 값입니다.
- 지시 수준 비교의 표본. L0–L2는 원본 20개에 한정되고, 그중 세 과제는 동일한 L3 실행을 L2에도 사용합니다. 저자들은 L1 이후 큰 하락이 관측되지 않았다는 범위에서 결과를 해석합니다.
- 사람 기준선 수집 중. 무변경과 전문가 기준 해법으로 척도를 고정했습니다. 스폰서 요청만 받은 실제 전문가가 얻는 성과는 이 버전에 보고되지 않았습니다.
- 단일 에이전트 실행 환경. 동일한 최소 실행 환경에서 비교했습니다. 실행 환경이 달라지면 점수와 순위가 달라질 수 있습니다.
- 격리와 비용. 여러 호스트에서 실행되어 프로세스 격리 수준에 차이가 있었습니다. 실행 기록은 채점 뒤 점검했으며, 저자들은 실행별 컨테이너 격리를 더 강한 방법으로 듭니다. 모델 사용료는 각 접근 경로에서 계량한 값입니다.
- 과제 범위와 학습 데이터 중복. 20개 시나리오는 규제가 있는 업무의 에이전트와 워크플로에 비중을 둡니다. 회사는 가상화하고 변형은 핵심 사실을 바꾸었지만 관련 자료가 학습 데이터에 포함됐을 가능성은 남아 있습니다. §7
📖 Chapter 8: Conclusion
저자들은 구현 여부에서 고객 업무 성과로 평가의 관점을 옮깁니다. 상위 모델은 필요한 사실을 상당 부분 얻었지만 이를 납품 시스템에 반영하는 과정에서 개선량이 줄고, 연락 비용으로 점수가 추가로 내려갔습니다. 하위 모델은 시스템을 그대로 두었을 때보다 못한 경우가 잦았습니다. 같은 고객 지표와 채점 규칙을 사람과 에이전트에게 적용하는 것이 저자들이 제안한 비교 방식입니다. §8
Acknowledgments and Disclosure
DeepLethe는 온라인 플랫폼을 개발·운영하고 리더보드를 관리합니다. 저자들은 평가 모델을 개발한 조직에 소속된 저자가 없다고 밝혔습니다. 이름이 공개되지 않은 산업 전문가도 기밀 유지, 프로젝트의 민감성, 소속사 정책 또는 본인 의사 등의 이유로 저자 명단에 포함되지 않았습니다. 감사와 이해관계 공개
References
마지막 참고문헌은 소프트웨어 공학 평가와 고객 대화, 요구 명확화, 업무 시뮬레이션, 에이전트 실행 비용 등의 근거를 제공합니다. 원문 v1은 참고문헌까지 14쪽이며 별도의 부록은 없습니다. 참고문헌 · PDF v1
실험 결과 심층 분석
| 모델 구성 | L3 평균 점수 | 95% 신뢰구간 | 차감 전 개선도 | 고객 접촉 비용 | 해결 과제 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 0.56 | 0.50–0.62 | 0.70 | 0.14 | 14/95 |
| Claude Sonnet 5.5 | 0.49 | 0.43–0.55 | 0.67 | 0.18 | 15/95 |
| GPT-6 Astra | 0.38 | 0.30–0.46 | 0.60 | 0.22 | 9/95 |
| GPT-6.1 Sol | 0.37 | 0.28–0.44 | 0.57 | 0.20 | 7/95 |
표는 Table 3의 L3 전체 95개 결과 중 평균 상위 네 구성을 뽑았습니다. 평균 점수는 95개에 걸쳐 변화량을 반영하고, 해결 수는 임계값에 도달하고 사고가 없었던 과제를 셉니다. Opus와 Sonnet의 순서가 두 열에서 달라지는 이유를 읽을 때 이 집계 차이가 중요합니다. 모델별 신뢰구간은 각각의 평균 추정치에 붙으며, Opus와 Sonnet의 점수 차이 자체에 대한 구간은 이 표에 제시되지 않습니다. Table 3
제약 발견을 살펴볼 때는 동일한 원본 20개에서 L0와 L1을 대조할 수 있습니다. 규칙을 숨기는 조건에서는 질문이 늘면서 비용이 오르고 산출물의 개선도도 감소했습니다. 사실을 모두 확보한 실행만 모은 결과는 별도의 관찰입니다. 이 73개 과제–모델 사례는 실행 결과에 따라 선택됐으므로, 여기서 얻은 평균 0.66을 모든 과제에 사실을 제공했을 때의 예상 점수로 적용할 수 없습니다. 명시된 규칙을 제공한 L0의 최고 0.82 역시 원본 20개에 한정한 평균 점수입니다. §4 · §5.2 · §5.3
기술적 함의와 응용
시추 사례를 평가하려면 고객 지표를 먼저 실행 가능한 형태로 적어야 합니다. 과거 보고서로 구현을 점검하고 인계 이후 보고서로 책임 귀속과 청구 시간을 평가하면, 화면에 챗봇이 나타나는지와 월별 청구 결과가 나아졌는지를 따로 확인할 수 있습니다. 무단 변경으로 정의한 사고와 승인에 드는 접촉 비용까지 기록하면, 산출물의 개선량과 납품 과정에서 그 개선량이 얼마나 상쇄되는지 각각 읽을 수 있습니다. §2 · §3.4
같은 고객 시스템에서 계약 규칙이나 승인자를 바꾸는 변형은 에이전트가 이전 해법을 반복하는지, 새 상황에서 적용할 제약을 다시 확인하는지 살펴보는 데 쓰입니다. 규칙을 처음부터 준 실행, 스스로 찾아야 하는 실행, 스폰서가 제시한 업무부터 재검토하는 실행을 비교하면 어떤 조건에서 성과가 내려가는지 파악할 수 있습니다. 이 논문에서는 상위 모델의 가장 큰 평균 하락이 제약을 명시하지 않은 단계에서 나타났습니다. §2.2 · §3.2 · §5.2