논문 개요와 전체 구조
하네스는 모델에 어떤 프롬프트와 도구를 주고, 실행 결과를 어떻게 읽어 다음 단계로 넘길지 정하는 프로그램입니다. 같은 모델도 하네스에 따라 다른 결과를 냅니다. Evo²는 하네스를 개선하는 모델도 학습할 수 있다는 데서 출발합니다. 어떤 코드 변경이 과제 점수를 높였고 어떤 진단이 효과 있는 수정으로 이어졌는지 기록해, 다음 탐색에서 더 나은 변경을 고르도록 개선 모델을 훈련합니다. 논문 초록
저자들은 하네스를 실행하는 실행자와 하네스를 편집하고 평가 결과를 해석하는 개선 모델을 나눕니다. 주요 실험에서 실행자는 가중치를 고정한 Qwen3.8-27B입니다. 개선 모델은 편집을 작성하는 Proposer와 실행 결과를 진단하는 Reflector를 한 가중치 집합으로 수행합니다. 코딩과 대화 기억 과제에서는 개선한 하네스의 점수와 전이를, 가중치를 고정한 상용 모델에서는 두 역할을 이용한 탐색의 성과를 따로 보고합니다. §3.1 · §4
| 원문 순서 | 다루는 내용 |
|---|---|
| 1. Introduction | 가중치와 하네스가 서로에게 제공하는 개선 신호 |
| 2. Related Work | 자체 생성 경험으로 모델을 훈련하는 계열, 실행 가능한 하네스를 탐색하는 계열 |
| 3. Method | 3.1 구성, 3.2 두 역할의 편집·진단과 교차 탐색, 3.3 EvoTIDE의 수집·보상·학습 |
| 4. Experiments | 4.1 설정, 4.2 코딩, 4.3 벤치마크 전이, 4.4 상용 모델, 4.5 기억 과제, 4.6 가중치와 비용 분석 |
| 5. Conclusion | 가중치에 남는 편집 능력과 하네스 코드에 남는 개선 |
| References | 자기 개선, 하네스 탐색, 강화학습과 평가 연구의 출처 |
고정 원문은 2026년 10월 9일 제출된 arXiv:2610.13025v1입니다. PDF는 12쪽이며, 5절 뒤에 참고문헌이 이어집니다. 버전 기록 · PDF
핵심 기여와 혁신성
코드 편집을 한 번 평가하면 점수 외에도 다음 탐색에 쓸 단서가 생깁니다. 한 변경이 어느 과제에서 실행됐는지, 어떤 오류로 실패했는지, 진단 지시를 적용한 뒤 결과가 나아졌는지가 그 예입니다. 저자들은 탐색 중 얻은 기록을 편집·진단 능력의 학습 신호로 사용하고, 갱신된 정책으로 다시 하네스를 탐색합니다. 탐색 결과와 다음 탐색의 출발점이 함께 바뀌는 구조입니다. §1
여러 하네스 분기에서 나온 개선책을 공유하는 방식도 중요합니다. Reflector는 다른 분기의 전략을 골라 현재 하네스에서 어디에 어떻게 반영할지 지시합니다. Proposer가 실제 코드를 바꾸면 그 결과를 다시 실행합니다. 이렇게 하면 수정할 코드가 달라도 실행 메커니즘을 옮길 수 있고, 성공 여부는 새 하네스에서 평가할 수 있습니다. §3.2
기술적 세부사항
| 구성 요소 | 받는 정보 | 만드는 결과 |
|---|---|---|
| 실행자 | 후보 하네스가 구성한 도구, 프롬프트, 컨텍스트와 과제 | 외부 평가에 쓰이는 과제 응답 또는 작업 결과 |
| Proposer Type A | 부모 하네스와 평가 기록 | 스스로 선택한 코드 편집 |
| Reflector | 부모와 후보의 차이, 점수 변화, 실행 기록, 선택 가능한 기증 전략 | 국소 수정, 교차 전략 이식, 유지 중 하나 |
| Proposer Type B | 현재 후보와 Reflector의 구체적 지시 | 지시를 현재 코드에 적용하는 편집 |
| EvoTIDE | 역할별 응답, 편집 전후 하네스, 과제 평가 | 이후 하네스 탐색에 사용하는 공유 정책 가중치 |
두 역할은 같은 언어 모델을 서로 다른 프롬프트로 호출합니다. 궤적은 한 호출을 구성한 입력, 모델 응답, 적용된 편집과 이후 평가를 따라갈 수 있는 기록입니다. 궤적을 바탕으로 정답 응답을 모방하는 지도 미세조정(SFT)을 먼저 수행하고, 이후에는 같은 입력에서 나온 응답들을 상대 비교하는 그룹 상대 정책 최적화(GRPO)로 정책을 갱신합니다. 목적은 정해진 실행자가 과제를 더 잘 수행하게 하는 코드 변경과 그 변경을 이끄는 진단을 학습하는 것입니다. §3
코딩 평가는 Polyglot과 LiveCodeBench의 pass@1, SWE-bench Verified의 해결률을 사용합니다. pass@1은 첫 시도 결과의 성공 비율입니다. 기억 실험은 LoCoMo의 평균 F1과 LongMemEval-S의 판정 정확도를 분리합니다. 같은 숫자가 나오더라도 벤치마크, 실행 모델, 평가 표본이 다르면 별개의 결과입니다. §4.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할. 자기 개선을 모델 가중치에 경험을 쌓는 방식과 실행 코드에 경험을 쌓는 방식으로 나눠, 두 방식이 만나는 지점을 제시합니다.
기존 개선 루프. 첫 접근은 모델이 스스로 풀이를 만들고, 과제 피드백으로 유용한 응답을 고른 뒤 가중치를 업데이트합니다. 둘째 접근은 프롬프트, 도구, 실행 피드백을 다루는 프로그램의 수정안을 작성하고 평가해 하네스에 개선을 남깁니다. 어떤 편집을 제안하고 실패를 어떻게 읽을지는 편집 모델의 역량에 좌우됩니다. 동시에 하네스 편집의 성공과 실패는 이 역량을 훈련하는 자료가 됩니다. §1
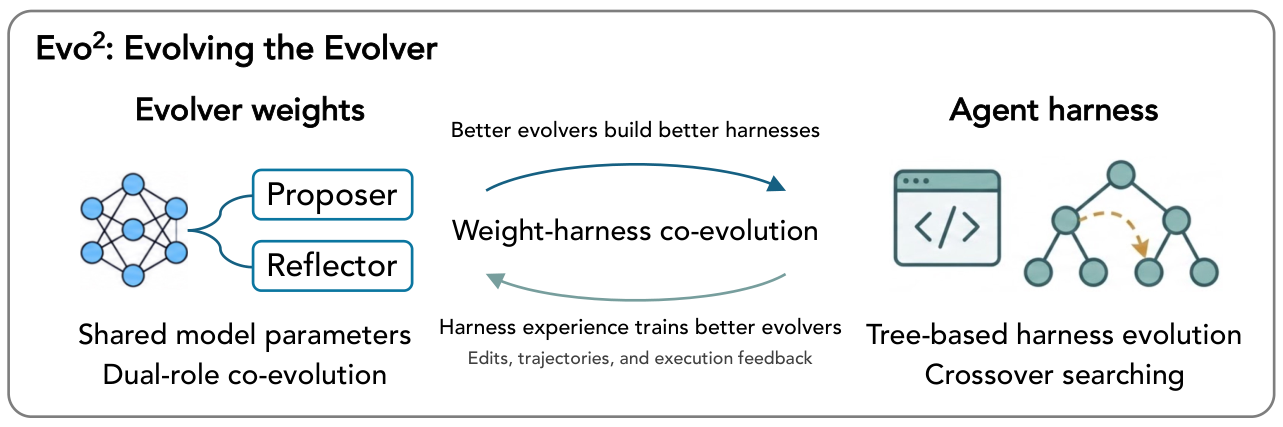
Figure 1, PDF 2쪽. 원본 영역 크롭, 번역·수치 변경 없음. 고정 원문 · 라이선스 CC BY 4.0
그림에서 보이는 두 방향. 왼쪽의 공유 가중치는 Proposer와 Reflector의 판단에 쓰이고, 오른쪽의 트리는 실행 가능한 하네스 변형을 저장합니다. 위쪽 화살표는 모델이 편집을 통해 트리를 확장하는 방향입니다. 아래쪽 화살표는 평가된 편집, 궤적, 실행 피드백이 모델 훈련으로 되돌아가는 방향입니다. 트리 안에서의 교차 탐색은 다른 분기의 유용한 전략을 가져올 수 있게 합니다. Figure 1
챕터의 핵심 기여와 다음 챕터 연결. 하네스를 개선한 경험으로 개선 모델을 훈련한다는 문제를 제시합니다. 이어지는 장은 이 문제가 성공 응답으로 모델을 학습하는 기존 방법과 코드 후보를 평가하는 기존 탐색에 각각 어떻게 닿는지 설명합니다. §1–2
📖 Chapter 2: Related Work
챕터의 위치와 역할. 개선이 저장되는 위치와 다음 개선에 쓰이는 피드백을 기준으로 두 연구 계열을 정리합니다.
- Self-improving language models. STaR과 ReST EM은 성공한 모델 출력을 골라 훈련에 사용하고, Absolute Zero와 R-Zero는 문제와 풀이를 자기 대국 과정에서 발전시킵니다. 논문은 궤적 선택·평가 개선과 함께 생성과 검증·수정을 한 정책에서 학습하는 연구도 짚습니다. EvoTIDE에서 학습의 대상은 과제 응답을 쓰는 실행자의 풀이 역량보다 하네스를 고치는 역할의 편집과 진단입니다.
- Self-evolving agent harnesses. SICA는 자체 구현을 수정하고, DGM은 보관한 후보에서 여러 수정 분기를 만들며, HGM은 후손 성능 추정치를 부모 선택에 사용합니다. Meta-Harness는 후보 코드와 실행 기록을 활용해 탐색하고, GEPA는 반성을 프롬프트 진화에 결합하며, GEA는 여러 개선 에이전트가 경험을 공유하게 합니다. 저자들은 평가 기준이 변하는 경우를 다루는 Red Queen Gödel Machine과 하네스 전이 연구도 언급합니다. Evo²에서는 다른 분기의 전략을 찾아 현재 코드에 맞춰 적용한 경험도 개선 정책의 학습에 들어갑니다. §2
챕터의 핵심 기여와 다음 챕터 연결. 역할을 학습하는 방법과 하네스를 탐색하는 방법의 접점을 정리합니다. 3장은 그 접점을 역할 호출, 실행 평가, 보상으로 구체화합니다. §3
📖 Chapter 3: Method
챕터의 위치와 역할. 먼저 하네스를 확장하는 탐색을 정의하고, 그 실행 기록을 공유 정책의 학습 자료로 바꾸는 절차를 설명합니다.
3.1 Overview
하네스 $h$는 프롬프트, 도구, 컨텍스트와 제어 흐름을 다루는 실행 프로그램입니다. 정책 $\pi_\theta$는 역할 프롬프트에 따라 편집자와 진단자가 되고, $\theta$는 그 정책의 학습 대상 가중치입니다. $M_{\mathrm{exec}}$는 각 후보 하네스 안에서 실제 과제를 수행합니다. 공동 진화 중 실행자 가중치를 고정하므로, 같은 실행 조건에서 후보 점수가 달라지면 하네스 변경의 결과로 읽을 수 있습니다. §3.1
탐색 트리의 노드는 하네스와 과제 평가 기록을, 간선은 부모에서 자식으로 갈 때 적용한 편집을 저장합니다. 한 반복에서 부모를 뽑고, 첫 수정본을 평가하고, 평가 기록을 바탕으로 Reflector의 판단을 받습니다. 추가 편집을 요청받으면 적용해 다시 평가합니다. 평가가 끝난 후보는 다음 탐색의 부모가 될 수 있고, 역할별 궤적과 과제 결과는 가중치 갱신에 쓰입니다. §3.1
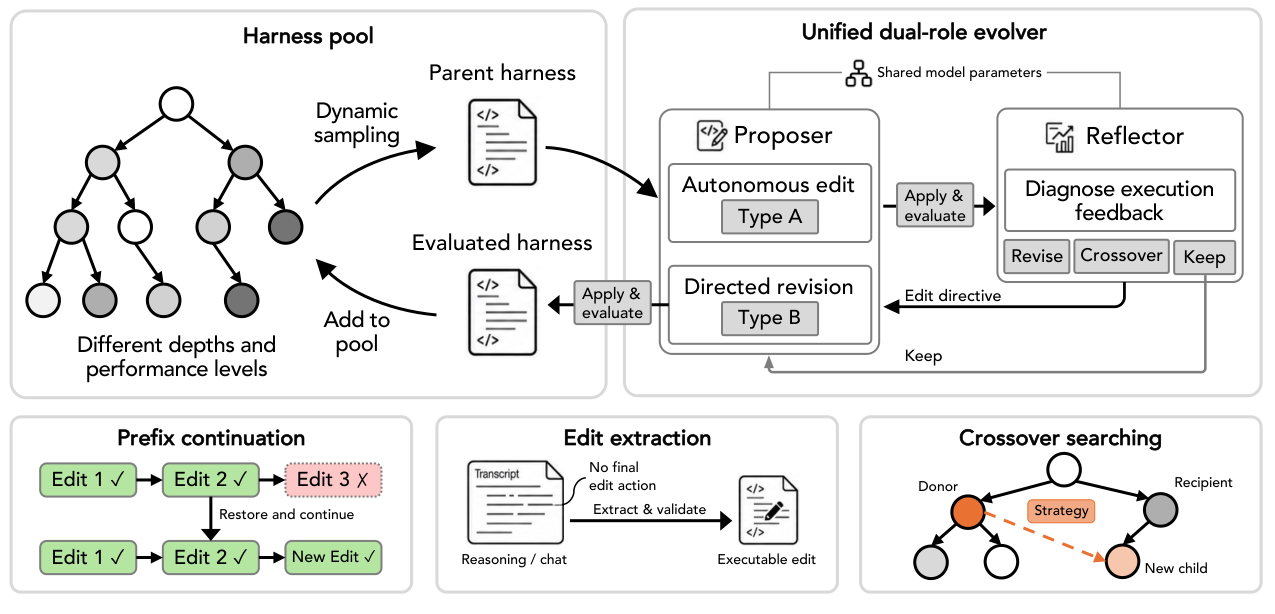
Figure 2, PDF 4쪽. 원본 영역 크롭, 번역·수치 변경 없음. 고정 원문 · 라이선스 CC BY 4.0
그림 위쪽은 부모 후보를 뽑는 풀과 두 역할의 호출 순서를, 아래쪽은 부분 편집의 복구와 분기 간 전략 이동을 보여 줍니다. 두 역할의 가중치를 공유하는 관계와 실행 가능한 후보를 평가하는 관계를 구분하면, 어느 단계에서 학습 데이터가 생기는지 따라갈 수 있습니다. Figure 2
3.2 Harness evolution through dual-role self-modification
Proposer. Type A는 부모 하네스 $h_p$와 평가 기록 $z_p$를 받고, 손볼 곳을 스스로 골라 편집 묶음 $e_0$을 작성합니다. 적용 결과가 초기 후보 $h_0$입니다. Type B는 대상 하네스와 Reflector가 쓴 지시를 받아 지시를 코드로 옮깁니다. 두 호출 모두 여러 파일 편집을 한 궤적에 포함할 수 있습니다. §3.2
Reflector. 현재 소스와 부모 대비 변경 내역, 점수 변화, 관련 성공·실패 기록을 받아 새 메커니즘이 작동했는지와 남은 문제를 확인합니다. 세 행동의 차이는 다음과 같습니다. §3.2
| 행동 | Reflector의 결과 | 하네스에 일어나는 일 |
|---|---|---|
| revise | 실행 근거를 붙인 국소 수정 지시 | Type B가 현재 후보에 추가 편집 |
| crossover | 다른 분기의 기증 전략과 이를 이식할 구체적 지시 | Type B가 수신 후보의 코드에 맞춰 메커니즘을 구현 |
| keep | 현재 후보 유지 | 추가 편집 호출 없이 초기 후보를 유지 |
식 (1)은 초기 편집, 진단, 지시 편집의 순서를 나타냅니다. Apply 함수는 현재 코드에 편집 묶음을 적용합니다. 식 (1), PDF 5쪽
$P_A$·$P_B$·$R$은 각 호출의 역할 프롬프트이고, $z_0$는 초기 후보의 편집 차이와 실행 피드백입니다. $\mathcal{S}$는 다른 분기에서 얻은 기증 전략의 집합입니다. 진단 결과에서 $m$은 행동, $d$는 편집 지시, $j$는 교차 때만 사용하는 기증 전략 식별자입니다. revise 또는 crossover면 지시를 바탕으로 $e_1$을 만들고, keep이면 $h_1=h_0$입니다. 학습 중 상대 역할 호출에는 §3.3.3의 고정 스냅샷을 사용합니다. §3.2
Crossover searching. $\mathcal{S}=\{s_j\}$의 항목에는 평가를 마친 하네스의 메커니즘과 관측 효과, 현재 후보에 이미 있는지 여부를 기록합니다. Reflector가 $s_j$를 고르면 Type B가 수신 하네스의 소스와 기존 동작에 맞춰 구현합니다. 그 자식은 수신 하네스를 트리의 부모로 유지하고, 기증 전략을 별도 기록합니다. 후보 전체를 섞는 대신 어떤 메커니즘을 이식했는지 추적할 수 있습니다. §3.2
3.3 Weight evolution through EvoTIDE
EvoTIDE는 먼저 수집한 기록으로 지도 미세조정을 한 뒤, 계속 커지는 트리에서 새 경험을 얻으며 두 역할에 GRPO를 적용합니다. 같은 모델이 여러 역할을 맡으므로 어떤 상대 정책이 편집 지시를 만들거나 실행했는지를 통제하는 절차가 필요합니다. §3.3
3.3.1 Data collection. 한 반복에서 역할 프롬프트와 응답, 적용 편집, 부모·자식 하네스, 과제 결과를 저장합니다. 초기 편집과 진단의 궤적이 생기고, 추가 편집을 요청한 경우 Type B 궤적도 얻습니다. 성공한 초기 편집뿐 아니라 점수 변화가 없거나 후퇴한 사례도 진단 입력이 됩니다. revise나 crossover는 지시를 코드로 구현한 결과에서 피드백을 받고, keep은 기존 후보를 유지합니다. §3.3.1
Proposer 출력은 아이디어가 남아 있어도 파일에 적용 가능한 형식으로 끝나지 않을 수 있습니다. Edit extraction은 명시적 편집 액션 없이 종료된 응답의 추론·대화 기록에서 구체적 편집을 찾아 액션 형식으로 변환합니다. Prefix continuation은 여러 편집 중 뒤쪽 편집이 잘못됐을 때 마지막으로 성공한 편집까지 되돌린 뒤 그 중간 하네스에서 생성만 이어 갑니다. 예컨대 Figure 2의 Edit 1과 2가 적용되고 Edit 3이 실패하면, 1과 2가 반영된 상태에서 3에 해당하는 뒷부분을 다시 생성합니다. 두 경우 모두 복구한 제안에 적용·시작·과제 평가 검사를 동일하게 수행합니다. §3.3.1 · Figure 2
3.3.2 Reward design. $\widehat V(h)\in[0,1]$는 하네스 $h$의 외부 평가 평균입니다. 과제별 결과가 성공과 실패 두 값이면 이 평균은 성공률입니다. 식 (2)는 같은 과제와 대응되는 실행 조건에서 편집 전후의 차이를 구합니다. 반복 실행이 있으면 평균을 사용합니다. 식 (2), PDF 6쪽
$r_P^{\mathrm{exec}}$는 Proposer가 하네스 $h$를 $h'$로 바꿔 얻은 점수 차이입니다. Type A의 기준은 뽑힌 부모이고, Type B의 기준은 지시를 받았을 때의 후보입니다. $r_R^{\mathrm{exec}}$는 진단을 받기 전후 후보의 점수 차이입니다. keep의 실행 보상은 0입니다. 형식 오류, 편집 불가, 시작 실패, 실질 변경 없는 편집, 무효 교차 지시에는 벌점을 줍니다. Type B는 지시가 지정한 파일을 수정했는지에 따라 작은 보너스나 벌점도 받습니다. Reflector의 양의 향상분은 새 메커니즘이 실제 실행된 기록이 있을 때만 인정합니다. §3.3.2
3.3.3 Training process. 다섯 단계가 어떤 데이터와 상대 모델로 업데이트를 계산하는지 정합니다. §3.3.3
- Supervised fine-tuning. 성과가 확인된 자율 편집·지시 편집과 후속 평가로 선별한 진단을 섞습니다. 역할 프롬프트와 하네스 문맥을 보고 기록된 응답을 예측하도록 훈련합니다.
- Tree maintenance and parent sampling. 온라인 단계에서 트리를 갱신하고, 수정 깊이마다 성능이 높은 일부 후보와 다른 실행 가능한 후보를 함께 보존합니다. 깊이가 얕은 초기 변경과 여러 변경이 누적된 하네스를 모두 학습에 노출합니다. 보존 후보 중 다음 부모를 뽑을 때 식 (3)을 적용합니다. 식 (3), PDF 7쪽
$\mathcal P_r$은 라운드 $r$에 보존한 부모 풀이고, $\mathcal N_r$은 루트를 제외한 부분입니다. 루트는 일정 비율 $\rho\in(0,1)$로 뽑고, 나머지 확률 질량은 $w(h)$ 비율로 나눕니다. $\widehat V(h)$가 0.5에서 멀수록 뽑힐 가중치가 커져, 높은 점수의 후보 개선과 낮은 점수의 후보 수리를 모두 학습할 수 있습니다. $\epsilon_p>0$는 중앙에 있는 후보도 양의 가중치를 갖게 합니다. 비루트 후보가 없을 때는 루트만 뽑습니다. §3.3.3
- Interleaved role training. 라운드 시작의 가중치를 $\bar\theta_r=\theta_r$로 복제해 고정합니다. Proposer를 훈련할 때 그 복제본이 Type B 입력에 필요한 진단 지시를 생성합니다. Reflector를 훈련할 때는 같은 복제본이 지시를 실행하는 Proposer가 됩니다. 매 단계에 Proposer와 Reflector 그룹을 하나씩 쓰고 각 프롬프트 안에서 상대 보상을 구해 같은 활성 가중치에 반영합니다. 고정 복제본은 한 라운드 내내 유지하고, 다음 라운드 시작에 $\bar\theta_{r+1}=\theta_{r+1}$로 갱신합니다.
- Balancing modes within each role. Proposer의 Type A와 B 입력을 번갈아 사용합니다. Reflector 입력은 기증 전략이 없는 경우와 있는 경우를 절반씩 구성합니다. 어느 문맥에서나 타당한 지도 응답은 전략을 넣거나 뺀 짝에 재사용하고, 특정 기증자에 의존하는 응답은 해당 전략이 포함된 문맥에만 사용합니다.
- Policy optimization. 같은 역할 프롬프트 $q$에 현재 정책으로 응답 $y_1,\ldots,y_G$를 생성합니다. 각 응답의 보상 $r_i$에서 그룹 평균을 뺀 값이 그 그룹 안의 상대 이점입니다. §3.3.3, PDF 7쪽
$G$는 동일 프롬프트에 대한 응답 수입니다. $A_i$가 양수이면 그 응답의 보상이 같은 문맥의 다른 대안 평균보다 높습니다. 토큰 손실은 고정된 최대 응답 길이 $L_{\max}$로 정규화하고, 잘려 끝난 응답은 손실에서 마스킹합니다. 두 역할 그룹의 손실을 평균해 배치당 한 번 갱신합니다. 논문은 이 그룹 기준과 정규화 방식을 설명합니다. §3.3.3
챕터의 핵심 기여와 다음 챕터 연결. 하나의 탐색은 실행할 수 있는 하네스와 새 하네스를 개선할 수 있는 정책을 함께 만듭니다. 4장은 두 산출물을 전이 실험, 상용 모델의 고정 가중치 실험, 개선 모델의 학습 여부를 비교한 실험로 나눠 평가합니다. §4
📖 Chapter 4: Experiments
챕터의 위치와 역할. 코딩에서 평가한 기본 효과를 먼저 보고하고, 다른 벤치마크에서의 재사용, 상용 모델, 기억 과제로 범위를 넓힙니다. 마지막으로 개선 정책의 가중치와 하네스 실행 비용을 따로 비교합니다. §4
4.1 Experimental Settings
주요 실험의 실행자는 Qwen3.8-27B입니다. FP8로 서빙하고 각 생성 단계에서 가장 가능성이 높은 토큰을 고르는 탐욕 디코딩을 사용합니다. 비교 방법의 개선 모델은 미훈련 Qwen3.8-27B이고, Evo²에서는 EvoTIDE로 미세조정한 Qwen3.8-27B가 두 개선 역할을 맡습니다. 기억 과제에는 Qwen3-Embedding-0.6B 검색 모델도 사용합니다. 상용 모델 실험에서는 GPT-5-mini와 Claude Haiku 4.5가 각각 자기 열의 실행자이자 개선 모델이며, 해당 모델의 가중치는 고정합니다. §4.1
평가용으로 남겨 둔 Polyglot 과제에서 세 평가 실행의 pass@1을, SWE-bench Verified에서는 해결률을, LiveCodeBench에서는 pass@1을 보고합니다. Qwen으로 수행한 Table 1의 SWE 결과는 보류 평가 인스턴스에 대한 값이며 정확한 평가 건수는 본문에 명시되지 않습니다. 상용 모델 실험의 Table 3은 명시적으로 60개 과제 부분집합을 사용합니다. 기억 실험에서는 진화 중 보지 않은 LoCoMo 대화 세 개에 평균 F1을 사용하고, LongMemEval-S 500개 인스턴스에서는 GPT 판정과 세 평가 실행으로 정확도를 구합니다. §4.1, PDF 8쪽 · Table 3, PDF 9쪽
비교군은 자체 구현을 한 계보에서 편집하는 SICA, 아카이브의 후보에서 분기하는 DGM, 후손 성능을 추정해 부모를 고르는 HGM, 병렬 개선 에이전트가 경험을 공유하는 GEA입니다. 각 비교군은 자신의 선택 규칙을 따릅니다. §4.1
4.2 Self-Evolution on Coding Benchmarks
Table 1의 각 열은 그 벤치마크에서 별도로 진화·선택한 하네스의 보류 평가 점수입니다. Evo²는 Polyglot에서 GEA 대비 19.5%p, SWE-bench Verified에서 HGM 대비 7.3%p, LiveCodeBench에서 HGM 대비 2.0%p 높았습니다. 벤치마크별로 가장 강한 비교군과 차이의 크기가 달라집니다. Table 1, PDF 8쪽
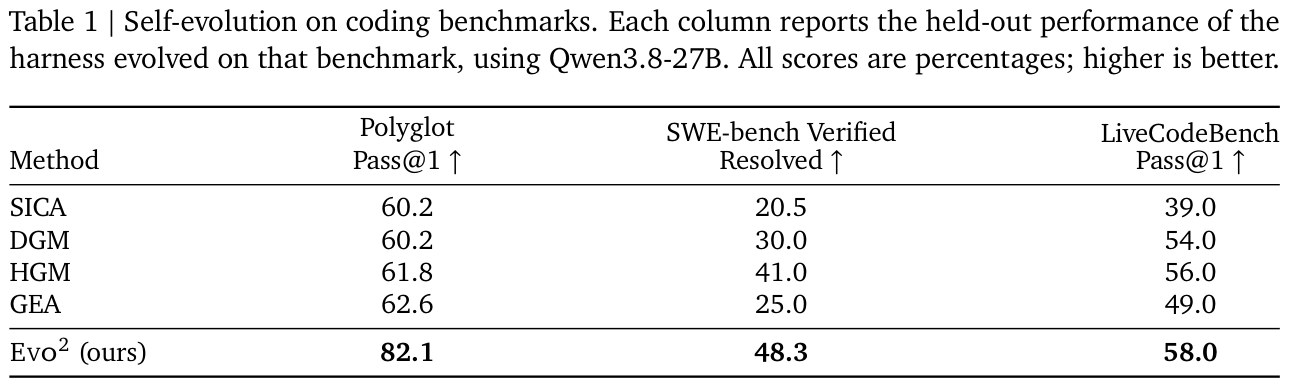
Table 1, PDF 8쪽. 원본 표 및 캡션 영역 크롭, 번역·수치 변경 없음. 고정 원문 · 라이선스 CC BY 4.0
| 방법 | Polyglot pass@1 (%) | SWE-bench Verified 해결률 (%) | LiveCodeBench pass@1 (%) |
|---|---|---|---|
| SICA | 60.2 | 20.5 | 39.0 |
| DGM | 60.2 | 30.0 | 54.0 |
| HGM | 61.8 | 41.0 | 56.0 |
| GEA | 62.6 | 25.0 | 49.0 |
| Evo² | 82.1 | 48.3 | 58.0 |
4.3 Harness Transfer across Benchmarks
각 방법의 Table 1 하네스를 다시 가져와, 선택에 사용한 벤치마크를 제외한 나머지 두 곳에서 추가 진화 없이 평가합니다. 화살표 왼쪽은 하네스를 진화·선택한 곳, 오른쪽은 그대로 평가한 곳입니다. 각 열의 단위는 오른쪽 벤치마크의 지표를 따릅니다. Table 2, PDF 9쪽
| 방법 | Polyglot → SWE | Polyglot → LCB | SWE → Polyglot | SWE → LCB | LCB → Polyglot | LCB → SWE |
|---|---|---|---|---|---|---|
| SICA | 19.0 | 33.0 | 52.0 | 49.0 | 43.9 | 29.0 |
| DGM | 20.0 | 45.0 | 69.9 | 45.0 | 63.4 | 19.0 |
| HGM | 20.0 | 41.0 | 53.7 | 50.0 | 63.4 | 16.0 |
| GEA | 16.0 | 45.0 | 48.8 | 42.0 | 61.0 | 25.0 |
| Evo² | 21.0 | 44.0 | 72.4 | 53.0 | 74.0 | 43.0 |
Evo²는 여섯 방향 중 다섯 방향에서 가장 높았습니다. Polyglot에서 LiveCodeBench로 옮겼을 때는 44.0%였고, DGM과 GEA가 45.0%로 공동 1위였습니다. LiveCodeBench에서 진화한 하네스를 SWE-bench Verified로 옮긴 값은 43.0%로, 같은 방향의 비교군 최고인 SICA 29.0%보다 14.0%p 높았습니다. SWE에서 직접 선택한 Evo² 하네스의 48.3%와 비교하면, 전이 결과가 출발 벤치마크에 따라 달라진다는 점도 드러납니다. §4.3 · Table 2, PDF 9쪽
4.4 Self-Evolution with Proprietary Models
Table 3은 SWE-bench Verified 60개 과제 부분집합에서 같은 상용 모델을 실행자와 개선 역할에 사용한 결과입니다. 방법·모델 조합마다 작은 탐색 부분집합에서 독립 탐색을 세 번 수행한 뒤 시드 평균을 보고합니다. 비교군은 탐색 순위 1위의 하네스를 평가하고 Evo²는 상위 두 하네스 중 결과가 좋은 쪽을 보고합니다. 모델 가중치가 모두 고정되어 있어 하네스 탐색 자체의 효과를 보여 주며, 보고 대상 하네스를 고르는 규칙은 방법 간 차이가 있습니다. §4.4 및 Table 3, PDF 9쪽
| 방법 | GPT-5-mini 해결률 (%) | Claude Haiku 4.5 해결률 (%) |
|---|---|---|
| SICA | 24.4 | 42.2 |
| DGM | 23.9 | 43.3 |
| HGM | 24.3 | 45.0 |
| GEA | 19.4 | 44.4 |
| Evo² | 48.3 | 47.8 |
GPT-5-mini에서 Evo²는 가장 높은 비교군인 SICA의 24.4%보다 23.9%p 높습니다. Claude Haiku 4.5에서는 HGM의 45.0%보다 2.8%p 높습니다. GPT-5-mini의 48.3%는 Table 3의 고정 가중치·60개 과제 실험이며, Table 1에서 같은 숫자가 나온 Qwen의 보류 평가와 구분해야 합니다. Table 1, PDF 8쪽 · Table 3, PDF 9쪽
4.5 Self-Evolution on Memory Tasks
기억 하네스에서는 편집 대상과 평가기를 바꾸되 편집·진단 역할, 교차 탐색, 학습 절차는 유지합니다. 한 탐색은 LoCoMo 학습 대화 일곱 개에서 뽑은 질문 1,500개를 평가합니다. 보류 대화 세 개에서 평균 F1을 측정한 뒤, LoCoMo에서 선택한 같은 하네스를 LongMemEval-S로 옮깁니다. LongMemEval-S는 하네스 진화와 선택에 사용하지 않았습니다. §4.5, PDF 10쪽 · Table 4, PDF 9쪽
| 방법 | LoCoMo F1 (%) | LongMemEval-S 정확도 (%) |
|---|---|---|
| SICA | 54.6 | 59.7 |
| DGM | 55.8 | 60.3 |
| HGM | 56.2 | 64.4 |
| GEA | 53.2 | 48.9 |
| Evo² | 60.4 | 71.5 |
LoCoMo에서 가장 높은 비교군 HGM의 56.2보다 4.2점 높고, LongMemEval-S에서 HGM의 64.4%보다 7.1%p 높습니다. 저자들은 Evo²의 개별 탐색도 LongMemEval-S에서 67.9~73.9%를 기록했다고 보고합니다. 이 범위는 독립 탐색별 관측값이며 신뢰구간과는 구분합니다. §4.5, PDF 10쪽
4.6 In-Depth Analysis of Evo²
가중치 학습의 기여. Table 5는 탐색 절차, 실행자, 부모 하네스를 고정하고 개선 모델의 훈련 여부를 바꿉니다. 비교 기준은 별도 하네스 탐색 프레임워크가 아니라 두 역할을 수행하는 미훈련 Qwen3.8-27B입니다. 따라서 Table 1의 HGM·GEA와의 비교나 Table 3의 상용 모델 비교와 다른 질문에 답합니다. §4.6 및 Table 5, PDF 10쪽
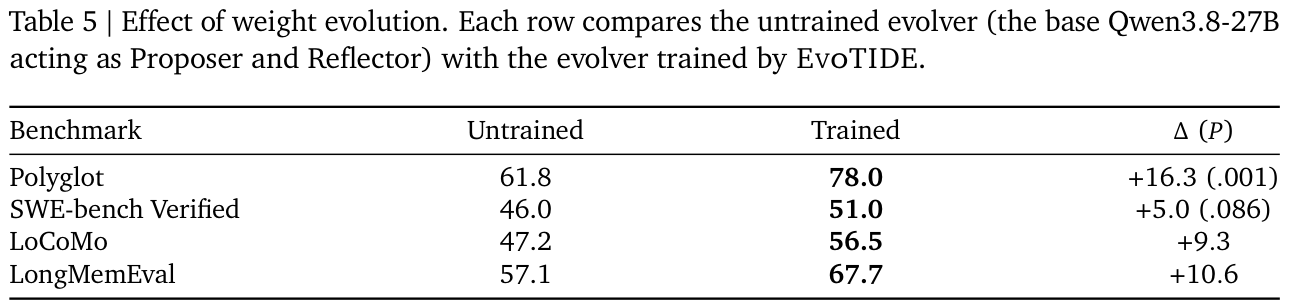
Table 5, PDF 10쪽. 원본 표 및 캡션 영역 크롭, 번역·수치 변경 없음. 고정 원문 · 라이선스 CC BY 4.0
| 벤치마크 | 미훈련 (%) | 훈련 (%) | 원문에 보고된 차이와 p값 |
|---|---|---|---|
| Polyglot | 61.8 | 78.0 | +16.3점, $p=.001$ |
| SWE-bench Verified | 46.0 | 51.0 | +5.0점, $p=.086$ |
| LoCoMo | 47.2 | 56.5 | +9.3점 |
| LongMemEval-S | 57.1 | 67.7 | +10.6점 |
Polyglot 점수 열의 표시값 차이는 16.2점이고 차이 열과 본문은 16.3점을 보고합니다. 표는 원문 표시값을 유지했습니다. SWE-bench Verified의 +5.0점은 관측된 개선이며, 보고된 p값 0.086은 통상적인 0.05보다 큽니다. 기억 과제 두 행은 p값이 제시되지 않습니다. 저자들은 훈련된 개선 모델이 평균적으로 더 나은 자식도 만들었으며, 교차 탐색이 Polyglot에서 추가로 4.1점을 제공했다고 보고합니다. 이 수치는 Table 5의 가중치 학습 차이와 별개입니다. §4.6 및 Table 5, PDF 10쪽
완성된 하네스의 실행 비용. Figure 3의 가로축은 LiveCodeBench 보류 과제 하나에 실행자가 생성한 평균 출력 토큰 수(천 단위), 세로축은 pass@1입니다. Evo²는 58.0%에서 3.6K 토큰과 과제당 10.2회 모델 호출을 사용했습니다. HGM과 DGM은 점수가 더 낮았고, 6.6K~6.9K 토큰과 26~37회 호출을 사용했습니다. Polyglot에서도 저자들은 Evo²의 최종 하네스가 진화 전 하네스보다 적은 호출(36 대 43회)과 토큰(3.6K 대 4.0K)을 사용했다고 보고합니다. 이 비교의 비용 단위는 평가 과제 실행이며, 하네스 탐색과 개선 모델 학습 비용을 합친 지표와 구분됩니다. §4.6 및 Figure 3, PDF 10쪽
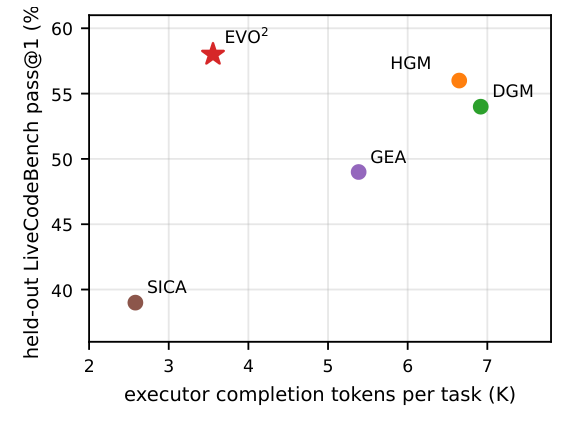
Figure 3, PDF 10쪽. 축·단위·모델 표기를 포함한 원본 그래프 영역 크롭, 번역·수치 변경 없음. 고정 원문 · 라이선스 CC BY 4.0
챕터의 핵심 기여와 다음 챕터 연결. 고정 실행자에서 다른 하네스의 성과를 비교하고, 전이·고정 상용 모델·가중치 학습 여부를 비교한 실험으로 어떤 부분을 바꿨는지 구분했습니다. 결론은 편집 능력과 편집된 코드에 경험이 각각 쌓인다는 설명으로 이 결과를 연결합니다. §4–5
📖 Chapter 5: Conclusion
챕터의 위치와 역할. 두 역할을 한 정책으로 구현한 탐색, 분기 사이의 교차, 실행 경험을 활용하는 훈련을 종합합니다.
저자들은 공유 정책이 편집을 제안하고 그 결과를 해석하는 두 일을 학습하고, 교차 탐색이 별도 분기에 있던 전략을 가져올 수 있게 한다고 정리합니다. 코딩과 기억 평가에서는 진화한 코드가 다른 벤치마크에서 쓰일 수 있었고, 상용 모델에서는 고정 가중치로도 하네스를 개선할 수 있었습니다. 저자들은 가중치 학습이 탐색의 신뢰도를 높이고 교차가 강한 하네스에 이르는 평가 예산을 줄인다고 설명합니다. 제시된 수치로는 훈련 여부에 따른 점수와 Polyglot의 교차 기여, 그리고 완성 하네스의 추론 비용을 각각 확인할 수 있습니다. §5, PDF 11쪽 · §4.6, PDF 10쪽
챕터의 핵심 기여. 한 번의 개선에서 실행 가능한 하네스에는 실제 전략이, 모델 가중치에는 다음 전략을 찾아 적용하는 능력이 남습니다. 원문은 이 결론 이후 두 연구 계열과 최적화 방법, 벤치마크의 참고문헌을 제공합니다. §5 및 참고문헌
실험 결과 심층 분석
세 비교가 답하는 질문. Table 1은 여러 하네스 탐색 방법의 최종 후보를 비교합니다. 실행자는 같지만 Evo²의 개선 모델은 훈련을 받았고 비교군은 미훈련 모델을 사용합니다. Table 5는 탐색 절차·부모·실행자를 고정해 개선 모델의 훈련 효과를 따로 읽을 수 있게 합니다. Table 3은 상용 모델의 가중치를 고정하므로 편집·진단 탐색의 결과를 보여 줍니다. 다만 Table 3의 평가 대상 선택 규칙은 비교군의 상위 하나와 Evo²의 상위 둘 중 하나로 다릅니다. Tables 1·3·5, PDF 8–10쪽
성능 차이의 해석. 코딩의 벤치마크별 최고 비교군 대비 차이는 +19.5%p, +7.3%p, +2.0%p입니다. 이 수치로 관측된 순위와 격차는 확인할 수 있지만 Table 1에 신뢰구간이나 해당 차이별 검정 결과는 제시되지 않았습니다. 가중치 비교의 Table 5에는 Polyglot과 SWE-bench Verified의 p값이 따로 실려 있고, 0.05 기준에서 두 결과의 해석은 달라집니다. LongMemEval-S 전이의 개별 탐색 범위는 평균만 보는 것보다 실행 간 차이를 드러내지만, 범위를 신뢰구간으로 해석할 수는 없습니다. Tables 1·5 · §4.5–4.6
재현에 필요한 실험 기록. 논문은 실행자와 서빙 방식, 보상 계산, 부모 선택 분포, 평가 지표를 명시합니다. 반면 본문에서 Qwen의 SWE 보류 평가 건수나 Table 5 p값의 검정 절차는 확인되지 않습니다. 표시값으로 표를 대조할 수 있는 부분과 같은 실험을 재현하기 위해 추가 명세가 필요한 부분을 구분해 읽는 편이 정확합니다. 원문이 다룬 실행 실패에는 잘못된 도구 호출이나 편집 형식으로 중간에 끊긴 궤적이 있고, §3.3.1의 복구는 이 경우를 처리합니다. §3.3.1 · §4.1 및 §4.6, PDF 8–10쪽
기술적 함의와 응용
하네스 코드의 이식과 개선 모델의 재사용은 서로 다른 배포 단위입니다. Table 2와 Table 4는 이미 만들어진 하네스를 추가 진화 없이 옮겨 평가합니다. §3.3.3은 학습한 개선 모델을 새 초기 하네스에 적용하는 경우에 그 과제의 평가기가 필요하다고 설명합니다. 전자는 호환되는 도구·모델 인터페이스에서 하네스를 실행하는 일이고, 후자는 새 과제에서 무엇이 개선인지 판단하며 다시 탐색하는 일입니다. §3.3.3 · Tables 2·4
실행 비용 관점에서 보면, Figure 3의 비교는 완성된 하네스가 같은 계열의 실행 모델을 어떻게 쓰는지도 중요하다는 것을 보여 줍니다. 리뷰어 해석으로는 배포한 에이전트의 과제당 비용과 개선 작업에 쓴 탐색·평가·학습 비용을 분리해 보는 것이 이 설계를 이해하는 데 중요합니다. Evo²는 개선 과정을 실행 가능한 코드와 두 역할의 공유 가중치에 나눠 남기며, 원문은 그 두 결과를 코딩과 대화 기억 과제에서 각각 평가합니다. Figure 3, PDF 10쪽 · §5