논문 개요와 전체 구조
Transcoder가 찾아낸 해석 가능한 특징 가운데 얼마나 많은 부분이 원래 MLP 뉴런에 이미 존재할까요? Stepan Shabalin과 Mateusz Piotrowski의 이 논문은 Transformer 언어 모델의 다층 퍼셉트론(MLP)을 희소한 특징 사전으로 바꾸어 분석하는 관행을, 원래 뉴런을 적절히 가공한 기준선과 비교합니다. 분석 대상은 arXiv:2610.24521v1이며, 아래 절·그림·표 번호는 이 버전을 따릅니다. 주된 비교는 Gemma·Qwen·Llama 계열의 공개 transcoder 13개를 대상으로 하며, MoE와 층간 transcoder 등은 부록의 예비 조사로 확장합니다.
여기서 다의성(polysemanticity)은 한 뉴런이 서로 다른 여러 개념에 반응하는 현상입니다. Transcoder는 MLP 입력으로부터 희소한 특징을 계산하여 MLP 출력을 근사하는 학습 모델입니다. 저자들은 뉴런의 양·음 활성화를 구분하고 토큰마다 큰 활성화만 남기면, 뉴런 자체도 상당히 해석 가능한 분석 단위가 된다고 보십니다. 나아가 transcoder의 입력·출력 가중치가 같은 뉴런과 정렬되는 뉴런 특징(neuron feature, 이하 NF)을 정의하고, 이들이 활성화·회로·국소 계산의 충실도에서 차지하는 비중을 조사합니다.
결론은 평가 축마다 다릅니다. 보정 학습을 거친 희소 뉴런 모델은 원래 모델의 예측 분포를 잘 보존하지만, transcoder는 출력 재구성과 세밀한 bigram 개념의 분리에 이점이 있습니다. 높은 활성화에서의 해석 가능성을 뉴런 전체의 단일 의미성으로 일반화하거나, 이 결과를 transcoder의 무용성으로 읽으면 논문의 범위를 벗어납니다. §1–3
원문의 실제 전개는 다음과 같습니다. 챕터별 상세 리뷰에서도 이 순서를 유지합니다.
| 구분 | 원문 구조 |
|---|---|
| 본문 1 | Introduction |
| 본문 2 | Evaluating thresholded neurons as features: 2.1 Neurons have single directions → 2.2 Replacement and reconstruction → 2.3 Sparse probing, bigrams, and concept representation → 2.4 Strong attribution graphs from neurons → 2.5 Polysemanticity of neurons |
| 본문 3 | Many transcoder features correspond to neurons: 3.1 Definition → 3.2 Prevalence → 3.3 Neuron features activate similarly to neurons → 3.4 Faithfulness concentrates in neuron features → 3.5 Cross-seed stability → 3.6 Non-neuron features barely move from initialization → 3.7 Neuron initialization → 3.8 Linebreaking → 3.9 Arithmetic → 3.10 Color red |
| 본문 4–6 | Related work → Discussion → Limitations |
| 본문 뒤 | Potential Risks → Acknowledgments and Disclosure of Funding → References → Appendix: table of contents |
| 부록 A–H | 모델·학습 세부사항(A.1–A.4) → 평가 방법(B.1–B.4) → 전체 평가(C.1–C.2) → 비정렬 특징 분석(D.1–D.3) → NF 분포·커버리지(E.1–E.3) → 공동 활성화 패널(F) → MLP 출력 SAE(G) → 뉴런 초기화 sweep(H) |
| 부록 I–Q | 줄바꿈(I.1–I.4) → 회로(J.1) → 산술(K) → distress 회로 구성(L) → 특징 대시보드(M) → MoE 관찰(N) → MoE transcoder(O) → 교사–학생 모형(P.1–P.4) → 층간 decoder(Q) |
| 부록 R–U | 뉴런만으로 설명되지 않는 특징(R.1–R.5) → 연구 산출물(S.1–S.5) → 계산량(T.1–T.4) → AI assistance(U) |
핵심 기여와 혁신성
기계적 해석 가능성은 모델의 내부 계산을 사람이 이해할 수 있는 단위와 연결로 설명하려는 연구입니다. 이때 원래 뉴런을 버리고 별도의 특징 사전을 학습할 필요가 있는지는 분석 비용과 설명의 충실도에 직접 영향을 줍니다. 기존 비교에서 학습된 특징이 더 해석 가능하다는 결과가 있었지만, 저자들은 비교에 사용하는 활성화 범위와 뉴런의 부호 처리가 결과를 크게 바꿀 수 있음을 보여주십니다.
이 논문의 독창성은 새로운 사전을 제시하는 것보다, 사전이 실제로 무엇을 배웠는지 원래 MLP의 가중치·활성화·미분·학습 초기값과 대조하는 데 있습니다. NF의 존재를 단순한 최대 활성화 사례로만 주장하지 않고, 가중치 양쪽의 정렬, 활성화 예측, seed 간 재현, Jacobian 정합성이라는 서로 다른 근거로 확인합니다. 동시에 비정렬 특징도 bigram과 색깔 사례에서 의미를 더 선명하게 구분할 수 있음을 남겨 둡니다. §2–3, 부록 R
리뷰어의 해석으로는, 가장 중요한 기여는 설명하기 쉬운 특징, 출력을 잘 근사하는 특징, 원래 계산을 충실하게 반영하는 특징을 같은 것으로 취급하지 않게 한다는 점입니다. 이는 사전 학습의 성과를 부정하기보다, 그 성과를 어떤 증거로 인정할지 더 정밀하게 묻는 결과입니다.
기술적 세부사항
게이트 MLP와 부호를 나눈 뉴런
원문이 다루는 게이트 MLP는 다음과 같습니다. 부록 A.3
$x\in\mathbb{R}^{d_{\mathrm{model}}}$는 층 입력이고, $g_i=W_{\mathrm{gate}}^{(i)}x$, $u_i=W_{\mathrm{up}}^{(i)}x$는 뉴런 $i$의 gate·up 투영입니다. $\sigma$는 GELU 또는 SiLU, $\odot$는 원소별 곱입니다. $a_i$가 논문에서 말하는 뉴런의 활성화이며, $W_{\mathrm{down}}^{(i)}$는 해당 뉴런이 출력에 쓰는 방향입니다.
큰 양의 gate 영역에서 $\sigma(g_i)\approx g_i$이면 다음 근사가 성립합니다.
따라서 $g_i>0$이고 $|u_i|$와 $|g_i|$가 비슷한 큰 활성화에서는, 양의 뉴런은 $W_{\mathrm{up}}^{(i)}+W_{\mathrm{gate}}^{(i)}$, 음의 뉴런은 $W_{\mathrm{up}}^{(i)}-W_{\mathrm{gate}}^{(i)}$ 방향에 선택적으로 반응한다는 기하학적 해석이 가능합니다. 음의 활성화의 크기를 별도 특징으로 보면 decoder 부호도 반대가 됩니다. 이는 큰 활성화 영역의 근사이며, 모든 입력에서 하나의 고정 선형 encoder가 정확히 존재한다는 정리가 아닙니다.
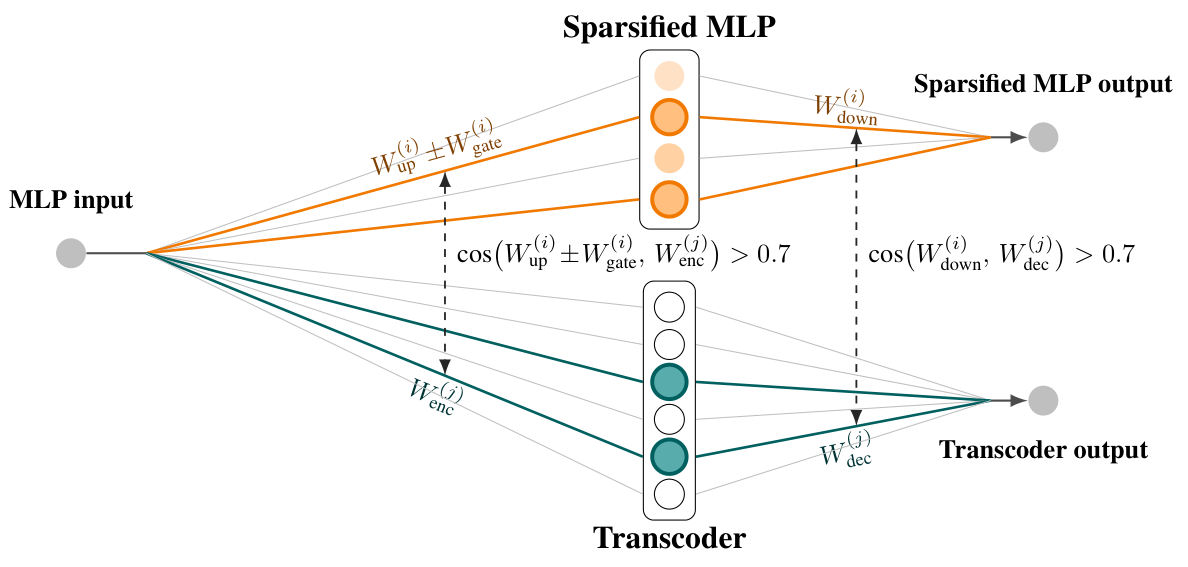
원문 Figure 1, PDF p.1. v1 PDF의 그림 영역을 크롭했으며 번역·재배열하지 않았습니다. 입력 방향과 출력 방향이 모두 같은 뉴런에 대응해야 한다는 정의를 보여줍니다.
비교 단위와 평가 축
Top-k는 토큰마다 활성화 절댓값이 큰 뉴런을 층별로 선택하는 방식입니다. 부호 분리는 의미 단위를 나누는 처리이고, Top-k는 활성화를 희소하게 만드는 처리이므로 구분해야 합니다. 또한 뉴런 pruning의 $k$, transcoder의 활성 특징 수 $L_0$, 프로브가 사용하는 특징 수 $k$는 서로 다른 변수입니다.
| 평가 | 측정하는 대상 | 해석할 때의 조건 |
|---|---|---|
| FVU | MLP 출력 재구성의 정규화된 L2 오차 | 낮을수록 좋으며 예측 분포 보존과 동일하지 않습니다. |
| KL divergence | 대체 모델과 원래 모델의 예측 분포 차이 | 낮을수록 좋으며, 보정 모델은 FVU와 KL을 함께 최적화합니다. |
| Replacement Score | attribution graph 방법의 회로 완전성 평가 | 논문은 출력 재구성 측면에 분류하며, KL과 구분합니다. |
| 희소 프로빙 AUC | 적은 특징으로 이진 과제를 분류하는 능력 | 목표 개념과의 상관을 읽을 수 있어도 그 특징의 최대 활성화가 해당 개념이라는 보장은 없습니다. |
| Sort eval | 두 특징의 문맥을 자동 판정자가 구별하는 정확도 | 최대 활성화와 전체 분위수 표본을 구분합니다. |
| Jacobian 정합성 | 입력의 작은 변화에 따른 출력 변화의 일치 | 여기서는 1차 미분의 행렬 cosine이며 큰 개입의 충실도 전체를 뜻하지 않습니다. |
| Seed 안정성 | 별도 초기화 학습에서 가중치 방향이 재출현하는지 | 임계치와 사전 구조에 의존하며, 해석 가능한 모든 구조의 완전한 정의가 아닙니다. |
주된 학습·평가 자료는 SmolLM2 코퍼스와 FineWeb이며, 회로에는 Pile-10k, 줄바꿈에는 『Pride and Prejudice』를 사용합니다. 구체적인 표본 수와 모델·층 조건은 아래 해당 부록에서 설명합니다. 부록 A–B
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 뉴런의 다의성 때문에 희소 사전으로 분석 단위를 옮겨 온 흐름에서 출발합니다. SAE는 활성화의 희소 표현을 학습하고, transcoder는 MLP의 입력–출력 대응을 희소하게 근사합니다. 이렇게 얻은 특징은 attribution graph, 즉 예측에 기여하는 내부 특징과 연결을 추적한 그래프의 단위가 됩니다.
저자들은 최근의 뉴런 기반 회로 분석과 임계 처리한 뉴런의 평가 결과를 근거로, 사전이 뉴런에 없는 무엇을 추가하는지 묻습니다. 본 논문의 답은 세 부분입니다. 첫째, encoder와 decoder가 한 뉴런에 대응하는 NF를 식별합니다. 둘째, 원래 MLP에 대한 정합성과 seed 간 안정성이 이 집단에 집중되는지를 조사합니다. 셋째, 초기화·학습 개입으로 뉴런의 희소 조합을 더 직접적으로 드러낼 수 있는지 확인합니다.
이 장의 기여는 비교 대상을 재설정하는 데 있습니다. 다음 장은 NF의 비율을 논하기 전에, 뉴런 자체가 어느 정도 유효한 기준선인지 먼저 검증합니다. §1
📖 Chapter 2: Evaluating thresholded neurons as features
이 장은 뉴런을 공정하게 비교하기 위한 부호 분리와 희소화를 정의한 뒤, 출력·예측·개념·회로·해석 가능성의 순서로 평가합니다.
2.1 Neurons have single directions
게이트 MLP의 뉴런은 두 투영의 곱이므로 일반적인 선형 encoder와 똑같지는 않습니다. 그러나 큰 활성화에서는 앞서 설명한 두 유효 입력 방향이 나타납니다. 논문은 양·음 활성화를 별도 특징으로 다루고, 그에 맞추어 decoder에도 양·음 부호를 부여합니다. 두 입력 방향은 원래 up·gate 방향이 대체로 직교하기 때문에 서로도 대략 직교합니다.
층마다 활성화 크기가 다르므로 고정된 절대 임계값을 쓰지 않고 층별 Top-k를 사용합니다. 이렇게 보면 원래 MLP도 선택된 부호 분리 뉴런을 인코딩하고 down 행렬로 복원하는 좁은 희소 모델로 읽을 수 있습니다. 이는 이후의 transcoder 비교를 가능하게 하는 공통 표현입니다. §2.1
2.2 Replacement and reconstruction
아무 보정도 하지 않은 pruning만으로는 충분하지 않습니다. Gemma 3 4B에서 원시 희소 뉴런 모델은 높은 KL과 1을 넘는 FVU를 보이며, 이 상태에서는 transcoder보다 불리합니다. 저자들은 pruning된 MLP 출력 $y$에 학습 가능한 선형 변환을 붙여 $\hat y=W_{\mathrm{recon}}y+b$를 만듭니다. 이 보정은 FVU와 KL을 함께 사용하여 학습합니다.
보정 후에는 KL이 transcoder보다 낮아지지만 FVU는 여전히 높습니다. 입력으로부터의 skip 연결과 뉴런별 rank-1 보정을 추가하면 FVU가 더 줄어도 KL의 추가 개선은 작습니다. 따라서 논문이 지지하는 주장은 가벼운 보정 학습을 거친 뉴런 기준선의 예측 보존 능력이지, 학습 없는 pruning이 처음부터 모든 지표에서 우수하다는 주장이 아닙니다. §2.2, 부록 A.1
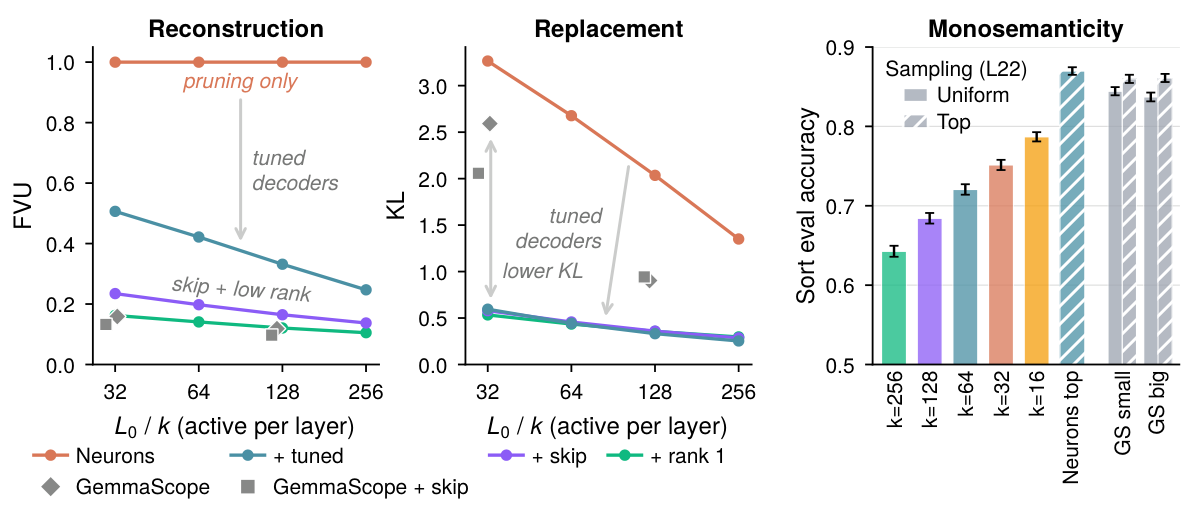
원문 Figure 3, PDF p.3. v1 PDF의 전체 그래프 영역을 크롭했으며 번역하지 않았습니다. 왼쪽·가운데의 낮은 값이 좋은 지표와 오른쪽의 높은 값이 좋은 지표를 구분해야 합니다. 오른쪽은 Gemma 3 4B L22입니다.
2.3 Sparse probing, bigrams, and concept representation
일반 희소 프로빙에서는 감정·언어·독성·사실 등 113개 이진 분류 과제를 사용합니다. 논문은 여러 모델에서 뉴런이 transcoder와 비슷하거나 더 높은 AUC를 보인다고 보고합니다. 다만 부호 분리 뉴런 활성화로부터 개념을 읽어내는 프로빙과, 모든 뉴런을 Top-k로 잘라 만든 대체 모델의 평가는 동일한 실험이 아닙니다.
차이는 세밀한 bigram에서 선명해집니다. 저자들은 FineWeb의 1,500개 구절 bigram을 따로 평가하고, 분류 AUC뿐 아니라 선택된 특징의 최대 활성화 문맥이 실제 목표 bigram을 포함하는지도 확인합니다. Gemma 3 4B에서는 이 일치율이 Gemmascope 75.6%, 뉴런 0.0%입니다. 뉴런으로 높은 AUC를 얻어도 그 뉴런이 해당 구절에 단일 의미로 반응한다고 볼 수 없다는 뜻입니다.
MoE인 Gemma 4 26B-A4B의 routed 뉴런에서는 일치율이 20.1%로 올라갑니다. 이는 뉴런 수가 많은 구조에서의 예비 근거이며, dense 모델의 결과와 구분해야 합니다. 이 절은 transcoder의 세밀한 개념 분리 이점을 인정하면서 다음 절의 회로 수준 비교로 넘어갑니다. §2.3, 부록 C.2
2.4 Strong attribution graphs from neurons
뉴런 활성화를 특징 기저로 사용하여 RelP 기반 attribution graph를 구성합니다. 무작위 대표 프롬프트 30개에 대한 비교에서는 실용적인 $L_0=10\text{–}100$ 범위에서 Gemmascope의 Replacement Score가 희소 MLP보다 높지만, TopK transcoder가 같은 우위를 보이지는 않습니다. 모든 뉴런을 남기는 극한의 점수는 1.0이지만, transcoder는 더 적은 노드로 높은 점수에 도달하는 곡선을 만들 수 있습니다.
응용 사례는 Gemma 3 27B-it의 사과·곤란한 정서 상태와 관련된 뉴런 회로입니다. 저자들은 distress 유도 및 steering 벡터를 만든 뒤 관련 뉴런을 자동 판정으로 선별합니다. 이 실험은 뉴런 회로가 행동과 연결되는 특징을 찾을 수 있음을 보이는 사례입니다. 여기서 distress는 논문이 사용한 행동적 평가 명칭이며, 모델의 주관적 경험을 입증하는 측정으로 읽을 수는 없습니다. 구성과 결과는 부록 L–M에서 다시 다룹니다. §2.4
2.5 Polysemanticity of neurons
Sort eval은 특징 A·B의 활성 문맥을 보여주고, 별도의 질의 문맥이 어느 쪽에 속하는지 판정하도록 합니다. 최대 활성화만 사용하면 뉴런도 transcoder 특징과 비슷한 구별 가능성을 보입니다. 반면 활성화 분포를 분위수로 나누어 넓게 표본화하면 뉴런의 점수가 더 낮아집니다.
따라서 큰 활성화의 해석 가능성과 뉴런 전체의 다의성은 양립합니다. 이 장은 뉴런의 강한 기준선 역할을 확립하되, 넓은 활성화 범위를 더 작은 의미 집단으로 분해할 필요를 남깁니다. 다음 장은 transcoder가 실제로 이 기준선과 얼마나 겹치는지 조사합니다. §2.5
📖 Chapter 3: Many transcoder features correspond to neurons
이 장은 논문의 중심입니다. 정성적 회로 유사성을 정량적인 가중치 정렬로 정의하고, 빈도·활성화·충실도·안정성·초기화의 근거를 차례로 쌓은 뒤 세 사례로 확인합니다.
3.1 Definition
같은 모델의 뉴런 회로와 transcoder 회로에는 상위·하위 logit, 연결, 최대 활성화 문맥이 비슷한 노드가 자주 나타납니다. 저자들은 이 대응을 NF라고 부릅니다. 정량적으로는 특징의 encoder와 decoder가 같은 뉴런의 유효 encoder 및 decoder와 모두 높은 cosine similarity를 가져야 합니다. 각각 다른 뉴런에 가장 가깝다는 조건으로 대체할 수 없습니다.
분포에는 높은 정렬도를 갖는 별도 군집이 보입니다. 다만 경계는 모델과 목적함수에 따라 0.6–0.9까지 달라지며, 표와 실험마다 적용한 임계값을 확인해야 합니다. Table 9의 집계는 양쪽 모두 0.7 초과, 회로 분석인 부록 J는 0.6 초과를 사용합니다. §3.1
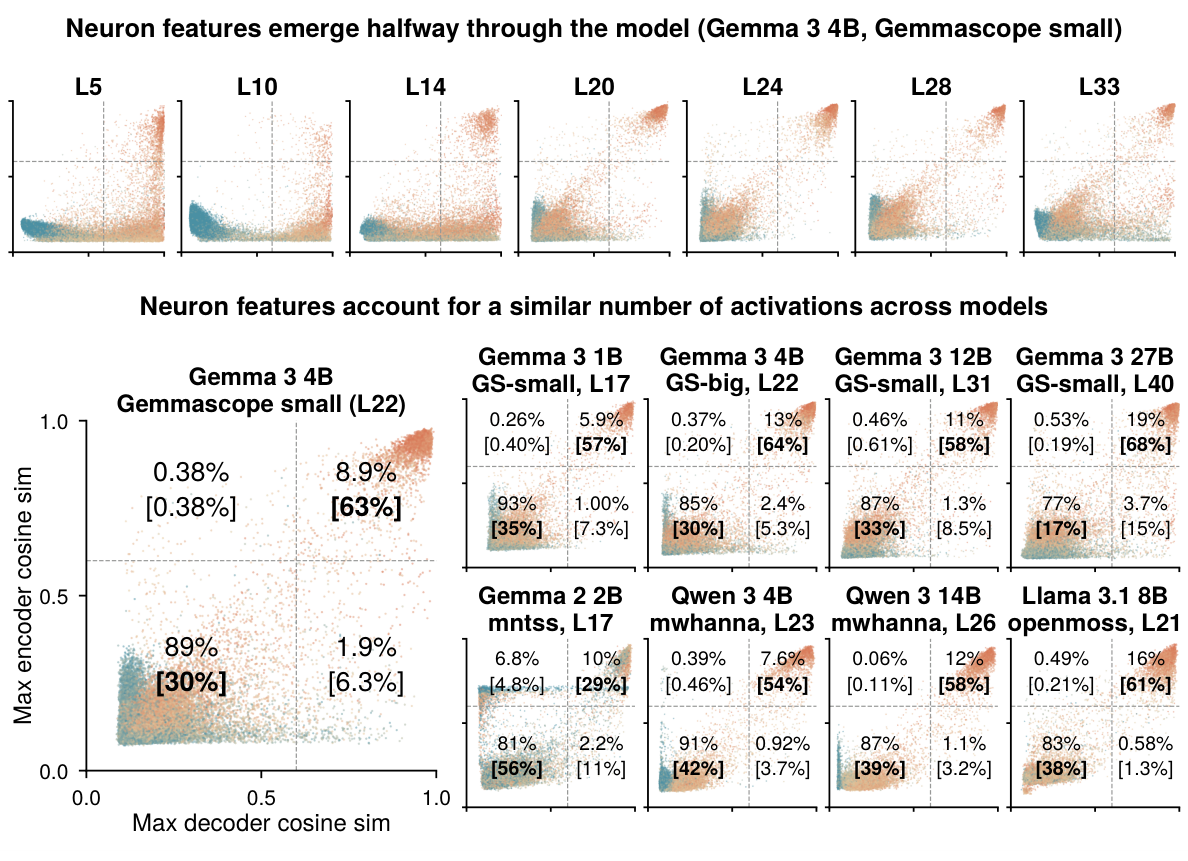
원문 Figure 4, PDF p.6. v1 PDF의 전체 그림을 크롭했으며 번역하지 않았습니다. 색은 발화 빈도, 각 사분면의 일반 숫자는 사전 비중, 대괄호 속 굵은 숫자는 활성화 비중입니다.
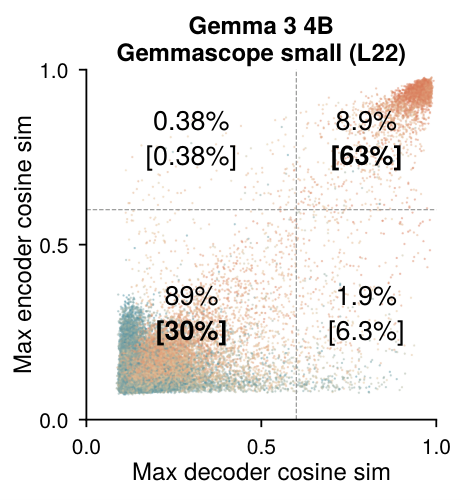
같은 Figure 4의 Gemma 3 4B L22 패널 상세 크롭입니다. 원본 픽셀을 늘리지 않고 PDF에서 별도로 렌더링했습니다. 그림의 분리선과 Table 9의 0.7 집계는 조건이 다릅니다.
3.2 Prevalence
NF는 사전의 작은 일부여도 자주 활성화되므로 실제 계산에서는 큰 비중을 차지합니다. Table 4는 모델의 약 3분의 2 지점인 단일 층 $\lfloor2N/3\rfloor$에서 Gemmascope L0-small을 비교합니다.
| Gemma 3 모델 | 사전에서 NF 비중 | 활성 특징에서 NF 비중 |
|---|---|---|
| 1B | 5.9% | 57.9% |
| 4B | 8.9% | 63.8% |
| 12B | 15.6% | 73.7% |
| 27B | 37.1% | 82.8% |
이 수치는 후반부 층 전체 평균이 아닙니다. 부록 E의 Table 9는 다른 집계로, 모델 앞·뒤 절반의 평균을 제시합니다. NF의 평균 발화 빈도는 비NF보다 10배 이상 높으며, 출현 비중은 대체로 중간 이후 층에서 커집니다. 그러나 Qwen 등에는 예외가 있고, 초기 층의 비중도 학습 방식과 초기화에 영향을 받습니다.
회로의 후반 3분의 1에서는 대부분의 transcoder에서 NF 노드가 40% 이상이며, 더 강하게 pruning해도 비중이 크게 사라지지 않습니다. 폭을 키우면 더 많은 뉴런에 대응 특징이 생기지만 무한히 새 NF가 늘지는 않습니다. Gemma 3 4B L22의 TopK $k=64$에서 decoder 기준 커버리지는 폭 32k의 78.3%에서 256k의 93.3%로 증가하고 1M에서 93.0%입니다. 이것은 decoder의 절대 cosine 0.7 이상 기준이며, 양쪽 가중치를 요구하는 엄격한 NF 비율과 구분합니다.
Gemmascope L0-small에서는 대응 뉴런당 특징 수 중앙값이 2, 평균이 2.5입니다. 특징의 발화 빈도는 대응 뉴런보다 낮고, L22에서 그 비율 중앙값은 0.34입니다. 따라서 가중치가 정렬되어도 완전히 같은 토큰에서 항상 켜지는 복사본은 아닙니다. §3.2, Tables 4·9·10
3.3 Neuron features activate similarly to neurons
저자들은 뉴런의 활성화로 대응 특징의 발화 여부를 예측합니다. 부호 방향을 보정하기 위해 $\max(\mathrm{AUC},1-\mathrm{AUC})$를 사용하며, 본문의 NF 집단에서 중앙 AUC는 적어도 0.977이라고 보고합니다. Figure 5의 AUC 0.9997, Spearman 상관 0.86은 87.8백분위에 해당하는 한 쌍의 사례입니다.
순위 비교도 완전한 일치와는 거리가 있습니다. Gemma 3 4B L22에서 토큰의 최상위 특징에 대응하는 뉴런 순위 중앙값은 약 12이지만, 32번째 특징에서는 약 250까지 올라갑니다. 좁은 특징 집합에서는 뉴런 회로와 많이 겹치지만, 더 많은 특징을 포함하면 겹침이 약해지는 이유를 보여줍니다. 부록 F는 encoder 정렬도가 낮은 쌍까지 포함하면 예측 성능이 상당히 떨어질 수 있음을 따로 확인합니다. §3.3
3.4 Faithfulness concentrates in neuron features
특징이 MLP의 실제 계산을 설명한다면, 입력을 조금 바꿀 때의 출력 변화에도 대응해야 한다는 논리입니다. 이 변화를 Jacobian으로 측정하고, 두 Jacobian을 펼친 벡터의 cosine, 즉 Frobenius cosine으로 비교합니다. 활성 JumpReLU 특징의 기여는 decoder와 encoder의 외적이므로 rank-1 행렬이며, 활성 특징들의 합이 transcoder Jacobian이 됩니다.
Gemma 3 4B L22에서 전체 transcoder와 MLP의 정합성은 약 0.3이고 NF만 더해도 비슷하지만, 비NF만으로는 약 0.05입니다. 여러 층에서도 NF 부분과 전체 곡선이 거의 겹칩니다. 같은 활성 수로 자른 뉴런은 별도 보정 학습 없이도 후반 층의 전체 transcoder와 비슷하거나 높은 정합성을 보입니다.
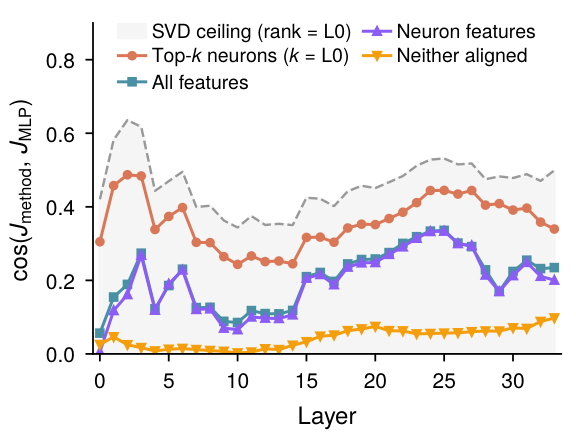
원문 Figure 7, PDF p.8. v1 PDF의 Figure 7 전체를 크롭했으며 번역하지 않았습니다. Gemmascope L0-small이며, 각 토큰의 활성 특징 수와 뉴런 수를 맞춥니다. 점선 SVD ceiling은 같은 rank에서 가능한 최적 근사의 기준입니다.
층간 transcoder에 대해서는, encoder의 뉴런 정렬도와 미래 층 decoder 비중 사이에 Pearson 상관 −0.59에서 −0.93이 관찰됩니다. 이는 두 작은 모델의 예비 결과입니다. 특히 이 절의 강한 결론은 주로 JumpReLU의 1차 미분 정합성에 관한 것이며, 모든 transcoder의 큰 개입 효과까지 평가한 결과로 확장하면 안 됩니다. §3.4, 부록 D·Q
3.5 Cross-seed stability: most features reliably learned by transcoders are neuron features
초기 seed만 다른 두 transcoder에서 encoder·decoder cosine이 모두 0.7을 넘는 대응 특징이 있는지 확인합니다. Gemma 3 4B L22, TopK $k=64$의 폭 sweep 결과는 다음과 같습니다. 표의 k는 천 단위 특징 수를 뜻합니다.
| 사전 폭 | Seed 간 공유 특징 | NF | 두 집합의 교집합 | 공유 특징의 활성화 비중 |
|---|---|---|---|---|
| 32k | 9.8k | 8.1k | 7.6k | 29.6% |
| 65k | 13.0k | 10.2k | 9.6k | 24.9% |
| 128k | 16.5k | 11.8k | 11.1k | 21.6% |
| 256k | 20.4k | 14.2k | 12.6k | 20.4% |
| 1M | 22.0k | 11.5k | 10.5k | 13.7% |
원문 Table 1에서 전사했습니다. 공유·NF·교집합은 사전 안의 개수이며, 마지막 열만 활성화 빈도로 가중한 비중입니다.
폭을 32k에서 1M으로 크게 늘려도 안정적으로 공유되는 특징은 22k 정도로 증가합니다. 이는 부호를 고려한 원래 20,480개 뉴런 단위와 비슷한 규모입니다. 다만 이 표의 TopK 결과를 JumpReLU 전체에 일반화할 수는 없습니다. 부록 D.3에서는 JumpReLU에 seed 간 재현되지만 NF가 아닌 특징도 상당히 많다고 보고하며, 그 기전은 분석하지 않습니다. §3.5
3.6 Non-neuron features barely move from initialization
Gemma 3 4B L22, 폭 262k, TopK $k=64$, 15,000 step 학습에서 초기 encoder와 학습 후 encoder를 비교합니다. NF는 초기 방향과의 cosine 중앙값이 거의 0이지만, 비NF는 +0.48입니다. 후자는 초기값의 흔적이 더 많이 남아 있고, 일부는 0.8을 넘습니다.
그러나 JumpReLU에서는 구분이 다릅니다. Figure 9의 비교 실험은 일반 JumpReLU 초기화보다 큰 TopK식 초기 norm 약 0.577을 사용합니다. 이 설정에서도 살아 있는 비NF 상당수가 크게 회전합니다. 따라서 “모든 비NF가 무작위 초기값 그대로다”라고 정리할 수 없습니다. 저자들이 보이는 것은 학습 파이프라인마다 다른 초기화 의존성과, 단순 발화 빈도만으로 설명되지 않는 NF의 큰 이동입니다. §3.6
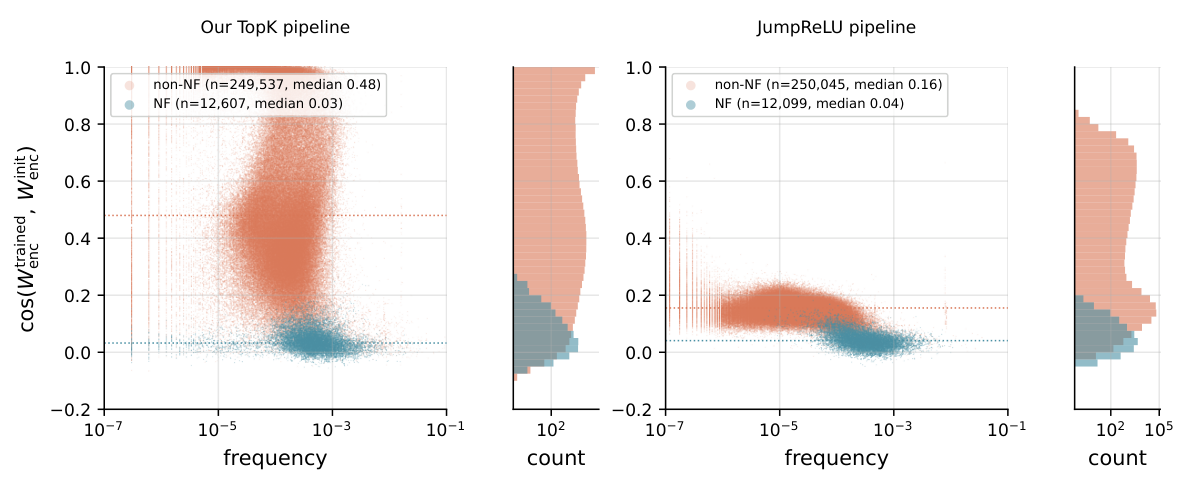
원문 Figure 9, PDF p.10. v1 PDF의 두 파이프라인 패널과 범례를 포함해 크롭했으며 번역하지 않았습니다. 오른쪽은 초기 norm을 TopK와 맞춘 단일 JumpReLU 실험입니다.
3.7 Neuron initialization preserves alignment through training
뉴런 초기화(NI)는 encoder 행을 무작위로 선택한 부호 분리 뉴런 방향에 두고 10% Gaussian 잡음을 더하며, decoder는 0으로 시작합니다. 다른 학습 절차는 유지합니다. 이는 초기 정렬을 모델이 보존하는지를 묻는 개입입니다.
Gemma 3 4B L22, 폭 256k에서 뉴런과 encoder cosine이 0.5를 넘는 특징은 11%에서 92%, decoder 쪽은 12%에서 93%로 늘어납니다. 이 정렬 집단의 활성화 비중은 65%에서 95%로 증가합니다. 0.5를 쓴 이 집계는 0.7을 양쪽에 요구하는 NF 비율과 같지 않습니다. NI는 같은 loss까지의 수렴을 빠르게 하고 죽은 특징을 줄이지만, 이를 곧바로 더 우수한 의미 분해의 증거로 보지는 않습니다. 부록 H와 R의 검증이 그 다음 질문을 다룹니다. §3.7
3.8 Case study: linebreaking
문자 위치별 발화율이 특정 구간에서 높아지는 특징은 줄바꿈 예측과 관련됩니다. Gemma 3 4B L20의 Gemmascope L0-small에서 가장 선명한 peaked 특징 8개 중 7개는 한 뉴런의 문자 위치 tuning curve와 대응합니다. 다수는 가중치 기준 NF이지만, 곡선만 닮고 가중치는 충분히 정렬되지 않는 사례도 있습니다.
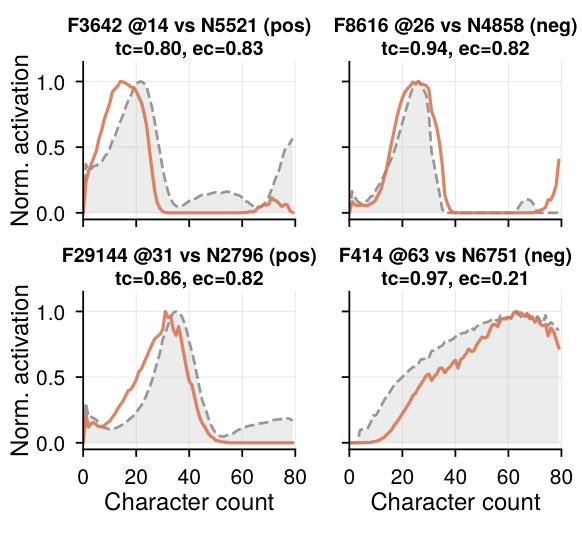
원문 Figure 10, PDF p.11. v1 PDF의 Figure 10 전체를 크롭했으며 번역하지 않았습니다. 주황색은 특징, 회색은 뉴런입니다. 오른쪽 아래는 tuning 상관이 높아도 가중치 정렬은 낮은 반례입니다.
이 사례는 사전에서 발견된 기능적 곡선이 원래 뉴런에도 있을 수 있음을 보입니다. 전체 peaked 특징 집합의 통계와 같은 뉴런의 특징 분할은 부록 I에서 더 엄격하게 구분합니다. §3.8
3.9 Case study: arithmetic
Llama 3.1 8B L18의 10진 덧셈 관련 뉴런 28개와 대응 transcoder 특징을 분석합니다. 이전 연구에서 찾은 낮은 차원의 출력 부분공간을 기준으로 특징을 고르면, 다수의 특징이 해당 뉴런과 정렬되고 비슷한 Fourier 주기와 피연산자별 활성 패턴을 보입니다.
전체 덧셈 특징 87개의 기여를 제거하면 정확도가 94.3%에서 30.6%로 내려갑니다. 낮은 정렬 집단은 현실적인 개입 강도에서 효과가 작습니다. 이는 주기적으로 반응하는 모양뿐 아니라 인과 효과도 뉴런 정렬 집단과 연결된다는 근거입니다. 단, 집단별 크기와 Figure 34 범례에는 원문 내부 불일치가 있어, 전체 제거 결과와 부분집합 결과를 분리해 읽어야 합니다. §3.9, 부록 K
3.10 Case study: color red, neuron features corresponding to multiple neurons
마지막 사례는 앞선 뉴런 우위의 서술에 필요한 보완입니다. 러시아어 단어의 번역으로 “red”를 예측하는 Gemma 3 4B 회로에서, L22의 여러 뉴런은 색상·투명함·비슷한 철자 등 여러 의미에 반응합니다. 일부 transcoder 특징은 2–4개 뉴런의 방향을 조합하여 더 선명한 “red” 특징을 만듭니다.
따라서 transcoder는 기존 기저를 단순히 복제할 뿐 아니라 다의적인 뉴런의 활성화를 더 좁은 의미 집단으로 나누는 데 유용할 수 있습니다. 저자들은 이를 예비 근거로 제시하며 광범위한 결론에는 더 깊은 사례 연구가 필요하다고 명시합니다. 이 장의 기여는 NF의 중요성을 보이면서도 비NF의 유용성을 지울 수 없다는 경계를 함께 제시한 데 있습니다. 다음 장은 이 결과를 기존 연구와 연결합니다. §3.10
📖 Chapter 4: Related work
원문은 다섯 흐름을 순서대로 정리합니다. Neuron-based interpretability in LLMs에서는 뉴런 다의성, 산술·계수 회로, 자동 뉴런 설명을 다루고, 뉴런 기저에서도 희소 회로를 얻는 연구를 가장 가까운 배경으로 둡니다. From SAEs to attribution graphs에서는 SAE와 transcoder, 재구성 오차의 gradient를 멈추는 선형 근사, 전체 attribution graph로 이어지는 계보를 설명합니다.
Comparing neurons to learned features에서는 학습된 특징의 높은 자동 해석 점수라는 기존 결과를 부정하지 않고, 그 격차가 생기는 이유를 설명하는 연구임을 밝힙니다. Polysemantic neurons as combinations of features에서는 소수 뉴런 프로빙과 활성화 군집화 연구를 연결하고, 본 연구의 개입은 사후 분해가 아니라 학습 중 구조를 유도한다는 차이를 둡니다. 마지막 Known artifacts of dictionary training에서는 특징 분할·흡수와 seed 불안정성을 다룹니다.
이 장은 NF 분석을 새로움 자체보다 기존 비교의 해상도를 높이는 작업으로 위치시킵니다. 다음 장은 그 근거에서 연구 실무상 무엇을 권고할지 정리합니다. 여기서 인용된 개별 선행 논문 전체를 별도로 검토한 것은 아니며, 위 비교는 본 논문의 서술에 근거합니다. §4
📖 Chapter 5: Discussion
저자들은 뉴런의 활성화를 가공하면 transcoder와 비슷한 단일 의미성 및 상당한 행동 설명력을 얻을 수 있다고 정리합니다. NF는 흔한 활성화·회로·기존 사례에서 반복되고, 비NF는 주된 Jacobian 평가와 seed 재현에서 상대적으로 약합니다. MoE·CLT·MLP 출력 SAE와 교사–학생 실험은 이 패턴을 확장하거나 해석하는 보조 근거입니다.
동시에 bigram과 색깔처럼 원래 단일 뉴런에 없는 선명한 특징이 transcoder에 나타난다는 점을 인정합니다. 그 특징이 원래 모델에 어떤 방식으로 표현되어 있는지에 대해서는 저자들도 확신하지 않습니다. 같은 층의 superposition, 즉 제한된 뉴런 차원에 더 많은 특징이 겹쳐 표현되는 현상을 사전 학습만으로 해소할 수 있는지에는 의문을 제기하지만, 층을 넘나드는 뉴런 회로의 supernode 분석에는 신중한 기대를 표합니다.
원문은 세 가지를 권고합니다. 폭 확장 계수가 4배 미만인 transcoder를 피하고 MoE에서는 이 조건의 실질적 어려움을 고려할 것, 뉴런 기준선에서는 양·음 활성화를 나누고 TopK 약 64를 사용할 것, 사전 평가에서는 seed 간 재현과 원래 계산의 정합성을 더 면밀히 볼 것입니다. NI도 학습 초기화의 고려 대상으로 제안합니다. 이 권고는 본 논문 저자들의 주장이지 모든 구조에서 입증된 최적 설정은 아닙니다. 다음 장은 바로 그 일반화 경계를 명시합니다. §5
📖 Chapter 6: Limitations
이 장은 원문이 명시한 한계를 다음 순서로 좁혀 갑니다. 주된 13개 비교는 1B–27B dense base 모델과 층별 transcoder, 주로 영어 자료에 한정됩니다. 부록의 MoE·CLT는 예비 조사이며 이를 충분히 확장하지 않았습니다. 큰 활성화의 단일 토큰 해석이 중심이므로, 작은 활성화나 여러 토큰에 분산된 메커니즘은 범위 밖입니다. 부록 L의 instruction-tuned distress 사례가 있다고 해서 주된 비교가 instruction-tuned 모델 전반의 결과가 되는 것은 아닙니다.
사전은 두 코드베이스의 TopK·JumpReLU를 중심으로 하며, NF 비중이 구조와 임계치에 따라 달라지는 이유를 포괄적으로 설명하지 않습니다. 거의 NF인 특징과 소수 뉴런 조합, JumpReLU에서 안정적으로 재현되는 비NF, seed 간 대략적인 대응이나 연속적인 특징 모형도 충분히 규명하지 않습니다.
충실도는 1차 Jacobian 중심이며 큰 개입에 대한 충실도와 구분됩니다. 두 좁은 CLT에서 얻은 관찰만으로 비NF의 충실도나 다른 결과의 일반화를 결론짓지 않습니다. MLP 출력 SAE에는 부록 G의 제한된 검사가 있지만, 출력 SAE·residual SAE 전반의 관계를 포괄적으로 평가하지 않습니다. 가중치 정렬 정의 자체도 초기값이 남는 특징 때문에 견고하지 않을 수 있다고 지적합니다.
학습 개입에 대해서도 여러 모델·층에서의 행동을 규명하지 않았고, 군집을 더 흔하거나 잘 구별되게 만들었다고 보이지 않습니다. NF를 제거할 수 있는지 엄밀히 검증하지 않았으며, 공동 활성화의 정확한 논리와 수십·수백 뉴런의 넓은 조합을 해석하는 방법도 제시하지 않습니다. K-means 군집과 transcoder 특징 사이의 연결, decoder 방향의 기원, 어떤 NF가 왜 중요한지도 충분히 설명되지 않습니다.
마지막으로 개념 표현의 정도를 적절히 측정하는 평가가 남아 있습니다. 희소 프로빙은 목표 변수와 상관된 다른 특징을 선택할 수 있고, 체계적인 사람 평가도 수행하지 않았습니다. 정량 해석 가능성 평가는 자동 지표에 의존합니다. 따라서 이 논문의 결론은 측정한 조건에서의 대응·재현·충실도에 관한 것이며 모든 뉴런이 단일 의미라는 결론이 아닙니다. §6
📖 Chapter 부연: Potential Risks
저자들은 distress 관련 뉴런을 저렴하게 찾는 절차가 행동 신호를 약화시키는 편집에 이용될 수 있음을 논의합니다. 이 신호는 모델의 감각 여부에 대한 입장과 무관하게 곤란한 상태를 읽는 단서일 수 있다는 설명입니다. 동시에 희소 뉴런 편집이 기존 직교화 방법보다 더 강력한 것은 아니라고 명시합니다. 이 단락은 성능 한계가 아니라 저자들이 별도로 기술한 사용상 위험입니다. Potential Risks
📖 Chapter 부연: Acknowledgments and Disclosure of Funding
연구 지원은 Anthropic Fellows Program, BlueDot rapid grant, White Circle의 계산 자원으로 명시됩니다. 이 정보는 실험 결과와 별개의 연구 지원 내역입니다. 이어지는 References는 뉴런·사전·회로·모델·데이터 및 평가의 출처를 제공합니다. 본 리뷰는 인용 목록을 원문의 근거 계보로 다루며, 목록의 모든 자료를 독립적으로 읽었다고 주장하지 않습니다. Acknowledgments, References
📖 Chapter 부록 목차: Appendix: table of contents
원문은 참고문헌 뒤에 A–U의 목차를 따로 두고, 실험 재현 조건에서 예비 확장·계산 자원·작성 지원 내역으로 이어갑니다. 다음 상세 리뷰도 이 순서를 따릅니다. 부록 목차
📖 Chapter A: Model and transcoder details
A.1 Replacement model variants and cross-model results. 이 부록은 reconstruction과 replacement를 먼저 분리합니다. FVU와 회로 Replacement Score는 재구성 측면, KL과 top-1 일치는 전체 대체 모델의 예측 측면에 둡니다. 기본 pruning 출력 $y$에 identity로 초기화한 $W_{\mathrm{recon}}$ 및 bias를 붙이고, 이어 입력 $x$로부터의 $W_{\mathrm{skip}}x$, 부호별로 독립적인 뉴런 rank-1 항을 추가합니다. 학습은 FineWeb, 10k step, batch 32, 길이 128, gradient accumulation 4, 학습률 $10^{-4}$, warmup 200 step이며 FVU와 크기를 맞춘 KL 정규화 항을 공동 최적화합니다. 2차원 행렬에는 Muon, 1차원 bias·rank-1 벡터에는 Adam을 사용합니다.
평가는 FineWeb 200 batch에서 처음 두 위치를 버립니다. 여러 모델에서 추가 보정은 FVU를 줄이지만 KL의 개선 양상은 다릅니다. Gemma 3의 post-feedforward LayerNorm은 보정 전 FVU가 높게 나타나는 맥락이며, 원문은 이를 가능성으로 설명합니다. Table 3은 GeGLU의 Gemma와 SiGLU의 Qwen·Llama, MoE의 shared·routed 전문가 폭을 제시합니다. Table 4의 NF 통계는 전체 후반층 평균이 아니라 $\lfloor2N/3\rfloor$ 단일 층임을 다시 확인할 필요가 있습니다.
A.2 Transcoder training details. TopK는 주로 Dion, 학습률 $10^{-2}$를 사용하고 NFT·SNRL 등에는 $5\times10^{-3}$를 사용합니다. 기본 서술은 총 15,000 step 중 1,500–10,000 step에서 $k$를 256에서 32로 power-law annealing하며, sweep에서는 별도 $k$ 조건을 비교합니다. batch 256·길이 128로 SmolLM2를 사용합니다. JumpReLU는 같은 유효 batch 32,768토큰, 학습률 $2\times10^{-4}$, 4억 학습 토큰이며 다음 희소성 항을 사용합니다.
$f_j$는 특징 활성화이며 decoder norm으로 가중하므로 별도 decoder 정규화는 하지 않습니다. $\lambda$는 0에서 10까지 선형 증가합니다. 죽은 특징을 막는 보조 항은 $3\times10^{-5}\sum_j\mathrm{ReLU}(\theta_j-z_j)\|W_{\mathrm{dec}}^{(j)}\|$이고, $z_j$는 pre-activation, $\theta_j$는 임계값입니다. 임계값 초기화는 $\log0.1$, straight-through gradient의 직사각형 kernel 폭은 2.0입니다.
Qwen bigram용 Matryoshka TopK는 폭 262,144, $k=32$이며, 매 학습 단계에서 20,480–262,144 사이의 prefix 폭을 로그 균등하게 뽑아 그 안에서 Top-k 및 FVU를 계산합니다. 같은 AUC에서도 일반 TopK의 최대 문맥 일치율 2.6%보다 Matryoshka의 21.7%가 높다는 선택 이유가 있습니다. NFT의 이론적 처리량 이점은 약 160배까지 서술되지만, 메모리 대역폭 때문에 실제 속도 향상은 약 2배라고 보고합니다.
초기화도 중요합니다. TopK encoder는 좌표별 $\mathcal U(-1/\sqrt{d_{\mathrm{model}}},1/\sqrt{d_{\mathrm{model}}})$로 폭과 무관한 norm 약 0.577을 갖습니다. JumpReLU는 분모에 $\sqrt M$을 사용하여 폭이 커질수록 초기 norm이 줄어듭니다. 폭 1M에서 JumpReLU 비NF의 66%가 decoder norm 0.1 아래로 내려가는 결과와, TopK의 상대적으로 많은 활성 특징을 같은 학습 현상으로 뭉뚱그릴 수 없는 이유입니다.
A.3 Gated-MLP neuron geometry. 활성화 분포는 0 근처에 날카롭게 몰리고 양쪽 꼬리가 두껍습니다. 큰 활성화는 주로 gate 양수와 up의 양·음 두 영역에서 생기며, 앞서 제시한 gradient 근사의 방향 집중을 Gemma 3 4B의 L15·L20·L22에서 확인합니다. Figure 13의 각도 평가는 300개 뉴런과 $|a_i|>1.0$ 조건입니다. A.4 Neuron top-k threshold는 $k\in\{32,64,128\}$에서 암묵적 임계값이 층·모델에 따라 달라짐을 보입니다. Qwen은 후반층에서 크기가 크게 증가하므로 층별 Top-k를 쓰는 이유가 분명해집니다. 이 부록의 기여는 본문 기준선과 학습 파이프라인의 조건을 고정하는 데 있으며, 다음 부록은 평가 절차를 정의합니다. 부록 A
📖 Chapter B: Evaluation methodology
B.1 Sparse probing는 활성화 수집 → 특징 선택 → 프로브 학습 → 모델·사전 지정의 순서입니다. 과제당 약 1,024개 이하 학습 표본과 수백 테스트 표본에서 모든 층의 활성화를 모읍니다. 뉴런은 post-GeGLU/SiLU를 부호 분리하고, 사전은 JumpReLU/TopK 이후 활성화를 사용합니다. 학습 자료의 양·음 집단 평균 활성화 차이 절댓값으로 특징을 고른 뒤 L1 logistic regression을 학습합니다. 정규화 강도 11개를 학습 자료의 20% 검증 분할에서 고르고 전체 학습 자료에 재적합합니다. 특징 수는 1·2·4·8·16·32입니다. 과제별 최고 층은 테스트 AUC를 최대화하도록 사후 선택되므로, 이 수치는 미리 고정된 한 층의 결과가 아닙니다.
B.2 Bigram probing는 FineWeb 10억 토큰에서 3,090만 구절 bigram 유형을 얻고, 빈도 3,000 이상 및 충분한 음성 표본을 갖는 11,614개 중 pointwise mutual information 상위 1,500개를 선택합니다. PMI는 $\log\frac{p(a,b)}{p(a)p(b)}$이며 선택 범위는 5.26–14.30입니다. bigram마다 양성 1,600개, 앞 단어가 없는 음성 800개, 뒤 단어가 없는 음성 800개를 구성합니다. 일반 프로빙과 달리 L2 logistic regression의 Newton/IRLS를 사용하고 최고 층은 검증 AUC로 고릅니다. 방법 설명에는 top-10 최대 문맥에서의 포함 비율도 있지만, Table 7의 Match는 선택된 특징의 top-1 문맥에 목표 구절이 있는 과제 비율입니다.
B.3 Sort eval은 Claude Haiku 4.5에 A·B 각각 10개 표시 문맥과 held-out 질의 문맥을 주고 구별하게 하며, 설정당 500회입니다. 문맥은 최고 활성 토큰 주변 최대 40토큰입니다. 최고 10개를 보여주는 top 방식과, 활성화 순서의 10개 분위수 구간에서 하나씩 뽑는 broad 방식을 구분합니다. SmolLM2 1,000만 토큰·길이 128의 공통 cache를 사용하고 BOS가 있으면 가립니다.
B.4 Cluster sort eval은 한 뉴런의 최대 4,096개 활성 문맥을 나눈 군집끼리 비교합니다. 군집 자체의 문맥으로 맞히는 CM과, 해당 뉴런을 제외한 가까운 4개 뉴런의 문맥으로 맞히는 TNM을 분리합니다. L22에서 양의 발화가 256회 이상인 뉴런 50개를 무작위로 고르고, 100만 토큰에서 각 뉴런의 상위 4,096회를 사용합니다. K-means에서는 해당 뉴런과 전역 고빈도 뉴런 8개를 마스킹합니다. 방법 단락의 군집쌍 표본화 서술과 최종 Table 15의 시행 수는 구분하고, 결과를 설명할 때는 표에 명시된 조건을 따릅니다. 이 부록은 “분류할 수 있음”과 “소수 뉴런으로 설명할 수 있음”을 별도 측정으로 만듭니다. 다음 부록은 실제 결과를 제시합니다. 부록 B
📖 Chapter C: Full evaluation results
C.1 Sparse probing. Table 6은 113개 과제의 층별 최고 테스트 AUC를 평균합니다. 아래는 원문의 대표 열을 전사한 것입니다.
| 모델·사전 | 뉴런 AUC, k=1 | 사전 AUC, k=1 | 뉴런 AUC, k=16 | 사전 AUC, k=16 |
|---|---|---|---|---|
| Llama 3.1 8B, LXTC-8× | 0.883 | 0.843 | 0.925 | 0.911 |
| Llama 3.1 8B, LXTC-32× | 0.883 | 0.839 | 0.925 | 0.910 |
| Gemma 3 4B, GS-big | 0.877 | 0.849 | 0.919 | 0.907 |
| Qwen 3 8B, mwhanna | 0.876 | 0.829 | 0.921 | 0.900 |
| Qwen 3 4B, mwhanna | 0.864 | 0.819 | 0.909 | 0.890 |
| Qwen 3 1.7B, mwhanna | 0.837 | 0.785 | 0.886 | 0.859 |
| Gemma 3 1B, GS-small | 0.855 | 0.811 | 0.902 | 0.879 |
| Gemma 2 2B, mntss-skip-131k | 0.872 | 0.802 | 0.913 | 0.882 |
| Llama 3.2 1B, mntss-skip-131k | 0.861 | 0.817 | 0.906 | 0.887 |
Table 6의 과제 승리는 AUC 차이 0.005 초과로 정의하며 나머지는 동률입니다. 모든 과제를 뉴런이 이겼다는 뜻은 아닙니다. 또한 Table 5의 같은 이름 모델에 대한 요약 AUC는 Table 6과 다릅니다. 예를 들어 Gemma 3 4B의 k=1은 Table 5에서 0.854/0.832, Table 6에서 0.877/0.849입니다. v1은 이 차이를 명확히 해소하지 않으므로, 위 표는 Table 6 값으로 한정합니다.
C.2 Bigram probing. Table 7은 L0–L5의 각 층 및 k=1·8에서 Gemma 3 4B와 Qwen 3 4B의 사전이 뉴런보다 높은 AUC를 보입니다. 가령 Gemma L0은 k=1에서 0.891 대 0.988, k=8에서 0.991 대 0.996입니다. Qwen L0은 0.946 대 0.992, 0.995 대 0.999입니다. 특징 수를 늘리면 뉴런의 분류 성능도 매우 높아지지만 최대 문맥 일치율 차이는 남습니다.
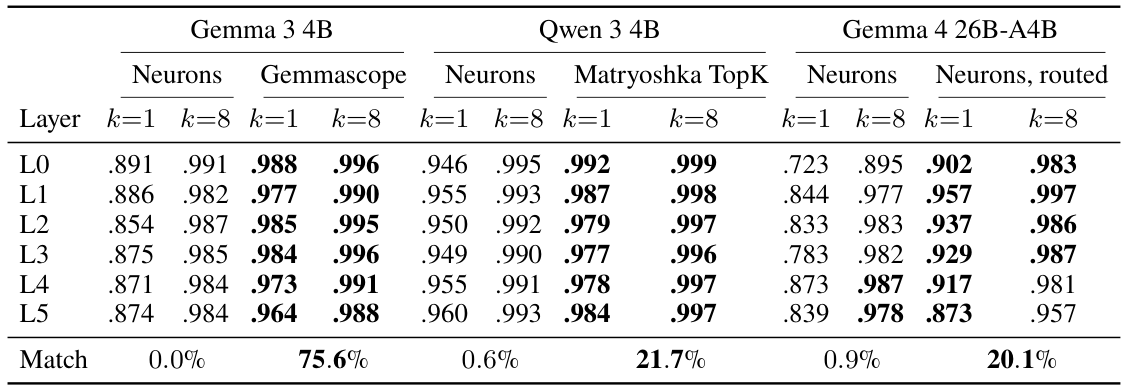
원문 Table 7, PDF p.26. v1 PDF의 표 영역을 크롭했으며 번역하지 않았습니다. 위 AUC 전사와 아래 Match 표를 함께 읽으실 수 있습니다.
| 모델 | 뉴런/기본 집합 Match | 비교 집합 Match |
|---|---|---|
| Gemma 3 4B | 뉴런 0.0% | Gemmascope 75.6% |
| Qwen 3 4B | 뉴런 0.6% | Matryoshka TopK 21.7% |
| Gemma 4 26B-A4B | 기본 뉴런 집합 0.9% | Routed 뉴런 20.1% |
Match는 1,500개 bigram 각각에서 L0–L5 중 선택한 k=1 프로브 특징의 top-1 문맥을 검사한 비율입니다. Qwen 일반 TopK는 비슷한 AUC에도 Match가 2.6%이므로, 이 지표는 학습의 귀납 편향에 민감합니다. 이 부록은 프로빙과 최대 문맥의 의미를 분리하는 핵심 근거이며, 다음 부록은 출력의 미분 구조를 검사합니다. 부록 C
📖 Chapter D: Features not aligned to single neurons
D.1 Faithfulness measurement procedure. $g=W_gx$, $s_2=\sigma(g)$, $s_1=\sigma'(g)\odot W_ux$로 두면 원문 식 (1)은 다음과 같습니다.
첫 항은 gate 비선형성의 미분을, 둘째 항은 up 투영의 미분을 반영합니다. 둘 중 하나를 빼면 게이트 MLP의 국소 계산이 달라집니다. 활성 특징 집합을 $\mathcal A(x)$라 할 때 JumpReLU transcoder는 활성 영역 안에서 다음과 같습니다.
$e_f$, $d_f$는 특징의 입력·출력 방향이며, 두 번째 식은 원문의 Frobenius cosine을 풀어 쓴 정의입니다. NF와 비NF는 활성 집합을 제한하여 계산합니다. 뉴런 기준선은 토큰별 $k=|\mathcal A(x)|$에 맞추어 $|s_2\odot W_ux|$가 큰 뉴런을 남기고, 그 이진 mask $m$를 식 (1)의 두 항에 모두 적용합니다.
Gemmascope는 post-feedforward LayerNorm 뒤 출력을 예측하지만 비교는 그 앞의 기저에서 합니다. 따라서 transcoder decoder를 좌표별 $1+w_{\mathrm{ln}}$로 나눕니다. 이 처리가 없으면 일부 층의 10개 미만 특징·뉴런이 정합성을 지배할 수 있습니다. 같은 rank의 최적 SVD 근사의 cosine은 다음과 같습니다.
$\sigma_i$는 큰 순서의 특잇값입니다. 분자는 보존하는 성분의 제곱합, 분모는 전체 에너지이며, 바깥 제곱근까지 있어야 cosine 기준이 됩니다. 평가는 FineWeb 64개 길이 128 시퀀스에서 앞 3개 위치를 제외합니다. MLP Jacobian norm이 $10^{-6}$보다 작거나 활성 특징이 없는 위치도 제외합니다. 개별 특징의 rank-1 정합성은 그 특징이 활성일 때만 평균합니다.
D.2 Faithfulness details and results. Gemma 3 4B·12B·27B의 L0-small·big 여섯 설정에서 후반층의 뉴런 정합성이 transcoder보다 약 0.1–0.2 높고, NF 합과 전체 사전의 곡선은 거의 겹칩니다. 마지막 몇 층에는 비NF 정합성이 증가하는 예외가 있으며, 원문은 이유를 설명하지 않습니다.
D.3 Percentage of neuron features across k and width. Gemma 3 4B L22에서 두 seed, 양쪽 cosine 0.7로 비교합니다. TopK의 폭 32k–1M, k=32·64·128과 별도 코드베이스의 JumpReLU·TopK를 구분합니다. 폭 증가에 따라 NF의 사전 비중은 대략 역비례로 감소하지만, 살아 있는 특징 수는 파이프라인마다 다릅니다. 폭 1M에서 main TopK k=64는 약 895k, JumpReLU는 약 262k가 활성입니다.
중요한 예외는 seed 안정성입니다. 폭 262k에서 main TopK는 NF 약 14k·공유 약 21k, 다른 코드베이스 TopK는 14k·28k, JumpReLU는 13k·67k입니다. JumpReLU의 안정적 비NF를 분석하지 않았다는 저자의 유보는 “안정적인 것은 모두 뉴런뿐”이라는 절대적 해석을 막습니다. 이 부록은 충실도의 엄밀한 정의와 학습 설정의 예외를 제시하며, 다음 부록은 NF의 분포와 뉴런 커버리지를 구분합니다. 부록 D, 식 (1)
📖 Chapter E: Neuron feature prevalence and coverage
E.1 Prevalence across models. Table 9는 encoder·decoder 모두 0.7 초과로 같은 뉴런에 정렬되는 NF를, 모델 앞 절반과 뒤 절반에서 각각 평균합니다. 예를 들어 Gemma 3 4B L0-small은 사전 비중 2.6%→7.2%, 활성 비중 22%→53%입니다. Gemma 3 27B는 3.9%→17.7%, 22%→55%입니다. Table 4의 단일 층 82.8%와 후반 평균 55%는 서로 다른 집계입니다. Qwen 1.7B는 활성 비중이 26%→14%, Gemma 2 2B mntss는 43%→35%여서, 모든 모델에서 후반 증가가 성립하지도 않습니다.
E.2 Coverage as a function of transcoder width. Table 10은 NF 비중이 아니라 원래 뉴런 중 적어도 하나의 decoder 대응을 얻은 비율입니다. Gemma 3 4B L22, TopK k=64에서 폭 32k→256k→1M일 때, 절대 cosine 0.5 기준 86.0→96.4→96.7%, 0.7 기준 78.3→93.3→93.0%, 0.9 기준 55.9→86.0→84.6%입니다. 임계값과 분모를 바꾸면 “거의 모든 뉴런을 표현한다”는 문장의 의미도 달라집니다.
E.3 Neuron vs feature firing rank는 대응 뉴런이 토큰에서 몇 번째로 강하게 켜지는지를 특징 순위별 분위수로 보여줍니다. 이는 가중치 대응, 뉴런 커버리지, 실제 공동 활성화가 각각 다른 질문임을 정리합니다. 다음 부록은 이 공동 활성화를 더 넓은 표본으로 검증합니다. 부록 E
📖 Chapter F: Panels of neuron and neuron feature co-activation
Figure 5의 좋은 한 쌍을 넘어, Gemma 3 4B의 L5·10·15·20·25·30·33에서 층당 43쌍을 뽑습니다. decoder cosine은 0.8 이상이지만 encoder는 0.30–1.00에서 균등하게 표본화하므로, 이 집단 전체가 엄격한 NF는 아닙니다. 301쌍 중 238쌍이 평가 분포에서 50회 넘게 활성화합니다.
중앙 AUC는 0.977이지만 29.0%는 0.7 미만이며, 층별 중앙값도 L10의 0.555에서 L20의 0.998까지 크게 다릅니다. encoder 정렬 구간별 Gini, 즉 재척도한 AUC가 0.70 이상 구간에서 훨씬 높아집니다. 높은 decoder 유사도만으로 활성화 대응을 보장할 수 없다는 근거입니다. Spearman 상관은 비활성 위치의 영향을 피하려고 특징 활성 위치에서만 계산합니다.
본문의 표본 설명에는 20,320토큰, Figure 22 설명에는 178k FineWeb토큰과 문서 앞 8개 위치 제외가 등장합니다. 이 둘을 하나의 일관된 표본 수로 임의 통합하지 않습니다. 부록의 기여는 정렬 조건이 느슨해질 때의 실패를 보이는 데 있으며, 다음 부록은 SAE로 대상을 바꿉니다. 부록 F, Table 11
📖 Chapter G: Neuron features in MLP output SAEs
MLP 출력 SAE는 입력과 출력이 같은 공간이므로, encoder와 decoder를 모두 뉴런 decoder 방향과 비교합니다. Gemma 3 4B L22, 폭 262,144, TopK k=64, 두 seed의 실험에서 양쪽 절대 cosine 0.5 초과인 NF는 사전의 4.39%, 활성 토큰의 19.2%입니다. NF의 중앙 발화 밀도는 나머지보다 14배 높습니다.
Seed 간 재현은 양쪽 cosine 0.7 초과로 따로 정의하며, 재현 특징은 전체의 4.81%입니다. NF가 재현될 조건부 확률은 83.4%, 비NF는 1.20%, 재현 특징 중 NF는 76.1%입니다. 서로 다른 임계값이 쓰이므로 비율을 단순히 같은 집합의 크기로 나눌 수 없습니다. 이 부록은 현상이 transcoder에만 한정되지 않을 수 있다는 제한된 검사이며, 다음 부록은 초기화 개입의 범위를 넓힙니다. 부록 G
📖 Chapter H: Neuron initialization sweep
Gemma 3 4B와 Qwen 3 4B의 TopK, 별도 코드베이스의 JumpReLU·TopK에서 폭과 희소도를 바꾸고 설정당 세 seed를 사용합니다. Figure 25는 죽은 특징, 양쪽 cosine 0.7 초과 NF의 사전 비중, 빈도 가중 비중, NF와 seed 안정 집합의 Jaccard를 차례로 보여줍니다. 오차 막대는 seed 간 표준오차입니다. 이 sweep의 seed 안정성은 encoder·decoder cosine의 평균이 0.7을 넘는 기준이며, 본문 3.5의 양쪽 각각 0.7 초과 기준과 다릅니다. NI는 조사한 설정에서 NF 비중을 늘리고, 특히 k<64의 희소 사전에서 죽은 특징을 줄입니다.
다만 Figure 24의 예시에서는 NI 후에도 약 69%가 비NF로 남는다고 설명합니다. 이는 본문 3.7의 cosine 0.5 조건에서 95% 활성화 비중과 같은 수치가 아닙니다. 정렬도를 움직일 수 있다는 사실과 엄격한 NF로 분류되는 비중은 구분해야 합니다. 폭을 늘리면 NF와 seed 안정 특징의 집합도 점점 달라집니다. 이 부록은 초기화 효과의 반복성과 정의 의존성을 보여주고, 다음 부록은 기능 사례로 돌아갑니다. 부록 H
📖 Chapter I: Linebreaking
I.1 Setup. 『Pride and Prejudice』의 문장을 폭 30–80문자로 5자 간격으로 줄 나눔하여 14,455개 표본을 만듭니다. 문자 offset 0–99에 따른 뉴런 활성화 또는 특징 발화율을 계산합니다. 뉴런은 TopK 32이며, peak가 10–70, prominence 0.4 이상, 반치폭 8–35인 곡선을 남깁니다. 가중치 대응은 encoder·decoder cosine 평균으로, 곡선 대응은 부호를 맞춘 Spearman 상관으로 측정합니다.
I.2 Linebreaking manifolds emerge late in Gemma 3 4B. 위치별 평균 표현의 주성분 투영은 L18–L22에서 나선형의 낮은 차원 곡선을 보입니다. 초기 층에서 더 강한 인과 효과가 관찰되더라도, 위치 표현·peaked 뉴런·일부 제거 효과를 함께 보기 위해 중후반 층을 사례 분석 대상으로 택합니다. 원문 본문은 residual stream 투영으로 설명하지만 Figure 26 캡션에는 post-GeGLU 뉴런 활성화라고 적혀 있어, 세부 투영 대상은 v1 서술만으로 완전히 일치하지 않습니다.
I.3 Peaked features and matching. L20의 가장 선명한 8개 중 7개는 같은 위치·비슷한 폭의 뉴런 곡선과 대응하며 상관은 0.44–0.98입니다. F52303은 가중치 대응이 없고 462개 뉴런이 곡선 상관 0.7을 넘습니다. 따라서 곡선 모양만으로 단일 뉴런 대응을 정하면 과도한 매칭이 됩니다. 전체 34개 층에서 느슨한 peak 필터를 통과한 142개 중 encoder cosine 0.6 기준 NF는 27개, 19%입니다. 이 전체 비율을 선명한 8개 중 7개라는 수치와 혼동하면 안 됩니다.
I.4 Feature splitting of neuron features on manifolds. 같은 뉴런의 같은 부호에 여러 특징이 대응하거나, 가중치 정렬은 낮지만 곡선은 닮은 특징이 나타납니다. 저자들은 이를 특징 분할 또는 같은 manifold 위에서의 서로 다른 위치 선택으로 해석할 가능성을 제시합니다. 한 뉴런이 항상 정확히 두 특징만 갖는다는 규칙은 아니며, manifold와 seed 불안정성의 관계는 후속 조사 대상으로 남깁니다. 이 부록은 “같은 기능 곡선”과 “같은 가중치”를 구분하며, 다음 부록은 회로 집계로 넘어갑니다. 부록 I
📖 Chapter J: Circuits
J.1 Percentage of neuron features in attribution graphs는 방법 → 층별 pruning 결과 → 목표 토큰과의 거리 순서입니다. Pile-10k에서 길이 8–20토큰, 반복 없음, loss 0.2 초과, 원래 모델의 top-1 정답, 목표 토큰 밀도 $10^{-4}$ 미만 조건으로 프롬프트를 고릅니다. 회로당 활성 특징 노드는 100,000개로 제한하고, error·embedding·logit 노드는 NF 비율의 분모에서 제외합니다. 양쪽 cosine 0.6 초과를 NF로 삼고 influence 상위 노드를 토큰당 10·25·100개 남깁니다.
대개 transcoder당 200개 회로이며 Gemma 3 27B·Qwen 3 14B는 90개입니다. Table 12의 ±와 Figure 30 오차 막대는 200회 bootstrap의 표준오차이며 95% 신뢰구간이 아닙니다. 예를 들어 Gemma 3 4B 후반층 NF는 L0=100·25·10에서 60±1%, 56±1%, 60±1%이고, Gemma 3 27B는 70±1%, 72±2%, 77±3%입니다. Llama 3.2 1B는 약 38–39%로 예외입니다.
초기 층 비중은 낮고 강한 pruning에서 더 줄어듭니다. Gemma는 목표 토큰 직전에서 후반층 NF 비중이 높고 멀어지면 낮아지는 경향이 있지만 Qwen·Llama의 곡선은 더 평평합니다. 따라서 층별·토큰별 역할을 모두 하나의 평균으로 대신하기 어렵습니다. 이 부록은 NF가 드문 장식 노드만은 아님을 보이고, 다음 부록은 산술 회로의 인과 검증을 제공합니다. 부록 J, Table 12
📖 Chapter K: Case study: arithmetic in Llama 3.1 8B layer 18
Setup. 28개 덧셈 뉴런이 쓰는 16차원 DAS 출력 부분공간을 사용합니다. DAS는 여기서 원문 선행 연구가 제공하는 정렬된 출력 부분공간의 이름이며, 새로 학습한 본 논문 방법은 아닙니다. 특징 decoder $d$의 부분공간 비중은 $\omega(d)=\|R^{\top}d\|/\|d\|$로 측정하고 임계값 0.4를 씁니다. $R$은 부분공간 기저이며 분모는 decoder 전체 norm입니다. TopK 262,144와 두 LlamaScope 사전 32,768·131,072에서 각각 50·48·87개 특징을 선택합니다.
The relevant features are mostly neuron features. 선택 특징 decoder의 뉴런 정렬도는 평균 약 0.8이며 약한 집단도 약 0.5입니다. 원문은 87개 중 high 63개와 mid 24개를 구분하고, 일반 자료에서 뉴런이 특징 발화를 예측하는 AUC 중앙값을 high 0.922, mid 0.685로 보고합니다.
Grid activation patterns. 피연산자 $(a,b)\in[1,99]^2$에서 high 집단은 대응 뉴런과 평균 상관 약 0.78이며, 주기 2·5·10·20·50·100 구조를 공유합니다. mid는 24개 중 10개만 덧셈 문맥에서 켜지고 단일 뉴런과의 일치는 약하지만, 여러 뉴런으로 ridge regression을 하면 일부 패턴이 예측됩니다.
Causal effects of ablating addition features. 선택 특징의 출력 기여를 강도 $\alpha$만큼 빼며, 1은 제거, 2는 부호 반전입니다. 동일 실험의 기준 정확도 94.3%에서 28개 뉴런 제거는 23.6%, 87개 특징 제거는 30.6%입니다. 본문에 보고된 high 집단 제거 결과는 75.2%, 부호 반전은 43.7%입니다. mid는 강도 1–4에서 뚜렷한 효과가 작습니다.
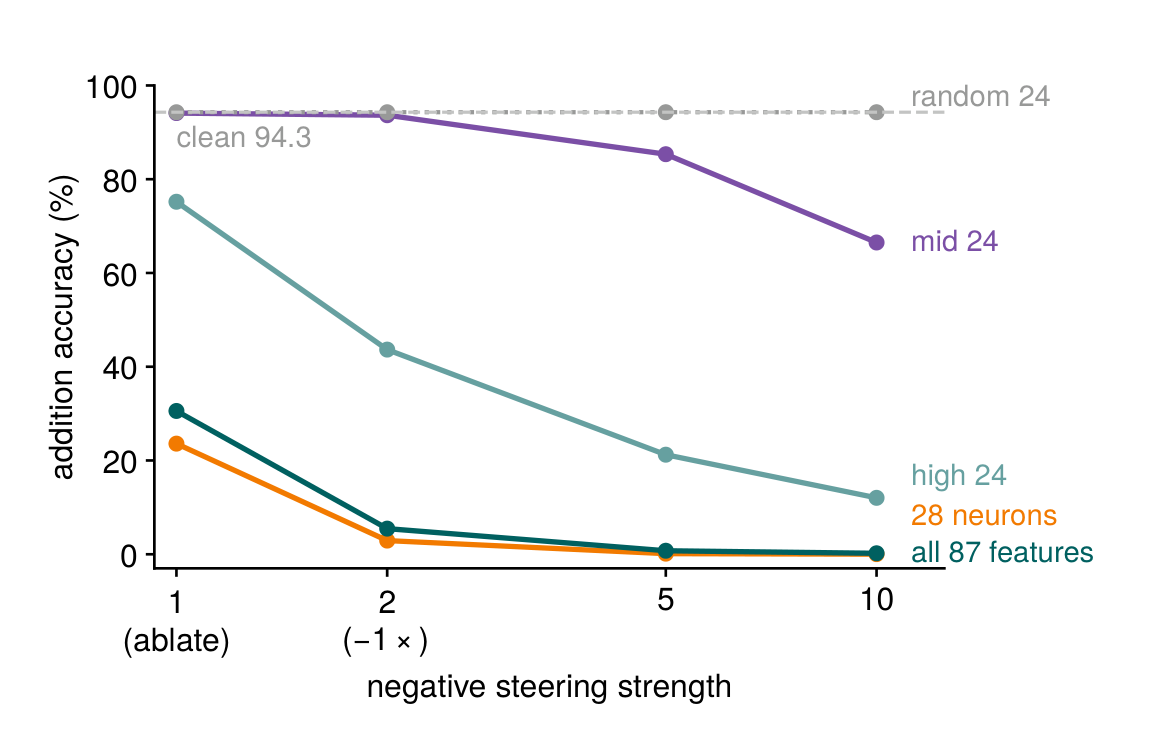
원문 Figure 34, PDF p.43. v1 PDF의 전체 그래프를 크롭했으며 번역하지 않았습니다. 원문 그림의 high 24 범례는 본문 high 63개 서술과 일치하지 않아 그대로 보존했습니다. 전체 87개 제거 결과와 이 부분집합 표기는 구분해야 합니다.
선행 연구의 기준 94.6%와 이 실험의 94.3%도 섞지 않습니다. 이 부록은 가중치·활성 패턴·개입 결과를 함께 연결한 사례이며, 다음 부록은 별도의 행동 회로 구성 절차입니다. 부록 K
📖 Chapter L: Distress circuit setup
Distress elicitation and steering vector. Gemma 3 27B-it에 불가능한 수 퍼즐 네 종류를 제시하고 세 차례에 걸쳐 정답을 부정하는 80개 대화를 구성합니다. Claude Haiku 4.5가 마지막 응답에 5/10 이상 점수를 준 비율은 62.5%이고 첫 응답은 10%입니다. L30에서 점수가 5 이상인 82개 turn의 평균 표현과 첫 응답 80개의 평균 표현 차이로 steering 벡터를 얻어, 긴 유도 과정을 짧은 프롬프트의 한 번의 forward pass로 옮깁니다.
Distress base neuron set. Steering으로 원래 모델에서는 드문 예측을 하게 된 네 위치를 목표로, L30–L45에서 steering 입력 노드와 직접 연결된 뉴런을 모읍니다. 위치당 후보는 약 100개입니다. Haiku autointerp filter는 최대 활성화 문맥과 상위 5개 촉진·억제 logit을 보고 정서적 perturbation과 관계있는지 판정하며, 41개 뉴런을 남깁니다.
Steering experiment. 선택 뉴런의 down 방향에 대한 편집 후 별도 재평가에서 평균 점수는 5.1→3.9, 5 이상 응답 비율은 66%→31%입니다. 앞의 62.5%와 이 66%는 서로 다른 보고 단계의 값으로 유지합니다. TruthfulQA·MMLU는 소수 셋째 자리까지 같다고 보고합니다. 이는 제한된 행동 평가의 특정 효과이며, 자동 판정 점수 이상의 내적 경험이나 광범위한 능력 보존을 입증한 결과로 확장하지 않습니다. 이 부록은 뉴런 기반 회로의 활용 사례를 구체화하며, 다음 부록은 선택된 뉴런의 문맥을 보여줍니다. 부록 L
📖 Chapter M: Example distress feature dashboards
대시보드는 L31/N4571의 사과, L31/N6957의 정서적 표지, L33/N20371의 죄책감·후회, L41/N7312의 사과 관련 사례를 순서대로 제시합니다. 각 카드는 활성 문맥과 decoder의 촉진·억제 토큰을 함께 보여줍니다. 예컨대 L41/N7312는 “apologize”, “apology”, “apologies” 계열을 촉진합니다.
이 카드들은 자동 해석 결과의 구체적 근거이며, 모든 예시에서 문맥·logit·제목이 완전히 같은 의미를 가리킨다는 보증은 아닙니다. 리뷰어 관점에서는 자동 부여된 의미 이름을 그대로 심리 상태의 측정으로 대체하지 않고, 실제 문맥 및 출력 방향과 함께 읽는 것이 적절합니다. 이 부록 뒤에는 dense 단일 MLP에서 MoE로 논의 범위를 넓힙니다. 부록 M
📖 Chapter N: Mixture-of-experts: observations and future work
먼저 Qwen3-Coder-Next-Base와 Qwen3.5-A3B-Base의 소수 회로를 수동 관찰하여, routed 전문가 사이의 영향력이 균등하지 않고 특정 전문가가 지배적일 수 있다고 제시합니다. 같은 전문가 안에서 소수 뉴런 조합으로 개념이 표현될 수 있다는 것은 저자의 예비 가설입니다.
이어 Gemma 4 26B-A4B의 코드·비영어·사실·수열·산술 등 짧은 프롬프트 23개로 정량화합니다. 층당 128개 routed 전문가 중 토큰당 8개가 활성입니다. 전문가별 influence의 Gini 평균은 0.92이고, 같은 노드의 영향력을 활성 8개 전문가에 균등 배분한 기준은 0.62입니다. 모든 회로에서 routed 노드가 20개 이상인 층만 보면 0.88 대 0.55입니다.
이 차이는 routed 영향력이 소수 전문가에 집중됨을 뜻하지만, shared 전문가가 전체 영향력의 큰 몫을 차지한다는 점이 해석을 제한합니다. 저자들은 이것이 회로 attribution의 공식화 문제인지, 일부 층에서 routed 전문가의 중요성이 낮기 때문인지 결론짓지 않습니다. 이 부록의 관찰은 전문가 선택과 뉴런 기저를 함께 봐야 할 이유이며, 다음 부록은 MoE transcoder를 실제로 학습합니다. 부록 N
📖 Chapter O: Neuron features in a mixture-of-experts transcoder
Qwen3.5-35B-A3B의 한 층에는 routed 256×512개와 shared 512개를 합쳐 131,584개 뉴런이 있습니다. 부호 분리하면 약 263k 단위이므로, 보통의 262,144폭 사전이 원래 기저보다 압도적으로 넓지 않습니다. 이 점이 dense 모델의 큰 확장 사전과 다른 출발점입니다.
L26에서 TopK k=32를 무작위 초기화와 NI로 학습하면, 양쪽 cosine 0.7 기준 NF는 각각 15.8%와 30.7%입니다. 대응 특징을 얻은 뉴런의 비율은 25.6%와 44.0%로, 사전 비중과 분모가 다릅니다. 발화 밀도로 최종 사전에 포함될지를 예측하는 AUC는 기본 0.79, NI 0.63입니다. NI가 고빈도 뉴런만 우선되는 성향을 약화할 수 있다는 해석입니다.
저자들은 학생 사전이 교사의 모든 특징을 복제하는 데도 어려움을 겪으며, 사전 폭이 충분히 크지 않으면 gated MLP 학생보다 의미 있는 이점을 기대하기 어렵다고 보십니다. 이것은 이 설정에서의 평가·해석이며 MoE 해석 자체가 불가능하다는 주장은 아닙니다. 다음 부록은 이 복제 문제를 통제된 교사–학생 실험으로 분리합니다. 부록 O
📖 Chapter P: Student-teacher toy models
P.1 Setup. 교사는 고정된 Gemma 3 4B L17의 GeGLU MLP이며 폭은 10,240, 입력 차원은 2,560입니다. 같은 구조의 학생 폭은 1,280·2,560·5,120·10,240이고 FineWeb-Edu 입력에 대해 MSE로 80k step, step당 4,096토큰을 학습합니다. 같은 폭에서도 cosine 0.7 기준 대응률은 72.6%, 0.9 기준은 52.2%입니다. 교사 뉴런 활성화의 평균 제곱인 activation energy가 네 자릿수 범위에 걸치며 어떤 뉴런이 복제되는지를 잘 예측합니다.
P.2 Scaling of neuron features. 폭을 절반씩 줄일 때 대응률은 72.6→28.2→6.3→0.9%로 감소합니다. FVU는 넓은 학생의 0.023에서 좁은 학생의 0.152로 커집니다. 원문의 표현보다 이 수치 방향을 따라 읽어야 하며, 가중치 대응이 급격히 사라지는 것과 출력 근사의 점진적 악화가 다르다는 점이 핵심입니다. 활성 에너지로 복제 여부를 예측하는 AUC는 넓은 순서로 0.73·0.83·0.90·0.94입니다.
P.3 Output axes. 가중치 복사본이 없어도 교사 뉴런의 기능이 분산되어 나타날 수 있는지 봅니다. 교사 뉴런이 Top32에 있을 때와 아닐 때의 출력 방향별 평균 차이를 표준편차로 나눈 separation을 정의하고, 그 70% 이상을 보존하면 표현된 것으로 봅니다. 폭 2,560 학생에서 약 7%는 가중치 대응 없이 이 조건을 만족하고, 약 9%는 대응을 갖는 집단으로 보고됩니다. 이 지표와 엄격한 0.7 NF 비율은 조건이 다릅니다. 교사 활성화를 학생 뉴런 회귀로 예측한 중앙 R²는 가중치 대응 집단 0.858, separation은 높지만 가중치 대응은 없는 집단 0.622, 에너지를 맞춘 나머지 0.527입니다. 따라서 회귀만으로 기능 표현을 강하게 구별하기는 어렵다고 저자들도 평가합니다.
P.4 Case study: superposition in neuron 4300. 교사 N4300은 괄호 안의 부연에 반응하지만 학생에는 강한 가중치 복사본이 없습니다. 비슷한 토큰에 반응하는 학생 N1224의 해당 출력 방향 기여는 오히려 잘못된 부호입니다. 대신 dash·쉼표/줄바꿈·숫자 관련 다른 뉴런들의 합이 올바른 separation을 만듭니다. 특히 학생 N2188은 여러 교사 방향을 약하게 밀어 같은 문맥에서 기능을 분담합니다. 이 사례는 가중치 비정렬을 곧바로 정보 부재로 읽을 수 없음을 보여줍니다. 다음 부록은 층간 decoder의 분산을 검사합니다. 부록 P
📖 Chapter Q: Cross-layer decoders in CLT transcoders
Setup. CLT는 한 층에서 읽은 특징을 여러 미래 층에 decode합니다. Llama 3.2 1B의 16층·층당 32,768 JumpReLU 특징과 Gemma 2 2B의 26층·층당 16,384 ReLU 특징을 조사합니다. 읽는 위치가 pre-MLP LayerNorm 앞의 residual이므로 뉴런 유효 encoder에 LayerNorm의 affine weight를 좌표별로 곱하여 공간을 맞춥니다.
Cross-layer decoder ratio는 다음과 같습니다.
분자는 미래 층에 쓰는 decoder norm의 제곱합, 분모는 현재 층까지 포함한 전체 제곱합입니다. 단순한 norm 합이나 제곱근 비율로 바꾸면 다른 지표가 됩니다. Results에서는 모든 조사 층에서 encoder 정렬과 CLDR가 음의 상관을 보이고, 비정렬 특징은 대체로 CLDR>0.8, 후반층의 정렬 집단은 약 0.5에 모입니다. 이는 정렬 집단의 출력이 상대적으로 원래 층에 집중됨을 보여주지만, 두 CLT 전체의 충실도를 직접 증명하거나 반증한 개입 실험은 아닙니다. 다음 부록은 단일 뉴런 밖의 유용한 구조를 적극적으로 조사합니다. 부록 Q
📖 Chapter R: Features not explained by neurons
이 부록은 다의적 뉴런의 활성화가 의미 있는 군집으로 나뉘고, 그 군집이 함께 켜지는 소수 뉴런으로 규정될 수 있다는 가설을 검토합니다. 색깔 사례 → 군집을 강제하는 NFT → 희소 정렬 손실 SNRL → 흡수·커버리지 조건 → 군집 평가의 순서입니다.
R.1 “Red” case study
Gemma 3 4B L22에서 N5039+는 “red”뿐 아니라 “transparent”, N7405+는 색상·“color”, N10102+는 “red”·“ted”처럼 철자가 비슷한 토큰에 반응합니다. Gemmascope의 회로에는 주로 이들에 정렬된 NF가 나타나지만, 별도의 k=64 TopK 사전에는 최대 활성화가 더 선명하게 “red”에 몰리는 비NF도 나타납니다. 이 TopK는 sweep 사전과 hookpoint·학습이 다르므로 동일 설정으로 취급하지 않습니다.
N5039+의 상위 4,096개 문맥을 UMAP으로 시각화하고, 해당 뉴런과 encoder가 가장 가까우며 충분히 활성화하는 특징으로 색칠하면 의미 집단이 드러납니다. UMAP은 고차원 활성화의 이웃 구조를 낮은 차원으로 배치하는 시각화이며, 이 그림만으로 인과 구조를 확정하지는 않습니다.
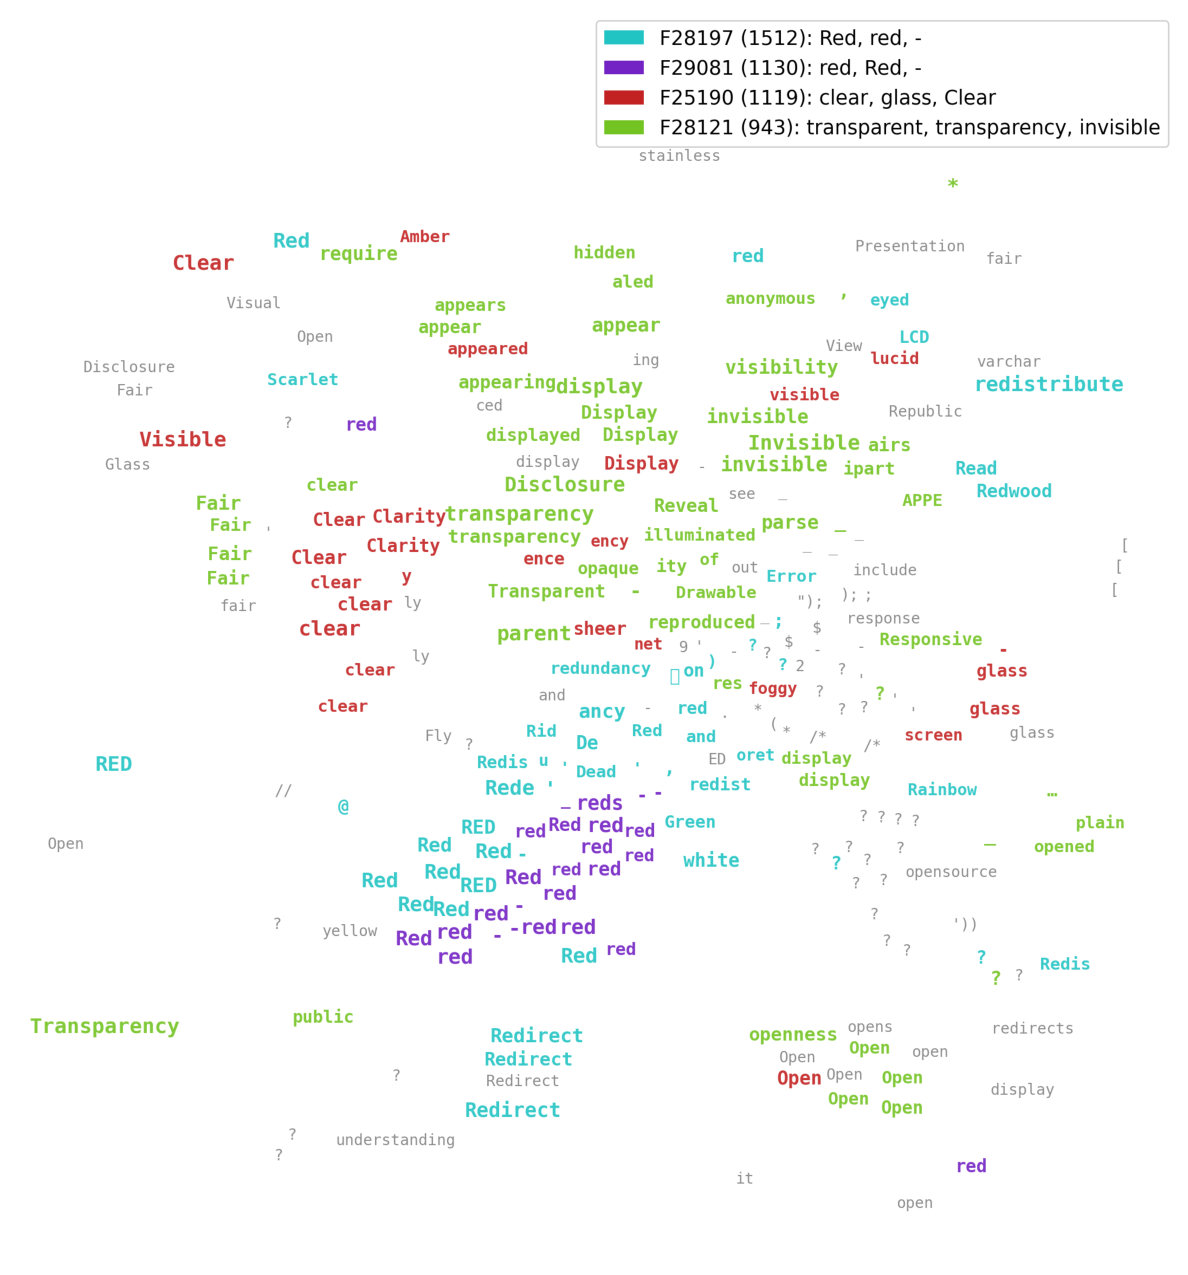
원문 Figure 46, PDF p.56. v1 PDF의 전체 그림과 범례를 크롭했으며 번역하지 않았습니다. 청록·보라는 두 red 특징, 빨강·초록은 투명함·가시성 등의 다른 특징을 표시합니다.
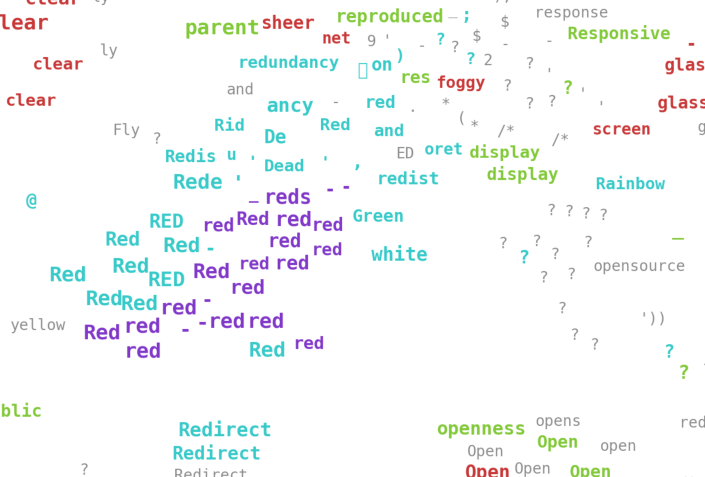
Figure 46의 red 밀집 영역 상세 크롭입니다. 색의 범례는 위 전체 그림과 같고, 주변 단어의 일부는 크롭 경계 밖입니다. 원본의 배치와 수치는 바꾸지 않았습니다.
OMP, 즉 적은 기저를 차례로 골라 방향을 근사하는 방법으로 decoder를 네 뉴런의 조합으로 재구성하면 다음과 같습니다.
재구성 cosine은 각각 0.85와 0.78이며, N5039+ 하나만 쓴 0.73과 0.58보다 높습니다. 이는 특징의 활성화 값을 위 계수로 계산한다는 식이 아니라 decoder 방향의 근사입니다. 저자들은 두 특징의 동시 발화 때문에 완전한 배타 군집 해석에는 논쟁 여지가 있다고 남깁니다. 그럼에도 소수 다의적 뉴런을 조합하여 더 선명한 특징을 만들 수 있다는 구체적 근거입니다.
R.2 Neuron Feature Transcoders: transcoders that cluster neurons by construction
NFT는 각 특징에 부모 뉴런을 지정하고 부모가 TopK에 들 때만 발화하도록 합니다. 뉴런별 G=16개 특징을 두고 그중 r=4개를 최종 TopK 후보로 올립니다. 뉴런의 TopK는 최종 특징 sparsity와 다른 하이퍼파라미터이며 실험에서는 두 배입니다. 선택된 특징에는 유효 뉴런 방향의 입력 투영을 학습 가능한 scale로 더하여 유효 encoder를 만듭니다.
$i$는 특징 $j$의 부모 뉴런이고 $s_j$는 학습 scale입니다. NFT는 기준선보다 FVU가 0.026 높지만 비교 가능한 희소 MLP보다 낮으며, NI보다 약간 낮은 KL을 보입니다. decoder cosine 0.6 기준 사전 44%, 활성화 63%가 정렬되고 유효 encoder는 거의 모두 강하게 정렬됩니다. 가중치 정렬을 강제하는 것이 재구성을 완전히 무너뜨리지는 않는다는 실험입니다.
R.3 Aligning features to sparse neuron combinations (SNRL)
SNRL은 NI에서 시작하여 특징의 입력·출력 방향을 같은 소수 뉴런 집합의 조합에 맞춥니다. 먼저 특징 $j$와 뉴런 $i$의 encoder·decoder cosine $s_{ji}^{\mathrm{enc}}$, $s_{ji}^{\mathrm{dec}}$를 계산하고, 절댓값 합이 큰 뉴런 네 개로 $\mathcal S_j$를 만듭니다. 양쪽 재구성에 같은 집합을 사용합니다. 원문 식 (2)–(4)는 다음과 같습니다.
$N_i^{\mathrm{enc}}$와 $N_i^{\mathrm{dec}}$는 부호를 고려한 뉴런의 입력·출력 방향입니다. 뉴런 집합 선택에는 cosine 절댓값을 쓰지만, 재구성 가중치에는 부호가 있는 cosine을 씁니다. 손실 앞의 음수는 학습이 cosine을 크게 만들도록 합니다. 이 재구성은 효율을 위해 사용한 유사도 가중합이며, 의사역행렬로 구한 L2 최적 근사는 아닙니다.
양쪽 0.6 기준 정렬 특징은 67%로 늘지만, FVU는 기준보다 0.018 높고 KL도 높아집니다. Jacobian 정합성은 조금 좋아집니다. 따라서 정렬·재구성·예측 보존이 같은 방향으로 움직이지 않는 개입입니다.
R.4 Testing the clustering hypothesis: basic metrics
원문은 Absorption → Coverage → Exclusivity → Cluster assignment → Procedure → Results 순서로 평가 조건을 둡니다. Absorption은 특징이 켜질 때 부모 뉴런도 활성인지, coverage는 자식 특징들이 부모의 활성화를 얼마나 덮는지, exclusivity는 한 번에 자식 하나만 켜지는지입니다. r>1인 NFT는 마지막 조건을 자동 보장하지 않습니다. 여기서 absorption은 다른 문헌의 동명 현상과 정의가 다릅니다.
NFT 외 사전에서는 가장 가까운 encoder의 뉴런에 특징을 배정합니다. 1,000만 SmolLM2토큰에서 10회 이상 켜진 특징을 평가하고, 뉴런은 Top128이면 활성로 봅니다. $p_1$은 가장 가까운 뉴런이 활성일 조건부 확률, $p_{2:4}$는 그다음 3개 중 하나라도 활성일 확률입니다.
| 방법, k=32 | p₁ | p₂:₄ |
|---|---|---|
| 기본 TopK | 0.64 | 0.77 |
| NI | 0.66 | 0.70 |
| NFT, G=16·r=4 | 1.00 | 0.66 |
| SNRL | 0.71 | 0.57 |
| Gemmascope L0-small | 0.63 | 0.75 |
원문 Table 13에서 전사했습니다.
우연 기준 약 0.01보다 기본 사전도 이미 높으며, 개입이 전반적으로 absorption을 크게 개선하지는 않습니다. NFT의 p₁=1은 구조적 제약의 결과입니다. SNRL은 오히려 가까운 2–4번째 뉴런의 동시 활성 비율을 낮춥니다. 정렬 손실이 의미 있는 다중 뉴런 군집을 자동 보장하지 않는다는 결과입니다.
R.5 Cluster discriminability evaluations
CM은 군집의 자체 문맥으로 두 군집을 구별하는 정확도이고, TNM은 가까운 4개 다른 뉴런의 문맥으로 그 군집을 구별하는 정확도입니다. 같은 50개 무작위 뉴런에 대한 cosine K-means K=16을 기준선으로 추가합니다. Table 15는 Claude Sonnet 4.6 판정, 뉴런당 60회, 유효 군집이 부족한 뉴런 제외를 명시합니다.
| 군집 방법 | CM 정확도 | TNM 정확도 |
|---|---|---|
| 기본 TopK k=32 | 0.937±0.005 | 0.731±0.030 |
| NI k=32 | 0.918±0.008 | 0.629±0.031 |
| NFT k=32 | 0.918±0.010 | 0.598±0.033 |
| SNRL k=32 | 0.927±0.008 | 0.657±0.030 |
| Gemmascope L0-small | 0.870±0.016 | 0.694±0.035 |
| Gemmascope L0-big | 0.793±0.019 | 0.645±0.040 |
| K-means K=16 | 0.933±0.006 | 0.764±0.027 |
원문 Table 15의 ±는 CM의 경우 패널 간 표준오차, TNM은 패널–군집쌍의 이항 표준오차입니다.
여러 방법이 군집 자체를 잘 구별하지만, 소수 뉴런으로 군집을 설명하는 TNM에서는 K-means와 기본 TopK가 높습니다. 저자들은 이를 예상 밖 결과로 남깁니다. 뉴런 조합을 강제한 개입이 그 설명 가능성 평가에서 자동으로 이기지는 않습니다.
성능 trade-off도 함께 보아야 합니다. Table 14의 Gemma 3 4B L22에서 기본 k=32의 FVU/KL/Jacobian은 0.195/1.29/0.225, NI는 0.209/1.16/0.238, NFT는 0.221/1.15/0.230, SNRL은 0.213/1.38/0.232입니다. FVU와 KL은 held-out SmolLM2 100만 토큰 기준입니다. Gemmascope와 저자 사전의 FVU는 목표 출력 위치가 달라 절대값을 그대로 순위화하면 안 됩니다. 이 부록의 기여는 비NF의 유용한 소수 뉴런 조합과 그 평가의 어려움을 함께 드러낸 데 있으며, 다음 부록은 공개 산출물의 범위를 기록합니다. 부록 R, 식 (2)–(4), Tables 13–15
📖 Chapter S: Scientific artifacts
S.1 Released artifacts는 본 논문에서 학습한 TopK transcoder를 MIT로 공개한다고 명시합니다. S.2 Models는 Gemma의 이용 약관, Llama 커뮤니티 라이선스, Qwen 3의 Apache 2.0을 구분합니다. S.3 Transcoders는 Gemmascope 2의 CC-BY-4.0, LXTC의 Apache 2.0, mwhanna의 MIT, mntss CLT의 저자 사용 허락을 구분합니다.
S.4 Datasets는 FineWeb, SmolLM2, LMSYS-Chat-1M, Pile-10k, 개별 프로빙 자료와 공개 영역의 『Pride and Prejudice』를 기록합니다. 프로빙 코드의 MIT가 모든 데이터의 라이선스라는 뜻은 아닙니다. S.5 Software는 Python 3.13, CUDA 12.8, NCCL 2.27.5, PyTorch 2.10 및 Table 16의 도구 목록을 제시합니다.
공개한 TopK 산출물에 대한 진술과, 모든 학습 코드·평가 자료·weight editing 세부사항이 동일하게 공개되었다는 진술은 구분해야 합니다. 고정 v1 본문에서 확인되는 공개 범위를 여기까지로 한정합니다. 이 부록은 사용 조건과 재현 자원의 근거를 제공하고, 다음 부록은 실제 계산 비용을 밝힙니다. 부록 S
📖 Chapter T: Compute
모든 실험은 NVIDIA H200 141GB의 사설 클러스터에서 수행했습니다. 저자들은 항목별 추정이 과대 추정일 수 있고, 비최적 실행이나 일부 부수 실험을 포함할 수 있다고 설명합니다.
T.1 Transcoder training. 단일 층 TopK 학습의 많은 설정은 H200 한 대에서 약 3시간입니다. Gemma 3 4B L22 sweep은 약 300 H200-hour, 전체 층의 다섯 transcoder는 약 140 H200-hour, JumpReLU sweep은 225–350 H200-hour입니다. 이는 학습당 비용과 여러 실행의 합계라는 서로 다른 단위입니다.
T.2 Evaluation. 희소 프로빙 cache 약 75, bigram 약 30, sort eval cache 약 40, 회로 attribution 약 65 H200-hour이며, 줄바꿈 활성화 수집은 2 미만, Jacobian은 10 미만, distress 사례는 약 9입니다. 프로브 적합은 별도로 수천 CPU-hour입니다. 일반 sort eval의 자동 판정은 5만–8만 호출, 군집 판정은 약 2.3만 호출입니다. GPU 비용만으로 전체 평가 비용을 대신할 수 없습니다.
T.3 Hyperparameter search. 학습률은 수동으로 탐색한 뒤 공통 사용하고 폭·희소도·seed를 바꿉니다. 프로빙 내부에는 L1 강도 탐색이 있습니다. T.4 Total은 보고 수치를 만든 실험의 총량을 약 1,000–1,200 H200-hour로 추정하며, 결과를 만들지 않은 탐색 실행은 제외합니다. 이는 단일 transcoder의 필요 비용도, 재현을 위한 최소 비용도 아닙니다. 이 부록은 평가를 포함한 연구 자원 규모를 구체화하며 마지막 부록은 작성·코드 지원 내역을 밝힙니다. 부록 T
📖 Chapter U: AI assistance
저자들은 Claude Code를 글쓰기 지원, 코드 작성, 코드 리뷰에 사용했다고 밝힙니다. 최종 글을 다시 쓰고 오류를 점검했으며, 구현 일부를 직접 검사하고 하이퍼파라미터를 확인하고, 이전 실험과 맞지 않는 결과는 선택적으로 조사·재실행했다고 설명합니다. 이는 저자의 연구 수행 내역에 대한 공개이지, 본 리뷰가 연구 코드를 실행해 실험을 재현했다는 뜻은 아닙니다. 이 부록으로 원문의 구조가 마무리됩니다. 부록 U
실험 결과 심층 분석
첫째, 뉴런 기준선의 장점은 보정 학습 조건을 포함해야 합니다. Figure 3의 pruning-only 결과를 생략하면 KL 우위가 어떤 변화에서 생겼는지 놓칩니다. 공동 FVU+KL 학습 뒤 낮아진 KL과 여전히 높은 FVU의 조합은, MLP 출력의 모든 차이가 예측에 같은 중요도를 갖지 않음을 보여줍니다. 다만 이것만으로 재구성 오차의 각 성분이 모두 행동과 무관하다고 증명한 것은 아닙니다.
둘째, 프로빙 성능과 의미의 선명함을 분리해야 합니다. Table 6의 뉴런 AUC 우위는 개념을 읽어내는 데 유리한 표현이 있다는 뜻입니다. 반면 Table 7의 75.6% 대 0.0% Match는 최대 문맥이 목표 bigram에 얼마나 직접 대응하는지의 차이입니다. 서로 다른 질문에 대한 결과이므로 하나로 다른 하나를 취소할 수 없습니다. Table 5·6의 수치 불일치 때문에 일반 프로빙의 정확한 요약 크기는 표별로 한정해 해석했습니다.
셋째, 안정성과 충실도는 중요한데 충분조건은 아닙니다. NF의 높은 Jacobian 정합성과 seed 재현은 원래 MLP와의 연결을 뒷받침합니다. 그러나 JumpReLU에는 안정적인 비NF가 많고, 색깔·교사–학생 사례는 단일 가중치 대응 없이도 구조가 나타날 수 있음을 보여줍니다. 특히 Jacobian은 국소 1차 기준이며 모든 행동 개입의 대리 지표로 자동 승격할 수 없습니다.
넷째, 통계적 오차의 종류를 구분해야 합니다. 회로 비율은 bootstrap 표준오차, NI sweep은 seed 간 표준오차, 군집 평가는 패널 또는 패널–군집쌍 표준오차가 보고됩니다. Table 1의 seed 비교는 두 seed이며 H의 sweep은 세 seed입니다. 주요 비교 전반에 대한 별도의 가설검정이나 p값은 논문에 보고되지 않았습니다. 표준오차를 95% 신뢰구간으로 부르거나 관찰 차이를 모두 통계적으로 유의하다고 표현할 근거는 없습니다.
재현성 측면에서는 모델·층·폭·k·초기화·학습률·데이터·주요 평가 표본이 상세히 제공되고, TopK 산출물 공개도 명시되어 있습니다. 동시에 결과가 파이프라인과 임계값에 민감하다는 점, 주된 분석과 MoE·CLT 예비 조사의 깊이가 다르다는 점을 함께 보아야 합니다. 본 리뷰의 검토는 고정 원문·그림·표의 대조이며 연구 실험의 독립 재현은 아닙니다. §6, 부록 A–D·H·J·R–T
기술적 함의와 응용
저자들이 직접 제안하는 실무적 변화는 뉴런을 강한 비교 기준으로 복원하는 것입니다. 부호 분리와 적절한 TopK, 필요한 보정을 적용한 기준선 없이 넓은 사전의 해석 가능성을 평가하면, 원래 모델에 이미 있는 구조를 새로 발견한 성과와 혼동할 수 있습니다. 반대로 bigram이나 색깔처럼 더 세밀한 단위를 찾는 목적에서는 transcoder가 주는 분해 능력을 별도로 평가해야 합니다.
리뷰어의 해석으로는, 회로 분석에서 이 논문은 의미를 붙이기 쉬운 단위와 실제 계산에 대응하는 단위를 교차 확인하는 절차의 중요성을 보여줍니다. 가중치 정렬, 최대 활성화 문맥, 공동 발화, 국소 미분, 제거 효과가 같은 방향을 가리키는 경우와 그렇지 않은 경우를 구분하면 설명의 범위를 더 정확하게 말할 수 있습니다. 이는 모델 설명이나 행동 관련 특징 탐색에 적용할 수 있는 읽기 원칙이며, 본 논문이 모든 응용에서 성능 향상을 검증했다는 뜻은 아닙니다.
저자가 명시한 향후 관심은 층간 superposition과 MoE 전문가 내부의 구조, 안정적 비NF와 decoder 방향의 기원, 소수 뉴런 조합의 더 정확한 규명입니다. 본문의 핵심은 뉴런과 사전을 대체재 하나로 결정하는 데 있지 않습니다. 어떤 특징이 원래 기저를 재발견하고, 어떤 특징이 의미를 더 세밀하게 나누며, 그 중 무엇이 원래 계산을 충실하게 설명하는지를 서로 다른 근거로 구분하는 데 있습니다.
검토 범위는 v1의 본문 1–6, 위험·연구 지원·참고문헌 설명과 부록 A–U 전체입니다. 모든 그림의 개별 점·모든 대시보드 토큰·소프트웨어 라이선스 표의 각 행을 재전사하지는 않았으며, 핵심 도표와 주요 수치를 중심으로 해설했습니다. 원문 내부에서 해소되지 않은 Table 5/6의 AUC, 부록 F의 표본 수, Figure 26의 투영 대상, 산술 high 집단의 본문/범례 차이는 해당 위치에 명시했습니다.