논문 개요와 전체 구조
코딩 에이전트가 저장소를 수정했더라도, 최종 출력이 패치가 아닌 설명문이라면 실제 문제 해결로 인정받지 못할 수 있습니다. 이처럼 에이전트의 성능은 언어 모델의 능력뿐 아니라 관찰할 문맥, 도구 실행, 피드백, 종료를 관리하는 하니스(harness)에도 좌우됩니다. Self-Evolving Coding Agents via Harness-Policy Optimization은 현재 정책 모델이 자신의 실패를 분석하여 하니스를 수정하고, 선택된 하니스 아래에서 강화학습한 다음, 남아 있는 실패를 다음 탐색 대상으로 삼는 Self-HPO를 제안합니다. 이 리뷰는 arXiv:2610.22791v1 원문의 본문과 부록을 분석합니다.
이 연구의 학습 가치는 프롬프트와 모델 가중치의 개선을 하나의 반복 과정에서 살펴볼 수 있다는 데 있습니다. Qwen3.5-35B-A3B와 mini-SWE-agent를 출발점으로, Self-HPO는 세 코딩 벤치마크의 평균 해결률을 57.8%에서 64.8%로 높입니다. 외부 Opus 4.8을 하니스 제안자로 사용하는 별도 구성 HPO는 평균 66.3%입니다. Self-HPO의 자기 제안 실험과 외부 모델을 사용하는 HPO의 결과를 구분해서 읽어야 합니다. 근거: 초록·§1·Table 1
원문은 다음 순서로 전개됩니다. 소제목이 번호 없는 문단 제목인 경우에도 해당 순서를 유지하였습니다.
- 1 Introduction
- 2 Self-HPO: Self-Evolving via Harness-Policy Optimization — 2.1 Problem Setup → 2.2 H-step: Failure-Conditioned Harness Search(Self-proposer for harness optimization → Evolving search set) → 2.3 P-step: Policy Optimization under the Optimized Harness
- 3 Experiments — 3.1 Experimental Setup(Harness, model, and data → Benchmarks and evaluation metrics → Baselines) → 3.2 Main Results(단일 구성요소 최적화 대비 결과 → OOD 일반화 → Opus 지식 전달 방식 → 교대 최적화 경로) → 3.3 Ablations(RL/SFT/RFT → 탐색 집합 갱신 → 자기 제안) → 3.4 Analysis(구성요소 교차 평가 → pass@k·난이도 → 학습 중 zero-success 그룹) → 3.5 Case Studies(기존 에이전트 루프 주변의 제어 추가)
- 4 Related Work — Harness optimization for LLM agents → Policy learning and self-improvement → Joint harness–policy evolution
- 5 Conclusion, 이어 References
- Appendix A Implementation Details — Agent implementation → Optimization data → Harness optimization → Policy optimization
- Appendix B Additional Evaluation Details — Evaluation configurations → SFT configuration → Search-frontier curves → Pass@k calculation → Comparison with frontier models
- Appendix C Conceptual Comparison with Related Methods — 비교표 → The trained solver becomes the next harness proposer → Policy training also determines the next harness-search tasks
- Appendix D Harness Details and Prompt Templates — Seed harness → Harness search space → Harness proposer → Optimized harness(코드 차이와 세 메시지)
- Appendix E Case Study: Where the Harness Intervenes — 같은 최종 정책을 초기 하니스와 진화한 하니스에 연결한 실패·성공 실행 비교
핵심 기여와 혁신성
저자가 제기하는 문제는 정책이 변하면 적합한 하니스와 유용한 실패 사례도 달라진다는 것입니다. 하니스만 개선하면 모델 가중치는 바뀌지 않습니다. 고정된 하니스 아래에서 정책만 학습하면 그 하니스가 만들어 내는 실행 궤적에 학습 기회가 제한됩니다. 여기서 정책(policy)은 관찰된 문맥을 받아 다음 행동을 생성하는 모델이며, 실행 궤적(trajectory)은 문제를 풀며 생성한 추론·명령·관찰의 연속입니다. 두 구성요소를 번갈아 수정하는 접근은 이 상호 의존성을 직접 다룹니다. 근거: §1–2
Self-HPO의 독창성은 교대 최적화 자체뿐 아니라 다음 라운드에 전달되는 두 입력에 있습니다. P-step에서 학습된 해결 정책이 다음 H-step의 하니스 제안자가 되고, P-step에서 한 번도 해결되지 않은 과제들이 다음 하니스 탐색 집합이 됩니다. 따라서 제안자의 능력과 진단 대상이 함께 바뀝니다. 한 H-step 안에서는 정책과 탐색 집합을 고정하므로 후보들을 같은 조건으로 비교합니다. 저자는 이 구조를 고정된 외부 제안자, 고정된 해결 정책 또는 고정된 탐색 과제를 사용하는 관련 방법들과 구분합니다. 근거: §2.2·§4·Appendix C
실험적 기여는 한쪽만 최적화하는 비교군, 하니스와 정책을 서로 바꾸어 연결하는 교차 평가, 여러 번 시도했을 때의 해결 범위를 함께 제시한 점입니다. 리뷰어의 해석으로는, 이 설계는 성능 증가를 단순한 “프롬프트가 좋아졌다” 또는 “모델이 학습했다”로만 설명하기 어렵게 합니다. 다만 교차 평가의 추가 이득은 보고된 평균값에 관한 관찰이며, 통계적 상호작용 검정이나 모든 환경에 대한 보장은 아닙니다.
기술적 세부사항
하니스 $H$와 정책 $P$는 과제 $x$에 대한 공동 실행 분포 $\pi_{H,P}(\cdot\mid x)$를 만듭니다. 검증기(verifier)는 생성된 패치가 벤치마크의 실행 조건을 통과하면 1, 그렇지 않으면 0을 부여합니다. 원문 식 (1)은 훈련 데이터 $\mathcal D$에서 이 성공 확률의 기댓값을 최대화할 대상으로 정의합니다. 근거: §2.1, 식 (1), PDF 3쪽
$\tau$는 한 번의 실행 궤적이고, $y(x,\tau)\in\{0,1\}$은 최종 결과의 이진 보상입니다. 바깥 기댓값은 어떤 훈련 과제를 고르는지, 안쪽 기댓값은 같은 과제에서도 샘플링에 따라 어떤 실행이 나오는지를 평균합니다. 따라서 하니스는 가중치를 바꾸지 않고도 실행 분포를 바꿀 수 있으며, 정책 학습 역시 그 분포를 바꿉니다. 이 식은 성공률 목적을 정의하며, 탐색 집합의 실측 점수나 테스트 벤치마크 전체를 그대로 뜻하지는 않습니다.
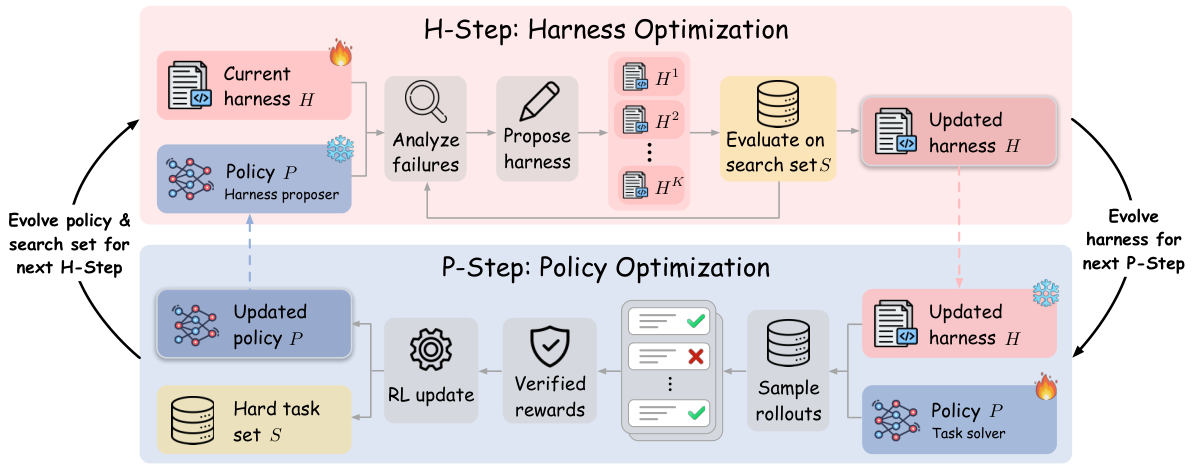
원문 Figure 2, “Overview of Self-HPO”, PDF 3쪽. 동일 v1 PDF에서 그림 전체 영역만 크롭하였으며 내부 문구·배치·색은 번역하거나 수정하지 않았습니다. 고정 버전 출처. 위쪽은 H-step, 아래쪽은 P-step이며 왼쪽 되먹임이 정책과 탐색 과제의 동시 갱신을 나타냅니다.
실험은 2,484개의 훈련 과제를 사용하고 H-step마다 후보 6개를 평가하며, P-step마다 RL 업데이트 50회를 수행하는 두 라운드입니다. 각 후보는 탐색 과제마다 한 번 실행됩니다. 결과적으로 정책 학습은 총 100회 업데이트에 해당하지만, 하니스 후보 평가와 학습 롤아웃의 전체 실행량까지 100회라는 뜻은 아닙니다. 주 결과의 avg@3는 세 번의 전체 평가에서 얻은 해결률 평균입니다. 한 과제에서 세 번 중 한 번이라도 성공하는 pass@3와 다릅니다. GRPO 학습 목적과 pass@k 계산식은 각각 부록 A·B의 상세 리뷰에서 설명합니다. 근거: §3.1·Appendix A–B
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 에이전트를 모델과 하니스의 결합으로 정의하고, 왜 두 구성요소를 함께 개선해야 하는지 설명합니다. 먼저 소프트웨어 공학, 웹 탐색, 컴퓨터 사용처럼 여러 행동을 이어 가는 과제를 배경으로 제시합니다. 하니스는 모델이 무엇을 보고, 행동이 어떻게 실행되며, 어떤 피드백을 받고, 언제 종료하는지를 결정합니다. 동일한 모델도 이 조건에 따라 성공하거나 실패할 수 있다는 점이 출발점입니다. 근거: §1
이어서 기존 개선 경로를 하니스 최적화와 정책 최적화로 나눕니다. 전자는 모델을 고정하고 프롬프트·워크플로·에이전트 코드를 탐색합니다. 후자는 하니스를 고정하고 성공 궤적이나 검증 가능한 보상으로 가중치를 업데이트합니다. 저자의 문제 제기는 어느 한 경로가 무의미하다는 것이 아니라, 정책의 실패 양상이 변할 때 고정된 상대 구성요소가 적합하지 않을 수 있다는 것입니다.
그다음 Self-HPO의 순환을 소개합니다. H-step은 현재 정책이 자신의 실패를 분석하고 그 실패를 겨냥한 하니스를 제안하는 단계입니다. P-step은 선택된 하니스 아래에서 강화학습을 수행하는 단계입니다. 업데이트된 정책과 그 과정에서 남은 어려운 과제가 다음 H-step으로 전달됩니다. 저자는 하니스가 현재 약점을 보완하고, 정책 학습은 유도된 행동을 모델에 내재화한다는 해석을 제시합니다. 이 설명은 이후 실험이 검토할 설계 의도이지, 모든 행동이 가중치에 내재화되었음을 개별적으로 측정한 결과는 아닙니다.
마지막으로 세 기여를 정리합니다. 자기 제안과 실패 집합 갱신을 결합한 프레임워크, 세 벤치마크에서의 단일 구성요소 비교군 대비 개선, 구성요소의 독립적 이득과 결합 이득 및 pass@k 분석입니다. Figure 1은 이 순환과 평균 해결률의 변화를 함께 보여 줍니다. 이 장의 핵심은 “다음에 무엇을 고칠 것인가”도 정책 학습 결과에 따라 바뀐다는 관점이며, 다음 장은 이를 목적함수와 알고리즘으로 구체화합니다.
📖 Chapter 2: Self-HPO: Self-Evolving via Harness-Policy Optimization
이 장은 앞서 제시한 상호 의존성을 실제 최적화 절차로 바꿉니다. 전체 HPO 틀과, 그 안에서 제안자를 자기 정책으로 사용하는 Self-HPO 구성을 먼저 구분해야 합니다. 근거: §2·Algorithm 1
2.1 Problem Setup
문제 설정은 앞 절의 식 (1)처럼 하니스–정책 쌍의 기대 해결률을 정의하는 데서 시작합니다. 외부 도구와 환경을 관리하는 $H$가 실행 궤적을 바꾸고, $P$의 업데이트는 다음 하니스가 겨냥해야 할 실패를 바꿉니다. 저자는 같은 교대 구조를 두 구성으로 구현합니다. Self-HPO는 진화하는 정책 자체가 후보를 제안하고, 비교용 HPO는 고정된 외부 Opus 4.8이 후보를 제안합니다. 외부 모델의 도움 없이도 가능하다는 주장은 전자에 해당합니다.
Algorithm 1의 순서는 다음과 같습니다. 초기 하니스 $H_0$, 정책 $P_0$, 훈련 데이터 $\mathcal D$, 후보 예산 $K$를 준비하고, 무작위 탐색 집합 $\mathcal S_0$을 고릅니다. 라운드 $t$에서 현재 쌍을 탐색 집합에 평가하여 점수와 궤적을 얻고, 이를 경험 기록의 시작으로 삼습니다. 이후 후보 $K$개를 순차적으로 제안·평가하며 현재 최고 점수보다 엄격히 높은 점수를 얻은 후보만 최선 하니스로 교체합니다. 따라서 개선 후보가 없으면 기존 하니스가 유지됩니다.
다음으로 선택된 $H_{t+1}$을 고정하고 $P_t$를 RL로 $P_{t+1}$에 업데이트합니다. 학습 과정의 궤적에서 어려운 과제 ID를 추출하여 $\mathcal S_{t+1}$을 만들고 라운드를 진행합니다. 원문은 라운드 사이 어려운 과제 집합이 안정화되면 멈춘다고 기술하며, 실험은 이 기준에 따라 두 라운드를 수행했다고 설명합니다. 안정화의 구체적인 수치 임계값은 제시하지 않습니다.
2.2 H-step: Failure-Conditioned Harness Search
Self-proposer for harness optimization. H-step 안에서 $P_t$는 문제 해결자이자 하니스 제안자이지만 가중치는 고정됩니다. 먼저 현재 하니스로 탐색 과제를 실행하고, 제안자가 실패 궤적을 읽어 프롬프트 또는 실행 시점의 Python 로직을 수정합니다. 후보는 매번 현재 최선 하니스를 출발점으로 삼으며, 지금까지 평가한 모든 후보와 궤적을 경험으로 참조합니다. 따라서 후보들이 서로 독립적인 무작위 프롬프트 변형이라는 설명은 부정확합니다.
Evolving search set. 한 H-step 동안에는 모든 후보가 같은 과제 집합에서 비교됩니다. 라운드 사이에는 집합이 달라집니다. 최초 $\mathcal S_0$은 훈련 데이터에서 균등하게 샘플링하지만, 다음 집합은 직전 P-step의 해당 과제에 대해 수집된 모든 롤아웃에서 한 번도 해결되지 않은 과제입니다. 한 번 실패한 과제, 최종 체크포인트에서만 실패한 과제, 높은 분산을 보인 과제라는 정의와 다릅니다. 근거: §2.2·Appendix A
재사용하는 것은 과제 ID입니다. 다음 H-step에서는 업데이트된 정책과 현재 하니스로 다시 실행하여 새로운 실패 근거를 만듭니다. 이렇게 해야 이전 정책의 오래된 실패 궤적만 계속 읽는 대신 현재 정책의 실패에 맞춰 수정할 수 있습니다. 리뷰어의 해석으로는, 이는 모델 업데이트가 후보 생성 능력과 평가용 진단 과제를 동시에 바꾸는 구조입니다.
2.3 P-step: Policy Optimization under the Optimized Harness
P-step은 선택한 $H_{t+1}$ 아래에서 현재 정책이 생성하는 on-policy 궤적, 즉 학습 중인 정책 자신이 수집한 실행을 사용합니다. 실행 검증기는 최종 성공 여부에 따른 이진 보상을 제공합니다. 기본 학습기는 GRPO(Group Relative Policy Optimization)와 Orchard의 BAR(Balanced Adaptive Rollout)를 결합합니다. GRPO는 같은 과제의 여러 실행 사이 보상 차이를 이용하여 상대적 이점(advantage)을 만들고, 더 유리한 행동의 생성 확률을 높이는 정책 최적화입니다. 근거: §2.3
모든 실행이 실패하여 보상이 같으면 그룹 내부의 대비가 사라집니다. BAR는 추가 궤적을 적응적으로 수집하여 성공과 실패가 섞인 그룹을 구성함으로써 이진 보상의 희소성을 줄입니다. 부록 A에는 과제당 8개에서 4개를 고르고 성공 비율을 0.25–0.75로 맞추는 구체적 구성이 나옵니다. 이는 Figure 4(c)의 “성공한 롤아웃이 하나도 없는 그룹 비율”이 성공·실패를 섞어 선별한 최종 학습 배치의 실패 비율을 뜻하는 것은 아니라는 점을 이해하는 데 중요합니다. 저자는 해당 곡선의 세부 집계 절차까지 설명하지는 않습니다.
이 단계는 정책뿐 아니라 다음 탐색 집합도 출력합니다. 이 장의 핵심 기여는 하니스 탐색과 가중치 학습의 입력·출력 관계를 명확히 연결한 것이며, 다음 장은 이 순환이 실제 해결률과 실행 행동을 어떻게 바꾸는지 평가합니다.
📖 Chapter 3: Experiments
이 장은 실험 설정, 주요 결과, 절제실험, 구성요소 분석, 사례 순서로 진행합니다. 처음부터 외부 모델 사용 여부를 나누어 비교하므로, 같은 표 안에 있다는 이유로 모든 방법이 같은 종류의 감독 정보를 사용한다고 읽으면 안 됩니다. 근거: §3
3.1 Experimental Setup
Harness, model, and data. 모든 실험의 기본 정책은 Qwen3.5-35B-A3B, 초기 하니스는 mini-SWE-agent입니다. 훈련 데이터는 SWE-rebench, SWE-rebench V2, Scale-SWE에서 구성한 2,484개 과제이며 하니스 탐색과 정책 학습에 함께 사용합니다. 두 라운드 각각 후보 6개와 RL 업데이트 50회를 사용합니다. 초기 탐색 집합은 300개이며, 다음 라운드는 직전 학습에서 한 번도 성공하지 못한 과제 집합을 사용합니다.
Benchmarks and evaluation metrics. 주 평가인 SWE-Bench Verified는 사람이 검토한 GitHub 이슈 500개입니다. 분포 외(OOD, out-of-distribution) 평가인 SWE-Bench Multilingual은 300개, SWE-Bench Pro public V2는 642개입니다. 해결률(resolve rate)은 생성 패치가 해당 벤치마크 검증기를 통과한 과제의 비율입니다. 주 결과는 세 차례 평가의 평균과 표준편차입니다. 서로 크기가 다른 세 벤치마크의 Avg.는 표에 보고된 벤치마크별 평균값의 산술평균이며, 전체 1,442개 과제를 한데 합친 성공률로 해석하지 않습니다.
Baselines. 자기 개선 구성에서 RLVR은 초기 하니스 아래에서 정책만 학습하고, Self-Harness는 초기 정책을 제안자로 사용하여 하니스만 수정합니다. Self-HPO는 현재 정책으로 하니스를 제안하면서 둘을 교대 최적화합니다. 외부 모델 구성의 SFT(supervised fine-tuning, 지도 미세조정)는 같은 훈련 과제를 Opus 4.8이 해결한 궤적을 가중치에 학습시킵니다. Meta-Harness는 Opus가 하니스를 제안하되 대상 정책을 고정하고, HPO는 외부 제안과 RL을 결합합니다. 따라서 이 비교는 “어디에 외부 지식을 전달할 것인가”까지 포함합니다.
3.2 Main Results
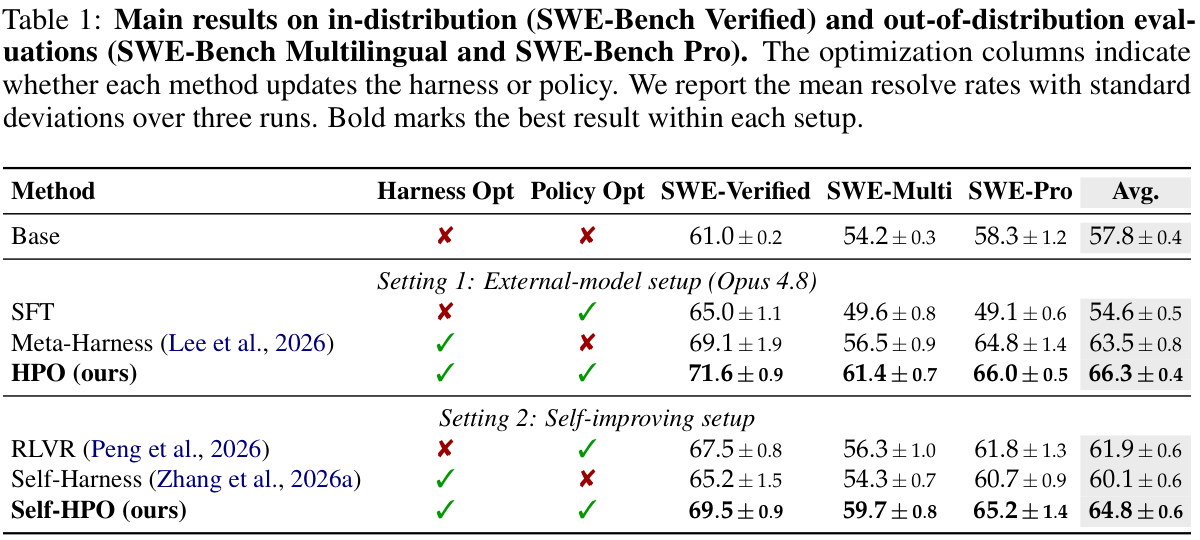
원문 Table 1, “Main results on in-distribution … and out-of-distribution evaluations”, PDF 5쪽. 표와 원문 캡션을 포함하여 크롭하였고 수치·굵은 표시는 원문 그대로입니다. 고정 버전 출처. 작은 숫자는 아래 전사표에서 읽을 수 있습니다. 표의 ±는 세 번 평가의 표준편차입니다.
| 구성 | 방법 | SWE-Verified (%) | SWE-Multi (%) | SWE-Pro (%) | Avg. (%) |
|---|---|---|---|---|---|
| 초기 | Base | 61.0 ± 0.2 | 54.2 ± 0.3 | 58.3 ± 1.2 | 57.8 ± 0.4 |
| 외부 Opus 4.8 | SFT | 65.0 ± 1.1 | 49.6 ± 0.8 | 49.1 ± 0.6 | 54.6 ± 0.5 |
| 외부 Opus 4.8 | Meta-Harness | 69.1 ± 1.9 | 56.5 ± 0.9 | 64.8 ± 1.4 | 63.5 ± 0.8 |
| 외부 Opus 4.8 | HPO | 71.6 ± 0.9 | 61.4 ± 0.7 | 66.0 ± 0.5 | 66.3 ± 0.4 |
| 자기 개선 | RLVR | 67.5 ± 0.8 | 56.3 ± 1.0 | 61.8 ± 1.3 | 61.9 ± 0.6 |
| 자기 개선 | Self-Harness | 65.2 ± 1.5 | 54.3 ± 0.7 | 60.7 ± 0.9 | 60.1 ± 0.6 |
| 자기 개선 | Self-HPO | 69.5 ± 0.9 | 59.7 ± 0.8 | 65.2 ± 1.4 | 64.8 ± 0.6 |
Self-HPO consistently outperforms policy-only and harness-only optimization. 자기 개선 구성에서 SWE-Verified의 69.5%는 RLVR보다 2.0포인트, Self-Harness보다 4.3포인트 높습니다. 평균 64.8%도 RLVR의 61.9%를 2.9포인트 상회합니다. 외부 모델 구성에서도 HPO는 Meta-Harness를 SWE-Verified에서 2.5포인트, 평균에서 2.8포인트 앞서며, 각 구성의 세 벤치마크 모두에서 둘을 업데이트하는 방법이 가장 높습니다. 이는 보고된 평균의 순위이며 유의성 검정 결과가 아닙니다.
The gains generalize to out-of-distribution benchmarks. 훈련에 사용한 과제는 Python 프로젝트뿐이지만, SWE-Multi는 Python 이외의 9개 언어를, SWE-Pro는 더 넓은 언어와 공학적 과제를 포함합니다. Self-HPO의 59.7%와 65.2%는 Base보다 각각 5.5·6.9포인트, RLVR보다 둘 다 3.4포인트 높습니다. 특히 SWE-Multi에서 Self-Harness의 개선은 0.1포인트지만 Self-HPO는 5.5포인트입니다. 여기서 확인한 일반화 범위는 이 두 OOD 벤치마크이며, 임의의 개발 업무나 다른 영역 전체를 보장하는 결과는 아닙니다.
Learning from Opus 4.8 through harness optimization is more effective than SFT distillation. SFT는 해결 궤적을 가중치로 증류하고, Meta-Harness는 외부 제안을 실행의 틀에 반영합니다. Meta-Harness는 SFT를 SWE-Verified에서 4.1포인트, 평균에서 8.9포인트 앞섭니다. SFT는 Verified에서 61.0%를 65.0%로 개선하지만 Multi와 Pro에서는 Base보다 낮습니다. 저자는 이 조건의 지식 전달에서 하니스 최적화가 더 효과적이었다고 해석합니다. Opus 호출 토큰 수·금전 비용이나 각 방법의 총계산량을 맞춘 비용 대비 효과는 보고하지 않습니다. SFT의 학습 예산도 부록 B에 제시된 설정 범위에서 읽어야 합니다.
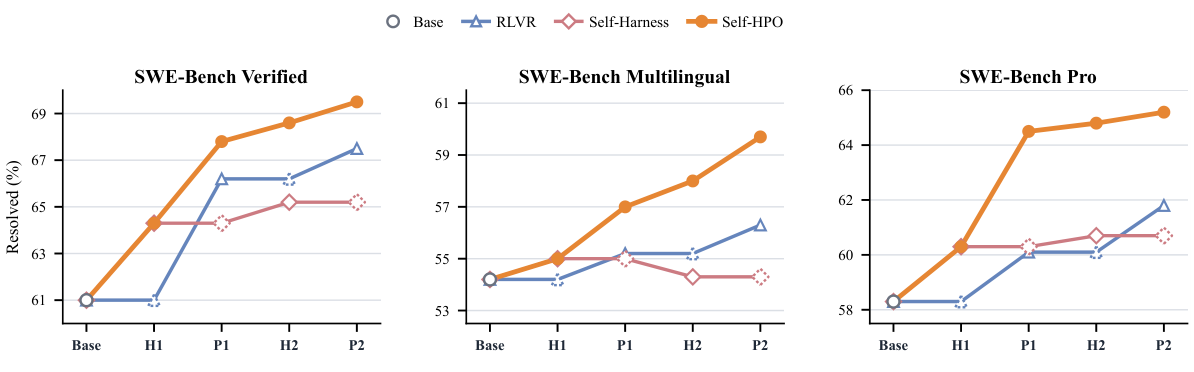
원문 Figure 3, “Optimization trajectories across harness and policy updates”, PDF 6쪽. 세 패널 전체와 공통 범례·축을 보존하여 크롭하였고 번역·재작성하지 않았습니다. 고정 버전 출처. 점선 테두리 마커는 해당 방법이 그 단계에서 업데이트하지 않았음을 표시합니다.
Alternating harness and policy optimization drives continued agent improvement. Figure 3에서 Self-HPO와 Self-Harness는 첫 H-step을 공유합니다. 이후 Self-HPO의 정책 업데이트가 둘의 경로를 갈라 놓습니다. 두 번째 H-step과 뒤이은 P-step은 세 벤치마크 모두에서 Self-HPO를 추가 개선합니다. 반면 Self-Harness는 Multi에서 55.0%에서 54.3%로 내려갑니다. 따라서 하니스 탐색을 더 많이 하는 것만으로 같은 경로를 얻는다고 볼 수 없습니다. Verified의 단계별 수치는 Base 61.0 → 첫 H-step 64.3 → 첫 P-step 67.8 → 둘째 H-step 68.6 → 둘째 P-step 69.5%이며, 부록 B의 후보 수준 곡선이 이를 보완합니다.
3.3 Ablations
이 절은 P-step 학습법, H-step 탐색 집합, 제안자를 순서대로 바꿉니다. 기준은 Self-HPO 69.5%가 아니라 외부 제안자를 사용하는 HPO 71.6%입니다. 따라서 아래 감소폭을 Self-HPO 자체에 대한 절제 결과로 옮기면 안 됩니다. 근거: §3.3·Table 2
| 구성 | SWE-Verified 해결률 (%) | HPO 대비 변화 (포인트) |
|---|---|---|
| HPO | 71.6 | 기준 |
| P-step을 SFT로 교체 | 67.2 | −4.4 |
| P-step을 RFT로 교체 | 70.5 | −1.1 |
| H-step에 고정 탐색 집합 사용 | 70.1 | −1.5 |
| H-step에 자기 정책 제안자 사용 | 69.5 | −2.1 |
RL yields stronger policy updates than SFT/RFT. SFT는 Opus의 해결 궤적을 사용하며, RFT(rejection-sampling fine-tuning)는 대상 정책 자신이 생성한 궤적 가운데 성공한 것만 골라 학습합니다. P-step의 RL을 이들로 교체하면 각각 67.2%와 70.5%가 됩니다. 자신의 성공 궤적을 사용하더라도 이 실험에서는 RL에 미치지 못하므로 저자는 RL을 기본 P-step으로 지지합니다. 이는 해당 데이터와 예산의 비교이며, 모든 SFT 또는 RFT 구성의 열등함을 입증한 결과는 아닙니다.
Evolving the search set helps harness optimization keep pace with the policy. 최초 탐색 집합을 계속 재사용하면 70.1%로 1.5포인트 낮아집니다. 학습 중 끝내 풀지 못한 과제로 갱신한 집합은 다음 정책의 남은 실패에 탐색을 집중시킵니다. 이 비교는 “과제를 매 후보마다 바꿔야 한다”는 뜻이 아닙니다. 같은 H-step 안에서는 고정하고 라운드 사이에 바꾸는 것이 원문 설계입니다.
Self-proposal retains strong performance without an external proposer. Opus를 현재 대상 정책으로 교체한 69.5%가 Self-HPO입니다. 외부 제안자보다 2.1포인트 낮지만 RLVR과 Self-Harness를 앞섭니다. 저자의 결론은 외부 모델이 도움이 되지만 이 방법에 필수적이지 않다는 것입니다. 다만 “자기 개선”이 검증기·훈련 과제·탐색 시 정답 수정본 같은 외부 자원까지 사용하지 않는다는 뜻은 아닙니다. 제안자가 열람하는 정보와 실행 시 주입 금지 조건은 부록 D에 명시됩니다.
3.4 Analysis
Both optimized components retain benefits even when paired with their base counterparts. Table 3은 Self-HPO의 하니스와 정책을 교차 연결하여 평가합니다. 행은 하니스, 열은 정책이며 단위는 해결률 %입니다. 아래 값은 원문의 평균 ± 표준편차를 전사하였습니다. 근거: §3.4·Table 3
| 하니스 / 정책 | P0 | P1 | P2 |
|---|---|---|---|
| H0 | 61.0 ± 0.2 | 61.7 ± 1.3 | 64.4 ± 1.1 |
| H1 | 64.3 ± 1.1 | 67.8 ± 1.6 | 68.1 ± 1.0 |
| H2 | 64.5 ± 1.5 | 68.6 ± 0.5 | 69.5 ± 0.9 |
최종 하니스만 초기 정책에 붙이면 64.5%로 3.5포인트, 최종 정책만 초기 하니스에 붙이면 64.4%로 3.4포인트 개선됩니다. 둘을 함께 쓰면 69.5%로 8.5포인트 증가합니다. 보고된 평균에 대한 산술로, 결합 이득은 개별 이득 합 6.9포인트보다 1.6포인트 큽니다. 이 결과는 학습된 각 구성요소가 원래 상대와도 일부 효과를 유지하며, 함께 사용할 때 가장 높다는 것을 보여 줍니다. 이 표의 $H_2$는 Self-HPO 과정에서 얻은 것으로, 초기 정책만으로 별도 최적화한 Self-Harness와 동일한 실험물이 아닙니다. 최종 정책 $P_2$ 역시 초기 하니스 아래에서 학습한 RLVR과 다릅니다.
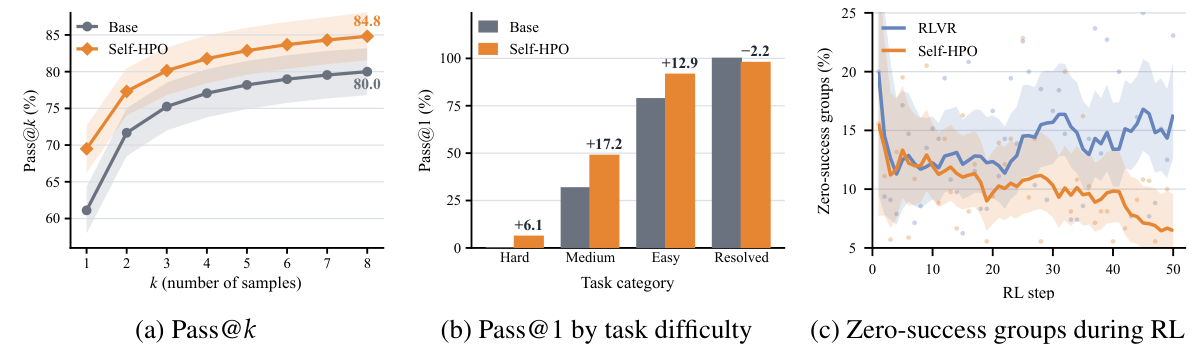
원문 Figure 4, “Pass@k performance on SWE-Bench Verified and RL training signal”, PDF 7쪽. 세 패널 전체를 크롭하였으며 축·범례·패널 표기를 보존했습니다. 고정 버전 출처. 아래에 패널별 상세 이미지와 수치 설명을 덧붙입니다.
Self-HPO improves reliability (pass@1) and expands the capability frontier (pass@k). 이 분석은 Verified의 과제마다 8번 시도한 별도 평가입니다. Figure 4(a)에서 Self-HPO는 $k=1,\ldots,8$ 모두 Base보다 높고, pass@8은 80.0%에서 84.8%로 4.8포인트 증가합니다. pass@1은 한 번 뽑았을 때 성공하는 신뢰성과 관련되고, pass@8은 8회 시도 안에 한 번이라도 성공할 수 있는 과제 범위와 관련됩니다. 부록 B는 해당 pass@k 곡선의 음영을 95% 부트스트랩 신뢰구간으로 설명합니다. 이는 Table 1의 세 번 평가 표준편차와 다른 불확실성 표시입니다.
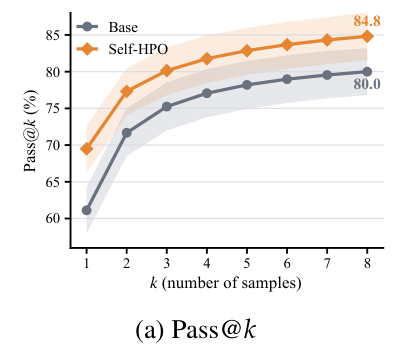
Figure 4(a) 상세 크롭, PDF 7쪽. 원문 범례·축·음영·끝점 값을 보존하였습니다. 출처. 추가 크롭이며 원본 전체는 바로 위 Figure 4에 있습니다.
Figure 4(b)는 Base의 8회 시도에서 추정한 성공률 $p$로 과제를 나눕니다. Hard는 관측된 성공이 없는 집합이며 수학적으로 절대 풀 수 없는 과제를 뜻하지 않습니다. Medium과 Easy에서의 상승은 이미 가끔 성공하던 과제의 신뢰성 증가를 보여 줍니다. Hard에서도 6.1포인트 상승하지만 Resolved에서는 2.2포인트 하락하여 개선이 과제 전체에서 균일하지 않습니다.
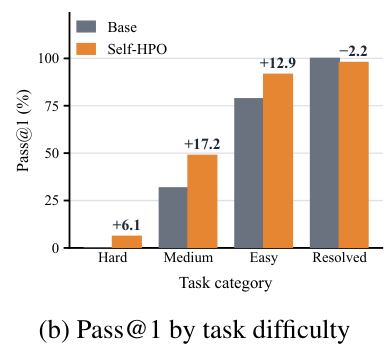
Figure 4(b) 상세 크롭, PDF 7쪽. 범례와 증감 표기를 원문 그대로 보존했습니다. 출처. 난이도 조건은 아래와 같습니다.
| Base 성공률 p에 따른 집합 | 원문 정의 | Self-HPO의 pass@1 변화 (포인트) |
|---|---|---|
| Hard | p = 0 | +6.1 |
| Medium | 0 < p ≤ 0.5 | +17.2 |
| Easy | 0.5 < p < 1 | +12.9 |
| Resolved | p = 1 | −2.2 |
Self-HPO reduces zero-success rollout groups during training. Figure 4(c)는 RLVR의 마지막 50회 업데이트와 Self-HPO의 마지막 P-step을 비교합니다. 성공 롤아웃이 하나도 없는 그룹의 비율은 Self-HPO의 마지막 10회 업데이트 구간에서 6.5%까지 낮아지는 반면, RLVR은 비교 구간에서 주로 11–17%에 머뭅니다. 이진 보상에서 모두 실패한 그룹은 GRPO가 이용할 그룹 내부 보상 차이를 주지 않으므로, 저자는 이 감소를 보상 희소성 완화와 연결합니다. BAR를 쓰는 두 방법 사이에서도 하니스와 정책의 상태에 따라 유용한 실행을 얻는 양상이 달라지는 것입니다.
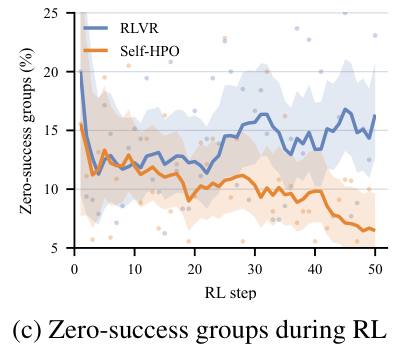
Figure 4(c) 상세 크롭, PDF 7쪽. 원문 축·범례·점·곡선·음영을 보존했습니다. 출처. 원문은 이 패널 음영의 계산 방식을 별도로 설명하지 않으므로 (a)의 부트스트랩 신뢰구간 정의를 여기에 임의 적용하지 않습니다.
3.5 Case Studies
Harness evolution adds targeted controls around the existing agent loop. Figure 5는 초기 하니스와 외부 제안자 HPO의 두 번째 H-step에서 얻은 하니스를 비교합니다. Self-HPO의 코드라고 바꾸어 부르면 안 됩니다. 모델 질의와 명령 실행의 기본 루프는 유지하면서 예산 소진 직전과 제출 시점에 개입합니다. 근거: §3.5·Figure 5
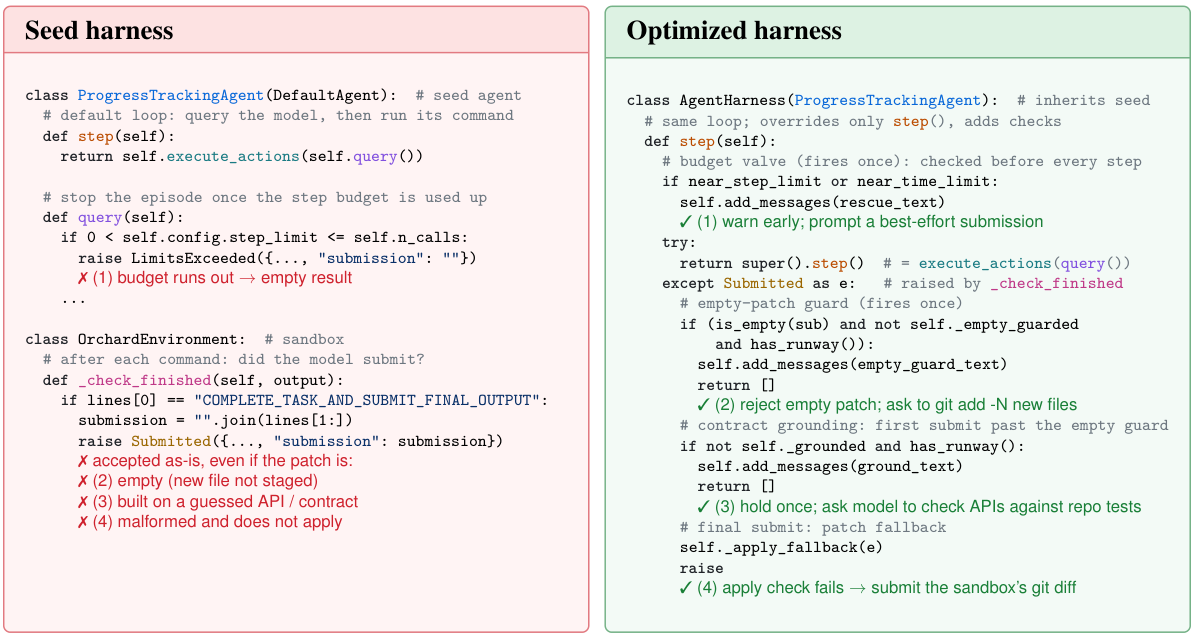
원문 Figure 5, “Seed versus optimized harness (HPO, second H-step)”, PDF 8쪽. 좌우 코드 패널 전체 크롭이며 색·코드·대응 번호를 보존했습니다. 고정 버전 출처. 작은 코드의 실행 순서는 아래 표와 부록 D의 텍스트 코드에서 다시 설명합니다.
| 개입 순서 | 초기 하니스에서 통과하던 실패 | 진화한 HPO 하니스의 동작 |
|---|---|---|
| 1 | 단계·시간 소진 후 빈 결과로 종료 | 소진 직전에 한 번 경고하고 가능한 최선의 수정을 제출하도록 요청 |
| 2 | 새 파일이 diff에 잡히지 않는 등의 빈 패치 | 한 번 제출을 보류하고 새 파일을 git add -N으로 diff에 포함하도록 안내 |
| 3 | 추측한 API 이름·호출 규약을 구현한 패치 | 빈 패치 검사를 통과한 첫 제출을 한 번 보류하고 기존 테스트·호출부와 대조하도록 요청 |
| 4 | 적용되지 않는 형식의 패치 | 적용 검사가 실패하면 샌드박스 자체의 Git diff를 대체 제출물로 사용 |
이 사례는 하니스 최적화의 탐색 공간이 프롬프트 문구에 머무르지 않음을 보여 줍니다. “빈 패치인가” 같은 실행 시점 검사와 “테스트에서 API를 대조하라”는 행동 지시가 함께 존재합니다. 다만 이 네 검사를 하나씩 제거한 인과적 기여도는 이 사례에 보고되지 않습니다. 부록 D는 같은 HPO 하니스의 코드와 메시지를, 부록 E는 별도의 Self-HPO 하니스가 실제 과제에서 개입하는 장면을 제시합니다. 실험 장의 핵심은 해결률뿐 아니라 최종 제출까지의 경로가 달라진다는 점이며, 다음 장은 이러한 설계를 기존 연구의 두 축과 비교합니다.
📖 Chapter 4: Related Work
이 장은 하니스 최적화, 정책 학습, 둘의 공동 진화 순서로 관련 연구를 정리합니다. 아래 비교는 이 논문이 제시한 분류와 기술에 근거하며, 인용된 모든 선행논문을 별도로 재검증한 결과는 아닙니다. 근거: §4
Harness optimization for LLM agents. 저자는 프롬프트와 프로그램, 문맥, 워크플로의 최적화를 먼저 정리하고, 피드백을 반영하는 수정·성찰, 기술과 메모리, 프로그램 진화로 범위를 넓힙니다. 이어 실행 증거·공유 경험·시연·자기 선호를 사용하는 하니스 수정과 지속 적응·과제 선택·탐색 제어·고정 예산 평가를 다룹니다. 이 분류에서 Self-HPO의 차이는 하니스가 제공하는 대상 정책도 학습으로 업데이트한다는 것입니다.
Policy learning and self-improvement. 이어 필터링한 추론, 갱신되는 선호, 자기 대국 커리큘럼, 부정적 교사와 진화하는 환경을 이용하는 학습을 소개합니다. 소프트웨어 공학에서는 실행 환경, 소프트웨어 변화에 대한 감독, 자기 대국 코드 수정을 다룹니다. 검증 보상 기반 RL, 하니스 유도 증류, 해를 찾는 중의 테스트 시점 학습도 포함합니다. 저자의 대비점은 기존 정책 학습들이 사용하는 고정 하니스와 달리 Self-HPO에서는 그 틀도 함께 진화한다는 것입니다.
Joint harness–policy evolution. 마지막으로 프롬프트와 가중치, 실행 가능한 하니스와 정책, 정책과 기술·외부 상태의 공동 적응 및 안전성 지향 공동 진화를 정리합니다. MetaRSI는 데이터 생성·하니스 편집·모델 학습을 조합한 순환으로 소개됩니다. 동시기 연구는 개입 경로, 전이와 여러 하니스 학습, 하니스를 고치는 능력과 그 혜택을 받는 능력의 분리를 다룹니다.
이후 구체적 차이를 두 가지로 좁힙니다. WHALE은 고정 외부 제안자를, Evo²는 고정 해결 정책과 별도로 학습되는 제안자를 사용합니다. HASE는 학습되는 자기 제안 정책을 쓰지만 하니스 편집을 RL 행동 공간에 포함합니다. Self-HPO는 하니스 탐색과 RL을 교대 수행합니다. 또 WHALE·Evo²·HASE의 고정 탐색 과제와 달리, Self-HPO는 직전 RL에서 끝내 풀지 못한 과제로 다음 탐색 집합을 구성합니다. 이 장의 기여는 “공동 최적화 최초” 같은 넓은 주장보다 누가 제안하는가, 어떤 과제가 탐색을 안내하는가라는 비교 축을 선명하게 하는 데 있으며, 부록 C가 이를 표로 확장합니다.
📖 Chapter 5: Conclusion
결론은 진화하는 정책이 자신의 하니스를 제안하고, 선택된 하니스 아래에서 RL로 학습하며, 그 학습의 어려운 과제를 다음 탐색에 전달하는 순환을 다시 정리합니다. 세 코딩 벤치마크 평균이 57.8%에서 64.8%로 개선되었고, 하니스와 정책의 이득이 상호 보완적이며 pass@1과 pass@k가 함께 좋아진다고 요약합니다. 근거: §5
저자는 이 장에 별도의 향후 연구 목록이나 한계 절을 제시하지 않습니다. 따라서 이 리뷰도 장기적인 무제한 자기 개선, 다른 도메인의 성능, 새로운 실험 과제를 저자의 결론으로 추가하지 않습니다. 본문 논증은 여기서 마무리되며, 이어지는 참고문헌과 부록은 방법의 재현 조건과 해석의 세부 근거를 제공합니다.
📖 Chapter References: References
참고문헌은 본문 결론 뒤, 부록 앞에 위치합니다. 에이전트의 도구 사용과 ReAct, SWE-bench 평가, GRPO와 검증 보상 학습, 하니스 최적화 및 공동 진화 연구가 앞서의 논증을 뒷받침합니다. 예를 들어 본문은 RL 구성에서 GRPO와 Orchard를, pass@k 계산에서 Chen 등의 코드 생성 평가 방식을 참조합니다. 이 리뷰는 참고문헌 목록의 위치와 인용 관계를 확인했으며, 목록의 모든 논문 원문을 읽었다고 주장하지 않습니다. 이어지는 부록 A는 이 논문 자체의 학습 구현을 구체화합니다. 근거: 원문 References, PDF 9–15쪽
📖 Chapter A: Implementation Details
부록 A는 모델 실행 환경, 탐색 데이터, 하니스 평가, 정책 학습의 순서로 본문의 재현 조건을 명시합니다. 본문에서 생략한 GRPO 목적함수와 BAR의 그룹 구성은 이 부록에 있습니다. 근거: Appendix A, PDF 16쪽
Agent implementation
모델은 Qwen3.5-35B-A3B이고 서빙에는 SGLang을 사용합니다. RL과 SFT는 B200 GPU 8개가 있는 한 노드에서 slime 프레임워크로 수행합니다. 초기 하니스는 mini-SWE-agent 인터페이스를 따르며, 모델은 과제별 저장소 환경에서 bash 명령을 실행합니다. 이는 일반 텍스트 정답을 생성하는 학습과 달리 실제 파일 수정·테스트·패치 제출의 궤적이 학습 단위라는 점을 분명히 합니다. GPU 개수는 실행 자원 구성이지 총 GPU 시간이나 비용은 아닙니다.
Optimization data
최초 탐색 집합 $\mathcal S_0$은 2,484개 훈련 과제에서 무작위로 뽑은 300개입니다. 후속 H-step에는 직전 P-step에서 해당 과제의 어느 롤아웃도 해결하지 못한 과제가 들어갑니다. 다음 단계에서 재사용하는 과제 ID와 새로 생성하는 실패 궤적을 구분해야 합니다. 원문은 후속 집합의 실제 과제 수를 이 부록에서 별도 제시하지 않습니다.
Harness optimization
Self-HPO는 현재 정책 체크포인트를 해결자와 제안자로 모두 사용합니다. 제안자는 실패를 포함한 평가 경험을 읽고 현재 최선 하니스를 수정합니다. HPO는 같은 구조에서 제안자만 Opus 4.8로 바꿉니다. 각 H-step에서 후보 6개를 평가하고 각 후보를 탐색 과제마다 한 번 실행하며, 선택한 하니스는 다음 정책 학습 동안 고정합니다. Self-Harness와 Meta-Harness도 같은 탐색 예산을 사용합니다. 따라서 하니스 후보 개수는 맞추지만, 이 사실만으로 모든 방법의 전체 훈련 비용까지 같다고 결론 내릴 수는 없습니다.
Policy optimization
각 P-step은 직전 라운드 정책에서 시작하여 선택된 하니스 아래에서 on-policy 궤적을 수집합니다. 원문 식 (2)는 다음과 같은 클리핑 목적함수입니다. 아래는 원문 식의 줄바꿈과 clip의 직립체 표기만 조정한 것입니다.
$\theta$는 업데이트할 정책의 가중치입니다. $\mathcal A(\tau_i)$는 궤적 $\tau_i$ 중 assistant가 생성한 토큰 위치의 집합입니다. 따라서 도구 관찰 전체에 같은 정책 손실을 적용하는 식이 아닙니다. $|\mathcal A(\tau_i)|$로 나누어 궤적 안에서 평균하고, $\mathbb E_i$로 궤적을 평균합니다. $\widehat A_i$는 같은 과제의 그룹 보상을 기준으로 한 상대적 이점이며, $\rho_{i,u}(\theta)$는 업데이트할 정책의 해당 토큰 확률을 롤아웃을 생성한 정책의 확률로 나눈 비율입니다.
$\mathrm{clip}$은 비율을 하한 $1-\varepsilon_{\mathrm{low}}$와 상한 $1+\varepsilon_{\mathrm{high}}$ 안으로 제한합니다. 두 항의 최솟값을 취해 큰 확률 변화로 목적값이 과도하게 좋아지는 것을 억제하며, 앞의 음수는 최대화 목적을 최소화 손실로 쓰기 위한 것입니다. 원문 임계값은 $\varepsilon_{\mathrm{low}}=0.2$, $\varepsilon_{\mathrm{high}}=0.28$로, 제한 구간은 0.8–1.28입니다. 원문은 이 부록에서 그룹 이점의 별도 계산식을 제시하지 않으므로 임의의 정규화 항이나 안정화 상수를 추가하지 않습니다.
BAR는 과제당 롤아웃 8개를 만들고 그중 4개를 골라 성공 비율이 0.25–0.75인 그룹을 구성합니다. 4개 가운데 1–3개가 성공해야 하므로 전부 성공하거나 전부 실패한 그룹을 그대로 학습시키는 것과 다릅니다. 필터를 통과하는 32개 그룹을 얻을 때까지 샘플링하며, 한 배치는 128개 학습 궤적으로 구성됩니다. 이 배치를 global batch size 128로 한 epoch 학습하여 옵티마이저 업데이트 한 번에 대응시킵니다. 원문의 128개는 선택 후 학습 궤적 수이며, 필터링 전에 생성한 전체 궤적 수는 아닙니다.
| 정책 학습 항목 | 원문 설정 |
|---|---|
| 옵티마이저 | Adam |
| 학습률 | 일정한 10⁻⁶ |
| 가중치 감쇠 | 0.01 |
| 엔트로피 계수 | 10⁻⁴ |
| KL 페널티 | 사용하지 않음 |
| 롤아웃 temperature / top-p | 0.95 / 0.95 |
| P-step당 업데이트 | 50회 |
| RLVR | 초기 하니스 아래에서 같은 학습 구성 사용 |
이 부록의 핵심은 성공률 보상과 실제 토큰 손실 사이를 연결하고, 유용한 보상 대비를 얻기 위한 샘플링 비용이 학습 배치 수와 별개임을 드러내는 데 있습니다. 다음 부록은 이와 분리된 평가 조건과 pass@k 계산을 설명합니다.
📖 Chapter B: Additional Evaluation Details
부록 B는 평가 실행 조건, SFT, 후보 탐색 곡선, pass@k 계산, 다른 모델과의 비교 순서로 주 결과를 보완합니다. 학습에 사용한 그룹 크기나 업데이트 횟수와 평가의 시도 횟수를 구분하는 데 필요한 부분입니다. 근거: Appendix B, PDF 16–17쪽
Evaluation configurations
모든 평가는 step limit 250, temperature 0.95, top-p 0.95를 사용합니다. 샌드박스나 API 오류로 실패한 시도는 다시 실행하고, 해결률의 분모는 각 벤치마크의 전체 과제입니다. 이는 인프라 오류로 일부 과제를 평가 집합에서 빼고 성공률을 계산하는 설정과 구분됩니다. 본문 Table 1은 세 번의 평가 평균이고, Figure 4의 시도 수는 과제당 8번입니다.
SFT configuration
Table 1의 SFT는 RL 훈련 과제에서 수집한 Opus 4.8 궤적 가운데 해결된 것만으로 초기 정책을 미세조정합니다. 학습은 2 epoch, batch size 64이며, 10% warmup 뒤 일정한 학습률 $5\times10^{-6}$을 사용합니다. 반면 Table 2의 SFT는 HPO의 P-step에서 RL을 대체하는 구성입니다. 같은 “SFT” 표기라도 Table 1의 독립 비교군과 Table 2의 교대 순환 내부 교체를 구분해야 합니다. 원문은 성공 궤적 총수나 외부 모델 토큰 비용을 제시하지 않으므로 2 epoch라는 설정에서 총비용을 계산할 수는 없습니다.
Search-frontier curves
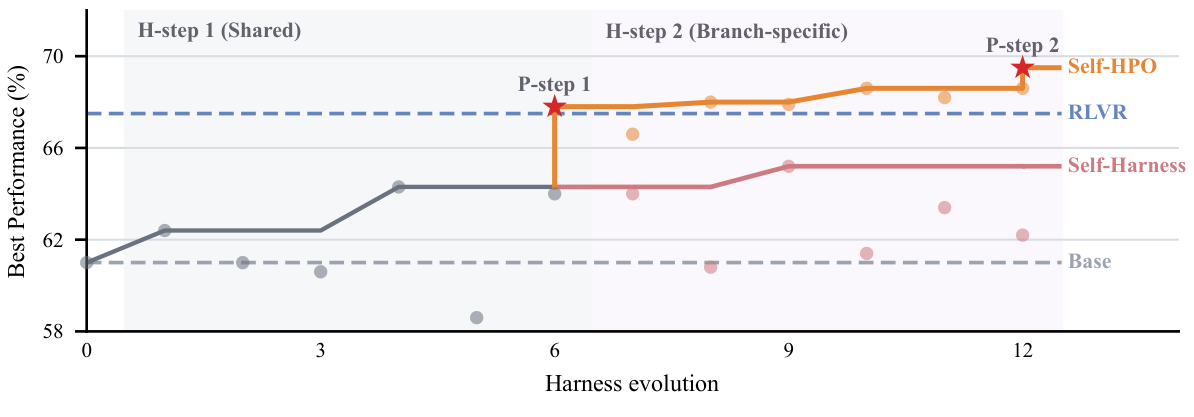
원문 Figure 6, “Best-so-far performance during harness evolution on SWE-Bench Verified”, PDF 17쪽. 그래프 전체를 크롭하고 개별 후보 점·별·축·범례를 보존했습니다. 고정 버전 출처. 원은 개별 후보 점수이고 선은 지금까지의 최고값이므로 서로 다릅니다.
후보 1–6은 두 방법이 공유하고, 7–12는 각각의 가지에 속합니다. 공통 첫 H-step은 64.3%에 도달합니다. 이후 Self-Harness는 하니스만 더 탐색해 최고 65.2%가 되지만, Self-HPO는 첫 정책 학습으로 67.8%에 도달한 뒤 탐색을 재개하여 68.6%, 두 번째 정책 학습 뒤 69.5%가 됩니다. 수직 상승과 별은 P-step이고, 수평 점선은 Base와 최종 RLVR입니다. 이것은 하니스 후보 수준의 변화와 정책 학습의 상승을 한 그림에서 분리하는 근거입니다.
Pass@k calculation
Verified 각 과제의 8회 실행 가운데 성공 수를 $c$, 전체 시도 수를 $n=8$이라고 할 때, 원문은 다음 추정량을 과제별로 계산하고 과제 전체에 평균합니다. 근거: Appendix B, PDF 17쪽
$\binom{n}{k}$는 8개 시도에서 $k$개를 고르는 경우의 수이고, $\binom{n-c}{k}$는 실패한 시도만 $k$개 뽑는 경우의 수입니다. 따라서 그 비율을 1에서 빼면 선택한 시도에 성공이 적어도 하나 들어갈 비율이 됩니다. $k=1$이면 과제의 성공 빈도 $c/n$이고, $k=8$이면 8번 중 한 번이라도 성공했는지의 지표입니다. 실패 수보다 $k$가 클 때는 실패만 고르는 경우가 0이므로 값은 1입니다. 이는 식의 조합론적 의미를 풀어 쓴 설명입니다.
따라서 avg@3의 평균 해결률을 이 식의 $k=3$에 넣을 수 없습니다. Figure 4(a)의 음영은 95% 부트스트랩 신뢰구간입니다. 원문은 Table 1에 대해서는 평균과 표준편차를 제시하며, 별도의 가설 검정이나 p값을 보고하지 않습니다.
Comparison with frontier models
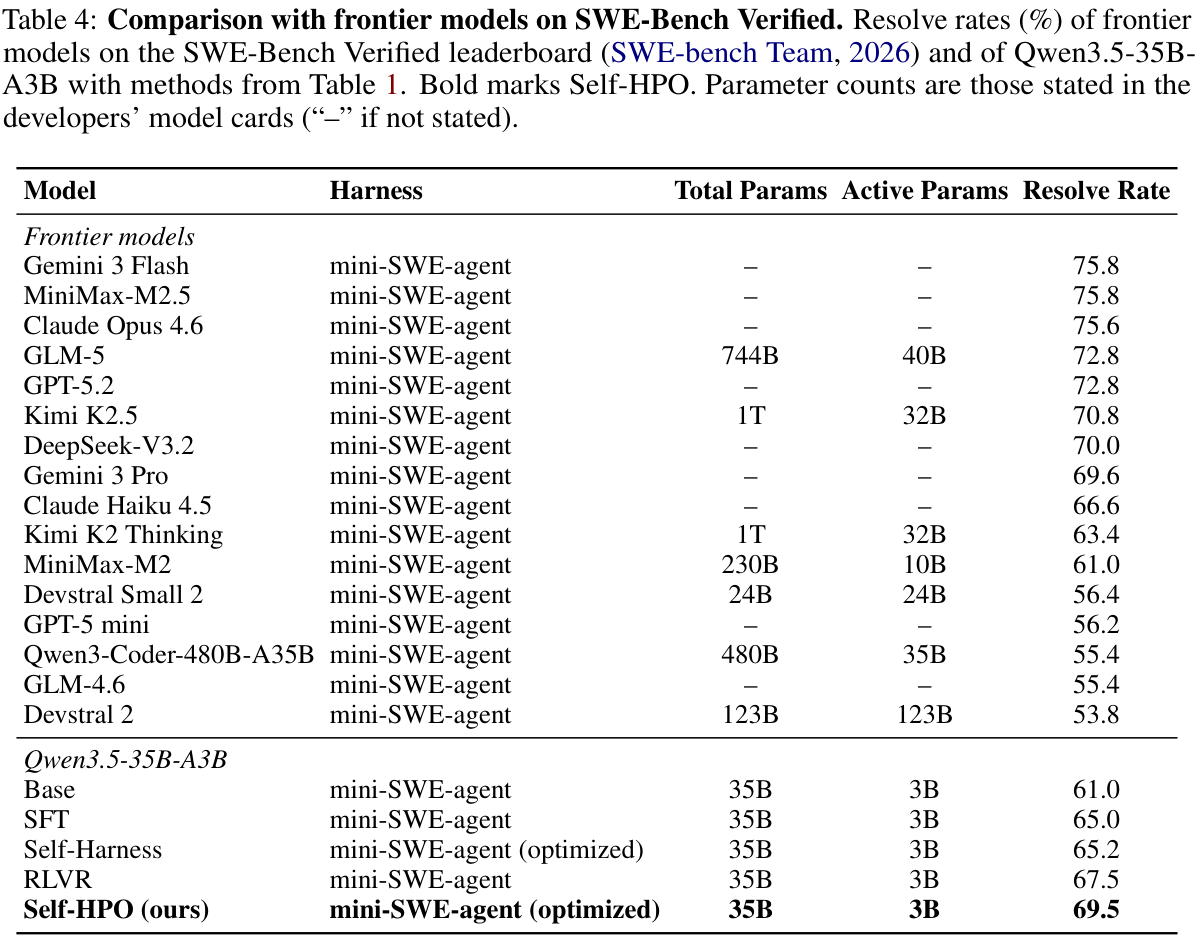
원문 Table 4, “Comparison with frontier models on SWE-Bench Verified”, PDF 17쪽. 원문 캡션과 표 전체를 크롭하였으며 수치·모델명·파라미터 수를 수정하지 않았습니다. 고정 버전 출처. 현재 시점의 리더보드를 재조회한 결과가 아니라 논문에 수록된 비교입니다. 작은 수치를 읽을 수 있도록 아래에 전체 값을 전사합니다.
| 모델·구성 | 하니스 | 전체 / 활성 파라미터 | 해결률 (%) |
|---|---|---|---|
| Gemini 3 Flash | mini-SWE-agent | 미기재 / 미기재 | 75.8 |
| MiniMax-M2.5 | mini-SWE-agent | 미기재 / 미기재 | 75.8 |
| Claude Opus 4.6 | mini-SWE-agent | 미기재 / 미기재 | 75.6 |
| GLM-5 | mini-SWE-agent | 744B / 40B | 72.8 |
| GPT-5.2 | mini-SWE-agent | 미기재 / 미기재 | 72.8 |
| Kimi K2.5 | mini-SWE-agent | 1T / 32B | 70.8 |
| DeepSeek-V3.2 | mini-SWE-agent | 미기재 / 미기재 | 70.0 |
| Gemini 3 Pro | mini-SWE-agent | 미기재 / 미기재 | 69.6 |
| Claude Haiku 4.5 | mini-SWE-agent | 미기재 / 미기재 | 66.6 |
| Kimi K2 Thinking | mini-SWE-agent | 1T / 32B | 63.4 |
| MiniMax-M2 | mini-SWE-agent | 230B / 10B | 61.0 |
| Devstral Small 2 | mini-SWE-agent | 24B / 24B | 56.4 |
| GPT-5 mini | mini-SWE-agent | 미기재 / 미기재 | 56.2 |
| Qwen3-Coder-480B-A35B | mini-SWE-agent | 480B / 35B | 55.4 |
| GLM-4.6 | mini-SWE-agent | 미기재 / 미기재 | 55.4 |
| Devstral 2 | mini-SWE-agent | 123B / 123B | 53.8 |
| Qwen3.5-35B-A3B / Base | mini-SWE-agent | 35B / 3B | 61.0 |
| Qwen3.5-35B-A3B / SFT | mini-SWE-agent | 35B / 3B | 65.0 |
| Qwen3.5-35B-A3B / Self-Harness | mini-SWE-agent(최적화) | 35B / 3B | 65.2 |
| Qwen3.5-35B-A3B / RLVR | mini-SWE-agent | 35B / 3B | 67.5 |
| Qwen3.5-35B-A3B / Self-HPO | mini-SWE-agent(최적화) | 35B / 3B | 69.5 |
B는 10억, T는 1조 파라미터를 나타내며, 원문은 개발자 모델 카드에 없는 파라미터 수를 대시로 표시합니다. 전체 파라미터와 활성 파라미터를 구분하면 Qwen의 총 35B와 활성 3B라는 조건을 함께 볼 수 있습니다. Self-HPO의 69.5%는 논문 표에서 Gemini 3 Pro 69.6%, DeepSeek-V3.2 70.0% 근처지만 최고 해결률은 아닙니다. 또 이 표는 리더보드 값과 본 논문 실험을 함께 배치한 맥락 비교이므로 동일 실험에서 모델 크기만 바꾼 통제 실험이나 비용 효율 순위로 해석하지 않습니다.
이 부록은 주 결과의 비교 조건과 다회 시도 지표를 분리해 읽을 근거를 제공합니다. 다음 부록은 수치 성능 대신 관련 방법들의 구조를 비교합니다.
📖 Chapter C: Conceptual Comparison with Related Methods
부록 C는 먼저 Table 5로 코딩 평가 여부, 해결 정책의 학습 방식, 하니스 제안자, 탐색 집합을 비교합니다. 아래는 이 논문에 수록된 분류를 한국어로 전사한 것입니다. 코딩 평가가 없다는 표기는 해당 논문 전체의 현재 적용 가능성을 단정하는 것이 아니라 원문의 비교 기준입니다. 근거: Appendix C·Table 5, PDF 18쪽
| 방법 | 코딩 평가 | 해결 정책 업데이트 | 하니스 제안자 | 하니스 탐색 집합 |
|---|---|---|---|---|
| Meta-Harness | 있음 | 고정 | 고정 외부 모델 | 고정 |
| Self-Harness | 있음 | 고정 | 고정 자기 정책 | 고정 |
| Task-CoEvolve | 있음 | 고정 | 고정 외부 모델 | 진화: 높은 분산 과제 |
| Evo² | 있음 | 고정 | 별도로 진화하는 제안자 | 고정 |
| WHALE | 없음 | SFT | 고정 외부 모델 | 고정 |
| HASE | 없음 | RL | 진화하는 자기 정책 | 고정 |
| Self-HPO | 있음 | RL | 진화하는 자기 정책 | 진화: RL의 어려운 과제 |
The trained solver becomes the next harness proposer
Self-Harness의 제안 정책은 고정되어 있고, WHALE은 정책 학습과 함께 별도의 고정 외부 제안자를 사용하며, Evo²는 해결 정책을 고정한 채 제안자를 따로 학습합니다. Self-HPO에서는 바로 직전 P-step에서 학습된 해결 정책이 다음 제안자입니다. H-step에서는 가중치를 고정하고 탐색한 뒤, P-step에서 선택된 하니스 아래의 RL을 수행합니다.
HASE 역시 자기 제안 정책을 학습한다는 공통점이 있습니다. 다만 저자의 비교에 따르면 HASE는 문제 해결과 하니스 편집을 하나의 RL 행동 공간에 넣고, 지속되는 편집을 단계 경계에서 검토합니다. Self-HPO는 하니스 후보 탐색과 RL 업데이트를 별도 단계로 교대한다는 차이가 있습니다. 따라서 “자기 정책으로 하니스를 고친다”는 한 특징만으로 두 방법을 동일시할 수 없습니다.
Policy training also determines the next harness-search tasks
P-step의 출력은 정책 $P_{t+1}$과 어려운 과제로 구성한 탐색 집합 $\mathcal S_{t+1}$입니다. 이는 “누가 제안하는가”와 “무엇을 근거로 탐색하는가”를 동시에 바꿉니다. Task-CoEvolve도 과제 선택을 적응시키지만, 저자가 구분하는 기준은 후보 하니스 사이의 결과 분산입니다. Self-HPO는 정책 학습에서 드러난 끝내 풀리지 않은 과제를 사용합니다. 후보마다 난이도를 다시 뽑는 대신 과제 ID는 H-step 사이에 바꾸고 한 H-step 안에서는 고정합니다.
이 부록의 핵심은 진화라는 명칭 아래 서로 다른 학습 대상과 과제 선택 규칙을 분해하는 데 있습니다. 다음 부록은 그중 하니스 제안자가 실제로 어떤 정보와 제약 아래 코드를 수정하는지 보여 줍니다.
📖 Chapter D: Harness Details and Prompt Templates
부록 D는 초기 하니스, 탐색 가능한 수정 범위, 제안자 프롬프트, 최적화된 코드와 주입 메시지 순서로 구체화합니다. 특히 Figure 5·8·9는 외부 제안자 HPO의 두 번째 H-step에서 선택된 하니스를 설명합니다. 다음 부록 E의 Self-HPO 하니스와는 다릅니다. 근거: Appendix D, PDF 18–21쪽
Seed harness
초기 $H_0$은 mini-SWE-agent의 ReAct 루프입니다. ReAct는 추론과 행동을 이어 가며 환경 관찰을 다음 행동에 반영하는 방식입니다. 여기서는 과제별 샌드박스에서 bash 도구를 호출하고, 정해진 제출 명령 뒤에 패치를 출력하면 에피소드가 끝납니다. 과제 프롬프트는 이슈 설명 뒤에 고정 지시와 정확한 제출 명령을 포함합니다.
Figure 5의 초기 step()은 execute_actions(query())를 호출합니다. query()는 단계 예산이 소진되면 빈 제출물과 함께 종료 예외를 발생시킵니다. 환경의 _check_finished()는 출력 첫 줄이 COMPLETE_TASK_AND_SUBMIT_FINAL_OUTPUT이면 나머지 출력을 제출물로 받아 Submitted 예외를 던집니다. 이 종료 신호의 존재와 유효한 코드 패치의 존재는 별개입니다. 다음 절의 탐색 공간은 이 간극을 다룰 수 있도록 허용됩니다.
Harness search space
후보는 초기 에이전트를 상속하는 Python 클래스와 프롬프트 템플릿입니다. 에이전트의 step 등을 재정의하여 상태를 읽거나, 제출을 받아들이기 전에 피드백을 돌려주거나, 제출 패치를 바꾸거나, 다른 실행 단계에 개입할 수 있습니다. 저장소 접근은 모두 샌드박스를 통합니다. 정책과 temperature·top-p 0.95는 후보 사이에 고정됩니다. 따라서 모델 샘플링 조건을 바꾸는 것이 이 실험의 하니스 개선으로 계산되지는 않습니다.
Harness proposer
제안자는 셸 접근 권한을 가진 코딩 에이전트로 실행됩니다. 부모 하니스, 탐색 집합의 실행 궤적, 탐색 과제의 기준 수정본(reference fixes), 이전 후보 출력, 라운드마다 덧붙이는 메모를 읽을 수 있습니다. 따라서 자기 제안은 모델이 아무런 감독 근거 없이 정답을 발명한다는 의미가 아닙니다. 원문 Figure 7의 시스템 프롬프트는 이 정보를 진단용으로 쓰되 기준 패치나 과제별 사실을 실행 에이전트의 문맥에 주입하지 못하도록 제한합니다. 근거: Figure 7, PDF 19쪽
프롬프트는 현재 고정 정책, 어려운 탐색 과제 수, 현재 최선 부모 하니스와 그 점수를 먼저 알려 주고, 부모 위에 새로운 메커니즘 하나를 추가하여 더 많은 과제를 풀라고 요구합니다. 첫 라운드의 집합은 무작위 $\mathcal S_0$이며, “직전 P-step의 어려운 과제”라는 설명은 후속 라운드에 해당한다는 점을 원문 캡션이 보충합니다.
| 프롬프트의 순서 | 제약·근거·행동 |
|---|---|
| 제약 1 | 부모의 기존 메서드를 그대로 유지하고 새 메커니즘은 정확히 하나 추가 |
| 제약 2 | 정책·샘플링·step limit·최대 토큰·검증기는 고정 |
| 제약 3 | 기준 패치나 과제별 사실을 실행 문맥에 주입하지 않고, 실행 시 스스로 계산한 신호 사용 |
| 경험 | 앞서 평가한 후보의 점수·코드·궤적과 제안자 메모를 먼저 읽음 |
| 진단 | 아래의 누락·정밀도·제출 손실·기준 수정 유형을 근거로 판단 |
| 작업 0–1 | 이전 경험과 최근 후보가 개선·악화시킨 과제를 읽고, 여러 실패 궤적과 일부 기준 수정을 비교하여 가설 구성 |
| 작업 2 | 에이전트 상태에서 감지 가능한 트리거와 구체적 동작을 설계 |
| 작업 3 | 부모 하니스 사본에 구현하고 모든 저장소 접근을 샌드박스로 수행 |
| 작업 4 | 진단 원인에서 메커니즘으로 이어지는 목적을 한 줄로 쓰고 배운 점을 메모에 추가 |
| 검사 | 부모 메서드 보존과 실제 과제에서의 발동을 검사하고 실패하면 제안자에게 수정 요청 |
진단 항목도 서로 다른 실패를 구분합니다. Coverage gap은 기준 수정에 필요한 파일과 에이전트가 만진 파일의 차이입니다. Precision gap은 필요한 파일을 모두 수정했으나 내용이 잘못된 경우입니다. Submission loss는 궤적에 실제 소스 수정이 있지만 최종 패치가 비거나 형식이 잘못된 경우입니다. 마지막으로 여러 파일 수정, 함수 시그니처 변경, 새 import, guard, 오류 처리 같은 기준 수정 유형과 실제 출력을 비교합니다. 프롬프트는 이 목록을 의무 처방이 아닌 근거로 읽고 가장 크면서 하니스가 개입할 수 있는 실패를 선택하거나 다른 원인을 찾도록 합니다.
원문 Figure 7 자체가 축약된 시스템 프롬프트이며, 파일 경로·샌드박스 인터페이스·검증 스크립트 같은 구현 지시는 생략되어 있습니다. 따라서 이 표는 원문에 공개된 지시의 논리 순서를 설명하며 실행 가능한 전체 환경을 복원한 것은 아닙니다.
Optimized harness
선택된 HPO 하니스는 초기 프롬프트와 기본 루프를 유지하며 step()만 재정의하여 네 검사를 추가합니다. 아래 Figure 8은 그 변경을 초기 코드와의 diff로 제시합니다. 원문도 helper 호출을 짧은 이름으로 축약합니다. 근거: Figures 8–9, PDF 20–21쪽
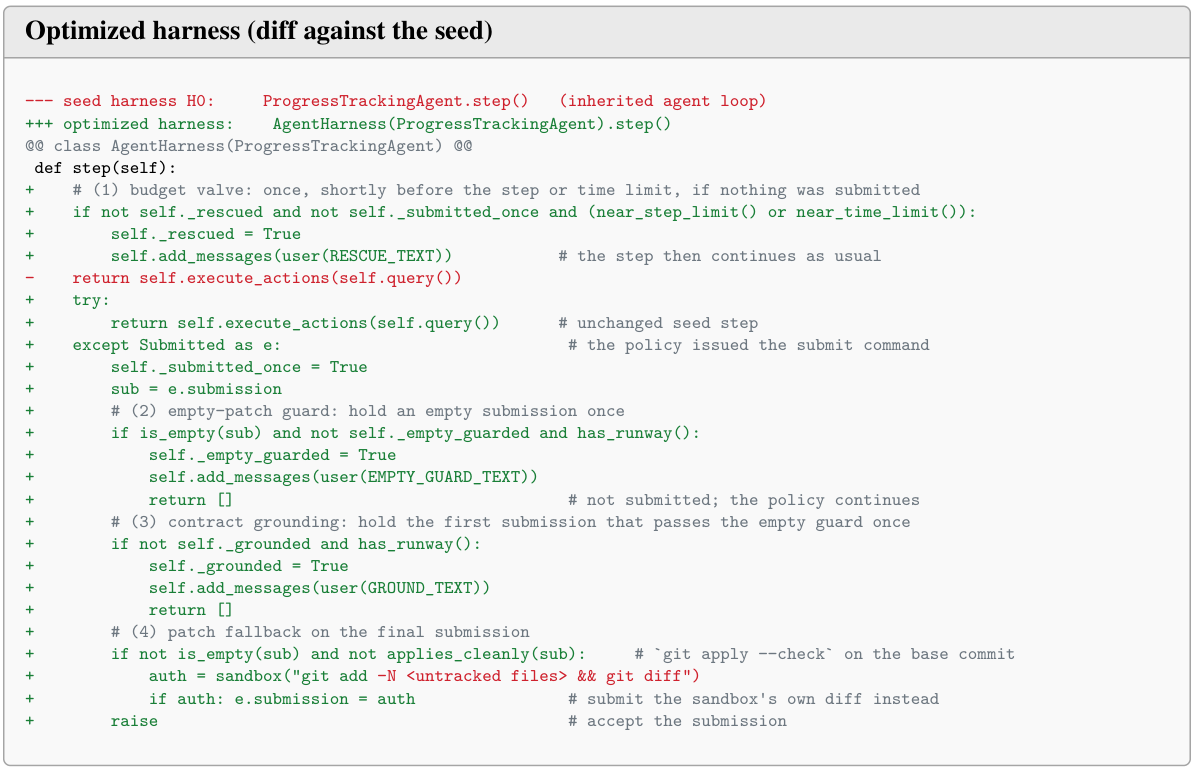
원문 Figure 8, “Harness changes from HPO’s second H-step”, PDF 20쪽. 코드 패널 전체 크롭이며 추가·삭제와 helper 이름을 보존하였습니다. 고정 버전 출처. 코드의 핵심 제어 흐름을 다음 텍스트 블록으로도 제공합니다.
다음은 Figure 8의 변경 후 step()을 읽기 위해 옮긴 원문 축약 코드입니다. 주석은 한국어로 풀었고, 원문 diff의 삭제 행과 + 표시는 제외하였습니다. helper의 구현을 보충하거나 새 실행 코드를 만든 것은 아닙니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
def step(self):
    # 1. 아직 제출하지 않았고 예산이 임박했으면 한 번 경고합니다.
    if not self._rescued and not self._submitted_once and (near_step_limit() or near_time_limit()):
        self._rescued = True
        self.add_messages(user(RESCUE_TEXT))
    try:
        return self.execute_actions(self.query())
    except Submitted as e:
        self._submitted_once = True
        sub = e.submission
        # 2. 남은 예산이 있으면 빈 패치를 한 번 보류합니다.
        if is_empty(sub) and not self._empty_guarded and has_runway():
            self._empty_guarded = True
            self.add_messages(user(EMPTY_GUARD_TEXT))
            return []
        # 3. 위 검사를 통과한 첫 제출을 한 번 보류하고 API 대조를 요청합니다.
        if not self._grounded and has_runway():
            self._grounded = True
            self.add_messages(user(GROUND_TEXT))
            return []
        # 4. 적용되지 않는 패치는 샌드박스의 diff로 대체합니다.
        if not is_empty(sub) and not applies_cleanly(sub):
            auth = sandbox("git add -N <untracked files> && git diff")
            if auth:
                e.submission = auth
        raise
첫 검사는 매 단계의 앞부분에서 예산 소진 직전 한 번 작동합니다. 나머지는 Submitted 예외를 가로채는 경로입니다. 두 보류 경로의 return []는 제출을 확정하지 않고 정책에 다음 행동 기회를 줍니다. 마지막 raise는 제출을 수용하는 예외를 다시 전달합니다. has_runway() 조건은 수정할 남은 예산이 있을 때만 추가 행동을 요구하게 합니다. 원문의 축약 helper 이름만으로 정확한 시간·단계 임계값을 추정하지 않습니다.
Figure 9는 이 중 세 검사가 대화에 넣는 메시지를 다음 순서로 제시합니다. 각 메시지는 과제당 최대 한 번 추가되며 그 뒤에 정책의 차례가 옵니다. 코드상 검사와 모델에게 요청하는 행동을 구분하여 읽어야 합니다.
- Budget valve —
RESCUE_TEXT: 남은 단계·시간이 거의 없고 아직 패치를 제출하지 않았음을 경고합니다. 새 탐색을 시작하지 말고 현재 아는 정보에서 가장 가능성 높은 수정 위치 하나를 정한 뒤, 요청을 만족하는 작은 소스 수정을 하도록 합니다. 다음 한두 명령 안에 패치 생성과 제출을 별도 명령으로 수행하도록 요구합니다. 빈 결과는 0점이지만 최선의 수정은 통과할 수 있다는 근거를 함께 제공합니다. - Empty-patch guard —
EMPTY_GUARD_TEXT: 소스 변경이 없는 빈 제출은 확정되지 않았음을 알립니다. 이슈가 지목한 정확한 심볼·메시지·플래그를 다시 찾고 해당 소스를 수정하도록 합니다. 새 파일을 만들었다면 일반git diff에 보이지 않을 수 있으므로git add -N을 실행하고, 실제 diff 또는new file mode가 나타나는지 확인한 뒤 패치를 다시 생성·제출하도록 합니다. “파일을 만들었다”와 “그 파일이 제출 패치에 들어갔다”를 분리하는 안내입니다. - Contract grounding —
GROUND_TEXT: 적용 가능한 패치라도 잘못 추측한 함수명·옵션·시그니처·오류 형태를 구현할 수 있음을 지적합니다. 이슈를 다시 읽는 것만으로는 같은 해석 오류를 잡기 어렵다고 설명하고 저장소의 기존 테스트와 호출부를 근거로 삼게 합니다. 먼저 diff와 새로 추가·변경한 심볼을 확인하고, 해당 심볼과 가까운 기존 API의 사용을 검색한 다음 실제 테스트 파일을 열어 정확한 이름·호출 형태·기댓값을 대조하게 합니다. 어긋나면 기존 규약에 맞추고, 필요한 동작을 놓치지 않았는지 확인하며, 변경했다면 패치를 재생성해 의도한 소스 변경만 담겼는지 검사한 뒤 정확한 제출 명령을 재실행합니다. 이 검사는 한 번만 수행되고 재제출은 통과시킵니다.
메시지에 포함된 패치 생성·제출 형식의 예는 다음과 같습니다. <the source files you modified>는 원문이 사용한 자리표시자이며 실제 파일명으로 바꾸어 쓰는 형식입니다.
1
2
git diff -- <the source files you modified> > patch.txt
echo COMPLETE_TASK_AND_SUBMIT_FINAL_OUTPUT && cat patch.txt
네 번째 patch fallback은 별도 메시지를 넣는 대신 제출 패치를 검사하고, 기준 커밋에서 git apply --check가 실패하면 샌드박스의 diff를 사용합니다. 세 메시지가 모두 코드를 자동으로 고치는 것도, 네 검사가 모두 언어 지시인 것도 아닙니다. 이 부록은 하니스가 상태 검사·피드백·제출물 대체를 결합한다는 구체적 근거이며, 다음 부록은 같은 정책이 다른 하니스 아래에서 제출에 성공하거나 실패하는 실행을 보여 줍니다.
📖 Chapter E: Case Study: Where the Harness Intervenes
마지막 부록은 SWE-Bench Verified의 sphinx-doc__sphinx-9658에서 동일한 최종 Self-HPO 정책 P2를 초기 $H_0$와 진화한 $H_2$에 연결한 두 실행을 비교합니다. 여기의 $H_2$는 Self-HPO 두 번째 H-step의 결과이며, 부록 D의 HPO 하니스와 다릅니다. 원문은 과제·추론·행동·관찰·하니스 메시지를 구분하고, 생략된 앞부분은 […]로 표시합니다. 근거: Appendix E·Figures 10–11, PDF 21–24쪽
과제는 mock 처리된 클래스를 상속하는 클래스의 문서에서 기반 클래스 이름이 torch.nn.Module 대신 torch.nn.으로 표시되는 문제입니다. 두 실행 모두 소스 파일을 수정하고 기존 테스트가 통과한 뒤 작업을 마무리하려 합니다. 비교의 초점은 “수정을 할 수 있었는가” 다음에 그 수정이 실제 패치로 평가자에게 도달했는가입니다.
Case 1 (Failure Case): Policy P2 with the seed harness H0
Figure 10은 앞선 131단계를 생략하고 마지막 부분을 보여 줍니다. 정책은 소스 파일만 수정했고 테스트 파일은 바꾸지 않았다고 설명한 뒤 관련 테스트를 실행합니다. 결과는 99 passed, 7 skipped, 7 warnings입니다. 이어 모델은 수정 내용을 요약하고 제출 명령 뒤에 패치 대신 Markdown 요약문을 출력합니다. 근거: Figure 10, PDF 22쪽
초기 하니스는 제출 신호 이후 출력을 그대로 수용합니다. 결과적으로 테스트를 통과한 저장소 수정이 있어도 평가자에게 코드 변경이 전달되지 않아 과제는 해결되지 않습니다. 이 사례의 실패를 “정책이 Sphinx 버그를 고칠 코드를 생성하지 못했다”고만 해석하면 원문이 보여 주는 제출 손실을 놓치게 됩니다.
Case 2 (Success Case): Policy P2 with the evolved harness H2
Figure 11은 앞선 114단계를 생략하고 성공 실행의 마지막 부분을 이어 보여 줍니다. 이번에는 더 넓은 테스트 실행에서 195 passed, 7 skipped, 7 warnings가 나온 뒤 모델이 다시 패치 없이 종료하려 합니다. 제출 명령 다음에 sphinx/util/typing.py 일부를 출력하므로 유효한 diff가 아닙니다. 근거: Figure 11, PDF 22–24쪽
이때 하니스의 Full Files Auditor - Coverage Check가 탐색 중 만진 파일은 sphinx/util/typing.py 하나인데 제출 패치의 파일 수는 0개라고 알립니다. 하니스는 이 첫 제출을 한 번 보류하고 제어를 정책에 돌려줍니다. 모델은 다음 순서로 행동합니다.
git diff > patch.txt로 작업 트리 변경을 패치 파일로 만들고 내용을 확인합니다.- diff에는 mock 객체를 감지하고 그 타입 속성을 사용하여 Python 버전에 맞는
_restify_py37또는_restify_py36으로 이름을 표현하는 분기가 추가되어 있습니다. - 원래 이슈의 mock 기반 예제를 실행하여
:py:class:역할 안에torch.nn.Module이 나타나는지 확인합니다. 원문 관찰은 실제값과 기댓값이 같고Fix works: True라고 표시합니다. - 정확한 제출 신호 뒤에
/testbed/patch.txt를 출력하여 유효한 패치를 전달하고, 과제를 해결합니다.
원문에 나온 핵심 행동 명령은 다음과 같습니다. 이 리뷰에서 실행한 명령이 아니라 논문의 실행 기록을 옮긴 것입니다.
1
2
cd /testbed && git diff > patch.txt && cat patch.txt
echo COMPLETE_TASK_AND_SUBMIT_FINAL_OUTPUT && cat /testbed/patch.txt
함께 출력된 PR Intent Reminder는 별도로 해석해야 합니다. 하니스는 이슈의 키워드가 패치에 없다고 경고하지만, 저자는 이 키워드들이 관련 없는 부분에서 왔으므로 이 사례의 경고가 거짓 양성(false positive)이라고 명시합니다. 성공 사례에 경고가 등장했다는 이유로 그 경고의 모든 진단이 정확했다고 볼 수 없습니다. 여기서 직접 관찰되는 유효한 개입은 패치에 파일이 없다는 사실을 알리고 추가 행동을 허용한 것입니다.
이 부록의 기여는 하니스의 효과를 정책 가중치가 같은 두 실행의 마지막 단계에서 구체적으로 보여 주는 데 있습니다. 두 실행의 앞부분 전체가 동일하다는 통제나 개별 검사 하나의 평균 기여도를 주장하는 사례는 아닙니다. 저장소 수정·기존 테스트 통과·최종 패치 전달이 서로 다른 단계임을 보여 줍니다.
실험 결과 심층 분석
가장 강한 근거는 같은 기본 모델과 초기 하니스에서 출발한 Table 1의 구성별 비교입니다. Self-HPO는 Verified에서 Base 대비 8.5포인트, RLVR 대비 2.0포인트, Self-Harness 대비 4.3포인트 높습니다. 세 벤치마크 평균은 Base 57.8%에서 64.8%로 7.0포인트 증가합니다. 외부 모델 구성 HPO의 평균 66.3%는 더 높지만, 이는 Opus 4.8 제안자가 참여한 결과입니다. 이 둘을 합쳐 “외부 모델 없이 71.6%”라고 쓰면 실험 조건이 바뀝니다. 근거: Table 1, PDF 5쪽
표준편차와 통계적 유의성도 구분해야 합니다. Table 1의 Self-HPO 평균 64.8 ± 0.6%는 세 번 평가의 평균과 표준편차입니다. 원문에 별도의 유의성 검정·p값은 보고되지 않았습니다. Figure 4(a)의 95% 부트스트랩 신뢰구간은 8회 시도 기반 pass@k 곡선에 대한 것이며, 이 구간을 Table 1의 방법 간 차이에 대한 신뢰구간으로 옮길 수 없습니다. 같은 이유로 Table 3의 결합 추가 이득 1.6포인트도 평균값의 산술적 분석으로 표현해야 합니다.
실용적 의미를 더하는 결과는 세 가지입니다. 첫째, Python 훈련 뒤 두 OOD 벤치마크에서도 성능이 올랐습니다. 둘째, pass@8이 4.8포인트 높아져 다회 시도로 해결 가능한 과제 범위도 늘었습니다. 셋째, 교차 평가에서 최종 하니스와 정책이 각각 초기 상대와 연결되어도 일부 이득을 유지합니다. 동시에 원문이 직접 보여 준 실패 범위도 보아야 합니다. Resolved 집합의 pass@1은 2.2포인트 낮아졌고, SFT는 두 OOD 벤치마크에서 Base보다 낮았으며, Self-Harness의 두 번째 탐색은 Multi에서 하락했습니다. 부록 E의 의도 키워드 경고에는 거짓 양성도 있습니다. 이것이 이 글에서 다루는 구체적 실패이며, 원문에 없는 한계 목록을 덧붙이지 않습니다. 근거: §3.2–3.4·Appendix E
학습 예산의 공개 범위는 후보 6개씩 두 번, P-step 50회씩 두 번, 8 B200의 단일 노드 구성, SFT 2 epoch 등입니다. 하니스 단독 비교군은 같은 탐색 예산을 사용하고 RLVR은 같은 정책 학습 구성을 사용합니다. 그러나 전체 롤아웃 수, Opus API 토큰 비용, 총 GPU 시간은 보고되지 않았으므로 성능 표에서 곧바로 동일 비용 대비 우월성을 계산할 수는 없습니다. 이는 보고 범위를 구분한 것이며 저자가 명시하지 않은 새로운 실패 원인을 주장하는 것은 아닙니다. 근거: Appendix A–B
기술적 함의와 응용
저자의 핵심 주장은 정책과 하니스를 서로의 변화에 맞춰 반복 개선하는 것이 한쪽만 최적화하는 것보다 효과적이라는 것입니다. 이 연구의 코딩 환경에서 그 효과는 해결률과 제출 행동 양쪽에 나타납니다. 하니스가 제공하는 외부 제어와 학습된 정책이 완전히 서로를 대체하는 것이 아니라, 각각 일부 이득을 유지하고 결합에서 가장 높은 결과를 얻었다는 점이 핵심입니다.
리뷰어의 해석으로는, 실제 코딩 에이전트를 이해할 때 “모델이 저장소를 고쳤는가”와 “수정이 유효한 제출물로 전달되었는가”를 나누어 관찰하는 관점이 유용합니다. 부록 D·E는 패치 생성, 새 파일 포함, API 규약 확인, 적용 가능성, 종료 처리가 해결률에 연결되는 장면을 보여 줍니다. 다만 원문의 두 라운드 결과를 장기간의 무제한 자기 개선이나 웹·컴퓨터 사용 영역의 실증 성능으로 확대하지는 않습니다.
학습 관점에서는 P-step의 출력이 다음 정책만이 아니라 다음 탐색의 과제 집합이 된다는 연결이 중요합니다. 같은 훈련 데이터에서도 어떤 실패를 다시 실행하고 어떤 궤적을 제안자가 읽는지에 따라 하니스 탐색이 달라집니다. 또 BAR는 이진 보상 환경에서 학습 신호를 얻기 위한 샘플링과 최종 학습 배치를 구분하게 합니다. 원문 첫 쪽은 Self-HPO 코드 저장소와 Hugging Face 페이지를 자료 링크로 제시합니다. 이 리뷰의 분석 근거는 고정한 논문 v1이며, 연결된 구현을 실행하거나 별도 성능을 재현한 결과를 포함하지 않습니다.
이 논문이 보여 주는 자기 개선은 현재 정책이 실패를 읽고 하니스를 제안하며, 그 하니스 아래에서 학습하고 남은 실패를 다음 탐색으로 전달하는 구체적인 순환입니다. 세 코딩 벤치마크의 성능 향상과 제출 손실 사례는 이 순환을 모델 가중치와 실행 제어를 함께 다루는 학습 대상으로 이해할 근거를 제공합니다.