논문 개요와 전체 구조
Data World: Scaling Data Environments from Scratch는 데이터 분석 에이전트의 학습 환경과 평가 기준을 함께 합성하는 연구입니다. 데이터 에이전트는 CSV·Excel·로그처럼 서로 다른 파일을 코드로 조사하고, 수치를 계산한 뒤 그 결과로 설명 가능한 결론을 작성합니다. 이때 필요한 것은 파일의 양뿐 아니라, 어떤 결론이 자료로 뒷받침되는지 판정할 수 있는 감독 신호입니다. 저자들은 이미 존재하는 자료에서 질문과 모범 통찰을 찾아내는 대신, 자료를 발생시키는 세계의 메커니즘을 먼저 명세하고 그로부터 관측 파일·질문·평가 기준을 생성합니다. 이 리뷰는 arXiv:2610.21656v1, 2026년 10월 15일 제출본의 본문과 부록 A를 기준으로 합니다.
여기서 세계는 물리 로봇의 제어 환경이 아니라, 공급망·의료·교육·공공정책 등의 변수가 연결된 데이터 환경입니다. 생성 과정의 정본 상태와 분석가가 보는 불완전한 파일을 분리하고, 독립 감사자가 목표 현상을 관측 자료만으로 다시 계산할 수 있는지 확인합니다. 이렇게 만든 50개 시험 세계의 100개 과제가 DataWorld-Bench이며, 별개의 1,037개 세계에서 나온 2,135개 과제로 강화학습을 수행합니다. 논문은 열 개 모델의 계산 능력과 통찰 발견 능력 사이의 차이, 그리고 합성 과제의 학습 효용을 실험합니다.
연구의 중심은 합성 데이터의 외형적 현실감보다 생성 근거와 평가 기준 사이의 추적 가능성에 있습니다. 다만 저자들은 생성 메커니즘을 안다고 해서 모든 타당한 통찰을 평가할 수 있거나 실제 업무에서의 유효성이 보장되는 것은 아니라고 명시합니다. 아래에서는 생성의 사실, 저자의 성능 해석, 리뷰어의 방법론적 해석을 구분합니다.
원문의 전개 순서는 다음과 같습니다. 명시적인 목차 대신 실제 절과 소제목을 기준으로 정리했습니다.
| 순서 | 원문 구조와 다루는 내용 |
|---|---|
| 1 Introduction | 환경·감독 신호 공급 문제, 관측 자료에서 통찰을 채굴하는 방식의 누락, 메커니즘 우선 합성 |
| 2 Related Work | Data analysis agents and benchmarks → Task synthesis and rubric-based rewards → Synthetic environments and data |
| 3 Method | 3.1 Formalization and Overview → 3.2 Environment Synthesis(Dependency Skeleton → World Contract → Canonical Truth Generation → Observation Projection → Independent Audit) → 3.3 Task Synthesis → 3.4 Benchmark and Training-Set Curation |
| 4 Experiments | 4.1 Experimental Setup → 4.2 DataWorld-Bench Results → 4.3 Validating Training Utility(Comparisons → Results → General-capability retention and factuality) |
| 5 Conclusion | 감독 신호와 환경을 공동 합성하는 접근의 결론 |
| 본문 뒤 | Limitations → Ethical Considerations → References |
| Appendix A | A.1 Intuitive Theoretical Analysis → A.2 Evaluated Models → A.3 Benchmark Composition and Additional Analyses(분포·사례·도메인·과제 경로) → A.4 RL Training Implementation Details(데이터·자원·rollout) → A.5 RL Evaluation Protocol(공유 평가·대응 통계·벤치마크별 조건) |
핵심 기여와 혁신성
분석 과제의 정답이 단일 숫자가 아니라 설명과 통찰일 때, 평가자는 계산의 정확성과 결론의 타당성을 함께 판단해야 합니다. 원본 데이터의 생성 과정을 알 수 없다면 전문가나 강한 모델이 먼저 발견한 사실이 평가 기준의 범위를 결정하기 쉽습니다. 논문은 배달 매출 감소에서 할인 종료를 발견했지만 식당 영업시간 감소를 놓치는 예로 이 문제를 설명합니다. 나중에 에이전트가 두 번째 요인을 타당하게 찾아도 기준에 없으면 점수를 받지 못할 수 있습니다. 이는 답안의 오류와 평가 기준의 누락을 구별해야 하는 이유입니다. §1
독창성은 DAG, 즉 순환이 없는 방향 그래프로 의존 관계를 정하고, 계약 → 정본 상태 → 불완전한 관측 → 독립 감사 → 질문과 rubric을 연결한 데 있습니다. Rubric은 계산이나 해석을 항목별로 채점하는 평가 기준입니다. 질문 작성자는 숨겨진 생성 기록을 볼 수 있지만, 문제 해결자는 질문과 관측 파일만 받습니다. 따라서 감독자는 목표를 알면서도 학습자는 파일 통합과 탐색을 실제로 수행해야 합니다. 이 비대칭을 유지하는 것이 단순한 정답 공개와 다른 핵심 설계입니다. §3
저자들은 이 엔진에서 평가용과 학습용 세계를 분리하고, 계산과 통찰에 별도 기준을 둡니다. 열 개 모델 모두 계산 점수가 통찰 점수보다 높았으며 그 차이는 4.87~21.35점입니다. 또한 Qwen3.6-35B-A3B를 정답 시연 없이 RL-zero 방식으로 훈련해, 미관측 세계와 외부 업무 과제에서 개선을 보고합니다. 이는 합성 환경의 학습 가치를 보여 주는 결과입니다. 리뷰어 해석으로는, 새 모델 구조의 제안보다 평가 가능성을 데이터 생성 과정 안에 설계하는 방법이 이 논문의 주요 학습 가치입니다. 합성 데이터가 실제 데이터를 대체하거나 특정 구성 요소가 단독으로 개선을 일으킨다는 증거로 확장해서는 안 됩니다. §4, Limitations
기술적 세부사항
방법을 이해하려면 다음 네 대상을 구분해야 합니다. 의존 뼈대는 무엇이 무엇에 영향을 주도록 생성할지 정하고, 정본 상태는 그 명세대로 만들어진 세계의 기준 상태이며, 관측 환경은 여러 업무 시스템을 거쳐 보이는 파일입니다. 재계산 가능한 현상은 그 관측 환경에서 분석가가 복원할 수 있어야 하는 지정된 관계나 수치적 발견입니다. 정본에만 존재하고 파일에서 복원할 수 없는 사실은 평가 목표로 정당화되지 않습니다.
| 구성 | 표현 | 역할과 접근 권한 |
|---|---|---|
| 의존 그래프 | $\mathcal G=(V,E)$ | 노드는 변수 묶음, 간선은 생성 방향과 함수 형태·지연·상호작용 등의 설명입니다. |
| 세계 계약 | $\mathcal C$ | 개체·시간축·생성 메커니즘·전역 불변조건·관측 시스템·산출물을 생성 전에 고정합니다. |
| 정본 상태 | $\mathcal X$ | 계층별 결정적 스크립트가 생성하며 하위 계층은 상위 상태를 읽기만 합니다. |
| 관측 환경 | $\mathcal E=O(\mathcal X)$ | 식별자 불일치·누락·지연·중복·단위 변화 등을 거친 분석가용 파일입니다. |
| 검증할 현상 | $\mathcal I$ | 관측 파일에서 다시 유도할 수 있는 지정된 분석 목표입니다. |
환경 생성 에이전트들은 대화 문맥을 공유하지 않고 디스크 산출물로 통신합니다. 따라서 생성 의도가 대화 속 암묵적 설명에만 남지 않도록, 각 단계에 기계 판독용 ledger와 서술 보고서를 남깁니다. Ledger는 검증 기록부이며, 감사자는 생성 스크립트와 정본·관측 파일까지 사용해 관계와 목표의 복원 가능성을 별도 코드로 재확인합니다. 감사자는 실패한 환경을 고칠 수 없고 판정만 내립니다. §3.1–3.2
학습 측면에서는 GSPO(Group Sequence Policy Optimization)를 사용합니다. 같은 질문에 대한 여덟 응답을 생성하고, rubric 점수의 집단 내 상대값으로 어느 응답의 확률을 높일지 정합니다. 학습 보상 판정에는 비용 절감을 위해 기반 Qwen3.6-35B-A3B 자체를 사용하고, 시험의 DataWorld-Bench와 DAComp 판정에는 Gemini-3.8-Flash를 사용합니다. 환경 생성 모델 GLM 5.3, 학습 보상 판정 모델, 시험 판정 모델, 평가 대상 모델을 서로 혼동하지 않아야 합니다. 수식 (1)~(5)와 MDE 식은 아래 원문 위치에서 항별로 설명합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 파일 분석 능력의 확장을 왜 환경과 감독 신호의 공동 공급 문제로 봐야 하는지 설명합니다. 코드 실행으로 표를 처리할 수 있다는 것과, 여러 출처의 수치를 연결해 지지되는 설명을 작성할 수 있다는 것은 다른 요구입니다. 실제 업무에서는 결과 변화의 원인이나 파급 결과를 묻기 때문에, 단순 계산 성공 여부만으로는 분석 품질을 충분히 평가하기 어렵습니다.
저자는 먼저 두 병목을 제시합니다. 첫째는 다양성과 접근성입니다. 실제 업무 데이터와 주석을 수집하는 데 비용이 들고 개인정보·지식재산 제약으로 재사용이 어렵습니다. 둘째는 검증 가능성입니다. 실제 파일이 만들어진 과정은 보통 관측되지 않으므로, 열린 분석 질문의 기준 답안은 전문가가 큐레이션한 참조나 근사 일치 판정에 의존합니다. 자료 탐색으로 기준을 만드는 방식에서는 탐색자가 못 찾은 타당한 설명이 누락될 수 있습니다.
배달 데이터의 매출 감소 예시는 이 누락을 구체화합니다. 프로모션 만료와 영업시간 감소가 모두 자료로 뒷받침될 수 있지만, 기준 작성자가 한 요인만 발견하면 다른 설명은 점수를 얻지 못합니다. 복잡한 자료와 충분히 통제되지 않은 교란요인 때문에 전문가 열 명이 서로 다른 설명을 낼 수도 있다는 것이 저자의 문제 설정입니다. 여기서 논문이 주장하는 것은 특정 실제 배달 데이터에서 그 문제가 실증되었다는 사실이 아니라, 기준 구성의 의존성을 보여 주는 설명 사례입니다.
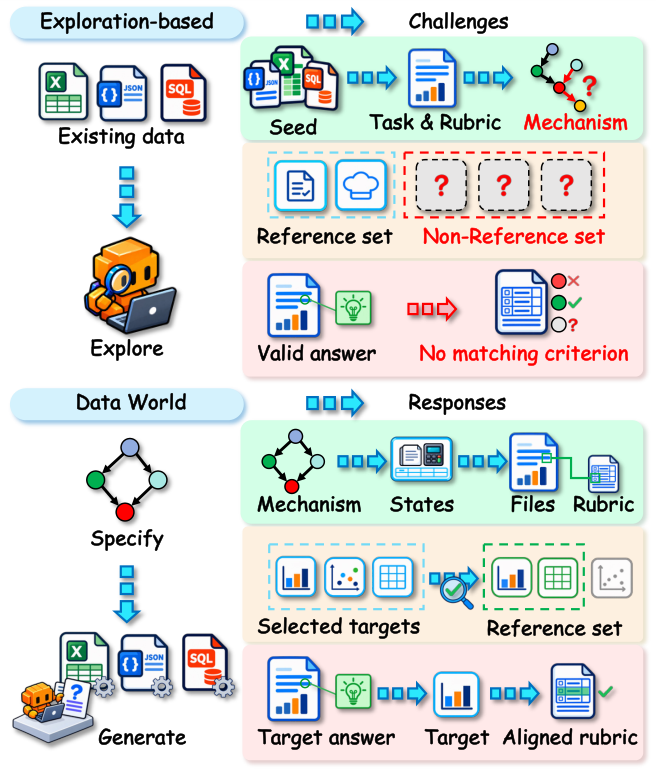
Figure 1, PDF 1쪽. 2610.21656v1 원문에서 그림 영역만 비례 크롭했습니다. 원문 영문을 유지했으며 번역·수치 변경은 없습니다. 위는 기존 파일의 탐색 범위가 평가 기준을 제한하는 경우, 아래는 명세한 목표와 기준을 정렬하는 경우입니다.
제안의 출발점은 파일의 배후 세계를 먼저 정하는 것입니다. 코드로 통계적·관계적 구조를 구현하면 사적 원천 기록 없이 환경을 만들면서도 선택한 목표를 생성 상태에 연결할 수 있습니다. 새 환경과 과제별 답안을 생성하는 것은 공개 데이터 재사용에 따른 사전학습 오염 위험도 줄인다고 저자들은 설명합니다. 다만 관측 파일에 불완전성을 주면서 목표가 여전히 복원되고, 문제가 사소한 정답 읽기가 되지 않도록 해야 하는 과제가 남습니다.
장 끝의 세 기여는 메커니즘 기반 합성과 감사, DataWorld-Bench 및 세계 분리 학습 세트, 강한 모델의 해결 궤적 증류 없이 수행한 RL-zero의 효용입니다. 이 장의 역할은 실제 업무 데이터의 대체를 선언하는 데 있지 않고, 기존 원천 기반 평가를 보완할 생성 방식을 정당화하는 데 있습니다. 다음 장은 이 위치를 기존 데이터 에이전트·합성 환경 연구와 비교합니다. §1
📖 Chapter 2: Related Work
이 장은 세 갈래 관련 연구를 원문의 순서대로 검토합니다. Data analysis agents and benchmarks에서는 Kaggle·과학 자료·정부 공개 자료·기업 공개 기록처럼 기존 출처를 사용하는 환경을 먼저 다룹니다. 과제의 형태는 데이터베이스 대상 text-to-SQL, 파일을 코드로 분석하는 작업, 정부·기업의 여러 표와 스프레드시트를 연결하는 업무까지 이어집니다. Data World에 가장 가까운 것은 DiscoveryBench·BLADE의 과학적 발견, InsightBench·InsightEval의 비즈니스 통찰처럼 열린 발견을 평가하는 연구입니다. 이들은 주어진 자료와 전문가 주석 또는 모델 탐색으로 기준 통찰을 마련합니다. Data World는 이 출처 기반 평가에 메커니즘 근거와 복원 가능성 감사를 추가하는 보완적 접근으로 소개됩니다.
Task synthesis and rubric-based rewards에서는 실제 데이터를 유지하고 환경을 탐색해 과제를 만드는 흐름을 설명합니다. 실행 가능하고 검증할 수 있는 문제를 에이전트가 제안하거나, 주어진 데이터에서 통찰을 채굴해 평가 묶음을 만들 수 있습니다. 그러나 생성 과정을 모르면 열린 과제의 난도와 감독 신호의 신뢰성을 함께 확장하기 위해 큐레이션이나 평가 장치가 추가로 필요합니다. LLM 판정자가 rubric을 보상으로 바꾸는 강화학습은 별도 관련 흐름입니다.
Data World에서도 판정자는 여전히 자연어 응답을 해석합니다. 차이는 rubric 작성 시 생성 기록과 독립 감사 결과를 사용할 수 있어, 지정한 기준을 정본과 관측 파일에 대조할 수 있다는 점입니다. 저자는 이 설계가 탐색자의 통찰 발견 능력에 대한 의존을 줄일 뿐, 메커니즘 설계·기준 선택·판정의 편향을 없애지는 않는다고 명시합니다. 따라서 근거를 알고 있다는 장점과 자연어 채점의 오차 가능성을 동시에 유지하는 서술입니다.
Synthetic environments and data는 에이전트 후학습의 환경 병목에서 출발합니다. WebArena·τ-bench 같은 수작업 환경에 이어, 플랫폼명이나 도메인 키워드에서 모의 도구·데이터베이스·과제를 생성하는 Agent World Model·ScaleEnv, 궤적과 기존 과제를 활용하는 EnvScaler·ASTRA, 웹의 MCP 인터페이스를 조립하는 EnvFactory·Agent-World를 비교합니다. 이때 Data World의 대상은 모의 도구 API가 아니라 상호의존 파일을 터미널로 분석하는 환경입니다.
마지막으로 기존 데이터베이스를 학습하는 GReaT·SDV·REaLTabFormer, 명시적 메커니즘으로 기록을 모사하는 Synthea, 인과 발견용 합성 벤치마크를 구분합니다. Data World의 초점은 불완전한 여러 파일에 흩어진 분석 목표가 복원되는지에 있습니다. 이 비교는 새 합성 데이터 모델 자체의 우월성보다 생성·관측·감사의 조합이 어디에 놓이는지를 설명하며, 다음 방법 장의 설계 선택으로 이어집니다. 이 리뷰는 인용 논문 전체를 별도로 읽은 비교가 아니라 해당 관련 연구 절의 논지를 분석합니다. §2
📖 Chapter 3: Method
이 장은 세계 정의부터 과제 선정까지 감독 신호의 근거가 만들어지는 순서를 제시합니다. 핵심은 분석가가 볼 파일과 감독자가 볼 생성 기록을 분리한 채, 두 층 사이의 일관성을 검증하는 것입니다.
3.1 Formalization and Overview
원문은 합성 세계를 $\mathcal W=(\mathcal G,\mathcal X,\mathcal E,\mathcal I)$로 정의합니다. $\mathcal G=(V,E)$의 노드 $v\in V$는 변수 묶음이고 간선 $(u,v)\in E$는 단조·임계값·포화·지연·상호작용처럼 방향을 가진 생성 관계입니다. $\mathrm{note}(u,v)$는 그 관계의 설명입니다. 간선 방향은 생성 순서와 모델링한 영향을 뜻합니다. 따라서 이 방향을 실제 관측 자료에서의 인과 식별이 자동으로 보장된다는 뜻으로 읽어서는 안 됩니다.
$\mathcal X$는 분석할 현상을 지배하는 정본 상태이고, $\mathcal E$는 분석가에게 제공하는 표·내보내기 파일·로그의 디렉터리입니다. 관측 사상 $O$가 정본을 파일로 바꿉니다. $\mathcal I$는 파일로부터 다시 유도하고 확인할 수 있는 관계나 수치적 발견의 집합입니다. 원문의 파이프라인은 다음과 같습니다.
식 (1)의 $\mathcal C$는 세계 계약이며 $\mathcal T$는 세계와 감사 기록에서 생성한 과제·rubric 쌍의 모음입니다. 이 식은 데이터와 정답을 동시에 자유롭게 쓰는 과정이 아니라, 명세와 파일 생성 이후에 감사를 거쳐 문제를 만드는 의존 순서를 나타냅니다. 시험 세계는 모든 감사 검사를 통과해야 하고, 학습 세계에는 그보다 완화된 필터를 사용합니다.
각 생성 단계는 독립 에이전트 세션을 사용하고, 정본 생성에서는 DAG 계층마다 세션 하나를 둡니다. 세션끼리 대화 상태를 공유하지 않으며 디스크 파일로만 결과를 전달합니다. 각 단계는 기계가 확인할 ledger와 후속 단계가 설계 의도를 이해할 서술 보고서를 함께 남깁니다. 이 설계가 실제로 무엇을 연결하는지 Figure 2가 보여 줍니다. §3.1, 식 (1)
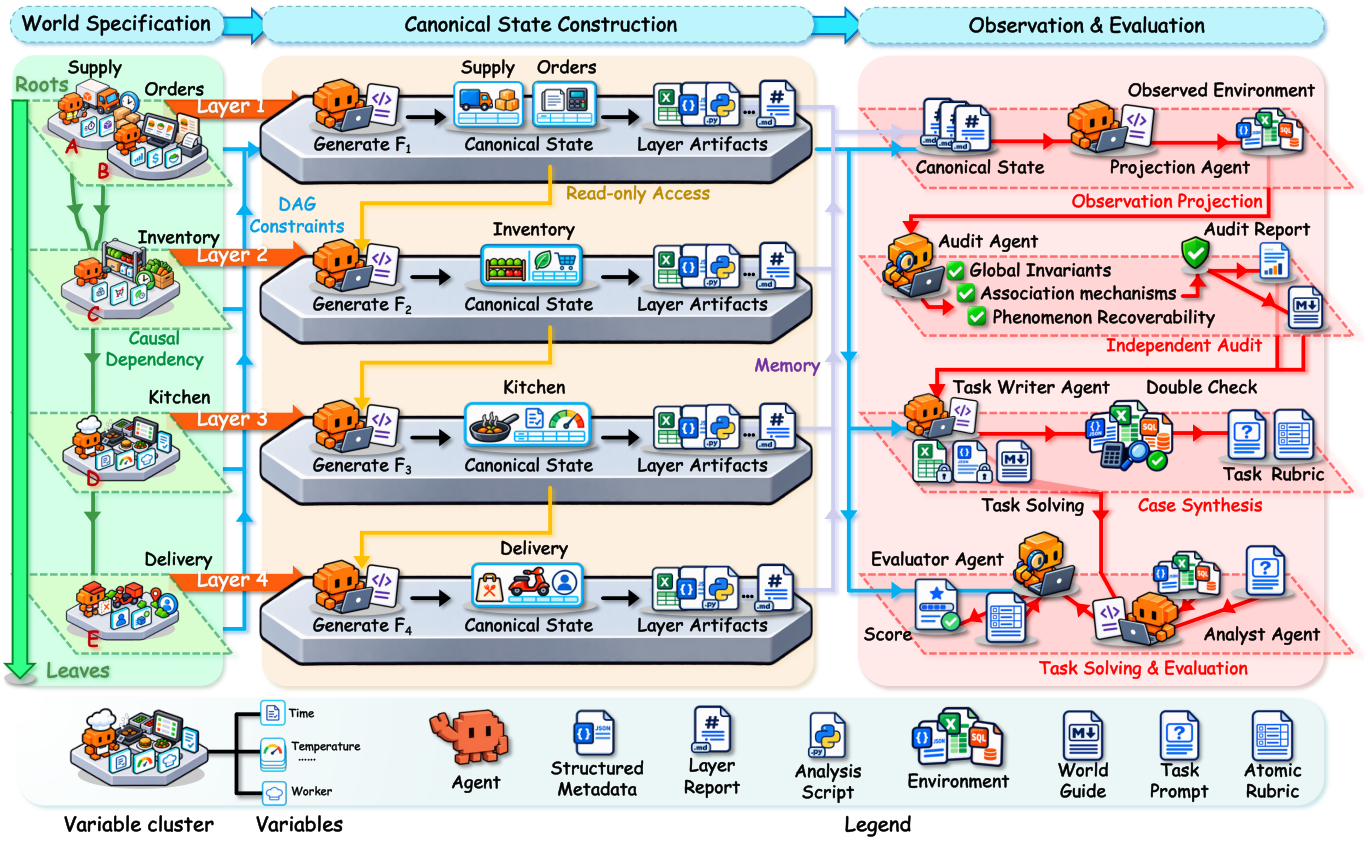
Figure 2 전체, PDF 4쪽. 2610.21656v1에서 그림과 범례 영역을 비율 유지 크롭했습니다. 번역이나 재배열은 없습니다. 아래 상세 그림은 원그림의 해당 부분을 그대로 분리한 것입니다.
3.2 Environment Synthesis
Dependency Skeleton. PersonaHub의 인물상(persona)을 프롬프트에 넣어 그 맥락에 맞는 합성 DAG를 작성하게 합니다. 인물상은 어떤 업무 세계를 만들지 다양화하는 출발점이고, 그래프는 이후 생성의 의존 뼈대가 됩니다. 여기서 원문은 사적 원천 데이터에 맞춰 분포를 학습하는 절차를 제시하지 않습니다.
World Contract. 계약 작성 에이전트는 DAG를 구조화된 전역 명세로 구체화합니다. 계약은 개체와 시간축, 간선별 함수 형태·이질성·시간적 성질·교란요인, 식별자·단위·공유 사건 같은 불변조건, 불완전한 관측 업무 시스템, 최종 데이터와 재계산 현상을 선언합니다. 이 계약을 데이터 생성 전에 고정해 후속 단계가 같은 세계를 만들도록 제약합니다. 예를 들어 상위와 하위 파일이 동일 사건을 서로 다른 단위나 식별자로 설명할 때도 정본 수준의 일관성은 유지해야 합니다.
Canonical Truth Generation. 그래프의 출발 노드에서 가장 긴 경로의 깊이를 $d(v)$라 하고 출발 깊이를 0으로 둡니다. 계층은 $V_\ell=\{v:d(v)=\ell-1\}$로 나누며, $V=\bigsqcup_{\ell=1}^{L}V_\ell$입니다. 모든 노드는 자신의 부모보다 뒤 계층에 배치됩니다. 각 세션의 생성은 다음 식으로 표현됩니다.
식 (2)의 $\mathcal X_{V_\ell}$는 현재 계층의 정본 상태, $\mathrm{pa}(V_\ell)$는 그 계층 노드들의 상위 부모, $F_\ell$은 현재 세션이 작성·실행하는 결정적 스크립트이며 $\mathrm{seed}_\ell$은 고정 난수 시드입니다. 이전 계층의 상태는 읽기 전용입니다. 하위 결과가 마음에 들지 않는다고 상위 파일을 고치면 원래의 생성 근거가 바뀌므로, 이 불변성이 감사의 기반이 됩니다.
두 안전장치가 이어집니다. 트랜잭션성은 한 계층의 모든 노드를 함께 생성하고 원자적으로 확정해 미완성 중간 상태가 전달되지 않게 합니다. 의존 검사는 들어오는 모든 간선마다 명세의 연관 패턴·함수 형태·시차·이질성이 생성 자료에서 성립하는지 경험적으로 확인하고 ledger에 남깁니다. 계층을 나누는 것은 모델 문맥 길이를 관리하는 것뿐 아니라, 생성 순서와 검증 단위를 일치시키는 방법으로 이해할 수 있습니다. 이 마지막 설명은 리뷰어의 설계 해석입니다.
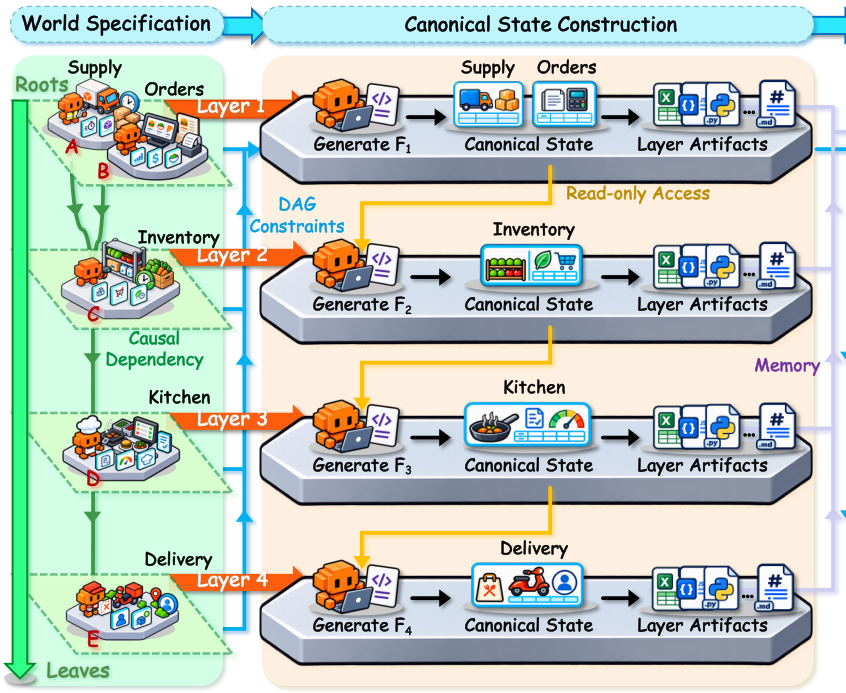
Figure 2 왼쪽·중앙 상세, PDF 4쪽. 같은 v1 PDF의 정본 생성 패널을 비례 크롭했으며 번역·재배열하지 않았습니다. 전체 그림의 범례와 함께 읽으시면 됩니다.
Observation Projection. 별도 세션이 $O$를 적용해 분석가용 파일을 만듭니다. 관측 불완전성은 근거 없는 잡음의 추가가 아니라, 어떤 시스템·단계에서 왜 생겼는지 명시된 관측 메커니즘입니다. 동일 개체의 식별자 표기와 키가 시스템마다 다를 수 있고, 결측·지연·중복·단위 변화·범주 인코딩·스키마 변화가 들어갑니다. 파일은 이름이 붙지 않은 외래키로 연결되며 데이터 사전은 제공되지 않습니다. 정본은 보존되지만 통찰을 얻으려면 시스템 사이의 대응을 복원해야 합니다.
이 설계는 생성 관계를 알고 있는 감독자와 파일 정합을 수행하는 분석가를 분리합니다. 중요한 합격 조건은 $\mathcal I$의 현상이 숨겨진 정본에만 남지 않고, 관측 환경에서도 복원 가능하다는 것입니다. 파일을 어렵게 만드는 것과 목표를 보이지 않게 만드는 것은 구별됩니다.
Independent Audit. 감사자는 뼈대·계약·ledger·보고서·생성 스크립트·정본·관측 환경을 읽고 자신의 스크립트를 작성합니다. 지정된 간선 관계, 전역 불변조건, 현상을 다시 검사하며 세계 내부 분석가의 관점에서 world guide를 작성합니다. 감사자는 정본이나 파일을 수정할 수 없고 합격·불합격만 보고할 수 있습니다. 실패 기대조건은 그대로 기록해야 합니다. 이는 생성자의 자기평가를 그대로 다음 단계로 전달하지 않기 위한 역할 분리입니다. §3.2, 식 (2)
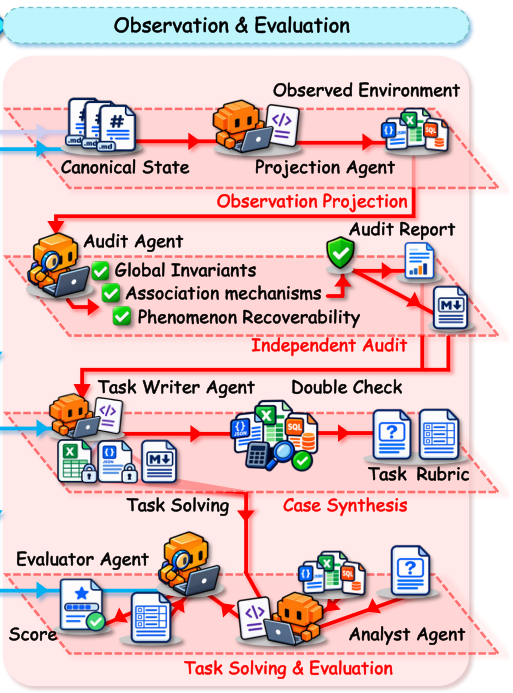
Figure 2 오른쪽 상세, PDF 4쪽. 같은 v1 PDF의 관측·평가 패널을 비례 크롭했습니다. 원문 표기·화살표를 유지했으며 번역하지 않았습니다.
3.3 Task Synthesis
문제는 감사된 생성 과정에서 만듭니다. 하나의 목표 노드에 대해 cause 경로는 들어오는 간선을 따라 변동의 상위 요인을 설명하게 하고, consequence 경로는 나가는 간선을 따라 하위 결과로의 영향을 추적하게 합니다. 두 명칭은 생성 그래프에서의 질문 방향입니다. 예컨대 접촉 건수의 요인을 설명하거나, 생산 손실이 재고를 거쳐 가용성에 이어지는지 조사합니다.
그래프 전체의 구조를 고르게 다루기 위해 깊이를 $K$개 층으로 나눕니다. 최대 깊이를 $d_{\max}$라 하면 $S_k=\{v:\lfloor d(v)K/(d_{\max}+1)\rfloor=k-1\}$입니다. 각 층에서 목표를 다음과 같이 결정적으로 고릅니다.
식 (3)의 $\deg^{-}$는 유입 차수, $\deg^{+}$는 유출 차수입니다. 한 층에서 상위 연결이 많은 노드와 하위 연결이 많은 노드를 각각 골라, 세계당 최대 $2K$개의 구조적으로 다양한 과제를 만듭니다. 이는 의미적으로 모든 질문을 균등 표집한다는 뜻이 아니라, 깊이와 연결도를 이용한 표적 선택입니다.
질문 작성자는 계약·코드·기록·정본·WORLD.md를 읽기 전용으로 받고, 목표가 관측 파일에서 도출되는지 확인한 다음 과제와 기준을 씁니다. 기준은 data computation과 insight discovery로 나뉩니다. 앞부분은 처리 및 수치 추정, 뒷부분은 추정으로 지지되는 결론을 평가합니다. 두 영역 모두 원자적 양의 항목과 음의 항목을 가집니다. 양의 항목은 맞는 계산·해석에 점수를 주고, 음의 항목은 명백히 틀린 계산이나 자료와 모순되는 결론에 감점합니다.
참조에 없는 타당한 통찰은 발생할 수 있습니다. 원문 규칙은 목록 밖이라는 이유만으로는 가점도 감점도 하지 않는 것입니다. 따라서 이 설계는 rubric 밖의 옳은 발견까지 완전히 평가하는 해결책은 아닙니다. 평가자는 감사된 정본을 보고 보고서를 항목별로 채점하며, 순 rubric 점수를 $[0,1]$로 정규화합니다. 원문은 이 절에서 정규화의 더 세부적인 대수식을 제공하지 않으므로 임의의 합산 공식을 덧붙이지 않습니다. §3.3, 식 (3)
3.4 Benchmark and Training-Set Curation
1,302개 후보 세계 중 1,087개를 유지합니다. 학습은 1,037개 세계·2,135개 과제이고, 시험은 학습에서 완전히 제외한 50개 세계·100개 과제로 16개 도메인을 포함합니다. 시험 세계는 모든 감사 검사를 통과해야 하며, 학습 세계의 DAG 간선 검사 통과율은 95.98%입니다. 이 수치는 학습 세계 전체의 합격 비율이나 최종 답안 정확도가 아니라 간선 검사의 비율입니다.
각 시험 세계에서 cause와 consequence 과제 하나씩 후보로 내고, 15명 주석자가 같은 세계·같은 경로의 다른 후보와 질문의 현실성을 비교합니다. 의견 차이는 조정해 최종 선택합니다. 인간의 역할은 질문의 현실성 비교이며 생성 세계의 실제 업무 유효성까지 입증하는 절차는 아닙니다. 시험은 도메인을 대체로 균등하게 다루지만 학습 분포는 고르지 않습니다. 이 구분은 다음 실험의 총점과 도메인별 결과를 읽는 전제가 됩니다. §3.4
이 장의 핵심 기여는 단순히 많은 파일을 생성하는 것이 아니라, 생성 관계·관측 불완전성·복원 가능성·rubric을 연결한 감독 신호의 경로입니다. 다음 장은 그 신호가 기존 모델의 능력을 구분하고 새 모델의 학습에 도움이 되는지 평가합니다.
📖 Chapter 4: Experiments
이 장은 두 질문에 답합니다. 합성 파일과 rubric이 기존 데이터 에이전트의 계산·통찰 능력을 의미 있게 구분하는지, 그리고 별도의 합성 세계로 학습했을 때 보지 못한 세계와 외부 과제에서도 성능이 좋아지는지입니다. 생성 품질을 그럴듯함만으로 주장하지 않고 평가와 학습 효용으로 연결하려는 장입니다.
4.1 Experimental Setup
구축의 모든 단계는 Claude Code harness 안의 GLM 5.3을 사용합니다. Harness는 모델에 도구·실행 반복 구조를 제공하는 실행 틀입니다. Table 1의 열 개 모델에는 모두 mini-swe-agent를 사용합니다. 이 harness는 bash를 유일한 도구로 제공하고, 추론·명령 실행·출력 피드백을 번갈아 받는 ReAct 방식으로 작동합니다. 본문의 표 1과 표 3은 보관된 보고서를 Gemini-3.8-Flash가 같은 DataWorld rubric으로 한 번 판정합니다.
별도 언급이 없으면 점수는 100배 표시이며 높을수록 좋습니다. DataWorld-Bench는 $[0,1]$로 정규화된 rubric 점수입니다. 외부 평가는 각자의 본래 채점 방식을 유지하므로 서로 다른 벤치마크의 10점 상승을 같은 종류의 개선으로 해석할 수 없습니다. 평가 모델의 소개는 부록 A.2, 학습과 평가의 분리는 A.4–A.5에 제시됩니다. §4.1
4.2 DataWorld-Bench Results
다음은 Table 1의 점수 부분을 옮긴 표입니다. 괄호는 과제별 점수의 표준편차(SD)이며 신뢰구간이 아닙니다. Avg는 전체 rubric 항목을 모아 계산하므로 계산 열과 통찰 열의 단순 산술평균일 필요가 없습니다.
| 모델 | 계산 | 통찰 발견 | Avg |
|---|---|---|---|
| GPT-6-Astra | 87.80 (16.38) | 66.45 (20.98) | 74.43 (15.85) |
| Qwen-3.8-Max-0902 | 82.36 (17.79) | 67.95 (22.92) | 73.43 (16.81) |
| GPT-6.1-Sol | 85.59 (17.26) | 66.02 (21.02) | 73.30 (16.44) |
| GLM 5.3 | 75.08 (21.22) | 63.18 (21.56) | 67.69 (17.67) |
| HY4-Preview | 77.27 (20.63) | 60.00 (21.38) | 66.55 (17.72) |
| Kimi-K3 | 72.64 (22.83) | 62.89 (23.43) | 66.39 (19.14) |
| DeepSeek-V4.1-Flash | 72.30 (19.72) | 57.34 (20.29) | 62.95 (16.93) |
| Qwen-3.8-27B | 66.93 (25.33) | 54.93 (22.46) | 59.64 (20.16) |
| Gemini-3.8-Flash | 59.00 (21.70) | 54.13 (21.18) | 56.17 (17.01) |
| MiniMax-M3 | 53.39 (20.44) | 47.39 (19.85) | 49.75 (16.89) |
Table 1 점수 열, PDF 7쪽의 v1 원문과 대조한 Markdown 전사입니다. 점수는 정규화 값×100입니다.
GPT-6-Astra가 종합·계산에서 가장 높고, Qwen-3.8-Max-0902가 통찰 발견에서 가장 높습니다. GPT-6.1-Sol은 계산 2위·종합 3위입니다. 모든 모델에 4.87~21.35점의 계산–통찰 차이가 존재한다는 것은 자료 처리의 성공이 지정된 설명의 발견으로 바로 이어지지 않는다는 결과입니다. 다만 저자도 이 비교가 rubric으로 정의한 능력에 관한 것이며 기준의 포함 범위와 채점 차이가 격차에 기여할 수 있다고 한정합니다. 순위의 통계적 유의성을 검정한 결과는 이 표에 보고되지 않았습니다.
같은 표의 상호작용 비용도 분리해 읽어야 합니다. Rounds는 모델 호출 횟수, Total tokens는 최종 호출의 프롬프트와 출력 토큰, Resp. tokens는 실행 전체의 출력 토큰 합계입니다. Total을 전체 실행에서 누적 입력·출력한 토큰으로 읽으면 원문의 정의와 달라집니다. 다음 값은 평균(SD)이며 k는 천 토큰입니다.
| 모델 | Rounds | Total tokens(k) | Resp. tokens(k) |
|---|---|---|---|
| GPT-6-Astra | 28.7 (8.7) | 121.9 (36.4) | 88.8 (18.9) |
| Qwen-3.8-Max-0902 | 82.7 (23.5) | 289.7 (81.9) | 125.8 (33.0) |
| GPT-6.1-Sol | 31.2 (10.6) | 135.2 (46.3) | 103.4 (30.4) |
| GLM 5.3 | 89.9 (28.0) | 238.7 (96.6) | 116.3 (49.4) |
| HY4-Preview | 70.7 (21.3) | 177.9 (49.2) | 86.0 (23.3) |
| Kimi-K3 | 36.4 (14.4) | 97.5 (35.1) | 48.0 (16.8) |
| DeepSeek-V4.1-Flash | 58.1 (20.2) | 150.7 (48.0) | 74.0 (24.3) |
| Qwen-3.8-27B | 55.1 (18.5) | 170.4 (39.7) | 82.1 (20.7) |
| Gemini-3.8-Flash | 62.3 (15.6) | 98.8 (20.9) | 50.8 (10.3) |
| MiniMax-M3 | 93.8 (32.1) | 158.4 (47.2) | 62.6 (19.4) |
Table 1 상호작용 열의 원문 대조 전사입니다.
가장 높은 종합 점수를 낸 GPT-6-Astra는 호출 횟수도 가장 적고, Kimi-K3는 두 토큰 지표가 가장 작습니다. Qwen-3.8-Max-0902는 가장 높은 통찰 점수와 가장 많은 토큰 사용을 함께 보입니다. MiniMax-M3는 호출이 가장 많지만 종합 점수는 가장 낮습니다. 따라서 모델 사이의 이 비교만으로 추가 추론량의 인과적 이득을 분리할 수 없으며, 긴 상호작용만으로 좋은 분석이 보장되지 않는다는 것이 저자의 해석입니다.
Table 2는 틀린 계산이나 모순되는 결론에 대한 음의 rubric이 실행 궤적에서 몇 개 발동했는지 보여 줍니다. 각 열의 분모는 해당 모델의 궤적이고, 정확히 0·1·2개 발동한 비율입니다. 3개 이상 열이 생략되어 있으므로 행 합이 100%가 아닐 수 있습니다.
| 모델 | 음의 항목 0개(%) | 1개(%) | 2개(%) |
|---|---|---|---|
| GPT-6.1-Sol | 86 | 11 | 2 |
| GPT-6-Astra | 83 | 14 | 2 |
| HY4-Preview | 74 | 20 | 5 |
| Kimi-K3 | 70 | 20 | 9 |
| Qwen-3.8-Max-0902 | 68 | 26 | 5 |
| GLM 5.3 | 65 | 23 | 9 |
| DeepSeek-V4.1-Flash | 64 | 30 | 6 |
| Qwen-3.8-27B | 64 | 27 | 9 |
| MiniMax-M3 | 59 | 28 | 10 |
| Gemini-3.8-Flash | 57 | 34 | 8 |
Table 2, PDF 7쪽의 원문과 대조했습니다.
GPT 두 모델은 Qwen-3.8-Max-0902보다 음의 항목이 없는 궤적 비율이 높지만 통찰 점수는 낮습니다. 즉 오류를 피하는 능력과 목표 발견을 회수하는 능력은 별도 축입니다. 이 결과를 모든 환각의 발생률로 부르면 안 됩니다. 측정 대상은 이 rubric의 명백한 오류 항목입니다. 장의 마지막은 도메인별 난도와 cause–consequence 비교로 이어지며, 세부 조건은 부록 A.3에 제시됩니다. §4.2, Tables 1–2
4.3 Validating Training Utility
먼저 학습 설계가 제시됩니다. 기반 모델은 Qwen3.6-35B-A3B이고, GSPO를 사용한 RL-zero 학습을 수행합니다. RL-zero는 이 연구에서 과제별 지도 미세조정(SFT) 단계를 두지 않고 모델 자신의 rollout, 즉 실행 궤적과 rubric 보상으로 최적화하는 설정입니다. 구축 모델은 환경·질문·기준을 제공하지만 정답 해결 시연은 제공하지 않습니다. 비용을 낮추기 위해 기반 모델 자체가 학습 보상을 판정합니다. 이는 시험에서 사용하는 Gemini 판정자와 다릅니다.
질문 $x$마다 $G$개 응답 $y_i$와 보상 $r_i$가 있습니다. 집단 평균 보상을 $\bar r$라 하면 장점 추정과 시퀀스 비율은 다음과 같습니다.
$\widehat A_i$는 같은 질문의 응답 집단에서 상대적으로 좋은 응답인지 나타내고, $\mathrm{std}$는 그 집단의 보상 표준편차입니다. $\rho_{i,t}$는 질문과 앞선 토큰 $y_{i,\lt t}$에 조건화한 현재 정책 $\pi_\theta$와 표집 정책 $\pi_{\rm old}$의 토큰 확률비입니다. $|y_i|$는 응답 길이이므로 $s_i$는 토큰별 비율의 기하평균에 해당하는 길이 정규화 시퀀스 비율입니다. 원문의 std 연산은 동일 의미의 직립 문자로 옮겼습니다.
식 (4)의 $\epsilon_{\rm low}$·$\epsilon_{\rm high}$는 비율의 아래·위 clipping 문턱입니다. $\mathrm{clip}$은 범위를 벗어난 비율을 경계에 제한하는 연산이며, $\min$은 과도한 정책 변화를 제한한 목적값을 선택합니다. 비율과 상대 장점은 응답 전체에 동일하게 적용됩니다. 식 자체는 학습 목표를 정의하며, 실제 집단 크기·clip 값·자원은 A.4의 설정입니다. §4.3, 식 (4)
Comparisons. 비교군은 같은 기반을 공유하는 세 모델입니다. DataMind-35B-A3B는 원래 모델의 기반과 문맥 길이가 이 평가에 맞지 않아, 공개 Python 데이터 분석 7,323개 과제를 동일 기반·동일 학습 설정으로 재훈련합니다. BigBang-v1과 Occamy-1.0은 공개 checkpoint를 평가하며 광범위한 다단계 학습을 거친 모델입니다. 세 비교군은 교사로부터 증류한 궤적을 사용합니다. 원문은 이 비교가 훈련 데이터나 레시피 각각의 효과를 고립하는 실험이 아니라 전체 학습 효용의 비교라고 명시합니다.
Results. Table 3의 점수를 평균(SD)로 옮기면 다음과 같습니다. 별도 열에 기재한 개선은 저자의 기반 대비 보고값입니다.
| 모델 | JobBench | DAComp | DABstep-Hard | DataWorld-Bench |
|---|---|---|---|---|
| Qwen3.6-35B-A3B | 18.31 (18.12) | 53.72 (20.35) | 25.66 (43.73) | 37.64 (11.62) |
| DataMind-35B-A3B | 22.93 (22.33) | 54.79 (20.49) | 31.22 (46.40) | 37.36 (11.14) |
| BigBang-v1 | 20.84 (20.69) | 54.31 (20.93) | 34.66 (47.65) | 40.05 (12.06) |
| Occamy-1.0 | 30.18 (23.79) | 64.86 (20.89) | 44.44 (49.76) | 42.38 (14.06) |
| DataWorld-35B-A3B | 30.43 (23.92) | 68.00 (18.90) | 46.56 (49.95) | 44.70 (13.94) |
| DataWorld의 기반 대비 개선(점) | +12.13 | +14.28 | +20.90 | +7.06 |
Table 3, PDF 8쪽의 원문 대조 전사입니다. 표시된 평균과 개선 배지는 각각 반올림되어 있어, 표시 평균끼리 뺀 값과 0.01점 차이가 날 수 있습니다. 예를 들어 JobBench의 인쇄 평균 차는 12.12이지만 저자 보고 개선은 12.13점입니다. 표의 개선을 임의로 고치지 않았습니다.
DataWorld는 이 비교 집합의 네 벤치마크에서 가장 높은 평균을 기록합니다. 외부의 열린 분석인 DAComp와 자동 정답 검사인 DABstep-Hard 모두에서 개선된 것은 단일 rubric 환경에만 점수가 좋아진 결과와 구별됩니다. JobBench는 35개 직업을 다루는 가장 덜 정렬된 평가로, 파일 기반 전문 업무로의 전이를 확인하는 역할입니다. 다만 전체 평균 향상이 모든 직업에서의 향상을 의미하지는 않습니다. DataMind는 외부 점수가 올라가면서도 DataWorld-Bench는 37.64에서 37.36으로 거의 변하지 않아, 기존 외부 평가의 개선과 메커니즘 기반 통찰 과제 개선이 자동으로 일치하지 않음을 보여 줍니다.
성능 향상에는 더 많은 상호작용이 동반됩니다. 다음은 Table 3에서 기반과 DataWorld의 비용을 평균(SD)로 대조한 것입니다.
| 평가 | 기반 Rounds → DataWorld | 기반 응답 토큰(k) → DataWorld |
|---|---|---|
| JobBench | 38.7 (17.4) → 63.6 (28.9) | 60.4 (22.1) → 88.1 (29.1) |
| DAComp | 35.6 (17.7) → 78.4 (25.0) | 41.8 (19.6) → 65.9 (21.7) |
| DABstep-Hard | 28.6 (18.0) → 43.2 (22.3) | 15.1 (15.3) → 36.3 (28.0) |
| DataWorld-Bench | 36.5 (13.9) → 102.8 (22.6) | 38.4 (19.2) → 68.4 (17.6) |
저자는 점수·호출·출력이 함께 늘어나는 양상을 더 긴 문맥에서 여러 차례 도구를 사용하는 추론이 강화된 것으로 해석하고 MiMo의 공개 학습 로그와 유사성을 언급합니다. 그러나 같은 계산 예산으로 성능을 비교한 결과는 아니므로, 리뷰어 관점에서는 개선과 비용 변화를 함께 제시하는 것이 적절합니다.
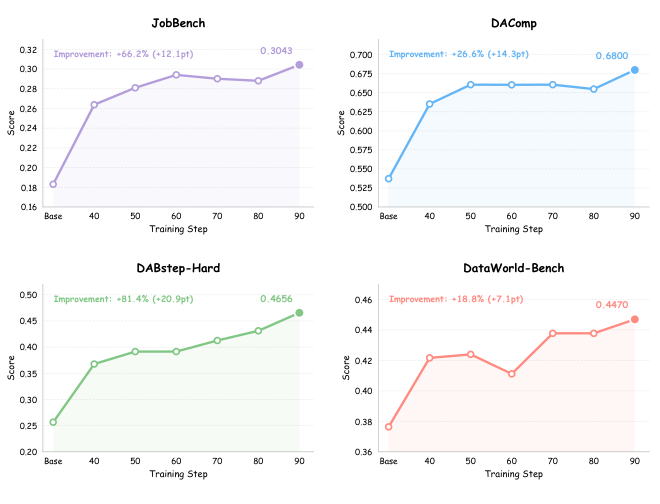
Figure 4, PDF 7쪽. v1 PDF에서 네 패널의 제목·축·주석을 포함해 비례 크롭했으며 번역·재구성하지 않았습니다. 세로축은 100배 표시 전 점수입니다. 수치의 가독성을 위해 최종값과 개선은 위 Table 3 전사에도 제시했습니다.
Figure 4는 Base와 학습 단계 40~90을 비교합니다. 최종 점수는 0.3043·0.6800·0.4656·0.4470이며, 그림 주석의 상대 개선은 순서대로 66.2%·26.6%·81.4%·18.8%입니다. 그래프는 전체적으로 향상하지만 모든 구간이 단조 증가는 아닙니다. 예를 들어 DataWorld-Bench는 중간에 하락한 후 다시 증가합니다. 이는 학습이 진행됨에 따른 궤적이지, 환경 개수만 바꾸고 다른 조건을 통제한 독립적인 데이터 규모 법칙 실험으로 제시된 것은 아닙니다.
General-capability retention and factuality. Table 4는 별도 일반 능력 확인입니다.
| 모델 | MMLU-Pro 정확도(%) | LiveCodeBench-Hard 정확도(%) | SimpleQA-Verified F1 |
|---|---|---|---|
| Qwen3.6-35B-A3B | 84.73 | 71.14 | 22.20 |
| DataWorld-35B-A3B | 84.73 | 70.29 | 24.00 |
Table 4, PDF 8쪽 원문 대조 전사입니다.
MMLU-Pro는 동일하고, 코딩 정확도는 0.85%p 감소하며, 사실 질의응답 F1은 1.80점 증가합니다. 저자들은 이를 일반 언어·코딩 능력을 보존하고 사실 지식을 눈에 띄게 교란하지 않았다는 근거로 해석합니다. 리뷰어 해석으로는 세 지표에서 관측된 변화의 범위까지만 말할 수 있습니다. 모든 일반 능력의 동등성이나 합성 세계 안에서의 환각 감소를 확립하는 결과는 아닙니다. 장의 기여는 세계 분리 평가와 외부 평가를 함께 둔 학습 효용의 확인이며, 결론 장은 이를 데이터 공급 전략으로 종합합니다. §4.3, Tables 3–4, Figure 4
📖 Chapter 5: Conclusion
결론은 Data World를 데이터 에이전트의 감독 신호를 확장하는 데이터 중심 경로로 정리합니다. 먼저 생성 메커니즘을 정하고 관측 파일을 만든 다음 분석 목표를 감사함으로써, 감독자는 알려진 메커니즘을 근거로 평가하고 해결자는 파일만으로 목표를 복원해야 합니다. 이 분리가 평가 기준의 근거와 분석 과제의 난도를 함께 유지한다는 주장입니다.
DataWorld-Bench는 계산–통찰 차이를 측정하고, 세계가 겹치지 않는 과제는 RL-zero 학습 신호를 제공합니다. 저자들은 미관측 세계·외부 데이터 분석·폭넓은 직업 업무에서의 개선이, 생성 자료의 목표를 큐레이터가 매번 다시 발견하지 않고도 감독 신호를 공급할 수 있다는 점을 뒷받침한다고 결론짓습니다. 핵심 표현은 실제 데이터에 대한 확장 가능한 보완재입니다. 이후에는 결론을 제한하는 명시적 한계와 윤리적 조건이 제시됩니다. §5
📖 Chapter Limitations: Limitations
저자가 명시한 첫 한계는 합성 요소가 밀접하게 연결되어 있고 세계·과제 재생성 비용도 커서 포괄적 ablation, 즉 요소를 바꾸거나 제거하는 절제 실험을 수행하기 어렵다는 점입니다. 통제된 여러 파이프라인 변형을 구축하지 않았으므로, 결과는 전체 프레임워크의 효용을 지지할 뿐 개별 요소의 기여를 분리하지 않습니다. 구성 요소의 추가·제거·미세조정보다 일관된 파이프라인 자체가 감사 가능성과 기준 포괄성을 지탱한다는 설명은 저자의 설계 입장이며, 각 대안이 열등하다는 독립 실험 결과로 볼 수는 없습니다. 실제 데이터와 합성 데이터 중 어느 쪽이 더 효과적인지 비교하지 않았다는 경계도 명시됩니다.
두 번째는 합성 질문과 실제 사용자 질문의 차이입니다. 인간 선호에 따라 현실적인 질문을 고르더라도 실제 요청 분포, 특히 모호함·암묵적 맥락·시간에 따라 변하는 목표를 대표한다는 사실은 확립되지 않습니다. 따라서 질문의 현실성 큐레이션과 실제 수요 분포에 대한 대표성은 다른 주장입니다.
세 번째는 rubric과 판정의 범위입니다. 생성 근거가 있는 기준도 모든 타당한 분석 발견을 포괄하지 못하며, LLM 채점에는 판정자 편향이 들어갈 수 있습니다. 감사된 정본은 명세한 기준의 확인 가능성을 높이지만 대안 통찰에 적절히 점수를 주거나 판정 모델을 바꾸어도 점수가 일관된다는 보장은 없습니다. 이 세 한계를 넘어서 원문에 없는 실패 원인이나 향후 연구 과제를 추가하지 않습니다. Limitations
📖 Chapter Ethical Considerations: Ethical Considerations
윤리 절은 먼저 동시기 합성 환경 연구가 빠르게 늘어나는 상황에서 지면과 저자 지식의 제약으로 가까운 연구 위주로 인용했음을 밝힙니다. 이어 환경·rubric이 에이전트로 만들어지고 LLM이 점수를 판정한다는 사실이 실제 의사결정 적합성을 입증하지는 않는다고 명시합니다. 감사는 지정 관계와 복원 가능성을 확인하고, 인간 큐레이션은 질문의 현실성을 평가할 뿐 운영상 유효성을 검증하지 않습니다.
합성은 사적 기록 의존을 줄이지만 공개 전 민감하거나 독점적인 내용이 포함되었는지 검토해야 한다고 저자는 적습니다. 중대한 결과를 낳는 도메인에서는 독립 검증과 인간 감독이 필요하다는 원문의 적용 조건도 있습니다. 마지막으로 코드와 원고 작성에 AI 도구가 사용되었고, 저자들이 생성 내용을 검토·편집·검증하여 정확성의 책임을 진다고 고지합니다. 이 절은 평가 점수를 현실의 안전성 인증과 구분하는 역할을 합니다. Ethical Considerations
📖 Chapter References: References
참고문헌은 데이터 에이전트 평가, 합성 환경, rubric 보상, GSPO, 기반 모델과 비교 모델, 외부 벤치마크·학습 인프라의 출처를 연결합니다. 특히 본문에 새로 실험한 DataWorld 점수와, A.2에서 다른 기술 보고서·모델 카드로 소개한 모델 특성은 서로 다른 증거입니다. 관련 연구의 원문을 모두 재분석한 서베이로 간주하지 않습니다. 이 리뷰의 수치 대조와 방법 분석의 1차 대상은 Data World v1 자체입니다. 참고문헌 뒤 부록은 정보 우위의 조건과 평가·학습 세부사항을 보충합니다. References
📖 Chapter A: Appendix
부록은 본문의 설계를 보완하는 다섯 부분으로 구성됩니다. 먼저 rubric 작성자가 생성 기록을 볼 때의 정보 우위를 제한된 가정 아래 설명하고, 평가 모델을 소개한 다음, 과제의 구성·실제 입력 예시·추가 분석을 보여 줍니다. 이후 학습 구현과 평가 프로토콜을 별도로 제시합니다. 아래도 A.1부터 A.5까지 이 순서를 유지합니다.
A.1 Intuitive Theoretical Analysis
고정된 질문과 관측 환경 $\mathcal E$에서 $S$는 파일로부터 복원할 수 있는 타당한 원자적 발견의 집합입니다. $R_{\rm obs}$는 파일만 본 작성자가 만든 양의 rubric 항목이 다루는 발견, $R_{\rm DW}$는 Data World 생성 기록까지 본 작성자가 다루는 발견입니다. 두 발견은 표현이 아니라 의미로 비교하고 음의 감점 항목은 이 논의에서 제외합니다. $|S\cap R|$는 타당한 발견 중 대응 평가 기준이 있는 것의 수입니다.
질문 작성자는 생성 전에 정한 메커니즘·목표와 이후 상태·감사 기록을 볼 수 있으므로, 지정한 현상을 파일에서 처음부터 재발견할 필요가 없습니다. 추가 정보는 후보 발견과 검증 근거를 공급합니다. 그러나 저자가 부등식을 도출하려면 다음 가정이 필요합니다. rubric 항목 수 예산이 같고, 이상적인 작성자가 파일만 보는 전략도 재현할 수 있으며, 불필요한 추가 정보는 무시하고 가용 전략 중 타당한 발견의 포괄성이 가장 큰 것을 고른다고 가정합니다.
식 (5)의 별표는 실제 LLM 출력이 아니라 이 가정 아래 최선의 전략을 고른 이상적 rubric입니다. 파일 전용 전략이 생성 기록 접근 전략 집합에도 포함되므로 그 최적값이 더 작아질 수 없다는 논리입니다. 같은 예산 안에서 추가 타당한 발견을 포함할 수 있을 때 엄격한 개선이 가능합니다.
숨겨진 상태에서만 알 수 있는 사실은 $S$에 속하지 않을 수 있으므로, 생성 기록의 후보도 반드시 관측 파일에서의 복원 가능성을 확인해야 합니다. 따라서 이 식은 실제 LLM rubric이 언제나 더 우수하다는 정리나 모든 발견을 포괄한다는 보장이 아닙니다. 본문 Figure 1의 직관을 정보 접근과 이상적 선택의 조건부 주장으로 좁혀 주는 것이 부록의 기여입니다. A.1, 식 (5)
A.2 Evaluated Models
이 절은 Table 1의 열 개 모델을 공통 mini-swe-agent에서 평가했다는 조건을 먼저 재확인하고 각 모델의 공개 보고서·카드에 기반한 소개를 제공합니다. 다음 설명은 Data World 저자가 인용해 소개한 특성이며, 이 리뷰에서 각 모델의 외부 자료를 별도로 검증하거나 그 소개 수치로 DataWorld 성능을 설명한 것은 아닙니다. 원문 모델 소개 순서를 유지합니다.
GPT-6-Astra는 복잡한 도구 업무를 위한 GPT-6 계열의 추론 모델로 소개됩니다. 원문은 강화학습 기반 추론 훈련, 에이전트 환경에서의 프롬프트 주입과 무권한 행동에 대한 견고성 개선을 시스템 카드의 설명으로 전달합니다. 이 소개는 Table 1의 계산 87.80·Avg 74.43과는 별도 출처의 주장입니다.
GPT-6.1-Sol은 속도와 비용 효율을 강조한 GPT-6.1 모델입니다. 저자는 Astra와 비슷한 능력을 더 높은 속도·경제성으로 제공하며 같은 유형의 데이터·훈련을 쓴다는 시스템 카드 부록의 설명을 요약합니다. 이 논문 안에서는 공통 harness에서 얻은 점수와 호출·토큰 지표로 비교합니다.
Qwen-3.8-Max-0902는 총 2.4T 매개변수, 토큰당 95B 활성 매개변수, 1M 토큰 문맥과 텍스트·이미지·비디오 입력을 가진 MoE로 기술됩니다. MoE는 여러 전문가 모듈 중 일부만 활성화하는 혼합 전문가 구조입니다. 0902는 2026년 9월 2일 공개된 코딩·에이전트 성능 개선 snapshot으로 소개되며, 기본 공개본의 Text/Vision Arena 순위와 코딩 에이전트 기반으로의 활용도 언급됩니다. 이 배경이 본 실험의 통찰 점수 1위와 인과적으로 연결된다는 분석은 제공되지 않습니다.
Kimi-K3는 2.8T 총 매개변수, 896개 전문가 중 상위 16개 선택, KDA attention, 1M 문맥과 기본 멀티모달 입력을 가진 공개 가중치 모델로 소개됩니다. 원문은 기술 보고서의 장기 코딩·에이전트·지식·추론 성과, 외부 Intelligence Index 3위와 GDPval-AA v2 Elo 1668을 배경으로 인용합니다. 본 평가에서는 가장 적은 두 토큰 지표가 별도로 관찰됩니다.
HY4-Preview는 770B 총·49B 활성 매개변수의 MoE로, 256개 경로 전문가와 공유 전문가 하나, 상위 8개 라우팅, 1M 문맥, Apache 2.0을 소개합니다. 원문은 장기 소프트웨어·문서 업무·과학 연구 개선과, 203개 공학 과제를 163명 전문가가 평가한 외부 결과를 인용합니다. 그 평가의 2.99/4.00 평균은 본 논문의 DataWorld 점수와 척도가 다릅니다.
GLM 5.3은 GLM-5.2의 기반을 공유하는 743B 모델의 개선된 후학습 모델로 기술됩니다. Z.ai 내부 코딩 평가의 50% 개선, 방어적 사이버보안과 장기 자율 공학 역량은 인용된 제공자 설명입니다. Data World에서는 이 모델이 세계 구축의 모든 단계에 사용되지만, 평가의 자연어 판정은 Gemini가 담당합니다.
DeepSeek-V4.1-Flash는 긴 문맥 제공 효율을 목표로 하는 552B Causal Encoder-Decoder 구조로 소개됩니다. prefill 8B·decode 16B 활성 매개변수와 1M 문맥을 기술하고, HBM에 항상 남는 KV cache가 토큰당 890바이트로 V4-Flash 대비 약 4배, V1 대비 437배 작다는 기술 보고서 값을 인용합니다. KV cache는 생성 중 앞선 토큰의 attention 계산에 재사용하는 저장 상태이며, 이 소개를 본 논문의 전체 실행 비용 측정으로 혼동하지 않아야 합니다.
Gemini-3.8-Flash는 경량 API 제공 모델로 소개됩니다. 원문은 Harvey 법률 에이전트 평가와 Terminal-Bench 2.1의 90.8%, 이전 3.7 Flash의 81.6%를 인용하고, Flash Cyber 파생형의 탐지 재현율·비용 개선도 설명합니다. 정식 기술 보고서가 공개되지 않았다는 점도 원문에 기재됩니다. Table 1에서는 평가 대상인 동시에 별도 역할의 공통 rubric 판정자로 사용되며, Table 3의 평가 대상 집합과는 겹치지 않습니다.
Qwen-3.8-27B는 64계층·은닉 차원 5120의 dense 모델로, Gated DeltaNet과 Gated Attention 혼합 구조, 262K 기본 문맥과 YaRN을 통한 1M 확장, Apache 2.0을 소개합니다. 원문은 외부 분석에서 더 큰 모델과 경쟁 가능하며 단일 24GB GPU에 배치 가능하다고 소개하지만, 본문의 학습 기반 Qwen3.6-35B-A3B와는 다른 평가 대상입니다.
MiniMax-M3는 MiniMax Sparse Attention(MSA)을 사용하는 멀티모달 모델입니다. 원문은 GQA에 준하는 품질에서 1M 문맥의 토큰당 attention 연산을 28.4배 줄이고 prefill·decode 효율을 9배·15배 높인다는 제공자 설명으로 마무리합니다. 이 부록은 모델의 배경을 제공하며, 실험 결론은 공통 harness의 Table 1 결과에 둡니다. A.2
A.3 Benchmark Composition and Additional Analyses
A.3.1 Training and Test Distributions
Figure 3은 16개 분류에 속한 과제의 비율을 학습과 시험에서 각각 정규화해 비교합니다. 시험은 공공정책과 사회과학이 각 8%, 나머지가 각 6%이며, 학습은 사회과학 19.00%, 상업 10.92%처럼 편중되어 있습니다. 반대로 에너지의 학습 비율은 0.62%, 교통은 1.66%입니다. 이 그림은 범주별 과제 공급의 구성을 보여 주며 난도를 뜻하지 않습니다.
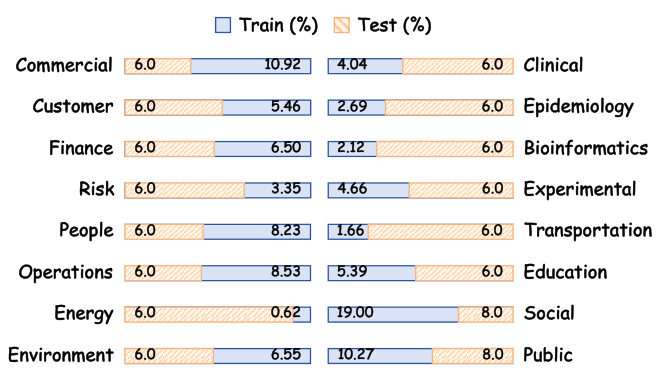
Figure 3, PDF 6쪽. v1 PDF의 그림 영역을 비례 크롭했습니다. 범례·수치·범주명을 유지하고 번역하지 않았습니다. 아래 표는 작은 수치의 확인을 돕기 위해 원문과 대조한 전사입니다.
| Figure 3 범주 | 학습(%) | 시험(%) |
|---|---|---|
| Commercial | 10.92 | 6.0 |
| Customer | 5.46 | 6.0 |
| Finance | 6.50 | 6.0 |
| Risk | 3.35 | 6.0 |
| People | 8.23 | 6.0 |
| Operations | 8.53 | 6.0 |
| Energy | 0.62 | 6.0 |
| Environment | 6.55 | 6.0 |
| Clinical | 4.04 | 6.0 |
| Epidemiology | 2.69 | 6.0 |
| Bioinformatics | 2.12 | 6.0 |
| Experimental | 4.66 | 6.0 |
| Transportation | 1.66 | 6.0 |
| Education | 5.39 | 6.0 |
| Social | 19.00 | 8.0 |
| Public | 10.27 | 8.0 |
시험 도메인을 넓게 평가하는 것과 학습 도메인 표집을 균등하게 만드는 것은 다른 설계입니다. 본문에서 외부 과제 전이를 확인하고 A.3.3에서 도메인별 상대 난도를 별도로 분석하는 이유도 이 구분과 연결됩니다. A.3.1
A.3.2 Task Case Studies
원문은 세 가지 영어 질문과 분석가용 파일 목록을 제공합니다. 각 세계의 env/는 sandbox의 /app/data/에 연결됩니다. 실행기가 추가하는 업무 지침은 예시에서 생략하고 요청 접두사를 표시용 제목으로 바꾸었습니다. 이 사례는 입력 과제의 다양성이며 실제 모델의 성공 답안이나 성공 사례가 아닙니다.
Public safety and deployment (cause route). 첫 세계는 2015~2025년 47개 인구조사 구역을 가진 미국 중규모 도시입니다. 경찰·학교·청소년 서비스·주거 법원·보건·소년사법 자료를 결합합니다. 파일 구조는 다음의 업무 출처로 나뉩니다.
| 디렉터리 | 원문의 파일과 연결할 정보 |
|---|---|
census/ |
acs_pums_households.csv, acs_tract_estimates.csv, acs_variable_codebook.pdf, housing_court_filings.csv, snap_enrollment_records.csv, tract_boundary_crosswalk_2020.csv |
crosswalks/ |
tract_precinct_mapping.csv, youth_student_id_crosswalk.csv |
health/ |
hospital_network_directory.csv, icd_coding_reference.pdf, youth_injury_er.csv |
juvenile_justice/ |
case_records.csv, disposition_code_reference.csv, youth_id_crosswalk_2019.csv |
municipal/ |
budget_allocations.csv, budget_vs_actual_variance.csv, program_code_crosswalk.csv, youth_program_quarterly_reports.csv, youth_program_site_directory.csv |
police/ |
cad_rms_codebook.pdf, deployment_monthly.csv, encounters_cad.csv, precinct_boundary_crosswalk_2019.csv, violence_incidents.csv |
school/ |
attendance_methodology_memo_sy2018.pdf, school_directory.csv, student_engagement_semester.csv |
surveys/ |
community_trust_biennial.csv, survey_methodology_documentation.pdf |
파일 크기도 서로 다릅니다. 원문 목록에서 접촉 기록은 21.3M, 학생 참여는 25.8M이고 구역 경계 대응 파일은 수백 바이트 수준입니다. 따라서 큰 이벤트 테이블뿐 아니라 작은 대응표·방법론 문서가 연결의 의미를 결정합니다. 질문은 경찰 접촉 건수에 인력·예산·지역·계절이 어떤 관계를 갖는지, 순찰 증가에 비례해 접촉이 늘거나 포화되는지, 흑인 지역·주민에 대한 접촉·수색의 집중이 배치 분포를 고려한 뒤에도 남는지 분석하게 합니다. 예산 청문회용 설명이라는 맥락에서 실제 요인·자료 인공물·통제 후 사라지는 패턴을 구별해야 합니다. 이 질문은 생성된 도시 내부의 분석 요구이지 실제 도시의 인종적 패턴에 관한 실증 결과가 아닙니다.
Class-capacity planning (cause route). 두 번째는 로스앤젤레스의 세 지점에서 운영되는 임산부 요가·모성 커뮤니티 플랫폼입니다. 스케줄·청구·고객·커뮤니티·가격·시장 정보를 결합합니다.
| 디렉터리 | 원문의 파일과 연결할 정보 |
|---|---|
billing/ |
ltv_monthly_snapshot.csv, orders_transactions.csv, subscription_events.csv |
community/ |
community_guidelines.txt, daily_user_activity.parquet, mom_group_directory.csv, posts_raw_sample.jsonl |
crm/ |
health_score_assessments.csv, nps_survey_responses.csv, user_current_view.csv, user_profiles_scd.csv |
market/ |
competitor_scan_notes.txt, monthly_market_index.csv |
revenue/ |
discount_rules_history.csv, price_adjustment_log.csv, pricing_tiers.xlsx, service_menu_2023.pdf |
scheduling/ |
class_sessions_2022.json, class_sessions_2023.json, class_sessions_2024.json, instructor_roster.csv, room_capacity_ref.csv |
운영 담당자는 월별 수용 규모 증감을 두고 경쟁사 프로모션 대응이라는 설명과 여름 출산 증가에 선제 대응한다는 설명이 충돌한다고 말합니다. 세 지점의 차이와 변화의 선행 신호까지 찾아 실제 계획에 쓸 수 있는 설명을 요구합니다. 연간 JSON 수업 기록과 월별 시장 지표를 같은 시간 단위로 맞추고 지점 차이를 분리해야 하므로, 단순한 추세 서술보다 여러 가설의 비교가 중심입니다. 파일 목록에 매출·커뮤니티 자료도 있지만 질문의 표적은 편성한 수업 수용 규모입니다.
Production yield and downstream availability (consequence route). 세 번째는 Hillcats의 2026년 경기일 공급 업무입니다. 중앙 공장의 가동률·품질 검사에서 구매·창고 재고·출하·구장 가용성까지 이어집니다.
| 디렉터리 | 원문의 파일과 연결할 정보 |
|---|---|
| 루트 | 00_DATA_ROOM_README.txt |
finance/, gameday/ |
game_day_sales_summary_2026.csv, supply_availability_2026.csv |
memos/ |
memo_2026-06-16_midseason_count_riskscore_v2.txt, memo_2026-08-01_supplier_change.txt |
production/, qms/ |
line_utilization_daily_2026.csv, shift_supervisor_notes_2026.txt, batch_inspections_2026.csv |
reference/ |
defect_codebook.csv, facility_codes.csv, sku_catalog.csv |
schedule/ |
attendance_forecast_revisions_2026.csv, hillcats_schedule_2026.csv, promo_calendar_2026.json |
scm/ |
purchase_order_lines_2026.csv, supplier_master_scd2_2026.xlsx |
weather/ |
station_metadata_and_notes.txt, weather_daily_klyh_2026.csv |
wms/ |
inventory_movements_2026.csv.gz, inventory_snapshot_sku_wh_2026.csv.gz, physical_count_2026-06-17.csv, po_receipts_2026.csv, shipments_2026.csv |
질문은 개막전 직전과 6월 중순의 고가동 구간에서 실제 수율 손실이 있었는지, 규모와 조건은 무엇인지, 그리고 그것이 구장 품절까지 전달되었는지 아니면 창고 완충 재고에 흡수되었는지 묻습니다. 현장 감독자의 주장과 실제 수치가 맞는지 확인하고, 자료가 지지하는 범위와 지지하지 못하는 범위를 명확히 설명해야 합니다. 생산과 품질의 국소 관계만 발견하고 끝낼 수 없으며, 시차와 재고 흐름을 따라 하위 결과를 추적하는 consequence 과제입니다.
세 사례는 단일 CSV의 회귀식을 잘 맞추는 것보다, 파일 간 키·시간·문서 맥락을 정합하고 경쟁 설명을 구분해야 한다는 점을 보여 줍니다. 목록의 파일명은 원문과 대조했으며 크기 라벨 전체를 재현하지는 않았습니다. 원문은 이 사례의 모범 해법이나 실제 모델 응답을 이 절에 제시하지 않습니다. A.3.2
A.3.3 Per-Domain Results
Domain key. Table 5는 세계의 dag_category에 따라 16개 도메인으로 결과를 나눕니다. Results. 모델마다 자신의 전체 평균을 빼고 그 편차를 열 개 모델에 걸쳐 평균하여 상대 난도를 설명합니다. 다음 표는 원문의 범주 순서·과제 수·마지막 편차 행을 옮겼습니다. 이 편차는 특정 모델의 원점수가 아니며, 양수는 각 모델이 평소 평균보다 더 높은 점수를 얻은 도메인입니다.
| 약어 | 원문 도메인 | 시험 과제 수 | 모델 평균 제거 후 편차(점) |
|---|---|---|---|
| Com | Commercial Growth & Acquisition | 6 | +1.30 |
| Cus | Customer, Pricing & Revenue | 6 | +3.55 |
| Fin | Finance, FP&A & Markets | 6 | +2.44 |
| Ops | Operations, Supply Chain & Manufacturing | 6 | +7.25 |
| HR | People | 6 | −1.25 |
| Risk | Risk, Fraud & Compliance | 6 | −5.00 |
| Clin | Clinical & Healthcare | 6 | −0.27 |
| Epi | Epidemiology & Public Health | 6 | +0.21 |
| Bio | Bioinformatics & Omics | 6 | +7.70 |
| Sci | Experimental & Physical Science | 6 | +3.04 |
| Env | Environment, Climate & Geospatial | 6 | −8.50 |
| Enrg | Energy, Utilities & IoT | 6 | +6.21 |
| Pol | Public Policy & Program Evaluation | 8 | −3.68 |
| Edu | Education & Learning Analytics | 6 | −6.22 |
| Soc | Social Science, Survey & Behavioral | 8 | +4.43 |
| Tran | Transportation & Mobility | 6 | −11.44 |
Table 5의 도메인별 과제 수와 평균 편차, PDF 16쪽 원문 대조 전사입니다. 모델별 16개 셀의 전체 점수는 원표를 참조할 수 있습니다.
상대적으로 생물정보·운영·에너지가 쉽고 교통·환경·교육이 어렵다는 것이 저자의 요약입니다. 중요한 조건은 도메인마다 6~8개 과제뿐이라는 점입니다. 예를 들어 GPT-6.1-Sol의 Experimental & Physical Science 점수 92.71을 그 도메인의 확정적 우위로 읽는 것은 표본 범위를 넘습니다. 저자도 개별 셀로 모델 순위를 매기지 말라고 명시합니다. 이 표는 폭넓은 도메인 평가의 필요성을 보여 주는 기술적 분석이며, 각 분야 전문가의 실제 성능을 대체하는 평가가 아닙니다. A.3.3, Table 5
A.3.4 Cause versus Consequence Tasks
Table 6은 같은 세계의 cause와 consequence 과제를 짝지어 비교합니다. 각 경로가 50개 과제이고, $\Delta$는 cause−consequence입니다. 최소 탐지 가능 차이(MDE)는 다음 식입니다.
$s_\Delta$는 쌍별 점수 차이의 표준편차, $n$은 짝지은 세계 수 50입니다. 2.802는 원문이 사용한 계수이며, 이 식에 대응하는 유의수준·검정력의 별도 설명을 원문 밖에서 추정해 덧붙이지 않습니다. MDE는 이 분석 해상도에서 식별 가능한 차이의 규모를 나타내며, 두 경로가 동일하다는 증명이 아닙니다.
| 모델 | Cause | Consequence | Δ | MDE |
|---|---|---|---|---|
| GPT-6-Astra | 76.32 | 72.54 | +3.78 | 9.30 |
| Qwen-3.8-Max-0902 | 75.32 | 71.53 | +3.80 | 8.79 |
| GPT-6.1-Sol | 73.33 | 73.27 | +0.07 | 8.87 |
| GLM 5.3 | 66.05 | 69.33 | −3.28 | 9.06 |
| HY4-Preview | 68.02 | 65.08 | +2.94 | 9.81 |
| Kimi-K3 | 68.91 | 63.88 | +5.03 | 10.35 |
| DeepSeek-V4.1-Flash | 64.10 | 61.80 | +2.30 | 10.25 |
| Qwen-3.8-27B | 60.40 | 58.87 | +1.53 | 10.38 |
| Gemini-3.8-Flash | 55.96 | 56.38 | −0.43 | 9.52 |
| MiniMax-M3 | 50.56 | 48.94 | +1.62 | 10.43 |
Table 6, PDF 16쪽 원문과 대조했습니다. 인쇄 평균·차이는 각각 반올림되어 일부 차이가 0.01점 어긋날 수 있으며 원문 보고값을 유지했습니다.
차이는 −3.28~+5.03점이고 어느 모델도 자신의 MDE에 도달하지 않습니다. 따라서 이 표는 어느 경로가 체계적으로 더 쉽다는 증거를 주지 못합니다. 난도 동일성을 확립하지도 않으며 모델 순위표도 아니라는 것이 저자의 명시적 해석입니다. A.3의 기여는 총점 뒤에 있는 도메인 구성과 질문 방향을 보여 주고, 작은 하위 표본에서 가능한 결론의 범위를 제한한 데 있습니다. 다음 절은 학습 구현을 재현 가능한 설정 수준으로 설명합니다. A.3.4, Table 6
A.4 RL Training Implementation Details
A.4.1 Training Data and Software
DataWorld-35B-A3B는 시험 세계와 겹치지 않는 1,037개 세계의 2,135개 과제로 기반 Qwen3.6-35B-A3B에서 출발하며, 과제 전용 SFT를 수행하지 않습니다. DataMind는 공개 Python 과제 7,323개로 같은 기반과 설정에서 재훈련합니다. 소프트웨어는 slime v0.3.1(a74ae3a0), Megatron-LM v0.16.0rc0(1dcf0daf), rollout 생성용 SGLang v0.5.15.post1(0b3bb0cb)입니다. 버전은 학습 컨테이너에서 확인한 것이고, rollout과 관련 추론 서비스는 같은 SGLang 설치를 사용합니다.
이 목록은 학습 실행 스택입니다. Table 3을 얻은 mini-swe-agent 평가 harness와 동일하다고 읽으면 안 됩니다. 공개된 버전·revision·자원 조건은 학습 결과의 구현 맥락을 제공하지만, 이 리뷰에서 학습을 재실행했다는 뜻은 아닙니다.
A.4.2 Resources and Optimization
Table 7의 설정을 원문과 대조해 옮기면 다음과 같습니다. TP는 tensor parallelism, CP는 context parallelism, PP는 pipeline parallelism, EP는 expert parallelism, ETP는 expert tensor parallelism, DP는 data parallelism입니다. 각각 매개변수 연산·문맥·계층·전문가·전문가 내부 연산·서로 다른 샘플을 여러 GPU로 나누는 방식입니다.
| 설정 | 원문 값 |
|---|---|
| 학습 / rollout GPU | H20-3e 48 / 64개, 8-GPU 노드 6 / 8개 |
| 학습 병렬화 | TP 2, CP 4, PP 1, EP 8, ETP 1 |
| 유도 DP | $48/(2\times4\times1)=6$ |
| Rollout 엔진 | 단일 GPU SGLang 엔진 64개, TP 1 |
| Rollout batch | 질문 24개 |
| 질문당 샘플 | 8개 |
| Global batch | 응답 192개($24\times8$) |
| Micro-batch | 1 |
| 업데이트당 rollout 단계 | 1 |
| 최대 문맥 / 생성 길이 | 262,144 / 16,384 토큰 |
| Optimizer / 학습률 | Adam / 일정한 $10^{-6}$ |
| Weight decay / Adam β | 0.1 / (0.9, 0.98) |
| GSPO clip 하한 / 상한 | $3.5\times10^{-4}$ / $5\times10^{-4}$ |
| KL loss / entropy 계수 | 0 / 0 |
| Rollout temperature | 1.0 |
Table 7, PDF 17쪽 원문 대조 전사입니다.
학습 GPU와 rollout GPU는 역할과 수가 다릅니다. 질문 24개에 각 여덟 응답을 표집하므로 업데이트에 쓰는 전체 응답 수는 192개입니다. KL·entropy 계수가 0이라는 조건과 작은 비대칭 clip 문턱은 이 실행의 실제 학습 목표 설정이며, 원문이 보고하지 않은 다른 정규화나 스케줄을 보충해서는 안 됩니다.
A.4.3 Rollout Environment
각 학습 rollout은 독립적으로 격리한 sandbox에서 실행됩니다. sandbox 이미지에는 Python과 일반 데이터 분석 패키지가 있고, 모델 생성은 별도 SGLang 엔진이 제공합니다. GSPO 집단 크기는 8이며 rubric 보상은 비용 절감을 위해 기반 모델 자체가 판정합니다. A.4의 설정은 학습 실행에 관한 것이고, 대응 평가는 A.5의 별도 공유 프로토콜을 사용합니다. 이 절의 기여는 모델 생성 서버·파일 분석 sandbox·평가 harness의 경계를 밝힌 것입니다. A.4, Table 7
A.5 RL Evaluation Protocol
이 절은 Table 3의 평가를 설명하며 대응 비교의 초점은 DataWorld-35B-A3B와 기반 모델입니다. JobBench·DAComp·DABstep-Hard·DataWorld-Bench는 각각 더 넓은 전문 업무, 열린 분석, 자동 검사 가능한 분석, 생성 세계의 계산·통찰을 확인합니다.
A.5.1 Shared Evaluation and Scoring
각 벤치마크 안에서 Table 3의 모델은 같은 mini-swe-agent harness, 예산 체계, 채점 절차를 사용합니다. DAComp는 Gemini-3.8-Flash의 rubric 판정, DABstep-Hard는 자동 정답 검사, DataWorld-Bench는 자체 rubric과 동일 Gemini 판정자를 사용합니다. DAComp와 DataWorld-Bench의 보관된 보고서는 한 번 채점하며 표시를 위해 100배 합니다. DataWorld만 순 rubric 점수를 $[0,1]$로 정규화하고, DAComp는 원래의 점수 체계를 유지합니다. DABstep-Hard는 이진 정답 여부입니다.
원문은 Tables 1과 3의 DataWorld-Bench 점수가 같은 판정자·rubric·단일 채점 절차로 얻어져 같은 척도라고 명시합니다. 두 표의 평가 대상 집합은 다르며, 공통 판정자인 Gemini-3.8-Flash를 두 표에 중복된 평가 모델로 세면 안 됩니다. Table 1 안에는 Gemini 평가 행이 있지만 Table 3의 비교 집합에는 없습니다. 공통 채점 절차는 각 표 내부의 비교 일관성을 제공하며, 판정자 편향이 없다는 증명은 아닙니다.
A.5.2 Paired Statistical Analysis
두 시스템의 과제를 이름으로 일대일 대응시키고 각 과제의 $\Delta$를 DataWorld−기반 점수로 정의합니다. 대응 분석은 DAComp 200쌍, DABstep-Hard 378쌍, DataWorld-Bench 100쌍 전체를 포함하며 빠뜨린 과제는 없습니다. 원문은 이 차이에 대한 paired one-sample test를 언급하고, A.3.4와 같은 $\mathrm{MDE}=2.802s_\Delta/\sqrt n$ 식을 제시합니다. 여기서 $n$은 각 벤치마크의 대응 과제 수이므로 경로 비교의 세계 수 50과 다릅니다.
다만 이 절에는 각 벤치마크의 실제 $s_\Delta$·MDE 수치, p값, 신뢰구간이 보고되지 않았습니다. Bootstrap 결과도 보고되지 않았습니다. 따라서 표준편차가 있는 평균 개선과 대응 설계가 제시되었다고 설명할 수 있지만, 모든 학습 개선이 특정 유의수준을 통과했다고 단정할 근거는 제시되지 않습니다. JobBench는 이 절에서 열거한 세 대응 분석에 포함되지 않습니다.
A.5.3 Benchmark-Specific Details
JobBench ($n=65$). 전문가가 위임하고 싶어 하는 업무를 35개 직업에서 모은 평가입니다. 이종 참조 파일과 사실에 고정된 이진 rubric 연쇄로 답변을 채점합니다. 사용한 65과제 main set은 실제 공개 기록과 합성 문서를 섞으며 easy set보다 더 많은 추론을 요구합니다. 데이터 분석에 한정되지 않아 네 평가 중 학습 과제와 가장 덜 정렬되어 있습니다. 따라서 전문 파일 업무로의 전이 확인에 의미가 있지만, 평균 개선은 직업별 전부의 개선을 확립하지 않습니다.
DAComp ($n=200$). 원래 기업 데이터 인텔리전스의 210과제로, 데이터 엔지니어링과 열린 데이터 분석을 포함합니다. 전자는 산업 스키마의 SQL 파이프라인 설계·요구 변경과 실행 기반 다지표 채점, 후자는 계획·반복 탐색 코드·권고안 통합과 계층 rubric 판정이 특징입니다. 이 논문은 열린 분석 부분 200개만 평가합니다. 같은 rubric을 Gemini-3.8-Flash가 두 시스템에 적용하므로 이진 성공률이 아니라 세부 rubric 점수입니다.
DABstep-Hard ($n=378$). 금융 분석 플랫폼의 실제 자료에 기반한 450개 이상 과제 중 가장 어려운 분할입니다. 다양한 문서를 해석하고 코드로 자료를 처리하여 단답형 정답을 제출하며 자동으로 맞음·틀림을 검사합니다. 원문은 벤치마크 소개에서 강한 에이전트도 hard split 정확도가 15% 미만이었다고 설명합니다. 이는 인용된 배경 성능이지 Table 3의 새 실험 상한이 아닙니다. 이 연구에서의 46.56은 이진 점수 0·1의 평균을 100배 한 통과율입니다.
DataWorld-Bench ($n=100$). 학습에서 제외한 50개 세계에 cause·consequence 각 하나를 둔 시험 분할입니다. 에이전트는 전체 세계 폴더를 탐색하고 반복 코드 실행으로 중간 변수를 계산한 뒤 통찰을 도출합니다. 최종 보고서는 양·음 항목이 모두 있는 rubric으로 채점합니다. 정답 파일만 계산하는 과제와 구별되는 열린 분석 능력을 확인합니다.
MMLU-Pro. 여러 학문·전문 분야의 지식과 추론을 다지선다형으로 평가합니다. MMLU보다 추론 난도를 높이고 선택지를 늘린 평가이며, Table 4에서는 정확도(%)로 일반 능력 유지 여부를 확인합니다.
LiveCodeBench-Hard. 코딩 경시 문제와 실행 가능한 테스트로 코드 생성의 정확성을 평가하는 LiveCodeBench의 어려운 부분입니다. 학습에 쓴 데이터 분석을 넘어선 알고리즘 코딩을 확인하며 Table 4는 정확도(%)를 사용합니다. 열린 보고서에 대한 rubric 점수와 구별됩니다.
SimpleQA-Verified. SimpleQA의 중복 제거·주제 균형·출처 조정·개선된 자동 판정 프롬프트를 적용한 단문 사실 질의응답 평가입니다. Table 4의 지표는 F1입니다. 합성 데이터 환경 밖의 사실 답변을 확인하지만, 그 점수의 상승만으로 합성 세계에 대한 근거 없는 주장이나 일반적인 환각이 줄었다고 결론내릴 수는 없습니다.
A.5는 같은 과제와 절차를 사용했다는 비교 조건, 서로 다른 점수의 의미, 통계 보고 범위를 명확히 합니다. 부록 전체는 생성 정보의 이론적 이점부터 과제 입력의 실제 형태와 재현 조건까지 연결하여, 본문 총점이 무엇을 측정하는지 구체화합니다. A.5
실험 결과 심층 분석
이 논문의 평가에서 가장 뚜렷한 관측은 정확한 계산과 목표 통찰의 발견이 같은 능력 지표가 아니라는 것입니다. GPT-6-Astra의 계산 87.80과 통찰 66.45의 차이는 21.35점이고, Gemini-3.8-Flash의 59.00과 54.13의 차이는 4.87점입니다. 차이가 작다고 통찰 능력이 더 높다는 뜻도 아닙니다. 두 축의 수준을 함께 봐야 하며, rubric의 항목 구성 차이도 격차의 해석에 포함해야 합니다. Table 2의 음의 항목은 틀린 주장을 덜 하는 것과 더 많은 타당한 발견을 회수하는 것을 추가로 분리합니다.
학습 효용의 증거는 세 층입니다. 첫째, 세계가 겹치지 않는 시험의 +7.06점은 학습 세계의 답안을 그대로 다시 쓰는 평가와 구별됩니다. 둘째, 열린 DAComp의 +14.28점과 자동 검사 DABstep-Hard의 +20.90점이 함께 나타나 서로 다른 채점 형식에서도 전이가 관측됩니다. 셋째, JobBench의 +12.13점은 데이터 분석 밖의 파일 기반 전문 업무로 범위를 넓힙니다. 다만 BigBang·Occamy·DataMind와의 비교는 학습 데이터·교사 궤적·다단계 레시피를 모두 맞춘 구성 요소 실험이 아니므로, 결과를 합성 데이터 한 가지 요인의 순수 효과로 환원할 수 없습니다. 이 경계는 저자가 명시한 한계입니다.
비용의 변화도 실용적으로 중요합니다. DataWorld-Bench의 평균 호출은 36.5에서 102.8, 응답 토큰은 38.4k에서 68.4k로 늘었습니다. 리뷰어 해석으로는, 같은 비용에서 더 좋은 응답을 보장하는 결과보다 긴 상호작용을 수행하면서 더 높은 점수를 얻은 정책의 결과로 이해하는 것이 정확합니다. 반대로 Table 1의 모델 간 비용 비교는 능력과 전략이 달라 추론량 증가의 이득을 분리하지 않습니다. 두 실험 모두 비용을 점수와 함께 읽을 근거를 제공하지만, 토큰 지표를 실제 금전 비용으로 바꾸는 가격 비교는 수행하지 않았습니다.
통계적 근거도 종류를 나눠야 합니다. Tables 1·3의 괄호는 SD이며 반복 학습 seed의 불확실성이나 판정자 간 일치도 신뢰구간이 아닙니다. A.5.2는 대응 분석과 MDE 계산식을 명시하지만 실제 p값·신뢰구간·학습 개선의 벤치마크별 MDE 결과는 논문에 보고되지 않았습니다. 반면 경로 비교의 Table 6에는 MDE가 있으며 모든 차이가 그 문턱보다 작습니다. 이 결과는 경로 난도 차이에 대한 증거 부재이지 동등성 증거가 아닙니다. 도메인별 6~8개 과제로 세부 순위를 확정하지 않는 원문의 신중함도 유지해야 합니다.
재현성의 관점에서는 세계 분리 수·감사 기준·역할별 접근 권한·학습 스택 revision·병렬화·배치·학습률·평가 과제 수가 제공됩니다. 첫 페이지는 GitHub·Hugging Face·프로젝트 페이지를 연결합니다. 이 리뷰는 버전 고정 논문과 PDF 그림을 분석했으며 공개 코드나 학습을 실행해 결과를 재현한 검증은 수행하지 않았습니다. 제공된 실행 정보와 실제 독립 재현은 구별됩니다. §4, A.3–A.5
기술적 함의와 응용
저자들이 제시하는 함의는 합성 데이터의 역할을 파일 생산에서 감독 신호의 근거 생산으로 넓히는 것입니다. 정본과 관측을 분리하면 감독자는 생성 메커니즘을 확인하면서도 해결자에게는 불완전한 업무 자료만 줄 수 있습니다. 이는 실제 데이터 수집·주석을 보완하는 공급 경로이며, 논문은 현실 데이터와 어느 쪽이 더 효과적인지 비교하지 않습니다.
리뷰어 관점에서 배울 설계는 세 연결입니다. 세계 계약이 모든 파일에 적용할 일관성 조건을 정하고, 독립 감사가 관측 파일에서의 복원 가능성을 확인하며, rubric이 계산·통찰·명백한 오류를 나누어 보상으로 연결합니다. 이 연결을 공급망처럼 여러 단계의 수치가 맞물리는 분석, 학교·보건·행정처럼 키와 문서 맥락을 정합해야 하는 분석, 열린 보고서의 평가를 설계하는 경우에 참고할 수 있습니다. 이는 논문 사례와 구조에서 도출한 응용 해석이며 해당 현업에 배치해 효과를 측정했다는 결과는 아닙니다.
마지막으로 알려진 생성 과정은 평가의 강한 근거이지만 포괄적인 진실 판정기는 아닙니다. 원문이 인정하듯 목록 밖 타당한 발견은 남고, 자연어 판정 편향과 실제 사용자 요청 분포의 차이도 남습니다. Data World의 성과는 이러한 경계를 유지하면서도, 합성 환경에서 얻은 학습 신호가 미관측 세계와 외부 분석·전문 업무의 점수 개선으로 이어졌다는 데 있습니다.