논문 개요와 전체 구조
Hybrid Reasoning Agents는 언어 모델이 내부 계산은 연속적인 잠재 표현으로 수행하면서 검색·코드 실행·사용자에게 보여 줄 판단은 텍스트로 표현하도록 만드는 연구입니다. 기존 텍스트 에이전트는 모든 중간 사고를 토큰으로 생성해야 하고, 잠재 추론 모델은 외부 도구를 호출하거나 내부 계산을 살펴보기 어렵다는 문제에서 출발합니다. 저자들은 두 표현을 하나의 자기회귀 생성 과정 안에서 전환하는 HybridAgent를 제안합니다. 핵심 장치는 마지막 은닉 상태를 입력 임베딩 공간으로 되돌리는 HybridLink, 여러 턴에 걸쳐 텍스트·잠재 상태·도구 응답을 보존하는 continuous working memory, 이를 학습하는 HybridSFT와 HybridRL입니다. 원문 §1–4
이 글은 2026년 10월 13일 제출된 arXiv:2610.18861v1의 45쪽 PDF와 같은 버전 HTML을 대상으로 합니다. 저자는 Jiaru Zou, Yunzhe Qi, Sirui Chen, Federico Bianchi, Shang Zhu, Pan Lu, Jingrui He, James Zou입니다. 평가는 Qwen3-Base 4B·8B·14B와 수학·과학·의학·검색·에이전트 추론의 11개 벤치마크를 다룹니다. 모든 벤치마크를 세 규모에서 평가한 것은 아니며, 4B의 추가 성능표는 네 과제에 한정됩니다. 초록의 성능·속도·비용 개선은 비교 대상과 계산 범위가 다른 요약치이므로 아래에서 개별 표와 그림에 맞추어 해석합니다. 서지·초록, 원문 §5·부록 G
원문 구조는 다음과 같습니다. 뒤의 상세 리뷰에서도 이 순서를 유지합니다.
| 순서 | 원문 제목과 소절 |
|---|---|
| 1 | Introduction |
| 2 | Preliminary |
| 3 | Building a Hybrid Reasoning Agent — 3.1 Hybrid Mode Interface; 3.2 Multi-Turn Hybrid Generation over Working Memory |
| 4 | Learning to Perform Hybrid Reasoning — 4.1 Stabilize Generation via Hybrid Supervised Fine-tuning; 4.2 Scale Reasoning via Hybrid Reinforcement Learning |
| 5 | Empirical Evaluations — 5.1 Scaling Performance via Hybrid Reasoning; 5.2 Efficiency Advantage on Hybrid Generation |
| 6 | In-depth Analyses — 6.1 Training Dynamics on HybridSFT and HybridRL; 6.2 Causal Reliance and HybridLink Design in Latent Mode; 6.3 Tool Use and Reasoning Auditability in Text Mode |
| 7–9 | Related Work; Discussion and Future Directions; Conclusion |
| 본문 뒤 | Acknowledgments; References |
| A | Multi-turn Continuation over Working Memory |
| B | Design and Analyses of Hybrid Supervised Fine-tuning — B.1 Why Self-Conditioned Training?; B.2 Learning When to Enter and Exit Latent Mode |
| C | Theoretical Analyses of Hybrid Reinforcement Learning — C.1 Formulation of Hybrid Policy Factorization; C.2 Hybrid Policy Optimization |
| D–F | Extended Related Work; Hybrid Data Curation; Latent Interpretability Evaluation (Figures 2 and 8) |
| G | Additional Experiments — G.1 Experiments on 4B-Scale HybridAgent; G.2 Cost Analyses on HybridAgent |
| H | Experiment Setups — H.1 Benchmark and Evaluation Details; H.2 Baseline Details; H.3 Implementation Details |
| I–J | Prompt Template; Case Study of HybridAgent |
핵심 기여와 혁신성
해결하려는 문제는 내부 추론에 적합한 표현과 외부 행동에 적합한 표현의 차이입니다. 텍스트는 도구 API와 사람이 읽는 기록에 적합하지만, 중간 계산을 모두 문장으로 만들면 생성 단계가 늘어납니다. 반대로 마지막 은닉 상태를 곧바로 다음 입력으로 사용하는 잠재 추론에서는 사전학습된 입력 임베딩과 은닉 상태의 분포 차이, 도구 호출을 포함하는 다중 턴 이력의 전달, 내부 표현의 관찰이 문제가 됩니다. 이 문제 설정은 원문의 주장입니다. 원문 §1·3
첫째 기여는 표현을 전환하는 인터페이스와 이력을 전달하는 메모리를 함께 설계했다는 점입니다. HybridLink는 은닉 상태를 잔차 연결이 있는 두 층 투영으로 입력 공간에 맞춥니다. 연속 작업 메모리는 모든 층의 KV를 이어 붙여 도구 실행 뒤에도 잠재 이력을 그대로 조건으로 사용합니다. 둘째 기여는 자신이 만든 잠재 입력을 읽는 학습과 그 이력에 보상을 부여하는 학습의 분리입니다. HybridSFT는 정답 임베딩만 본 모델이 자기 출력을 입력으로 받을 때의 불일치를 줄이고, HybridRL은 기록된 잠재 입력과 도구 응답을 고정한 채 샘플링된 텍스트 위치의 확률을 갱신합니다. 원문 §3–4
셋째 기여는 잠재 추론의 성능만 보고하는 데서 나아가 잠재 벡터 개입, 임베딩 최근접 토큰 판독, 텍스트 기록만을 이용한 감시·오류 진단을 함께 평가한 점입니다. 다만 최근접 토큰의 읽기 쉬움은 벡터와 어휘 임베딩의 기하학적 정렬이며, 질문 특이성은 어휘 중복 비율입니다. 이를 인간과 동일한 사고의 복원이나 전 과정의 진실성 보증으로 확대해서는 안 됩니다. 리뷰어의 관점에서 이 연구의 학습 가치는 추론 매체, 실행 상태, 학습 목적함수, 관찰 가능성을 하나의 시스템 설계로 연결해 볼 수 있다는 데 있습니다. 원문 §6·부록 F
기술적 세부사항
| 용어 | 이 논문에서의 의미 |
|---|---|
| 텍스트 모드 | 어휘 확률에서 토큰을 샘플링하고 그 토큰의 임베딩을 다음 입력으로 사용하는 생성 |
| 잠재 모드 | HybridLink가 만든 연속 벡터를 토큰으로 양자화하지 않고 다음 입력으로 되먹이는 생성 |
| HybridLink | 마지막 층 은닉 상태를 입력 임베딩 공간에 정렬하는 작은 잔차 어댑터 |
| 연속 작업 메모리 | 텍스트·잠재 단계·도구 관찰에서 생긴 모든 층의 KV를 순서대로 유지하는 실행 상태 |
| 자기 조건화 | 첫 순전파에서 만든 잠재 입력으로 두 번째 순전파를 학습하는 절차 |
| exact rollout replay | 보상을 받은 궤적의 잠재 입력과 관찰을 그대로 재생해 텍스트 확률을 다시 계산하는 절차 |
| pseudo-text | 잠재 벡터에 가장 가까운 토큰 임베딩을 찾아 외부 관찰용으로 읽은 의사 텍스트 |
추론의 한 단계는 여전히 백본의 순전파 한 번입니다. 잠재 모드는 백본 계산을 없애지 않으며, 출력 어휘 투영·샘플링·재임베딩 대신 HybridLink를 사용합니다. 따라서 텍스트 토큰 수, 텍스트와 잠재를 합친 생성 단계 수, 벽시계 시간, 추정 FLOP 비용을 구분해야 합니다. 같은 이유로 의사 텍스트를 관찰용으로 읽는 것과 그 토큰을 실제 다음 입력으로 사용하는 것도 다릅니다. 원문 §2–3·5.2·부록 G.2
학습 중 고정되는 대상도 단계마다 다릅니다. 형식 활성화는 백본을 학습하고, HybridLink 활성화는 백본을 고정한 채 어댑터를 학습합니다. 자기 조건화에서는 둘을 함께 학습합니다. HybridRL에서는 HybridLink를 고정하고 백본을 갱신합니다. 이때 재생되는 잠재 벡터까지 고정되지만, 그 벡터를 처리하는 백본의 은닉 상태와 텍스트 확률은 미분 가능합니다. 식의 의미와 이 조건은 상세 리뷰의 §4 및 부록 C에서 설명합니다. 원문 §4·부록 C
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 에이전트의 외부 상호작용과 잠재 추론의 내부 효율을 연결해야 하는 이유를 제시합니다. 먼저 어려운 문제 해결에는 도구 호출, 환경 피드백 관찰, 다음 행동 수정이 필요하다고 설명합니다. 현재 에이전트는 내부 추론과 환경 상호작용 모두에 텍스트라는 공통 매체를 사용하므로 행동 전에 중간 사고를 토큰 단위로 생성합니다. 이어 잠재 추론은 이러한 언어화 없이 연속 공간에서 계산할 수 있지만, 도구 호출과 사람이 살펴볼 수 있는 의미를 자연스럽게 제공하지 못한다고 지적합니다.
저자들의 해결 순서는 아키텍처를 바꾸고, 다중 턴 실행을 가능하게 한 뒤, 전용 후학습을 적용하는 것입니다. HybridLink로 은닉 상태와 입력 임베딩 사이를 잇고, 작업 메모리로 텍스트·잠재·관찰의 전체 궤적을 유지합니다. 이어 HybridSFT가 백본과 연결 모듈의 협응을 학습하고, HybridRL이 언제 잠재 공간에서 생각하고 언제 텍스트로 행동할지 조정합니다. 잠재 단계의 최근접 임베딩 판독은 학습과 실행 중 관찰 수단으로 제시됩니다.
이 장의 성능 요약은 11개 벤치마크, 3개 규모, 평균 10.4% 개선과 효율 향상입니다. 이 수치는 뒤의 서로 다른 비교를 한 문장에 압축한 것으로 읽어야 합니다. 도입의 핵심 기여는 두 모드를 단순히 번갈아 호출하는 파이프라인이 아니라 하나의 생성 과정과 메모리 위에서 연결한다는 문제 설정이며, 다음 장은 이를 입력 벡터와 궤적 기호로 정의합니다. 원문 §1
📖 Chapter 2: Preliminary
이 장은 텍스트와 잠재 입력을 동일한 자기회귀 계산으로 표현합니다. 입력 문맥을 $x$, 그 임베딩 열을 $E=[e_1,\ldots,e_t]\in\mathbb R^{t\times d_h}$로 두고 마지막 층 은닉 상태를 $h_t$로 나타냅니다. 원문 식 (1)–(2)의 기본 생성은 다음과 같습니다.
$d_h$는 백본의 표현 차원, $W_{\mathrm{out}}$은 은닉 상태를 어휘 점수로 바꾸는 행렬, $\mathrm{Emb}$는 토큰 임베딩 함수입니다. 세미콜론은 앞선 입력과 새 입력의 연결입니다. 텍스트 모드는 이산 토큰을 선택하지만, 여기서 소개하는 기존 잠재 모드는 $h_t$ 자체를 다음 입력으로 사용합니다. 뒤의 HybridAgent는 이 두 번째 경우를 $\mathcal R(h_t)$로 바꿉니다. 따라서 이 식의 직접 은닉 상태 재사용과 최종 제안 방법을 혼동하면 안 됩니다.
이어서 도구 통합 추론을 모델 측 텍스트·잠재 계산 → 텍스트 도구 호출 → 환경 측 도구 응답으로 설명합니다. 원문 식 (3)의 한 턴 궤적 $\tau$는 이 요소들을 모두 포함하며, 마지막 텍스트 답이 나올 때까지 다음 턴의 문맥에 이어집니다. 도구 응답은 모델이 샘플링한 행동이 아니라 환경이 돌려준 관찰입니다. 이 구분은 뒤의 정책 확률에서 도구 응답 위치를 제외하는 근거가 됩니다. 이 장은 입력 형식과 행동·관찰의 경계를 정했고, 다음 장은 잠재 입력의 분포 정렬과 이력 전달을 해결합니다. 원문 §2, 식 (1)–(3)
📖 Chapter 3: Building a Hybrid Reasoning Agent
이 장은 HybridAgent의 실행 인터페이스를 정의합니다. 3.1 Hybrid Mode Interface는 기존 방식처럼 마지막 은닉 상태를 그대로 넣으면 사전학습된 입력 공간과 표현 분포가 맞지 않는다는 설명으로 시작합니다. HybridLink는 원문 식 (4)의 잔차 어댑터입니다.
$W_1,W_2$는 학습하는 선형 투영, $\sigma$는 GELU 같은 활성화 함수입니다. $h_t$를 직접 더하는 잔차 경로가 의미를 유지하고, 학습 경로는 입력 임베딩 공간과의 차이를 보정하도록 설계되었습니다. 파라미터 수는 대략 $2d_h^2$이며, 저자들은 4B 백본에서 약 10M을 예로 듭니다. 작다는 말은 백본 대비 규모에 관한 것이며 추가 연산이 없다는 뜻은 아닙니다.
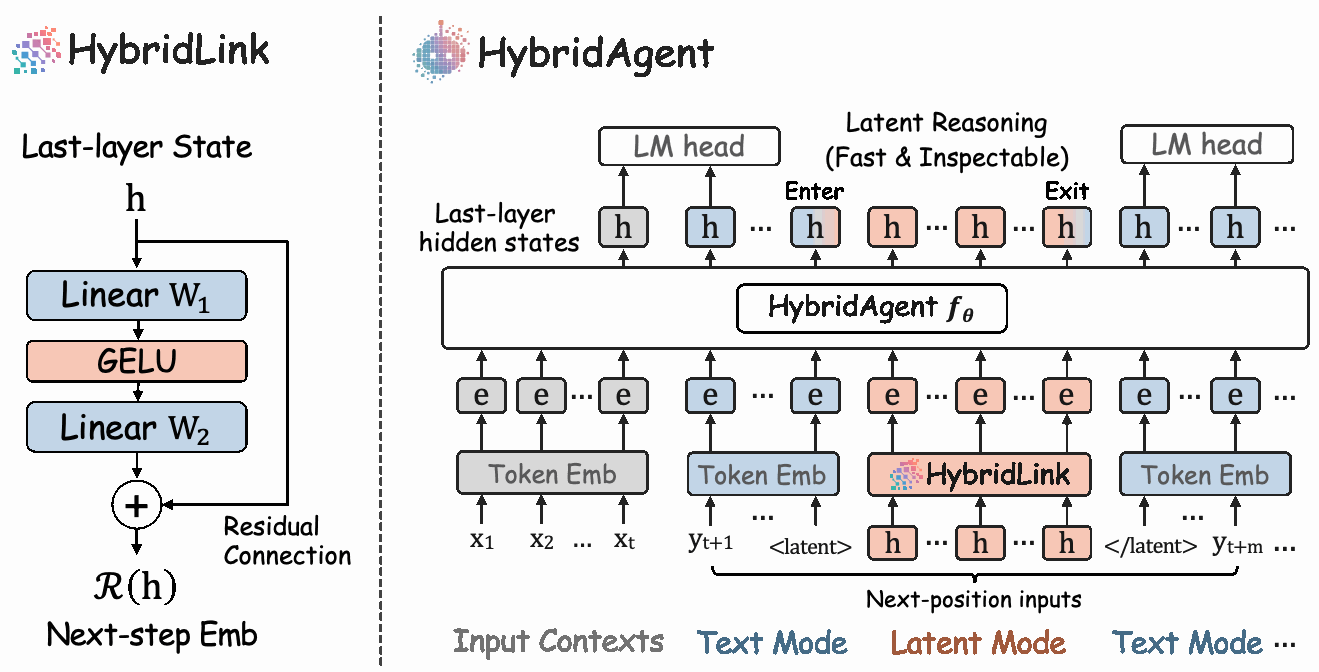
Figure 1, PDF 1쪽. 2610.18861v1 PDF의 도식 영역을 크롭했습니다. 원문 영어 표기와 배치를 유지했으며 번역하지 않았습니다. 아래 두 그림은 같은 그림의 왼쪽·오른쪽 패널 상세입니다.
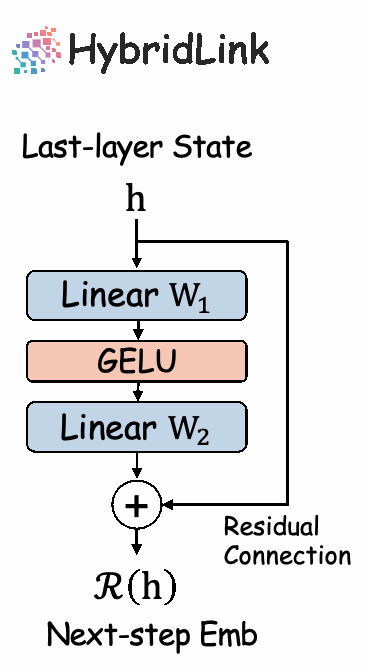
Figure 1 왼쪽 패널 상세, PDF 1쪽. 동일 버전 출처를 패널 크롭했으며 번역하지 않았습니다. 세로 우회 경로가 잔차 연결입니다.
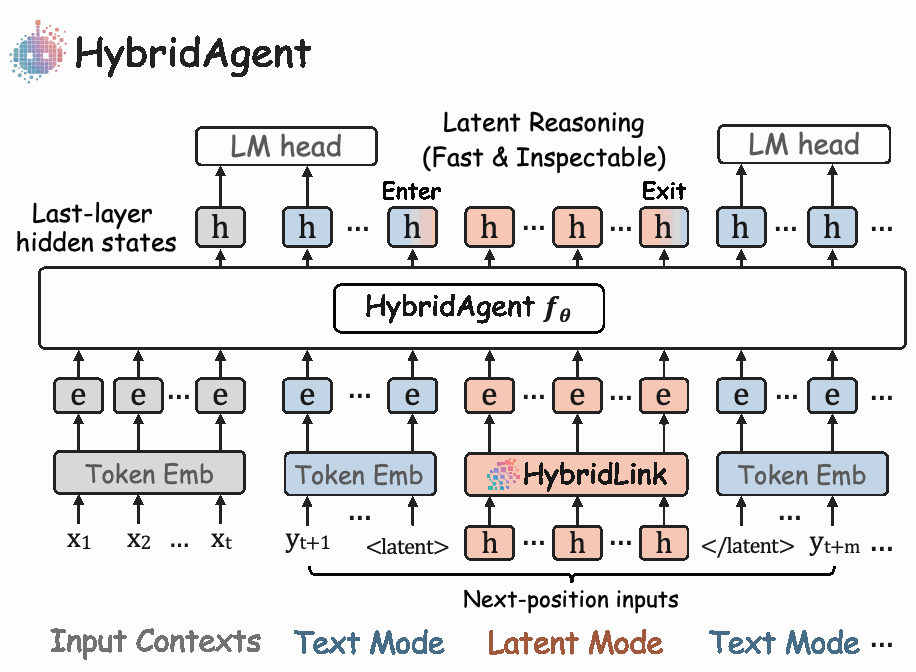
Figure 1 오른쪽 패널 상세, PDF 1쪽. 동일 버전 출처를 패널 크롭했으며 번역하지 않았습니다. 텍스트 구간은 LM head와 토큰 임베딩을, 잠재 구간은 HybridLink를 사용합니다.
다음으로 모드 전환을 설명합니다. 텍스트 모드에서 <latent>가 샘플링되면 다음 계산부터 HybridLink 출력을 되먹입니다. 잠재 모드에서는 일반 토큰을 샘플링하지 않고, 현재 출력 벡터와 어휘 임베딩들의 코사인 유사도를 비교해 종료 앵커를 찾습니다. 식 (5)는 다음 조건입니다.
$\mathcal V$는 어휘 집합입니다. 가장 가까운 임베딩이 종료 토큰의 임베딩이면 텍스트 모드로 돌아갑니다. 진입은 텍스트 샘플링, 이탈은 연속 상태에 대한 결정적 판독이라는 비대칭이 있습니다. 모드 길이와 빈도는 문맥에 따라 달라지지만, 실제 실험에는 잠재 구간당 최소 16·최대 256단계라는 경계가 적용됩니다. 본문의 적응적 전환 주장을 무제한 길이의 전환으로 해석해서는 안 됩니다.
마지막 소주제인 Interpretable Latent Mode는 같은 최근접 임베딩 연산을 종료 판정 이외의 관찰에도 사용합니다. 각 벡터에 가장 가까운 토큰을 읽으면 의사 텍스트를 얻습니다. 실제 계산에 사용되는 것은 계속 연속 벡터이며, 관찰용 토큰으로 계산을 대체하는 것은 아닙니다.
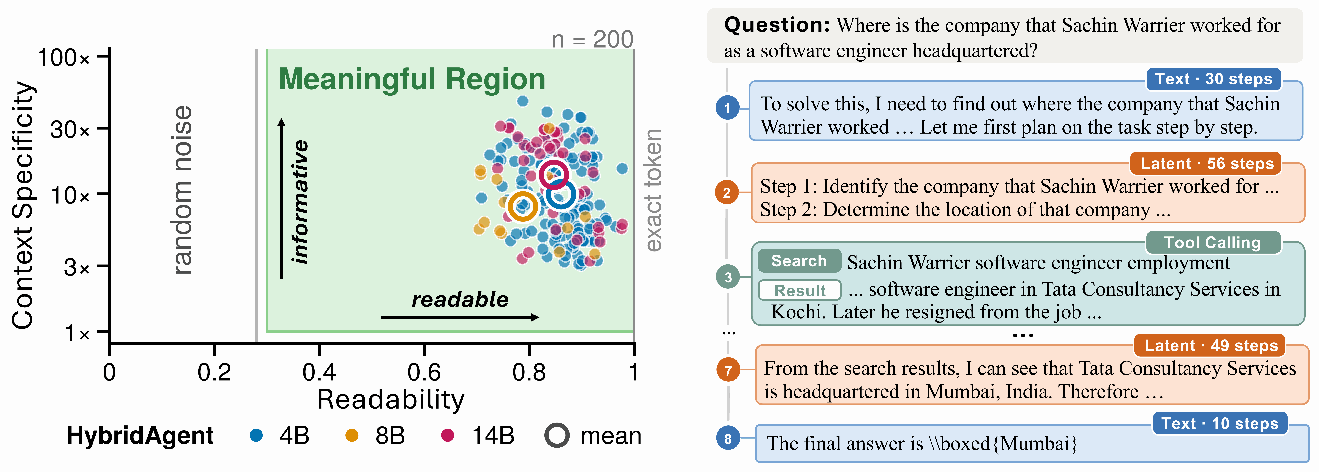
Figure 2, PDF 4쪽. 원문의 그림 전체를 크롭했으며 번역하지 않았습니다. 왼쪽의 점 하나는 질문 하나가 아니라 연속된 잠재 구간 하나입니다. 200은 평가 질문 수입니다.
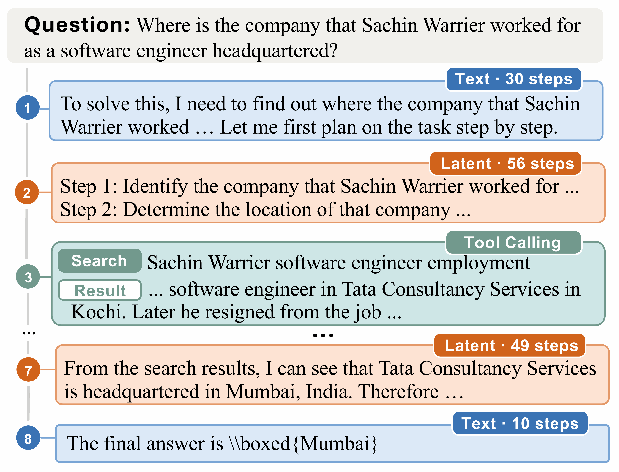
Figure 2 오른쪽 패널 상세, PDF 4쪽. 동일 버전 출처의 패널을 크롭했으며 번역하지 않았습니다. 잠재 구간의 계획·검색 결과 해석을 최근접 토큰으로 읽은 예입니다. 개별 성공 사례와 정량 평가의 범위는 구분해야 합니다.
3.2 Multi-Turn Hybrid Generation over Working Memory는 턴 경계의 문제로 이동합니다. 텍스트 에이전트는 이전 내용을 문자열로 다시 토큰화할 수 있지만, 연속 벡터가 섞인 이력은 그 방식으로 복원할 수 없습니다. HybridAgent는 모든 입력이 같은 표현 공간으로 들어간다는 점을 이용해, 각 위치·각 층의 key와 value를 작업 메모리로 누적합니다. 식 (6)의 초기화와 첫 턴 누적은 다음과 같습니다.
$\mathcal M^{(0)}$는 입력 문맥의 KV, $\oplus$는 새로 생긴 KV를 위치 순서대로 덧붙이는 연산입니다. 뒤 항은 첫 턴의 새 항목을 뜻하며, 부록 A는 각 항목을 정확히 한 번 추가하는 방식으로 인덱스를 명확히 합니다. 검색·Python 응답도 기존 메모리를 조건으로 처리하여 새 KV만 추가합니다.
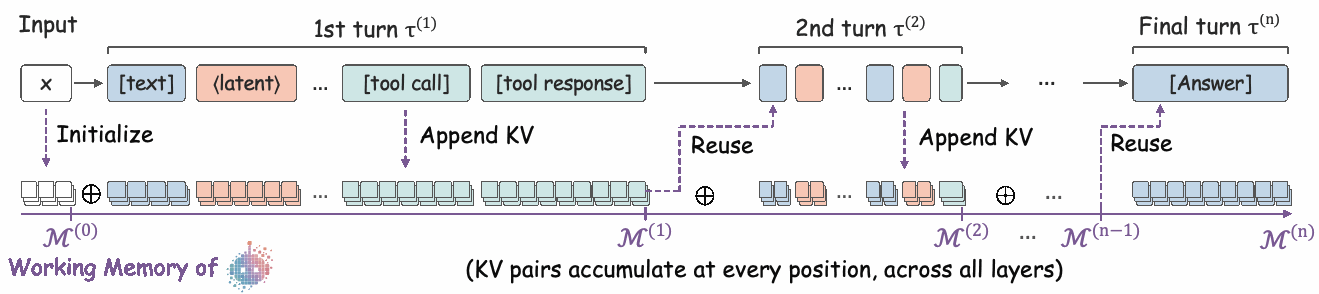
Figure 3, PDF 5쪽. 원문의 도식 영역을 크롭했으며 번역하지 않았습니다. 모든 층과 위치에서 생성된 KV를 다음 턴이 재사용합니다.
이 설계의 핵심은 과거 잠재 사고를 문자열로 재구성하지 않는다는 것입니다. 여기서 “lossless”는 완전한 KV와 동일한 추론 설정을 보존하면 전체 혼합 입력을 다시 계산한 것과 같은 후속 출력을 얻는다는 부록 A의 의미입니다. 기억 내용의 인간적 이해나 요약의 무손실성을 증명한 것은 아닙니다. 이 장이 실행 가능한 구조를 마련했다면, 다음 장은 그 구조를 안정적으로 사용하는 학습을 설명합니다. 원문 §3, 식 (4)–(6)
📖 Chapter 4: Learning to Perform Hybrid Reasoning
이 장은 사전학습을 처음부터 다시 하지 않고 기존 백본을 후학습하는 방법을 제시합니다. 4.1 Stabilize Generation via Hybrid Supervised Fine-tuning은 먼저 텍스트 기반 에이전트 시연을 혼합 궤적으로 주석화합니다. 외부 LLM의 판단과 대상 모델의 예측 엔트로피로 잠재 후보를 고르고, 도구 상호작용과 감사에 필요한 핵심 판단은 텍스트에 남깁니다. 자세한 절차는 부록 E에서 이어집니다.
다음은 Format and HybridLink Activation입니다. 형식 활성화에서 백본은 진입·종료 앵커가 있는 텍스트를 교차엔트로피로 학습합니다. 이어 백본을 고정하고 잠재 위치 은닉 상태를 정답 토큰의 입력 임베딩에 정렬하도록 HybridLink를 학습합니다. 원문 식 (7)은 다음과 같습니다.
$(x,y)$는 입력과 정답 시연, $h_{\mathrm{lat}}$는 잠재 위치의 은닉 상태, $y_{\mathrm{lat}}$는 그 위치의 정답 토큰입니다. 첫 회귀항은 벡터 방향을, 둘째 항은 크기를 포함한 유클리드 거리를 맞춥니다. 가중치는 각각 $\lambda_{\cos}=1.0$, $\lambda_{\mathrm{mse}}=0.2$입니다. 이 단계에서는 정답 임베딩을 입력으로 넣으므로, HybridLink 출력이 다음 입력이 되는 실제 실행을 아직 충분히 경험하지 못합니다.
Self-Conditioned HybridSFT는 이 차이를 두 번의 순전파로 줄입니다. 첫 번째는 정답 열을 입력으로 주는 teacher forcing이며, 잠재 위치의 은닉 상태를 HybridLink에 통과시켜 다음 위치용 입력을 만듭니다. 두 번째는 같은 열을 처리하되 잠재 위치의 정답 임베딩을 첫 순전파가 예측한 벡터로 바꿉니다. 두 번째 순전파에서 백본과 HybridLink를 함께 학습합니다. 식 (8)은 다음 합입니다.
이때 일반 텍스트 위치에는 교차엔트로피, 잠재 내부 위치에는 회귀 손실을 적용합니다. 진입·종료 앵커의 교차엔트로피와 종료 위치의 추가 회귀 감독은 부록 B.2에서 구체화됩니다. 두 순전파는 실행 시 모든 잠재 단계를 자유 생성하는 긴 순환을 그대로 펼친다는 뜻이 아니라, 자신의 예측 잠재 입력을 백본이 읽도록 만드는 자기 조건화 절차입니다.
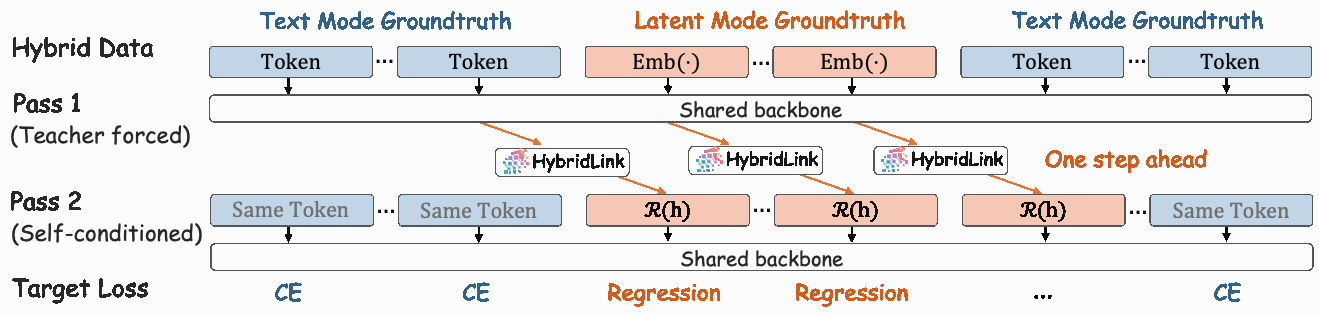
Figure 4, PDF 6쪽. 원문의 도식을 크롭했으며 번역하지 않았습니다. “One step ahead”는 첫 패스의 출력이 다음 위치 입력을 예측한다는 뜻입니다.
4.2 Scale Reasoning via Hybrid Reinforcement Learning은 혼합 궤적에서 정책 확률을 정의하는 문제로 시작합니다. PPO·GRPO의 토큰 중요도 비율은 보통 식 (9)처럼 계산합니다.
$\theta_{\mathrm{old}}$는 궤적을 생성한 정책, $\theta$는 갱신 중인 정책입니다. 잠재 위치에는 샘플링된 토큰이 없으므로 이 비율을 그대로 적용할 수 없습니다. 저자들은 Hybrid Policy Factorization으로 모델이 샘플링한 텍스트 위치에만 확률 인자를 둡니다. 명제 4.1의 식 (10)은 다음과 같습니다.
$\mathcal T$는 모델이 샘플링한 텍스트 위치 집합이며 도구 응답은 포함하지 않습니다. $\tau_{\lt t}$에는 앞선 텍스트·잠재 벡터·도구 관찰이 모두 들어갑니다. HybridLink가 고정되고 잠재 전이·비샘플링 모드 전이가 결정적이라는 조건에서 이 전이들은 확률질량 1로 취급됩니다. 따라서 “텍스트 위치에서만 손실을 계산한다”와 “텍스트만 보고 학습한다”는 다릅니다.
이어지는 Policy Update via Exact Rollout Replay에서는 궤적 생성 때 잠재 벡터와 텍스트·관찰을 함께 기록합니다. 갱신 때는 같은 잠재 입력을 바꾸지 않고 혼합 임베딩 열 전체를 한 번의 미분 가능한 순전파로 재생하여 텍스트 확률을 구합니다. HybridLink는 고정하고 백본은 학습합니다. 잠재 입력을 현재 백본으로 새로 생성하면 보상을 받은 원래 문맥이 달라지므로, 이 재생은 보상과 조건 문맥을 맞추는 역할을 합니다.
알고리즘 1은 문제 선택 → 그룹별 혼합 rollout 생성 → 잠재·텍스트·관찰 기록 → 보상과 그룹 정규화 advantage 계산 → 정확한 재생 → 중요도 비율 계산 → 정책 갱신의 순서입니다. Advantage는 같은 문제의 여러 후보 중 상대적으로 좋은 궤적에 더 큰 가중치를 주는 신호입니다. 원문 식 (11)의 보상은 다음과 같습니다.
정답 항은 과제에 따라 정답 검증 또는 token-level F1, 형식 항은 유효성 패널티, 도구 항은 Python과 검색을 모두 호출한 궤적에 주는 보상입니다. 잠재 모드 비율 자체에 대한 명시적 보상은 두지 않습니다. 다만 형식·데이터·구간 길이 경계가 존재하므로 전환 행태가 아무 제약 없이 학습된다고 설명해서는 안 됩니다. 이 장의 이론은 기록된 궤적의 재생과 rollout 정책 지점의 기울기에 관한 것이며, 부록 C에서 정확한 성립 범위를 확인합니다. 다음 장은 이 구조와 학습의 성능을 평가합니다. 원문 §4, 식 (7)–(11)·알고리즘 1
📖 Chapter 5: Empirical Evaluations
이 장은 먼저 과제·비교군·학습·실행 조건을 제시한 뒤 성능과 효율을 평가합니다. 수학은 AIME25·AIME26·MATH500, 지식 추론은 GPQA-Diamond·MedQA·MuSiQue, 에이전트 추론은 GAIA·HLE·WebWalker·SealQA·DSQA입니다. 비교군은 도구를 쓰는 텍스트 SFT 및 GRPO·ARPO, Coconut·SoftCoT·SoftThinking 같은 잠재 방식, 원문에 기재된 frontier LLM agents, ReAct·Search-o1·WebThinker입니다. 이름이 다른 비교군은 동일 학습 예산으로 재학습한 방법과 외부 모델을 포함하므로 한 종류의 통제 실험으로 묶을 수 없습니다.
Qwen3-Base 4B·8B·14B에 54K 혼합 궤적으로 SFT를 적용하고, 12K deep reasoning 예제와 1K agentic search 예제로 RL을 수행합니다. rollout 배치는 서로 다른 문제 64개에 후보 8개씩인 512개 궤적이며, 8개 미니배치를 한 번 순회합니다. rollout 온도는 1.0, 평가는 온도 0.6·top-p 0.95·top-k 20입니다. 검색과 Python을 사용하고 실험은 H100에서 다섯 독립 seed로 수행합니다. 수학용과 검색·에이전트용 RL 체크포인트는 부록 H.3에서 구분합니다.
5.1 Scaling Performance via Hybrid Reasoning의 Table 1은 8B·14B 에이전트 과제 결과를 제시합니다. 아래 값은 원문 표에서 직접 옮겼으며 단위는 %입니다. GAIA·WebWalker·HLE는 각 표의 Avg., SealQA는 두 split, DSQA는 완전 정답률과 F1입니다.
| 규모·방법 | GAIA | WebWalker | HLE | Seal-0 | Seal-Hard | DSQA 정답률 | DSQA F1 |
|---|---|---|---|---|---|---|---|
| 8B GRPO | 32.0 | 30.0 | 7.8 | 15.3 | 23.6 | 17.3 | 33.8 |
| 8B ARPO | 38.8 | 32.0 | 8.8 | 18.9 | 26.0 | 18.0 | 37.2 |
| 8B HybridAgent | 43.7 | 42.5 | 14.4 | 22.5 | 35.8 | 20.0 | 40.7 |
| 14B GRPO | 36.9 | 38.5 | 8.6 | 17.1 | 24.4 | 18.6 | 43.9 |
| 14B ARPO | 43.7 | 40.5 | 10.0 | 17.1 | 22.8 | 16.3 | 38.2 |
| 14B HybridAgent | 52.4 | 49.5 | 16.0 | 24.3 | 37.8 | 21.7 | 46.8 |
14B의 GAIA는 ARPO 대비 +8.7%p, WebWalker는 +9.0%p입니다. 그러나 Table 1의 모든 모델·모든 하위 지표에서 최고라는 뜻은 아닙니다. 예를 들어 14B DSQA 정답률 21.7은 표에 기재된 GPT-5.6-Luna 23.3보다 낮고, HLE 평균 16.0도 Kimi-K3 31.4보다 낮습니다. GAIA의 쉬운 Lv.1에서는 14B ARPO 56.4가 HybridAgent 53.8보다 높지만, HybridAgent는 Lv.2·Lv.3과 전체 평균에서 더 높습니다. 난도별 분포를 보아야 전체 평균의 의미가 드러납니다.
Table 2는 같은 백본과 학습 예산의 수학·지식 추론 비교입니다. AIME는 30문제를 각각 여러 번 샘플링한 avg@16 정확도이며 pass@16과 다릅니다.
| 규모·방법 | AIME25 | AIME26 | MATH500 | GPQA-D | MedQA | MuSiQue |
|---|---|---|---|---|---|---|
| 8B Text SFT | 30.0 | 28.3 | 78.2 | 32.3 | 69.7 | 23.5 |
| 8B HybridSFT | 30.8 | 29.2 | 78.4 | 31.8 | 70.0 | 26.5 |
| 8B GRPO | 36.3 | 39.4 | 82.0 | 43.9 | 74.3 | 27.5 |
| 8B ARPO | 37.1 | 41.5 | 82.8 | 46.5 | 74.7 | 28.5 |
| 8B HybridRL | 39.2 | 43.3 | 84.6 | 48.0 | 75.3 | 32.0 |
| 14B Text SFT | 30.8 | 31.7 | 83.8 | 43.9 | 78.0 | 28.0 |
| 14B HybridSFT | 32.5 | 31.7 | 84.2 | 45.5 | 78.7 | 29.5 |
| 14B GRPO | 40.8 | 42.5 | 87.4 | 52.5 | 81.0 | 32.0 |
| 14B ARPO | 42.1 | 43.3 | 87.0 | 54.0 | 80.3 | 31.5 |
| 14B HybridRL | 43.3 | 45.8 | 88.2 | 55.1 | 81.7 | 34.5 |
8B HybridSFT의 GPQA-D는 Text SFT보다 0.5%p 낮고, 14B AIME26은 같습니다. 따라서 SFT 단계가 모든 셀을 개선했다는 설명은 정확하지 않습니다. 반면 두 규모의 HybridRL은 이 표의 여섯 과제에서 GRPO·ARPO보다 높은 값을 기록합니다. 14B MATH500의 가장 높은 텍스트 비교값은 GRPO 87.4이므로, HybridRL 88.2의 차이는 +0.8%p입니다. ARPO만을 비교 기준으로 삼으면 +1.2%p가 되어 기준 선택의 영향도 확인할 수 있습니다.
저자들은 §5.1에서 가장 강한 agentic baseline 대비 14B 평균 17.4%, 대응하는 텍스트·잠재 비교군 대비 SFT 평균 18.5%, RL 평균 10.4% 개선이라고 보고합니다. 이는 서로 다른 집계 설명이며 퍼센트포인트가 아닙니다. 해당 문단에는 전체 집계의 셀 선택·가중·분모 계산식이 상세히 제시되지 않아, 이 글에서는 이를 저자의 집계치로 인용하고 개별 비교는 위 표의 %p로 따로 계산합니다. 초록의 10.4%를 모든 frontier 모델에 대한 일률적 개선으로 일반화하지 않습니다.
이어 Figure 5는 어려운 수학·과학 문제 100개에서 $k=4,8,16,32,64$의 pass@k를 평가합니다. pass@k는 여러 시도 중 정답을 하나 이상 얻는 성능으로, 단일 답 선택의 정확도가 아닙니다. 샘플을 늘릴 때 각 규모의 HybridAgent 성능이 상승하고 GRPO 텍스트 에이전트보다 더 큰 이득을 얻는 경향을 보고합니다. 이는 같은 샘플 수의 비교이며, 후보 하나당 계산량까지 같은 예산으로 정규화한 결과라고 덧붙이지 않습니다.
5.2 Efficiency Advantage on Hybrid Generation은 생성량·시간·연산 비용을 구분합니다. Figure 6의 회색 막대는 텍스트 기준의 토큰 수이고, 혼합 막대는 텍스트와 잠재 단계를 합친 수입니다.
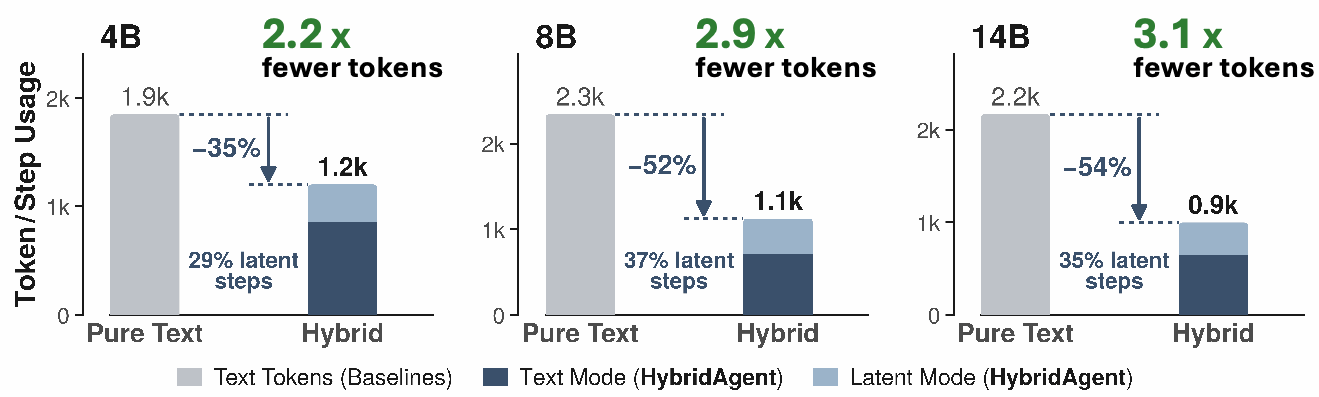
Figure 6, PDF 10쪽. 원문의 그래프를 크롭했으며 번역하지 않았습니다. 짙은 파랑은 텍스트, 옅은 파랑은 잠재 단계입니다. 아래 표는 그림의 반올림 표기를 그대로 옮겼습니다.
| 백본 규모 | 텍스트 기준 단계 | 혼합 전체 단계 | 전체 단계 감소 | 텍스트 토큰 감소 배수 | 혼합 중 잠재 단계 비율 |
|---|---|---|---|---|---|
| 4B | 1.9k | 1.2k | 35% | 2.2배 적음 | 29% |
| 8B | 2.3k | 1.1k | 52% | 2.9배 적음 | 37% |
| 14B | 2.2k | 0.9k | 54% | 3.1배 적음 | 35% |
초록의 35.5%–54.7% “token reduction”은 Figure 6에서 잠재 단계까지 센 전체 생성 단계 감소와 대응하는 범위로 읽어야 하며, 텍스트 토큰만의 감소율과 같지 않습니다. 그림의 값은 반올림되었으므로 표시된 k 단위 값으로 초록의 소수점 수치를 역산하지 않습니다. §5.2의 평균 2.7배 적은 텍스트 토큰과 최대 약 54% 적은 전체 단계도 이러한 구분 위에 있습니다.
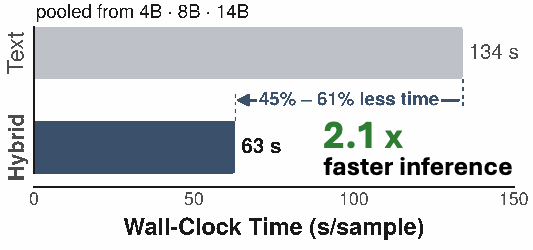
Figure 7, PDF 11쪽. 원문의 그래프를 크롭했으며 번역하지 않았습니다. 원문에 “pooled from 4B · 8B · 14B”라고 명시되어 있습니다.
Figure 7은 세 규모를 합친 텍스트 134초/샘플과 Hybrid 63초/샘플, 약 2.1배 빠른 추론을 보여 줍니다. 그림의 “45%–61% less time”은 초록의 약 1.8–2.6배 범위와 대응하지만 규모별 개별 초 단위 값은 그림에 나열되지 않습니다. 따라서 4B=1.8배, 14B=2.6배처럼 임의로 배정할 수 없습니다. 비용 2.7–3.7배는 별도의 Table 9 추정이며 부록 G.2에서 다룹니다. 이 장은 효용과 효율의 증거를 제시했고, 다음 장은 무엇이 그 결과에 기여했는지 검토합니다. 원문 §5, Tables 1–2·Figures 5–7
📖 Chapter 6: In-depth Analyses
이 장은 학습 동역학, 잠재 모드 개입과 구조, 텍스트 도구 사용과 감사 가능성 순으로 분석합니다. 6.1 Training Dynamics on HybridSFT and HybridRL의 첫 실험은 자기 조건화가 필요한지를 평가합니다. Table 3의 공통 Qwen3-14B-Base 결과는 다음과 같습니다.
| 단계 | AIME25 | AIME26 | MATH500 |
|---|---|---|---|
| 원래 백본 | 4.9 | 3.0 | 47.0 |
| 형식 활성화 추가 | 20.6 | 19.8 | 62.4 |
| HybridLink 활성화 추가 | 23.8 | 22.5 | 73.8 |
| 자기 조건화 추가 | 32.5 | 31.7 | 84.2 |
| Standard Text SFT | 30.8 | 31.7 | 83.8 |
자기 조건화는 HybridLink 활성화에서 다시 +8.7·+9.2·+10.4%p를 더합니다. 원문은 세 수학 과제의 평균 상대 개선을 30.5%라고 보고합니다. 활성화만으로 추론 시 자기 출력을 읽는 문제를 해결하지 못한다는 설계 동기를 뒷받침합니다. Figure 8에서는 200개 질문의 잠재 구간들을 평가하여 형식 활성화, HybridLink 활성화, 자기 조건화 순으로 읽기 쉬움과 질문 관련성이 개선되는 양상을 제시합니다. 본문의 이 소주제가 “Table 8”이라고 지칭하는 부분은 14B 활성화 실험인 실제 Table 3과 구분해야 하며, Table 8은 부록의 4B 결과입니다.
다음 Figure 9는 14B HybridRL 중 보상이 상승하면서 텍스트 생성이 잠재 쪽으로 이동하고 도구 사용도 증가하는 모습을 보여 줍니다. 모드 비율 보상이 없어도 이런 배분이 나타난다는 관찰이지만, 개별 곡선의 동반 변화를 곧바로 각 요인의 독립적 인과효과로 해석할 수는 없습니다. 이어 Table 4는 보상 항을 하나씩 제거하는 8B 통제 실험입니다.
| 보상 구성 | MATH500 | GAIA | WebWalker |
|---|---|---|---|
| 전체 HybridRL | 84.6 | 43.7 | 42.5 |
| 정답 보상 제거 | 79.2 | 35.9 | 37.5 |
| 형식 보상 제거 | 80.6 | 40.7 | 40.5 |
| 도구 보상 제거 | 84.2 | 38.8 | 41.0 |
정답 보상 제거는 세 과제 모두에 큰 영향을 주고, 형식 보상도 세 과제에 기여합니다. 두 종류 도구를 모두 써야 받는 도구 보상은 Python만으로 충분한 경우가 많은 MATH500에서는 0.4%p 차이지만, GAIA에서는 4.9%p 차이를 만듭니다. 호출 횟수 전체에 무조건 보상을 주는 설계로 읽으면 이 결과의 이유를 놓치게 됩니다.
6.2 Causal Reliance and HybridLink Design in Latent Mode는 먼저 잠재 계산이 실제 답에 쓰이는지를 개입으로 확인합니다. Table 5에서 상대 교란 크기는 원래 벡터 $v$와 개입한 벡터 $v'$에 대해 $d=\|v'-v\|/\|v\|$를 잠재 단계별 평균한 값입니다.
| 잠재 개입 | 교란 크기 d | 8B MATH500 | 14B MATH500 |
|---|---|---|---|
| 개입 없음 | 0.0 | 84.6 | 88.2 |
| Gaussian noise, 0.5 | 0.5 | 72.6 | 75.0 |
| Gaussian noise, 2.0 | 2.0 | 66.4 | 70.2 |
| 무작위 토큰 임베딩 교체 | 1.6 | 41.2 | 44.6 |
| 다른 문제의 잠재 구간으로 교체 | 1.4 | 44.8 | 48.6 |
| 평균 잠재 벡터로 교체 | 1.0 | 53.6 | 58.4 |
| 최근접 토큰 임베딩으로 교체 | 0.2 | 82.6 | 87.2 |
| 구간 내부 순서 무작위화 | 0.8 | 73.2 | 76.4 |
| 구간을 한 단계로 제한 | — | 72.2 | 75.0 |
| 잠재 모드 진입 차단 | — | 80.4 | 78.8 |
다른 문제의 구간으로 교체하면 더 큰 Gaussian noise보다도 정확도가 낮습니다. 저자들은 단순한 벡터 변화량 외에 내용의 의미, 순서, 충분한 계산 깊이가 기능적으로 중요하다는 근거로 해석합니다. 최근접 토큰 교체의 저하는 상대적으로 작아 판독 가능한 의미와 실제 계산의 연결을 뒷받침하지만, 원래 벡터와 완전히 동등한 결과는 아닙니다. 또한 이 개입의 성능 근거는 MATH500의 두 규모라는 평가 범위를 갖습니다.
두 번째 실험인 HybridLink Design은 같은 14B 설정에서 정렬 모듈 구조를 바꿉니다. 직접 은닉 상태 재사용, 1층, 1층+잔차, 2층, 2층+잔차 순으로 MATH500은 71.4·83.6·86.4·85.8·88.2, MedQA는 73.7·79.7·80.3·81.0·81.7, MuSiQue는 24.5·28.5·31.0·31.5·34.5입니다. 단순히 층을 늘리는 것뿐 아니라 잔차를 두는 것도 기여합니다. 예컨대 MATH500은 1층+잔차가 잔차 없는 2층보다 높습니다. 최종 2층+잔차는 세 과제 모두에서 가장 높아, 정렬과 의미 보존을 함께 추구한 설계를 뒷받침합니다.
6.3 Tool Use and Reasoning Auditability in Text Mode의 첫 분석은 텍스트 인터페이스의 도구 사용입니다. Figure 10은 8B·14B에서 유효 호출률이 높고, 유효 호출 중 오류 없이 실행된 비율은 99.7%로 텍스트 GRPO 에이전트와 같다고 보고합니다. 실행 성공의 분모는 모든 생성이 아니라 유효 도구 호출입니다. 도구를 최소 한 번 호출한 문제의 최종 답 정확도와, 결과에 최종 답이 포함된 호출의 비율도 평가합니다. 후자의 “useful” 정의는 최종 답 포함 여부이며 일반적인 도구 효용 전체를 측정하는 것은 아닙니다.
다음은 잠재 구간을 경계 표시 뒤에 숨기고 텍스트·도구 호출·도구 출력만 외부 평가자에게 보여 주는 실험입니다. 수학 560문제(MATH500 500개와 AIME25/26 각 30개)에서 감시, 첫 오류 진단, 수정 힌트의 효과, 최종 답을 지운 설명만으로 모델의 답을 예측하는 충분성을 비교합니다. 약한 감시·독자는 GPT-4o-mini, 강한 감시·진단자는 원문에 기재된 GPT-5.6-Luna입니다.
| Table 7 항목 | 8B Hybrid / Text | 14B Hybrid / Text |
|---|---|---|
| 예제당 보이는 텍스트 토큰 | 302 / 596 | 284 / 497 |
| 예제당 잠재 단계 | 170 / 없음 | 183 / 없음 |
| 보이는 100토큰당 핵심 단계 | 0.72 / 0.57 | 0.86 / 0.67 |
| 약한 감시 AUROC, MATH500 | 0.840 / 0.772 | 0.860 / 0.818 |
| 강한 감시 AUROC, 전체 과제 | 0.961 / 0.935 | 0.989 / 0.990 |
| 첫 오류 위치 정답률 | 99.2 / 94.2 | 98.1 / 100.0 |
| 진단의 기준 답 일치율 | 97.6 / 93.5 | 97.2 / 96.3 |
| 표적 힌트의 일반 재시도 대비 수정률 이득 | +9.1 / +3.4 | +5.4 / +3.5 |
| 텍스트만 본 답 일치의 이득 | +0.25 / +0.17 | +0.30 / +0.28 |
AUROC는 정답 궤적과 오답 궤적을 얼마나 잘 구별하는지 나타냅니다. 값이 높을수록 좋지만 정답률과 동일한 지표는 아닙니다. 8B Hybrid의 텍스트는 약 49%, 14B는 약 43% 적고 핵심 단계 밀도는 높습니다. 오류 위치 찾기와 진단도 높은 값을 보이나 모든 지표에서 우위는 아닙니다. 14B 강한 감시 AUROC와 첫 오류 위치 정답률은 텍스트 기준이 더 높습니다.
여기에는 원문 서술과 표의 불일치가 있습니다. §6.3은 감시 AUROC가 텍스트 기준과 “0.022 이내”라고 설명하지만, Table 7의 약한 감시는 8B +0.068, 14B +0.042, 강한 감시도 8B +0.026입니다. 이 글은 표의 수치를 우선하며 그 문장을 그대로 재현하지 않습니다. Table 7 캡션은 paired bootstrap 95% 신뢰구간으로 평가했다고 밝히지만 각 셀의 구간은 표에 제시하지 않습니다. 본문이 수정률 이득을 유의하다고 보고한다는 사실과, 독자가 표의 점추정치만으로 유의성을 독립 확인할 수 있다는 주장은 구분해야 합니다. 이 장의 기여는 적은 텍스트에서도 여러 감사 작업이 가능하다는 실험이며, 다음 장은 기존 연구와의 관계를 정리합니다. 원문 §6, Tables 3–7·Figures 8–10
📖 Chapter 7: Related Work
이 장은 먼저 Latent Reasoning Beyond Text를 정리합니다. 중간 사고를 은닉 공간으로 옮기는 방식에는 마지막 층 상태의 되먹임, 텍스트 추론 사슬의 잠재 표현 압축, 연속 궤적의 직접 최적화가 있습니다. 저자들은 이러한 연구가 추론 효율과 깊이를 높이는 한편 직접 관찰과 외부 상호작용에는 어려움이 있다고 설명합니다. HybridAgent의 차별점은 잠재 추론을 에이전트 생성의 내부 모드로 두고, 읽을 수 있는 판독과 텍스트 기반 행동을 함께 유지한다는 데 둡니다.
이어 Agentic Reasoning and Tool Use는 검색·코드 실행·API를 통해 정적인 답 생성 밖으로 나가는 에이전트와, 여러 턴의 도구 궤적을 학습하는 후학습을 다룹니다. 기존 프레임워크가 내부 추론과 환경 상호작용 모두를 텍스트로 표현한다는 점에 대비해, HybridAgent는 두 역할을 서로 다른 매체에 배분합니다. 이 비교는 원문이 인용한 연구들의 역할을 설명하는 것이며, 여기에서 참고문헌 전체를 독립적으로 재검증한 것은 아닙니다. 핵심 기여의 위치를 잡은 뒤 다음 장은 배포와 향후 시스템 구성으로 논의를 넓힙니다. 원문 §7
📖 Chapter 8: Discussion and Future Directions
첫 소주제는 Implications for Frontier Agent Safety and Secure Deployment입니다. 저자들은 고객에게 전체 사고 과정을 공개하지 않는 API 배포와 관련 연구의 암호화된 기록 재생 문제를 배경으로, 잠재 상태를 제공자 측에 두고 제공자 소유 HybridLink로 읽는 구상을 설명합니다. 사용자는 도구 호출·핵심 결정·최종 답만 받고, 제공자는 사용자에게 보이지 않는 부분을 포함한 판독으로 안전성을 감시할 수 있다는 주장입니다.
이 부분의 “누출될 텍스트가 없다”는 표현은 저자의 배포 구상과 주장으로 한정해야 합니다. 논문의 성능·판독·감사 실험은 제공자와 고객의 정보 경계를 겨냥한 형식적 보안 증명이나 공격별 유출 방지 성공률을 제시하지 않습니다. 또한 잠재 의사 텍스트의 직접 판독과 사용자에게 노출하는 텍스트 기록의 감사는 서로 다른 관찰 경로입니다. 앞의 실험에서 두 경로를 평가했다고 해서 모든 배포 환경의 안전성이 검증된 것으로 바뀌지는 않습니다.
두 번째 소주제 Future Directions on Hybrid Agent Harness and Efficient Post-Training는 저자가 명시한 후속 방향입니다. 작업 메모리를 일급 구성요소로 취급하는 harness, KV 항목을 직접 다루는 문맥 관리, 모드에 따른 단계 스케줄링, 에이전트 간 혼합 궤적 전달을 제안합니다. 또 외부 critic이 잠재 구간에 단계별 보상을 주고 유망한 궤적을 분기하거나 잘못된 궤적을 텍스트·도구 호출 전에 종료하는 후학습을 제안합니다. 이 항목들은 현재 실험에서 완료한 기능 목록이 아니라 향후 가능성입니다. 이 장이 시스템적 의미를 논의한 뒤, 다음 장은 논문 전체의 주장을 정리합니다. 원문 §8
📖 Chapter 9: Conclusion
결론은 효율적인 잠재 추론과 텍스트 기반 관찰·도구 상호작용을 하나의 프레임워크로 묶었다고 정리합니다. 구조 측면에서는 HybridLink와 다중 턴 작업 메모리, 학습 측면에서는 SFT와 RL의 전용 절차가 서로 보완합니다. 실험은 텍스트·잠재 방식과 에이전트 프레임워크 대비 성능을 평가하고 생성 시간·토큰 사용·연산 비용 감소를 제시합니다.
이 장에 별도의 새로운 실험이나 추가 한계 목록은 없습니다. 논문의 결론을 읽을 때 유지할 구분은 “언어를 넘어 계산한다”와 “언어를 전혀 쓰지 않는다”의 차이입니다. 실제 제안은 외부 행동과 관찰을 위해 텍스트를 계속 사용합니다. 이어지는 부록은 본문의 메모리 보존, 학습 조건, 분석 지표와 실험 설정을 구체화합니다. 원문 §9
Acknowledgments와 References의 위치와 역할: 원문은 결론 뒤에 감사의 글을 두어 Zou Lab·iDEA-iSAIL Lab 및 Stanford NLP Group·Together Agent Team 등의 토론과 지원을 언급하고, 이어 참고문헌에서 본문과 부록의 연구·데이터·평가 근거를 연결합니다. 이 둘은 별도의 방법·실험 장이 아니며, 그 뒤에 부록 A가 시작합니다. 이 리뷰는 참고문헌의 서지와 인용 역할을 확인했지만 인용된 논문 전체를 읽었다고 주장하지 않습니다. 원문 감사의 글·참고문헌
📖 Chapter A: Multi-turn Continuation over Working Memory
부록 A는 §3.2의 작업 메모리 재사용이 전체 혼합 prefix를 다시 계산하는 것과 같은지를 증명합니다. 입력 열을 $E_{\leq t}$, 모든 층의 KV를 $\mathcal M_t=[K_{\leq t},V_{\leq t}]$로 둡니다. 정리 A.1의 식 (12)는 다음 동등성입니다.
왼쪽은 저장된 KV를 사용한 다음 입력 계산, 오른쪽은 이전 혼합 입력 전체를 포함하는 순전파입니다. 고정된 백본과 HybridLink, 같은 인과 연산·마스크·위치 인코딩, 기존 KV의 완전 보존이라는 조건이 필요합니다. 따라서 KV 일부를 버리거나 위치를 바꾸어도 같다는 정리는 아닙니다.
증명은 입력 위치에 대한 귀납법입니다. 첫 입력에서 두 실행은 같은 query·key·value·attention을 계산하므로 모든 층의 출력과 메모리가 같습니다. $t$까지 저장된 KV가 전체 prefix 계산의 KV와 같다고 가정하면, $t+1$에서도 같은 입력과 마스크, 같은 과거 KV가 같은 attention을 만듭니다. 같은 논리를 층마다 적용하면 마지막 은닉 상태와 새 KV도 같아집니다. 업데이트는 다음과 같습니다.
여기서 새 KV는 정확히 한 번 추가됩니다. 턴 $j$의 끝 위치를 $t=|x|+\sum_{i=1}^{j}|\tau^{(i)}|$로 세면, 초기 문맥·텍스트·잠재·도구 관찰을 모두 포함하는 메모리가 됩니다. 턴 경계 자체가 계산을 바꾸지 않는 이유입니다.
마지막으로 같은 은닉 출력은 같은 텍스트 확률과 HybridLink 출력을 만듭니다. 텍스트 샘플링과 도구 실행에서 같은 난수 추출을 결합해 비교하면 이후 궤적도 단계별로 같고 생성 확률도 같습니다. 결정적 백본 연산이라는 증명 조건과 텍스트 샘플링의 확률성은 양립합니다. 이 부록의 기여는 “텍스트 복원 없이도 전체 혼합 이력의 후속 효과를 유지한다”는 실행 동등성이며, 다음 부록은 이 입력을 안정적으로 만드는 SFT 설계를 다룹니다. 부록 A, 정리 A.1·식 (12)
📖 Chapter B: Design and Analyses of Hybrid Supervised Fine-tuning
B.1 Why Self-Conditioned Training?은 활성화만으로 충분하지 않은 이유를 설명합니다. teacher forcing 중 백본이 받는 잠재 위치 입력은 정답 토큰 임베딩입니다. HybridLink 출력은 그 임베딩에 맞추어 학습되지만 실제 다음 입력으로 쓰이지 않습니다. 추론에서는 모든 잠재 입력이 자기 HybridLink 출력이므로, 작은 오차도 다음 은닉 상태와 입력으로 전달됩니다.
원문은 이를 exposure bias, 즉 정답 prefix로 학습하고 자기 예측 prefix로 실행할 때 생기는 차이와 연결합니다. 텍스트에서도 잘못된 토큰 선택이 이후 추론에 영향을 주지만, 재임베딩하면 항상 어휘 임베딩 집합 안의 벡터가 됩니다. 반면 연속 잠재 벡터는 그 집합으로 투영되지 않으므로 입력 표현 자체가 학습 때 본 정답 벡터에서 벗어날 수 있습니다. 여기서 텍스트 오류가 누적되지 않는다는 일반적 주장을 도출하는 것이 아니라, 연속 입력 공간에서의 이탈이 추가로 있다는 설명입니다.
두 패스 자기 조건화는 첫 패스가 만든 다음 위치 잠재 예측을 두 번째 패스에 넣어, 백본이 그것을 읽고 HybridLink가 그 조건에서 출력을 만드는 법을 함께 학습합니다. 논문은 두 요소를 따로 활성화한 부품에서 통합된 시스템으로 바꾸는 과정으로 설명합니다. Figure 11의 학습·추론 차이는 Figure 4의 두 패스 설계와 직접 연결됩니다.
B.2 Learning When to Enter and Exit Latent Mode는 경계 감독의 비대칭을 구체화합니다. 진입 앵커 <latent>는 텍스트 모드가 예측하는 교차엔트로피 목표입니다. 그 위치의 은닉 상태가 HybridLink를 거쳐 첫 잠재 입력을 만듭니다. 반대로 종료는 잠재 모드에 있으므로 토큰을 샘플링하지 않고 식 (5)의 최근접 임베딩으로 판단합니다.
종료 직전 잠재 단계는 양쪽에서 감독합니다. HybridLink의 회귀 목표는 </latent>의 임베딩이며, 단 한 번의 종료 신호가 긴 구간 내부에 묻히지 않도록 내부보다 조금 더 큰 가중치를 줍니다. 백본도 같은 은닉 상태에서 종료 토큰을 예측하는 교차엔트로피를 받습니다. 원문은 이 추가 가중치의 구체적 수치를 이 소절에 제시하지 않으므로 임의로 채우지 않습니다. 이 부록의 핵심은 “잠재 위치는 모두 회귀만 학습한다”는 단순화에서 경계 앵커를 구분하는 것이며, 다음 부록은 RL 확률과 기울기를 정식화합니다. 부록 B.1–B.2
📖 Chapter C: Theoretical Analyses of Hybrid Reinforcement Learning
C.1 Formulation of Hybrid Policy Factorization은 궤적을 $\tau=(z,y,o)$로 나눕니다. $z$는 잠재 입력, $y$는 샘플링된 텍스트, $o$는 환경 관찰입니다. 명제 C.1의 식 (13)은 본문 식 (10)을 다시 제시합니다. 고정된 정책과 실현된 이력을 조건으로 잠재 연속 입력 $\mathcal R(h_{t-1})$의 조건부 질량은 1이며, 비샘플링 모드 전이도 결정적입니다. 연쇄법칙에서 이 인자들이 1이 되어 샘플링된 텍스트 확률의 곱이 남습니다.
도구 관찰은 이후 결정의 문맥이며 에이전트가 출력한 행동의 likelihood 인자가 아닙니다. 이 명제는 잠재 표현을 새 독립 확률변수로 샘플링한다는 모델을 쓰지 않습니다. 또한 여기의 결정성은 잠재 전이와 비샘플링 전이에 관한 것이고, 진입 앵커를 포함한 텍스트 생성은 여전히 확률적일 수 있습니다.
C.2 Hybrid Policy Optimization은 rollout 정책에서 문제당 $G\geq2$개의 궤적을 수집하고, 그 보상에서 계산한 그룹 정규화 advantage $A_i$를 갱신 중 고정합니다. 식 (14)–(15)는 전체 혼합 이력을 조건으로 한 비율과 clipped 목적함수입니다.
$\mathcal T_i$는 궤적 $i$에서 샘플링한 텍스트 위치 집합입니다. 분모는 잠재·관찰을 포함한 전체 길이가 아니라 샘플링 텍스트 위치의 총수입니다. $\mathrm{clip}$은 비율을 $[1-\epsilon,1+\epsilon]$에 제한하며 $0\lt\epsilon\lt1$입니다. 손실 앞의 음수는 보상이 높은 방향의 목적을 최소화 문제로 표현합니다.
정리 C.3의 핵심 조건은 rollout의 잠재 입력과 도구 관찰을 기록하고 그대로 재생한다는 것입니다. 잠재 벡터는 이전 정책에서 얻었으므로 현재 파라미터로 미분할 때 다음이 성립합니다.
첫 식은 잠재 입력을 재생 중 새로 생성하거나 그 생성 경로를 미분하지 않는다는 뜻입니다. 둘째 식은 그 입력 열을 처리하는 은닉 상태가 여전히 백본 파라미터에 의존한다는 뜻입니다. 따라서 “잠재 위치를 학습하지 않는다”거나 “백본이 고정된다”는 결론은 틀립니다. 보상은 전체 혼합 문맥을 읽고 텍스트 출력을 만드는 백본에 학습 신호를 줍니다.
식 (17)은 기록된 궤적의 로그확률 기울기를 텍스트 위치의 합으로 표현합니다.
고정된 rollout 확률을 분모로 미분하면 $\nabla_\theta\rho=\rho\nabla_\theta\log\pi_\theta$입니다. 파라미터가 $\theta_{\mathrm{old}}$일 때 정확한 재생은 $\rho=1$을 재현하고, 1 근방에서는 clipping이 값을 바꾸지 않습니다. 이를 대입한 식 (16)이 다음 동등성입니다.
즉 텍스트 위치에서 누적한 기울기가 기록된 전체 혼합 궤적에 advantage를 부여한 기울기와 rollout 정책 지점에서 같습니다. 정리의 범위는 고정한 잠재 입력·관찰, 같은 prefix를 재현하는 조건, clipping이 국소적으로 항등인 지점입니다. 이를 모든 파라미터 갱신 후에도 새로운 잠재 rollout의 분포가 동일하다거나 전역 최적성이 보장된다는 주장으로 확대할 수 없습니다. 이 부록은 구현 목적함수의 국소 기울기 해석을 제공하며, 다음 부록은 추가 관련 연구를 배치합니다. 부록 C, 식 (13)–(17)·정리 C.3
📖 Chapter D: Extended Related Work
첫 주제 Adaptive Reasoning on Text and Latent Space는 추론의 길이와 매체를 적응적으로 정하는 연구입니다. 종료 시점 학습, 명시적 숙고 필요성 판단, confidence·entropy에 따른 전환이 포함됩니다. 저자들은 기존 방식이 한 번의 추론 또는 단일 턴 전환에 집중한 데 비해 HybridAgent는 잠재 문맥을 여러 턴에 전달하고 텍스트 도구 사용과 직접 판독을 유지한다고 설명합니다.
두 번째 Hybrid Communication among Agents는 한 에이전트 안의 추론과 에이전트 사이의 통신을 구분합니다. 관련 다중 에이전트 연구는 은닉 상태·KV 같은 조밀한 신호와 사람이 볼 수 있는 텍스트 약속·결정을 이중 채널로 전달합니다. HybridAgent는 이러한 통신 프로토콜과 상보적으로, 단일 에이전트의 생성 단계마다 내부 매체를 선택합니다. §8의 혼합 궤적 메시지 전달은 이 구분 위에서 제시한 향후 방향입니다.
마지막 KV-Cache Reuse는 기존 prefix·모듈 캐싱과의 관계입니다. 기존 최적화는 원칙적으로 텍스트에서 다시 인코딩할 수 있는 문맥의 KV를 재사용합니다. HybridAgent는 텍스트만으로 재구성할 수 없는 잠재 정보를 같은 KV 흐름에 보유한다는 점을 강조합니다. KV 캐시라는 부품 자체의 발명보다 혼합 이력의 지속 상태로 사용하는 역할이 차별점입니다. 다음 부록은 이 구조에 맞는 학습 데이터를 어떻게 만드는지 설명합니다. 부록 D
📖 Chapter E: Hybrid Data Curation
이 부록은 텍스트 시연을 54K 혼합 궤적으로 변환하는 네 단계를 원순서로 제시합니다. 먼저 Step Segmentation에서 결정적 절차로 원자적 추론 단위를 나누고 정확한 문자 오프셋을 기록합니다. 내용과 순서를 바꾸지 않고 어느 구간에 모드 주석을 붙일지 지정하기 위한 장치입니다.
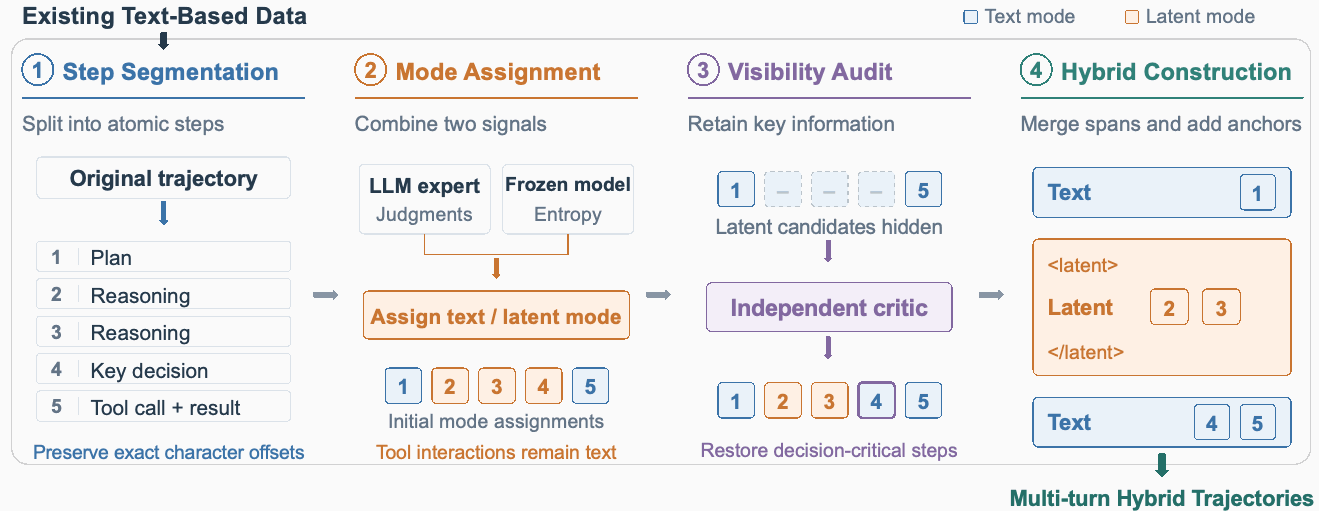
Figure 12, PDF 33쪽. 원문의 도식을 크롭했으며 번역하지 않았습니다. 마지막 가시성 검사는 잠재 후보를 가렸을 때 사라진 핵심 판단을 텍스트로 되돌립니다.
둘째 Mode Assignment는 원문에 기재된 GPT-6.1-Sol/GPT-5.6-Luna 전문가 판단과 고정된 대상 base 모델의 엔트로피를 함께 사용합니다. 각 단계 $s$의 평균 엔트로피는 식 (18)입니다.
$\mathcal I_s$는 해당 단계의 토큰 위치, $\mathcal V$는 어휘, 여기의 $f_\theta(v\mid\cdot)$는 어휘 투영과 softmax 뒤의 다음 토큰 확률입니다. 원래 텍스트 궤적을 frozen base 모델에 teacher forcing하여 계산합니다. 엔트로피가 낮은 단계는 모델이 비교적 확신하는 잠재 후보, 높은 단계는 텍스트 후보가 됩니다. 낮은 엔트로피가 정답임을 보증한다는 뜻은 아니며 최종 배정에는 별도 판단과 감사가 더해집니다.
셋째 Visibility Audit는 독립 critic에게 잠재 후보를 가린 기록을 보여 줍니다. 남은 텍스트와 도구 상호작용만으로 결정의 근거를 따라갈 수 없는 경우 원래 단계를 텍스트로 복원합니다. 이 과정은 관찰 가능성을 사후에 측정하기만 하는 것이 아니라 학습 데이터 구성에도 반영한다는 점에서 중요합니다. 다만 최종 모델이 모든 질문에서 같은 감사 가능성을 갖는다는 보증은 아니므로 §6.3의 별도 실험과 함께 읽어야 합니다.
넷째 Hybrid Trajectory Construction은 이웃한 잠재 단계를 하나의 구간으로 합치고 진입·종료 앵커를 넣습니다. 도구 호출·응답은 텍스트로 유지하며, 삽입한 앵커를 제거하면 원래 궤적과 바이트 단위로 같음을 검사합니다. 이 검사는 모드 주석이 원래 시연을 다시 쓰지 않았음을 확인하는 것입니다. 이 부록은 데이터가 모드 전환과 가시적 판단을 어떻게 가르치는지 설명했고, 다음 부록은 잠재 판독 평가의 정의를 제공합니다. 부록 E, 식 (18)·Figure 12
📖 Chapter F: Latent Interpretability Evaluation (Figures 2 and 8)
Probe Setup은 AIME25/26·MATH500·MuSiQue·GAIA·DSQA 등에서 가져온 200개 질문입니다. Figure 2는 4B·8B·14B 최종 HybridRL 체크포인트, Figure 8은 같은 14B 백본의 활성화·자기 조건화 변형과 Coconut을 비교합니다. 온도 0.6·top-p 0.95·top-k 20과 고정 seed를 사용합니다. 산점도 점 하나는 연속된 잠재 단계의 최대 구간이며, 고리는 구간별 점수 평균입니다. 따라서 200개의 질문이 반드시 200개의 점이라는 뜻은 아닙니다.
Readability는 식 (19)의 최근접 토큰 정렬 평균입니다.
$b$는 잠재 구간, $L_b$는 그 길이, $z_{b,t}$는 해당 잠재 입력입니다. 매 단계에서 가장 가까운 어휘 임베딩과의 코사인 유사도를 구해 평균합니다. 1은 모든 입력이 어휘 임베딩과 같은 방향이라는 “exact token” 기준입니다. 저자들은 Gaussian 무작위 벡터 2,000개에 같은 판독을 적용한 평균을 잡음 기준 $\tau_{\mathrm{noise}}$로 사용합니다. 이 수치는 문법·논리·사실성의 사람 평가가 아니라 기하학적 대리 지표라고 원문이 명시합니다.
Context Specificity는 의사 텍스트가 같은 과제의 다른 질문보다 자기 질문과 더 관련 있는 단어를 담는지 평가합니다. $P_b$는 최근접 토큰으로 읽은 구간, $W(s)$는 소문자화한 길이 3 이상의 영숫자 내용어 집합이며 불용어는 제거합니다. 집합 $A,B$의 Jaccard 겹침은 $J(A,B)=|A\cap B|/|A\cup B|$입니다. 식 (20)은 다음 비율입니다.
$q_{i(b)}$는 구간을 만든 원래 질문, $M\geq2$는 같은 과제의 질문 수입니다. 분자는 자기 질문과의 어휘 겹침, 분모는 나머지 질문과의 평균 겹침입니다. 분모가 양수일 때 정의하며, 내용어가 없는 판독은 제외하고 양의 점수를 로그 축에 표시합니다. 1보다 크면 자기 질문에 대한 상대적 어휘 관련성이 높습니다.
마지막 Meaningful Region은 $\mathrm{Read}(b)>\tau_{\mathrm{noise}}$이면서 $\mathrm{Spec}(b)>1$인 영역입니다. 두 축은 각각 토큰 정렬과 질문 관련성을 확인합니다. 이 실험이 지지하는 것은 읽을 수 있고 질문에 특이적인 판독의 존재입니다. 벡터의 모든 계산을 언어로 완전 복원했다거나 읽은 문장이 정답 원인의 충실한 설명이라는 등식은 이 지표 정의에 포함되지 않습니다. §6.2의 개입은 잠재 내용이 기능적으로 쓰인다는 별도 증거로 함께 보아야 합니다. 다음 부록은 작은 모델과 비용 결과를 추가합니다. 부록 F, 식 (19)–(20)
📖 Chapter G: Additional Experiments
G.1 Experiments on 4B-Scale HybridAgent는 Table 8의 네 과제를 제시합니다. 작은 모델에서 혼합 방식이 어떻게 동작하는지를 보며, 본문의 8B·14B와 같은 폭의 에이전트 평가를 추가한 것은 아닙니다.
| 4B 방법 | AIME25 | AIME26 | MATH500 | GPQA-D |
|---|---|---|---|---|
| Coconut | 10.6 | 13.3 | 40.6 | 17.2 |
| SoftCoT | 14.8 | 18.5 | 55.2 | 26.3 |
| Text SFT | 19.0 | 22.7 | 77.4 | 31.8 |
| HybridSFT | 22.5 | 23.3 | 76.8 | 30.8 |
| GRPO | 28.1 | 35.6 | 80.6 | 36.9 |
| ARPO | 31.3 | 36.3 | 81.8 | 38.4 |
| HybridRL | 35.2 | 37.5 | 82.2 | 40.9 |
HybridSFT는 두 잠재 비교군보다 모두 높지만, Text SFT 대비 MATH500과 GPQA-D는 각각 0.6·1.0%p 낮습니다. HybridRL은 네 항목 모두 ARPO보다 높습니다. 그 차이 +3.9·+1.2·+0.4·+2.5%p의 단순 평균은 +2.0%p로, 원문의 “평균 2.0 percentage points”와 일치합니다. 여기는 상대 개선율과 퍼센트포인트를 명확히 구분한 사례입니다.
G.2 Cost Analyses on HybridAgent는 같은 백본·문제·생성 예산·도구 한도에서 평균 단계 수로 decoding 연산을 추정합니다. 텍스트와 잠재 단계 모두를 백본 순전파 한 번으로 계산하고, 각각 어휘 투영 또는 HybridLink 비용을 더합니다. 잠재 계산을 무료로 처리하는 모델이 아닙니다.
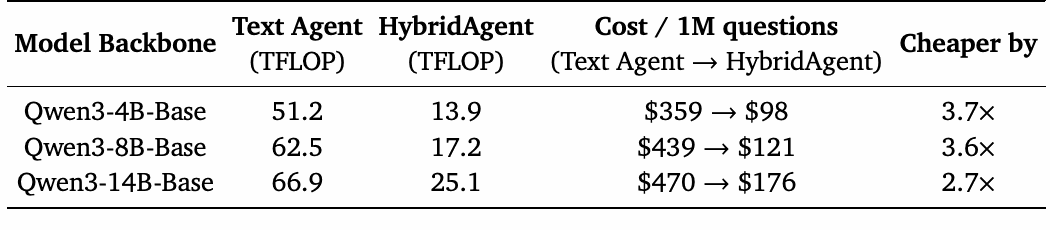
Table 9, PDF 35쪽. 원문의 표 본체를 크롭했으며 번역하지 않았습니다. 조건은 본문과 아래 표에서 함께 설명합니다.
| 백본 | Text TFLOP/문제 | Hybrid TFLOP/문제 | Text 비용/100만 문제 | Hybrid 비용/100만 문제 | 비용 감소 배수 |
|---|---|---|---|---|---|
| Qwen3-4B-Base | 51.2 | 13.9 | $359 | $98 | 3.7배 |
| Qwen3-8B-Base | 62.5 | 17.2 | $439 | $121 | 3.6배 |
| Qwen3-14B-Base | 66.9 | 25.1 | $470 | $176 | 2.7배 |
금액은 H100 시간당 $2.50, BF16 최대 처리량의 10% 활용률, 약 $0.007/PFLOP를 가정합니다. 저자들이 명시한 제외 범위는 prompt prefill, 문맥 길이에 따른 attention, 외부 도구 실행입니다. 따라서 이 값은 서비스 전체 청구 비용이 아니며, 검색 페이지 요약 모델까지 포함한 end-to-end 금액이라고 사용할 수 없습니다. 표의 TFLOP 감소율은 4B 약 72.9%, 8B 약 72.5%, 14B 약 62.5%로 원문의 62.5%–72.9%와 일치합니다. 반올림된 비용으로 배수를 재계산하면 미세하게 달라질 수 있습니다.
이 부록의 기여는 작은 백본에서도 학습 이득이 나타남을 보이고, 효율을 생성 연산의 단위와 가정으로 환산한 것입니다. 다음 부록은 이러한 결과를 얻은 데이터·학습·실행 조건을 자세히 기록합니다. 부록 G, Tables 8–9
📖 Chapter H: Experiment Setups
H.1 Benchmark and Evaluation Details는 원문 순서대로 세 종류 과제를 설명합니다. 수학의 AIME25·AIME26은 각각 30문제이고, MATH500은 7개 수학 주제와 5개 난도의 500문제입니다. 작은 AIME 집합에는 avg@16을 사용합니다. 이 조건은 문제 수를 16배 늘린 새로운 독립 문제 집합과 같지 않습니다.
지식 추론의 GPQA-Diamond는 생물·물리·화학 전문가 작성 198문제, MedQA는 이 논문 설정에서 300문제, MuSiQue는 2–4-hop 연결 추론을 평가하는 200개 test 질문입니다. MedQA의 300은 이 논문에서 설명한 평가 범위로 읽으며 전체 원천 데이터셋 규모로 일반화하지 않습니다. MuSiQue는 단일 passage의 단서만으로 중간 연결을 건너뛰기 어렵게 만든 다중 홉 과제라는 역할을 갖습니다.
에이전트 과제는 GAIA의 3단계 난도, HLE의 고급 학문 문제, 하위 웹페이지를 찾아야 하는 WebWalker, 잡음·충돌·도움이 적은 검색 결과를 다루는 Seal-0·Seal-Hard, 분산된 정답 집합을 모으는 DSQA 순입니다. Table 1의 HLE 하위 열은 NS/CE/SF라는 원문 표기를 사용합니다. DSQA는 전체 정답 집합을 맞힌 비율과 부분적 정밀도·재현율을 반영한 F1을 함께 보고하므로 두 숫자를 같은 정확도로 취급해서는 안 됩니다. 이 소절은 모든 에이전트 평가의 실제 샘플 수를 나열하지는 않습니다.
H.2 Baseline Details는 네 범주를 구분합니다. Text SFT는 같은 데이터·백본으로 학습하고 도구를 사용할 수 있습니다. GRPO는 별도 critic 없이 그룹 보상으로 학습하며, ARPO는 entropy 기반 적응 rollout과 단계별 advantage를 사용합니다. 이 두 방법은 HybridRL과 같은 RL 데이터·백본으로 학습합니다. 이 통제 비교가 외부 frontier 모델보다 학습 설계의 효과를 읽기에 직접적입니다.
잠재 비교군의 Coconut은 마지막 은닉 상태를 되먹이는 단계적 커리큘럼입니다. SoftCoT는 고정 assistant가 만든 질문별 soft thought를 학습 가능한 투영으로 대상 모델 공간에 옮기고 assistant와 대상 LLM은 고정합니다. SoftThinking은 어휘 확률 가중 임베딩 혼합을 다음 입력으로 씁니다. 따라서 “모두 동일한 잠재 알고리즘”으로 합칠 수 없습니다. 원문은 가능한 경우 같은 백본·학습 설정·예산을 적용한다고 설명합니다.
이어 frontier 비교군은 원문에 기재된 GPT-5.6-Luna, Kimi-K3, GLM-5.3-Flash, DeepSeek-V4.1-Flash, QwQ-32B입니다. 이는 논문이 평가한 모델명이며 이 글이 현재 제품의 사양이나 순위를 별도로 확인한 것은 아닙니다. ReAct·Search-o1·WebThinker 프레임워크는 모두 Qwen3-14B를 백본으로 두고 같은 도구 접근·사용 예산을 적용합니다. 프레임워크 간 동일 백본 비교와 서로 다른 frontier 모델 비교를 구별해야 합니다.
H.3 Implementation Details는 학습 세부부터 설명합니다. HybridSFT는 형식 활성화·HybridLink 활성화·자기 조건화를 각각 1 epoch씩 수행합니다. 최대 길이는 16,888, 유효 배치는 16, 백본 학습률은 $7\times10^{-6}$입니다. HybridLink 학습률은 활성화 $2\times10^{-4}$, 자기 조건화 $5\times10^{-5}$, weight decay 0, warmup 비율 0.1, cosine 스케줄입니다. 앞서 설명한 방향/거리 손실 가중치는 1.0/0.2입니다.
| HybridRL 조건 | Agentic Search, Table 11 | Deep Reasoning, Table 12 |
|---|---|---|
| 초기화 | 8B·14B HybridSFT | 4B·8B·14B HybridSFT |
| 문제 수 × rollout 수 | 64 × 8 = 512 | 64 × 8 = 512 |
| 미니배치·최적화 | 8개, 1회 순회 | 8개, 1회 순회 |
| 학습 단계 | 150 | 200 |
| 정답 보상 | token-level F1, 0–1 | Math Verify, 0 또는 1 |
| 형식 보상 | 0 또는 -1 | 0 또는 -1 |
| 도구 보상 | +0.1 | +0.1 |
| rollout당 도구 호출 한도 | 10 | 5 |
| 잠재 구간 최소·최대 | 16 / 256 | 16 / 256 |
두 RL 설정 모두 온도 1.0·top-p 1.0, 최대 길이 16,888, 백본 학습률 $10^{-6}$, 상수 스케줄, weight decay 0.01, AdamW $\beta=(0.9,0.95)$, KL 계수 0입니다. 수학 평가에는 deep reasoning 체크포인트, 지식 검색·에이전트 평가에는 agentic search 체크포인트를 사용합니다. 따라서 Table 2의 모든 열이 하나의 동일 RL 체크포인트 결과인 것처럼 설명하지 않습니다.
추론은 온도 0.6·top-p 0.95·top-k 20입니다. 텍스트와 잠재를 함께 센 생성 한도는 수학·지식 검색 4,096단계, 어려운 에이전트 과제 24,000단계입니다. 일반 추론 설명의 도구 한도는 10이고, 위 deep reasoning의 5는 RL 학습 표의 조건입니다. 검색은 top-10, 학습 검색 표에는 각 결과 1,000문자 한도가 있습니다. 원문은 검색 페이지 요약과 LLM judge로 GPT-5.6-Luna를 사용하며, 학습·추론 전체를 32 H100에서 수행했다고 기록합니다. 백본 규모만으로 전체 검색 시스템의 외부 모델 사용을 생략해서는 안 됩니다.
마지막 Infrastructure and Configurations는 verl·vLLM을 확장한 실행기를 설명합니다. 공통 루프가 텍스트·잠재·도구 상태를 조율하고, 각 궤적의 KV를 유지합니다. 도구 응답은 기존 문맥에 이어 처리하며 과거 이력을 다시 prefill하지 않습니다. 배치 안에서 서로 다른 상태의 궤적을 추적하고, 대기·완료 궤적은 생성에서 마스킹하며 도구는 동시에 실행합니다. 궤적별 attention mask와 위치를 보존하고, RL에서는 변경 전 정책에서 rollout·replay의 log-probability 일치를 검사합니다. 데이터 병렬화, optimizer state 분할, mixed precision, gradient checkpointing, 재개 가능한 체크포인트를 사용해 백본 전체를 최적화합니다. 실행기 변경의 설명과 실제 배포 엔진이 그대로 지원한다는 주장은 다르며, 다음 부록은 이 실행의 입력 규약을 제시합니다. 부록 H, Tables 10–12
📖 Chapter I: Prompt Template
이 부록은 HTML에서 이미지로 제시된 프롬프트를 PDF 41–42쪽에서 확인할 필요가 있습니다. 첫째 HybridAgent Training and Inference 프롬프트는 매 라운드를 <think>로 시작하고, 이를 닫은 뒤 검색·Python·최종 답 중 하나를 출력하도록 합니다. 잠재 구간은 think 내부에만 허용하며 routine planning·recall·restatement·double-checking을 맡깁니다. think의 시작과 끝에는 짧은 텍스트 판단을 남겨 다음 행동으로 이어지는 결정이 보이도록 지시합니다.
도구 결과 <result>는 시스템이 넣으며 모델이 직접 쓰면 안 됩니다. 결과가 비었거나 오류·호출 한도 통지이면 같은 호출을 반복하지 말고 접근을 조정하거나 최선의 답을 내도록 합니다. 최종 답은 <answer> 안의 LaTeX boxed 형식입니다. 이 프롬프트는 눈에 보이는 판단을 남기는 동작이 데이터 주석과 학습뿐 아니라 추론 지시에도 포함되어 있음을 보여 줍니다.
둘째 Downstream LLM Judge는 문제·정답·예측을 주고 의미와 핵심 정보가 일치하면 Correct, 아니면 Incorrect를 내도록 합니다. 셋째 LLM-Guided Hybrid Data Annotation은 단계별로 latent=0/text=1을 부여합니다. 도구 호출·응답·최종 답 및 핵심 중간 결정을 text로 남기되, 나머지 내부 계획·불필요한 반복은 latent를 선호하도록 합니다. 각 단계의 이유, 누락 없는 라벨 수 확인, 최종 JSON 배열의 순서로 출력합니다.
이 부록의 기여는 모드 배분이 추상적인 설명에만 머물지 않게 입력·출력 규약을 제공한다는 점입니다. 프롬프트의 도구 사용 지시나 예제 코드를 이 리뷰에서 실행한 것은 아닙니다. 다음 부록은 이 규약 아래 생성된 세 가지 실제 사례를 보여 줍니다. 부록 I, PDF 41–42쪽
📖 Chapter J: Case Study of HybridAgent
마지막 부록도 HTML 본문 추출만으로 내용이 보이지 않는 사례 그림이므로 PDF 43–45쪽을 직접 확인했습니다. 첫 Mathematical Reasoning — MATH500 사례는 원 $x^2+y^2=25$를 점 $(4,1)$에 대칭 이동한 자취의 계수를 구합니다. 잠재 판독은 점대칭 $(x_2,y_2)=(8-x_1,2-y_1)$를 사용해 $(x_2-8)^2+(y_2-2)^2=25$를 얻고, 텍스트는 핵심 전개와 검산 결정을 노출합니다. 첫 Python 호출은 solve를 import하지 않아 NameError로 실패합니다. 다음 턴의 텍스트가 오류를 진단하고 import를 수정하여 도구 응답을 받은 뒤 $(a,b,c,d)=(1,-16,-4,43)$으로 답합니다. 이 사례는 처음부터 오류가 없는 실행이 아니라 도구 오류를 관찰하고 고친 다중 턴입니다.
둘째 Knowledge-Intensive Reasoning — MuSiQue는 온도에 따른 복사 곡선의 peak 관계를 발견한 인물의 분야를 묻습니다. 초반에는 Planck를 떠올리지만 검색 결과에서 Wien의 변위 법칙과 Wilhelm Wien을 찾고, 추가 검색으로 물리학자임을 확인하여 Physics로 답합니다. 잠재 의사 텍스트에는 반복이나 어색한 표현도 그대로 보입니다. 성공 사례를 제시하면서도 판독이 언제나 매끄러운 자연어라는 식으로 다시 쓰지 않는 것이 중요합니다. 관찰 가능한 핵심은 검색 결과가 들어온 뒤 인물 추정이 수정되는 과정입니다.
셋째 Agentic Reasoning — GAIA는 같은 부피의 꿀·마요네즈에서 꿀을 한 컵씩 얼마나 덜어야 더 가벼워지는지 묻습니다. 검색 뒤 사례는 밀도 1.42와 0.91g/mL, 1갤런 약 3785.41mL, 1컵 약 236.588mL를 사용합니다. 잠재 판독은 꿀의 초기 질량 5375.2822g, 컵당 335.95496g, 마요네즈 3444.7231g으로부터 제거 컵 수가 약 5.74648보다 커야 한다고 계산합니다. 텍스트는 이 부등식과 Python 검산 결정을 보이며, Python은 6컵이면 충분하고 5컵이면 부족함을 확인합니다. 최종 답은 6입니다.
세 사례는 수학 전개, 검색을 통한 수정, 검색과 수치 계산의 결합이라는 서로 다른 역할을 보여 줍니다. 이는 원문이 선택한 정성 사례이며 전체 실패 빈도나 일반적 오류 회복률의 추정치는 아닙니다. 특히 GAIA의 표시된 검색 발췌에는 부정확한 밀도 문장도 들어 있으므로 이 사례를 외부 근거 검증이 완전하다는 증거로 바꾸지 않습니다. 이 부록으로 원문의 본문과 A–J 부록에 대한 순서별 검토를 마칩니다. 부록 J, PDF 43–45쪽
실험 결과 심층 분석
비교의 중심은 같은 백본·데이터·학습 예산의 텍스트 SFT/GRPO/ARPO입니다. 이 비교에서 HybridRL은 Table 2의 8B·14B 여섯 과제와 Table 8의 4B 네 과제에서 높은 점추정치를 보입니다. 반면 HybridSFT는 텍스트 SFT와 비슷하거나 일부 항목에서 낮습니다. 따라서 아키텍처를 추가하기만 하면 모든 과제가 개선된다는 결론보다, 자기 조건화와 RL을 거친 최종 시스템이 어느 조건에서 이득을 얻는지를 보는 편이 근거에 충실합니다. Table 3의 단계별 실험과 Table 4의 보상 제거 실험이 이 해석을 보완합니다. Tables 2–4·8
숫자의 단위도 다릅니다. 14B GAIA 43.7→52.4는 +8.7%p, 상대적으로 약 19.9% 개선입니다. 이 계산 하나가 원문의 전체 평균 17.4% 또는 10.4%를 대신하지는 않습니다. 4B ARPO 대비 네 과제 평균 +2.0%p는 표에서 재계산할 수 있지만, §5.1의 전체 요약에는 같은 수준의 집계 계산식이 제시되지 않습니다. 외부 frontier 모델 비교에서는 일부 지표 우세와 일부 열세가 공존하므로 “10.4% 우수한 14B 모델”처럼 단일 순위로 바꾸지 않습니다.
통계 정보는 보고되어 있습니다. Table 1은 5개 독립 실행에서 HybridAgent 정확도의 평균 표준편차 ±0.014와 95% CI ±0.017, Table 2는 수학 ±0.031·검색 ±0.018의 평균 표준편차와 각각 ±0.038·±0.022의 95% CI를 보고합니다. 표의 성능값은 %로 제시되지만 이 통계는 원문처럼 정확도 비율 단위로 인용하면 각각 1.4·1.7%p, 3.1·1.8%p, 3.8·2.2%p에 대응합니다. 이는 과제별·방법 쌍별 구간을 모두 제시한 것과 다릅니다. Table 7은 paired bootstrap 95% CI 평가를 명시하되 표에 개별 구간을 싣지 않습니다. 모든 개선에 대한 개별 유의성 검정 결과는 논문에 보고되지 않았습니다. 평균 CI만으로 모든 셀의 차이가 유의하다고 판정할 수 없습니다. Tables 1–2·7
효율은 네 층위로 읽어야 합니다. Figure 6의 텍스트 토큰 감소는 눈에 보이는 생성량, 잠재를 포함한 단계 감소는 백본 반복 수, Figure 7은 실제 실행의 벽시계 시간, Table 9는 명시된 연산·가격 가정의 추정치입니다. 잠재 단계도 백본을 계산하고, Table 9는 prefill·문맥 attention·도구 실행을 제외하므로 단계 감소율·시간 배수·비용 배수가 서로 같을 이유는 없습니다. 또한 검색 요약과 판정에 외부 모델을 사용한 실험 설정을 고려해야 전체 시스템의 자원 범위를 이해할 수 있습니다. §5.2·부록 G.2·H.3
재현성 관점에서 원문은 데이터 변환 순서, 프롬프트, 손실, 모드 경계, 하이퍼파라미터, 체크포인트 선택과 인프라 변경을 제공합니다. 초록과 PDF는 코드·데이터 저장소를 공개 링크로 제시합니다. 이 리뷰는 해당 저장소를 별도로 실행하거나 결과를 재현하지 않았습니다. 원문이 명시하지 않은 세부 집계·개별 신뢰구간은 미보고로 남기며, 이를 곧바로 방법 자체의 결함이라고 단정하지 않습니다.
기술적 함의와 응용
원문이 직접 보여 주는 성과는 추론의 매체와 행동의 인터페이스를 분리하면서도 같은 이력 위에서 연결할 수 있다는 것입니다. HybridLink는 입력 표현을, 작업 메모리는 시간에 걸친 문맥을, HybridSFT는 자기 생성 잠재 입력에 대한 적응을, HybridRL은 기록된 궤적에 대한 보상 학습을 맡습니다. 이 네 요소를 함께 보아야 단순한 토큰 절약 기법 이상의 시스템 설계를 이해할 수 있습니다.
리뷰어의 해석으로는 검색과 계산을 오가는 에이전트에서 어떤 정보를 텍스트로 드러낼지 자체가 데이터·학습·실행 규약의 설계 문제가 된다는 점이 중요합니다. 실제 적용을 판단할 때는 16–256단계의 잠재 구간, 지속 KV와 위치 추적, 도구 대기 상태 관리, 잠재 문맥의 정확한 재생을 지원하는 실행기가 필요하다는 원문 조건을 함께 보아야 합니다. 논문의 평가가 수학·의학·검색을 포함한다는 사실은 각 산업 현장의 배포 성능이나 안전성을 검증했다는 뜻은 아닙니다.
향후 방향은 저자가 §8에서 제시한 범위로 한정됩니다. 잠재 메모리를 직접 관리하는 harness, 모드에 따른 스케줄링, 에이전트 간 혼합 궤적 전달, 잠재 구간을 읽는 critic의 단계별 보상·분기·조기 종료입니다. 현재 결과는 읽을 수 있는 판독과 압축된 텍스트 기록의 감사 가능성을 함께 시험했다는 데 의의가 있습니다. 그 근거는 기하학적 정렬·질문 특이성·잠재 개입·수학 과제의 외부 감시라는 각 평가의 범위 안에서 해석해야 합니다. §8·부록 F
검토 범위: 버전 고정 HTML과 PDF의 본문 1–9, 모든 소절, 부록 A–J를 반영했습니다. 부록 I·J의 이미지형 프롬프트와 사례는 PDF에서 확인했습니다. 참고문헌 전체의 원 논문과 공개 구현을 독립적으로 검증하지는 않았습니다. 논문에는 별도로 이름 붙인 한계 절이 없으며, 위의 지표 범위·미보고 정보·원문 내부 서술 불일치는 확인한 자료의 범위를 설명하기 위해 구분했습니다. arXiv 서지의 DOI는 10.48550/arXiv.2610.18861이며 초록 페이지는 이를 arXiv-issued DOI와 등록 대기 상태로 표시합니다. 별도의 출판 DOI는 이 원문에서 확인하지 않았습니다. 버전 고정 초록·서지