논문 개요와 전체 구조
에이전트가 실패를 회고하여 새로운 규칙을 저장했다면, 다음에는 더 잘할 것이라고 기대하기 쉽습니다. 그러나 SQL 과제를 위해 만든 규칙이 API 사용 과제에 끼어들거나, 새 업무의 처리 절차가 이전 업무의 지침을 덮어쓴다면 어떨까요? 모델의 가중치를 바꾸지 않아도 에이전트는 이전에 익힌 행동을 잊을 수 있습니다. 이 논문은 이 문제를 지속학습(continual learning)의 관점에서 측정합니다.
대상은 Are Self-Evolving Agents Continual Learners?의 arXiv 2610.25858v1입니다. Xiaoyin Chen 외 6인이 작성했으며, arXiv 최초 제출일은 2026년 10월 19일입니다. PDF 첫머리의 날짜는 10월 20일로, 제출일과 구분합니다. 연구진은 Gemini 3.6 Flash의 가중치를 고정하고, 기억 검색을 사용하는 ReasoningBank, 공유 프롬프트를 고치는 GEPA, 프롬프트·기억·스킬·제어 코드를 수정하는 Meta-Harness를 비교합니다. 여기서 harness는 모델을 감싸며 행동과 문맥을 구성하는 실행 장치 전체를 뜻합니다.
핵심 질문은 최종 점수가 올랐는지가 아니라, 새 과제를 배우면서 아직 만나지 않은 과제와 과거 과제의 능력도 유지했는가입니다. SQL, 상태를 가진 API, 텍스트 과학 실험으로 네 가지 분포 변화 상황을 구성하고, 학습 능력인 plasticity와 능력 보존인 stability를 분리합니다. 이 연구는 새로운 에이전트 알고리즘을 제안하는 논문보다, 기존 자기진화 방법의 학습 양상을 진단하는 실험 연구에 가깝습니다. 원문 §1–3
원문의 구조와 상세 리뷰 순서는 다음과 같습니다.
| 원문 순서 | 세부 구성과 역할 |
|---|---|
| 1 Introduction | 지속적으로 바뀌는 업무와 자기진화 에이전트의 연구 질문 |
| 2 Background | 2.1 Continual Learning over Task Streams → 2.2 Nonparametric Self-Evolving Agents |
| 3 Methodology | 3.1 Task Stream Configurations → 3.2 Metrics |
| 4 Experiments | 4.1 Experimental Setup → 4.2 가소성·안정성 절충 → 4.3 자기수정의 간섭·덮어쓰기 → 4.4 검색의 간섭·충돌 |
| 5 Related Work | Self-evolving agents → Continual learning |
| 6 Conclusion | 관찰한 현상과 저자의 결론 |
| References | 관련 연구의 서지 목록 |
| Appendix A | Results on the Interleaved Mixture Stream |
| Appendix B | Per-Group Continual Learning Decomposition and Evolved Prompts |
| Appendix C | Similarity and Cross-Group Retrieval under ReasoningBank |
| Appendix D | Implementation Details: seed harness → retrieval → Meta-Harness proposer |
| Appendix E | Seed System Prompt and Environment Preambles → E.1 사용자 메시지와 BIRD·BFCL·ScienceWorld 인터페이스 |
핵심 기여와 혁신성
첫 번째 기여는 자기진화를 지속학습 문제로 정식화한 것입니다. 하나의 고정된 업무에서 반복 개선하면 충분했던 기존 평가와 달리, 이 연구에서는 하나의 공유 harness가 성격이 다른 업무를 순차적으로 처리합니다. 새로운 경험으로 harness를 고친다는 사실만으로, 그 변화가 다른 업무에도 도움이 된다고 보지 않습니다.
두 번째 기여는 전체 성능을 학습·간섭·망각으로 분해한 평가입니다. 최종 평균이 양수여도 특정 업무에서 얻은 향상이 이후에 소실될 수 있습니다. 또한 아직 학습하지 않은 업무의 점수도 기존 수준 아래로 내려갈 수 있습니다. 연구진은 두 현상을 각각 post-block forgetting과 pre-block interference로 구분합니다. 원문 §3.2
세 번째 기여는 점수와 실제 상태 변화를 연결한 분석입니다. GEPA의 프롬프트에서 이전 규칙이 차지하는 문자 비중, BFCL의 추가 질문 비율, ReasoningBank가 다른 업무의 기억을 가져오는 비율을 함께 측정합니다. 이를 통해 프롬프트 압축·규칙 반전·검색 충돌이라는 구체적 작동 원리를 드러냅니다. 기억을 따로 저장하는 방식도, 질문이 비슷하지만 필요한 행동이 반대이면 안전하지 않다는 점이 중요합니다.
리뷰어 해석: 에이전트의 개선을 “기억이 더 많아졌다” 또는 “최종 평균이 올랐다”로만 판단하기 어렵다는 연구입니다. 학습한 규칙이 어디에 저장되고 어느 요청에 적용되는지까지 평가 단위에 포함했다는 데 데이터과학적 학습 가치가 있습니다. 논문이 실제로 검증한 범위는 선택한 세 방법과 네 스트림이며, 모든 기억 시스템에 대한 보편적 불가능성 증명으로 확대해서는 안 됩니다.
기술적 세부사항
가중치와 harness를 나누어 생각하기
논문의 식 (4)–(5)는 경험을 이용한 정책 갱신을 정의하고, 가중치를 고정하는 경우 이를 harness 갱신으로 좁힙니다.
$x_\tau$는 입력 과제, $y_\tau$는 행동과 관찰을 포함한 전체 실행 궤적, $r_\tau$는 성공이면 1, 실패이면 0인 보상입니다. $\mathcal H_t$는 시점 $t$까지의 경험이며, $f$가 이 경험과 현재 harness $c_t$로 다음 harness를 만듭니다. 실제 방법은 전체 경험이 아니라 일부를 사용할 수도 있습니다. 모델 가중치 $\theta$가 같아도 $c_t$가 바뀌면 에피소드 수준 정책 $\pi_{\theta,c_t}$의 행동이 바뀝니다.
| 방법 | 바꾸거나 누적하는 상태 | 다음 과제에 적용되는 방식 |
|---|---|---|
| ReasoningBank | 에피소드에서 정리한 외부 기억 | 현재 질문과 cosine similarity가 가장 높은 기억 한 개를 주입 |
| GEPA | system prompt의 공유 strategy 영역 | 수정된 지침이 모든 후속 실행에 적용 |
| Meta-Harness | prompt, memory·skill 파일, harness.py 제어 코드 |
검증에 통과한 workspace 변경을 후속 실행이 공유 |
세 방법은 같은 seed harness에서 출발합니다. 실험 표의 수치는 각 방법의 seed 평가값을 기준으로 뺀 percentage points(pp., 퍼센트포인트)이며, 별도 평가로 추정한 기준 정확도를 모든 실험에서 하나의 상수처럼 취급하지 않습니다. 원문 §2.2, §4.1
최종 점수와 보존 능력의 차이
$A[t,k]$는 시점 $t$의 harness를 고정한 뒤 업무군 $k$의 별도 평가 집합에서 얻은 정확도입니다. 기준값은 $B_k=A[0,k]$입니다. 식 (7)은 성공 보상의 기대 평균으로 정의하며, 본문과 표에서는 이를 정확도 %로 표시합니다. 아래 차이와 지표는 그 % 스케일에서 계산한 pp.입니다.
식 (8)의 $K$는 업무군 수, $M$은 seed 이후 평가 체크포인트 수, $t_m$은 각 체크포인트, $T$는 마지막 위치입니다. Term.은 마지막 상태만, $\bar\Delta$는 중간 상태까지 평균합니다. 잠깐 좋아졌다가 나빠진 경우와 늦게 좋아진 경우를 구분하여 읽는 데 필요합니다.
업무군 $k$의 학습 블록을 $\sigma_k<t\leq\tau_k$라 하면 식 (9)–(11)은 다음과 같습니다.
$P$는 각 업무군을 학습한 블록 종료 시점의 seed 대비 향상입니다. 블록 시작 직전 점수를 빼는 정의가 아니라는 점에 주의해야 합니다. $I_k$는 해당 블록 이전에 seed보다 낮아진 정도의 평균이고, $M_k$는 그 이전 체크포인트 수입니다. $F_k$는 블록 종료 뒤 마지막까지 잃은 점수입니다. 이전 체크포인트가 없으면 $I_k=0$, 마지막 블록이면 $F_k=0$으로 둡니다. 향상은 음의 손실로 상쇄하지 않도록 두 손실에 $\max(0,\cdot)$를 적용합니다. 따라서 안정성 $S$는 0이 가장 좋고, 더 음수일수록 손실이 큽니다. 원문 식 (7)–(11)
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 에이전트가 배포 후에도 새 지식과 도구를 받아들여야 한다는 문제에서 시작하여, 가중치가 고정된 자기진화가 그 요구를 충족하는지 묻습니다.
- 업무가 바뀌는 속도와 가중치 갱신의 간극을 먼저 설명합니다. 매 상호작용 뒤 모델을 다시 학습시키는 것은 비용이 크며, 소수의 최근 경험에 대한 미세조정은 기존 능력을 훼손할 수 있습니다. 저자는 다음 세션부터 경험이 반영되어야 하는 사용 시간 규모에 주목합니다.
- 이어 in-context learning을 이용하여 가중치 대신 harness를 바꾸는 접근을 소개합니다. 자기수정은 프롬프트나 코드를 다시 쓰고, 경험 증강은 회고·궤적·스킬을 외부 저장소에 쌓아 필요할 때 가져옵니다. 두 방식 모두 업무 사이에 남는 상태를 형성합니다.
- 다음으로 단일 도메인 성능이 지속학습을 입증하지는 않는다고 설명합니다. 특정 업무의 출력 형식이나 행동 순서를 익힌 변화가 다른 업무의 요구와 충돌할 수 있기 때문입니다. 하나의 공유 harness에서 모든 후속 과제에 변화가 적용된다는 점이 핵심입니다.
- 마지막으로 네 가지 drift, 세 가지 방법, 가소성과 안정성을 소개한 뒤 세 발견을 제시합니다. 학습 능력과 보존 능력의 절충, 공유 상태의 간섭과 덮어쓰기, 비슷한 질문에 대한 기억 검색 충돌이 뒤의 실험을 조직합니다.
챕터의 핵심 기여: “자기진화가 성능을 높이는가”를 “서로 다른 업무에 걸쳐 유용한 능력을 누적하는가”로 구체화합니다. 다음 챕터로의 연결: 이 질문의 입력·정책·경험·업데이트를 수학적으로 정의합니다. 원문 §1
📖 Chapter 2: Background
챕터의 위치와 역할: 변화하는 과제 분포와 자기진화 연산을 같은 틀에 놓습니다. 배경 정의는 이후 실험의 측정 대상이 무엇인지 결정합니다.
2.1 Continual Learning over Task Streams
저자는 먼저 하나의 task family를 입력 공간, 입력 분포, 출력 공간, 보상 함수의 묶음으로 정의합니다. 여기서 출력은 답변 문장만이 아니라 환경에서 수행한 전체 에피소드입니다. 여러 업무군을 받는 스트림은 식 (1)의 혼합 분포로 표현합니다.
$\mathcal D_k$는 업무군 $k$의 입력 분포, $w_{t,k}$는 시점별 비중입니다. 이 비중이 바뀌면 모델이 만나는 업무도 바뀝니다. 정책은 입력을 받아 실행하고 보상을 관측한 뒤 다음 정책으로 갱신됩니다.
그다음 식 (2)는 모든 업무군에서의 기대 보상을 균등 평균하고, 식 (3)은 그 값을 전체 학습 시간에 걸쳐 평균합니다. 중요한 점은 현재 학습 중인 업무만 평가하지 않는다는 것입니다. 이미 배운 업무가 나빠지면 이후 시점에도 전체 목적값을 낮춥니다. 새 업무에서만 잘하는 변화는 지속학습의 충분조건이 되지 않습니다.
2.2 Nonparametric Self-Evolving Agents
이어서 evolver $f$를 현재 정책과 축적한 경험에서 다음 정책을 만드는 함수로 정의합니다. 연구 범위에서는 모델 가중치가 고정되어 있으므로, 업데이트는 앞에서 살펴본 $c_{t+1}=f(c_t,\mathcal H_t)$로 줄어듭니다. 초기 harness가 seed 정책을 정하고, 이후에는 경험을 받는 순서대로 harness가 달라집니다.
식 (6)은 이 evolver가 만든 정책들의 성능을 스트림과 evolver의 확률성에 대해 평균합니다. 기존 단일 업무 자기진화는 업무군 수가 하나인 특수한 경우로 해석됩니다. 여러 업무군으로 확장하면 어떤 경험으로 바꾼 상태가 다른 업무에 어떻게 작용하는지 확인해야 합니다.
챕터의 핵심 기여: 가중치 업데이트가 없어도, 유지되는 harness 상태와 그 변화는 지속학습의 분석 대상임을 명확히 합니다. 다음 챕터로의 연결: 일반적인 혼합 분포를 연속 블록 형태로 구체화하고 평가 지표를 정의합니다. 원문 §2, 식 (1)–(6)
📖 Chapter 3: Methodology
챕터의 위치와 역할: 어떤 변화를 학습자에게 주고, 그 영향을 어느 시점에서 측정할지 정합니다.
3.1 Task Stream Configurations
각 블록에서는 하나의 업무군만 도착하고, 경계에서 업무군이 바뀝니다. 이전 업무는 새로운 피드백을 받지 않으며, 이후 업무는 아직 관측되지 않았습니다. 연구진은 내용만 바뀌는 topic, 요구 행동이 바뀌는 workflow, 도구·관찰 공간까지 바뀌는 domain, 이들이 연달아 나타나는 compound drift를 구분합니다.
각 방법은 전체 구간 동안 하나의 공유 harness를 유지합니다. 업무군 라벨과 블록 경계는 에이전트에 알려주지 않으며, drift가 있다는 사실이나 업무군 간 균형을 유지하라는 지침도 주지 않습니다. 구분이 필요하면 입력과 경험에서 스스로 추론하여 harness에 표현해야 합니다. 이 조건은 연구자가 알고 있는 평가용 업무군과 에이전트가 실제 받는 정보를 분리합니다.
3.2 Metrics
저자는 매 업데이트마다 전수 평가하는 비용을 피하기 위해 체크포인트를 둡니다. 각 상태를 고정하여 별도 hold-out 집합의 정확도 $A[t,k]$를 추정하고, seed의 $B_k$를 뺍니다. 마지막의 Term.과 중간을 포함한 $\bar\Delta$를 먼저 제시한 뒤, 같은 평균 향상이 서로 다른 학습·손실 조합에서 나올 수 있다고 지적합니다.
그다음 앞서 해설한 $P$, $I_k$, $F_k$, $S$를 정의합니다. 예를 들어 한 업무군이 자기 블록 끝에서 seed보다 15.5pp. 높고 마지막에는 2.5pp. 높다면, 최종 향상은 양수이지만 블록 이후 망각은 13.0pp.입니다. 이는 실제 GEPA workflow drift 결과와 일치하는 지표 적용입니다.
$I_k$와 $F_k$는 다른 시점을 봅니다. 아직 배운 적 없는 업무가 나빠진 것은 앞선 규칙의 간섭이고, 자기 블록에서 얻었던 능력을 나중에 잃은 것은 망각입니다. 두 현상을 모두 포함하는 안정성은 순방향 전이나 다른 업무의 향상으로 손실을 지워 버리지 않습니다.
챕터의 핵심 기여: 순차적 경험의 효과를 최종 점수 하나로 압축하지 않고, 학습 전·학습 직후·전체 종료를 구분하는 평가 틀을 제공합니다. 다음 챕터로의 연결: 정의한 업무 변화와 지표를 실제 벤치마크에 적용합니다. 원문 §3
📖 Chapter 4: Experiments
챕터의 위치와 역할: 공통 실험 조건에서 전체 결과를 제시한 다음, 자기수정과 기억 검색의 서로 다른 실패 메커니즘을 순서대로 분석합니다.
4.1 Experimental Setup
Datasets and streams. BIRD는 관계형 데이터베이스의 text-to-SQL, BFCL은 상태를 가진 API를 사용하는 다중 턴 요청, ScienceWorld는 텍스트 환경에서의 과학 실험입니다. 모든 업무군은 50개 훈련 과제를 받습니다. 평가 집합은 훈련과 분리된 업무군당 50개이며 ScienceWorld만 90개입니다.
| 변화 | 업무군이 도착하는 원래 순서 | 전체 훈련 과제 수 / 업무군 수 |
|---|---|---|
| Topic | BIRD-F1 → BIRD-Code → BIRD-TP | 150 / 3 |
| Workflow | BFCL-Miss → BFCL-Base | 100 / 2 |
| Domain | ScienceWorld → BFCL-Base → BIRD-F1 | 150 / 3 |
| Compound | BIRD-Code → BIRD-F1 → BFCL-Miss → BFCL-Base | 200 / 4 |
Topic에서는 SQL이라는 큰 작업은 같지만 데이터베이스 스키마와 관례가 달라집니다. Workflow에서는 API 목록과 도메인이 같아도 행동 규칙이 반대입니다. BFCL-Miss는 빠진 인자를 사용자에게 물어야 하고, BFCL-Base는 이미 필요한 인자가 있으므로 불필요한 질문을 하면 감점됩니다. Domain은 관찰·행동 공간을 바꾸고, compound는 SQL 주제 변화 뒤 API 도메인과 workflow 변화까지 연결합니다.
Model and harness. 모든 방법에 Gemini 3.6 Flash와 관찰·행동을 교대하는 ReAct 형태를 사용합니다. 모델 변경의 효과와 harness 변경의 효과를 분리하기 위한 조건입니다.
Self-evolving algorithms. ReasoningBank는 에피소드를 기억으로 정리하여 가장 비슷한 항목 하나를 가져옵니다. GEPA는 수집한 실행을 성찰하여 공유 strategy를 수정합니다. Meta-Harness는 coding agent가 workspace 변경을 제안하고, 활성 sub-block의 검증 정확도가 개선될 때만 이를 받아들입니다. 모든 run은 비어 있는 상태의 같은 seed에서 시작하고 성공 여부의 이진 피드백을 받습니다.
Evaluation protocol. 50개 과제마다 블록 경계의 harness를 저장하고 모든 업무군의 hold-out을 평가합니다. 정확도는 각 평가 과제를 8번 rollout한 평균으로 추정합니다. 50개 평가 과제의 업무군은 체크포인트당 400회 실행에 해당하지만, 이를 400개의 서로 다른 문제라고 해석하지 않습니다. 원문 §4.1
4.2 Current Methods Trade Stability for Plasticity
아래 그림은 색으로 업무군을, 배경색으로 현재 학습하는 블록을 표시합니다. 자기 업무의 블록에서 올라간 곡선이 이후에도 유지되는지, 아직 학습하지 않은 곡선이 먼저 내려가는지를 함께 읽어야 합니다.
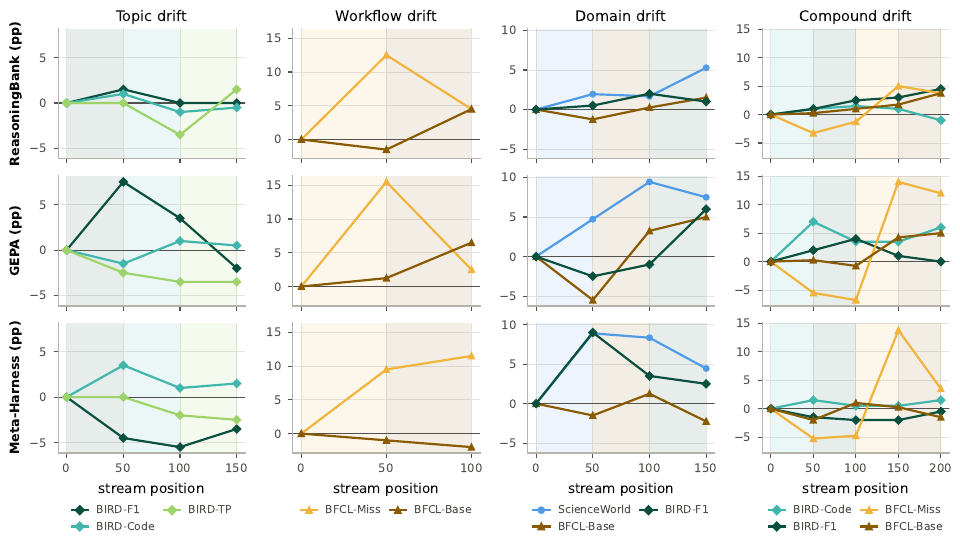
원문 Figure 1, PDF 8쪽. 그림 영역 크롭, 내용·패널 순서 변경 없음. 곡선의 단위는 pp.이며 작은 눈금은 원본 이미지로 확대해 확인할 수 있습니다. 고정 버전 원문, CC BY 4.0.
먼저 전체 성능은 대체로 개선됩니다. 아래는 Table 1의 네 스트림 평균을 옮긴 것입니다. 각 수치는 각 방법의 seed 대비 pp.이고, 안정성은 0에 가까울수록 좋습니다.
| 방법 | 최종 향상 Term. | 시간 평균 향상 | 가소성 P | 안정성 S |
|---|---|---|---|---|
| ReasoningBank | +2.5 | +2.0 | +3.3 | −1.9 |
| GEPA | +3.7 | +3.1 | +6.2 | −4.3 |
| Meta-Harness | +1.4 | +1.8 | +2.2 | −2.1 |
GEPA는 모든 drift에서 가장 높은 P를 얻지만 평균 S는 가장 낮습니다. 공유 프롬프트의 변화가 해당 업무군 전체에 넓게 적용되어 학습 효과가 큰 반면, 다른 업무에도 같은 변화가 적용되기 때문입니다. ReasoningBank는 검색한 에피소드에만 기억을 주입하여 변화가 국소화되고, 안정성 손실이 더 작지만 가소성도 낮습니다.
Meta-Harness는 더 넓은 수정 자유도를 갖지만 모든 조건에서 더 잘 학습하지는 않습니다. Topic과 workflow에서 안정성 손실이 작은 이유는 검증 gate가 후보 변경의 절반 이상을 거절하여 나중 블록에서 workspace가 거의 고정되기 때문이라고 저자는 분석합니다. 매 체크포인트에서 최선의 후보를 무조건 수용하도록 gate를 제거하면 S는 topic에서 −0.3 → −3.1pp., workflow에서 −0.5 → −5.5pp.로 낮아집니다. 변화하지 않아 보존한 경우와, 새것을 배우면서 보존한 경우를 구분해야 합니다.
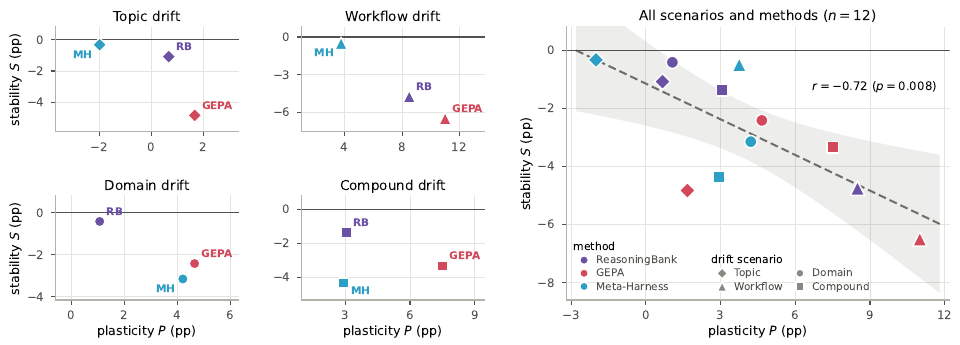
원문 Figure 2, PDF 9쪽. 그림 영역 크롭, 내용 변경 없음. 오른쪽은 4개 조건 × 3개 방법의 12점과 회귀선·95% 신뢰구간입니다. 고정 버전 원문, CC BY 4.0.
Figure 2에는 r = −0.72, p = 0.008이 보고되어 있습니다. 이는 해당 12개 방법·조건 조합에서 P와 S의 음의 상관관계에 관한 값입니다. 개별 방법 간 정확도 차이가 유의하다는 검정 결과와 같은 의미가 아닙니다. 원문 §4.2, Table 1, Figure 2
4.3 Self-Modification Causes Cross-Task Interference and Overwriting
Pre-block interference from task-specific rules. 공유 프롬프트나 workspace에 쓴 지침은 아직 만나지 않은 업무에도 적용됩니다. Domain drift에서 ScienceWorld를 학습한 뒤 BFCL-Base의 정확도는 seed보다 GEPA에서 5.5pp., Meta-Harness에서 1.5pp. 낮아집니다. Compound의 두 SQL 블록 직후에도 BFCL-Miss가 각각 6.8pp., 4.8pp. 낮아집니다. 부록 Figure 6의 실제 프롬프트에는 SQLite 탐색과 검증 절차가 전역 지침으로 들어 있어, 인자를 물어야 하는 API 업무에서도 탐색 도구 호출로 기울어집니다.
Post-block forgetting via compression and overwriting. 다음으로 저자는 이미 배운 업무를 잊는 경로를 추적합니다. Topic drift에서 GEPA의 BIRD-F1 규칙 문자 비중은 100% → 75.2% → 40.2%로 줄고, 해당 업무의 seed 대비 이득은 +7.5 → +3.5 → −2.0pp.로 내려갑니다. Compound에서는 두 SQL 블록 뒤의 일곱 SQL 절이 3,386자였으나 BFCL-Miss 블록에서 1,034자의 단일 절로 압축됩니다. BIRD-F1 규칙 비중은 59.5% → 5.8% → 4.1%로 줄고, 자기 블록 끝의 +4.0pp. 이득은 마지막에 0.0pp.가 됩니다.
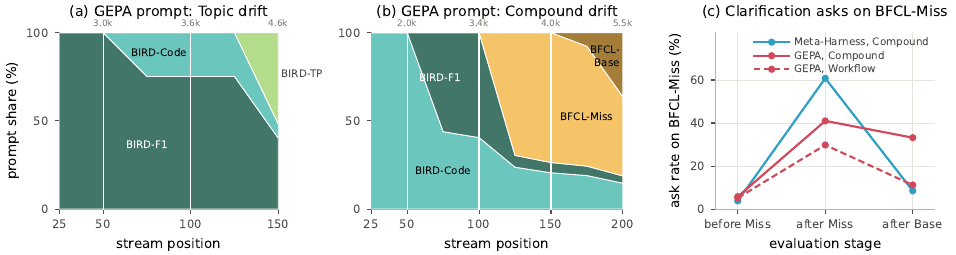
원문 Figure 3, PDF 10쪽. (a) topic, (b) compound의 프롬프트 구성, (c) BFCL-Miss의 질문 행동을 원래 패널 순서대로 크롭했습니다. 수치 변경 없음. 고정 버전 원문, CC BY 4.0.
Spontaneous additive updates across distant domains are fragile. 덮어쓰기가 언제나 생기는 것은 아닙니다. Domain drift에서는 GEPA가 기존 ScienceWorld 여섯 절을 그대로 두고 BFCL·BIRD 절을 덧붙입니다. 전략 길이는 4,372 → 5,650 → 7,621자로 늘고 평균 post-block forgetting은 0.0pp.입니다. 그러나 같은 방법이 compound의 도메인 전환에서는 SQL 절을 압축합니다. 저자는 이 추가형 보존 행동이 안정적으로 나타나지 않는다고 설명합니다. 프롬프트가 길어진다는 사실 자체가 망각 방지를 보장하는 결과는 아닙니다.
Behavioral reversal under conflicting workflows. 마지막 분석은 같은 API에서 “물어야 한다”와 “곧바로 실행해야 한다”가 뒤집히는 경우입니다. Workflow의 GEPA는 BFCL-Miss 학습 뒤 질문 비율이 29.8%(119/400 rollout)가 되지만, BFCL-Base를 배운 뒤 11.2%(45/400)로 내려갑니다. BFCL-Miss의 정확도 이득도 +15.5 → +2.5pp.로 줄어 13.0pp.를 잃습니다. Compound의 Meta-Harness에서는 질문 비율이 60.8% → 8.5%(34/400)로 낮아지고 정확도가 10.2pp. 떨어집니다. 위치 175에서 prompt·memory·skill의 관련 지침을 즉시 도구 실행 쪽으로 덮어쓴 변경과 연결됩니다. 원문 §4.3, Figures 3·6–8
4.4 Similarity-Based Retrieval Cannot Prevent Interference or Collision
Domain separation prevents post-block forgetting. ReasoningBank는 공유 프롬프트를 덮어쓰지 않습니다. Domain drift에서는 업무군 내부 최근접 질문 유사도가 약 0.80–0.95, 다른 도메인 사이가 약 0.57–0.63으로 분리됩니다. 자기 업무의 기억이 쌓인 뒤에는 다른 도메인 기억이 검색되는 비율이 0%이며, 평균 post-block forgetting도 0.0pp.입니다.
Pre-block interference from foreign memory retrieval. 그러나 자기 업무의 기억이 아직 없으면 가장 가까운 항목도 다른 업무의 기억입니다. 이 구현은 유사도 임계값 없이 top-1을 항상 주입하므로, 해당 블록 이전 평가에서는 외부 업무 기억 비율이 100%입니다. Domain의 BFCL-Base는 ScienceWorld 기억을 받아 seed보다 1.2pp. 낮아집니다. Compound의 BFCL-Miss도 SQL 회고를 받아 최대 3.2pp. 낮아집니다. 임계값이 무조건 검색을 줄일 수 있다는 저자의 논의와, 실제로 임계값을 사용한 실험을 혼동해서는 안 됩니다.
Retrieval collision when similar queries require conflicting workflows. 더 어려운 경우는 BFCL의 두 workflow입니다. 서로 다른 그룹 사이의 평균 pairwise cosine similarity는 0.667로, 각 그룹 내부 0.666·0.664와 비슷합니다. 최근접 유사도도 그룹 간 0.835–0.840, 내부 0.834–0.837로 겹칩니다. 질문의 주제와 표현만으로는 빠진 인자가 있는지에 따른 행동 적합성을 분리하기 어렵습니다.
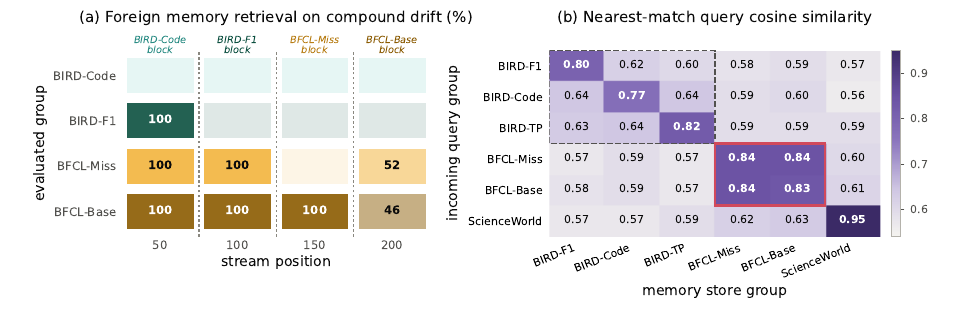
원문 Figure 4, PDF 11쪽. 원래 (a) 검색 비율과 (b) 유사도 행렬을 함께 크롭했으며 축·범례·패널 순서를 보존했습니다. 고정 버전 원문, CC BY 4.0.
마지막에는 BFCL-Miss 평가의 52%가 BFCL-Base 기억을, BFCL-Base의 46%가 BFCL-Miss 기억을 가져옵니다. Workflow에서 ReasoningBank의 BFCL-Miss 이득은 +12.5 → +4.5pp.로 줄어 8.0pp.를 잃습니다. 저장된 기억을 삭제하지 않았는데도, 현재 요청에 맞지 않는 기억이 선택되어 행동상 망각이 나타난 것입니다. 이 실험에서 cosine similarity가 포착하는 주제 유사성과 절차 호환성이 다르다는 것이 저자의 결론입니다. 원문 §4.4, Figure 4, Table 4
챕터의 핵심 기여: 결과표의 손실을 전역 규칙 적용, 문자 수준의 압축·덮어쓰기, 명확화 행동 반전, 기억 선택 충돌과 연결합니다. 다음 챕터로의 연결: 이 관찰이 자기진화와 지속학습 연구 중 어디에 해당하는지 정리합니다.
📖 Chapter 5: Related Work
챕터의 위치와 역할: 앞서 평가한 방법이 속한 연구 계열과 지속학습의 평가 배경을 연결합니다.
- Self-evolving agents: 저자는 먼저 자기수정과 경험 증강을 다시 구분합니다. GEPA·TextGrad·PromptBreeder는 프롬프트 수정, ADAS·Darwin Gödel Machine·EvoTest·Meta-Harness 등은 코드까지 포함한 수정으로 소개합니다. Reflexion·ExpeL의 회고, Voyager의 스킬, ReasoningBank·MemGen·Mem0의 기억은 외부 저장소를 활용하는 계열에 놓습니다. 이어 SCoRe·TTRL·TTT-Discover·LSE처럼 가중치나 학습된 evolver를 다루는 접근과, 이 연구의 비모수적 범위를 구분합니다.
- Continual learning: 과거 업무 성능을 잃는 catastrophic forgetting과 이를 줄이는 가중치 보호·경험 재생·업데이트 조정 계열을 설명합니다. 본 연구의 P와 S는 지속학습의 기존 평가를 에이전트에 맞게 적용한 것입니다. 업무 경계를 알려주지 않는 설정과 중간 성능 하락을 관찰하는 평가도 그 맥락에서 제시됩니다. 다만 여기서 보존할 상태는 가중치가 아니라 harness입니다.
챕터의 핵심 기여: 비모수적 자기진화와 지속학습을 연결하되, 기존 연구 전부를 새로 실험한 것처럼 다루지 않습니다. 다음 챕터로의 연결: 실제 관찰 범위의 결론으로 돌아갑니다. 이 리뷰는 인용된 개별 참고문헌의 원문을 별도로 모두 검토하지 않았습니다. 원문 §5
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 전체 성능 향상과 지속학습의 완전성을 구분하는 답을 제시합니다.
저자는 대부분 조건에서 seed보다 전체 성능이 개선되었지만, 새 업무의 강한 학습과 다른 업무의 보존을 함께 달성하지 못했다고 정리합니다. GEPA와 Meta-Harness는 공유 상태를 바꾸면서 아직 만나지 않은 업무에 간섭하고, 이후에는 이전 지침을 압축하거나 덮어씁니다. ReasoningBank는 도메인이 먼 경우의 망각을 줄이지만, 미경험 업무에 다른 기억을 주입하고 비슷한 질문에서 workflow가 충돌하면 검색 선택이 실패합니다.
따라서 “current methods remain incomplete continual learners”라는 결론은 이번에 평가한 방법과 스트림에서 남은 능력 보존 문제를 뜻합니다. 저자가 서론 말미에 명시한 방향은 업무별 업데이트를 격리하고 표면적 질문 유사도 이상의 조건으로 검색을 조절하는 것입니다. 새로운 해결 알고리즘이 이 논문에서 검증되었다고 서술하지 않습니다.
챕터의 핵심 기여: 자기진화의 유효성을 부정하는 대신, 향상이 지속적으로 누적되기 위해 해결해야 할 간섭과 충돌을 명확히 합니다. 다음 내용과의 연결: 원문의 References를 거쳐 부록에서 추가 실험·분해 결과·실제 지침과 구현 조건을 제공합니다. 원문 §6
📖 Chapter References: References
본문 뒤에는 자기진화, 프롬프트 최적화, 경험 증강, 지속학습, 평가 벤치마크의 참고문헌이 배치됩니다. 이 리뷰는 논문이 관련 연구를 분류한 맥락을 설명하며, 서지 목록을 별도의 실증 근거처럼 재인용하거나 모든 선행 연구의 검증을 완료했다고 표현하지 않습니다. 원문의 다음 내용은 추가 실험인 Appendix A입니다.
📖 Chapter A: Results on the Interleaved Mixture Stream
부록의 위치와 역할: 업무를 연속 블록으로 받는 일정 자체가 원인인지 확인하기 위해, 네 업무군을 처음부터 끝까지 균등하게 섞는 Mix 스트림을 비교합니다.
전체 길이는 200이며 compound와 같은 BIRD-Code·BIRD-F1·BFCL-Miss·BFCL-Base를 사용합니다. 모든 업무가 전 구간에 활성화되어 있으므로 앞의 pre-block interference와 post-block forgetting은 정의되지 않습니다. 이 부록에서는 Term.과 시간 평균 향상을 비교합니다.
| 방법 | Blocked Term. / 시간 평균 | Mix Term. / 시간 평균 |
|---|---|---|
| ReasoningBank | +2.8 / +1.5 | +2.3 / +1.2 |
| GEPA | +5.8 / +3.1 | +0.9 / +0.4 |
| Meta-Harness | +0.8 / +0.2 | +1.9 / +0.5 |
Table 2에서 GEPA의 전체 최종 향상은 섞은 경우 더 작으며, BIRD-F1은 −4.5pp., BIRD-Code는 −1.0pp.가 됩니다. Figure 5에서는 공유 프롬프트 안에서 규칙이 공간을 다투는 모습을 보여줍니다. BIRD-Code의 문자 비중은 37.0% → 21.8% → 5.8%로 줄고 BIRD-F1은 0%에서 22.8%까지 늘어납니다. Meta-Harness의 전체 Term.은 Mix에서 높아져 모든 방법이 똑같이 악화된다고 말할 수는 없지만, BIRD-F1은 −0.5 → −3.0pp.로 나빠집니다.
핵심 기여와 연결: 업무를 섞는 것만으로 공유 지침의 경쟁이 해소되지 않는다는 추가 관찰입니다. 다음 부록은 개별 업무의 손실과 실제 프롬프트 변화를 더 세밀하게 보여줍니다. 원문 Appendix A, Table 2, Figure 5
📖 Chapter B: Per-Group Continual Learning Decomposition and Evolved Prompts
부록의 위치와 역할: 본문 평균 S를 업무별 간섭과 망각으로 나누고, 실제로 달라진 지침을 대조합니다.
먼저 Table 3은 각 업무군의 seed, P, −I, −F, Term.을 제시합니다. 첫 블록은 이전 학습이 없고 마지막 블록은 이후 학습이 없어, 해당 손실 칸을 구조적으로 정의되지 않는 대시로 표시합니다. 본문에서 평균을 계산할 때는 대응 손실을 0으로 취급합니다. 예컨대 workflow의 GEPA에서 BFCL-Miss는 P +15.5pp., 이후 손실 −13.0pp., 마지막 +2.5pp.입니다. Domain의 GEPA BFCL-Base는 블록 이전 간섭 −5.5pp.가 있지만 이후 망각은 0.0pp.로, 두 현상은 다르게 나타납니다.
이어 Figure 6은 compound 위치 100에서 SQL 탐색 규칙이 GEPA와 Meta-Harness의 system prompt에 들어간 모습을 보여줍니다. Figure 7은 domain에서 ScienceWorld 지침을 유지하며 새 절을 덧붙인 경우와, compound에서 SQL 지침을 축약한 경우를 비교합니다. 강조색과 이탤릭 주석은 저자의 설명이며, 원문 전체 prompt가 아니라 축약된 비교입니다.
마지막 Figure 8은 네 스트림의 문자 구성과 정확도 궤적을 함께 제시합니다. 각 줄은 처음 작성된 블록에 귀속하며, 이월되거나 편집된 줄도 원래 그룹 귀속을 유지합니다. 따라서 문자 비중은 그 규칙이 매번 새롭게 생성되었는지나 인과적 기여도를 직접 측정하는 값이 아닙니다. 저자는 이 추적과 실제 정확도 감소를 함께 사용하여 덮어쓰기 메커니즘을 설명합니다.
핵심 기여와 연결: 평균 손실을 업무·시점·지침의 실체로 분해합니다. 다음 부록은 프롬프트 수정 대신 기억 검색에서 같은 종류의 문제가 생기는 이유를 조사합니다. 원문 Appendix B, Table 3, Figures 6–8
📖 Chapter C: Similarity and Cross-Group Retrieval under ReasoningBank
부록의 위치와 역할: 기억 검색의 충돌을 질문 임베딩과 실제 검색 출처의 두 관점으로 확인합니다.
Table 4는 업무군당 50개 훈련 질문과 768차원 정규화 임베딩을 사용합니다. 평균 pairwise similarity는 모든 질문 쌍의 유사도를 평균하고, mean nearest-match similarity는 각 행 질문이 열의 저장소에서 얻는 최대 유사도를 평균합니다. 후자는 행과 열의 역할이 다르므로 행렬이 반드시 대칭일 필요가 없습니다. 같은 그룹의 대각에서는 자기 자신과의 자명한 일치를 제외합니다.
BFCL 두 그룹의 최근접 유사도를 원문 그대로 옮기면 다음과 같습니다.
| 평가 질문군 → 기억 저장군 | BFCL-Miss | BFCL-Base |
|---|---|---|
| BFCL-Miss | 0.837 | 0.840 |
| BFCL-Base | 0.835 | 0.834 |
이 표는 오히려 반대 workflow의 기억이 자기 그룹의 기억만큼 가깝다는 상황을 보여줍니다. 반면 ScienceWorld 내부 최근접 유사도는 0.951이고 다른 업무군과는 더 낮아, 도메인 분리와 workflow 분리를 같은 문제로 취급할 수 없습니다.
이어 Figure 9는 네 drift와 Compound Mix의 모든 체크포인트에 대한 다른 업무 기억 검색 비율을 제공합니다. 자기 기억이 없는 구간의 100%, workflow·compound 마지막의 BFCL 양방향 52%·46%, Mix 전반의 38–60%는 서로 다른 시점·일정의 결과이므로 하나의 평균 오류율로 합치지 않습니다.
핵심 기여와 연결: 외부 저장소가 기억을 보존해도, 선택 규칙이 작업 적합성을 보존하지 못할 수 있음을 뒷받침합니다. 다음 부록은 이 검색과 실행을 구현한 실제 조건을 명시합니다. 원문 Appendix C, Table 4, Figure 9
📖 Chapter D: Implementation Details
부록의 위치와 역할: 본문의 비교를 재현하거나 평가 범위를 이해하는 데 필요한 생성 설정과 실행 인터페이스를 제공합니다.
먼저 Table 5의 생성 설정은 temperature 1.0, max_output_tokens 8192, thinking_level MEDIUM입니다. 이 값은 모델 생성 설정이며, 평가 과제 수나 에피소드의 도구 실행 횟수 상한과 다릅니다.
- Seed harness: 에이전트는 관찰을 받고
act블록에 행동을 출력합니다. BIRD에서는 읽기 전용 SQLite를 Bash workspace에서 탐색한 뒤 SQL을/workspace/answer.sql에 쓰고 제출합니다. BFCL에서는 상태를 가진 API의 Python 함수 호출 목록 또는 사용자에게 돌려주는reply를 사용합니다. ScienceWorld에서는 시뮬레이터가 정의한 텍스트 행동을 보냅니다. - Retrieval: ReasoningBank는 기억과 질문을
gemini-embedding-2로 임베딩하고 cosine similarity의 최근접 항목을 검색합니다. 검색 단계가 있는 방법은 이 하나이며, GEPA와 Meta-Harness는 공유 prompt·workspace를 전체 읽습니다. 부록 C의 768차원 조건과 함께 해석해야 합니다. - Meta-Harness proposer: harness 코드를 직접 읽고 편집해야 하므로, proposer는 평범한 seed ReAct loop가 아닌 opencode harness에서 실행합니다. backend는 같은 Gemini 3.6 Flash이고 생성 설정도 Table 5와 같습니다. 모델을 맞추었다는 조건과 편집 도구를 포함한 실행 장치까지 동일하다는 주장은 다릅니다.
핵심 기여와 연결: 방법 간 공통 조건과 역할에 따른 인터페이스 차이를 밝힙니다. 다음 부록은 수정 가능한 prompt와 환경이 고정한 안내문의 경계를 실제 문서로 보여줍니다. 원문 Appendix D, Table 5
📖 Chapter E: Seed System Prompt and Environment Preambles
부록의 위치와 역할: 프롬프트를 추상적인 텍스트가 아니라 수정 권한과 실행 규약이 있는 상태로 설명합니다.
먼저 seed system prompt는 S1: REPLACEABLE_SYSTEM_PROMPT와 S2: FIXED_TAIL_INJECTION_SLOT라는 두 앵커를 둡니다. GEPA는 S1 본문을 수정하고, ReasoningBank는 S1을 유지한 채 S2의 Retrieved Memories 아래에 기억을 주입합니다. Meta-Harness는 둘과 제어 코드까지 편집할 수 있습니다. 시스템의 기본 규칙은 한 번에 실행 가능한 행동 하나를 보내고 환경의 실제 관찰을 기다리는 것입니다. 첫 act fenced block만 실행되며, 비어 있거나 닫히지 않은 블록도 한 step을 소비합니다.
E.1 User Message Template and Environment Preambles
초기 사용자 메시지는 환경 안내문 → 과제 → 첫 관찰 순서로 조립합니다. 이후에는 새 관찰을 전달합니다. 환경 안내문은 벤치마크별 행동 문법과 한도를 정의하며 어느 방법도 편집할 수 없습니다. 따라서 수정할 수 있는 harness와 평가 조건을 정하는 환경의 경계가 분명합니다.
BIRD. 일반 act 내용은 네트워크 없는 workspace에서 Bash로 실행되고, 명령의 표준 출력·오류·종료 코드가 다음 관찰이 됩니다. 명령 timeout은 60초, 최종 SQL 평가의 실행 제한은 30초입니다. 데이터베이스는 읽기 전용이며 모델 호출은 최대 20회입니다. SQL 파일을 지정 형식으로 제출해야 하고, 숨겨진 기준 SQL의 결과 행과 비교합니다.
BFCL. 과제는 <USER_TURN>으로 도착합니다. 함수 호출 목록은 순서대로 실행되며 중첩 호출은 허용하지 않습니다. reply는 현재 사용자 턴을 끝내고 다음 턴으로 넘깁니다. 턴당 최대 20 step이며 별도 submit은 없습니다. 관측되지 않은 초기 API 상태를 임의로 가정해서는 안 된다는 안내도 포함합니다.
ScienceWorld. 에이전트는 환경에 실제로 있는 객체와 방 이름을 사용하여 이동·관찰·혼합·연결 등의 텍스트 행동을 보냅니다. wait는 시뮬레이션 10회, wait1은 1회를 진행하며, 실험 수행과 대상에 대한 focus on이 함께 필요한 과제가 있습니다. 한도는 모델 호출 100회이고, 환경의 공식 점수가 완료 여부를 결정합니다. submit이 그 점수를 덮어쓰지는 않습니다.
부록의 핵심 기여: 방법들이 같은 문제를 풀더라도 어디까지 자기를 바꿀 수 있는지, 무엇을 성공으로 판정하는지는 고정되어 있음을 보여줍니다. 원문은 이 부록으로 끝나며 별도의 다음 챕터를 가정하지 않습니다. 원문 Appendix E
실험 결과 심층 분석
평균 향상과 유지되는 능력은 별도 결과입니다
네 스트림 평균에서 GEPA의 Term. +3.7pp.는 가장 높습니다. 그러나 P +6.2pp.와 S −4.3pp.를 같이 보면, 블록별로 배운 효과 중 일부가 다른 시점·업무에서 손실과 함께 나타납니다. P와 S는 서로 다른 시점의 합계이므로 단순히 둘을 더해 Term.을 재구성하는 공식으로 쓰지 않습니다. ReasoningBank의 S −1.9pp.는 상대적으로 좋은 보존을 뜻하지만, P +3.3pp.가 GEPA보다 낮다는 조건을 함께 읽어야 합니다.
또한 전체 평균은 네 스트림의 요약입니다. Topic의 GEPA Term.은 −1.7pp.지만 domain에서는 +6.2pp.입니다. 평균 하나로 모든 업무에서 유리하다고 판단할 수 없습니다. 이 논문의 관찰은 업데이트의 저장 위치와 적용 범위가 환경 변화의 종류에 따라 다르게 작용한다는 것입니다. 원문 Table 1
통계적 신뢰도는 실제 보고된 범위만 읽어야 합니다
평가 과제마다 8회 rollout을 평균하였으며, Figure 2는 12개 방법·조건 조합의 P–S 상관 r = −0.72, p = 0.008과 선형 적합의 95% 신뢰구간을 보고합니다. 다만 표의 방법별 정확도 차이에 대한 별도의 유의성 검정이나 반복 훈련 run 간 신뢰구간은 보고되지 않았습니다. 따라서 +3.7pp.와 +2.5pp.의 차이에 대해 통계적 우위를 새로 선언하지 않습니다. 회귀 그림의 구간을 모든 성능 수치의 오차 막대로 해석해서도 안 됩니다.
실패 메커니즘을 행동 수준에서 설명합니다
GEPA의 BFCL-Miss 질문 비율 감소와 정확도 13.0pp. 하락은 왜 이전 지침의 반전이 문제인지 보여주는 구체적 사례입니다. ReasoningBank에서 반대 workflow 기억이 52% 검색되고 이전 향상이 8.0pp. 줄어든 결과는 파일 보존만으로 행동 보존을 판단할 수 없음을 보여줍니다. 동시에 domain에서는 기억 검색과 GEPA의 추가형 지침이 post-block forgetting을 0으로 만들었으므로, 모든 변화가 반드시 망각으로 이어진다는 결론도 아닙니다.
실험 설계에 대한 리뷰어 해석: 가중치를 고정하고 업무군별 hold-out을 모든 체크포인트에서 평가한 구성은 harness 변화의 다른 업무에 대한 영향을 관찰하기에 적절합니다. 특히 같은 API에서 필요한 행동만 달라지는 BFCL 비교는 의미적 유사성과 절차 호환성을 분리합니다. 실제 prompt 추적과 질문 행동, 검색 출처를 함께 제시하여 평균 수치의 의미도 보강합니다. 재현을 위한 모델·생성 설정·인터페이스와 seed prompt는 부록에 제시되어 있으나, 이 리뷰에서 실험을 재실행하여 결과를 재현한 것은 아닙니다.
기술적 함의와 응용
이 연구에서 관측한 자기진화의 상태는 모델 내부 파라미터가 아니라 지침과 기억, 스킬과 제어 코드입니다. 그러므로 가중치가 고정되어 있다는 조건은 서비스의 행동이 고정되어 있다거나, 이전 능력이 보존된다는 뜻이 아닙니다. 업무가 바뀔 때 공유 상태가 어떻게 적용되는지까지 보아야 한다는 것이 논문의 중심 결론입니다.
저자는 업무별 업데이트의 격리와 표면적 질문 유사도 이상의 조건을 고려하는 검색을 향후 필요한 방향으로 명시합니다. 다만 이를 구현한 새로운 시스템의 효과는 이 논문에서 평가하지 않았습니다. 리뷰어 해석: 실제 에이전트 평가에서도 새 업무 성능, 미경험 업무에 대한 간섭, 이미 배운 업무의 유지 여부를 구분하여 읽는 관점으로 활용할 수 있습니다. 이 해석은 논문의 지표와 관찰을 응용한 것이며, 추가 실험 결과는 아닙니다.
이번 리뷰는 본문 1–6절과 References의 위치, 부록 A–E의 실험·구현·인터페이스를 모두 순서대로 다루었습니다. Table 1·3·4의 전체 셀, Figure 6–8의 실제 prompt 전문과 Appendix E의 긴 안내문 전문은 재수록하지 않았으며, 각 자료의 구조·대표 수치·해석을 설명했습니다. 참고문헌 개별 논문과 관련 구현 코드는 별도로 분석하지 않았습니다. 전체 평균의 개선과 지속적인 능력 보존을 함께 관찰해야 자기진화가 무엇을 배우고 무엇을 잃었는지 이해할 수 있습니다.