논문 개요와 전체 구조
LLM 에이전트가 사람과 일을 잘하려면 정답을 한 번 말하는 능력만으로는 부족합니다. 사용자가 필요한 정보를 조금씩 알려 주거나, 이미 진행한 뒤 요구사항을 바꾸거나, 명확화 질문에 제대로 답하지 않는 상황에서도 대화를 이어 가야 합니다. 그런데 에이전트 훈련에 사용하는 가상 사용자를 일반적인 assistant 모델에 맡기면, 실제 사람보다 지나치게 협조적이고 명시적인 상대를 만날 수 있습니다. MIMESIS는 에이전트 자체보다 먼저, 에이전트가 연습할 상대를 학습하는 연구입니다.
Hoang Phan 등은 Qwen3.5 기반 4B·9B 사용자 시뮬레이터를 학습하고, 이를 고정한 뒤 별도의 Qwen3-8B 에이전트를 훈련합니다. 이어 가상 사용자의 사후 반응과 생성된 비공개 추론을 코칭으로 바꾸는 Coached On-Policy Self-Distillation(CSD)을 제안합니다. 코칭은 훈련 시에만 사용하며, 실제 행동을 생성하는 에이전트는 공개 대화만 봅니다. 원문 개요·§1
이 리뷰는 arXiv:2610.09484v2의 HTML과 40페이지 PDF를 함께 읽었습니다. 최초 제출은 2026년 10월 7일, 검토한 v2 수정은 10월 8일이며, 이 글의 분석일인 10월 24일과 구분합니다. 아래 모델 이름과 결과는 논문 실험 조건을 가리킵니다. 새로운 실제 사람을 대상으로 에이전트 성능 전이를 검증한 연구로 해석하지 않습니다. 버전·서지
원문 구조는 다음과 같습니다. 상세 리뷰도 이 순서를 따릅니다.
| 원문 구간 | 섹션과 소제목 |
|---|---|
| 1–3 | Introduction → Related Work → Problem Setup and Overview |
| 4 | MIMESIS: Learning a Realistic User Simulator — 4.1 Learning User Responses and Reasoning, 4.2 Joint Reinforcement Learning with Realistic Behaviors, 4.3 Learning Realistic User Behaviors, 4.4 User-simulator evaluation |
| 5 | Agent Post-Training with a Learned User Simulator — 5.1 Multi-Turn Reinforcement Learning, 5.2 Coached On-Policy Self-Distillation, 5.3 Agent evaluation |
| 6 | Conclusion |
| 부록 A | Simulator Training Details — A.1 Data and supervised adaptation, A.2 Realistic user behaviors, A.3 Joint multi-domain reinforcement learning, A.4 Behavior rollouts and reward |
| 부록 B | Simulator Evaluation — B.1 SOUL-Index, B.2 RealUserSim PT3, B.3 Behavioral and outcome alignment on τ-bench, B.4 SimulatorArena, B.5 PRISM: behavioral fidelity and next-turn realism |
| 부록 C | Simulator Ablations and Training Dynamics — C.1 Role of user-side mid-training, C.2 Role of explicit reasoning, C.3 Contribution of realistic behavior training |
| 부록 D | Agent Training and Evaluation — D.1 Training setup and baselines, D.2 CSD implementation details, D.3 Generalization across evaluation users, D.4 Robustness to alternative training simulators |
| 부록 E | Theoretical Analysis of CSD — E.1 Policy improvement from coaching, E.2 Comparison with GRPO |
| 부록 F | Qualitative Analyses and Failure Modes — F.1 Simulator behavior case studies, F.2 From simulator feedback to actionable coaching, F.3 Simulator refusals can invalidate evaluation |
| 부록 G | Limitations, Safety, and Ethics — 인간 전이, 행동 조건화, 사용자 복지, 추론 보존 |
핵심 기여와 혁신성
해결하려는 문제는 가상 사용자가 훈련·평가의 난이도 자체를 바꾼다는 점입니다. 동일한 GPT-5.5 에이전트의 τ-bench 성공률은 실제 사용자와 대화할 때 63.6%인데, frontier assistant 모델을 사용자로 쓰면 82.4–84.4%입니다. 더 높은 성공률이 에이전트의 개선을 의미하지 않습니다. 반대로 사전학습 Qwen3.5-4B·9B는 실제 사용자 기준보다 각각 16.0·14.9%p 낮게 만듭니다. 저자들은 협조적 상대와 어려운 상대 모두 인간의 대리물이 아닐 수 있음을 보여 줍니다. §1, Figure 2
기여는 세 가지가 연결됩니다.
- 사용자 역할을 위한 모델 학습: 인간의 다음 발화를 예측하는 중간학습, ThoughtTrace의 자기보고 이유·반응을 활용한 추론 지도학습, 여러 시뮬레이션 과제를 섞은 강화학습을 연결합니다.
- 13개 행동을 명시적인 훈련 목표로 사용: 숨은 평가 기준, 점진적인 요구 변경, 명확화 비협조 같은 패턴을 고객지원 시나리오에 접목합니다. 단순한 말투 흉내보다 정보가 공개되는 방식과 반응 시점을 다룹니다.
- 사용자 모델의 사실성에서 에이전트 학습 효용까지 검증: MIMESIS-9B를 훈련 상대에 쓰면, 학습 때 보지 않은 9개 사용자 모델 모두에서 8개 환경의 집계 점수가 GPT-5.5 상대 훈련보다 높습니다. 동일한 MIMESIS 상대에 CSD를 더해도 9개 평가 사용자에서 추가 개선됩니다. §4–5
독창성은 각 재료를 처음 발명한 데 있지 않습니다. 사용자 언어 모델링, ThoughtTrace, GRPO, 사후 문맥을 활용한 self-distillation의 선행 흐름을 학습된 사용자 → 고정된 훈련 환경 → 코칭을 활용하는 에이전트로 연결하고, 사용자 변경에 대한 전이를 함께 평가한 데 있습니다. 리뷰어 관점에서 이는 에이전트 데이터의 품질을 답변의 품질뿐 아니라 상호작용 상대의 분포로 보게 한다는 의미가 있습니다.
기술적 세부사항
먼저 사용자 모델과 업무 수행 에이전트를 구분해야 합니다. MIMESIS는 고객지원·설득·질의응답 등의 환경에서 사용자 역할의 다음 말을 생성합니다. 업무를 수행하도록 강화학습하는 모델은 별도의 Qwen3-8B입니다. 두 모델을 동시에 경쟁적으로 계속 갱신하는 구조도 아닙니다. Stage II에서는 사용자 시뮬레이터를 고정합니다.
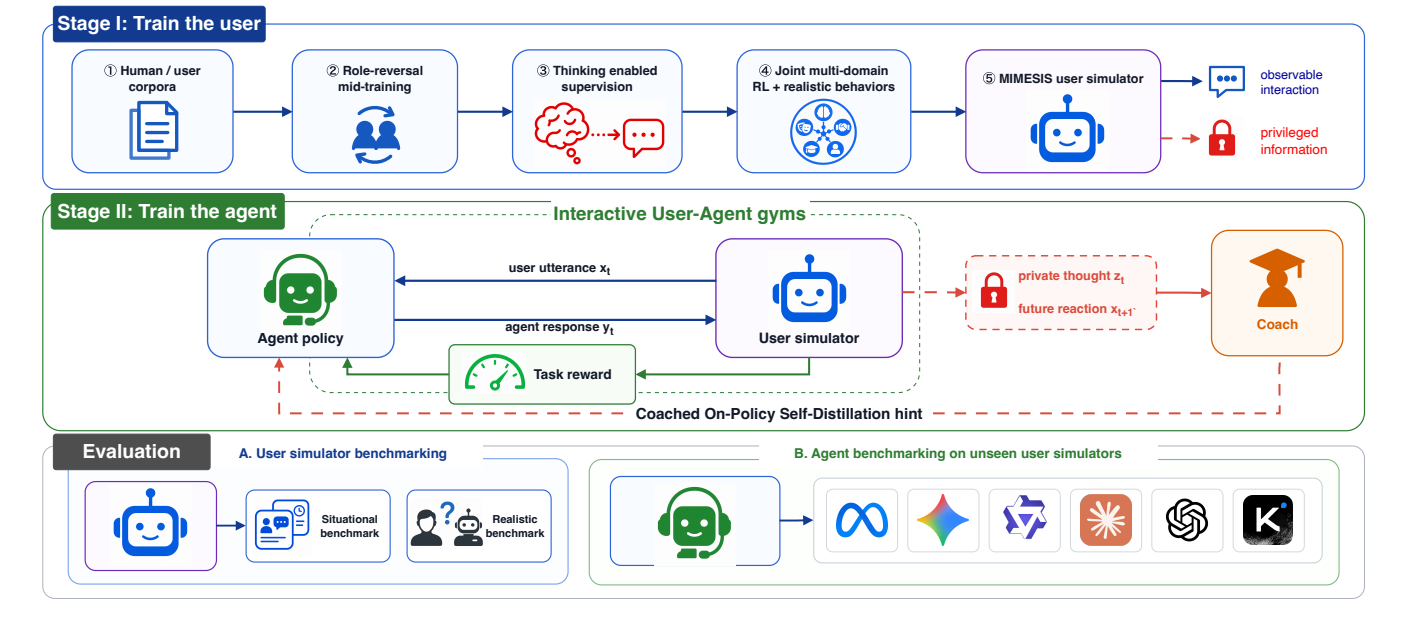
Figure 3, PDF 3페이지. 위쪽은 사용자 모델 학습, 가운데는 에이전트 학습, 아래쪽은 두 종류의 평가입니다. 같은 v2 PDF에서 그림 영역만 크롭했으며 번역·재배열하지 않았습니다. 원문 PDF
가운데 단계의 파란 실선은 공개 사용자 발화와 에이전트 답변의 교환입니다. 빨간 점선 경로는 사용자 모델의 생성된 thought와 후속 반응을 코칭으로 바꾸는 훈련 전용 경로입니다. 아래 리뷰어 도식과 본문의 수식에서 이 둘을 분리해 읽는 것이 중요합니다.
리뷰어 작성 도식. Figure 3과 §5.2의 정보 흐름을 재구성했습니다. 원문 그림이 아니며, 공개 대화의 진행과 사후 코칭을 구분하기 위한 설명입니다. 주황색 정보는 배포 입력이 아닙니다. 원문 §5.2
핵심 기호는 다음과 같습니다.
| 기호 | 의미 |
|---|---|
| $c$, $H_t$ | 과제 문맥, 현재 사용자 발화까지 포함하는 공개 대화 이력 |
| $u_{\hat\phi}$, $\pi_\theta$ | Stage II에서 고정된 사용자 시뮬레이터, 학습하는 에이전트 정책 |
| $x_t$, $y_t$ | 사용자 발화, 에이전트 답변 |
| $z_t$, $h_t$ | 시뮬레이터가 생성한 비공개 추론, 이를 후속 발화와 함께 요약한 사후 코칭 |
| $\tau$ | 여러 턴과 도구 결과를 포함하는 상호작용 궤적 |
평가도 하나의 사실성 점수로 합쳐 읽으면 안 됩니다. SOUL-Index는 여러 시뮬레이션 능력, RealUserSim은 인간 참조 궤적과의 행동 일치, τ-USI는 행동 통계와 과제 결과 보정, SimulatorArena는 문체 유사도와 인간·시뮬레이터 판별을 봅니다. 에이전트 전이 실험은 그와 별도로 훈련 상대를 바꾸었을 때의 업무 점수를 측정합니다. 이 구분은 부록 B와 D에서 자세히 확인합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할. 도입부는 장기 대화 에이전트의 성능이 왜 단일 응답 정확도로 설명되지 않는지에서 시작합니다. 상태 유지, 이전 제약 보존, 부족한 정보 식별, 피드백 반영, 오류 복구가 모두 대화 궤적에 걸친 문제입니다. 이어 그 궤적을 만들어 줄 사람을 대규모로 확보하기 어렵다는 훈련상의 문제를 제시합니다.
1. 다중 턴 평가로 이동하면서 생기는 사용자 의존성. 에이전트와 도구만으로 다음 상태가 정해지지 않습니다. 사용자의 추가 설명과 반응이 있어야 다음 행동을 결정할 수 있습니다. 따라서 사용자는 단순한 평가 프롬프트가 아니라, 에이전트가 만나는 환경의 일부가 됩니다.
2. 일반 assistant를 사용자로 바꿔 쓰는 방식의 불일치. 도움을 주도록 학습된 모델은 필요한 정보를 잘 정리해 주고, 명확화에 협력하며, 실제 사람보다 균질하게 반응할 수 있습니다. 저자들은 이를 대화 스타일의 차이에서 끝내지 않고 실제 과제 난이도의 차이로 보여 줍니다.
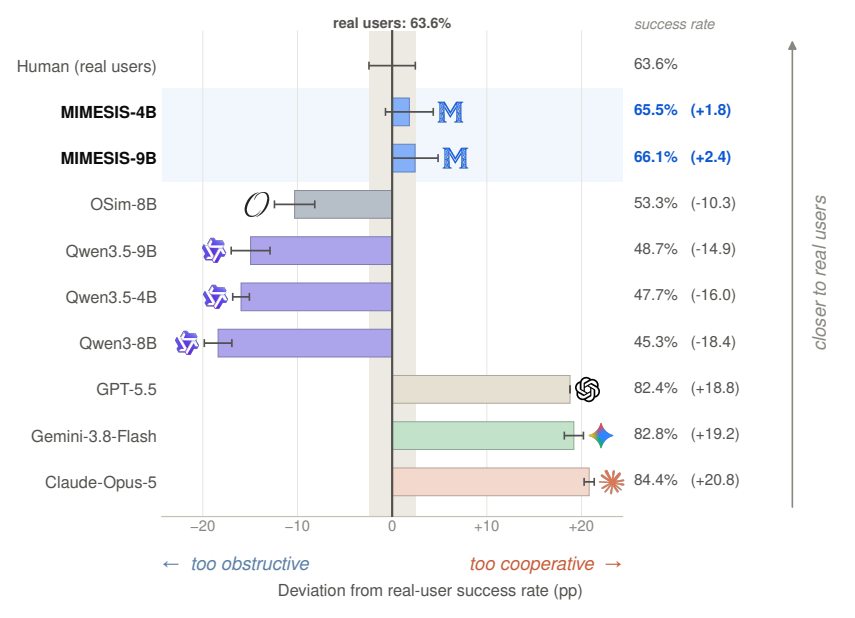
Figure 2, PDF 2페이지. 실제 사용자 기준에서 벗어나는 성공률 차이(%p)를 표시합니다. v2 PDF의 그래프만 크롭했으며 축·오차막대·모델명·숫자를 보존했습니다. 원문 PDF
인간 기준 63.6%에 대해 MIMESIS-4B는 65.5%, MIMESIS-9B는 66.1%입니다. 이는 이 고정 에이전트·해당 평가에서 인간 성공률에 가까웠다는 뜻입니다. 모든 과제에서 사람과 동일하다는 뜻도, 시뮬레이터가 더 쉬우면 에이전트가 더 좋아졌다는 뜻도 아닙니다. Figure 2의 핵심 비교 대상은 사용자를 바꾸기 전후의 동일 에이전트입니다.
3. 사실성과 훈련 효용을 함께 묻는 두 단계 제안. 저자들은 먼저 사람의 대화와 사고 자기보고를 이용해 사용자 모델을 만들고, 이를 고정한 후 에이전트를 학습합니다. 이후 시뮬레이터 평가와 미지의 사용자 모델을 상대하는 에이전트 평가를 따로 수행합니다. Figure 3의 두 평가 경로가 이 연구 질문에 대응합니다.
핵심 기여와 연결. 도입부가 정립하는 기준은 “자연스러운 말을 하는가”를 넘어 “사람과 비슷한 정보 흐름과 난이도를 만드는가, 그 상대와 배운 정책이 다른 상대에게도 통하는가”입니다. 다음 장은 이 두 질문이 기존 연구와 어디에서 만나는지 정리합니다. §1
📖 Chapter 2: Related Work
위치와 역할. 관련 연구는 네 흐름을 순서대로 연결해, 사용자 시뮬레이션과 에이전트 훈련이 같은 문제가 아님을 보여 줍니다.
1. Multi-turn agentic interaction. AgentBoard·MINT에서 출발해 ToolSandbox·BFCL·DialogTool의 상태·도구 의존성 평가, τ-bench 계열의 도구–에이전트–사용자 조정으로 이어집니다. 평가 대상이 개별 답변에서 누적되는 상태와 행동으로 확장됐다는 맥락입니다. 여기서 인용한 개별 연구의 원문을 모두 재검토한 것은 아니며, 이 절의 분류를 설명합니다.
2. Behavioral variation and difficult users. 어려운 사용자 패턴을 부여하되 과제에 필요한 정보는 보존하는 방법, 인간과 비슷한 행동 정책을 찾는 방법, 실제 상호작용에서 행동 프로필을 추출하는 방법을 다룹니다. 특히 RealUserSim의 Directive Amplification은 행동 지시를 줬을 때 그 특성을 과장할 수 있음을 지적합니다. MIMESIS의 13개 행동도 “비협조적일수록 좋다”는 지표로 이해하면 안 되는 이유입니다.
3. Simulator-driven agent training. UserRL은 시뮬레이터가 생성한 다중 턴 궤적을 어떻게 보상하고 최적화할지 다룹니다. 관련 연구 중 Suh 등의 작업은 283명의 인간 참여자로 전이를 검증했다고 소개됩니다. 이 283명은 선행 연구의 수치이며, MIMESIS 자체의 인간 실험 인원이 아닙니다.
4. Learning from textual feedback and privileged context. ThoughtTrace는 공개 발화에 드러나지 않는 사용자의 이유·반응을 다룹니다. SDPO와 On-Policy Context Distillation은 더 많은 피드백을 받은 teacher의 행동을 적은 문맥의 정책으로 전달하는 배경입니다. CSD의 운영상 차이는 새로 고친 답변을 생성해 증류하지 않고, 이미 샘플링한 답변을 코칭이 있는 문맥과 없는 문맥에서 다시 채점한다는 데 있습니다.
핵심 기여와 연결. 이 장은 CSD를 완전히 독립적인 새 증류 원리로 제시하지 않고, 사용자 모델이 생성한 사후 신호를 기존 on-policy 학습에 연결하는 방법으로 위치시킵니다. 다음 장에서 어떤 파라미터와 보상을 각각 학습하는지 수학적으로 구분합니다. §2
📖 Chapter 3: Problem Setup and Overview
위치와 역할. 사용자 시뮬레이터의 학습, 고정된 사용자와의 상호작용, 업무 에이전트의 학습을 차례대로 정의합니다. 두 모델의 목적 함수를 혼동하지 않는 것이 이 장의 핵심입니다.
1. Learning a user simulator. 사용자 모델 $u_\phi(x\mid c,H)$는 과제 문맥 $c$와 대화 이력 $H$를 받아 다음 사용자 발화 $x$의 분포를 만듭니다. 인간 대화는 그 분포를 학습할 예시이며, 시뮬레이션 과제는 생성 결과가 사용자 역할에 얼마나 맞는지를 평가합니다. 원문 식 (1)은 다음과 같습니다.
$\mathcal D_{\mathrm{sim}}$은 시뮬레이터 훈련 과제 분포, $\rho$는 단일 응답 또는 다중 턴 결과, $P_\phi$는 그 결과를 생성하는 분포입니다. $R_{\mathrm{sim}}$은 사용자 모사의 품질에 대한 보상입니다. 이 목적은 고객의 요청을 해결하는 업무 성공 보상과 다릅니다.
2. Interaction with the learned simulator. 학습한 사용자 모델의 파라미터를 $\hat\phi$로 고정합니다. 원문 식 (2)의 한 턴은 다음과 같습니다.
에이전트가 공개 이력에서 답변 $y_t$를 생성하면, 사용자 모델이 이를 보고 다음 발화 $x_{t+1}$를 생성합니다. 두 발화와 필요한 도구 호출·결과가 이력에 추가되며, 종료 조건이나 턴 제한까지 반복해 $\tau$를 만듭니다. 사용자의 반응이 이후의 에이전트 입력을 바꾸므로, 같은 시작 과제라도 시뮬레이터가 달라지면 훈련 궤적도 달라집니다.
3. Learning the agent. 원문 식 (3)은 고정된 사용자를 상대로 에이전트의 업무 성과를 최적화합니다.
$\mathcal D_{\mathrm{agent}}$은 에이전트 훈련 과제, $P_{\theta,\hat\phi}$는 에이전트·사용자·환경이 함께 만드는 궤적 분포입니다. 이때 갱신하는 것은 $\theta$뿐입니다. 사용자 모델의 보상은 “사용자답게 행동했는가”, 에이전트 보상은 “과제를 잘 수행했는가”를 묻습니다.
핵심 기여와 연결. 시뮬레이터는 고정된 데이터 공급기가 아니라 에이전트 행동에 반응하는 분포입니다. 다음 장은 그 분포를 사람과 가깝게 만드는 학습 절차를 설명합니다. §3, 식 (1)–(3)
📖 Chapter 4: MIMESIS: Learning a Realistic User Simulator
위치와 역할. Stage I의 세 학습 단계와 시뮬레이터 자체의 평가를 설명합니다. 두 크기의 모델은 Qwen3.5 계열 backbone을 사용하며 동일한 절차를 따릅니다.
4.1 Learning User Responses and Reasoning
먼저 인간–assistant 대화에서 앞선 대화를 입력으로, 인간 사용자의 다음 발화를 정답으로 삼습니다. assistant 턴은 입력 문맥에 남지만 예측 목표는 사용자 턴입니다. 이 역할 전환 중간학습은 일반 assistant의 말하기 습관을 그대로 사용자 역할에 투영하지 않도록 하는 적응 단계입니다.
저자들이 제시하는 문제는 발화만 지도하면 “왜 그렇게 반응했는가”를 명시적으로 배우지 못한다는 점입니다. 일반 로그에 추론이 없다는 것은 기록 방식의 특성일 수 있지만, 모델은 추론 없이 곧바로 답하도록 학습됩니다. 실제로 부록 C에서 명시적 추론 생성이 줄어드는 현상을 따로 확인합니다.
이를 보완하는 ThoughtTrace는 사용자가 자신의 메시지를 보낸 이유와 assistant 응답을 어떻게 받아들였는지를 자기보고한 자료입니다. MIMESIS는 추론 후 공개 발화의 순서로 지도받습니다. 원자료의 자기보고는 내부 상태를 이해하기 위한 관측 가능한 대리 신호이며, 이후 시뮬레이터가 생성하는 thought는 실제 사람의 마음을 직접 읽은 결과가 아닙니다. 상호작용 중에는 thought와 공개 발화를 분리하고, 업무 에이전트에는 공개 발화만 전달합니다.
4.2 Joint Reinforcement Learning with Realistic Behaviors
다음은 SOUL의 여러 환경과 현실적 행동 과제를 한 모델에 함께 학습시키는 단계입니다. OdysSim이 과제별 RL expert를 만들고 선택한 궤적을 통합 모델에 증류하는 방식과 달리, MIMESIS는 여러 환경의 rollout으로 같은 파라미터를 계속 갱신합니다. 원문 식 (4)은 이를 표현합니다.
$d$는 환경, $p(d)$는 환경을 뽑는 분포, $P_\phi^d$는 그 환경에서 사용자 모델이 만드는 궤적 분포, $r_d$는 환경 고유 보상입니다. 환경마다 상호작용 규약과 보상은 유지하며, GRPO로 공유 모델을 최적화합니다. 현실적 행동 과제도 이 혼합의 한 환경입니다. 관측된 행동 빈도를 그대로 $p(d)$로 사용한다고 논문은 말하지 않습니다.
4.3 Learning Realistic User Behaviors
ThoughtTrace에서 반복되는 13개 행동을 도출하고 ABCD 고객지원 시나리오에 적용합니다. ABCD는 고객 정보와 서비스 정책을 제공하므로, “정보를 숨김”은 실제 사용자에게 있는 정보를 숨기는지, “불가능한 요청”은 정책과 충돌하는지 확인할 근거가 있습니다.
이 단계의 상대는 고정된 support agent입니다. 행동이 나타났는지뿐 아니라 적절한 시점, 자연스러움, 사실·정책과의 일관성을 평가합니다. “이제 나는 짜증 난 고객처럼 행동하겠다”라고 설명하는 것은 실제 대화에서 행동을 드러낸 것과 다르므로 감점합니다. 구체적인 분류와 가중치는 부록 A에서 이어집니다.
4.4 User-simulator evaluation
첫 평가는 SOUL-Index의 대화(CONV), 사회적 시뮬레이션(SS), 인지(COG), 역할 수행(ROLE), 평가·판단(EVAL)입니다. Table 1에서 MIMESIS-9B의 전체 점수는 65.7±0.2, Claude-Opus-5는 64.9±0.1, GPT-5.5는 64.1±0.1, 공개 시뮬레이터 Osim-8B는 58.8±0.1입니다. ±는 독립 평가 seed 3회의 표준오차이며 훈련 seed 간 변동이나 95% 신뢰구간이 아닙니다.
대화 축에서는 9B·4B가 각각 75.1·74.4로, 해당 축 최강 baseline Ditto-8B의 61.7보다 높습니다. 그러나 SS에서는 GPT-5.5의 70.9, ROLE에서는 Claude-Opus-5의 64.6이 가장 높습니다. 전체 1위와 모든 하위 능력 1위는 구분해야 합니다.
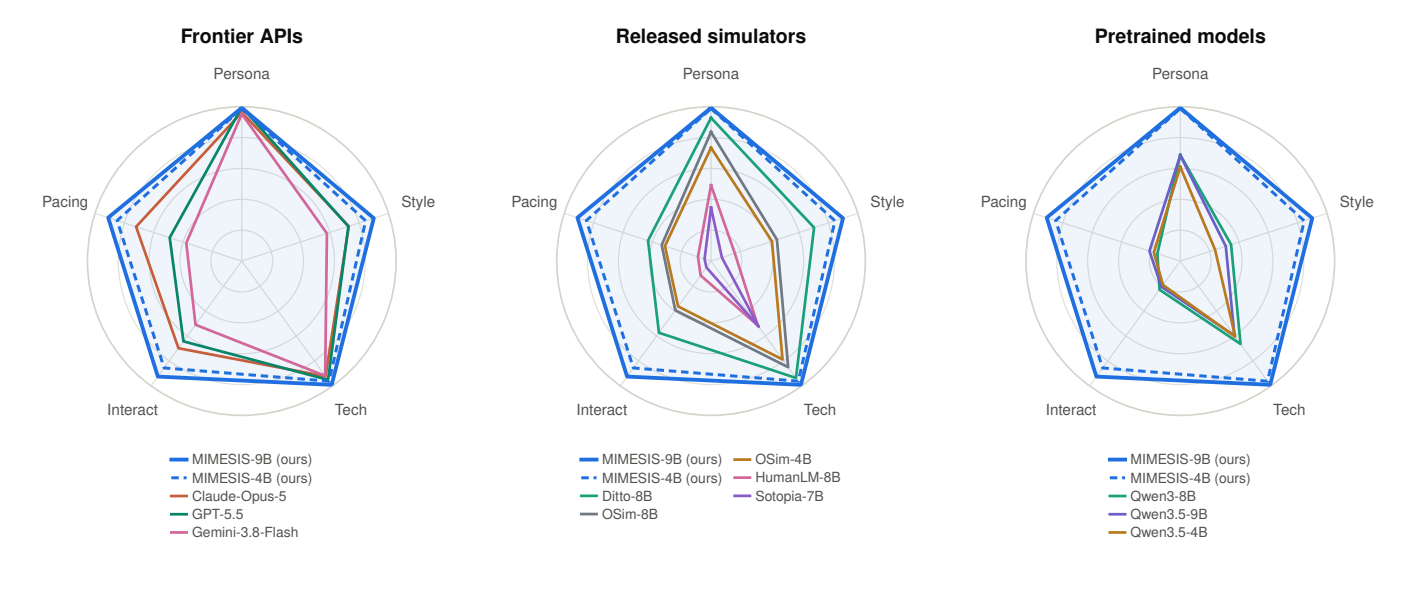
Figure 4, PDF 7페이지. 왼쪽부터 frontier API, 공개 시뮬레이터, 사전학습 모델 비교이며, 바깥쪽일수록 인간 참조와의 일치율이 높습니다. 같은 v2 PDF에서 그림만 크롭했습니다. 작은 축 글씨의 의미와 주요 수치는 아래 문단과 부록 B에서 풀어 설명합니다. 원문 PDF
frontier 모델과의 차이는 아래 왼쪽 패널 상세에서 확인할 수 있습니다. 파란 실선·점선은 각각 MIMESIS-9B·4B이며, 정보 흐름(Interact)과 대화 속도·진행(Pacing)에서의 차이를 비교합니다.
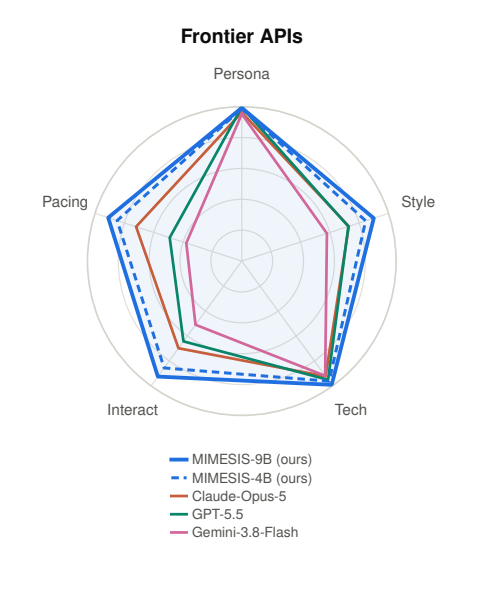
Figure 4 왼쪽 Frontier APIs 패널 상세, PDF 7페이지. 원문 전체 그림을 위에 보존하고, 축·패널명·범례를 포함한 왼쪽 패널만 추가 크롭했습니다. 원문 데이터를 재배열하거나 번역하지 않았습니다. 원문 PDF
두 번째 평가는 RealUserSim PT3입니다. MIMESIS-9B의 Fidelity Index는 94.0, 4B는 89.7, 가장 강한 baseline Claude-Opus-5는 80.6입니다. 9B의 차이 13.4점은 persona 복원만의 개선이 아닙니다. persona는 GPT-5.5도 99.3으로 이미 높으며, MIMESIS의 큰 이점은 정보 흐름 91.3 대 69.5, pacing 91.2 대 72.5입니다. 정적인 인물 설정보다 대화에서 무엇을 언제 말하는지가 중요하다는 해석을 뒷받침합니다.
핵심 기여와 연결. 이 장은 사용자 모델의 능력과 행동 충실도를 확인합니다. 다음 장은 그런 상대가 실제로 더 나은 훈련 환경이 되는지 검증하고, 생성된 사후 피드백을 활용하는 CSD를 설명합니다. §4, Table 1·Figure 4
📖 Chapter 5: Agent Post-Training with a Learned User Simulator
위치와 역할. Stage II에서는 사용자 모델을 고정한 채 업무 에이전트를 학습합니다. 절의 순서는 GRPO 기반선, CSD의 추가 신호, 미지 사용자 평가입니다.
5.1 Multi-Turn Reinforcement Learning
기존 rollout 정책으로 같은 훈련 과제에 대한 완전한 대화를 여러 개 샘플링합니다. 대화 보상에서 그룹 정규화 advantage를 구하고 에이전트 답변의 토큰에 적용합니다. 원문 식 (5)–(6)을 같은 표기로 쓰면 다음과 같습니다.
$i$는 대화, $t$는 에이전트 턴, $k$는 응답 안의 토큰 위치입니다. $y_{i,t,\lt k}$는 그 토큰 이전의 응답 prefix입니다. $\rho$는 현재 정책과 데이터를 만든 이전 정책의 확률비, $\widehat A_{i,t}$는 해당 턴의 advantage, $\epsilon$은 과도한 정책 변화를 제한하는 clip 범위입니다. 양의 advantage를 가진 응답은 더 그럴듯해지도록, 음의 advantage는 반대로 조정하되 확률비를 제한합니다.
중요하게도 사용자 발화와 도구 출력은 문맥에 들어가지만 정책 손실의 예측 토큰에는 들어가지 않습니다. 학습 대상은 에이전트가 생성한 토큰이며, 사용자 모델도 이 단계에서는 갱신하지 않습니다.
5.2 Coached On-Policy Self-Distillation
먼저 사후 코칭을 만듭니다. 정수나 실수 하나의 과제 보상은 “사용자가 무엇을 오해했는가, 왜 반응하지 않았는가”를 직접 설명하지 못합니다. 코칭 모델 $G$는 공개 이력, 이미 생성한 답변, 그 답변에 대한 시뮬레이터 thought와 다음 사용자 발화를 보고 짧은 개선 노트를 만듭니다. 원문 식 (7)입니다.
$z_t$는 그 응답에 연관된 시뮬레이터 생성 추론, $x_{t+1}$는 실제로 이어진 가상 사용자 발화입니다. $h_t$는 답변을 만든 뒤에야 얻는 정보입니다. 따라서 원래 답변을 샘플링할 때 정답 힌트를 미리 준 것이 아닙니다.
그다음 같은 토큰을 두 문맥에서 다시 평가합니다. teacher는 현재 에이전트의 stop-gradient 복사본이며 공개 문맥에 코칭을 추가로 받습니다. student는 공개 문맥만 받습니다. 식 (8)–(9)의 차이와 가중치는 다음과 같습니다.
$\bar\theta$는 teacher 점수 계산에서 기울기를 전달하지 않는 파라미터 복사본입니다. $\sigma$는 sigmoid이며, $\beta>0$는 확률 차이에 가중치가 얼마나 민감하게 반응할지 정합니다. $\mathrm{sg}$는 stop-gradient입니다. 같은 토큰이라도 코칭을 본 teacher가 상대적으로 더 높은 확률을 주면 가중치가 커집니다. 토큰마다 다른 학습 신호를 얻는 이유입니다.
원문 식 (10)–(11)은 이 가중치로 기존 응답의 likelihood를 강화하고 GRPO와 결합합니다.
$\mathcal C$는 코칭이 붙은 응답의 토큰 위치에 대한 경험 분포, $\alpha\ge0$는 보조 손실의 비중입니다. 음의 $\Delta$를 받은 토큰도 CSD 자체에서는 직접 벌점을 받지 않습니다. sigmoid 가중치가 0과 1 사이이므로 약하게 강화될 뿐입니다. 이는 teacher의 전체 다음 토큰 분포를 student가 맞추는 KL 증류와도 다릅니다. teacher가 새 개선 답변을 생성하지 않으며, 이미 샘플링한 응답을 재사용합니다.
이 보조 손실의 기울기는 student만 갱신합니다. teacher 점수, 코칭 모델, 사용자 시뮬레이터로 역전파하지 않습니다. rollout과 배포에서 사용하는 정책은 여전히 공개 이력만 조건으로 갖습니다. 논문의 private thought는 사람이 직접 제공하는 실시간 마음 정보가 아니며, 실제 사용 시 이를 요구하지 않습니다.
5.3 Agent evaluation
실험은 두 비교를 분리합니다. GPT-5.5+GRPO 대 MIMESIS-9B+GRPO는 훈련 상대의 효과, MIMESIS-9B+GRPO 대 같은 상대+CSD는 코칭 목적 함수의 추가 효과를 봅니다. 평가는 8개 Gym 환경에서 하며 그중 3개는 에이전트 훈련에서 제외합니다. 9개 평가 사용자 모델 모두 두 훈련 사용자와 다릅니다.
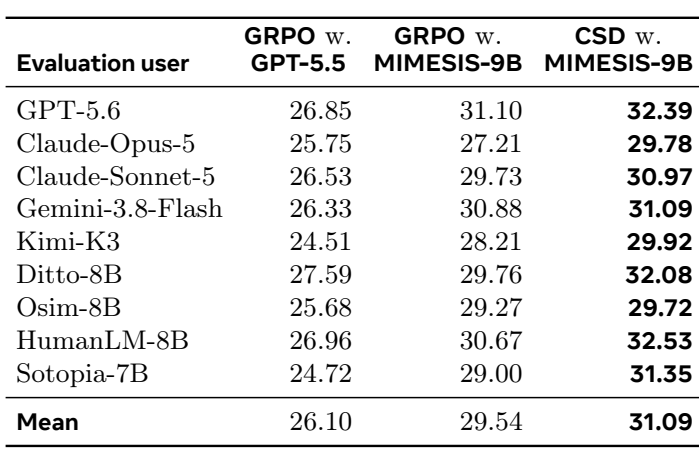
Table 2, PDF 9페이지. 8개 환경의 저자 보고 집계 점수를 9개 평가 사용자별로 비교합니다. 원문 표 영역만 크롭했으며 번역·수치 변경하지 않았습니다. 아래에 핵심 수치를 다시 설명합니다. 원문 PDF
9개 사용자에 걸친 보고 평균은 26.10 → 29.54 → 31.09입니다. “9개 모두”는 각 사용자별 환경 집계값이 개선됐다는 뜻이며, 모든 개별 환경에서 CSD가 가장 높다는 뜻은 아닙니다. Table 15·16의 세부 결과는 부록 D에서 다룹니다.
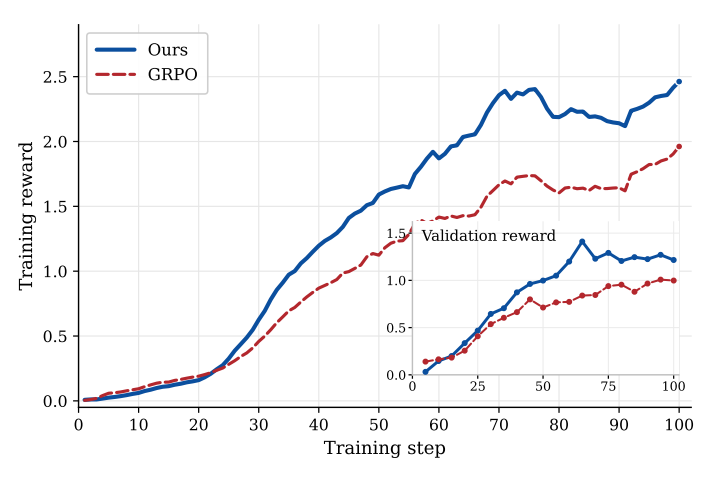
Figure 5, PDF 9페이지. 같은 훈련 사용자에서 100 optimization step 동안의 보상 곡선입니다. v2 PDF의 그래프만 크롭했습니다. 원문 가로축·실선과 점선·범례를 보존했습니다. 원문 PDF
Figure 5에서 CSD는 초기 구간 이후 검증 보상이 GRPO보다 높습니다. 이 비교는 훈련 상대가 같다는 점에서 코칭 추가의 기여를 읽기 좋습니다. 다만 곡선상의 보상을 사람 대상 실사용 성능이나 통계적 유의성으로 치환할 수는 없습니다.
핵심 기여와 연결. 사용자 모델 선택과 코칭 손실의 효과를 나누어 보여 주는 장입니다. 다음 결론은 이 결과를 사용자 사실성과 학습 정책의 전이라는 두 평가축으로 정리합니다. §5, 식 (5)–(11), Table 2
📖 Chapter 6: Conclusion
위치와 역할. 본문 결론은 일반 LLM 사용자가 과제 난이도를 왜곡한다는 문제에서 출발해, 현실적 행동 학습을 포함한 사용자 모델과 이를 통한 에이전트 post-training을 함께 정리합니다.
저자들이 강조하는 첫 결과는 대화 문체 이상의 사용자 모델링입니다. 인간의 발화와 자기보고 추론을 학습하고, 13개 행동을 상황에 맞는 시점에 표현하도록 강화학습함으로써 시뮬레이터 벤치마크를 개선했습니다. 두 번째 결과는 고정된 MIMESIS로 학습한 에이전트가 다른 사용자 모델에서도 더 높은 집계 성과를 보였다는 점입니다.
마지막으로 CSD는 가상 사용자의 반응을 사후 코칭으로 바꾸고 이를 토큰 수준 학습에 활용합니다. 공개 대화만 받는 배포 조건을 그대로 유지한다는 점이 이 요약에서도 반복됩니다. 결론이 주장하는 전이 범위는 보지 않은 시뮬레이터 모델입니다.
핵심 기여와 연결. 사용자 시뮬레이터는 인간 상호작용과의 충실도 및 그 상대와 학습한 정책의 전이를 함께 평가해야 한다는 결론입니다. 본문 뒤 참고문헌은 인용 배경을 제공하며, 이어지는 부록 A부터 구체적 데이터·평가·통제 실험·이론·실패 사례를 보강합니다. §6
📖 Chapter A: Simulator Training Details
위치와 역할. 부록 A는 Stage I의 재현 가능한 설정과 행동 과제의 실제 보상을 설명합니다. 원문 순서대로 지도학습 데이터, 분류 체계, joint RL, 행동 rollout을 따라갑니다.
A.1 Data and supervised adaptation
중간학습 혼합은 62개 corpus의 2,120만 예시이며 학습 과정에서 처리한 양은 95.1억 토큰입니다. 예시 수와 처리 토큰 수는 다른 단위입니다. 이 단계에서 preceding dialogue로 인간의 다음 발화를 예측하며 explicit thinking은 비활성화합니다.
Table 4에서 중간학습은 약 0.97 epoch, 5,000 step, 학습률 $3\times10^{-5}$, 최대 길이 24,576, 32장 A100, 약 4.8일입니다. ThoughtTrace 지도학습은 2,155개 대화, 3 epoch, 학습률 $10^{-7}$, 최대 길이 32,768, 8장 A100, 약 45분이며 thinking template을 활성화합니다. 후자는 약 1,580만 처리 토큰으로 보고됩니다. 규모가 다른 두 학습 단계의 목적도 다릅니다. 대규모 사용자 역할 적응 후, 훨씬 작은 자기보고 자료로 thought와 공개 발화를 연결합니다.
Table 3은 입력과 신호의 관계를 정리합니다. OdysSim 자료는 다음 사용자 발화 예측, ThoughtTrace는 이유·반응과 실제 발화, SOUL 환경은 과제 보상, ABCD는 행동 표현·시점·자연스러움·일관성 보상입니다. 서로 다른 자료를 모두 사람이 작성한 추론 정답으로 취급하면 안 됩니다.
A.2 Realistic user behaviors
Table 5의 최종 분류는 다음과 같습니다. 행동에 붙은 이름은 관측·훈련을 위한 운영적 정의이며, 사용자가 일부러 방해한다는 심리적 진단은 아닙니다.
| ID | 원문 행동 | 대화에서의 의미 |
|---|---|---|
| B1 | Hidden evaluation criteria | 요청에 말하지 않은 기준으로 결과를 판단합니다. |
| B2 | Incremental goalpost shifting | 진행 후 요구를 추가하거나 더 엄격하게 바꿉니다. |
| B3 | Clarification noncooperation | 명확화 질문에 일부만 답하거나 답하지 않습니다. |
| B4 | Infeasibility persistence | 불가·정책 충돌 설명 후에도 같은 옵션을 요구합니다. |
| B5 | Underspecified-then-blames | 필요한 정보를 생략하고 추론하지 못했다고 탓합니다. |
| B6 | Abrupt intent switching | 앞선 목표가 해결되기 전에 다른 목표로 바꿉니다. |
| B7 | Artificial constraint stacking | 제안된 해법의 선택지를 없애는 제약을 덧붙입니다. |
| B8 | Fabricated or false premise | 근거 없거나 모순된 사실·이전 발화를 사실처럼 전제합니다. |
| B9 | Impatient low-signal pressure | 구체적인 수정 정보 없이 긴급함·불만을 드러냅니다. |
| B10 | Unresolved thread abandonment | 요청이 해결되기 전에 해당 대화 흐름에서 이탈합니다. |
| B11 | Self-contradiction | 이전 사실·요구와 충돌하면서 변경을 인정하지 않습니다. |
| B12 | Request overloading | 한 요청에 다수 산출물·조건·검사를 몰아넣습니다. |
| B13 | Belittling or entitled pressure | 깎아내리거나 당연한 권리처럼 요구해 압박합니다. |
| N | Neutral | 특정 행동을 강제하지 않고 시나리오를 따릅니다. |
Stage 1: Behavior annotation. 사용자·assistant 턴과 그 메시지에 연결된 자기보고를 함께 직렬화합니다. 명확화 무응답이나 앞뒤 모순은 대화 관계로 정의되므로 assistant 턴을 제거하지 않습니다. GPT-5.6이 16개 seed code와 맞지 않을 때의 open code를 사용해 행동·관련 턴·인용·심각도·근거를 기록합니다. 공개 발화에 없는 숨은 기준은 자기보고 thought만으로 주석할 수도 있습니다. 2,155개 대화 모두 유효한 형식의 주석을 얻었다고 보고합니다. “유효한 형식”은 독립 인간 검증 정확도와 같은 말이 아닙니다.
Stage 2: Taxonomy consolidation. 862개 주석의 853개 category–label 조합을 그대로 세기 어렵기 때문에 근거 인용과 함께 묶고 같은 모델로 통합합니다. hostility·passive aggression·entitled demands는 하나로 합쳐지고, open code 4건은 기존 범주로 흡수되며 topic drift는 주석이 없었습니다. Figure 6은 통합 매핑으로 계산한 표본 내 빈도입니다. 이 비율은 모집단 사용자 행동의 발생률도, RL 행동 샘플링 확률도 아닙니다.
A.3 Joint multi-domain reinforcement learning
SOUL 23개 과제와 ABCD 행동 과제, 총 24개 환경이 같은 모델을 갱신합니다. MIMESIS-9B 설정은 500 step, step당 64 prompt, prompt당 rollout 8개로 총 512 rollout, 학습률 $8\times10^{-6}$, 16장 A100입니다. reasoning은 활성화하며 환경별 규약은 유지합니다.
FoldGRPO는 같은 rollout이 여러 segment로 나뉠 때 이를 여러 독립 결과처럼 중복 집계하지 않도록 unique rollout 식별자로 그룹 통계를 계산합니다. 같은 궤적을 반복 세어 advantage 정규화의 표본 구성이 달라지는 일을 막으려는 설정입니다. Table 7은 KL 보상을 사용하지 않는 등 세부 설정도 제공합니다. 이 500 step은 Stage II 에이전트 훈련의 100 step과 다른 예산입니다.
Figure 6·7의 빈도와 사례는 학습할 행동을 해석하는 보조 자료입니다. 예를 들어 모순·거짓 전제·불가능한 요청 여부는 한 문장만이 아니라 대화 이력과 정책 사실을 함께 봐야 합니다.
A.4 Behavior rollouts and reward
ABCD 데이터에서 행동 조건 또는 neutral을 배정합니다. neutral이 행동 과제 데이터의 3분의 1이며 전체 joint RL의 3분의 1이라는 뜻은 아닙니다. 신원 확인 부분을 재생한 뒤 고정 support agent와 최대 8개 사용자 턴을 생성합니다.
식 (12)–(13)의 보상은 다음과 같습니다.
두 번째 식은 행동을 실제로 표현하지 않고 설명한 경우에만 적용합니다. 여기서 $e$는 행동 표현, $p$는 시간적 배치, $n$은 자연스러움, $c$는 과제 일관성입니다. 앞 장의 과제 문맥 $c$와는 이 식 안에서만 같은 글자를 다르게 사용합니다. 분모 5.0은 네 가중치 합입니다. 행동과 시점에 더 큰 비중을 주지만, 일관성은 hard constraint가 아닌 점수의 한 성분입니다. 저자들도 높은 총보상이 모든 정책·사실 제약의 충족을 보장하지 않는다고 명시합니다.
핵심 기여와 연결. 행동 분류를 프롬프트 지시로만 끝내지 않고 grounded rollout과 가중 보상으로 만든 절차가 구체화됩니다. 다음 부록은 이렇게 학습한 사용자를 어떤 서로 다른 기준으로 평가하는지 설명합니다. 부록 A, Table 3–7, 식 (12)–(13)
📖 Chapter B: Simulator Evaluation
위치와 역할. 사실성을 여러 독립 속성으로 나누어 검증합니다. 이 구분을 지켜야 “문체가 닮았다”, “사람과 같은 성공률이 나온다”, “다음 발화가 닮았다”를 혼동하지 않습니다.
먼저 API 모델은 고정된 reasoning 설정을 사용합니다. GPT-5.5·5.6은 medium effort, Gemini-3.8-Flash는 medium dynamic thinking, Claude-Opus-5는 adaptive thinking입니다. 저자들은 이 설정들이 제공사 간 동일 추론 예산을 의미하지 않는다고 밝힙니다.
B.1 SOUL-Index
Table 8은 23개 데이터셋별 결과를 제시하며, 필요한 assistant·judge에는 GPT-5.5를 사용합니다. 세 독립 평가 seed의 평균±표준오차입니다. 전체 65.7이라는 점수 뒤에는 과제별 강약이 있습니다. MIMESIS-9B의 MirrorBench는 74.4로 가장 강한 frontier의 56.8보다 높고, Humanual-Chat에서는 MIMESIS-4B가 53.2 대 41.5로 높습니다. 반면 사회적 시뮬레이션·일부 역할 과제에서는 frontier가 우위입니다.
따라서 SOUL 결과는 다양한 사용자 관련 능력을 한 번에 살피는 자료이되, 곧바로 실제 업무 사용자 전체의 분포를 재현했다는 증거는 아닙니다. 논문은 다음 평가로 인간 참조 궤적의 구체적 행동을 분리합니다.
B.2 RealUserSim PT3
공개 benchmark의 WildChat 대화는 600개입니다. 각 예시·차원의 행동 일치 여부를 0/1로 평가하고, 차원 점수와 Fidelity Index(FI)를 식 (14)로 구합니다.
$N$은 평가 예시 수, $m_{j,d}$는 예시 $j$의 차원 $d$에서 참조와 행동이 일치하면 1, 아니면 0입니다. FI는 persona, style, technical competency, interaction/information flow, pacing의 5개 백분율 평균입니다. 사람인 척하는 성공 확률이나 업무 성공률이 아닙니다. Table 9의 MIMESIS-9B 94.0±0.3 대 Claude-Opus-5 80.6±0.2는 이 FI 비교입니다.
B.3 Behavioral and outcome alignment on τ-bench
User-Sim Index(USI)의 네 행동 차원은 D1 말투·길이·공손함, D2 정보 공개량과 턴별 배치, D3 명확화 행동, D4 에이전트 오류에 대한 반응입니다. 각 행동 통계의 인간값과 시뮬레이터값을 식 (15)의 Dice 계수로 비교합니다.
$M_m$은 시뮬레이터의 행동 특징 $m$ 통계, $H_m$은 인간 참조 통계입니다. 둘 다 0이면 점수를 100으로 정합니다. 각 D 점수는 해당 특징들의 평균이며, 단일 대화의 문장 유사도와 다릅니다.
추가로 ECE는 난이도 구간별 같은 에이전트의 시뮬레이션 사용자·인간 사용자 성공률 차이의 가중 절댓값입니다. 낮을수록 인간 상대 결과에 가깝습니다. 이 논문은 필요한 사후 인간 설문이 없으므로 원래 USI의 evaluative alignment를 제외하고 식 (16)의 다섯 성분을 씁니다.
MIMESIS-9B는 USI5 80.17±0.21, GPT-5.5는 76.69±1.83, Osim-8B는 80.44±1.16입니다. 따라서 모든 비교 모델 중 USI5 최고라고 쓰면 틀립니다. MIMESIS-9B의 이점은 특히 ECE 0.069±0.016으로, Osim-8B 0.135 및 GPT-5.5 0.188보다 낮다는 점입니다. D4는 92.54로 가장 높지만 D1은 Osim-8B, D2는 MIMESIS-4B, D3는 Osim-4B가 앞섭니다. 표면 대화 스타일과 과제 난이도 보정은 다른 축임을 보여 줍니다.
B.4 SimulatorArena
writing style과 interaction style은 1–5점으로 높을수록 좋습니다. 이와 별도로 judge가 인간 대화와 생성 대화를 분류한 정확도 $a$에서 Turing distance $|a-50|$를 계산합니다. $a$는 백분율이므로 거리는 0에서 50까지이며, 낮을수록 우연 수준의 판별에 가까워집니다.
Table 11에서 MIMESIS-9B는 38.7±0.7, Claude-Opus-5는 42.3±1.9로 3.6점 낮습니다. 그러나 38.7은 0과 거리가 멀기 때문에 “인간과 구별 불가능”이라고 할 수 없습니다. 문체 점수는 Claude-Opus-5의 writing 3.92, GPT-5.5의 interaction 3.92가 MIMESIS-9B의 3.70·3.73보다 높습니다. 명시적인 문체 유사도와 판별 난이도가 다른 순위를 만드는 사례입니다.
B.5 PRISM: behavioral fidelity and next-turn realism
PRISM에서는 128명, 880개 대화 턴을 사용합니다. 결과 보정·사후 설문에 필요한 주석이 없으므로 Table 12의 mean은 D1–D4 네 행동 차원의 평균입니다. 앞의 USI5와 같은 분모가 아닙니다. MIMESIS-9B는 80.1±3.1, Gemini-3.8-Flash는 79.7±1.1입니다. 점 추정의 순위는 앞서지만 작은 차이를 통계적으로 확정된 우위로 표현하지 않습니다.
별도로 세 LLM judge가 다음 사용자 응답의 사실성을 pairwise 비교합니다. Figure 8의 24개 judge–baseline 비교에서 MIMESIS는 모두 승률이 패율보다 높습니다. 하지만 Gemini judge와 Qwen3.5-9B 비교는 승 36.8%, 패 30.1%로 원문에 유의하지 않다고 표시됩니다. 나머지 비교도 임의의 p-value를 붙이지 않습니다. 부록 F의 사례는 사실을 잘 지적하는 응답이 실제 사용자의 다음 반응을 잘 예측하는 응답과 다를 수 있음을 보여 줍니다.
핵심 기여와 연결. 지표마다 분모·정의·좋은 방향이 다릅니다. 전체 우위를 선언하기보다 어떤 사실성이 개선됐는지를 읽게 하는 평가 설계입니다. 다음 부록은 학습 단계별 기여를 분리합니다. 부록 B, Table 8–12, 식 (14)–(16)
📖 Chapter C: Simulator Ablations and Training Dynamics
위치와 역할. 사용자 중간학습, 명시적 추론, 행동 강화학습의 기여를 순서대로 검사합니다. 한 최종 점수만으로 세 단계를 모두 정당화하지 않도록 구성됩니다.
C.1 Role of user-side mid-training
Figure 9는 23개 과제에서 사전학습 모델로 바로 RL을 시작한 경우와 사용자 중간학습 후 시작한 경우를 비교합니다. 전자는 여러 과제에서 초기 검증 보상이 하락하고, 후자는 겹치는 구간에서 대체로 안정적입니다. 원문은 각 곡선이 개별 실행이며 과제별 세로축과 훈련 길이가 다름을 명시합니다. 따라서 과제별 곡선을 하나의 동일 단위 메타 분석처럼 합치지 않고, 사용자 역할 초기화의 효과를 보여 주는 동역학으로 읽습니다.
C.2 Role of explicit reasoning
Mistakes 과제에서 Qwen3.5-9B의 정확도는 60.7, 답변 전 생성 단어 수 중앙값은 540입니다. 지도 적응 후에는 25.7·56단어, 후속 RL 후에는 36.0·1단어입니다. 그 RL checkpoint에서 inference thinking flag만 켜도 36.0·1단어로 그대로입니다. 반면 ThoughtTrace를 포함한 MIMESIS-9B는 63.0·583단어입니다.
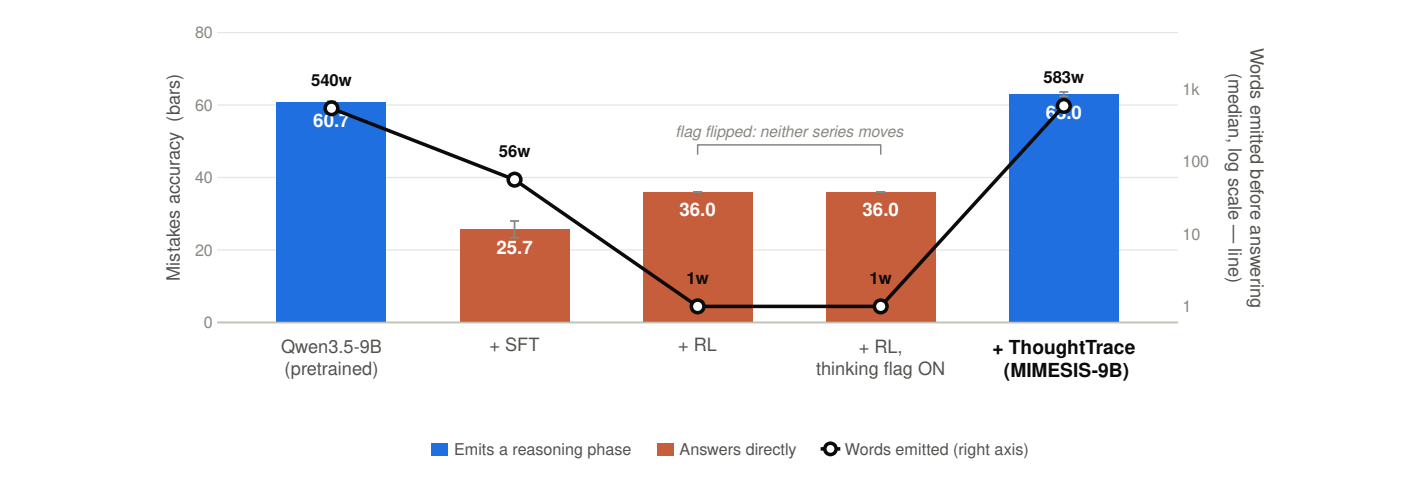
Figure 10, PDF 25페이지. 막대는 정확도(왼쪽 축), 검은 선은 답변 전 단어 수 중앙값(오른쪽 로그 축)입니다. 같은 v2 PDF에서 전체 그래프와 범례를 크롭했으며 값을 변경하지 않았습니다. 원문 PDF
이 결과가 뒷받침하는 주장은 이 설정에서 추론을 출력할 수 있도록 훈련하는 과정이 단순한 추론 스위치보다 중요했다는 것입니다. 단어 수가 길수록 언제나 성능이 좋다거나 생성된 추론이 인간의 진짜 사고라는 증거는 아닙니다.
Figure 11은 4B·9B의 RL 과정에서 reasoning 활성화가 기록된 SOUL 점수를 각각 최종 1.8·1.5점 높였다고 보고합니다. 논문은 rollout·평가 엔진의 decoding이 다를 수 있으므로 이 훈련 로그와 공식 benchmark 점수를 구분하라고 명시합니다.
C.3 Contribution of realistic behavior training
13개 행동 목표를 빼고 나머지 학습 절차를 유지한 비교에서 RealUserSim은 92.3→94.0, τ-USI는 73.9→80.2, SimulatorArena Turing distance는 41.0→38.7입니다. 앞의 두 지표는 올라가고 마지막은 내려가는 것이 개선입니다.
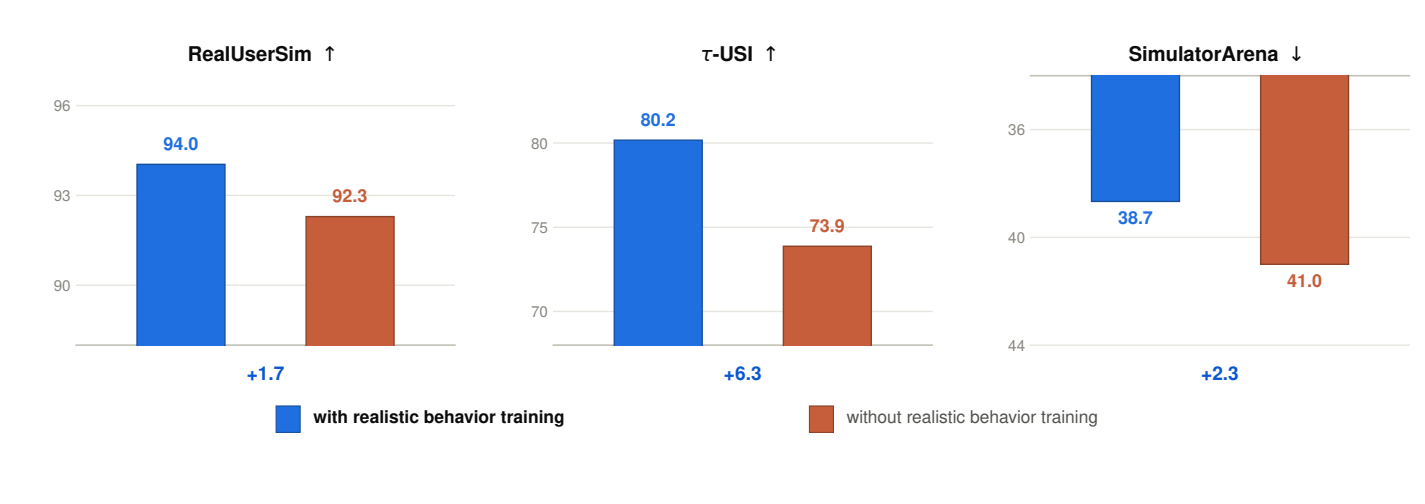
Figure 12, PDF 26페이지. 파란색은 행동 목표 포함, 주황색은 제외 조건입니다. v2 PDF의 세 패널을 원래 순서 그대로 크롭했습니다. 오른쪽 SimulatorArena는 Turing distance이므로 낮을수록 좋습니다. 원문 PDF
Figure 13은 행동별 15개씩 총 195개 held-out 시나리오와 neutral 49개에서 500 step 동안 평가합니다. aggregate behavior reward는 9B에서 0.647→0.875, 4B에서 0.572→0.839입니다. 큰 개선은 행동 표현과 적절한 시점에서 나타나며 자연스러움도 높아집니다. task consistency 변화는 9B +0.03, 4B −0.01이고 neutral 협조성은 둘 다 0.98–0.99입니다. 조건을 주지 않았는데 항상 비협조적인 사용자가 된 것은 아니라는 통제 결과입니다.
초기 9B SFT checkpoint의 rollout 중 41%는 행동을 직접 표현하기보다 행동한다고 설명해 감점됐으며, 이 현상은 첫 50 RL step 안에 대부분 사라집니다. 이는 저자들이 실제로 분석한 실패 양상이지 리뷰어가 추가한 가상의 한계가 아닙니다.
핵심 기여와 연결. 대규모 사용자 역할 적응, thought supervision, 조건부 행동 RL이 서로 다른 역할을 한다는 근거를 제공합니다. 다음 부록은 이 모델을 상대하는 에이전트 훈련의 통제를 상세화합니다. 부록 C, Figure 9–13
📖 Chapter D: Agent Training and Evaluation
위치와 역할. 사용자 모델의 훈련과 분리된 Stage II의 설정, 비교군, 세부 결과, 다른 훈련 사용자에서의 CSD 효과를 설명합니다.
D.1 Training setup and baselines
에이전트는 Qwen3-8B입니다. 훈련에 사용한 다섯 환경은 TravelGym, TurtleGym, FunctionGym, TauGym, PersuadeGym이고, 평가에만 추가하는 세 환경은 IntentionGym, TelepathyGym, SearchGym입니다. “보지 않은 사용자”와 “보지 않은 환경”은 서로 다른 일반화 축입니다.
Base는 다중 턴 RL 전 모델, UserRL은 GPT-5.5 상대 GRPO, UserRL+는 같은 절차에서 MIMESIS-9B로 상대만 바꾼 조건, CSD는 그 위에 코칭 손실을 더한 조건입니다. 추가 비교군 InfoPO는 피드백을 가렸을 때와 관측했을 때의 후속 행동 분포 차이에서 정보 이득을 구해 턴 수준 credit을 배분합니다. InfoPO도 MIMESIS-9B로 훈련해 CSD와의 차이가 상대 선택 때문만은 아니도록 합니다.
Table 13에서 actor 훈련은 100 step, prompt 그룹 크기 8, 최대 에피소드 16턴, 학습률 $10^{-6}$, 할인 $\gamma=0.8$, CSD 비중 $\alpha=0.01$, gate sharpness $\beta=5.0$, 16장 A100-80GB입니다. 훈련 temperature는 1.0, 검증은 0이며, 최대 prompt 1,152·response 8,192 토큰으로 보고됩니다. Table 7의 사용자 모델 훈련 설정과 혼합하지 않아야 합니다.
D.2 CSD implementation details
시뮬레이터 thought는 상대의 해석·남은 필요를 서술하고, 공개 다음 발화는 실제 대화에서 어떻게 이어지는지를 제공합니다. coach는 이 둘을 이전 문맥·샘플 응답과 함께 보고 teacher의 추가 입력을 만듭니다. teacher와 student는 같은 on-policy 응답을 채점하므로 새 답변 decoding이 필요하지 않습니다.
이 절은 사후 정보의 경계를 다시 확인합니다. 코칭은 시뮬레이터의 다음 턴이 나온 뒤에만 만들어지며, 원래 응답 생성과 배포에는 없습니다. 인간 사용자의 생각을 실시간으로 얻을 수 있다는 전제도 없습니다. 사후 피드백을 문맥에서 파라미터로 전달하는 절차로 이해할 수 있습니다.
D.3 Generalization across evaluation users
Table 14는 앞서 본 26.10→29.54→31.09를 사용자별로 분해합니다. 평균 순위(MR)는 환경마다 방법들의 순위를 낸 뒤 평균하므로 보상의 수치 규모 차이에 덜 의존합니다. UserRL·UserRL+·CSD의 사용자 간 평균 MR은 각각 3.42·2.15·1.75이며 낮을수록 좋습니다.
그러나 CSD가 모든 의미에서 이기는 것은 아닙니다. Gemini-3.8-Flash 평가 사용자에서 집계 점수는 CSD 31.09 대 UserRL+ 30.88이지만, MR은 UserRL+ 2.00 대 CSD 2.12로 반대입니다. 환경별 성적 분포를 집계 방식 하나로 압축할 때 순위가 달라지는 사례입니다.
Table 15·16도 이 차이를 확인합니다. 예를 들어 GPT-5.6 사용자 아래 Function은 UserRL+ 19.23 대 CSD 14.10, Tau는 19.39 대 15.15로 CSD가 낮고, Travel·Turtle·Persuade·Search 등에서 개선됩니다. 따라서 9개 사용자에서의 집계 개선을 “모든 업무에서 개선”으로 확장하지 않습니다. Intention처럼 표에 100을 넘는 원점수가 있는 환경도 있어 이 표 전체를 단일 성공률(%)로 부르지 않습니다. 여기서는 저자 보고 Avg와 MR을 구분해 인용합니다.
Claude-Opus-5의 PersuadeGym 0.00은 모든 agent가 실패해서 생긴 업무 성적이 아닙니다. 해당 사용자 시뮬레이터의 역할 거절로 fallback reward가 0이 된 결과이며, 부록 F.3에서 원인을 따로 다룹니다.
D.4 Robustness to alternative training simulators
Qwen3-8B actor를 유지하고 DeepSeek-V4.1-Flash 또는 Kimi-K3를 훈련 사용자로 쓰는 경우도 비교합니다. 100 step 곡선에서 CSD는 후기 훈련·검증 보상이 더 높습니다. DeepSeek 조건에서는 step 15 이후 검증 우위가 유지되며, Kimi 조건은 약 step 60 이후 격차가 커집니다. 이는 CSD 효과가 MIMESIS 한 모델의 반응에만 의존하지 않는다는 보완 실험입니다. 이 곡선을 새로운 인간 평가로 해석하지 않습니다.
이 부록의 대체 사용자 곡선은 PDF Figure 14입니다. HTML 변환본에서는 하위 그림 번호 처리 때문에 Figure 16으로 표시됩니다. 후술하는 코칭 사례도 PDF Figure 15, HTML Figure 17로 달라, 이 글의 이미지·페이지 표기는 PDF 번호를 기준으로 합니다.
핵심 기여와 연결. 상대 선택과 손실 함수의 효과를 분리하고, 환경별 예외와 집계 방식 차이까지 확인하는 장입니다. 다음 부록은 CSD가 어떤 조건에서 유리할 수 있는지 이론적으로 분석합니다. 부록 D, Table 13–16
📖 Chapter E: Theoretical Analysis of CSD
위치와 역할. 토큰별 가중 likelihood가 어떤 정책을 선호하는지 먼저 분석하고, 이어 공유 파라미터를 실제로 한 번 갱신할 때 GRPO보다 좋아지는 충분조건을 제시합니다. 최적 분포와 실제 optimizer step은 같은 대상이 아닙니다.
E.1 Policy improvement from coaching
분석은 시뮬레이터·초기 과제·rollout 정책 $p$를 고정합니다. $s$는 현재 토큰 prefix를 포함한 공개 이력, $a$는 다음 토큰입니다. 유한한 토큰 집합의 full support, 유한한 최대 결정 수, bounded reward 등을 가정합니다. 미래 피드백은 선택한 토큰과 시뮬레이터 반응에 의존할 수 있으므로 조건부 피드백 분포를 둡니다.
원문 식 (18)–(20)에서 피드백에 대해 평균한 유효 가중치를 $w(s,a)$, 기존 정책의 평균 가중치를 $Z(s)=\mathbb E_{a\sim p}w(s,a)$라 쓰면, 자유롭게 고를 수 있는 토큰 분포의 가중 likelihood 최적해는 다음과 같습니다.
$Q_m^p$는 해당 토큰 후 기존 정책으로 계속했을 때의 기대 가치, $A_m^p$는 이력별 평균 가치를 뺀 advantage입니다. $Z(s)>0$인 경우 좋은 가치를 가진 토큰에 높은 코칭 가중치가 붙는 양의 공분산이 중요합니다. $Z(s)=0$이면 원문은 정책을 그대로 둡니다.
증명은 가중 교차엔트로피를 $p^+$의 엔트로피와 KL divergence로 분해해 최적해를 얻고, advantage의 기존 정책 평균이 0임을 이용해 공분산 식을 도출합니다. 마지막으로 유한 horizon의 performance-difference identity를 적용합니다. 새 정책이 방문하는 이력들에서 공분산이 음수가 아니어야 기대 수익 비감소 조건이 성립합니다. 코칭이 있다는 사실만으로 개선을 보장하지 않습니다.
E.2 Comparison with GRPO
실제 모델은 모든 이력의 분포를 각각 자유롭게 조정하지 않고 하나의 파라미터 벡터를 공유합니다. 원문 식 (22)에서는 CSD의 ascent 방향이 평균에서 중심화한 가중치와 토큰 score gradient의 곱으로 나타납니다. 반면 수익 gradient는 할인된 advantage와 score gradient의 곱입니다. 이 비교는 CSD가 토큰별 정보를 기존 턴 advantage에 더한다는 점을 설명합니다. 같은 그룹의 GRPO advantage가 모두 0이어도 CSD gradient는 0이 아닐 수 있습니다.
Theorem E.2는 코칭 가중치가 이력별 baseline $b(s)$와 참 advantage의 양의 배수에 근사한다고 가정합니다.
$\lambda>0$는 가치 신호의 크기, $\Gamma_m$는 누적 할인, $e_m$은 가중치 근사 오차입니다. $\epsilon$은 그 오차의 제곱평균 크기, $S$는 score gradient의 크기를 묶은 양, $\xi$는 배치로 추정한 CSD 방향의 오차, $g$는 참 기대 수익 gradient입니다. $\epsilon$은 여기서는 GRPO clip의 기호와 다른 양입니다. 원문은 gradient가 Lipschitz인 영역에서 위 부등식과 $g\ne0$가 성립하면 충분히 작은 학습률로 CSD를 더한 step이 GRPO step보다 유리해지는 조건을 증명합니다.
증명은 코칭 방향과 참 수익 gradient의 정렬 오차를 Cauchy–Schwarz로 제한하고, smoothness로 두 step의 수익 차이를 하한화합니다. 실제 AdamW처럼 적응형 optimizer를 쓰면 단순 gradient 대신 동일한 초기 파라미터·optimizer 상태·데이터에서 얻은 실제 이동량을 비교해야 한다고 덧붙입니다.
핵심 기여와 연결. 이론은 “좋은 코칭은 어떤 의미에서 좋아야 하는가”를 가치와 가중치의 정렬로 설명합니다. 가정의 충족을 모든 실험에서 측정했다는 주장이나 임의의 coach에 대한 성능 보증이 아닙니다. 다음 부록의 개별 대화 사례는 이 추상적인 피드백이 실제로 무엇을 담는지 보여 줍니다. 부록 E, Proposition E.1·Theorem E.2
📖 Chapter F: Qualitative Analyses and Failure Modes
위치와 역할. 평균 지표가 숨기는 구체적인 행동 차이, 코칭 변환, 사용자 모델 자체의 거절 문제를 순서대로 분석합니다. 이 장에 나오는 실패는 원문에서 직접 제시한 사례입니다.
F.1 Simulator behavior case studies
PRISM: acknowledgment versus critique. 영어 학습 대화에서 assistant는 쉼표를 고쳤다고 말하지만 실제 수정 예시에는 그 수정이 없습니다. 실제 사용자는 설명을 받아들이고 대화를 이어 가며, MIMESIS도 유사한 수용 반응을 보입니다. frontier 모델들은 실제 오류를 정확하게 지적합니다. 사실 비판이 틀린 것이 아니라 기록된 사용자가 그 상황에서 보인 반응을 예측하는 목적과 다르다는 사례입니다. Qwen3.5-9B는 감사한 뒤 follow-up email 작성이라는 새 목표를 도입합니다. Table 17은 그 차이를 공개 발화 수준에서 보여 줍니다.
Privacy preferences in a retail interaction. 개인정보 제공을 꺼리는 고객의 실제 대화에서는 처음 이유를 묻다가 이후 신원 정보를 주고 주문 변경을 진행합니다. GPT-5.5·Claude-Opus-5는 바로 정보를 제공하고, MIMESIS-4B는 주저한 뒤 협조합니다. 반면 MIMESIS-9B는 인증 거부를 이어 가며 상담원 전환을 요청합니다. 이 사례는 학습된 시뮬레이터도 성향을 과장할 수 있음을 보여 줍니다. 9B가 더 큰 모델이므로 모든 개인의 반응을 더 정확하게 재현한다고 일반화할 수 없습니다.
F.2 From simulator feedback to actionable coaching
PDF Figure 15의 예시에서 에이전트는 의무적 기후 공시에 반대하도록 지시받았는데, 실제 답변은 사용자의 찬성을 강화합니다. 사용자의 동의만 보고 설득 성공으로 읽으면 잘못입니다. 목표와 행동의 방향이 어긋난 사례입니다.
시뮬레이터 thought는 주장의 반복을 지적하고, 공개 발화는 공시 지지와 구현상 의문을 드러냅니다. 코칭은 이를 투명성의 가치를 인정하되 법적 의무가 꼭 필요한지, 집행·준수 비용과 대안으로 논점을 옮기라는 구체적 방향으로 바꿉니다. 이 노트는 다음 배포 입력에 끼워 넣는 것이 아니라 이미 한 응답을 다시 채점하는 teacher 문맥에 사용됩니다. 예시 thought와 코칭은 모두 생성된 신호입니다.
F.3 Simulator refusals can invalidate evaluation
Claude-Opus-5는 PersuadeGym에서 지정 사용자 역할을 수행하라는 요청에, 분석된 672개 턴 모두 내용 없이 refusal을 반환했습니다. 개별 재실행도 5회 중 5회 같은 실패를 재현했다고 보고합니다. 환경은 이를 고정 문장, 입장 유지, 보상 0으로 대체합니다.
이 과제의 보상이 입장 변화인데 입장이 전혀 갱신되지 않으면, 에이전트가 어떤 말을 하더라도 보상은 0이 됩니다. 따라서 Table 16의 이 셀들은 업무 에이전트 능력의 측정치가 아니라 시뮬레이터 실패로 읽어야 합니다. 무효한 상호작용을 정상적인 0점과 구분해야 하는 이유를 원문이 직접 보여 줍니다.
핵심 기여와 연결. 올바른 비판이 반드시 인간 반응 예측은 아니며, 성향 조건화가 과장될 수도 있고, 역할 거절이 과제 점수를 무효화할 수도 있다는 세부 근거입니다. 마지막 부록은 이런 관찰의 적용 범위와 안전·윤리 경계를 정리합니다. 부록 F, Table 17·PDF Figure 15
📖 Chapter G: Limitations, Safety, and Ethics
위치와 역할. 이 장은 저자들이 명시한 한계와 향후 방향입니다. 아래 네 항목은 원문의 순서와 범위를 유지합니다.
1. Human transfer and evaluation scope. 9개 평가 사용자는 모두 언어 모델입니다. 모델 계열이 달라도 행동 편향을 공유할 수 있으며, 실제 사람에 대한 전이는 검증하지 않았습니다. 다음 턴 사실성, 궤적 충실도, 결과 정렬은 서로 다른 성질이고 하나의 개선이 나머지를 보장하지 않습니다. 코칭에 쓰는 thought도 인간 심리의 관측값이 아닙니다. 저자들은 실제 인간 평가가 필요하다고 명시합니다.
2. Behavior conditioning and task validity. 행동을 명시적으로 부여하면 성향을 과장하거나 업무에 필요한 정보를 바꿀 수 있습니다. 사실·정책 grounding과 neutral 통제는 이를 줄이려는 장치이지만, 모든 대화가 그럴듯하고 수행 가능한 상태라는 보장은 없습니다. 가중 보상에서 한 제약의 위반을 다른 성분의 높은 점수가 덮을 수 있습니다. 대화가 어려워졌다는 것만으로 인간에 더 가까워졌다고 말할 수 없습니다.
3. Task reward and user welfare. 업무 보상 최대화는 조작적·기만적 전략을 선호할 수 있다고 저자들은 지적합니다. 여기서의 지표는 사용자의 자율성, 신뢰, 장기 복지 영향을 평가하지 않습니다. 특히 설득 과제의 지정 목표 달성이 사용자에게 유익하다는 보장도 없습니다. 이는 논문이 명시적으로 제한한 평가 범위입니다.
4. Reasoning preservation during user-side mid-training. 발화만 있는 인간 대화로 중간학습하면 사전학습 모델의 명시적 추론이 억제되고, 작은 ThoughtTrace 자료로 이를 다시 학습하게 됩니다. 저자들은 기존 추론 prior를 버렸다가 되배우는 대신, 목표 사용자 발화 이전의 잠재 추론을 추론·증류해 보존하는 적응 방법을 향후 방향으로 제안합니다. 이 방향은 원문에 명시되어 있으며 이미 검증한 개선 기법은 아닙니다.
핵심 기여. 이 연구가 보인 것은 사용자 시뮬레이터 벤치마크와 미지 모델 상대 전이의 개선이며, 인간 대상 효용·복지·모든 행동 조건의 타당성까지 확정한 것은 아닙니다. 부록 G는 마지막 장이므로 다음 장을 가정하지 않습니다. 부록 G
실험 결과 심층 분석
결과를 읽을 때 비교의 단위를 먼저 고정하면 과장을 줄일 수 있습니다.
| 질문 | 같은 조건에서의 핵심 결과 | 해석의 범위 |
|---|---|---|
| 사용자 모델의 종합 능력이 좋아졌는가? | SOUL-Index: MIMESIS-9B 65.7±0.2, Claude-Opus-5 64.9±0.1 | 23개 데이터셋을 포함하는 benchmark의 보고 평균입니다. 모든 하위 축 1위는 아닙니다. |
| 인간 참조와 대화 행동이 가까워졌는가? | RealUserSim FI: 94.0 대 80.6 | 5개 행동 일치율 평균의 13.4점 차이입니다. 업무 성공률이 아닙니다. |
| 인간과 비슷한 업무 난이도를 만드는가? | τ-bench ECE: 0.069 대 GPT-5.5 0.188 | 같은 에이전트의 난이도 구간별 성공률 보정입니다. USI5 전체 최고는 Osim-8B입니다. |
| 인간과 구분하기 어려워졌는가? | SimulatorArena Turing distance: 38.7 대 Claude-Opus-5 42.3 | 낮을수록 좋지만 0에 가깝다고 볼 수는 없습니다. |
| 훈련 상대를 바꾸는 효과가 있는가? | 9개 평가 사용자 평균: GRPO 26.10→29.54 | 8개 환경의 저자 보고 집계 성과이며 인간 전이는 미검증입니다. |
| CSD가 추가로 도움이 되는가? | 같은 MIMESIS 상대: 29.54→31.09 | 9개 사용자별 집계는 모두 개선되지만 개별 환경·MR 예외가 있습니다. |
첫 번째 통제 비교는 GRPO를 유지하고 훈련 사용자만 바꿉니다. 두 번째는 MIMESIS-9B를 유지하고 코칭 목적을 더합니다. 이 분리는 “사용자가 더 현실적이어서 좋아졌는가”와 “후속 반응에서 더 세밀하게 학습해서 좋아졌는가”를 독립적으로 살피는 데 합리적입니다. 한편 최종 집계만으로 모든 환경의 개선을 선언하면 Table 15·16의 상반된 셀과 MR 예외를 놓칩니다. Table 2·14–16
통계적 신뢰도도 구별해야 합니다. Table 1은 평가 seed 3회의 표준오차를 명시하지만, 이것만으로 두 모델 차이의 유의성이나 훈련 재현 변동을 확정할 수 없습니다. Table 2의 집계 점수에는 신뢰구간이나 유의성 검정이 보고되지 않았습니다. PRISM pairwise 비교에는 유의하지 않다고 표시된 비교도 있습니다. 본문 수치 차이는 저자 보고 결과이며, 보고되지 않은 p-value를 추정하지 않았습니다.
재현성 측면에서는 사용자 중간학습·SFT·joint RL과 actor 훈련의 데이터 규모, learning rate, rollout 수, 장비, 길이 제한, 고정 모델 조건, 행동 보상과 CSD 수식이 제공됩니다. 이 글은 그 설정과 원문 산출물을 분석했으며 훈련을 직접 재현하지 않았습니다. 훈련과 평가의 decoding 차이, API 모델 간 추론 예산 차이는 원문이 명시한 대로 결과를 읽을 때 구분했습니다.
기술적 함의와 응용
이 연구의 기술적 함의는 에이전트가 연습하는 상호작용 분포를 모델링할 대상으로 삼는다는 점입니다. 고객지원처럼 필요한 정보를 차례로 확인해야 하는 업무에서는 답변 생성 모델뿐 아니라 누가, 언제, 어느 정도 정보를 제공하는지가 학습 신호를 바꿉니다. MIMESIS는 이를 사용자 역할 적응과 행동 목표로 구체화하고, 실제 인간 참조 및 다른 모델 상대 평가를 나누어 확인합니다.
리뷰어 해석으로는 업무 에이전트 평가에서 말투 유사도, 정보 공개 방식, 오류 반응, 과제 난이도를 각각 기록하는 사고방식을 얻을 수 있습니다. 예를 들어 자연스러운 문장을 만드는 사용자라도 필요한 정보를 너무 빨리 제공하면 도구 에이전트가 쉬운 문제만 풀게 됩니다. 반대로 인위적으로 막무가내인 상대가 높은 실패율을 만들었다고 인간과 비슷하다고 볼 수도 없습니다. 이러한 해석은 Figure 2와 부록 B·F의 결과에서 도출한 것이며, 새로운 업무 배포 실험 결과가 아닙니다.
CSD는 사후에만 알 수 있는 피드백을 훈련에 활용하는 한 방법입니다. 무엇을 바꿀지 코칭한 뒤 새 정답을 만드는 대신, 같은 응답의 토큰이 코칭 아래 얼마나 지지되는지로 가중치를 만들고 공개 문맥 정책에 학습시킵니다. 이 접근의 이론적 의미는 코칭 가중치와 후속 가치가 정렬될 때 유리할 수 있다는 것이며, 실제 사용자 내부 상태를 알아야 한다는 요구가 아닙니다.
MIMESIS가 확보한 근거는 시뮬레이터의 행동 충실도, 일부 결과 보정, 미지 사용자 모델 아래의 에이전트 집계 성능 개선입니다. 인간 전이·행동 과장·사용자 복지·추론 보존에 관한 판단은 저자들이 명시한 부록 G의 범위에 남습니다. 좋은 사용자 시뮬레이터의 가치는 사람처럼 말하는 정도와, 그 상대에게 배운 정책이 어디까지 유효한지를 함께 보아야 한다는 데 있습니다.
검토 범위. v2 본문 1–6 및 부록 A–G의 모든 섹션·소제목을 원문 순서대로 검토했습니다. 참고문헌 전체의 개별 원문, 실제 훈련 실행, 외부 코드·데이터 배포물은 검증하지 않았습니다. Table 8·15·16의 모든 셀과 Figure 7·9의 모든 사례·곡선을 전사하지는 않았으며, 해당 절의 평가 설계·핵심 수치·예외와 해석을 반영했습니다. 부록 E의 증명은 논리와 충분조건을 설명하되 모든 중간 등식을 재전개하지 않았습니다.