논문 개요와 전체 구조
작은 언어 모델 에이전트에게 큰 모델의 행동을 가르칠 때, 모델 바깥의 소프트웨어가 이미 제공하는 정보까지 다시 학습시켜야 할까요? Harness-Aware Distillation(HAD)은 이 질문에서 출발합니다. 하네스(harness)는 현재 위치와 소지품을 기록하고, 사용할 수 있는 행동을 보여 주며, 같은 실패가 반복되는지 알려 주는 실행 소프트웨어입니다. 교사와 학생이 배포 시점에도 같은 하네스를 사용한다면, 학생이 배워야 할 핵심은 그 기록 자체를 암기하는 능력보다 기록을 읽고 다음 행동을 바꾸는 교사의 판단 능력입니다.
Moonseok Choi, Taehong Moon, Giung Nam, Juho Lee는 학생이 실제 방문한 상태에서 같은 교사에게 하네스 정보를 보여 준 응답과 제거한 응답을 각각 받습니다. 학생은 하네스를 본 교사의 전체 응답을 모방하면서, 두 교사 응답의 행동만 자신의 추론 문맥 뒤에서 비교하도록 학습합니다. 하네스 기록과 모순되는 선호 행동은 추가 선호 손실에서 제외합니다. 보상이나 성공 라벨로 선호를 정하는 방식은 아닙니다. 원문 §1–3
ALFWorld에서 Qwen3-1.7B 학생의 미관측 과제 성공률은 하네스를 함께 사용하는 가장 높은 기준선 47.01%에서 HAD 63.43%로 높아집니다. 다만 이 결과는 하네스를 유지하는 텍스트 환경의 증류 실험입니다. 교사를 항상 능가한다거나 하네스를 제거해도 같은 효과가 유지된다는 결론으로 넓힐 수는 없습니다. 이 글은 2026년 10월 2일 제출된 arXiv 2610.02858v1의 본문과 부록 전체를 기준으로 설명합니다. 초록 페이지의 DOI는 arXiv 발급 식별자이며 확인 시점에 등록 대기 상태로 표시됩니다. 초록·버전 정보
원문 구조는 다음과 같습니다.
| 순서 | 원문 절 | 역할 |
|---|---|---|
| 1 | Introduction | 공유 하네스를 쓰는 교사·학생 사이의 증류 문제와 세 가지 실패 유형을 제시합니다. |
| 2 | Related Work | 에이전트 증류, 외부 문맥 학습, 선호 증류와의 관계를 구분합니다. |
| 3 | Method | 3.1 HAD, 3.2 추가 감독 신호, 3.3 행동만 비교하고 학생 추론을 사용하는 이유를 설명합니다. |
| 4 | Experiment | 4.1 설정, 4.2 주요 결과, 4.3 분석, 4.4 모델 계열 일반화, 4.5 절제 실험을 제시합니다. |
| 5 | Conclusion | 결론과 저자가 명시한 한계·향후 연구를 정리합니다. |
| A | Additional Supervision from Harness Awareness | A.1 구현, A.2 절제 변형, A.3 추가 정보, A.4 정규화 편향, A.5 필터링, A.6 전체 응답 비교, A.7 학생 추론 문맥, A.8 점수의 확률 실현을 분석합니다. |
| B | Experiment settings | B.1 모델·과제, B.2 하네스, B.3 활용도, B.4 구현을 명세합니다. |
| C | Prompts and Examples | 공통 프롬프트와 성공·실패 사례를 보여 줍니다. |
| D | Further experiments | D.1 턴 수, D.2 Gemma 상세 결과, D.3 추가 절제, D.4 행동 차이의 시점별 분포를 제시합니다. |
핵심 기여와 혁신성
문제의 중요성은 증류 대상이 모델 하나로 끝나지 않는다는 데 있습니다. 모델을 작은 학생으로 교체해도 실행 환경과 하네스는 남습니다. 같은 상태 요약을 제공받았다는 사실만으로 큰 모델의 정보 활용 능력이 작은 모델로 이전되지는 않습니다. 논문은 이 간극을 하네스 활용도와 과제 성공률로 함께 관찰합니다.
기존 접근의 한계는 감독 신호가 하네스의 기여를 분리하지 않는다는 것입니다. 학생이 방문한 상태에서 교사를 모방하는 on-policy distillation(OPD)은 학생의 상태 분포를 고려하지만, 교사가 하네스 때문에 선택을 바꾼 행동을 직접 드러내지는 않습니다. 또한 하네스를 본 교사라도 소지하지 않은 물체를 사용하는 등 기록과 모순되는 답을 만들 수 있습니다.
HAD의 독창성은 동일 교사의 두 입력 조건을 행동 수준의 대비로 사용한다는 점입니다. 하네스가 있는 응답과 없는 응답의 상대적 차이를 학생 자신의 추론 뒤에서 학습합니다. 전체 응답 모방, 행동 선호, 선호 라벨의 유효성 검사라는 세 역할을 분리한 설계입니다. 교사 응답 전체를 선호 비교하면 추론 문체 차이만으로 손실을 줄일 수 있다는 문제도 이론과 절제 실험으로 다룹니다. 원문 §3
파급효과에 대한 리뷰어 해석: 외부 도구가 정보를 제공하는 능력과 모델이 그 정보를 의사결정에 반영하는 능력을 구별하면, 경량화의 목표를 더 명확하게 정의할 수 있습니다. 이 논문이 직접 입증한 범위는 세 텍스트 환경과 두 모델 계열이며, 일반 소프트웨어 에이전트로의 확장은 저자가 남긴 후속 과제입니다.
기술적 세부사항
HAD의 데이터 흐름은 학생의 하네스 포함 실행 → 같은 상태에서 교사의 두 조건 응답 → 양성 행동 유효성 검사 → 전체 응답 모방과 필터링된 행동 선호 학습입니다. 여기서 추론(reasoning)은 응답의 Thought 부분을 뜻합니다. 평가 모델의 별도 thinking 기능은 꺼져 있으므로, 학생 추론 문맥을 사용한다는 설명과 thinking 모드를 활성화한다는 설명을 혼동하면 안 됩니다.
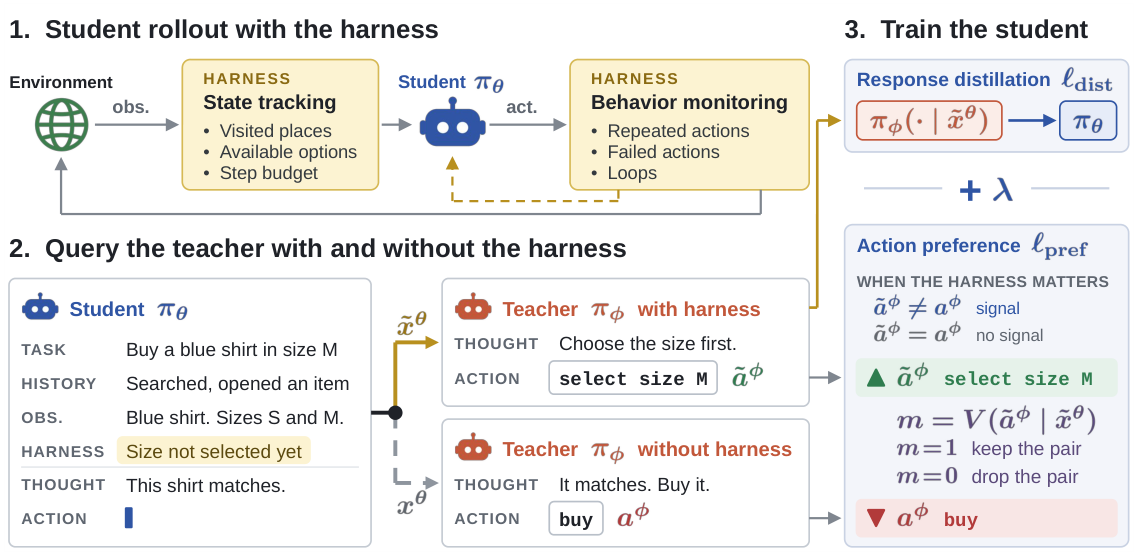
원문 Figure 3, PDF 5쪽. 그림 전체 영역을 크롭했으며 내용과 배치는 변경하지 않았습니다. 학생 실행에서 얻은 같은 상태가 두 교사 질의와 두 손실로 이어집니다. 고정 버전 PDF
핵심 비교를 간단히 쓰기 위해 하네스를 본 교사 행동을 $a^{+}$, 제거한 교사 행동을 $a^{-}$, 학생이 생성한 추론을 $z_s$라고 하겠습니다. 이는 원문 식 (5)의 기호를 짧게 쓴 것입니다.
$\pi_\theta$는 학생 정책, $\tilde{x}$는 하네스 정보가 포함된 실행 이력, $|a|$는 행동 토큰 수입니다. 행동 길이로 나누므로 긴 명령이 단지 토큰 수 때문에 낮은 점수를 받는 효과를 줄입니다. $\sigma$는 sigmoid이며, 양성 행동의 평균 로그확률이 음성 행동보다 커지도록 학습합니다. 두 행동은 같은 학생 추론 뒤에서 점수를 매기지만, 교사는 그 학생 추론을 이어 쓰도록 후보를 생성한 것이 아닙니다. 교사 후보는 각 입력 조건에서 독립적으로 생성됩니다.
이 선호 손실만으로 학습하지는 않습니다. 하네스를 본 교사의 추론과 행동 전체를 모방하는 응답 증류 손실을 함께 둡니다. 유효성 마스크는 양성 행동이 현재 기록과 모순되면 선호 쌍만 제거하며, 그 상태의 응답 증류는 그대로 남깁니다. 학습과 평가 설정은 다음과 같습니다. 원문 §3.1·부록 B
| 항목 | ALFWorld | WebShop | ScienceWorld |
|---|---|---|---|
| 교사 → 학생 | Qwen3-8B → 1.7B | Qwen3-30B-A3B → 0.6B | Qwen3-30B-A3B → 0.6B |
| 평가 | seen 140개·unseen 134개 | 500개 목표 | 30유형·149개 과제 변형 |
| 턴 제한 | 30 | 15 | 15 |
| 지표 | 성공률 | 평균 보상×100·성공률 | 평균 최종 점수·성공률 |
| 업데이트 | 250 | 150 | 150 |
모든 방법은 같은 하네스와 학습 루프를 사용합니다. 학습 온도는 1.0, 평가 온도는 0.4이며 full fine-tuning을 수행합니다. Gemma-4-12B → Gemma-4-E2B 조합으로 ALFWorld의 모델 계열 변경도 검사합니다. 성공률은 제한된 턴 안에 과제를 완료한 비율이고, 하네스 활용도(HU)는 규칙과 행동의 일치도를 보는 진단 지표입니다. 둘은 같은 의미가 아닙니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 모델을 둘러싼 하네스를 고정한 상태에서 교사 모델을 학생 모델로 바꾸는 문제를 정의합니다. 왜 하네스를 보여 주는 것만으로는 충분하지 않은지 설명하는 출발점입니다.
1. 모델과 하네스가 함께 만드는 행동
저자는 언어 모델 에이전트가 환경을 여러 번 관측하고 행동하면서 긴 과제를 해결한다고 설명합니다. 하네스는 환경 상태, 허용 행동, 반복 실패를 정리합니다. 모델을 바꾸지 않고 하네스만 바꾸어도 성능이 달라지는 배경 때문에, 증류 역시 하네스가 있는 시스템을 전제로 검토해야 합니다.
교사와 학생이 동일한 하네스를 사용하면 학생이 모든 상태 추적 기능을 내부 가중치에 복제할 필요는 없습니다. 그러나 하네스가 “접시가 아직 깨끗하지 않다”고 보고했을 때 싱크대로 가야 한다는 판단은 모델의 몫입니다. 정보의 제공과 정보에 따른 행동 선택을 분리하는 것이 문제 설정의 중심입니다.
2. OPD에서 관찰한 세 가지 실패
첫째, 기존 OPD는 하네스가 교사의 행동을 바꾼 순간을 명시적으로 표시하지 않습니다. 둘째, 하네스가 제공하는 기록과 교사가 추가하는 의사결정을 분해하지 않습니다. 셋째, 교사가 하네스 기록과 모순되는 행동을 제시해도 그대로 감독 신호에 포함할 수 있습니다. 원문 Figure 1은 필요한 물체를 들고 있지 않거나 상태 경고를 행동으로 연결하지 못하는 사례로 이 문제를 설명합니다.
Figure 2의 오른쪽 비교에서는 하네스를 사용한 증류로 HU가 65.7%에서 73.1%까지 높아지지만, 보고된 집계 성공률은 43.1%에서 43.5%로 거의 변하지 않습니다. HAD는 HU 81.0%, 집계 성공률 57.4%를 보고합니다. 이 성공률은 Table 2의 seen/unseen 두 성공률 산술평균과 일치하는 집계값이며, 두 split의 크기를 합쳐 가중한 성공률로 읽지 않습니다. HU의 계산 방식은 부록 B.3에서 별도로 정의됩니다.
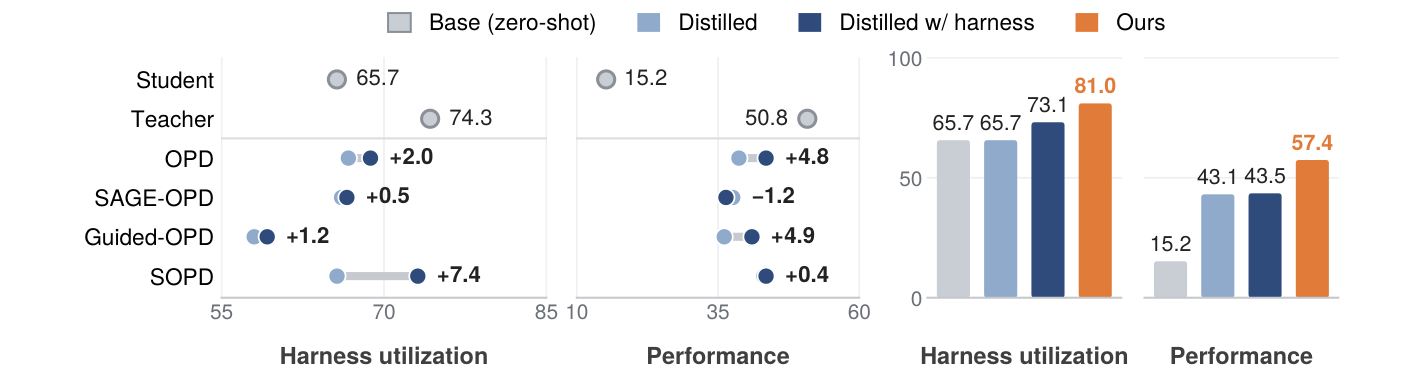
원문 Figure 2 전체, PDF 2쪽. 축·범례·수치를 보존한 크롭입니다. 왼쪽은 방법별 하네스 추가 효과, 오른쪽은 학생·증류·하네스 포함 증류·HAD를 비교합니다. 원문
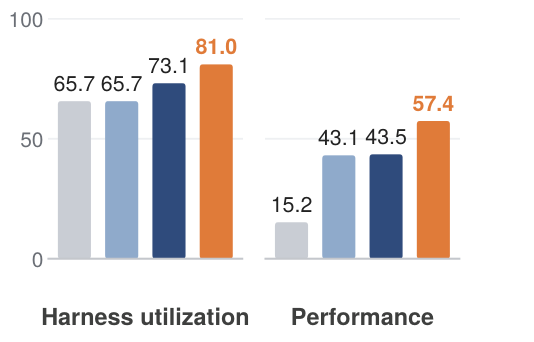
Figure 2 오른쪽 상세 크롭입니다. 전체 그림과 같은 범례를 사용하며, 회색부터 주황색까지 순서대로 기본 학생·증류·하네스 포함 증류·HAD입니다. 원문 PDF 2쪽
3. 제안으로 이어지는 논리
HAD는 하네스가 있는 교사 응답을 계속 모방하되, 같은 교사의 하네스 유무에 따른 행동 차이를 별도 감독 신호로 만듭니다. 선호 행동이 상태 기록과 모순될 때에는 선호 학습에서 제외합니다. 과제 보상, 성공 라벨, 미래 정보를 사용하지 않는다는 점이 소개됩니다. 다만 하네스의 임계값을 사전에 정하는 검증 절차와 HAD의 학습 목적은 구별해야 하며, 이 부분은 부록 B에서 다시 확인합니다.
챕터의 핵심 기여: “하네스가 있는 증류”와 “하네스가 의사결정에 더한 차이를 감독하는 증류”를 구분합니다.
다음 챕터로의 연결: 다음 절은 이 목표가 문맥을 가중치에 내재화하는 기존 연구나 일반 선호 학습과 어떻게 다른지 정리합니다. §1
📖 Chapter 2: Related Work
챕터의 위치와 역할: HAD가 결합하는 연구 흐름을 세 가지로 나누고, 각각에서 가져오는 요소와 다른 목표를 설명합니다.
1. Distilling language model agents
에이전트 증류는 큰 모델의 추론과 도구 사용을 작은 모델로 이전합니다. 학생이 실제로 만드는 이력에서 교사의 감독을 받는 OPD는 교사 궤적만 학습할 때의 분포 차이를 줄이려는 접근입니다. 저자는 단계별 감독, 시간에 따른 교육 과정, 선택적 교사 개입 등 여러 변형을 소개한 뒤, 같은 하네스를 읽는 능력의 이전에 초점을 좁힙니다.
2. Learning with external context and agent harnesses
외부 문맥이나 하네스가 주는 지식을 가중치에 흡수하여 나중에 그 문맥을 줄이려는 연구가 있습니다. 여러 하네스 구성에서 동작하는 소형 에이전트를 학습하는 연구도 언급합니다. HAD의 목표는 배포 시 하네스를 남겨 두고 그 정보를 사용하는 법을 학습하는 것입니다. 하네스 자체를 없애는 방법으로 정의되지 않습니다.
3. Contrastive supervision and preference-based distillation
일반 선호 학습은 후보 두 개의 우열을 학습하며, 기준 정책을 두거나 모방 손실과 함께 기준 정책 없이 학습할 수 있습니다. HAD는 서로 다른 모델의 답이나 정답 판정으로 쌍을 만드는 대신, 학생이 방문한 같은 상태에서 같은 교사에게 하네스를 보여 주었는지를 대비 조건으로 삼습니다. 하네스가 있는 쪽을 양성으로 삼는 것은 품질의 대리 신호이고, 정답 보장이 아니므로 기록 기반 필터를 추가합니다.
챕터의 핵심 기여: 기존 기법을 나열하는 데서 끝나지 않고, 학습 후에도 외부 구성 요소가 유지된다는 전제가 감독 설계를 바꾼다는 위치를 명확하게 합니다.
다음 챕터로의 연결: 방법 절에서는 이 대비가 실제로 어떤 이력과 응답을 비교하는지 수식으로 정의합니다. §2
📖 Chapter 3: Method
챕터의 위치와 역할: 실행 이력, 두 교사 조건, 학생 문맥에서의 행동 점수, 유효성 마스크를 순서대로 정의합니다. 이어서 추가 감독이 갖는 정보와 비교 범위의 의미를 분석합니다.
3.1 Harness-Aware Distillation
1. 하네스가 있는 이력과 제거한 이력
과제 $u$, 관측 $o_t$, 하네스가 추가하는 정보 $h_t$에 대해 원문 식 (1)은 다음 두 이력을 만듭니다.
$\tilde{x}_t$는 하네스가 추가한 정보가 있는 이력이고, $x_t$는 그 정보만 제거한 이력입니다. 이전 응답과 관측은 그대로이므로, 하네스가 없는 상태에서 새로 실행한 독립 궤적이 아닙니다. 하네스가 과거 행동과 관측에 끼친 영향까지 되돌리는 반사실적 재실행도 아닙니다. 동일한 실현 이력을 두 입력 조건으로 읽게 하는 비교입니다.
2. 하네스를 본 교사의 전체 응답 모방
학생은 하네스가 있는 이력에서 추론과 행동을 생성하고, 교사는 학생이 도달한 같은 이력에 답합니다. 교사 응답을 $\tilde{y}_t^\phi$라 하면 원문 식 (3)의 손실은 다음과 같습니다.
$j$는 응답 토큰 위치이며, 앞선 교사 토큰을 조건으로 현재 교사 토큰의 음의 로그우도를 최소화합니다. 응답 길이로 평균하므로 각 단계의 긴 응답이 토큰 수만큼 과도하게 가중되는 것을 피합니다. 이 항에는 교사의 추론과 행동이 모두 포함됩니다.
3. 하네스 유무의 행동 대비
교사는 하네스를 제거한 이력에도 독립적으로 답합니다. 하네스를 본 행동과 제거한 행동을 각각 양성·음성으로 삼고, 앞서 정의한 행동 점수 차이를 학생 자신의 추론 뒤에서 계산합니다. 행동 후보의 생성 문맥과 행동 점수의 조건 문맥이 다르다는 점이 중요합니다. 교사는 두 입력에서 스스로 추론하여 후보를 만들고, 학생은 자신이 실제 생성한 추론 문맥에서 그 행동을 선택할 수 있도록 학습합니다.
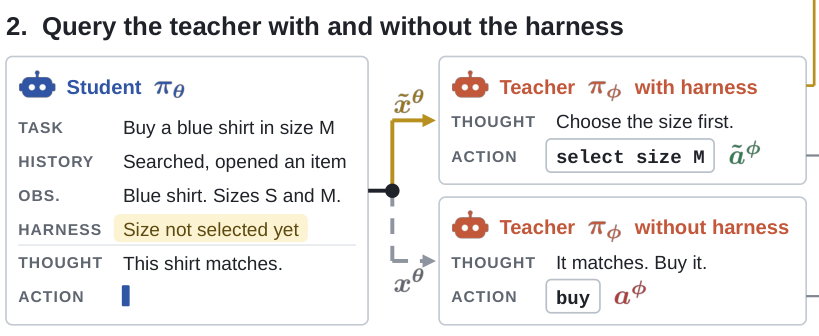
원문 Figure 3의 2단계 상세 크롭, PDF 5쪽. 전체 그림에서 교사의 두 조건 질의 부분을 발췌했습니다. 오른쪽으로 나가는 연결선은 전체 그림에서 손실로 이어집니다. 원문
그림의 예에서는 사용자가 파란색 M 사이즈 셔츠를 원합니다. 하네스는 아직 크기를 선택하지 않았다고 보고합니다. 이를 본 교사는 크기 M을 먼저 선택하고, 보지 않은 교사는 바로 구매합니다. 학생의 추론이 “이 셔츠가 맞는다” 수준이어도 다음 행동에서는 크기 선택을 우선하도록 감독하는 예입니다.
4. 양성 행동 유효성 검사와 최종 목적
검사기 $V$는 현재 기록으로 행동의 모순을 확인하며, 결과를 $m_t$라는 0 또는 1의 마스크로 둡니다. 원문 식 (7)의 목적은 다음과 같습니다.
$\nu$는 수집된 학습 기록의 분포, $\lambda$는 두 항을 조절하는 가중치입니다. 양성 행동이 허용 명령에 없거나, 들고 있지 않은 물체를 사용하거나, 같은 상태에서 효과가 없던 명령을 반복하면 선호 쌍을 제거합니다. 응답 증류 항은 제거하지 않습니다. 음성 행동은 검사하지 않으며, 이 설계에서 무효한 음성 행동의 우도를 낮추는 것은 막을 이유가 없다는 설명입니다.
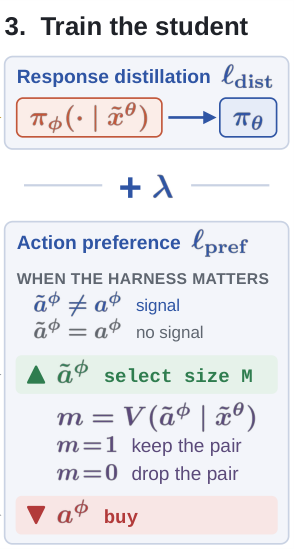
원문 Figure 3의 3단계 상세 크롭, PDF 5쪽. 같은 행동을 출력한 쌍은 선호 기울기가 없고, 양성 행동이 무효하면 선호 쌍을 버립니다. 원문
3.2 What Harness Awareness Adds to Distillation
1. 추가되는 것은 높은 확률 자체보다 상대적 변화입니다
고정된 상태에서 하네스를 본 교사의 행동 주변분포를 $P_+$, 정보를 제거한 교사의 행동 주변분포를 $P_-$라고 합니다. 주변분포란 교사의 여러 가능한 추론을 합쳐 얻은 행동 확률입니다. 유한한 공통 행동 집합, 모든 행동의 양의 확률, 독립 표본이라는 조건 아래에서, 다른 손실 없이 선호 항만 분석한 최적 점수는 다음 형태입니다.
$\kappa$는 모든 행동에 공통으로 더하는 상수입니다. 교사가 원래 자주 내놓는 행동이라는 이유만으로 높은 점수가 되는 것이 아니라, 하네스를 보았을 때 상대적으로 더 자주 나오는 행동에 높은 대비 점수가 붙습니다. 양성 응답만 모방하는 손실은 음성 분포를 보지 못하므로 이 상대적 변화를 일반적으로 식별할 수 없습니다.
이 결과는 행동의 실제 효용이나 정답 확률을 추정한다는 정리가 아닙니다. 교사 입력 조건에 따른 출처 차이를 학습한다는 분석이며, 유한한 신경망으로 최적화하는 결합 HAD가 항상 이 해에 도달한다는 보장도 아닙니다.
2. 필터는 대리 선호의 명백한 오류만 줄입니다
하네스를 보았다는 사실만으로 올바른 행동이 되지는 않습니다. 현재 기록과 모순되는 행동을 제외하면, 양성 분포는 검사기를 통과한 행동에 조건화됩니다. 그러나 문법과 상태에 맞지만 과제를 진전시키지 않는 행동은 남을 수 있습니다. 저자는 이 한계를 명시합니다. 부록 A.5는 필터가 음성 분포를 바꾸지 않고 양성 분포만 조건화한다는 점을 수식으로 정리합니다.
3.3 Why Action-Only Preference under Student Reasoning
1. 전체 응답 비교가 묻는 질문은 다릅니다
하네스 유무에 따라 교사의 추론 길이와 문체가 달라질 수 있습니다. 전체 응답 선호는 행동이 같더라도 추론의 차이를 구별하여 손실을 낮출 수 있습니다. 긴 추론이 짧은 행동의 신호를 희석할 수도 있습니다. 따라서 HAD는 행동 토큰만 비교합니다. 저자는 부록에서 전체 응답 비교가 행동 대비 외에 조건부 추론 대비를 더한다는 사실을 분석합니다. 그렇다고 추론의 차이가 언제나 쓸모없다는 주장은 하지 않습니다.
2. 학생이 실제 결정하는 문맥을 감독합니다
학생은 배포 시 교사 추론 뒤가 아니라 자신의 추론 뒤에서 행동을 선택합니다. 이 때문에 같은 학생 추론 문맥에서 두 교사 행동의 점수를 비교합니다. 교사의 좋은 추론을 배우는 역할은 전체 응답 증류가 계속 담당합니다. 행동 선호가 추론 토큰을 직접 점수화하지 않는다고 해서 공유 신경망 파라미터를 통한 추론 변화까지 없어지는 것은 아닙니다.
챕터의 핵심 기여: 무엇을 비교하는지(행동), 어디에서 비교하는지(학생 추론), 어떤 라벨을 신뢰하는지(현재 기록과의 일치)를 분리합니다.
다음 챕터로의 연결: 실험은 이 설계가 단순히 교사를 더 많이 호출하거나 하네스 문장을 추가하는 효과를 넘어서는지 확인합니다. §3
📖 Chapter 4: Experiment
챕터의 위치와 역할: 같은 하네스 아래에서 증류 방법만 바꾼 결과를 비교합니다. 설정, 주요 성능, 실패 궤적 회복, 모델 계열 변경, 절제 실험 순서로 설계의 각 부분을 검토합니다.
4.1 Experimental setup
1. 모델·데이터와 하네스
ALFWorld는 가정 내 물체 조작을 텍스트 명령으로 수행하는 환경이며, 실제 로봇 제어 실험은 아닙니다. WebShop은 상품을 찾아 조건을 맞추어 구매하는 환경이고, ScienceWorld는 과학 과제를 텍스트 행동으로 수행합니다. 교사·학생의 크기와 평가 개수는 앞의 기술 표와 같으며, 모든 방법의 평가에서 thinking을 끄고 온도 0.4를 사용합니다.
하네스는 과제별 하위 목표나 해결 순서를 알려 주지 않습니다. 환경과 이력에서 현재 위치, 소지품, 방문 기록, 남은 턴, 실패와 정체를 계산합니다. 텍스트를 추가할 뿐 행동을 선택하거나 차단하지 않습니다. 상태 추적은 매 턴 보여 주고, 행동 감시 경고는 해당 조건이 발생할 때만 보여 줍니다. 같은 코드와 템플릿을 세 환경에서 공유하되 환경 상태를 읽는 부분은 환경에 맞춥니다.
2. 지표와 기준선
성공률(SR)은 제한된 턴 안의 완료 비율입니다. WebShop 점수는 평균 최종 보상의 100배이고, ScienceWorld 점수는 평균 최종 과제 점수로 음수가 가능하므로 SR와 구분합니다. 성공한 에피소드에서의 평균 턴 수와 HU도 측정합니다. HU는 사용 가능한 행동을 고르고, 실패로 보고된 행동을 피하는 등 하네스 보고와의 일치도를 평가합니다.
기준선 OPD는 학생 토큰에서 교사에 대한 reverse KL을 최소화합니다. SAGE-OPD는 교사가 판단한 교정 필요도와 신뢰도로 턴 가중치를 조정합니다. Guided-OPD는 초기에 교사가 더 많이 개입하다가 개입을 줄입니다. SOPD는 학생이 방문한 상태마다 교사가 작성한 전체 단계를 모방합니다. 모두 같은 과제 풀·업데이트 횟수·하네스 조건을 사용하지만, 원 논문 구현 그대로인 것은 아니며 수정 사항은 부록 B.4에 명시됩니다.
3. 학습 설정
AdamW, 학습률 0.00001, weight decay 0.01, gradient clipping 1.0, 유효 배치 크기 60을 사용합니다. cosine 스케줄과 15회 warmup을 적용하며, 한 라운드에서 학생이 16개 과제를 실행합니다. 수집한 단계는 두 정책 버전 동안 보관하고 각 단계를 한 번 사용합니다. HAD의 선호 기울기 크기는 응답 증류 기울기의 약 절반이 되도록 조정합니다. 이는 매 미니배치에서 계산하는 경험적 균형 규칙입니다.
4.2 Main experiment
1. 주요 결과의 정량 비교
다음은 하네스를 사용한 평가의 원문 Table 2를 재작성한 것입니다. ScienceWorld의 양수·음수는 PDF에서 확인했습니다.
| 방법 | ALFWorld unseen SR | ALFWorld seen SR | WebShop 점수 | WebShop SR | ScienceWorld 점수 | ScienceWorld SR |
|---|---|---|---|---|---|---|
| 교사 | 51.49 | 50.00 | 49.96 | 18.80 | 20.26 | 20.13 |
| 기본 학생 | 9.70 | 20.71 | 20.95 | 9.80 | −16.47 | 3.36 |
| OPD | 47.01 | 40.00 | 41.59 | 19.00 | −0.82 | 8.05 |
| SAGE-OPD | 31.34 | 41.43 | 42.21 | 17.00 | 0.77 | 6.04 |
| Guided-OPD | 46.27 | 35.71 | 43.89 | 16.60 | −2.52 | 6.04 |
| SOPD | 45.52 | 41.43 | 39.97 | 13.80 | −8.45 | 6.71 |
| HAD | 63.43 | 51.43 | 47.19 | 19.60 | 4.17 | 9.40 |
SR의 단위는 %이며 굵은 값은 학생 중 최상입니다. 점수는 앞서 정의한 환경별 척도입니다. Table 2, PDF 7쪽
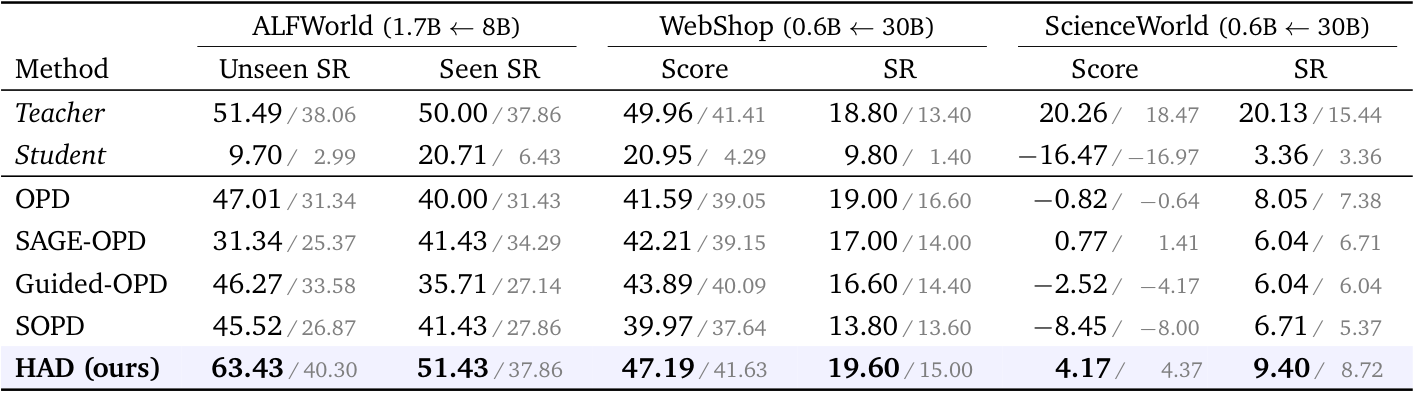
원문 Table 2의 표 전체 영역 크롭, PDF 7쪽. 각 셀은 진한 값이 하네스 사용, 회색 값이 하네스 제거 평가입니다. 위 Markdown 표는 진한 값만 옮겼습니다. 원문
ALFWorld unseen에서는 가장 높은 기준선 OPD보다 16.42%p 높고, seen에서는 가장 높은 기준선 41.43%보다 10.00%p 높습니다. 이 조건에서는 Qwen3-8B 교사의 성공률도 넘어섭니다. WebShop은 학생 기준으로 점수와 SR 모두 가장 높지만, 점수 47.19는 교사 49.96에 미치지 못합니다. ScienceWorld에서도 학생 중 가장 높지만 교사의 점수 20.26·SR 20.13%와는 차이가 큽니다. 따라서 “교사를 넘어섰다”는 표현은 ALFWorld의 해당 결과로 한정해야 합니다.
하네스를 제거하면 HAD의 ALFWorld unseen SR는 63.43%에서 40.30%로 23.13%p 낮아집니다. 하네스와 함께 배포한다는 설계 전제가 결과에서도 드러납니다. 제거 조건에서도 여러 기준선보다 높다는 사실과, 하네스 의존성이 크다는 사실은 함께 성립합니다.
2. 실패 반복을 벗어나는 정성 사례
Figure 4에서는 컵을 데운 뒤 캐비닛에 놓아야 합니다. 이 환경의 가열 명령은 손에 든 물체에 작용합니다. 모든 학생은 컵을 전자레인지 안에 두고 빈손으로 가열을 시도합니다. 기준선은 효과 없는 가열이나 잘못된 꺼내기 명령을 반복합니다.
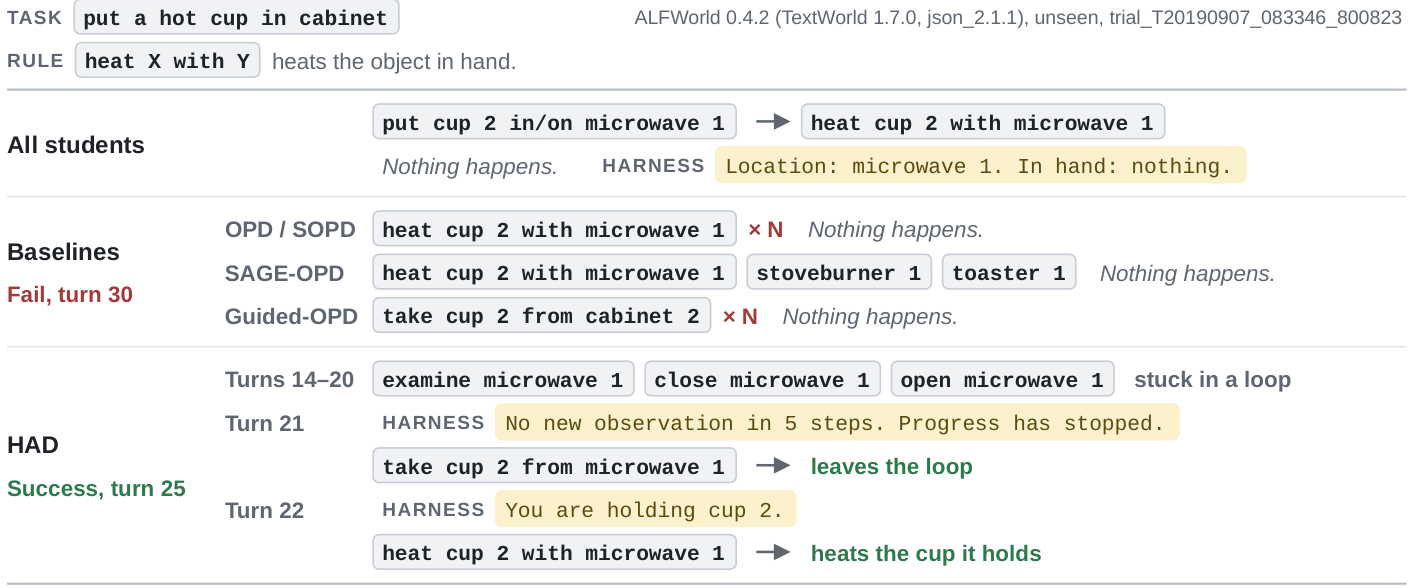
원문 Figure 4 전체 영역 크롭, PDF 7쪽. HAD도 처음에는 정체되지만 21턴의 경고 뒤 컵을 꺼내고, 22턴에 소지 상태를 확인하여 가열한 뒤 25턴에 성공합니다. 원문
HAD 역시 처음부터 오류를 피한 것은 아닙니다. 14–20턴에 반복하다가 새 관측이 5단계 동안 없다는 경고를 받은 뒤 컵을 꺼냅니다. 그다음 하네스가 컵을 들고 있다고 보고하자 가열하고 과제를 완료합니다. 이 사례의 의미는 완벽한 초기 계획보다 실패 상태에서 보고를 읽고 행동을 수정하는 과정에 있습니다.
4.3 Analysis
1. Error trajectory recovery
정체 예방(prevention)은 정체가 없는 에피소드 비율이고, 회복(recovery)은 정체에서 새로운 상태로 빠져나온 비율입니다. 원문 Table 3에서 HAD는 예방 75.9%, 회복 59.7%입니다. 교사는 각각 64.6%·47.0%, 기본 학생은 20.4%·46.8%, SOPD는 62.0%·50.0%입니다. 따라서 예방과 회복을 서로 다른 분모의 지표로 읽어야 합니다. 전체 과제 성공률 59.7%라는 뜻이 아닙니다.
논문은 기준선이 기본 학생보다 회복을 뚜렷하게 개선하지 못한다고 해석하지만, SOPD의 보고값은 50.0%로 기본 학생보다 높습니다. 여기서 “뚜렷하게”를 통계적 유의성 판정으로 바꿀 수는 없습니다. 해당 비교의 검정·신뢰구간은 보고되지 않았습니다.
2. Harness internalization
하네스 내재화는 하네스가 하던 역할 일부를 모델이 가중치로 수행하여 해당 정보가 없어도 행동하는 현상입니다. HAD의 주된 목표는 내재화가 아니지만 저자는 일부 감시 피드백의 내재화 가능성을 분석합니다.
| HAD 평가 조건 | Unseen SR | Seen SR |
|---|---|---|
| 전체 하네스 | 63.43 | 51.43 |
| 행동 감시 정보 숨김 | 55.97 | 45.00 |
| 상태 추적 정보 숨김 | 37.31 | 40.71 |
| 하네스가 거부한 행동을 강제 차단 | 55.22 | 46.43 |
원문 Table 4. 모든 값은 %입니다. §4.3
상태 추적을 숨겼을 때 unseen이 26.12%p 낮아지고, 행동 감시를 숨겼을 때는 7.46%p 낮아집니다. 저자는 이 차이가 감시 피드백 일부는 학습되지만 현재 위치와 소지품 같은 상태 정보는 여전히 읽어야 한다는 해석과 일치한다고 봅니다. 다만 감시 경고는 더 적은 단계에서 발화하므로, 두 범주 제거 실험을 동일 노출량의 인과 비교로 읽어서는 안 됩니다.
무효 행동을 강제로 막는 조건의 성능이 낮아진 결과는 하네스를 단순한 명령 차단기로 바꾸는 것과 정보로 제공하는 것이 같지 않음을 보여 줍니다. 본 실험의 원래 하네스는 행동을 차단하지 않는다는 점을 다시 확인할 수 있습니다.
4.4 Cross-model generalization
Gemma-4-12B 교사를 Gemma-4-E2B 학생으로 증류해도 하네스 사용 조건에서 HAD가 학생 중 가장 높습니다. Unseen 37.31%·seen 36.43%이며, 가장 높은 기준선 SOPD는 32.09%·34.29%입니다. 차이는 각각 5.22%p·2.14%p로, Qwen 조합의 차이와 동일한 크기는 아닙니다.
하네스를 제거한 Gemma unseen에서는 HAD 23.88%보다 SOPD 29.85%가 높습니다. 따라서 이 절의 일반화는 하네스를 유지하는 평가에서 두 모델 계열 모두 개선 방향이 관찰되었다는 뜻입니다. 모든 배포 조건에서 우월하다는 결과는 아닙니다.
4.5 Ablation study
1. 구성 요소 제거
| 변형 | 원문 집계 SR | HU |
|---|---|---|
| HAD | 57.4 | 81.0 |
| 유효성 검사 제거 | 50.8 | 78.9 |
| 음성 행동 제거·양성만 모방 | 52.4 | 74.4 |
| 선호 항 제거·응답 증류만 | 43.5 | 73.1 |
원문 Table 6, 단위 %. 집계 SR는 split별 성공률의 산술평균과 일치하며, HU는 부록 B.3의 구성 요소 평균입니다. §4.5
유효성 검사 제거는 SR를 6.6%p 낮추고, 음성 행동 제거는 5.0%p 낮춥니다. 특히 양성만 모방하면 HU가 74.4%로 응답 증류만의 73.1%에 가까워집니다. 저자는 음성 대비가 하네스 활용도 개선의 큰 부분을 담당하고, 유효성 검사는 과제 성능을 보호하는 역할을 한다고 해석합니다. 양성만 모방하는 변형도 학생 추론 문맥을 유지하므로, 이 실험만으로 학생 추론과 교사 추론 조건의 차이를 따로 식별한 것은 아닙니다.
2. 교사 호출 예산
HAD는 상태마다 교사를 두 번 호출합니다. 동일 업데이트 횟수 비교만으로는 추가 호출량의 효과를 배제할 수 없으므로, OPD와 SOPD에도 두 배의 교사 예산을 제공합니다. 기준선은 학생 궤적과 업데이트도 두 배로 늘어나는 유리한 조건입니다. 그래도 OPD 2배의 unseen/seen은 47.8%·45.7%, SOPD 2배는 50.8%·42.9%로 HAD 63.4%·51.4%보다 낮습니다. 집계값 역시 46.7%·46.8%에 그칩니다. 이 실험은 추가 교사 호출만으로 HAD의 개선 전체를 설명하기 어렵다는 근거입니다.
3. 선호 항 설계
전체 응답을 비교한 변형은 unseen 59.7%·seen 47.1%, 교사를 기준 정책으로 둔 변형은 56.0%·46.4%입니다. HAD 63.4%·51.4%가 모두 높습니다. 선호 기울기 비중을 조절하는 값은 0.25, 0.5, 1.0, 2.0 중 0.5에서 가장 높습니다. 이 결과는 조사한 범위의 절제 결과이지 모든 모델·과제에서 0.5가 최적이라는 규칙은 아닙니다. 원문 HTML의 일부 본문 표 참조는 어긋나지만 실제 비교 표는 Table 15, 가중치 표는 Table 16입니다.
챕터의 핵심 기여: 같은 하네스 조건에서 성능, 회복, 구성 요소, 호출 예산을 분리해 검토합니다. 개선의 범위와 하네스 의존성을 함께 보여 줍니다.
다음 챕터로의 연결: 결론은 이 결과를 고정 외부 구성 요소가 있는 시스템의 증류 원리로 정리하고 적용 범위를 제한합니다. §4
📖 Chapter 5: Conclusion
챕터의 위치와 역할: 응답 모방에 하네스 조건의 행동 대비와 기록 기반 필터를 더하는 방법을 요약합니다.
1. 결론의 논리
공유 하네스가 제공하는 내용을 그대로 복제하기보다, 그 정보를 사용하는 교사의 능력을 가르쳐야 한다는 관점으로 돌아옵니다. HAD는 같은 교사의 입력 조건을 바꾸어 행동 선호를 만들고, 현재 기록에 모순되는 양성 라벨을 제외합니다. 세 장기 텍스트 환경에서 같은 하네스를 쓰는 OPD 기준선보다 높은 학생 성능을 보고합니다.
2. 저자가 명시한 한계와 향후 연구
실험 학생은 최대 약 2B, 교사는 최대 30B이며 텍스트 환경에서 평가되었습니다. 더 큰 모델, 도구 호출 에이전트, 소프트웨어 에이전트로 확장하는 것은 후속 연구입니다. 하네스는 사람이 설계했으므로 자동 학습·최적화한 하네스와 HAD가 어떻게 상호작용하는지도 아직 이 실험으로 확인되지 않았습니다. 저자는 고정 구성 요소가 제공하지 못하는 능력에 증류를 집중한다는 원리가 검색이나 외부 도구를 사용하는 시스템에도 적용될 가능성을 제시합니다.
챕터의 핵심 기여: 직접 평가한 결과와 더 넓은 설계 원리를 분리하면서 연구 범위를 명시합니다.
다음 내용으로의 연결: 본문 뒤 참고문헌에 이어, 부록 A는 추가 감독의 이론적 의미와 가정을 자세히 검토합니다. §5
📖 Chapter A: Additional Supervision from Harness Awareness
챕터의 위치와 역할: “하네스가 있는 교사 행동을 선호하면 무엇을 배우는가”를 확률과 손실의 관점에서 분석합니다. 아래 결과는 주로 분리된 선호 손실의 이상적 최적해에 관한 것이며 실제 결합 학습의 과제 성공 보장이 아닙니다.
A.1 Practical Implementation
1. 선호 마진의 크기와 동일 행동
행동 점수는 토큰 평균이므로 길이에 따라 단순히 커지지 않습니다. 마진 스케일을 정하는 $\beta$가 작으면 보존된 쌍들의 기울기가 비교적 비슷해지고, 크면 아직 마진이 작거나 음수인 쌍에 집중합니다. 전체 선호 기울기 크기는 별도 균형 가중치로 조정하므로, 이 값은 주로 쌍 사이에 기울기를 어떻게 배분하는지에 영향을 줍니다. 두 교사 행동이 같으면 점수 차이는 항상 0이고, 손실은 상수이므로 선호 기울기가 없습니다.
2. 검사 대상과 손실의 경계
검사기는 양성 행동만 확인합니다. 거부된 쌍에서도 교사의 전체 응답 증류는 계속되므로, 잘못된 교사 응답을 학습 전체에서 완전히 정화하는 장치는 아닙니다. 검사기 역시 현재 기록과의 모순만 판단하며, 과제 보상·미래 정보·정답 행동은 사용하지 않습니다.
3. 미니배치 기울기 균형
원문 식 (8)–(9)의 실제 구현에서는 전체 기록 수 $n$으로 응답 손실을 평균하고, 검사기를 통과한 수 $n_V$로 선호 손실을 평균합니다.
통과 표본이 없으면 선호 손실을 0으로 둡니다. 선호 손실 기울기가 0이 아닐 때 가중치는 다음과 같습니다.
$\mathrm{stopgrad}$는 계산된 가중치 자체로 기울기를 전파하지 않는 연산입니다. 선호 기울기가 0이면 가중치도 0으로 둡니다. 이 방식은 두 손실의 기울기 노름을 맞추는 휴리스틱이며, 두 기울기의 방향이나 최종 업데이트의 효용을 보장하지 않습니다. 이론의 고정 가중치 목적과 구현의 유효 표본 평균·배치별 가중치를 구분해야 합니다.
A.2 Ablation Variants
먼저 선호 가중치를 0으로 두면 응답 증류만 남고, 모든 마스크를 1로 두면 필터링이 사라집니다. 양성만 모방하는 변형은 학생 추론·행동 길이 정규화·유효성 마스크를 그대로 유지하면서 음성 대비만 제거합니다. 따라서 학생 문맥을 감독한다는 요소는 남아 있습니다.
전체 응답 비교는 두 교사의 각 추론과 행동을 함께 점수화합니다. 원문 식 (13)은 다음 분해를 제시합니다.
$z$는 해당 교사 응답의 추론이고 $a$는 그 행동입니다. 이 변형은 점수화 범위뿐 아니라 행동을 조건화하는 추론 문맥도 바꿉니다. 따라서 “기존 행동 비교에 추론 감독만 하나 더했다”는 단일 변화로 해석하지 않습니다.
A.3 What Harness-Aware Action Preference Learning Adds
저자는 교사의 양성·음성 전체 응답 분포를 각각 $J_+$와 $J_-$로 쓰고, 추론을 합친 행동 분포를 앞의 두 $P$ 분포로 정의합니다. 응답 모방 위험은 양성 전체 응답 분포에만 의존합니다. 반면 두 독립 행동 표본의 logistic 선호 위험은 두 행동 분포 모두에 의존합니다.
명제 A.1은 공통 유한 행동 집합과 완전 지지(full support: 모든 행동의 확률이 양수), 독립 표본을 가정합니다. 쌍의 방향을 대칭화하면 이진 교차엔트로피가 되고, 최적 점수 차이는 앞에서 설명한 로그 밀도비의 차이로 정해집니다. 초과 위험은 쌍별 Bernoulli 분포 사이의 KL로 표현됩니다. 보정되는 대상은 교사 입력 출처이며 측정한 행동 효용이 아닙니다.
양성 분포를 두 행동에 대해 각각 1/2로 고정해도, 음성 분포를 (3/4, 1/4)에서 (1/4, 3/4)로 바꾸면 최적 행동 점수 차이는 음의 log 3에서 양의 log 3으로 바뀝니다. 양성 응답 모방 손실은 두 상황을 구별할 수 없으므로, 추가 교사 질의가 없던 정보를 제공한다는 반례입니다. 이것이 응답 모방만으로 하네스 의존 행동을 전혀 배울 수 없다는 뜻은 아닙니다.
A.4 Regularization Bias and Reference-Relative Preferences
하네스 유무의 행동 분포가 모두 (0.9, 0.1)이라 해도, 길이가 같은 행동에 대한 독립된 기준 정책 없는 선호 손실의 최적 확률은 (0.5, 0.5)가 됩니다. 방향이 반대인 두 쌍이 같은 확률로 나타나므로 대비할 차이가 없고, 최적 점수가 같아지기 때문입니다. 이는 교사의 원래 비균등 확률을 평평하게 만드는 편향입니다.
기준 정책의 확률에 대한 상대 로그확률을 비교하면 두 교사 분포가 같을 때 기준 정책을 최적으로 둘 수 있습니다. 그러나 학생 추론 뒤에서 큰 교사의 행동 확률이 적절한 사전분포인지 분명하지 않고, 고정한 학생도 하네스를 잘못 사용할 수 있습니다. 교사를 기준으로 둔 실제 절제 실험은 HAD보다 낮았습니다.
HAD는 응답 모방과 균형을 맞춘 보조 선호 항을 함께 사용합니다. 따라서 선호 단독 최적해가 균등하다는 분석을 결합 HAD가 모든 행동을 균등하게 만든다는 결론으로 확장할 수 없습니다.
A.5 What Harness-Aware Validity Filtering Adds
검사 통과 확률을 $\gamma$라 하면 원문 식 (29)은 필터링 위험을 다음처럼 정리합니다.
$V(a)$는 양성 행동의 통과 여부이며 $\gamma>0$일 때의 식입니다. 하나도 통과하지 못하면 위험은 0입니다. 통과 행동과 거부 행동의 쌍에서는 통과 행동을 선호하는 방향만 남아, 해당 점수 차이를 키우는 쪽으로 손실이 감소합니다. 필터가 없다면 무효 행동이라도 두 교사 분포의 비율이 높아 큰 선호를 받을 수 있습니다. 이 식은 그 실패 경로를 차단하는 의미를 보여 주지만, 유효한 오답까지 식별하지는 않습니다.
A.6 Why Action-Only Preference Rather Than Full-Response Preference
1. 행동 대비와 조건부 추론 대비의 분해
전체 응답 선호의 최적 점수는 다음 두 성분을 포함합니다. 이는 원문 식 (32)에서 공통 상수를 생략하여 쓴 것입니다.
첫 항은 원하는 행동 주변분포의 대비, 둘째는 그 행동에 조건화한 추론 분포의 대비입니다. 같은 추론 문맥에서 두 행동을 비교할 때 두 번째 항이 행동별로 다르면 순위를 뒤집을 수 있습니다. 행동과 무관한 공통 상수라면 비교에서 상쇄됩니다.
2. 추론만 구별하여 손실을 낮출 수 있습니다
두 행동 주변분포가 같아도 추론 분포가 다르면 전체 응답 선호 손실은 감소할 수 있습니다. 이때 낮아진 손실은 행동 선택이 더 좋아졌다는 뜻이 아니라, 어느 입력 조건에서 생성된 추론인지를 잘 구분했다는 뜻일 수 있습니다. 다만 조건부 추론 대비는 추론과 행동의 적합성 정보를 담을 수도 있으므로, 논문은 그것을 항상 불필요한 신호라고 단정하지 않습니다.
3. 음성 추론만 바꾼 반례와 분석 범위
명제 A.2는 양성 전체 응답과 두 행동 주변분포를 고정한 채 음성 추론의 분포만 바꾸는 예를 구성합니다. 두 행동·두 추론의 유한 예에서 행동 선호 단독 최적은 첫 행동에 확률 2/3을 주지만, 전체 응답 선호 최적은 특정 추론에서 첫 행동에 1/4만 줍니다. 음성 추론만 바꾸면 이 확률이 4/5로 뒤집힙니다.
이는 전체 응답 비교의 행동 순위가 음성 추론에도 민감하다는 존재 반례입니다. 응답 증류를 결합한 실제 모델에서도 같은 역전이 반드시 일어난다거나, 행동 단독 방식이 과제 효용에서 항상 낫다는 증명은 아닙니다. 행동 단독 선호도 후보를 생성하는 교사 추론과 양성 응답 모방을 없애지는 않습니다.
A.7 Action-Only Preferences at Student Reasoning Prefixes
1. 학생 추론은 선호 라벨을 받는 또 다른 후보가 아닙니다
수집한 학생 추론 분포를 $\omega$로 고정하면, 선호 위험은 그 분포가 실제 방문한 추론 문맥들의 행동 조건부 위험을 평균합니다. 전체 응답 증류는 교사 추론의 확률과 교사 추론 뒤의 행동을 함께 감독합니다. 반면 보조 선호 항은 학생 문맥에서 행동 확률만 직접 점수화합니다. 공유 파라미터 때문에 추론이 간접적으로 바뀔 가능성까지 배제하는 분석은 아닙니다.
2. 독립 학생 추론을 사용하는 이유
교사 행동 후보 두 개와 학생 추론은 이력이 주어졌을 때 독립적으로 생성됩니다. 그러므로 각 학생 추론 뒤에서도 후보 행동의 법칙은 같은 두 주변분포입니다. 행동 길이가 같고 필터가 없다는 이상적 조건에서 원문 식 (44)의 선호 단독 최적은 다음과 같습니다.
$L$은 공통 행동 길이, $z$는 감독을 받는 학생 추론 문맥입니다. 이 보조 항 단독의 목표는 문맥마다 같고, 일반적으로 양성 교사 분포 자체와 다릅니다. 따라서 선호 항만으로 유익한 추론별 행동 차이를 보존하지는 못합니다. 응답 모방과 공유 파라미터가 들어간 결합 HAD까지 문맥에 무관한 해라는 뜻은 아닙니다.
양성 교사의 추론을 그대로 공통 문맥으로 재사용하면 양성 행동의 조건부 분포도 그 추론에 종속됩니다. 이 경우 목표는 원래의 주변분포 대비에 양성 추론과 행동의 적합성을 더한 형태로 바뀝니다. 학생 추론 선택은 단순한 표기상의 교체가 아닙니다.
3. 어떤 추론 문맥을 얼마나 감독하는가
다른 추론 분포 $\tau$에서 학습한 오차를 실제 학생 분포로 옮기려면, 해당 문맥들이 충분히 덮여 있어야 합니다. 원문 명제 A.3의 범위는 다음과 같습니다.
$\mathcal E$는 최적 선호 위험에 비해 남은 초과 위험입니다. 실제 학생이 방문하는 문맥에 학습 분포의 확률이 0이면 비율은 무한대가 되어 유한한 일반 보장을 둘 수 없습니다. 모든 문맥이 덮여 있어도 드물게 등장한 문맥의 잔여 오차는 큰 전이 계수를 만들 수 있습니다. 학생 문맥을 직접 수집하면 이 분포 전이 단계를 피하지만, 오차가 작아지거나 과제 보상이 높아진다는 보장은 아닙니다.
4. 교사 강제 학습의 미관측 문맥과 양성만 모방하는 대조군
두 교사 추론 분포 모두 방문하지 않는 학생 추론이 있다면, 그 문맥의 행동 조건부 확률은 교사 전체 응답 손실에서 직접 점수화되지 않습니다. 학생 문맥 기반 행동 선호는 그 위치에서도 감독 신호를 만들 수 있습니다. 이는 신경망의 파라미터 공유를 통한 일반화가 없다는 주장이 아니라, 손실이 직접 평가하는 위치의 차이입니다.
양성 행동만 모방하는 대조군도 이 학생 문맥 감독을 유지합니다. 그 단독 최적 확률은 검사 통과 여부와 양성 확률을 행동 길이로 나눈 가중치에 비례합니다. 음성 분포를 사용하지 않으므로, 대비 정보의 효과를 검사하는 대조군으로 이해해야 합니다.
A.8 From Scores to Probabilities
최적 점수와 최적 시퀀스 확률은 동일한 대상이 아닙니다. 원문 식 (49)은 양의 길이 $\ell(\xi)$를 가진 유한 집합에서 다음 관계를 제시합니다.
$\xi$는 행동 또는 전체 응답, $g$는 그 경우의 최적 점수, $\kappa$는 정규화 조건으로 유일하게 정해지는 상수입니다. 길이가 같으면 점수 순위와 확률 순위가 보존되지만, 길이가 다르면 달라질 수 있습니다. 또한 특정 유한 집합 안에서의 정규화를 가정한 분석이므로 그 밖의 확률 질량까지 결정하지 않습니다. 비교 대상으로 제시한 가중 모방은 각 항의 가중치를 전체 합으로 정규화한 분포가 최적입니다.
챕터의 핵심 기여: 하네스 대비, 필터링, 비교 범위, 문맥 커버리지의 역할을 각각 분리하고, 이상적 선호 최적해와 실제 결합 학습을 구별할 조건을 제시합니다.
다음 챕터로의 연결: 부록 B는 추상적인 이력·검사기·지표가 실험 환경에서 어떻게 구현되었는지 설명합니다. 부록 A
📖 Chapter B: Experiment settings
챕터의 위치와 역할: 모델·환경, 실제 보고 문장, 발화 임계값, HU 계산, 기준선 구현을 명세합니다. 성능 비교의 조건을 재현하려면 본문 수치와 함께 읽어야 하는 부분입니다.
B.1 Models and tasks
모든 모델은 공개 체크포인트이며 thinking을 끄고 사용합니다. 응답 형식은 Thought와 Action 두 줄입니다. 파싱 가능한 행동이 없는 응답도 턴을 소모하므로 형식 준수는 상호작용 예산과 연결됩니다.
ALFWorld는 학습 풀 3,553개, seen 140개·unseen 134개 평가 과제를 사용합니다. 전체 대화 이력을 보존하고, 최대 응답 길이 2,048토큰·문맥 길이 24,576토큰을 둡니다. 하네스 문장은 마지막 턴의 관측과 허용 명령 목록 사이에 들어갑니다. 과제 설명은 원 배포판의 첫 인간 주석을 사용하며, 274개 평가 중 10개에서는 템플릿 목표와 문장이 다릅니다. 모든 방법이 같은 설명을 받고, 정성 사례에는 이 10개를 쓰지 않았다고 명시합니다.
WebShop은 상품 1,000개 버전, 학습 목표 11,587개, 평가 목표 500개를 사용합니다. 최근 두 단계의 이력만 유지하며 응답 최대 512토큰·문맥 길이 24,576토큰입니다. 보상이 정확히 1.0인 에피소드를 성공으로 셉니다.
ScienceWorld는 1.2.3 버전과 teleport simplification을 사용합니다. 학습 풀 3,592개, 30개 과제 유형의 평가 변형 149개이며, 전체 이력을 유지하고 응답 최대 128토큰·문맥 16,384토큰을 둡니다. 최종 점수 100 이상이 성공입니다. 따라서 세 환경의 점수와 동일한 이름의 SR를 직접 하나의 난이도 척도로 비교할 수는 없습니다.
B.2 Harness
1. 설계와 기본 정보의 보존
하네스는 관측과 자기 이력으로 알 수 있는 정보만 보고하며 과제별 해법을 주지 않습니다. ALFWorld·WebShop의 허용 명령처럼 원래 환경이 보여 주던 정보는 하네스를 제거한 조건에도 남깁니다. 즉 “하네스 없음”은 모든 외부 상태 정보나 명령 목록이 사라지는 조건이 아닙니다.
2. 보고 문장
상황 문장은 현재 위치·소지품·방문 장소와 미방문 장소를 보고합니다. 방문 문장은 현재 방문의 시작 턴과 수행 명령 수, 재방문이면 이전 방문 요약을 보여 줍니다. 예산 문장은 현재 턴과 최대 턴을 보여 주고 부족할 때 완료를 촉구합니다. 실패 문장은 같은 상태에서 효과가 없었던 행동과 반복 횟수를 알립니다. 정체 문장은 일정 기간 새로운 상태가 없음을 알립니다.
각 문장은 세 가지 바꿔쓰기 중 하나를 에피소드·단계에 의존하는 시드로 선택합니다. 따라서 단일 고정 문장만 사용한 것이 아니지만, 동일 상태와 이력에 대한 계산 규칙은 공유됩니다.
3. 임계값과 보상 사용의 정확한 범위
| 환경 | 정체 창 | 예산 경고 임계값 | 실패 최소 반복 |
|---|---|---|---|
| ALFWorld | 5 | 11 | 2 |
| WebShop | 4 | 5 | 1 |
| ScienceWorld | 8 | 11 | 2 |
원문 Table 10. 예산 경고는 남은 턴이 임계값보다 적을 때 나타납니다. 부록 B.2
임계값은 증류 전에 학습 과제에서 분리한 검증 집합으로 정합니다. 기본 모델의 성공 검증 에피소드에서 각 경고가 전체 단계의 최대 5% 정도만 발화하도록 정체 창·예산 임계값·실패 반복 조건을 조절합니다. 평가 과제는 사용하지 않습니다. WebShop은 거부 행동을 별도로 알리지 않기 때문에 효과가 없는 첫 시도부터 실패 보고를 만들도록 합니다.
따라서 “HAD 학습 목적이 보상·성공 라벨을 사용하지 않는다”는 설명은 정확하지만, 시스템 전체의 사전 설계에도 성공 여부가 전혀 쓰이지 않았다는 의미는 아닙니다. 하네스 임계값 보정에서 성공 검증 에피소드를 사용하는 절차와 증류 손실을 구분해야 합니다.
4. Example pages
Figure 5는 세 환경에서 교사가 실제 보는 페이지를 축약해 보여 줍니다. ALFWorld에서는 리모컨 하나를 이미 들고 있어 두 번째를 집는 행동이 효과 없었다고 보고합니다. WebShop에서는 상품 옵션 중 flavor가 아직 선택되지 않았고, 같은 페이지를 재방문했으며 4단계 동안 진전이 없음을 보여 줍니다. ScienceWorld에서는 현재 들고 있는 것은 orange인데 다른 물체를 옮기는 명령이 거부되었다는 상황을 표시합니다. 이 예들은 해답을 직접 제공하기보다 관측과 실패 기록을 읽기 쉬운 형태로 정리하는 하네스의 역할을 설명합니다.
B.3 Harness utilization
HU는 모든 과제에서 성립하는 규칙을 만들 수 있는 다섯 구성 요소만 사용합니다. 방문 횟수나 미방문 장소의 적절한 대응은 과제에 따라 달라지므로 제외하고, 현재 턴을 말하는 예산 카운터 자체도 제외합니다. 정의는 원문 식 (50)과 같습니다.
$\mathcal C$는 다섯 구성 요소, $S_c$는 그 보고가 적용되고 규칙을 평가할 수 있는 단계 집합, $r_c(s)$는 행동이 규칙과 일치하면 1인 값입니다. 구성 요소별 비율을 먼저 구하고 동일 가중치로 평균하므로, 매 턴 적용되는 규칙이 드물게 발생하는 경고를 압도하지 않습니다. Seen/unseen ALFWorld는 합쳐 계산합니다.
| 구성 요소 | 일치 판정의 요지 | HAD | 기본 학생 |
|---|---|---|---|
| 사용 가능 행동 | 현재 허용 명령에 포함 | 93.3 | 73.7 |
| 상황 | 소지하지 않은 물체를 쓰지 않는 등 상태 조건 준수 | 99.0 | 96.2 |
| 예산 | 경고 후 look·inventory·examine·help를 피함 |
87.7 | 79.1 |
| 실패 | 실패했다고 보고된 행동을 반복하지 않음 | 91.1 | 61.2 |
| 정체 | 다음 5단계 안에 새로운 상태로 가거나 성공 | 33.8 | 18.1 |
| HU | 위 다섯 비율의 동일 가중 평균 | 81.0 | 65.7 |
원문 Table 11, 단위 %. 부록 B.3
HAD는 예산 항목에서 모든 방법보다 높지 않으며, 정체 항목은 33.8%입니다. 높은 종합 HU를 “모든 경고를 정확히 따름”으로 해석할 수는 없습니다. 문법 밖 행동은 사용 가능 행동의 불일치로만 세고 다른 구성 요소에서는 제외하여 같은 오류를 중복 계산하지 않습니다. 상태의 새로움은 위치·소지품·허용 명령을 묶은 키로 판정합니다.
본문 Table 3의 회복률과 여기의 정체 항목도 동일하지 않습니다. 후자는 보고가 나타난 단계에서 다음 5단계 이내라는 제한과 성공 조건을 적용하는 구성 요소별 진단입니다. 보고값 59.7%와 33.8%가 다르다고 단순 오류로 볼 수 없습니다.
B.4 Implementation details
1. 공통 on-policy 루프와 기준선 조정
모든 방법이 동기식 루프를 공유하며 학생이 매번 16개 과제를 온도 1.0으로 실행합니다. 토큰 KL을 쓰는 방법에서는 교사의 top-64 토큰만 사용하고 두 분포를 해당 토큰들 위에서 다시 정규화합니다. 원 논문의 학습률 0.000001은 이 설정에서 학생이 학습되지 않아 모든 방법에 0.00001을 사용했다고 명시합니다.
Guided-OPD는 처음 80% 업데이트 동안 교사 개입 확률을 cosine으로 1에서 0으로 낮춥니다. 교사 턴의 학습은 원 방법의 forward KL 대신 교사가 디코딩한 토큰에 대한 교차엔트로피로 구현합니다. SOPD는 단계 안 토큰 평균을 구한 뒤 단계 평균을 냅니다. 그러므로 이 논문은 공통 실험 틀에서 구현·조정한 기준선과 비교한 결과이며, 인용 논문의 모든 설정을 그대로 실행한 벤치마크는 아닙니다.
2. 교사 샘플링과 유효성 검사
하네스가 있는 교사와 제거한 교사는 모두 온도 1.0으로 독립 표본을 생성합니다. 따라서 두 행동이 달라진 비율에는 하네스 조건의 영향뿐 아니라 샘플링 차이도 포함됩니다. 이 점은 부록 D.4의 행동 차이 비율을 순수한 하네스 인과 효과로 해석하지 못하게 하는 중요한 조건입니다.
세 환경의 검사기는 허용 명령 밖 행동, 소지하지 않은 물체 사용, 같은 상태에서 효과가 없던 명령 반복을 거부합니다. 검사가 학습용 양성 행동에 적용된다는 사실과 실행 시 하네스가 행동을 막지 않는다는 사실을 구분해야 합니다.
챕터의 핵심 기여: 하네스 정보의 정확한 범위, HU의 분모, 기준선 수정, 사전 보정과 학습 라벨의 차이를 명세합니다.
다음 챕터로의 연결: 부록 C는 이 설정에서 성공과 실패가 실제 대화에 어떻게 나타나는지 보여 줍니다. 부록 B
📖 Chapter C: Prompts and Examples
챕터의 위치와 역할: 공통 시스템 프롬프트와 ALFWorld의 성공·실패 사례를 통해 수치가 놓치는 행동 맥락을 제공합니다.
1. 공통 프롬프트와 사례 표기
Figure 6의 지시는 다음 행동에 대한 간단한 추론과 허용 명령 하나를 정확히 두 줄로 출력하도록 합니다. 물체·수용체의 이름과 숫자 식별자를 그대로 복사하고, 한 번에 행동 하나만 실행하도록 제한합니다. Nothing happens.는 직전 행동에 효과가 없었다는 뜻으로 설명합니다. 사례 그림은 최근 세 턴만 남기며 허용 명령은 마지막 턴에만 표시합니다. 생략 표시가 있는 대화를 완전한 실행 로그라고 읽어서는 안 됩니다.
2. 성공 사례: 두 리모컨을 ottoman에 옮기기
Figure 7에서 HAD는 첫 리모컨을 놓은 뒤 두 번째를 찾고 있습니다. 하네스는 14곳 중 13곳을 방문했고 sofa만 미방문이라고 알려 줍니다. HAD는 sofa로 가서 두 번째 리모컨을 찾고 집습니다. 비교 사례의 OPD는 들고 있지 않은 리모컨을 놓으려 하고, SOPD는 이미 찾았던 장소로 돌아갑니다.
여기서 하네스가 “두 번째 리모컨은 sofa에 있다”고 정답 위치를 알려 주는 것은 아닙니다. 남은 미방문 장소를 보고하고, 모델이 탐색 행동을 선택합니다. 또한 기준선은 자신의 실행 궤적 후반의 대응 지점에 제시되어 있으므로, 같은 상태에서 모든 방법의 행동만 교체한 통제 실험으로 해석하지 않습니다.
3. 실패 사례: 가열되지 않은 머그잔의 성급한 완료 판단
Figure 8에서 HAD는 가열되지 않은 머그잔을 커피머신에 놓고 이미 과제를 마쳤다고 판단합니다. 하네스가 5단계의 정체와 남은 3턴을 보고해도 HAD는 반복하던 inventory를 다시 선택하고 제한에 도달합니다. 하네스를 잘 이용하도록 학습했어도 목표 달성 상태를 잘못 이해하면 보고를 읽지 못하는 실패가 남는다는 사례입니다.
같은 그림에서 OPD는 성공하지만, 해당 턴에서 이미 가열된 다른 머그잔을 들고 있는 다른 상태입니다. 따라서 그 행동을 HAD가 보던 동일 페이지의 더 나은 응답이라고 비교할 수는 없습니다. 저자가 직접 명시한 이 차이는 정성 사례를 읽을 때 중요합니다.
챕터의 핵심 기여: 하네스 기록을 탐색에 활용한 성공과, 경고를 받아도 잘못된 완료 판단을 고치지 못한 실패를 함께 보여 줍니다.
다음 챕터로의 연결: 부록 D는 이 사례를 넘어 턴 수·다른 모델·추가 설계 변형·행동 차이의 분포를 제시합니다. 부록 C
📖 Chapter D: Further experiments
챕터의 위치와 역할: 본문의 성능 개선을 효율성과 모델 계열, 선호 항 설계, 감독 신호의 발생 위치라는 관점에서 보완합니다.
D.1 Analysis: turns
원문 Table 13의 턴 수는 성공한 에피소드만 평균한 값입니다. 하네스 사용 조건에서 HAD 14.83턴, OPD 13.16턴, SOPD 15.15턴, 교사 14.10턴입니다. HAD는 더 많은 과제를 해결하면서 성공 에피소드 길이는 다른 방법과 비슷한 범위에 있습니다. 하지만 성공 집합이 서로 달라서 이를 같은 과제의 속도 향상이나 전체 계산 비용 감소로 단정할 수는 없습니다.
하네스를 제거하면 HAD는 13.14턴이고 교사는 12.99턴입니다. 여러 모델에서 하네스를 추가했을 때 성공 에피소드의 평균 턴 수가 늘어납니다. 하네스가 항상 더 짧은 실행을 만든다는 결과는 아닙니다.
D.2 Generalization to other model architecture
Gemma 전체 결과에서 HAD의 HU는 77.91%로 교사 75.92%와 기본 학생 71.38%보다 높습니다. 반면 모든 OPD 기준선은 기본 학생의 HU보다 낮습니다. 같은 하네스를 OPD 입력에 넣는 것만으로 작은 Gemma가 이를 더 잘 사용하게 되지 않았다는 관찰입니다.
HAD는 하네스를 사용한 성공 에피소드에서 15.42턴으로 기준선보다 더 오래 행동하면서 가장 높은 SR를 얻습니다. 하네스를 제거한 unseen SR는 HAD 23.88%, SOPD 29.85%로 순위가 달라집니다. 이 결과는 하네스를 계속 사용한다는 배포 전제가 모델 계열을 바꾼 뒤에도 중요하다는 점을 보여 줍니다.
D.3 Additional ablations
원문 Table 15는 전체 응답 비교와 교사 기준 정책을, Table 16은 선호 가중치를 비교합니다. 실제 두 표를 구분하면 다음과 같습니다.
| 선호 설계 | Unseen SR | Seen SR |
|---|---|---|
| 전체 응답 대비 | 59.7 | 47.1 |
| 교사를 기준 정책으로 사용 | 56.0 | 46.4 |
| HAD | 63.4 | 51.4 |
| 선호 기울기 비중 | Unseen SR | Seen SR |
|---|---|---|
| 0.25 | 53.7 | 47.9 |
| 0.5 | 63.4 | 51.4 |
| 1.0 | 49.3 | 50.7 |
| 2.0 | 51.5 | 49.3 |
원문 Table 15·16, 단위 %. PDF 28쪽
전체 응답 대비가 완전히 효과 없는 것은 아닙니다. HAD보다는 낮지만 다른 기준선보다 높은 보고값도 있습니다. 결과는 행동만 비교하는 설계의 상대적 이점을 지지하며, 추론 감독 자체를 없애야 한다는 주장과는 다릅니다. 가중치 변화도 단조롭지 않으므로 선호를 강하게 걸수록 좋아지는 구조가 아님을 확인할 수 있습니다.
D.4 Where the harness changes the teacher’s action
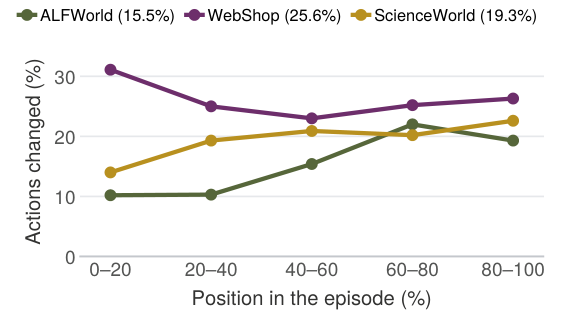
원문 Figure 9 전체 크롭, PDF 28쪽. 가로축은 에피소드 내 상대 위치, 세로축은 행동이 달라진 비율입니다. 축·범례·환경별 전체 비율을 보존했습니다. 원문
학습 중 학생이 방문한 상태에서 두 교사의 행동이 달라진 비율은 ALFWorld 15.5%, WebShop 25.6%, ScienceWorld 19.3%입니다. 그래프는 그 차이가 초반에만 모이지 않고 진행 구간 전반에 존재함을 보여 줍니다. 이는 소수의 초기 결정만 대비하는 방식이 아니라 여러 시점에서 감독이 발생한다는 근거입니다.
그러나 두 응답을 독립적으로 샘플링했으므로, 이 비율 전체를 하네스가 인과적으로 바꾼 행동의 비율로 볼 수 없습니다. 하네스 조건과 표본 변동이 함께 들어 있습니다. 또한 보고된 분모는 HAD 학습 중 방문한 상태이며 평가 과제 전체의 실패 비율이나 유효 선호 쌍의 최종 비율이 아닙니다.
챕터의 핵심 기여: 성능 개선을 턴 감소와 혼동하지 않게 하고, 다른 모델 계열의 하네스 의존성 및 감독 신호의 발생 범위를 보완합니다.
부록의 마무리: 원문은 이 행동 차이 분석으로 끝납니다. 본문과 부록의 모든 절을 위 순서대로 다루었으며, 참고문헌에 나열된 개별 선행 논문까지 모두 독립 검토한 것은 아닙니다. 부록 D
실험 결과 심층 분석
성능 개선의 의미는 같은 하네스를 읽는 능력이 학습 목표에 따라 달라진다는 것입니다. Qwen ALFWorld unseen에서 HAD 63.43%는 OPD 47.01%보다 16.42%p 높습니다. Seen에서는 가장 높은 기준선 41.43%보다 10.00%p 높습니다. 모든 방법에 하네스를 제공했으므로, 이 비교의 초점은 정보 추가 자체가 아니라 그 정보를 활용하도록 증류하는 방식입니다. 두 배 교사 예산의 기준선도 따라오지 못한 결과는 추가 호출량만으로 개선을 설명하기 어렵게 합니다.
환경과 모델에 따라 효과 크기와 교사와의 간격이 다릅니다. WebShop SR는 OPD 19.00%에서 HAD 19.60%로 0.60%p 높아집니다. ScienceWorld는 학생 중 높은 결과지만 HAD SR 9.40%와 교사 20.13% 사이에 10.73%p 차이가 남습니다. Gemma의 개선 역시 Qwen보다 작습니다. “세 환경에서 우수하다”는 방향성과 실무에서 느낄 개선 폭은 구분해야 합니다.
통계적 신뢰도는 보고된 수준으로 제한해 읽어야 합니다. 논문은 이 비교의 신뢰구간, 유의성 검정, 여러 학습 시드의 분산을 제시하지 않습니다. 특히 작은 성공률 차이를 통계적으로 유의하다고 표현할 근거는 없습니다. 평가 개수는 ALFWorld 140/134, WebShop 500, ScienceWorld 149로 확인되지만, 이 개수만으로 보고되지 않은 불확실성 추정치를 만들어 붙이지 않습니다.
하네스 활용도는 원인 분석을 돕는 진단이지 성공의 대체 지표가 아닙니다. HU는 구성 요소별 비율을 동일하게 평균하고, SR는 과제 완료를 셉니다. 유효성 검사 제거 시 HU는 81.0%에서 78.9%로 비교적 작게 낮아지지만 집계 SR는 57.4%에서 50.8%로 더 크게 낮아집니다. 반대로 하네스 경고에 일치하는 명령도 실제 목표 달성을 보장하지 않습니다. 원문의 머그잔 실패 사례와 유효하지만 틀린 양성 행동을 필터가 잡지 못한다는 설명이 이 경계를 보여 줍니다.
재현성에 필요한 명세는 비교적 구체적이지만 원 설정과의 차이를 유지해야 합니다. 모델 체크포인트 계열, 환경 버전과 과제 수, 문맥·응답 길이, 하네스 문장·임계값, 학습률·루프·지표 규칙이 부록에 제시됩니다. 동시에 top-64 토큰 KL, 모든 방법의 학습률 변경, Guided-OPD 교사 턴 손실 변경이 있으므로 기준선 이름만 보고 원 논문과 동일 구현이라고 볼 수는 없습니다. 이 글은 공개된 논문과 PDF·HTML을 분석했으며, 학습을 재실행하거나 코드 재현 성공을 확인한 결과는 아닙니다.
집계 숫자도 구분할 필요가 있습니다. Table 6의 HAD SR 57.4%는 split별 63.43%·51.43%의 산술평균과 일치합니다. 각 split의 성공 개수 85/134와 72/140을 합산하면 약 57.30%가 되므로 서로 다른 집계입니다. HU는 부록 B.3에 따라 seen/unseen을 합쳐 구성 요소별로 계산합니다. 서로 다른 평균의 분모를 하나로 통일해 설명하면 논문의 비교를 바꾸게 됩니다.
기술적 함의와 응용
이 연구의 직접적인 성과는 작은 에이전트의 학습에서 외부 구성 요소가 무엇을 이미 제공하며 모델이 무엇을 더해야 하는지를 분리했다는 데 있습니다. 하네스는 상태와 반복 실패를 요약하지만, 그 보고를 다음 행동으로 연결하는 판단은 모델이 학습해야 합니다. 같은 하네스를 입력에 넣는 것과 그 기여를 대비하여 감독하는 것은 다른 설계입니다.
리뷰어 관점에서 보면 HAD는 학습 목표를 읽는 좋은 사례이기도 합니다. 전체 응답 모방은 교사 추론과 행동을 전달하고, 행동 대비는 학생 문맥에서 입력 조건의 상대적 차이를 강조하며, 유효성 검사는 선호 라벨의 명백한 모순만 제거합니다. 각 항이 무엇을 담당하는지, 무엇을 보장하지 않는지 분명히 해야 이론의 밀도비 결과를 실제 성공 확률로 잘못 읽지 않을 수 있습니다.
실제 적용에서 먼저 확인할 조건은 배포 시에도 같은 하네스 정보와 행동 인터페이스가 유지되는지입니다. 논문 자체에서 하네스 제거, 특히 상태 추적 제거 시 성능이 크게 낮아지고, 자동 설계 하네스나 일반 소프트웨어 에이전트로의 전이는 후속 연구로 남아 있습니다. 저자가 제시한 검색·외부 도구 시스템으로의 확장 가능성은 이러한 범위 안에서 읽어야 합니다.
HAD가 보여 준 핵심은 외부 상태 보고를 모델 안에 모두 넣는 경량화가 아니라, 남겨 둘 하네스를 작은 모델이 더 잘 사용하도록 가르치는 증류입니다. 텍스트 환경에서의 성공과 회복 개선은 이를 지지하지만, 유효한 오답·잘못된 완료 판단·하네스 의존성까지 사라진 것은 아닙니다.