논문 개요와 전체 구조
짧은 생성 영상 여러 개를 이어 붙이면 긴 영상이 되지만, 같은 인물이 끝까지 같은 사람으로 남고 이야기가 자연스럽게 진행되는 것은 별개의 문제입니다. 옷이나 얼굴이 바뀌지 않도록 과거 이미지를 강하게 참조하면 장면이 정체될 수 있고, 움직임을 자유롭게 생성하면 화면 밖에 있던 사물과 배경의 구조가 달라질 수 있습니다. A²RD는 이 긴장을 영상 생성 모델의 재학습 없이, 기억·생성·검증·수정의 반복으로 다루는 연구입니다.
Do Xuan Long, Yale Song, Min-Yen Kan, Tomas Pfister, Long T. Le의 A²RD: Agentic Autoregressive Diffusion for Long Video Consistency는 텍스트와 이미지를 입력받는 영상 생성기 바깥에 멀티모달 에이전트를 배치합니다. 이 리뷰는 arXiv 2605.06924v1의 본문과 부록 A–F, 64쪽 PDF를 기준으로 합니다. 학습 데이터나 모델 가중치를 새로 최적화하는 연구가 아니라, 이미 존재하는 생성기를 어떻게 호출하고 그 결과를 검수할 것인가에 관한 연구입니다.
원문은 다음 순서로 전개됩니다.
- Introduction: 시간적 일관성과 서사적 정합성이라는 두 목표를 설정합니다.
- Related Work: 긴 영상 합성, 추론 시점 연산 확장, 에이전트 메모리를 연결합니다.
- A²RD: Agentic Auto-Regressive Diffusion: 3.1 MVMem, 3.2 생성 파이프라인, 3.3 계층적 자기 개선, 3.4 병렬 변형을 설명합니다.
- Long Video Bench-Challenge (LVbench-C): 사라졌다 다시 나타나는 인물·사물·환경의 상태를 평가합니다.
- Experiments: 5.1 설정, 5.2 자동 평가, 5.3 사람 평가를 제시합니다.
- Analysis: 6.1 구성요소 제거, 6.2 다른 생성기, 6.3 긴 구간의 일관성, 6.4 10분 영상으로 확장합니다.
- Conclusions, 이어 Limitations, Acknowledgements, References가 나옵니다.
- 부록은 A 용어·함수, B 추가 분석, C 평가 구현, D 벤치마크 예시, E 방법론 프롬프트, F 전체 스토리보드 순서입니다.
핵심 기여와 혁신성
첫 번째 기여는 영상의 세계 상태를 명시적으로 기억하는 MVMem입니다. 이전 프레임만 저장하는 대신, 인물의 정체성·상태 변화·공간 관계·움직임·카메라 정보와 프레임, 영상 자체를 함께 저장합니다. 얼굴의 시각적 세부는 이미지에서, 장면 사이에 유지되어야 할 관계는 텍스트에서, 동작의 연속성은 영상에서 가져옵니다.
두 번째는 외삽과 보간의 적응적 선택입니다. 외삽은 시작 프레임에서 앞으로 생성하는 방식이며, 보간은 시작과 끝 프레임 사이를 생성하는 방식입니다. A²RD는 같은 공간에서 이어지는 동작에는 자연스러운 진행을 허용하고, 이미 정해진 다른 공간으로 이동해야 할 때는 목적지 프레임으로 제약합니다. 세 번째는 HITS와 MAPO입니다. HITS는 프레임과 영상의 오류를 각각 검증하고 수정하며, MAPO는 과거 프롬프트 수정의 성공·실패 사례를 검색해 다음 수정을 돕습니다. 근거: §3
새 벤치마크 LVbench-C도 중요한 기여입니다. 단순히 인물이 계속 같은 화면에 있는 상황을 넘어, 여러 장면 동안 보이지 않다가 상태가 바뀌어 돌아오는 상황을 시험합니다. 리뷰어 해석: 이 설계의 가치는 한 클립의 시각적 품질과 전체 이야기의 상태 관리를 분리해 측정한다는 점입니다. 높은 순간 화질이 곧 긴 서사의 일관성을 의미하지 않는다는 문제를 시스템과 평가 양쪽에서 구체화합니다.
기술적 세부사항
전체 시스템은 멀티모달 언어 모델(MLLM), 텍스트·이미지 기반 이미지 생성기(TI2I), 텍스트·이미지 기반 영상 생성기(TI2V)로 구성됩니다. 기본 실험에서는 각각 Gemini 3 Flash, Nano Banana 2, Veo 3.1을 사용합니다. 사용자의 맥락, 순서가 있는 장면 설명, 선택적인 참조 이미지가 입력이며, 출력은 검증을 거친 영상 구간들을 연결한 긴 영상입니다. 논문에서 segment는 반드시 한 장면이나 한 숏과 일치하지 않습니다.
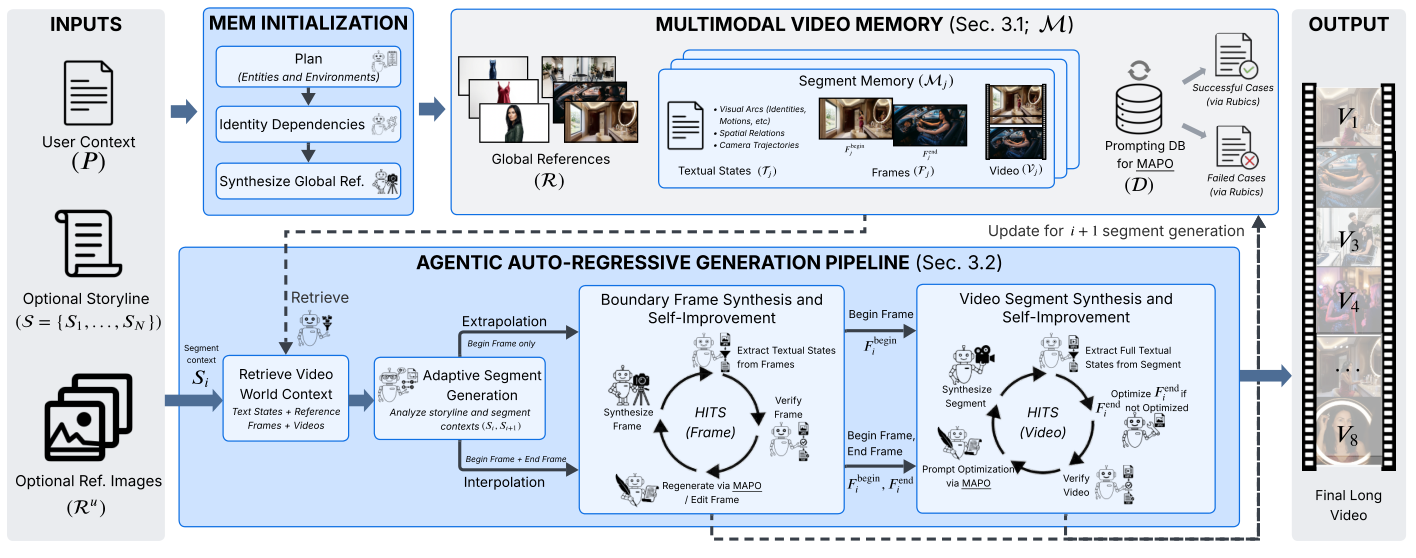
원문 Figure 4, PDF 5쪽. 도식 영역만 크롭했으며 내용과 비율을 변경하지 않았습니다. 버전 고정 원문
읽을 때 구분해야 할 평가 축은 세 가지입니다. 구간 내부 일관성은 한 클립 안에서 인물과 배경이 유지되는지, 구간 사이 일관성은 다른 클립과 이어졌을 때 정체성과 공간이 유지되는지, 서사적 정합성은 실제 사건이 논리적으로 전개되는지를 뜻합니다. 같은 장면을 거의 복제하면 앞의 일부 점수는 높아질 수 있어도 마지막 목표를 달성하지 못합니다. 아래 챕터 리뷰에서는 이 구분을 기준으로 수식과 실험을 연결합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
위치와 역할. 서론은 초 단위 클립 생성의 발전과 분 단위 이야기 생성 사이에 남아 있는 문제를 설명합니다. 핵심 요구를 시간적 일관성과 서사적 정합성으로 나눈 뒤, 기존 생성 방식에서 오류가 어떻게 축적되는지 논증합니다.
먼저 프레임 또는 작은 묶음을 자기회귀적으로 생성하는 방식은 직전 내용과의 국소적 연속성을 얻지만, 생성된 프레임을 고정 조건으로 삼습니다. 잘못된 내용이 한 번 생기면 뒤의 생성에도 전달될 수 있습니다. 이어 짧은 영상 구간을 자기회귀 또는 병렬로 만드는 방식은 장면별 연출을 제어하기 쉽지만 구간 경계에서 정체성·환경·동작이 불일치할 수 있다고 설명합니다. 저자는 이미지 메모리만으로는 내러티브 상태를 장기간 추적하기 어렵다고 주장합니다.
대안은 Retrieve → Synthesize → Refine → Update입니다. 과거에서 필요한 맥락을 꺼내고, 생성하고, 검증해 고친 뒤, 채택한 결과를 다시 기억합니다. 여기서 에이전트라는 말은 스스로 목적 없는 행동을 한다는 의미가 아니라, 주어진 이야기와 평가 기준에 따라 생성 모드·참조·수정 방법을 선택한다는 뜻입니다. 서론의 핵심 기여는 오류를 그대로 물려주는 생성 과정에 검증과 수정의 되먹임을 넣는 문제 설정이며, 다음 장은 이 위치를 기존 연구와 비교합니다. §1
📖 Chapter 2: Related Work
위치와 역할. 관련 연구는 긴 영상 합성 → 생성 모델의 test-time scaling → 에이전트 메모리의 순서로 A²RD의 구성요소를 정리합니다.
Long-Form Video Synthesis. 프레임 기반 방식에는 rolling KV cache, 짧은 주의 창, 초기 프레임 참조 등이 있고, 구간 기반 방식에는 병렬 합성과 자기회귀 합성이 있습니다. 저자는 어느 한 범주를 전면 부정하기보다 각각의 제어 문제를 짚습니다. 시작 프레임만 쓰는 외삽은 그 프레임에 보이지 않는 세부를 잃을 수 있고, 미리 정한 양 끝 프레임을 쓰는 보간은 끝 프레임의 계획이 부정확하면 부자연스러운 진행을 유발합니다.
Test-Time Scaling for Generative Models. 여러 후보 중 좋은 것을 고르는 best-of-N, 반복 수정, 프롬프트 최적화는 추론 시점에 더 많은 계산을 투입하는 방법입니다. 이 장은 기존 영상 연구가 주로 단일 구간의 품질을 다룬다는 점을 강조합니다. A²RD의 검수 대상에는 현재 클립뿐 아니라 과거 클립과의 관계가 들어갑니다. 따라서 후보 수를 늘리는 것과 검증 기준을 구조화하는 것은 별도로 비교해야 합니다.
Memory for LLM Agents. 텍스트·은닉 표현·그래프·이미지 메모리의 장점을 검토한 뒤, 이미지의 구체성과 텍스트 상태의 해석 가능성을 함께 쓰는 방향을 선택합니다. 이 장의 기여는 메모리와 test-time scaling을 단순 병렬 기능으로 나열하지 않고, 메모리가 검증과 수정의 근거가 되도록 연결한다는 점입니다. 다음 장에서 그 연결을 실제 자료 구조와 호출 단계로 정의합니다. §2
📖 Chapter 3: A²RD: Agentic Auto-Regressive Diffusion
위치와 역할. 방법 장은 무엇을 기억하는지부터 시작해, 구간을 어떻게 생성하고 고치며, 어떤 부분을 병렬화할 수 있는지로 이어집니다. 이 순서를 따라가야 메모리 검색이 단순 이미지 검색 이상의 역할을 한다는 점을 이해할 수 있습니다.
3.1 MVMem Design and Initialization
메모리 구조는 다음과 같습니다. §3.1의 정의를 표기 그대로 옮기되 줄을 나누었습니다.
$N$은 영상 구간 수, $\mathcal M_j$는 $j$번째 구간의 기억입니다. $T_j$는 텍스트 상태, $\mathcal F_j$는 시작·끝 프레임, $V_j$는 실제 영상입니다. $\mathcal R$은 전체 이야기에서 재사용하는 참조 이미지, $\mathcal D$는 프롬프트 수정 사례 저장소입니다. 즉 이 메모리는 시각 자료의 목록이면서 동시에 상태 기록과 수정 경험의 저장소입니다.
Memory Schema. 텍스트 상태는 세 부분을 담습니다. Visual Arcs는 인물·사물·환경의 정체성과 변화, 움직임을 기록합니다. Spatial Relations는 주체–관계–객체의 공간 관계를 저장합니다. Camera states는 카메라의 이동을 다룹니다. 시작 프레임에서 정체성과 배치를 먼저 추출한 후 전체 영상을 읽어 중간에 드러나는 속성·움직임·카메라 정보를 보충합니다. 한 프레임에서 알 수 없는 시간 정보를 억지로 추정하지 않도록 추출 단계를 나눈 것입니다.
이미지는 텍스트로 충분히 기술하기 어려운 얼굴·의상·배치의 구체적인 참조가 됩니다. 영상 원본은 움직임의 연속성을 확인하고, 나중에 다시 등장하는 장면의 중간 숏을 찾아내는 데 쓰입니다. 과거 모든 정보를 그대로 넣기보다 다음 단계에서 관련 기억을 선택합니다.
MVMem Initialization. 원문 식 (1)은 사용자 맥락과 전체 이야기에서 배경·개체 참조용 프롬프트를 만들고, 사용자가 준 이미지에는 캡션을 붙이는 단계입니다. 다음으로 참조 사이의 의존성을 방향성 비순환 그래프(DAG)로 구성합니다. 예컨대 한 개체의 모습이 배경에 의존한다면 배경 참조를 먼저 생성합니다. 연결된 구성요소 안에서는 위상 정렬 순서로 만들고, 서로 독립적인 구성요소는 병렬로 생성합니다. 이 초기화가 전체 이야기의 공통 시각 기준을 제공합니다. §3.1
3.2 Agentic Auto-Regressive Generation Pipeline
(i) Adaptive Segment Generation. 생성 모드는 현재와 다음 구간의 관계로 결정됩니다. 원문 식 (2)의 논리를 다음과 같이 나타낼 수 있습니다.
$S_i$는 현재 구간 설명입니다. $\mathcal C(S_i)$는 이미 정해진 새로운 환경으로 전환하지 않는다는 조건이고, $\mathrm{Continuous}$는 다음 구간과 시공간적으로 이어진다는 조건을 짧게 표시한 것입니다. 두 판단은 MLLM이 수행하며, 수식의 $B_i$는 두 조건의 논리곱을 줄여 쓴 표기입니다. 마지막 구간에는 다음 구간 연속성 조건을 생략합니다. 여러 환경을 오가는 구간이나 다음에 다른 공간으로 이동하는 경우에는 보간을 선택합니다. 다음 장면을 미리 보는 lookahead가 끝 프레임 선택에 영향을 준다는 점이 중요합니다.
(ii) Retrieve. 식 (3)–(4)는 관련 과거 장면, 시간적으로 이어지는 영상, 전역 참조를 구분해서 검색합니다. 이전 인물의 모습을 참조할 장면과 지금 동작을 이어받을 장면이 같을 필요는 없습니다. 관련 장면 집합을 $\mathcal S_j^{\mathrm{rel}}$이라 할 때, 검색 결과의 조립은 다음과 같습니다.
$\mathcal T_j^{\mathrm{rel}}$는 검색된 상태 문장들이고, $\mathcal F_j^{\mathrm{rel}}$는 과거의 경계 프레임과 관련 전역 이미지 $\mathcal R_j^{\mathrm{rel}}$를 합친 집합입니다. 현재 시작 프레임과 그 상태가 이미 있으면 함께 넣습니다. 검색을 통해 무관한 과거 장면이 현재 조건으로 들어가는 오류를 줄이려는 설계입니다.
(iii) Synthesize and Self-Improve—Boundary Frame(s). 연속 생성에서 현재 시작 프레임은 이전 끝 프레임을 이어받습니다. 첫 시작 프레임만 새로 합성합니다. 식 (5)는 끝 프레임을 세 경우로 나눕니다. 보간이고 과거의 비인접 영상으로 돌아갈 필요가 없으면 다음 장면에 맞는 프레임을 생성합니다. 비인접 과거 영상으로 이어져야 한다면 그 영상의 숏별 끝 프레임을 추출해 적절한 것을 선택합니다. 외삽이면 초기에는 끝 프레임을 지정하지 않습니다.
이 세 번째 경우의 끝 프레임 부재는 데이터 누락이 아니라 생성 방식의 선택입니다. 반대로 비인접 구간으로 돌아갈 때에는 영상 전체의 마지막 프레임만으로 부족할 수 있습니다. 한 클립 안에 자동차·개·기차 숏이 함께 있고 나중에 자동차로 돌아간다면, 기차가 나온 클립 끝 대신 자동차 숏의 끝을 찾아야 합니다. 부록 B.2.3은 이 구체적인 예를 제공합니다.
(iv) Synthesize and Self-Improve—Video Segment. 식 (6)의 영상 생성은 다음과 같습니다.
$P_i$는 검색된 상태와 경계 프레임을 반영한 영상 프롬프트입니다. $\mathcal F_i$는 이번 구간의 시작·끝 조건이고, $\mathcal F_i^{\mathrm{rel}}$는 외형을 맞추기 위한 추가 참조입니다. 장면 지시와 과거 상태를 먼저 자연어 프롬프트로 통합한 뒤 생성기에 전달합니다. 생성 후에는 바로 확정하지 않고 아래 HITS 검증을 수행합니다.
(v) Update. 채택된 경계 프레임과 영상, 추출한 상태를 메모리에 기록합니다. 다음 구간의 시작 프레임 상태도 함께 전달합니다. 이렇게 해야 다음 검색이 계획된 장면 설명뿐 아니라 실제 생성된 결과를 반영합니다. §3.2, 식 (2)–(6)
3.3 Hierarchical Boundary Frame and Video Self-Improvement
Boundary Frame Self-Improvement. HITS는 프레임의 텍스트 상태를 추출한 뒤 세 묶음의 기준으로 검증합니다. 첫 묶음은 참조 이미지와의 개체·환경 일관성, 서사 진행, 공간 논리입니다. 둘째는 이전 텍스트 상태와의 일관성, 셋째는 지시 준수와 물리적 타당성입니다. 식 (7)의 합집합 표기는 이 점수들을 하나의 기준 집합으로 모은다는 뜻이며, 각 기준은 1–10점입니다.
검증 결과에 따라 Edit와 Regenerate를 선택합니다. Edit는 한 번에 하나의 문제를 직접 수정합니다. Regenerate는 MAPO로 프롬프트를 다듬고 다시 생성합니다. 최종 선택은 원문 식 (8)처럼 전체 반복 과정의 후보 중 집계 점수가 가장 높은 프레임입니다.
$\mathcal F^{\mathrm{cand}}$는 만들어 본 후보 프레임들의 집합, $\mathcal Q_i^F$는 각 검증 기준의 점수, $\mathrm{Agg}$는 그 점수를 집계하는 연산입니다. $*$는 시작 또는 끝 경계를 가리키는 원문의 표기입니다. 마지막으로 만든 결과를 무조건 채택하지 않고, 이전 반복의 더 좋은 후보도 보존하는 구조입니다.
Video Segment Self-Improvement. 영상은 개체·환경·움직임·카메라의 구간 간 연결, 구간 내부 상태 유지, 지시 준수·물리적 타당성·서사 진행·끝 프레임 적합성을 검증합니다. 식 (9)–(10) 역시 점수화 후 전체 후보 중 최선의 영상을 고릅니다. 본문은 프레임 8개·영상 10개 기준으로 묶어 설명하지만, 부록 프롬프트와 Tables 9–10에서는 개체 상태를 인물과 사물로 나누므로 출력 점수 열이 더 많습니다. 이 리뷰에서는 묶음의 개수와 실제 점수 열의 개수를 동일하다고 가정하지 않습니다.
핵심 차이는 외삽에서의 끝 프레임 공동 최적화입니다. 보간에서는 끝 프레임이 있으므로 영상 프롬프트를 수정합니다. 외삽에서는 생성된 영상 끝을 먼저 추출하고, 그 프레임을 Edit 방식으로 고친 뒤, 고친 끝 프레임에 맞춰 프롬프트와 영상을 다시 생성합니다. 장면의 자연스러운 배치를 보존하기 위해 이 끝 프레임 수정에는 재생성이 아니라 편집만 사용합니다. 단순히 “목도리를 유지하라”라는 문장을 강화하는 대신, 실제 사라진 목도리가 복구된 끝 상태를 새 조건으로 제공하는 것입니다.
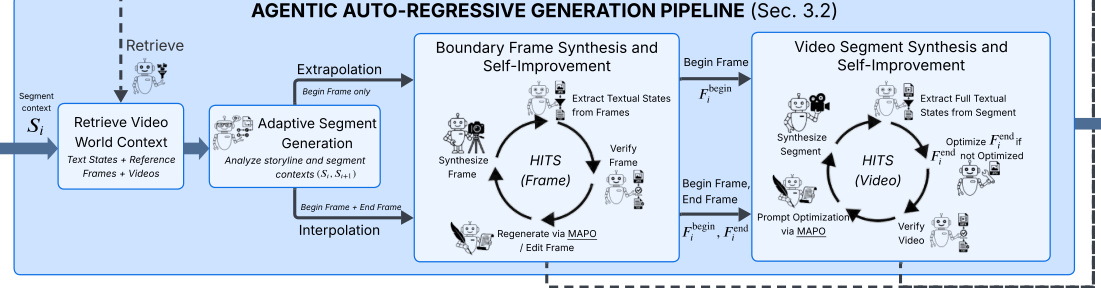
Figure 4의 생성 파이프라인 상세, PDF 5쪽. 전체 도식 중 관련 영역만 추가 크롭했으며 원래 배치와 화살표를 유지했습니다. 원문
Memory-Augmented Prompt Optimization (MAPO). 사례 저장소는 다음 형식입니다.
$P$와 $P^{*}$는 수정 전후 프롬프트, $\mathcal Q$는 검증 점수, $\ell$은 수정 결과의 라벨입니다. 모든 기준 점수가 개선되면 양성, 모두 악화되면 음성 사례로 기록한다고 원문은 설명합니다. 현재 프롬프트와 평가 정보의 임베딩으로 관련 성공·실패 사례를 검색하고, 둘을 비교해 수정 지침을 도출합니다. 모델 가중치가 업데이트되는 것이 아니라 추론 과정에서 쌓인 수정 경험이 다음 프롬프트에 재사용됩니다. 일부 지표만 개선된 혼합 사례의 라벨 처리 규칙은 이 정의만으로 확정하지 않습니다. §3.3, 식 (7)–(10)
3.4 A²RD-Parallel (A²RD-Par)
병렬 변형은 경계 프레임들을 먼저 자기회귀적으로 생성하고 프레임 검증까지 마친 뒤, 모든 영상 구간을 병렬 생성합니다. 영상 단계의 자기 개선은 수행하지 않습니다. 따라서 전체 방법의 모든 계산이 병렬화되는 것은 아닙니다.
원문은 영상 합성에 해당하는 지연이 이상적인 병렬 하드웨어에서 $Nk_vL_V$에서 $L_V$로 줄어든다고 설명합니다. $N$은 구간 수, $k_v$는 영상 생성 반복 수, $L_V$는 영상 생성 호출 지연입니다. 이 주장은 메모리 초기화와 순차 프레임 생성까지 포함한 전체 실행 시간이 한 번의 영상 호출과 같다는 뜻은 아닙니다. 이 장의 기여는 일관성 검증이 가능한 생성 파이프라인과 속도·품질 선택지를 함께 정의한 것이며, 다음 장은 이 구조를 어렵게 만드는 평가 과제를 설계합니다. §3.4
📖 Chapter 4: Long Video Bench-Challenge (LVbench-C)
위치와 역할. LVbench-C는 방금 정의한 메모리가 정말 필요한 상황을 만듭니다. 평가 대상은 인물·사물·환경이 등장했다가 긴 구간 동안 보이지 않은 뒤 다시 나타나는 경우이며, 재등장 시 상태가 자연스럽게 달라질 수도 있습니다. 같은 모습의 반복만 요구하면 “옷을 갈아입었는데도 이전 옷을 유지하는” 생성이 오히려 높은 일관성으로 평가될 수 있습니다.
먼저 세 유형을 정의합니다. Character State Evolving은 의상·외형·신체 상태, Object State Evolving은 위치·방향·상태, Environment State Evolving은 공간의 변화와 새로운 세부의 드러남을 다룹니다. 이어 Human-In-The-Loop Dataset Construction에서는 사람이 만든 예시와 시나리오 작가 역할 프롬프트로 MLLM을 유도합니다. 사건의 인과성, 자연스러운 행동, 구간 길이, 적어도 10개 구간의 부재, 현실적인 상태 변화를 제약합니다. 사람이 중간 결과를 보고 제약과 예시를 조정합니다.
Data Refinement and Deduplication에서는 시나리오를 요약해 유사 내용을 제거하고, 구체성·논리·자연스러움·현실성·반복·모순의 여섯 기준으로 수정합니다. 생성에 쓰인 모델과 별개의 MLLM이 같은 기준으로 다시 확인하고, 사람도 일부 표본을 검토합니다. 이 순서는 자동 생성 데이터의 논리성과 다양성을 확보하려는 절차입니다.
데이터 규모에는 원문 내부의 불일치가 있습니다. Table 1은 125개 시나리오와 5,200개 프롬프트로 기재하지만 §4 본문은 120개라고 쓰고, 길이별 수로는 50·50·25개를 제시합니다. 10분 유형별 세부 수 10·5·5개도 25와 일치하지 않습니다. 따라서 전체 데이터 규모를 한 숫자로 확정하지 않고, 실제 실험은 §5.1의 3분 20개·5분 20개, §6.4의 10분 10개라는 평가 범위를 기준으로 읽습니다. 이 장의 기여는 규모 자체보다 사라진 대상의 정체성과 변화한 상태를 함께 추적하는 시험 조건이며, 다음 장은 이 조건에서의 실제 결과를 제시합니다. §4·Table 1
📖 Chapter 5: Experiments
위치와 역할. 실험 장은 공통 생성기와 비교 방법을 정한 뒤, 자동 지표와 사람 평가를 순서대로 보고합니다. 서로 다른 평가 결과를 하나의 “정확도”로 합치지 않는 것이 중요합니다.
5.1 Settings
VBench-Long의 40개 프롬프트를 각각 8개 연속 구간으로 확장해 약 1분 영상을 생성합니다. LVbench-C에서는 3분 24장면, 5분 40장면 설정을 각각 20개 사용합니다. 기본 생성 모델은 A²RD와 베이스라인 모두 Gemini 3 Flash·Nano Banana 2·Veo 3.1로 맞춥니다.
비교 대상은 장면 설명만 쓰는 Direct Prompting, 이전 마지막 프레임을 쓰는 Naive-AR, 경계 프레임을 만든 뒤 병렬 보간하는 Naive-Par, 계층적 제작 에이전트 MovieAgent, 대본·스토리보드·캐릭터 참조를 사용하는 ViMax, 개체 메모리를 쓰는 VideoMemory입니다. 모델 교체 효과보다 생성·메모리·검증 방식의 차이를 보려는 구성입니다.
프레임과 영상은 각각 두 번의 수정 반복을 사용하며, 각 반복에서 후보 3개를 배치 생성하고 판단들을 병렬 수행합니다. 평균 검증 점수가 9/10 이상이면 일찍 종료합니다. §5.1은 구간당 최대 영상 6개·이미지 6개라고 기술합니다. 다만 부록 B.5의 지연 유도는 초기 생성 1회와 수정 2회를 합쳐 $k_f=k_v=3$으로 계산합니다. 이 두 설명의 생성 횟수 집계가 완전히 일치한다고 가정해서 비용을 새로 산출하지 않습니다. 이야기·이미지 목록에 대한 MLLM 입력 창은 최대 100으로 제한합니다. §5.1
5.2 Automatic Evaluations
Automatic Metrics. Semantic Alignment는 ViCLIP의 텍스트–영상 유사도입니다. Narrative Coherence는 Gemini 3 Pro가 이야기·개체·환경의 진행과 인과성을 0–1로 평가합니다. 구간 사이 인물·환경 일관성은 같은 상태를 공유해야 하는 장면을 묶어 시각 임베딩을 비교하고, 움직임 일관성은 연속 구간 경계를 평가합니다. 구간 내부 지표는 VBench를 사용합니다. 자동 지표 중에도 임베딩 유사도와 MLLM의 판단이 섞여 있습니다.
Single-Scene Results. 다음은 Table 2의 주요 열을 그대로 옮긴 표입니다. 40개 VBench-Long 프롬프트의 약 1분 영상 조건이며, 숫자는 0–1 범위의 서로 다른 지표입니다.
| 방법 | 서사 정합성 | 구간 간 인물 | 구간 간 환경 | 구간 간 동작 |
|---|---|---|---|---|
| Naive-AR | 0.7466 | 0.5125 | 0.7148 | 0.9903 |
| ViMax | 0.6912 | 0.5552 | 0.7015 | 0.9754 |
| VideoMemory | 0.6717 | 0.5729 | 0.7273 | 0.9777 |
| A²RD-Par | 0.8082 | 0.6817 | 0.8180 | 0.9843 |
| A²RD | 0.8987 | 0.7353 | 0.8368 | 0.9935 |
A²RD의 서사 정합성은 가장 높은 베이스라인인 Naive-AR보다 0.1521 높습니다. 이는 상대적으로 약 20.4% 증가한 값이며, “정확도 20.4%p 증가”가 아닙니다. 인물·환경·동작의 개선은 영상이 같은 내용을 반복해서 점수만 얻는 것이 아니라, 이야기 진행과 시각적 연결을 함께 달성하는지 판단할 근거가 됩니다.
Multi-Scene Results. Table 3의 LVbench-C 결과는 순차·병렬 변형이 모든 축에서 같은 순서를 갖지 않음을 보여 줍니다.
| 조건·방법 | 의미 정합 | 서사 정합성 | 구간 간 인물 | 구간 간 환경 |
|---|---|---|---|---|
| 3분 VideoMemory | 0.2062 | 0.8475 | 0.3687 | 0.3554 |
| 3분 A²RD-Par | 0.2153 | 0.8641 | 0.4082 | 0.4270 |
| 3분 A²RD | 0.2215 | 0.9000 | 0.4262 | 0.4148 |
| 5분 VideoMemory | 0.1545 | 0.8292 | 0.3697 | 0.3830 |
| 5분 A²RD-Par | 0.1976 | 0.8813 | 0.3930 | 0.4567 |
| 5분 A²RD | 0.1806 | 0.9500 | 0.4395 | 0.4119 |
5분 영상에서 순차 A²RD의 서사·인물 점수는 높지만, 의미 정합과 환경 일관성은 A²RD-Par가 더 높습니다. 3분 환경 점수도 병렬 변형이 앞섭니다. 서로 다른 공간을 오가는 이야기에서 미리 정한 경계 프레임이 제공하는 제약과, 영상까지 반복 수정하는 방식의 장점이 다른 지표로 드러난 결과로 읽을 수 있습니다. 이 마지막 설명은 결과에 대한 리뷰어 해석입니다.
Scaling Baselines. Figure 6은 후보 영상·프레임 수를 맞추고 Gemini 3 Pro가 최선을 고르는 best-of-N 비교를 합니다. 원문은 평균 일관성이 Naive-AR 약 0.61→0.67, VideoMemory 약 0.65→0.71로 개선되지만 A²RD는 약 0.73→0.78, 서사 정합성은 약 0.74→0.90으로 개선된다고 보고합니다. 후보 수를 늘리는 효과와 평가·수정 구조의 효과를 구별하려는 실험입니다. 다만 생성 후보 수를 맞춘 것이 모든 MLLM 호출·금액·지연을 완전히 동일하게 맞췄다는 뜻은 아닙니다. §5.2, Tables 2–3, Figure 6
5.3 Human Evaluations
사람 평가는 VBench-Long 40개 샘플을 대상으로 하며 평가자는 7명입니다. 방법을 가린 무작위 순서로 제시하고, 각 샘플은 적어도 2명이 평가합니다. 인물·사물·환경 일관성, 전환의 자연스러움, 서사적 정합성, 참조 일치도를 1–5점 척도로 채점합니다. 따라서 이 결과를 5분·10분 전체 실험에 대한 사람 평가로 확대해서는 안 됩니다.
Table 4의 보고 평균은 A²RD 4.68, A²RD-Par 4.29, VideoMemory 3.93입니다. A²RD의 인물 일관성은 4.89, 환경 4.52, 전환 4.34, 서사 4.75입니다. 전환 점수에서 가장 높은 베이스라인은 Naive-AR의 3.63입니다. 원문 설명 문장의 “최고 베이스라인 3.34”는 표의 Naive-Par 값이므로, 이 리뷰에서는 표를 기준으로 비교합니다. 참조 이미지가 없는 방법은 해당 항목이 N/A라서 각 행의 평균을 같은 분모로 다시 계산하지 않습니다.
사람 결과는 자동 평가와 같은 방향의 근거를 더하지만, 신뢰구간·유의성 검정은 보고되지 않았습니다. 저자는 평가자 간 agreement 점수를 제시하지 않았다는 사실을 Limitations에서 직접 밝힙니다. 이 장의 기여는 정량 지표와 사람의 감상 평가를 연결한 것이며, 다음 장은 어떤 구성요소가 그 성과에 기여했는지 분해합니다. §5.3·Table 4
📖 Chapter 6: Analysis
위치와 역할. 분석 장은 구성요소 제거 → 다른 생성기로의 적용 → 평가 구간 증가 → 10분 생성의 순서로 주장의 범위를 넓혀 갑니다.
6.1 Ablation Studies
Figure 5의 표에서 MVMem을 제거하면 서사 정합성은 0.8987→0.7235, 인물 일관성은 0.7353→0.5061로 낮아집니다. 단, 이 제거는 기억 한 종류만 비우는 변화가 아니라 장기 조건·검증·HITS도 함께 영향을 받는 변화라고 저자가 설명합니다. 따라서 이를 독립적인 텍스트 메모리의 순수 효과로 해석하면 안 됩니다.
텍스트 상태만 제거해도 서사 점수는 0.7794로, 영상을 제거하면 0.8647로 낮아집니다. 영상 기억은 주로 동작 연속성에 쓰이고, 텍스트 상태는 이야기와 정체성의 구체적인 제약을 전달합니다. HITS 제거 시 서사는 0.7395, MAPO를 Self-Refine으로 대체하면 0.7900입니다. 전역 참조 제거 시 환경 일관성은 0.8368→0.7923으로 하락합니다.
항상 보간하면 인물 0.7400·환경 0.8499로 기본 방식보다 약간 높지만, 서사는 0.7094로 낮아집니다. 항상 외삽하면 서사는 0.8278입니다. 일관성을 높이기만 하면 좋은 이야기가 만들어지는 것은 아니라는 핵심 문제가 이 실험에서 명확해집니다. 강한 경계 제약이 시각적 진행을 제한할 수 있다는 저자의 설명과 연결됩니다. §6.1·Figure 5
6.2 Generalization to Other Video Diffusion Models
LTX-Video 0.9.8 13B와 Wan 2.2 5B에서 704×480 해상도, 30 denoising steps, VBench-Long 평가를 사용합니다. Wan 2.2는 보간을 지원하지 않으므로 항상 외삽 모드로 실행합니다. 즉 두 생성기에서 완전히 같은 모드 선택을 썼다고 주장하지 않습니다.
Table 5에서 LTX의 서사 정합성은 Naive-AR 0.5903에서 A²RD 0.7922로, 인물 일관성은 0.5040에서 0.7011로 증가합니다. Wan의 서사는 0.6719→0.8000, 인물은 0.5104→0.6912, 환경은 0.5898→0.7824입니다. 이 결과는 제안 구조가 Veo 한 모델에만 묶이지 않을 가능성을 보여 주지만, 원문이 실제로 시험한 두 공개 생성기의 조건 안에서 이해해야 합니다. §6.2·Table 5
6.3 Consistency Analysis over Extended Horizons
이 절은 단순 이미지 유사도가 자연스러운 상태 변화와 부당한 변화를 완전히 구별하지 못한다는 문제에서 출발합니다. MLLM-Judge는 시각적 차이를 찾고, 이야기로 설명되는 차이인지 분류한 뒤, 명백하면서 설명되지 않는 위반만 표시합니다. 식 (11)은 그 판단의 비율입니다.
$q_{i,d}$는 원문 식의 MLLM 판단을 줄여 쓴 표기입니다. $d$는 인물·사물·환경 중 평가 차원, $|\mathcal S|$는 평가 대상 장면 수입니다. 참조 프레임과 장면 설명을 비교해 일관적이라고 판정하면 지시함수 $\mathbf 1$이 1을 반환합니다. 이 값은 “모든 픽셀이 정확한 확률”도 “사람이 매긴 만족도”도 아닙니다. 정의된 위반 기준을 통과한 장면 비율입니다.
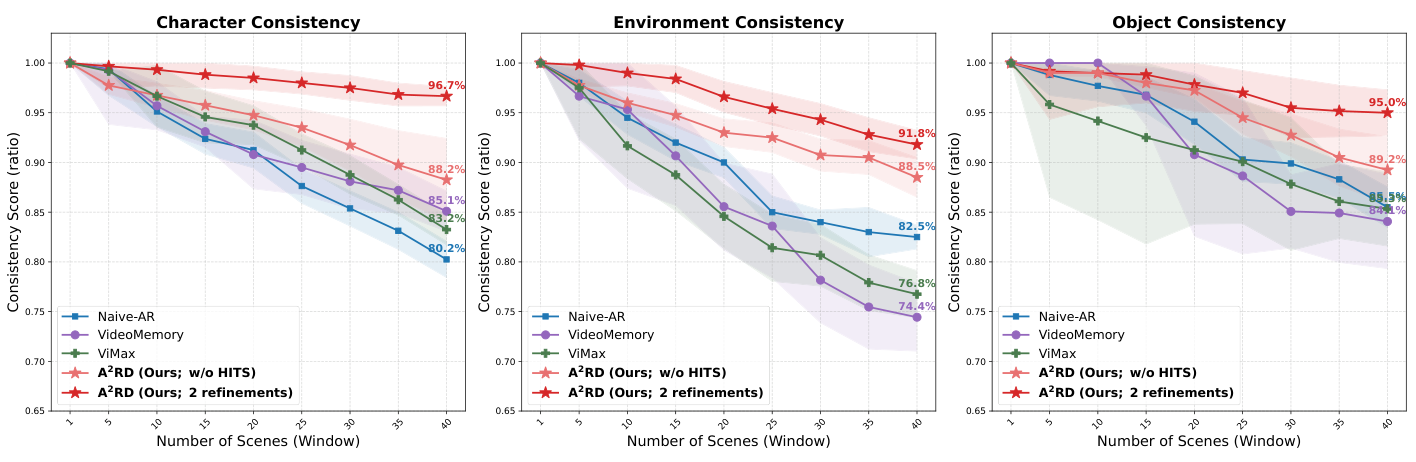
원문 Figure 7, PDF 15쪽. 세 패널·축·범례를 보존한 크롭입니다. 음영을 이 리뷰에서 임의의 신뢰구간으로 해석하지 않습니다. 원문
LVbench-C 5분 조건에서 A²RD는 인물 96.7%, 환경 91.8%, 사물 95.0%를 보고합니다. 저자가 일부 판단을 수동 확인했을 때의 agreement는 80%입니다. 이것은 앞의 7명 사람 평가의 평가자 간 일치도가 아닙니다. 작은 액세서리나 색조 변화는 의도적으로 놓칠 수 있도록 평가 기준을 설계했으므로, 높은 통과율을 미세한 오류까지 사라졌다는 주장으로 바꾸지 않습니다. §6.3·식 (11)
6.4 Scaling to Longer-Horizon Video Generation
10분 시나리오 10개에 같은 MLLM-Judge 평가를 적용했을 때 인물 90.5%, 환경 84.0%, 사물 91.5%를 보고합니다. 긴 영상에서도 일관성을 유지하는 사례를 제시하지만, 5분 결과보다 낮아지는 축이 있다는 사실도 함께 읽어야 합니다. 또한 별도 길이·표본의 결과이므로 동일 영상을 단순 연장했을 때의 인과 효과로 단정하지 않습니다.
이 장의 기여는 메모리·검증·모드 선택의 역할과 적용 범위를 분리해 보여 주는 것입니다. 다음 결론은 그 결과를 종합하고, 이어지는 한계 절은 비용과 판단 모델의 적용 범위를 명시합니다. §6.4
📖 Chapter 7: Conclusions
위치와 역할. 결론은 창의적인 영상 합성과 일관성 관리를 분리한다는 설계 관점으로 돌아옵니다. 멀티모달 메모리, 적응적 생성 방식, 계층적 자기 개선을 통해 1–10분 실험에서 일관성과 이야기 진행을 함께 개선했다는 것이 저자의 요약입니다.
새 학습 손실이나 하나의 거대한 장기 영상 모델을 제시한 것이 아니라, 기존 생성 모델의 출력을 검증 가능한 상태로 바꾸고 되먹이는 시스템을 제시했다는 점이 핵심입니다. 이어지는 Limitations는 이 시스템이 어떤 계산 비용과 평가 가정을 필요로 하는지 설명합니다. §7
📖 Chapter: Limitations · Acknowledgements · References
원문은 추가 계산 부담을 명시합니다. Gemini 3 Flash를 이용한 능동적 추론 비용을 구간당 0.5달러 미만으로 추정하지만, 여기에는 추가 영상 5개와 추가 프레임 5개의 생성 비용이 제외되어 있습니다. 이 수치를 전체 영상 제작 가격으로 읽으면 안 됩니다.
저자가 직접 밝힌 다른 경계는 강한 지시 준수·시각 추론 능력을 가진 구성 모델이 필요하다는 점, 검증 기준이 창작 양식·문화·도메인의 다양한 선호를 모두 대표하지 않을 수 있다는 점, 사람 평가의 agreement를 보고하지 않았다는 점입니다. 전환의 자연스러움과 물리적 환경 일관성은 여전히 어려운 과제로 명시합니다. 여기의 한계와 향후 방향은 원문에 있는 내용을 한정해 정리했습니다.
Acknowledgements는 지원과 감사, References는 인용 연구를 기록합니다. 이 리뷰는 참고문헌의 모든 원문을 별도로 검토한 리뷰가 아닙니다. 이어지는 부록은 본문의 용어를 명확히 하고, 정성 사례와 실제 프롬프트로 구현 의도를 보충합니다. Limitations
📖 Chapter A: Terminologies and Summary of Major Implemented Functions
위치와 역할. 부록 A는 본문에서 혼용하기 쉬운 영상 단위와 함수의 책임을 표로 정리합니다. Table 6의 순서대로 보면 shot은 컷 없이 이어지는 카메라 시퀀스, scene은 한 물리적 환경에서 이어지는 서사 단위, segment는 여러 shot·scene까지 포함할 수 있는 생성 단위입니다. Segment Context는 그 단위의 설명, Storyline은 전체 설명의 순서 있는 집합입니다. 마지막으로 외삽과 보간의 경계 조건을 정의합니다.
Table 7은 계획·캡션·의존성·모드 결정·검색·프롬프트 생성·상태 추출·검증·장기 일관성 평가·MAPO의 역할과 해당 식·프롬프트 위치를 연결합니다. 같은 MLLM 호출이라도 무엇을 입력받고 무엇을 판단하는지가 다릅니다. 이 부록의 기여는 시스템을 재현할 때 각 단계를 독립된 책임으로 이해하게 한다는 점이며, 부록 B는 그 책임이 필요한 실제 사례를 보여 줍니다. 부록 A
📖 Chapter B: Additional Analysis
위치와 역할. 부록 B는 일반 화질, 설계 이유, 실패, 반복 개선, 지연, AI 도구 사용 공개의 순서로 본문을 보충합니다.
B.1 General Video Quality Assessments
Table 8은 VBench의 주체·배경 일관성, 미학·영상 품질, 깜빡임·움직임 지표를 제시합니다. A²RD의 주체 일관성은 0.9231, Imaging Quality는 0.7431이지만, Temporal Flickering 점수는 0.9578로 A²RD-Par 0.9910과 VideoMemory 0.9907보다 낮습니다. 미학 점수도 A²RD 0.6632보다 Naive-Par 0.6692가 높습니다. 따라서 “모든 화질 지표에서 최고”라는 결론은 표가 뒷받침하지 않습니다. 본문의 핵심 성과인 서사·장기 일관성과 일반 화질을 따로 읽어야 합니다.
B.2 Methodology Design Analysis: Why Does A²RD Work?
B.2.1 Adaptive Segment Generation Mechanism. 새로 정해진 골목으로 이동할 때는 목적지를 고정하는 보간을 선택하고, 조각 작업처럼 같은 행동을 이어 갈 때는 외삽을 허용하는 예를 듭니다. 저자는 모드 판단이 사람 전문가와 85%를 넘는 agreement를 보였다고 보고합니다. 이는 생성된 영상 자체의 품질 점수가 아니라 생성 모드 선택 판단의 일치도입니다.
B.2.2 Why Co-Optimization in Extrapolation Mode Is Crucial. Figure 9는 목공 작업 중 파란 목도리가 사라지거나 얼굴이 바뀌는 사례를 보여 줍니다. 영상 프롬프트만 다듬으면 이미 잘못된 끝 상태에 계속 끌릴 수 있습니다. 끝 프레임을 먼저 고치고 새로 생성하면 그 오류를 수정할 구체적인 조건이 생깁니다.
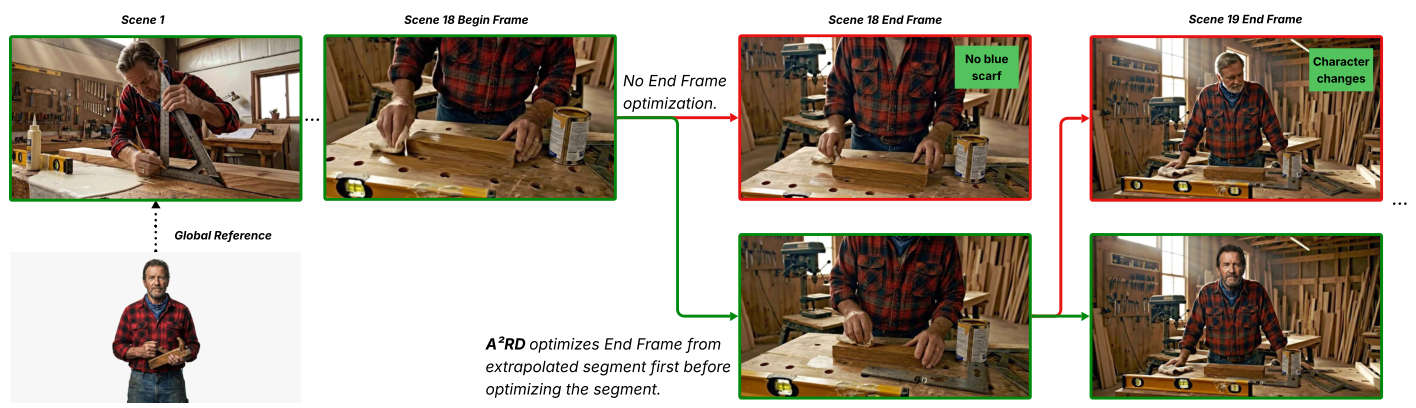
원문 Figure 9, PDF 24쪽. 비교 패널과 연결 화살표를 보존했습니다. 개별 사례의 정성 비교이며 전체 성공률을 뜻하지 않습니다. 원문
B.2.3 How A²RD Maintains Long-Distance Motion Continuity. Figure 10의 자동차→개→기차 영상에서 자동차로 다시 돌아가는 경우, 저장한 영상의 숏 경계를 다시 추출해 자동차의 마지막 상태를 고릅니다. 시작·끝 프레임만 저장한 요약으로는 중간 숏을 복구할 수 없기 때문에 영상 기억이 의미를 갖습니다.
B.2.4 The Role of MVMem’s Textual States. Figure 11의 마라톤 주자는 한동안 가려졌던 참가 번호 402가 다시 보일 때 그 번호를 유지해야 합니다. 텍스트 상태 없이 긴 프롬프트를 쓰더라도 참가 번호와 배경의 표지·무지개 같은 구체적 요소가 빠질 수 있습니다. 관련 상태를 명시적으로 꺼내 프롬프트에 넣는 것이 단순히 프롬프트 길이를 늘리는 것과 다릅니다.
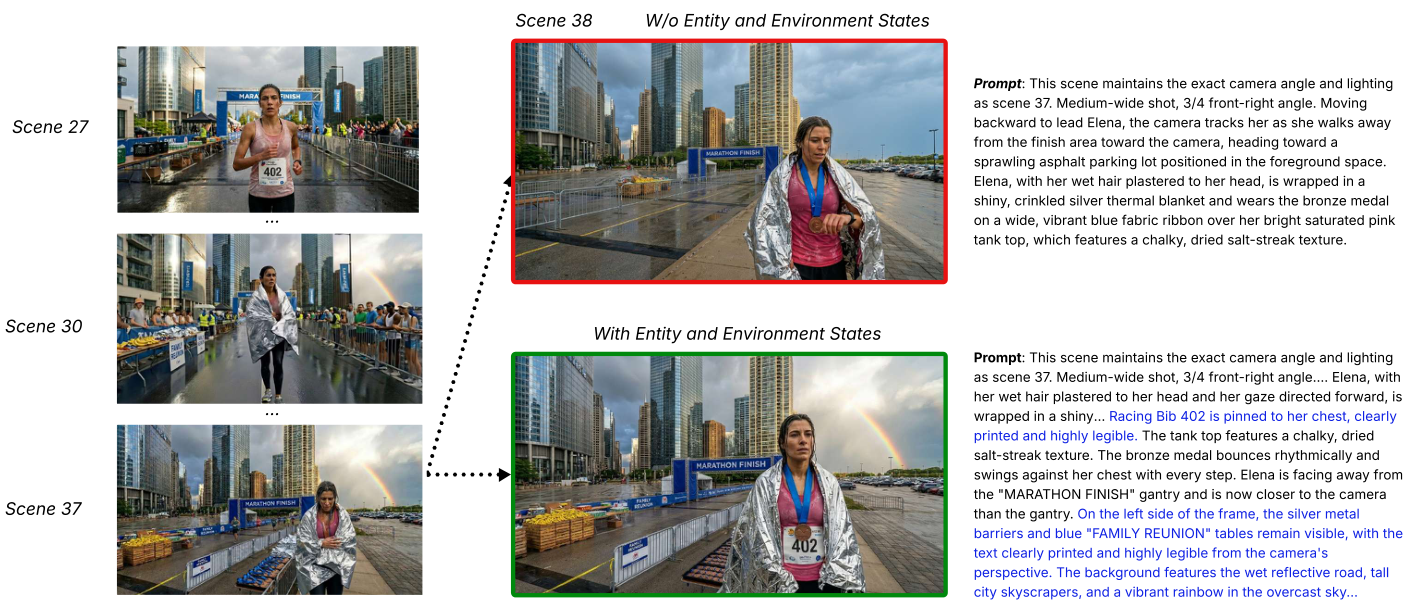
원문 Figure 11, PDF 25쪽. 원문의 프롬프트와 비교 이미지를 함께 보존한 크롭입니다. 핵심 비교는 참가 번호 402와 다시 나타나는 배경 요소입니다. 원문
B.2.5 Why Do We Need Those MLLM-Judge Criteria? 물리적으로 불가능한 프레임은 그것을 시작으로 생성하는 영상에도 문제를 전달합니다. 개체가 같아도 자동차의 방향이나 공간 배치가 바뀌면 연속성이 깨집니다. 반대로 모든 외형을 고정한 채 이야기 진행을 검사하지 않으면 거의 같은 프레임만 반복할 수 있습니다. 저자는 Figures 12–14를 통해 물리적 타당성 → 공간 논리 → 서사 진행의 필요성을 설명합니다.
B.2.6 Memory-Augmented Prompt Optimization (MAPO). Figure 15의 빵집 사례는 과거 양성 10개·음성 5개 수정 사례를 검색해 12개 적용 지침을 도출합니다. 추상적인 카메라 위치 대신 유리병·그릇 같은 물리적 기준을 쓰고, 행동·손 위치·배경 순서를 명료화합니다. 보고된 사례 평균 점수는 6.4→8.3입니다. 이 수치는 MAPO 전체 실험의 평균 향상량이 아니라 한 정성 사례의 결과입니다.
B.3 Error Analysis
환경 오류는 비슷하게 보이지만 실제 구조가 다른 공간, 갑자기 나타나는 테이블 같은 형태입니다. MLLM이 오류를 찾아도 수정 두 번의 예산으로 항상 해결되지는 않습니다. 개체 오류로는 체크무늬 셔츠가 유사하지만 색조가 달라지는 사례가 있으며, 판단 모델도 작은 차이를 놓칠 수 있습니다.
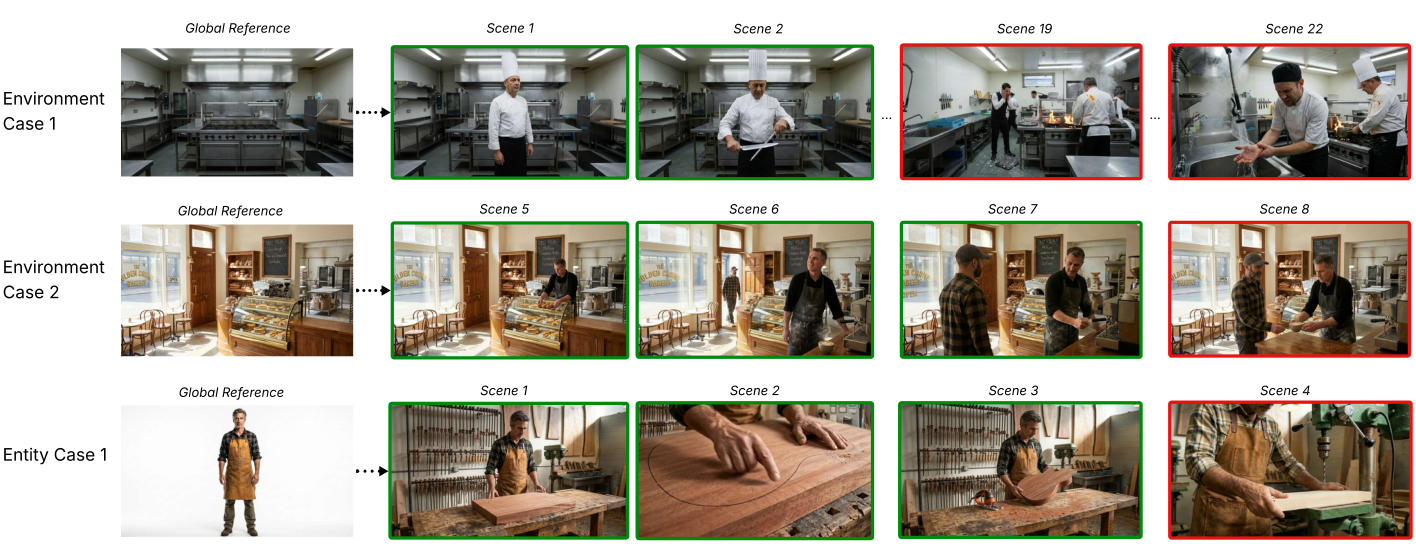
원문 Figure 16, PDF 28쪽. 녹색·적색 표시와 환경·개체 구분을 보존한 크롭입니다. 원문
저자는 더 정밀한 물리적 제어와 더 정확한 판단·추론 모델을 향후 방향으로 제시합니다. 이는 리뷰어가 추가한 과제가 아니라 이 절에 명시된 논의입니다.
B.4 Test-Time Self-Improvement Analysis
Tables 9–10은 초기·1회·2회 수정의 점수 변화를 보고합니다. 프레임의 원문 보고 평균은 8.741→9.259→9.407, 영상은 7.928→8.194→8.493입니다. 이 평균은 표에 적힌 값을 그대로 사용하며, 표시된 모든 열의 단순 평균이라고 새로 정의하지 않습니다. 프레임 공간 논리는 7.083→8.708, 영상의 구간 간 환경 일관성은 7.430→8.795로 증가합니다. 반복 개선이 특히 공간·구간 연결의 약점을 보완한다는 저자의 해석과 연결됩니다.
B.5 Estimated Latency Analysis
B.5.1 Baseline Latency. 저자는 MLLM·이미지·영상 호출 지연을 각각 $L_M,L_I,L_V$로 놓고, 배치가 단일 호출과 같은 시간에 처리되는 이상적 하드웨어를 가정합니다. MovieAgent는 대본 분해·장면 계획·숏 생성 후 이미지와 영상을 생성하는 비용을, VideoMemory는 각 숏의 개체 판단·참조 생성·키프레임·영상 생성 비용을 합산합니다. 식 (13)의 VideoMemory 추정은 다음과 같습니다.
$N$은 숏/생성 단위 수이고, $|\mathcal R|$은 참조 개체 수에 대응하는 항입니다. 순차 생성이라 영상 지연이 $N$에 비례합니다. 이 식은 측정된 전체 벽시계 시간을 보고한 표가 아니라 호출 구조를 바탕으로 한 추정입니다.
B.5.2 A²RD Latency. 초기 참조 생성, 사전 검색 계산, 경계 프레임 수정, 영상 수정을 각각 더합니다. 식 (14)는 이를 MLLM·이미지·영상 호출 지연으로 정리하고, 식 (15)는 영상 병렬 변형을 따로 계산합니다. 여기서 $k_f=k_v=3$은 초기 생성과 두 수정 단계를 뜻합니다. 본문 §5.1의 최대 후보 수 설명과 구분해 읽어야 합니다.
저자는 관측한 호출 지연을 MLLM 10초 미만, 이미지 약 30초, 영상 120초 미만으로 두고, VideoMemory 대비 구간당 추가 부담을 7.2분 미만으로 추정합니다. 실시간 생성 성능이나 전체 작품 완성 시간을 직접 측정한 결과로 바꾸어 말하지 않습니다. 저자의 주장은 수동 검수·재생성을 자동화하는 제작 맥락에서 이런 추가 비용을 고려할 수 있다는 것입니다.
B.6 Use of AI Assistants
저자는 코딩과 집필 보조에 ChatGPT·Gemini·Claude를 사용했다고 공개하고, 분석과 결론의 책임은 저자에게 있다고 명시합니다. 이는 방법론의 생성·평가 모델 설정과 구별되는 연구 수행 고지입니다. 부록 B의 기여는 높은 집계 점수 뒤에 있는 작동 사례·실패·계산 조건을 드러내는 것이며, 다음 부록은 평가 절차를 재현 가능한 수준으로 설명합니다. 부록 B
📖 Chapter C: Implementation Details
위치와 역할. 평가 구현과 사람 평가 지침을 분리하여, 결과 숫자가 어떤 판단 절차에서 나왔는지 밝힙니다.
C.1 Automatic Metrics’ Implementations. 의미 정합성은 ViCLIP 임베딩의 코사인 유사도입니다. 구간 간 인물·환경은 먼저 같은 상태를 유지해야 하는 장면을 MLLM으로 묶고, YOLOv8로 인물·배경 영역을 나누고, DINOv3 임베딩의 쌍별 코사인 유사도를 계산해 그룹 평균을 냅니다. 움직임은 연속 구간 쌍의 앞 영상 마지막 10프레임과 뒤 영상 첫 10프레임을 연결해 VBench motion smoothness를 계산합니다. 따라서 0.99 수준의 움직임 점수는 이 경계 평가 정의 안에서 이해해야 합니다.
C.1.1 Best-of-N Baseline’s Prompts. 이미지 후보는 장면 충실성·시각 품질·개체 일관성, 영상 후보는 프롬프트 충실성·시각 품질·동작 자연스러움으로 선택합니다. C.1.2 Narrative Coherence Evaluation은 0–1 기준을 구체화하며, 대본에 없는 반복이 있으면 0.6을 넘지 못하도록 하고 전체 이야기가 이해 불가능하면 0.2 이하로 제한합니다. C.1.3 Grouping Scenes는 배경·인물·사물의 동일 상태 그룹을 JSON으로 반환합니다. 상태 변화가 의도된 장면과 동일하게 유지되어야 하는 장면을 먼저 구분하는 평가 설계입니다.
C.2 Human Metrics’ Scoring Guidelines. 평가자는 참조 이미지·장면 설명과 영상을 보고 여섯 기준을 1–5로 평가합니다. 3점은 수용 가능한 수준, 5점은 매우 우수한 수준이며 참조가 없으면 참조 일치도는 N/A입니다. 이 부록의 기여는 결과를 해석할 수 있는 측정 정의를 제공한다는 점입니다. 다음 부록은 그 측정이 적용되는 이야기 예시를 보여 줍니다. 부록 C
📖 Chapter D: LVbench-C: Examples
위치와 역할. Figure 17 → 18 → 19의 순서로 사물·인물·환경의 상태 변화 사례를 제시합니다. Figure 17의 3분 요리 시나리오에서는 냄비가 처음에는 비어 있다가 조리 중 화면에서 사라지고, 나중에는 스튜가 담긴 상태로 돌아옵니다. 같은 냄비이되 내용물과 사용 흔적이 달라야 하므로 외형을 완전히 고정하는 것만으로는 정답이 되지 않습니다.
Figure 18의 5분 시나리오에서는 Elias와 Sing이 초반에 등장한 뒤 10개 장면 동안 보이지 않고, 나중에 다른 옷을 입은 상태로 돌아옵니다. 인물의 정체성과 의상 상태의 변화를 동시에 추적해야 합니다. Figure 19의 10분·80장면 등대 시나리오는 등실·등대 하부·나선 계단을 반복 방문하며 폭풍, 침수, 파손, 다음 날의 상태를 축적합니다.
이 부록의 기여는 “일관성”을 동일 이미지 복제가 아니라 이야기에 의해 설명되는 변화와 유지되는 정체성의 결합으로 구체화한다는 점입니다. 다음 부록은 그 요구를 생성기와 평가기에 전달하는 프롬프트를 공개합니다. 부록 D
📖 Chapter E: Methodology Prompts
위치와 역할. 가장 긴 부록인 E는 초기화 → 생성 → HITS 판단 → MAPO 수정 → 장기 일관성 평가의 순서로 실제 입력·출력 규칙을 제시합니다. 여기서는 프롬프트 전문을 복제하지 않고 모든 소절의 역할과 제약을 원문 순서로 정리합니다.
E.1 MVMem Initialization Prompts
E.1.1 Reasoning은 주요 인물·동적 사물을 찾고 놓친 개체를 다시 확인하는 과정, 참조 의존성을 정하는 과정, 공간과 그 안에 필요한 요소를 계획하는 과정을 제시합니다. 환경은 전체 이야기에 필요한 정적 요소를 포괄하게 기술하되, 개체는 상태가 변할 수 있도록 초기 설명을 간결하게 둡니다. E.1.2 Environment Synthesis는 여러 패널이 아닌 하나의 통일된 공간 이미지를 생성하도록 합니다. E.1.3 Entity Synthesis는 깨끗한 흰 배경의 단일 개체 참조를 생성하며, 사물에 불필요한 얼굴을 넣지 않도록 제한합니다.
E.2 A²RD Prompts
E.2.1 Adaptive Segment Generation Mode는 위치·시간·행동의 연속성을 기준으로 그룹을 만듭니다. 움직이는 환경의 줌·프레이밍 변화와 정적인 환경의 큰 프레이밍 변화를 다르게 처리하고, 위치 변경·시간 점프는 확실한 경계로 둡니다. E.2.2 Contiguous Context는 각 장면과 직접 이어지는 과거 장면을 최대 하나 고릅니다. E.2.3 Relevant Scenes는 사물·인물·환경별로 관련 과거 장면을 최대 10개 고르며 미래 장면을 참조하지 않게 합니다.
E.2.4 Global References는 실제로 관련된 전역 참조 이름만 반환합니다. E.2.5 End-of-Shot Frame은 과거의 다중 숏 영상에서 새 장면에 가장 자연스럽게 이어지는 끝 프레임을 고르며 적절한 것이 없으면 null을 허용합니다. E.2.6 Frame Prompts는 전체 장면 수준에서 프롬프트를 먼저 계획한 뒤, 순차 생성 중 실제 상태 기억으로 다시 다듬는 두 단계입니다. 처음 등장하는 개체의 필요한 속성을 확립하고, 이후에는 의도된 변화만 허용합니다. 카메라 화면의 단순 좌우보다 개체·환경 사이의 상대적 위치와 방향을 명시하도록 합니다.
E.2.7 Synthesize Frames는 참조 이미지의 매핑과 장면 진행 조건을 이미지 생성기에 전달합니다. E.2.8 Video Prompts는 시작 상태를 정확히 이어받고 끝 프레임이 있으면 그 상태에 도달하도록 합니다. 이전 움직임·카메라 방향을 갑자기 뒤집지 않으며, 여러 행동이 있으면 시간 순서로 분해합니다. 끝 프레임이 없는 외삽에서는 존재하지 않는 두 번째 이미지를 언급하지 않도록 합니다. E.2.9 Synthesize Video Segments는 이렇게 얻은 프롬프트로 영상을 생성하는 연결 단계입니다.
E.3 HITS Self-Refinement Prompts: MLLM-Judge
E.3.1 Frame States는 개체별 identity와 현재 state, 공간 관계를 추출합니다. 위치·방향을 다른 개체나 환경에 대한 관계로 표현합니다. E.3.2 Video States는 시작 프레임 뒤에 새로 나타나는 개체, 드러나는 속성 변화, 시작·중간·끝의 움직임과 카메라를 보충합니다.
E.3.3 Consistency over Images는 같은 개체·환경의 관련 참조를 먼저 식별한 뒤 외형 일치와 서사 진행을 평가합니다. E.3.4 Spatial Logicalness는 물리적 공간의 배치를 별도로 확인합니다. E.3.5 Textual States는 사물 → 인물 → 환경 순서로 과거와 현재 상태를 비교하며, 카메라나 인물의 이동에 따라 자연스럽게 드러나는 환경 변화는 오류로 세지 않습니다. E.3.6 Basic Quality는 지시 준수와 물리적 타당성을 평가하고, 한 순간의 프레임을 여러 패널이나 시간대의 콜라주로 만드는 것을 금지합니다.
E.3.7 Video Inter Consistency는 직접 연결되는 두 구간의 개체 외형 → 개체 움직임 → 환경 → 카메라 순서로 평가합니다. E.3.8 Video Intra Consistency and Basic Quality는 영상의 지시 준수·물리성·진행·끝 프레임 적합성을 보고, 인물·사물·환경의 내부 변화는 추출된 상태를 비교합니다. 모든 점수가 영상의 원시 픽셀을 직접 다시 보는 동일 절차에서 나오는 것은 아니라는 점을 이 프롬프트에서 확인할 수 있습니다.
E.4 MAPO Prompts
E.4.1 Frame Feedback은 장면 요구와 현재 프롬프트, 검증 피드백을 읽어 모호한 부분·추가할 부분·지울 부분을 분석하고 Edit 또는 Regenerate를 선택합니다. 프롬프트 문구가 오류를 확정적으로 유발했다고 단정하지 않고 원인 후보로 다루게 합니다. E.4.2 Video Feedback은 같은 절차를 개체 정체성·환경·움직임에 적용합니다.
E.4.3 Frame Contrastive Patterns는 성공·실패 사례에서 구조·구체성·용어·공간 논리의 실용적인 지침을 뽑습니다. E.4.4 Video Contrastive Patterns는 시간 순서·동작·연속성·상충하는 지시·과도한 세부를 다룹니다. E.4.5 Refine Frame Prompt는 문제가 있는 부분만 수정하고 나머지는 유지하게 합니다. E.4.6 Refine Video Prompt는 특히 이전 장면에서 물려받은 초기 위치·속도·상태를 바꾸지 않도록 하며, 장면이 요구하지 않으면 정적인 카메라를 기본으로 둡니다. 수정 때문에 이미 맞았던 연결 조건을 다시 깨지 않도록 제한하는 것입니다.
E.5 Section 6.3’s Prompts
E.5.1 Character Drift, E.5.2 Object Drift, E.5.3 Environment Drift는 모두 변화 탐지 → 이야기로 정당화되는지 분류 → 명백한 위반 판정의 순서입니다. 인물에서는 약간의 오염·액세서리·포즈 차이, 사물에서는 작은 마모·부분 가림, 환경에서는 카메라 각도·작은 조명 변화를 위반에서 제외합니다. 따라서 Figure 7의 높은 일관성 비율은 이 관대한 명백성 기준과 함께 읽어야 합니다.
이 부록의 기여는 추상적인 “에이전트가 검수한다”를 실제 선택·출력·예외 규칙으로 풀어 쓴 것입니다. 제공된 프롬프트는 재현을 돕지만, 이 리뷰에서 모델 API 실행이나 전체 파이프라인 재현 실험을 수행한 것은 아닙니다. 다음 부록은 완성된 스토리보드를 제시합니다. 부록 E
📖 Chapter F: Full Storyboard Examples
위치와 역할. 마지막 부록은 짧은 성공 사례를 넘어 전체 장면열을 보여 주는 정성 자료입니다. F.1 A²RD Examples에는 3분 잠수부 이야기(Figure 20, 24장면), 5분 Clara의 무대 공포 이야기(Figure 21, 40장면), 10분 박물관 절도 이야기(Figure 22, 79장면)가 순서대로 나옵니다. F.2 Baseline Examples에는 같은 잠수부 주제의 Naive-AR, Naive-Par, MovieAgent, ViMax, VideoMemory(Figures 23–27), 이어 VideoMemory의 5분 Clara 이야기(Figure 28)가 있습니다.
이 배열은 멀리 떨어진 장면에서 인물·배경이 재등장하는 모습을 비교하는 근거입니다. 다만 PDF의 정지 스토리보드는 실제 재생에서의 움직임과 전환을 모두 전달하지 않습니다. 이 리뷰는 PDF 60–64쪽의 스토리보드를 시각적으로 확인했으며, 보충 영상 전체를 재생해 검수했다고 주장하지 않습니다. 마지막 부록의 기여는 자동·사람 평가에 정성 근거를 더하는 데 있습니다. 부록 F
실험 결과 심층 분석
가장 강한 결과는 이야기의 진행과 장기 정체성 보존을 함께 평가한 조건에서의 개선입니다. VBench-Long에서 A²RD의 서사 점수 0.8987은 가장 높은 베이스라인 0.7466보다 높고, 사람 평가의 보고 평균도 4.68 대 3.93입니다. 그러나 자동 서사 점수, 사람의 Likert 점수, Figure 7의 명백한 위반 통과 비율은 서로 다른 측정이므로 하나의 성능 향상률로 합치지 않습니다.
비교 설계의 장점은 기본 생성기를 맞추고, best-of-N 비교와 구성요소 제거를 함께 제공한다는 점입니다. 특히 항상 보간했을 때 일관성은 높아져도 서사는 떨어지는 결과가 적응적 모드 선택의 동기를 뒷받침합니다. 동시에 5분 환경 일관성에서 A²RD-Par가 우수하고, 일반 깜빡임 지표에서는 순차 A²RD가 낮다는 사실도 남습니다. 이 연구의 성과는 모든 시각 품질 지표의 일괄 개선으로 요약하기 어렵습니다.
통계적 유의성이나 신뢰구간은 보고되지 않았고, Figure 7의 일부 MLLM 판정과 수동 확인 사이의 80% agreement는 사람 평가 전체의 신뢰도 계수가 아닙니다. 재현에 필요한 프롬프트·모델·일부 생성 설정·평가 절차는 상당히 상세하지만, 데이터 총수와 반복 횟수 집계의 서술 불일치는 원문 그대로 구분해 두었습니다. 실제 비용을 판단하려면 저자가 따로 제외한 영상·이미지 생성 비용까지 포함해야 합니다. §5–6, 부록 B–C
기술적 함의와 응용
리뷰어 해석: A²RD는 긴 영상의 품질을 “더 긴 문맥을 받는 생성 모델” 하나에만 맡기지 않고, 상태 표현·검색·모드 선택·검증·수정을 조직하는 문제로 다룹니다. 데이터과학 관점에서는 관측된 결과를 구조화된 상태로 바꾸고, 잘못된 상태가 다음 단계로 전파되기 전에 검사한다는 점이 흥미롭습니다. MAPO 역시 실패를 문장으로 회고하는 데서 끝나지 않고, 수정 전후 결과를 저장해 다음 검색과 비교의 자료로 사용합니다.
실제 제작에서 적용 여부를 판단할 때는 원하는 서사 길이, 반복 등장 대상, 공간 변화, 생성기의 시작·끝 프레임 지원 여부, 검수 비용을 함께 보아야 합니다. 이 논문의 결과에서 병렬 변형은 단순한 열화판이 아니라 일부 환경 지표와 지연에서 다른 선택지를 제공합니다. 저자가 명시한 대로 창작 양식과 도메인에 맞게 판단 기준을 조정할 필요도 있습니다.
A²RD가 보여 주는 핵심은 같아야 하는 속성, 자연스럽게 바뀌어야 하는 상태, 반드시 앞으로 나아가야 하는 이야기를 구분해 제어하는 것입니다. 그 구분을 메모리와 평가 규칙에 명시했을 때, 기존 영상 생성기만으로도 긴 구간의 일관성과 서사적 정합성을 개선할 수 있다는 것이 이 연구의 구체적인 성과입니다.
검토 범위: 본문 1–7장, Limitations, 부록 A–F의 구조와 모든 하위 주제를 반영했습니다. 프롬프트 전문과 시나리오별 모든 장면 문장을 전재하지 않았으며, References의 개별 논문·보충 영상 전체·저자 코드 실행은 검토 범위에 포함하지 않았습니다.