논문 개요와 전체 구조
Co-Director는 간단한 아이디어와 제품·로고 참조 이미지에서 출발해 대본, 장면 이미지, 영상, 음향을 만드는 다중 에이전트 시스템입니다. 연구의 초점은 개별 생성 모델의 가중치를 학습하는 데 있지 않습니다. 여러 생성 단계가 같은 창작 의도에 맞춰 움직이도록 제어하고, 완성 결과의 평가를 다음 제작에 반영하는 방법을 설계합니다. 이 리뷰는 Yale Song 외 저자들의 arXiv:2604.24842v1, 2026년 4월 27일 제출본을 기준으로 합니다.
핵심은 두 종류의 피드백을 결합하는 데 있습니다. 대본과 키프레임은 중간 산출물 단계에서 수정하고, 전체 영상은 다중 팔 밴딧(Multi-Armed Bandit, MAB)으로 창작 방향을 바꾸며 다시 만듭니다. 밴딧은 여러 선택지의 보상을 관찰하면서 새로운 선택지를 시험하는 탐색과 이미 좋은 선택지를 활용하는 이용을 조절하는 의사결정 방식입니다. 논문은 브랜드 자산 보존과 목표 고객층이라는 제약을 명확히 평가할 수 있는 광고를 주 실험으로 삼고, 400개 시나리오의 GenAd-Bench를 제안합니다. 에이전트 조율, 멀티모달 평가, 추론 시점 탐색을 함께 공부하기에 적합한 연구입니다.
원문의 실제 순서는 다음과 같습니다. 참고문헌 뒤에도 평가와 구현의 중요한 조건이 이어집니다.
- 1 Introduction, 2 Related Work: 영상 기반 모델 → 영상 스토리텔링 에이전트 → 벤치마크.
- 3 Approach: 3.1 계층적 다중 에이전트 구조 → 3.2 국소 자기 수정 → 3.3 밴딧 기반 전역 최적화.
- 4 GenAd-Bench: Evaluating Generative Video Advertising.
- 5 Experiments: 구현·비교 모델 → 5.1 주요 결과 → 5.2 사람 평가와 MLLM 지표 검증 → 5.3 제거 실험 → 5.4 정성 결과.
- 6 Conclusion, References.
- 부록 A–F: 부록 안내 → GenAd-Bench 정성 결과 → 일반 스토리텔링 평가 → 데이터 상세(D.1 구축, D.2 분포, D.3 분할) → 비교 모델 구현 → MAB 효율.
- 부록 G–L: 창작 방향(G.1 계층적 조율, G.2 미학 유형) → 자기 수정(H.1 대본, H.2 키프레임) → 대본 평가 프롬프트 → 키프레임 평가 프롬프트 → 최종 영상 평가 프롬프트 → 벤치마크 평가 프롬프트.
핵심 기여와 혁신성
긴 제작 과정을 단순히 연결하면 앞 단계의 오류가 뒤 단계로 전파됩니다. 잘못 해석한 제품이 대본에 들어가면, 이후 이미지와 영상은 그 오류를 정교하게 시각화할 수 있습니다. 저자들은 이 문제를 에이전트별 고정 프롬프트의 의미 표류와 연결합니다. 최종 실패를 어떤 앞선 선택에 귀속할지 판단하는 신용 할당(credit assignment) 역시 어렵습니다. §1–2
해결책은 창작 의도를 무엇을 전달할지, 어떻게 전개할지, 어떤 감각으로 표현할지로 나누고, 상위 에이전트가 이 조합을 각 제작 단계의 지침으로 번역하는 것입니다. 완성 영상을 고르는 종합 점수와 각 창작 축을 갱신하는 보상을 구별한다는 점도 중요합니다. 대본·이미지 수정은 이미 선택한 방향의 실행을 개선하고, MAB는 방향 자체를 탐색합니다. 저자들의 전역 최적화라는 표현은 전체 제작 파이프라인을 제어한다는 뜻으로 읽어야 하며, 네 번의 실행이 수학적 전역 최적해를 보장한다는 뜻은 아닙니다. §3.3, 부록 F
또 다른 기여는 평가 문제를 구체화한 것입니다. GenAd-Bench는 제품·로고의 보존, 고객층 적합성, 광고 설득력, 시각 품질을 함께 측정합니다. 리뷰어 관점에서 이 설계는 생성 품질을 한 장면의 아름다움에 한정하지 않고, 입력 제약을 여러 생성 단계를 거쳐 유지하는 능력으로 확장합니다. 다만 평가 점수가 실제 광고 매출이나 전환율을 의미하지는 않습니다. 논문이 측정한 것은 공개한 평가 지침에 따른 영상 점수입니다.
기술적 세부사항
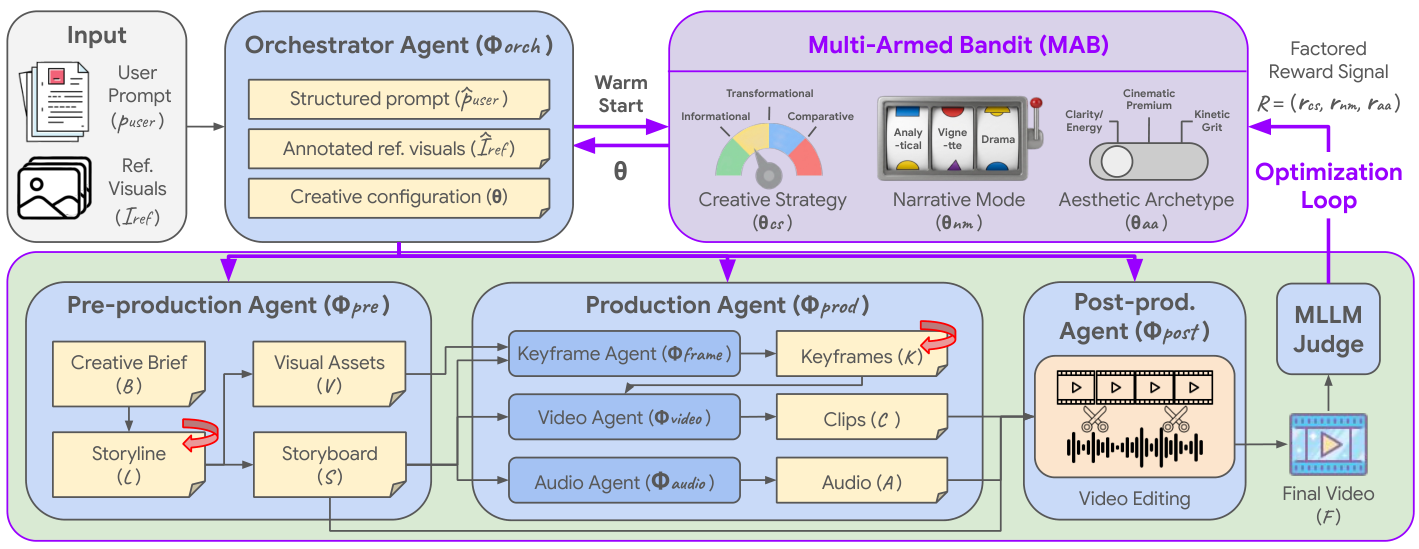
원문 Figure 1, PDF 3쪽에서 전체 도식 영역을 크롭했습니다. 번역·재배열 없이 원본을 사용했습니다. 버전 고정 PDF. 아래 챕터 분석에서 위·아래 부분을 나누어 설명합니다.
시스템은 Gemini 3 Pro로 추론·평가, Nano Banana Pro로 이미지 생성, Veo 3.1로 영상 생성, Gemini 2.5 Pro TTS로 음성 합성, Lyria 2로 음악 생성을 수행합니다. 최종 결과는 4개 샷, 총 12초이며 전역 실행 예산은 4회, 국소 수정은 최대 3회 재시도입니다. 이 값은 논문의 실험 구성이지 모든 제작 환경의 고정 요구사항은 아닙니다. §5
방법을 이해할 때는 세 점수 체계를 분리해야 합니다.
| 평가 위치 | 평가 대상과 출력 | 사용 목적 |
|---|---|---|
| 국소 수정 | 대본 또는 키프레임의 점수·텍스트 피드백 | 문제가 있는 중간 산출물 수정 |
| 전역 탐색 | 최종 영상 종합 점수 + 창작 축별 0–100 보상 | 최종 후보 선택 + MAB 갱신 |
| GenAd-Bench | VAF·DA·MA·VQ 각각 0–100 | 방법 간 성능 비교 |
VAF는 시각 자산 충실도, DA는 목표 인구집단 적합성, MA는 마케팅 매력도, VQ는 시각 품질입니다. 약어 이름만으로 평가를 재구성하면 안 됩니다. 특히 부록 L의 VAF에는 제품의 시각적 강조와 로고 등장 시점, VQ에는 영화적 조명 선호도 포함됩니다. 이러한 평가 지침을 함께 읽어야 점수의 의미를 정확히 해석할 수 있습니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
서론은 추상적인 문구를 완결된 영상으로 바꾸는 과제를 정의합니다. 필요한 능력은 서사적 일관성, 시각적 일관성, 미장센입니다. 여기서 미장센은 카메라 각도·색상·시각적 은유가 메시지를 전달하는 방식을 뜻합니다. 개별 영상의 사실감이 높더라도 이 세 능력이 자동으로 함께 확보되는 것은 아니라는 것이 출발점입니다.
저자들은 먼저 대규모 전문가 팀이 있는 인간·AI 공동 제작과 독립 창작자의 조건을 대비합니다. 이어 생성 모델을 에이전트로 연결하는 접근이 수작업 부담을 줄이지만, 초기 오류의 누적과 고정 프롬프트의 제한을 그대로 가질 수 있다고 설명합니다. 마지막으로 창작에는 이미 성공한 스타일을 정교화하는 작업뿐 아니라 예상 밖의 방향을 탐색하는 과정이 필요하다고 주장합니다. 이 논리가 전역 탐색을 도입하는 이유입니다.
광고는 시각적 이야기와 엄격한 요구조건이 공존하는 사례로 선택합니다. 제품 보존, 고객층 적합성, 가치 제안 전달을 관찰할 수 있기 때문입니다. 서론의 기여 목록은 계층적 에이전트 구조, 창작 의도의 매개변수화, GenAd-Bench, 비교 실험, 구현·데이터 공개에 대한 저자 진술로 마무리됩니다. 이 리뷰는 공개 구현을 실행한 결과를 제시하지 않습니다. 다음 장은 이 제안이 기존 모델·파이프라인·평가와 어디에서 구별되는지 정리합니다. §1
📖 Chapter 2: Related Work
Foundation Models for Video Synthesis. 첫 소주제는 영상 확산 모델과 인물 일관성에 특화된 모델을 다룹니다. 저자들은 이 모델들을 강력한 생성 부품으로 평가하면서도, 여러 장면의 의미를 계획하는 완결된 이야기 제작 시스템과 구별합니다. 따라서 Co-Director의 기여를 새로운 영상 생성 백본 자체와 혼동하지 않아야 합니다.
Agentic Frameworks for Video Storytelling. 다음에는 대본을 샷 목록과 생성 프롬프트로 분해하는 다중 에이전트 연구를 검토합니다. AniMaker·MAViS처럼 국소 일관성을 검사하는 시스템도 있지만, 저자들은 제작 전체에 걸친 선택의 책임을 조율하는 문제를 남긴다고 봅니다. Co-Director가 추가하는 것은 상위 창작 변수를 공유하는 전역 조율입니다.
Benchmarks for Video Storytelling. 마지막으로 일반적인 영상 미학·프롬프트 정합성 평가와 장면별 대본이 이미 주어진 이야기 평가를 구별합니다. GenAd-Bench는 짧은 아이디어에서 완성 영상까지의 전체 과정을 평가하도록 설계됩니다. 이 장의 핵심은 생성 부품, 제작 제어, 과제 정의를 나누는 것이며, 다음 장은 그중 제작 제어를 구체화합니다. §2
📖 Chapter 3: Approach
3.1 Hierarchical Multi-Agent Architecture
Orchestrator Agent. 최상위 에이전트는 사용자 입력을 브랜드·제품·고객층의 구조화된 조건으로 바꾸고, 참조 이미지에 제품·로고·주인공 같은 역할과 설명을 붙입니다. 매 전역 반복에서 밴딧이 창작 설정을 선택하면, 이 세 정보를 묶어 하위 단계에 전달합니다.
원문 §3.1의 비번호 식입니다. $t$는 전역 반복, $\hat p_{user}$는 구조화된 사용자 조건, $\hat{\mathcal I}_{ref}$는 역할을 주석화한 참조 이미지, $\theta^{(t)}$는 해당 반복의 창작 방향입니다. $\Theta^{(t)}$를 공유하므로 각 에이전트가 입력을 독립적으로 재해석하는 부담을 줄입니다.
Pre-Production Agent. 사전 제작은 Creative Brief → Storyline → Visual Assets → Storyboard 순서입니다. 브리프는 제품·고객 조건을 문화적·환경적 맥락으로 확장합니다. 스토리라인은 장면별 행동, 속도감, 전환을 정하고, 필요한 인물·소품·환경 이미지가 참조 자료에 없을 때 시각 자산을 생성합니다. 인물에는 대본에 맞는 의복과 다각도 참조 콜라주를 준비합니다. 마지막 스토리보드는 장면마다 행동·환경, 카메라 크기와 움직임, 시간 제약, 등장 자산을 지정하며 내레이션·음악의 전체 방향도 작성합니다.
Production Agent. 제작은 키프레임, 영상, 음향 에이전트로 나뉩니다. 키프레임은 각 장면의 첫 이미지를 고정하는 시각적 사전 조건입니다. 원문 식 (1)과 (2)는 다음과 같습니다.
$N$은 장면 수, $s_i$는 장면 기술, $\mathcal V$는 참조용 시각 자산, $\theta$는 창작 방향입니다. $\Phi_{frame}$은 이 조건을 이용해 첫 프레임 $k_i$를 만드는 에이전트이며, $\mathcal K$는 그 집합입니다. 식의 목적은 학습 손실을 정의하는 것이 아니라 제작 단계의 입출력 의존관계를 명시하는 것입니다.
$\Phi_{video}$는 장면 기술·첫 프레임·창작 방향을 받아 영상 클립 $c_i$를 생성합니다. $\mathcal C$는 클립 집합입니다. 같은 제품 참조에서 먼저 정지 이미지를 만든 뒤 이를 영상 생성의 조건으로 사용하는 것이 정체성 표류를 줄이려는 설계입니다.
음향은 장면마다 따로 만드는 대신 스토리보드 전체의 내레이션과 음악을 생성·혼합합니다. Post-Production Agent는 클립의 시간 조건에 맞춰 연결한 뒤 음향을 결합합니다. 식 (3), (4)는 다음과 같습니다.
$\mathcal S$는 스토리보드, $\mathcal A$는 전역 음향 트랙, $F$는 최종 영상입니다. $\Phi_{audio}$는 음성·음악 생성과 혼합을, $\Phi_{post}$는 영상 연결과 음향 결합을 담당합니다. 이로써 시각과 청각이 같은 계획을 공유합니다. §3.1, 식 (1)–(4)
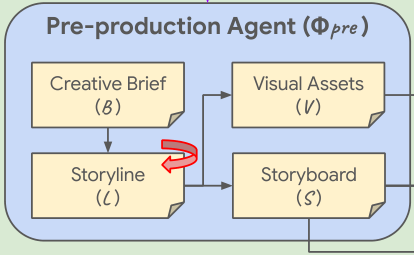
Figure 1의 사전 제작 영역 상세, PDF 3쪽 크롭·번역 없음. 빨간 반복 표시는 스토리라인 수정 지점을 나타냅니다. 원문.
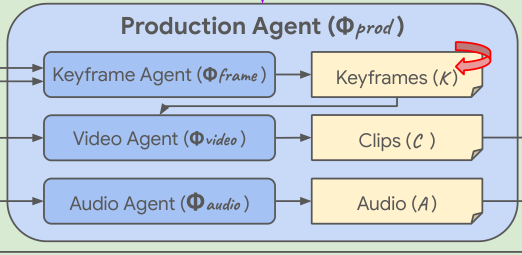
Figure 1의 제작 영역 상세, PDF 3쪽 크롭·번역 없음. 키프레임 수정 후 이미지를 영상 생성의 조건으로 사용하며, 음향은 별도 에이전트가 생성합니다. 원문.
3.2 Local Optimization via Agentic Self-Refinement
이 절은 초기 오류가 후속 제작으로 전파되기 전에 중간 결과를 수정합니다. 피드백 하강(feedback descent)은 수치 미분 대신 자연어 비평으로 다음 생성 지침을 개선하는 방식입니다. 기준 점수에 도달하거나 반복 예산을 소진하면 종료하고 가장 좋은 시도를 반환합니다.
Storyline. 스토리보드 확장 전에 LLM이 도입부의 주목도, 서사 연결, 제품 통합, 감정적 관여, 입력 준수를 평가합니다. 점수가 임계값 $\tau_{\mathcal L}$보다 낮으면 비평에 맞게 프롬프트를 수정해 대본을 다시 생성합니다. 제품을 잘못 이해한 상태로 시각 자산까지 만드는 것을 막는 위치에 이 검사를 둡니다.
Keyframe. 멀티모달 대규모 언어 모델(MLLM)은 이미지를 따로 평가하지 않고 장면열 전체를 함께 봅니다. 인물과 제품이 장면을 넘어 같은 대상으로 보이는지, 배경 변화가 논리적인지 확인해야 하기 때문입니다. 점수가 $\tau_{\mathcal K}$보다 낮으면 문제 프레임의 인덱스와 수정 지침을 제공하고, 통과한 프레임은 보존합니다. 논문은 임계값 기호를 제시하지만 이 절에서 구체적 수치를 주지는 않습니다. §3.2
3.3 Global Optimization via Multi-Armed Bandits
MAB Preliminaries. 여러 모델과 도구가 연결된 과정은 전체가 미분 가능하지 않습니다. 저자들은 개별 프롬프트를 별도로 조정하는 대신, 제작 파이프라인을 하나의 평가 가능한 블랙박스로 취급합니다. 밴딧의 한 번 실행은 완성 영상 한 편을 만드는 것이며 보상은 그 결과의 평가에서 얻습니다.
Hierarchical Parameterization. 창작 방향은 세 범주형 변수로 분해됩니다.
$\theta_{cs}$는 창작 전략으로 정보 전달, 경험·정체성을 강조하는 변형적 전략, 비교 전략의 세 선택지가 있습니다. $\theta_{nm}$는 서사 방식으로 논증 중심 Analytical, 분위기 중심의 생활 단편 Vignette, 갈등과 해결 중심 Narrative Drama입니다. $\theta_{aa}$는 미학 유형으로 Clarity/Energy, Cinematic Premium, Minimalist Focus, Kinetic Grit의 네 선택지입니다. 전체 조합은 3×3×4=36개지만 축별 선택지는 합계 10개입니다.
밝은 조명과 빠른 편집을 쓰는 Clarity/Energy, 명암 대비와 느린 카메라·관현악을 쓰는 Cinematic Premium처럼 미학 변수는 영상뿐 아니라 음향에도 영향을 줍니다. 최상위 에이전트는 선택된 범주 이름을 그대로 전달하는 데 그치지 않고, 대본·키프레임·영상 에이전트 각각의 기술적 지침으로 바꾸어 시스템 프롬프트에 주입합니다.
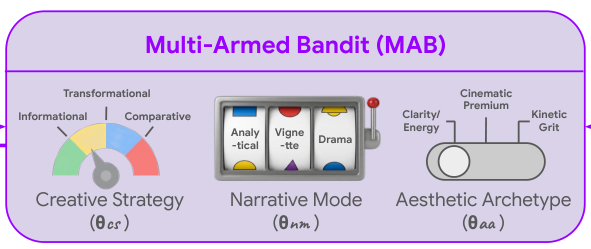
Figure 1 상단의 밴딧 선택 영역 상세, PDF 3쪽 크롭·번역 없음. 세 축의 선택을 한 제작 방향으로 합성하는 구조입니다. 원문.
Reward. 최종 판정자는 두 출력을 만듭니다. 종합 품질 점수는 여러 실행에서 반환할 최종 영상을 고릅니다. 반면 아래의 축별 보상은 선택한 전략·서사·미학 유형의 효과를 평가하여 밴딧을 갱신합니다.
$r_{cs}$, $r_{nm}$, $r_{aa}$는 각각 전달 전략, 이야기 전개, 감각적 표현의 효과에 대한 점수입니다. 예를 들어 영상에 오류가 있다는 총평만으로 모든 선택을 같은 정도로 벌점 처리하는 대신, 어떤 창작 축이 의도 달성에 기여했는지 분리해 평가하려는 설계입니다. 다만 이것은 평가 모델의 귀속 판단이며, 각 선택의 인과 효과를 별도 실험으로 식별한 결과는 아닙니다.
Optimization Policy and Warm Start. 정책은 UCB1을 사용하며, 축별로 선택된 선택지의 기대값을 갱신합니다. UCB는 보상 추정과 탐색 불확실성을 함께 고려하는 방식입니다. 최초 실행 전에는 LLM이 제품·고객 정보를 읽고 기대값을 초기화합니다. 생성 비용이 큰 상황에서 무정보 탐색을 줄이려는 warm start입니다. 원문에는 UCB1의 구체적 구현 식이나 초기화 수치가 제시되지 않아 이를 새 식으로 보충하지 않습니다. 이 장은 공유 방향·국소 수정·전역 탐색을 완성하며, 다음 장은 이 구조를 비교할 평가 과제를 정의합니다. §3.3
📖 Chapter 4: GenAd-Bench: Evaluating Generative Video Advertising
먼저 데이터 구축을 설명합니다. Gemini 3 Pro와 Nano Banana Pro를 사용하는 사람 개입형 파이프라인으로 가상 브랜드 50개×제품 4개×고객층 조건 2개=400개 시나리오를 만듭니다. 각 제품에 전형적 고객층과 관습을 벗어나는 고객층을 짝지어 같은 제품을 다른 맥락에서 해석하게 합니다. 입력은 브랜드, 제품, 성별, 나이, 위치, 관심사의 여섯 항목과 참조 이미지입니다. 제품 시각 자료의 약 15%는 검수 후 재생성했습니다.
이어서 가상 자산의 목적을 설명합니다. 저자들은 기존 유명 제품을 기억해 재현하는 효과를 줄이고, 주어진 시각 자료와 조건을 실제로 사용하는 평가를 의도합니다. 이는 기억 의존을 줄이기 위한 설계 취지로 이해할 수 있으며, 모든 형태의 학습 데이터 편향이 제거되었다는 독립 검증과 같지는 않습니다. 데이터는 시스템 조정용 hillclimbing 200개와 검증용 200개로 나눕니다.
마지막으로 네 지표를 정의합니다. VAF는 제품·로고의 시각적 정체성, DA는 성별·나이·위치·관심사 적합성, MA는 주의·관심·욕구·행동의 AIDA 틀을 참고한 설득력, VQ는 물체 변형·시간적 깜박임·부자연스러운 움직임 등을 평가합니다. Gemini 3 Pro가 영상 프레임과 음향을 함께 읽습니다. 저자들은 자동 판정의 타당성을 다음 장의 사람 평가로 확인합니다. §4
📖 Chapter 5: Experiments
Implementation Details와 Baselines. 앞서 소개한 모델 조합과 12초 출력을 고정합니다. 비교 대상은 단일 생성 모델, 상용 제작 플랫폼, 다중 에이전트 시스템입니다. AniMaker·MovieAgent에는 같은 기반 모델과 Gemini 3 Pro 대본 생성기를 사용합니다. 이 두 방법은 샷별 대본을 요구하므로 여섯 항목의 입력을 구조화된 대본으로 변환한 뒤 전달합니다. 내부 비교에는 최적화 없는 기본 파이프라인과 4회 무작위 탐색을 포함합니다.
5.1 Main Results
Table 1에서 Co-Director의 평균은 81.4, 같은 4회 예산의 Random Search는 75.7입니다. 기본 파이프라인은 68.5, MovieAgent는 65.3, AniMaker는 62.2입니다. 이 표에서 먼저 확인할 점은 반복 자체도 성능을 올린다는 사실입니다. 68.5에서 75.7로의 변화와 75.7에서 81.4로의 변화는 서로 다른 비교이므로, 전체 차이를 MAB 하나의 효과로 돌리면 안 됩니다.
Veo 3.1 단독의 VQ 50.5와 Co-Director의 70.2 차이는 동일 영상 백본도 계획·수정·후보 선택을 포함한 제작 절차에 따라 결과가 달라짐을 보여 줍니다. 상용 플랫폼 결과는 해당 프롬프트와 광고 제약에서의 점수이며 서비스 전체의 보편적 품질 순위로 확대하지 않습니다.
Figure 2는 10회까지의 탐색을 비교하며 저자들은 warm start와 MAB가 초기에 좋은 방향을 찾는다고 해석합니다. 그림은 누적 최고 성능으로 소개되지만 빨간 곡선 일부는 뒤에서 낮아집니다. 따라서 이를 엄밀한 단조 증가 기록으로 다시 계산하거나, 음영을 정의가 확인된 신뢰구간으로 해석하지 않습니다. 이 리뷰는 그림의 보이는 추세와 Table 1의 보고값을 구별합니다. §5.1, Figure 2
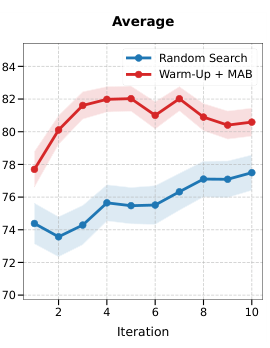
Figure 2의 오른쪽 Average 패널, PDF 9쪽 크롭·번역 없음. 파랑은 Random Search, 빨강은 Warm-Up + MAB입니다. 축·범례·음영을 보존했습니다. 전체 그림과 원문 캡션.
5.2 MLLM Metric Validation via Human Evaluation
50개 시나리오의 부분집합에서 영상마다 독립 평가자 5명이 네 항목을 1–5점으로 평가합니다. 저자들은 사람끼리의 일치도를 비교 기준으로 두고, 자동 판정과 사람 평균의 상관을 측정합니다. Krippendorff의 알파는 전체 평가자 집단의 일치도, Cohen의 카파와 MAE는 개별 평가자 쌍의 평균, Pearson·Spearman 상관은 사람 평균 의견 점수(MOS)를 기준으로 계산합니다.
MLLM–사람 Pearson 상관은 VAF 0.601, DA 0.647, MA 0.570, VQ 0.345입니다. 이에 대응하는 사람–사람 값은 0.733, 0.751, 0.737, 0.705입니다. 따라서 자동 평가가 모든 차원에서 사람을 거의 대체한다고 묶어 말하기보다, DA 등과 VQ 사이의 차이를 읽어야 합니다. 저자들은 사람이 실시간 재생에서 덜 거슬린다고 보는 짧은 오류를 MLLM이 프레임 단위로 엄격하게 벌점 처리할 수 있다고 설명합니다.
Perceptual Comparison (MOS). Table 3에서 Co-Director 평균은 3.96, Veo 3.1은 3.71이며 Co-Director가 네 항목 모두 가장 높습니다. 이 0.25점 차이는 1–5 척도입니다. Table 1의 0–100 자동 점수와 직접 빼거나 같은 백분율로 해석할 수 없습니다. 이 절의 기여는 자동 결과와 사람 선호의 방향을 함께 보여 주면서 평가 차원별 차이를 드러낸 데 있습니다. §5.2, Tables 2–3
5.3 Ablation Studies
MAB Logic. Table 4의 전체 구성 평균은 79.0입니다. Table 1의 81.4와 같지 않으며, 이 표 안의 비교는 79.0을 기준으로 해야 합니다. cold start는 77.3, 축별 보상을 종합 스칼라 보상으로 바꾸면 76.4입니다. 스칼라 보상에서 VAF는 79.8→74.8로 5.0점 내려갑니다. 저자들은 방향별 보상과 초기 기대값의 효용으로 해석합니다.
Self-Refinement Loops. 대본 수정을 빼면 MA가 80.0→73.7, DA가 88.6→86.2로 낮아집니다. 키프레임 수정을 빼면 VAF가 79.8→70.0으로 9.8점 하락합니다. 두 수정을 모두 빼고 MAB를 유지하면 평균 69.4, 모든 수정과 전역 최적화를 빼면 67.2입니다. 완전 구성 대비 차이는 11.8점이며, 저자들의 상대 향상 17.6%는 11.8을 67.2로 나눈 값입니다. 81.4나 Table 1의 기본 파이프라인 68.5와 섞지 않습니다. §5.3, Table 4
5.4 Qualitative Results and Discussion
저자들은 전형적·비전형적 맥락 모두의 전략 적응성, 자세·카메라·조명 변화 속 정체성 보존, 제품 범주 환각을 수정하는 논리적 견고성을 강조합니다. 구체 사례는 부록 B와 H로 연결됩니다. 광고 밖의 일반화는 부록 C에서 다루지만, 그 실험은 정적 스토리보드 이미지 생성으로 축소된 구성입니다. 이 구별을 유지해야 영상 전체 제작으로의 일반화를 실제 측정보다 넓게 주장하지 않을 수 있습니다. 다음 결론은 이러한 결과를 전체 설계의 기여로 모읍니다. §5.4
📖 Chapter 6: Conclusion
결론은 계층적 에이전트와 MAB 기반 창작 방향 탐색으로 영상 스토리텔링을 전역 최적화 문제로 다뤘다는 주장을 다시 제시합니다. GenAd-Bench는 조건이 명확한 종단 간 제작 평가라는 위치를 갖습니다. 저자들은 광고를 넘어선 이야기 생성 가능성을 강조합니다. 별도의 미래 연구 목록이나 한계 절은 제시하지 않으므로 새로운 과제를 저자의 결론처럼 덧붙이지 않습니다. 원문은 이후 References를 거쳐 부록으로 이어집니다. 참고문헌은 인용 계보를 확인하는 범위에서 읽었으며, 개별 인용 논문을 모두 독립 분석한 것은 아닙니다. §6
📖 Chapter A: Appendix Overview
부록 A는 후속 자료의 안내입니다. B·C는 정성 결과와 일반 과제 평가, D·E는 데이터와 비교 조건, F·G는 탐색 효율과 창작 지침, H는 실제 수정 사례, I–L은 평가 프롬프트를 담당합니다. 이 배열은 결과를 먼저 살핀 뒤 그 결과를 만든 데이터·제어·평가를 재구성하도록 돕습니다. 부록 A
📖 Chapter B: Qualitative Results on GenAd-Bench
Figure 3은 네 시나리오의 대본과 키프레임을 함께 제시합니다. 기능적 설명이나 안전에 대한 심리적 메시지가 어떻게 장면 지시로 바뀌는지 보여 주며, 시점과 환경 변화에도 제품·인물의 정체성을 유지한다는 저자 해석을 뒷받침하는 사례입니다.
Figure 4는 열 개의 추가 시나리오입니다. 시럽의 소박한 분위기나 곰 인형의 부드러운 조명 같은 전형적 맥락과, 도서관의 베개·첨단 작업 공간의 접착제처럼 관습에서 벗어난 맥락을 대비합니다. 이 자료는 선택된 사례의 시각적 설명으로 읽으며 전체 400개 성공률로 환산하지 않습니다. 다음 부록은 광고 밖에서도 동일한 제어가 작동하는지 평가합니다. 부록 B, Figures 3–4
📖 Chapter C: Evaluation on General Video Storytelling
먼저 기존 벤치마크와 종단 간 제작의 차이를 설명합니다. ViStoryBench-Lite는 샷별 대본·인물 참조를 입력받고 정적 이미지를 출력하므로, 여기서는 대본 생성과 영상 합성을 제외합니다. 키프레임 에이전트, 국소 수정, MAB 제어만 남겨 평가합니다. 이는 광고가 아닌 이야기에 대한 핵심 이미지 제어 구성의 이전 가능성을 검사합니다.
Table 5에서 Co-Director의 스타일 일관성 Cross/Self는 0.499/0.743, 인물 일관성 Cross/Self는 0.499/0.593입니다. Cross/Self의 세부 정의는 인용 벤치마크에 의존하므로 이 리뷰는 원문의 표 항목명과 값을 보존합니다. 프롬프트 정합성 평균은 3.166으로 비교 방법 중 가장 높습니다. 다만 원문이 인물 Self도 최고라고 서술하는 부분은 표와 일치하지 않습니다. 표의 MMStoryAgent는 0.598이며 Co-Director 0.593보다 높고, AniMaker도 0.593입니다. 이 리뷰는 표 수치를 우선합니다.
품질·다양성의 Inception Score는 10.900으로 MovieAgent 12.044보다 낮으며, 장면에 등장하는 인물 수의 일치도인 OCCM은 66.215로 Vlogger 79.145보다 낮습니다. 저자들은 다양성을 보상하는 평가와 장면 일관성 사이의 긴장, 배경 인물 추가를 벌점 처리하는 인물 수 평가를 그 이유로 해석합니다. 이러한 해석은 지표가 측정하는 축의 차이를 설명하지만, 낮은 항목의 결과 자체를 없애지는 않습니다.
마지막 Figure 5·6은 인물·배경을 유지한 이미지열을 보여 주며, 저자들은 손의 좌우 혼동 같은 해부학적 오류가 남을 수 있음을 명시합니다. 여기서 확인한 실패 사례를 영상 전반의 임의 한계 목록으로 확대하지 않습니다. 다음 부록은 주 벤치마크의 생성과 분포를 세부화합니다. 부록 C, Table 5
📖 Chapter D: GenAd-Bench Details
D.1 Dataset Construction Pipeline. 브랜드·제품 텍스트 생성, 같은 제품에 대한 두 고객층 시나리오 생성, 로고와 로고 조건부 제품 이미지 생성, 사람 검수 순서입니다. 로고를 먼저 검수·교정한 뒤 제품 참조 이미지를 만들고, 로고 통합 오류·논리 오류·기존 제품과 지나치게 유사한 디자인을 바로잡기 위해 제품 참조의 약 15%를 재생성합니다. 단순 무작위 이미지 묶음이 아니라 텍스트와 시각 자산의 관계를 검수한 입력이라는 점이 중요합니다.
D.2 Taxonomy and Distribution Statistics. 제품은 24개 대분류에 속합니다. Home Goods 24개, Food·Fashion·Tech 각 20개 등 빈도가 높은 영역과 Automotive 8개, Logistics·Baby 각 4개 같은 영역을 함께 담습니다. 반사 금속, 투명 액체, 의류 등 서로 다른 시각 특성을 요구합니다.
다음 소주제인 인구·지리 분포에서는 Male/Female 목표를 각각 200개로 맞추고 동일 제품의 짝에서 목표 성별을 바꿉니다. 연령은 18–24, 25–34, 35–50, 50+의 네 구간이며 원문의 구간 표기를 그대로 따릅니다. 지역은 183개 고유 위치, 여섯 대륙권을 포함하되 유럽 158개·아시아 108개에 집중됩니다. 따라서 지리적 다양성과 대륙별 동일 비율을 같은 뜻으로 쓰지 않습니다. 성별 균형 또한 이 벤치마크가 채택한 두 범주의 설계에 대한 설명입니다.
D.3 Dataset Split. 200개 hillclimbing 시나리오는 시스템 조정용이며 보고 평가에서 제외합니다. 검증 200개 중 160개는 익숙한 대분류에 속한 40개 브랜드·80개 제품이고, 40개는 조정 집합에 없는 산업의 5개 브랜드·20개 제품입니다. 전체 검증은 45개 브랜드를 포함합니다. 이 분할은 알려진 산업 안의 새 자산과 새로운 산업을 구분해 평가하려는 설계입니다. 다음 부록은 비교 시스템에 어떤 입력과 모델을 제공했는지 명확히 합니다. 부록 D, Figures 7–8
📖 Chapter E: Baseline Implementation Details
Monolithic and Commercial Platforms. 단일 모델·상용 플랫폼에는 여섯 항목의 광고 조건과 마지막 1초를 로고 강조 장면으로 남기라는 공통 제로샷 지침을 줍니다. 여기서 제로샷은 작업별 예시를 제시하지 않고 지시하는 조건입니다. 논문은 이 비교 방법들이 텍스트 프롬프트에서 오디오를 생성한다고 설명합니다.
Multi-Agent Frameworks. AniMaker·MovieAgent용 Script Generator는 Gemini 3 Pro로 서사 흐름, 장면별 시각 프롬프트, 내레이션, 정확한 샷 길이를 JSON으로 만듭니다. 총 길이는 12초이며 영상에 Veo 3.1, 음성에 Gemini 2.5 Pro TTS를 사용합니다. 이는 에이전트 구조 비교에서 기반 모델 차이를 줄이는 통제입니다. 다음 부록은 전체 영상 재생성이라는 비싼 평가를 왜 적은 횟수로 수행하는지 설명합니다. 부록 E
📖 Chapter F: Extended Discussion on MAB Optimization Efficiency
이 부록은 목표를 무한한 시간에서의 밴딧 수렴이 아닌 제한된 영상 생성 예산에서의 표본 효율로 좁힙니다. 36개 창작 조합을 전부 실행하면 프롬프트 하나당 36개의 제작 파이프라인이 필요합니다. 이에 비해 축별 보상은 한 번 실행으로 세 축의 선택지 기대값을 동시에 갱신하고, warm start는 제품·고객 맥락에 맞는 시작점을 제공합니다.
저자들은 4회 예산이 실험에서 효과적인 설정에 빠르게 도달하기에 충분했다고 설명합니다. 여기서 ‘10개 독립 매개변수’는 세 축의 범주 수 합계를 뜻합니다. 모든 조합의 상호작용을 완전히 식별했다는 결과로 해석하지 않습니다. 본문에 실행 시간·달러 비용의 측정 표가 없으므로 효율성을 비용 절감률로 새로 계산하지 않습니다. 다음 부록은 추상적인 창작 조합이 실제 지침으로 바뀌는 사례를 제공합니다. 부록 F
📖 Chapter G: Creative Direction Examples
G.1 Horizontal Directing through Hierarchical Parameterization. Table 6은 오사카의 여성 고객층을 위한 Foo-Family 차량 광고의 세 반복을 보여 줍니다. 첫 조합은 Informational·Vignette·Clarity/Energy로, 차량의 문·공간·안전 기능을 밝고 빠른 일상 장면에 배치합니다. 두 번째는 Transformational·Analytical·Cinematic Premium으로, 접근성·보호·공동체를 논증하면서 명암 대비와 느린 카메라로 차분한 신뢰감을 만듭니다. 세 번째는 Comparative·Narrative Drama·Minimalist Focus로, 좁은 공간의 일반 차량과 슬라이딩 도어를 대비하는 갈등·해결 서사를 정밀한 질감과 작은 움직임으로 표현합니다.
핵심은 대본 지시만 바꾸는 것이 아니라 키프레임의 조명·의복·색상, 영상의 움직임·편집·음향까지 함께 바꾼다는 점입니다. ‘변형적 전략’과 ‘논증형 서사’도 동시에 선택될 수 있어, 세 축이 동일한 스타일 이름의 반복이 아니라 구별된 제어 변수임을 보여 줍니다.
G.2 Visual Realization via Aesthetic Archetypes. Figure 9는 구두와 반려견 사료의 두 사례를 네 미학 유형으로 보여 줍니다. Clarity/Energy는 밝고 선명한 인지, Cinematic Premium은 명암과 고급스러움, Minimalist Focus는 배경을 줄이고 재질에 집중하는 표현, Kinetic Grit은 어둡고 거친 현장감을 강조합니다. 저자들은 이런 분위기 변화 속에서도 참조 제품의 구조·로고를 유지한다고 설명합니다. 다음 부록은 방향 변경과 별개로 실제 오류를 고치는 과정을 보여 줍니다. 부록 G, Table 6·Figure 9
📖 Chapter H: Local Optimization via Agentic Self-Refinement
H.1 Storyline Self-Refinement. AlphaFoo-Desk는 이름과 달리 책상이 아니라 컴퓨터 섀시, 즉 처리 부품을 담는 케이스입니다. 초기 대본은 이를 높이를 조절하는 전동 책상으로 해석했습니다. 비평 에이전트는 제품 범주의 불일치를 지적하고, 다음 대본은 구형 컴퓨터 케이스가 영상 렌더링을 완료하는 장면으로 수정합니다. 제품의 이름보다 기능 정의를 근거로 오류를 교정한 사례입니다.
H.2 Keyframe Self-Refinement. 대본이 맞더라도 이미지에서는 머리색·연령과 장소가 바뀔 수 있습니다. Figure 10의 초기 프레임은 인물이 바뀌고 작업 공간도 차고·실험실·회사 사무실처럼 달라집니다. 판정자는 장면들을 함께 비교하여 문제를 지적하고, 수정 결과는 같은 인물과 차고 작업실을 중심으로 이어집니다. 부록 H, Figure 10
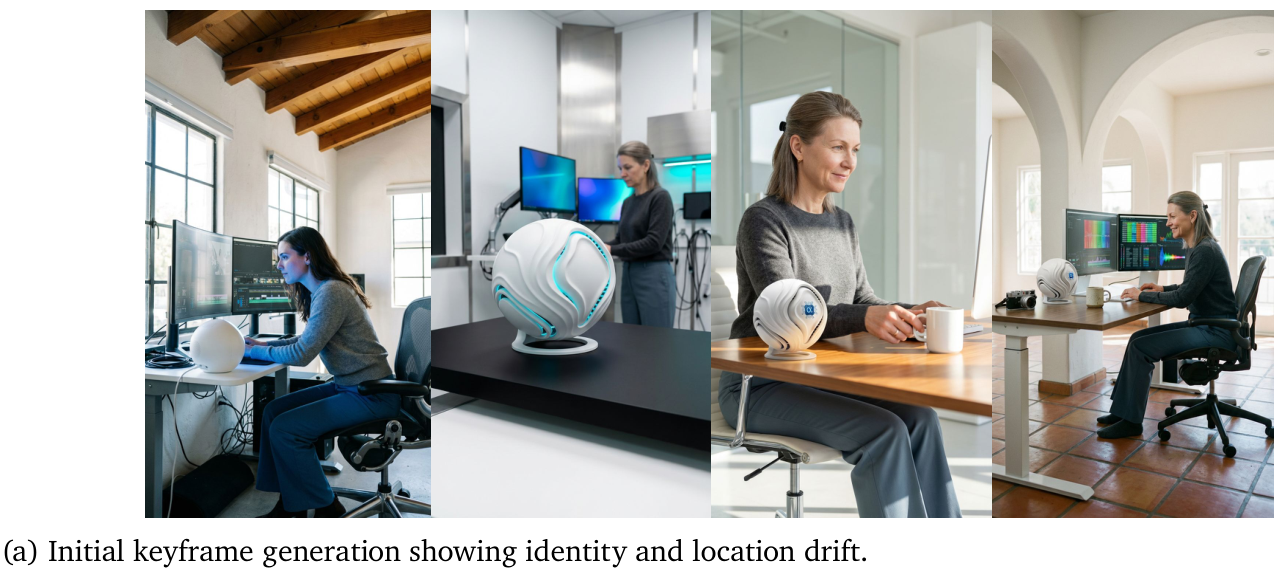
Figure 10(a), PDF 30쪽 크롭·번역 없음. 원문 패널 표시를 보존했습니다. 원문.
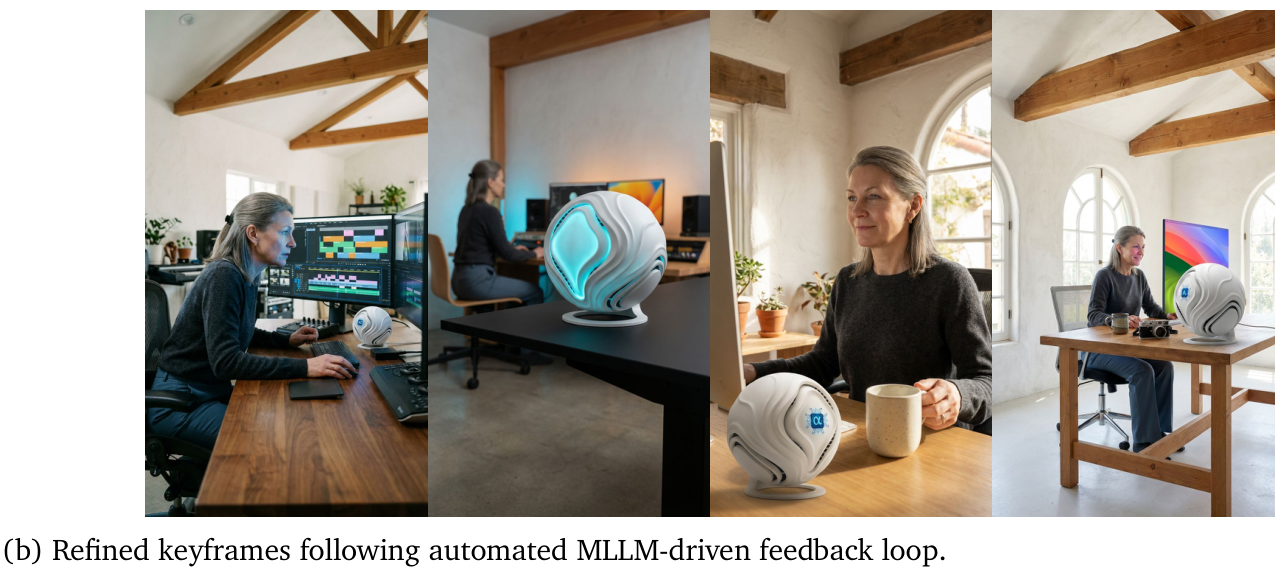
Figure 10(b), PDF 30쪽 크롭·번역 없음. 원문의 피드백 전문은 두 이미지 사이에서 제외하고 위 문단에 내용을 풀었습니다. 원문.
이 사례의 핵심은 한 프레임의 미학 점수를 올리는 것보다 장면 간 관계를 검사한다는 데 있습니다. 다음 세 부록은 이러한 수정과 전역 탐색에 사용하는 판정 지침을 공개합니다.
📖 Chapter I: Storyline Evaluation Prompt
대본 평가는 도입부 주목도, 서사 구조·연결, 제품 통합, 정서적 관여, 입력 준수의 다섯 항목을 각각 0–20점으로 매깁니다. 첫 1–2초에 관심을 끄는지, 오디오 없이도 이야기를 이해할 수 있는지, 제품이 갈등 해결에 필수적인지 같은 판단 기준을 지정합니다.
출력은 항목별 점수, 총점, 비평, 다음 대본 생성기에 전달할 직접적인 수정 명령을 포함한 JSON입니다. 점수만 반환하지 않고 실패 이유와 수정 행동을 연결한다는 점이 국소 수정의 작동 조건입니다. 다음 부록은 같은 원리를 시각적 장면열에 적용합니다. 부록 I
📖 Chapter J: Keyframe Evaluation Prompt
입력은 원래 프롬프트, 인물·제품 참조 이미지, 네 장면 이미지입니다. 먼저 시각적 일관성·연결을 검사하고, 서사의 흐름, 제품의 매력·통합, 정서적 효과, 입력 준수를 평가합니다. 인물 얼굴·제품 색상과 형태뿐 아니라 배경과 조명의 연결까지 함께 보도록 지시합니다. 대본 문제인지 이미지 실행 문제인지 원인을 구별하도록 요구하는 점도 중요합니다.
출력 예시는 총점·수정 지침과 함께 원인 단계 및 MAB 효과 점수 필드도 포함합니다. 다만 설명 문단의 다섯 항목명과 JSON breakdown의 필드명은 완전히 일치하지 않습니다. 이 리뷰는 부록을 실행 가능한 구현과 동일하다고 단정하지 않고, §3.2가 규정한 키프레임 수정과 §3.3의 최종 영상 보상 역할을 기준으로 설명합니다. 다음 부록은 최종 영상에서 그 보상을 어떻게 정의하는지 보여 줍니다. 부록 J
📖 Chapter K: Final Video Evaluation Prompt
최종 판정에는 영상·원래 요청뿐 아니라 구조화된 제약, 주석화한 참조 이미지, 선택한 창작 변수, 이론적 정의, 스토리보드를 제공합니다. 첫 평가는 일관성, 시각 품질, 관여도, 입력 준수, 논리·물리적 일관성의 다섯 항목입니다. 각 0–20점을 합해 완성 영상 선택에 쓰는 0–100 점수를 만듭니다. 물리적 일관성에는 중력·관성, 물체를 용도에 맞게 다루는지, 형태가 유지되는지 등이 포함됩니다.
두 번째 평가는 창작 전략·서사 방식·미학 유형 각각의 선택 효과입니다. 단순 지시 충실도가 아니라 그 선택이 가치 전달과 정서적 연결에 도움이 되었는지 묻습니다. 동시에 프롬프트는 전략 점수가 실행 점수와 방향상 일치해야 한다고 명시합니다. 따라서 본문의 ‘실행과 전략을 분리한다’는 말은 출력 목적을 나눈다는 뜻이지, 보상 신호가 결과 품질에서 완전히 독립한다는 뜻은 아닙니다.
마지막으로 문제 시점·프레임에 근거한 피드백, 주요 책임 단계, 행동 가능한 지침을 JSON으로 반환합니다. 이것이 종합 점수와 축별 보상을 구별하는 가장 구체적인 근거입니다. 다음 부록은 시스템 내부 평가가 아닌 공개 벤치마크 채점 지침입니다. 부록 K
📖 Chapter L: GenAd-Bench Evaluation System Prompts
이 부록은 로고 이미지, 제품 이미지, 여섯 항목 조건, 최종 영상을 받아 VAF·DA·MA·VQ를 평가합니다. 각 차원의 짧은 근거를 먼저 작성하고 정수 점수를 뒤에 출력하도록 합니다. 80–100, 60–79, 40–59, 20–39, 0–19의 다섯 구간으로 품질 수준을 보정합니다.
원문 순서대로 보면 VAF는 제품의 정체성과 질감뿐 아니라 자연스러운 빛의 강조인 product bloom과 로고의 전략적 등장 시점도 중시합니다. DA는 대상의 속성뿐 아니라 도시·지역의 구체적 조명·건축·생활 분위기를 요구합니다. MA는 제품이 이야기의 해결책으로 등장하고 실제로 작동하는 동적 시연을 선호합니다. VQ는 생성 안정성과 함께 주변 환경에 맞는 영화적 조명·반사·그림자의 통합을 평가합니다.
그러므로 VAF를 단순 이미지 유사도, VQ를 오직 물리 오류 검출 점수로 바꾸어 읽으면 평가 의도를 놓칩니다. 예를 들어 평평한 스튜디오 조명이나 정적인 제품 나열은 이 평가에서 낮아질 수 있습니다. 이는 원문에 명시된 채점 선호이며 리뷰어가 새로 제안한 한계가 아닙니다. 부록 L까지 읽으면 방법의 수정 기준과 최종 비교 점수의 정의가 어떻게 다른지 완결해서 이해할 수 있습니다. 부록 L
실험 결과 심층 분석
다음은 Table 1을 직접 대조한 전체 비교값입니다. 네 지표는 모두 0–100이며 평균은 원문 보고값을 그대로 옮겼습니다. 검증 집합은 200개 시나리오입니다. Table 1·부록 D.3
| 방법 | VAF | DA | MA | VQ | 평균 |
|---|---|---|---|---|---|
| Creatify | 23.2 | 16.2 | 19.5 | 29.5 | 22.1 |
| HeyGen | 42.9 | 59.3 | 39.5 | 45.0 | 46.7 |
| Kling 3.0 Omni | 62.0 | 70.3 | 56.0 | 45.3 | 58.4 |
| Veo 3.1 | 60.0 | 80.8 | 63.2 | 50.5 | 63.6 |
| Wan 2.6 | 67.0 | 71.5 | 62.5 | 58.9 | 65.0 |
| LTX-2.3 | 23.5 | 56.0 | 30.6 | 24.4 | 33.6 |
| AniMaker | 53.1 | 81.3 | 60.3 | 53.9 | 62.2 |
| MovieAgent | 61.2 | 81.3 | 66.4 | 52.4 | 65.3 |
| Base Agentic Pipeline, 1회 | 68.5 | 78.4 | 67.1 | 59.9 | 68.5 |
| Random Search, 4회 | 77.0 | 85.8 | 75.6 | 64.1 | 75.7 |
| Co-Director, 4회 | 82.1 | 91.4 | 82.0 | 70.2 | 81.4 |
같은 4회 예산의 무작위 탐색 대비 차이는 평균 5.7점입니다. 차원별로는 VAF 5.1, DA 5.6, MA 6.4, VQ 6.1점입니다. 이 비교는 단순히 더 많이 생성한 효과와 방향성 있는 탐색을 구분하는 데 가장 직접적입니다. 다만 warm start와 MAB를 합친 구성이므로 5.7점 전체를 UCB1만의 효과라고 부르지 않습니다.
Table 4는 그 구성요소를 더 나눕니다. 아래 평균과 차이는 이 제거 실험 안에서만 비교합니다.
| 제거 실험 구성 | 평균 | 전체 구성 대비 감소 |
|---|---|---|
| 전체 구성 | 79.0 | — |
| Cold Start | 77.3 | 1.7 |
| Scalar Reward | 76.4 | 2.6 |
| 대본 수정 제외 | 74.0 | 5.0 |
| 키프레임 수정 제외 | 71.5 | 7.5 |
| 두 국소 수정 제외, MAB 유지 | 69.4 | 9.6 |
| 국소 수정 유지, MAB 없음 | 68.2 | 10.8 |
| 모든 수정·전역 최적화 제외 | 67.2 | 11.8 |
이 패턴은 제품·인물의 시각적 일관성을 중간 단계에서 검사하는 기능과 전체 방향 탐색이 서로 다른 역할을 수행함을 뒷받침합니다. Table 1과 Table 4의 완전 구성 평균이 다른 이유를 설명하는 세부 표본·실행 조건은 원문에서 명확하게 확인되지 않아 두 표를 합산한 추가 효과량은 계산하지 않았습니다.
사람 평가의 평균 3.96 대 3.71은 자동 평가와 순위 방향이 일치함을 보여 줍니다. 그러나 50개 시나리오의 사람 평가와 200개 검증 시나리오의 자동 평가를 같은 표본으로 취급하지 않습니다. 논문에는 성능 차이의 유의성 검정이나 수치 신뢰구간이 보고되지 않았습니다. Figure 2의 음영도 구체적 통계 정의가 확인되지 않으므로 신뢰구간이라고 부르지 않았습니다. 관찰된 점수 차이와 통계적 유의성은 구별해야 합니다.
재현성 측면에서는 모델 구성, 길이, 전역·국소 반복 예산, 데이터 분할, 평가 프롬프트가 제공됩니다. 반면 원문만으로는 UCB 초기값과 국소 임계값의 구체적 수치 등을 모두 복원할 수 없습니다. 이는 확인 가능한 명세의 범위이며, 이 리뷰는 코드를 실행하거나 생성 영상을 다시 평가해 보고값을 독립 재현하지 않았습니다.
기술적 함의와 응용
Co-Director에서 배울 수 있는 설계 원리는 중간 결과의 수정과 전체 의도의 탐색을 분리하면서 연결하는 것입니다. 제품 범주를 잘못 이해한 대본은 국소 피드백으로 고칠 수 있지만, 광고가 정보 중심이어야 할지 경험 중심이어야 할지는 다른 수준의 선택입니다. 공유된 창작 변수를 단계별 지침으로 번역하는 구조가 이 두 문제를 하나의 시스템에서 다룹니다.
리뷰어의 해석으로는, 이 구조는 여러 생성 도구를 연결하는 작업에서 어떤 상태를 공유하고 어디에서 판정할지를 생각하는 구체적 사례입니다. 응용 범위에 대한 원문 근거는 12초 광고 제작과 ViStoryBench-Lite의 정적 장면열 실험이며, 일반 장편 영상이나 실제 매출 개선까지 검증한 것으로 확대하지 않습니다. 저자들이 강조하는 영상 제작의 일관성은 단일 생성 모델의 능력뿐 아니라 계획, 참조 자산, 수정 지점, 탐색 보상의 결합으로 이해할 수 있습니다.
분석 범위는 v1의 본문 1–6과 부록 A–L 전체입니다. 부록의 긴 프롬프트·사례 대본은 역할과 판단 기준을 설명하는 방식으로 다뤘으며 전문을 재인쇄하지 않았습니다. 외부 참고문헌 전수 검토, 공개 코드 실행, 보충 영상 전체의 재생 평가, 실제 광고 성과 검증은 수행하지 않았습니다.