논문 개요와 전체 구조
Agensh는 중앙 관리자가 작업을 배정하지 않아도 다수의 언어모델 에이전트가 공동 소프트웨어를 구축할 수 있는지를 연구한 조직 수준의 실행 환경입니다. 여기서 하네스(harness)는 모델 호출, 도구 실행, 상태 유지와 작업 반복을 연결하는 주변 시스템을 뜻합니다. Agensh는 개별 에이전트의 하네스 위에 협업 절차와 공용 서비스를 더합니다. 연구의 초점은 모델의 가중치를 개선하는 학습법보다, 동일한 모델을 사용하는 작업자 수를 늘렸을 때 조직 전체의 결과와 완료 속도가 어떻게 달라지는지에 있습니다. 논문 v1
Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia, Furu Wei가 작성한 이 논문은 ProgramBench의 가장 어려운 다섯 과제를 사용합니다. 에이전트들은 인터넷 없이 참조 실행 파일의 동작을 관찰하고, 이를 재현하는 코드베이스를 처음부터 만듭니다. GPT-5.6-sol의 high 추론 설정과 Copilot 하네스, 6시간의 공통 마감 아래 작업자 수를 1명에서 128명으로 늘리면 다섯 과제 평균 최종 테스트 통과율이 19.31%에서 28.78%로 상승합니다. 1,024명 확장 실험은 pandoc 한 과제에서 수행되며 최종 통과율은 55.06%입니다. 두 실험의 범위를 구분해서 읽어야 합니다. §3 및 부록 C
원문의 구조는 다음과 같습니다. 이 리뷰는 본문 1–5절과 부록 A–C의 순서를 유지하며, 참고문헌은 관련 연구의 위치를 설명하는 범위에서 다룹니다.
| 순서 | 원문 제목과 내부 구성 |
|---|---|
| 1 | Introduction |
| 2 | Multi-Agent Organization Harness — 2.1 Multi-Agent Cooperation Loop, 2.2 Agentic Organization Infrastructure(Shared workspace, Message interface, Shared context), 2.3 Implementation |
| 3 | Scaling Multi-Agent Organization to 1,024 Agents — 3.1 Main Results, 3.2 Self-Organized Cooperation Emerges at Scale(8, 32, 128, 1,024 agents) |
| 4 | Related Work — Multi-agent organization and cooperation harnesses; Shared context and decentralized coordination |
| 5 | Conclusion |
| 참고문헌 | References |
| A | Worker Prompt |
| B | Implementation Details — B.1 Event-Driven Runtime, B.2 Shared Context Delivery |
| C | Experiment Details — Task selection, Agent configuration, Experiment setup, Large-scale deployment, Single-agent baseline |
핵심 기여와 혁신성
복잡한 작업에서 하나의 에이전트는 하나의 문맥 창과 순차적인 행동 흐름에 제약됩니다. 여러 작업자를 두면 병렬 실행이 가능하지만, 작업 분해와 통합을 모두 중앙 관리자에게 맡길 경우 관리자의 조정 능력이 조직의 확장성을 제한할 수 있다는 것이 저자의 문제 설정입니다. Agensh에서는 작업자들이 같은 목표를 읽고, 자신의 하위 과제를 발견하고, 담당 범위를 알리고, 검증한 변경을 통합합니다. 작업 배정과 통합의 판단이 동료들 사이에서 이루어집니다. §1–2
기여는 반복 가능한 협업 절차와 그 절차가 의존하는 상태 저장 구조를 결합했다는 점에 있습니다. Git 기반 작업 공간은 코드와 변경 이력을, 메시지 인터페이스는 협의와 긴급 연락을, 공유 문맥은 관찰·실패·담당 범위·패치 근거를 보존합니다. 작업자는 이 구조를 이용하여 타인의 결과를 다음 행동의 입력으로 삼습니다. 중앙 오케스트레이터가 없다는 주장은 조직 운영을 결정하는 모델 역할에 관한 것입니다. Gitea, Mattermost, 공유 문맥 서비스와 이벤트 라우터 같은 공통 인프라는 존재합니다.
실험적 기여는 고정된 시간 안에서 작업자 수를 늘리는 확장을 관찰했다는 점입니다. 다섯 과제 평균의 향상과 pandoc의 1,024명 실험, 그리고 규모에 따라 달라지는 협업 사례가 함께 제시됩니다. 리뷰어의 관점에서는 이를 모델 성능과 조직 운영을 분리해 생각할 수 있게 하는 연구로 읽을 수 있습니다. 다만 저자가 제시한 ‘일반 지능의 경계 확장’이라는 해석을 평가 결과와 동일시해서는 안 됩니다. 실제 측정된 것은 지정된 소프트웨어 재구성 과제의 테스트 통과율과 시간별 추이입니다. §3, §5
기술적 세부사항
방법의 중심은 문맥 수집 → 하위 과제 담당 선언 → 실행 → 검증 → 통합의 반복입니다. 모든 작업자는 같은 협업 지침을 받으며 작업자 ID만 달라집니다. 이 반복 절차는 런타임이 강제하는 단계별 프로그램보다 프롬프트에 담긴 작업 규약으로 구현됩니다. 반면 이벤트 전달, 재시도, 세션 복구는 런타임이 처리합니다. 따라서 ‘무엇을 할지 결정하는 모델의 규약’과 ‘새 정보가 도착하도록 보장하는 시스템의 기능’을 구분하는 것이 구조를 이해하는 데 중요합니다. §2.3, 부록 B
| 구성 | 저장하거나 전달하는 것 | 협업에서의 의미 |
|---|---|---|
| 공유 작업 공간 | 개인 브랜치, 통합된 main, 이슈와 PR, 변경 이력 | 각자 개발한 기여를 공동 산출물로 축적합니다. |
| 메시지 인터페이스 | 공용 채널, 직접 메시지, 대화 이력 | 중복 담당과 의존성을 협의하며 긴급 충돌을 알립니다. |
| 공유 문맥 | OBSERVED, FACT, FAIL, CLAIM, PATCH_SUMMARY | 발견과 실패를 재사용하고 현재의 작업 의도를 공개합니다. |
| 이벤트 런타임 | 큐, 고유 이벤트 ID, 전달 상태, 지속 세션 | 비동기 작업자가 활동을 이어가도록 연결합니다. |
논문에는 학습 목적함수나 최적화 알고리즘을 정의하는 번호식이 없습니다. 수학적 정리로 확장성을 도출하기보다 실행 구조와 실험을 통해 주장을 전개합니다. 부록 C의 시간 정의에서 첫 작업자의 활성화 시각을 $t$라고 하면 공통 종료 시각은 $T=t+6\,\mathrm{h}$입니다. 종료 45분 전에는 새 기능보다 빌드와 통합에 집중하라는 안내를, 5분 전에는 준비된 작업을 병합하고 최종 실행 상태를 확인하라는 안내를 보냅니다. 이 정의는 모든 작업자가 시작한 뒤 각각 6시간을 받는다는 뜻이 아닙니다. 부록 C
평가 지표는 ProgramBench 공식 평가의 canonical-kept pass rate입니다. 이 리뷰에서는 이를 원문이 보고한 테스트 통과율로 표기합니다. 기준 실행 파일과 같은 입력에 대한 동작을 재현하는 정도를 측정하며, 원본 소스의 복원율이나 구현 코드의 유사도를 뜻하지 않습니다. 논문은 canonical-kept라는 평가 변형의 명칭을 제시하지만 필터링 규칙을 다시 상세히 정의하지 않습니다. 다섯 과제 평균은 서로 다른 과제의 통과율을 평균한 값이며, 전체 테스트를 하나로 합친 통과 비율이라고 바꾸어 해석하지 않습니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
도입부는 단일 에이전트의 순차적 실행에서 출발합니다. 모델이 문맥을 읽고 도구를 호출하며 상태를 갱신하는 능력이 있더라도, 하나의 행동 흐름으로 대규모 작업을 수행하면 긴 시간이 필요합니다. 저자들은 이 문제에 대한 자연스러운 대응으로 다중 에이전트의 병렬 실행을 제시한 뒤, 병렬 작업자만 추가하는 구조에서 중앙 관리자가 담당하는 계획·분해·배정·통합의 부담을 지적합니다. 이는 개별 모델의 추론 능력과 별개로 조직 구조를 설계해야 한다는 동기입니다. §1
이어서 Agensh의 해결책을 두 층으로 소개합니다. 첫 번째는 개인의 작업을 공동 기여로 전환하는 협업 반복 절차이고, 두 번째는 진행 중인 작업과 메시지, 발견을 모든 작업자가 접근할 수 있도록 보존하는 인프라입니다. 작업자는 이미 통합된 변경과 동료의 발견을 읽어 자신의 다음 과제를 결정합니다. 구현이 끝나면 검증 근거와 함께 병합하므로 이후 작업자가 그 결과를 기반으로 이어갈 수 있습니다. 비동기라는 말은 모든 동료가 한 단계를 끝낼 때까지 기다리는 전역 장벽 없이 각자 다음 순환을 진행한다는 뜻입니다.
도입부의 실험 예고는 결과의 두 측면을 구분합니다. 하나는 6시간 종료 시점의 최종 품질이며, 다른 하나는 같은 수준에 도달하는 시간입니다. 저자는 여기에 작업 이력에서 관찰한 협업 양식의 변화도 연결합니다. 이 장의 핵심 기여는 에이전트 수를 단순한 복제 수가 아니라 지속적으로 협업하는 조직의 규모로 정의한 것입니다. 다음 장에서는 그 조직이 실제로 어떤 정보와 절차를 공유하는지 구체화합니다.
📖 Chapter 2: Multi-Agent Organization Harness
2.1 Multi-Agent Cooperation Loop
첫 단계인 문맥 수집에서는 공통 목표, 현재 상태, 동료 진행 상황과 메시지, 축적된 발견을 확인합니다. 환경에 직접 질의하여 아직 수행할 가치가 있는 일을 찾는 것도 포함됩니다. 두 번째 단계에서 작업자는 스스로 하위 과제를 제안하고 공유 문맥에 CLAIM을 추가합니다. 이는 ‘내가 이 범위를 맡고 있다’는 공개 선언입니다. 다른 작업자와 범위가 겹칠 때는 직접 메시지로 조정하도록 안내합니다. 원문은 이를 원자적 잠금 획득 알고리즘으로 정의하지 않습니다. §2.1
세 번째 단계는 도구를 이용한 실제 수행입니다. 작업자는 로컬에서 코드를 만들면서 동료에게 도움이 될 발견을 중간에도 공유합니다. 네 번째 단계에서는 하위 과제의 수용 기준, 즉 완료로 인정할 조건과 결과를 대조하고 부족하면 수정합니다. 다섯 번째 단계에서는 기여를 공동 작업 공간에 병합하고, 무엇이 바뀌었는지와 구현 아이디어, 검증 근거를 공개합니다. 병합 충돌이 생기면 최신 동료 변경을 반영한 뒤 다시 해결하고 통합합니다.
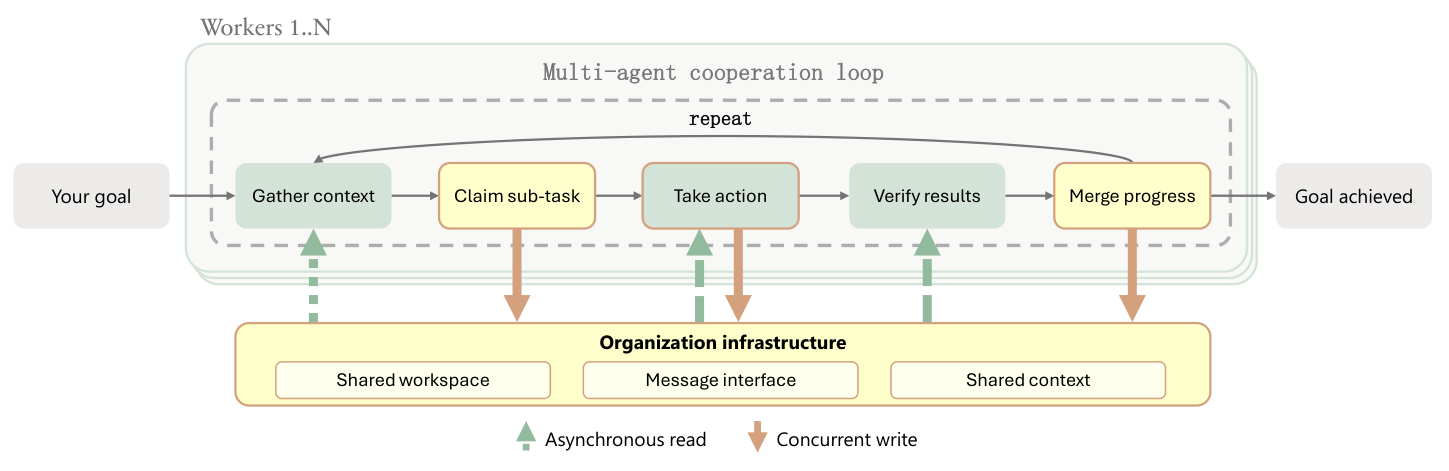
Figure 3, PDF 3쪽. 고정 버전 원문에서 그림 영역만 크롭했으며 번역·재배열·수치 변경은 없습니다.
그림의 아래쪽 인프라는 반복 절차의 한 단계에서만 사용되는 저장소가 아닙니다. 문맥을 수집할 때 읽고, 담당 범위와 실행 결과를 알릴 때 쓰며, 검증과 통합 이후의 결과가 다음 순환에 다시 입력됩니다. 리뷰어의 해석으로는 이 되먹임이 각 작업자의 국소적 성공을 조직 전체의 진전으로 바꾸는 핵심 연결입니다. 역할 분담은 미리 완성된 작업 목록을 중앙에서 분배하는 방식보다, 누적된 현재 상태에 반응하여 계속 갱신됩니다.
2.2 Agentic Organization Infrastructure
Shared workspace. 저자는 동시 쓰기와 비동기 읽기, 버전 이력 보존, 기여 병합, 충돌 노출을 작업 공간의 요구사항으로 제시합니다. 실제 구현에서는 Git 플랫폼을 사용하며, 작업자들은 개인 체크아웃과 브랜치에서 수정하고 main에 통합합니다. Git은 변경의 출처를 기록하고 텍스트 병합 충돌을 탐지합니다. 이슈와 PR은 제안된 일과 코드 기여를 표현합니다. 따라서 ‘공유’는 모든 작업자가 동일한 파일을 아무 구분 없이 동시에 편집한다는 의미와 다릅니다. §2.2
Message interface. 공용 작업 채널은 조직 전체의 공지를 운반하고 직접 메시지는 긴급한 일대일 조정을 담당합니다. 공용 채널의 낮은 우선순위 메시지는 반복의 시작에 전달되며, 직접 메시지는 인프라 도구 호출이 끝날 때 전달됩니다. 대화 이력과 비동기 전달이 있어 한 작업자가 담당 범위의 중복을 협의하거나 도움을 청하더라도 나머지 작업자들은 자신의 일을 계속할 수 있습니다. 이 구분은 조직 전체가 읽어야 할 공지와 당장 특정 동료에게 알려야 할 충돌의 전달 경로를 달리합니다.
Shared context. DeLM의 아이디어를 받아들인 공유 문맥에는 의미 유형이 있는 짧은 항목을 쌓습니다. OBSERVED는 관찰한 동작, FACT는 확인한 사실, FAIL은 실패한 접근, CLAIM은 현재 작업 범위, PATCH_SUMMARY는 완료된 변경 요약입니다. 추가 전용(append-only) 데이터베이스이므로 과거 항목을 대체하는 대신 새 항목이 이력에 누적됩니다. 최근 문맥 바깥의 기록은 검색 도구로 찾습니다. 새 항목은 높은 우선순위의 갱신으로 취급하여 다른 작업자의 다음 인프라 도구 응답에 함께 전달합니다.
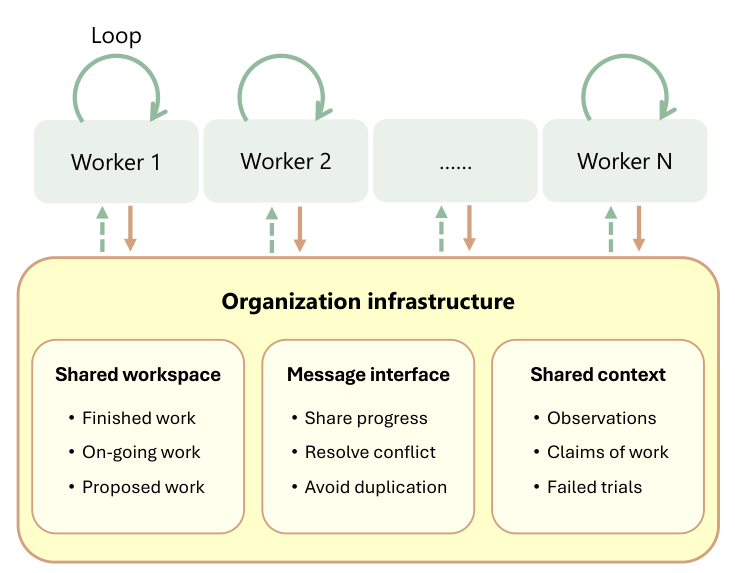
Figure 4, PDF 4쪽. 고정 버전 원문의 그림 영역을 크롭했으며 번역하지 않았습니다.
세 서비스는 동일한 내용을 중복 저장하는 장치로 제시되지 않습니다. 작업 공간에는 실제 산출물이, 메시지에는 조정 과정이, 공유 문맥에는 재사용할 지식과 의도가 남습니다. 예를 들어 어떤 입력에서 참조 프로그램이 예상과 다르게 동작했다는 발견은 아직 코드 패치가 없어도 다른 작업자의 탐색을 바꿀 수 있습니다. 이런 정보가 코드 병합까지 기다리지 않고 전달될 수 있다는 것이 세 경로를 함께 사용하는 의미입니다.
2.3 Implementation
Agensh는 단일 에이전트 하네스를 대체하지 않습니다. 대화 상태, 모델 호출, 도구 실행, 다음 응답의 생성은 하위 하네스가 담당합니다. Agensh는 작업자 식별, 협업 규약, 이벤트 라우팅, 전달, 공용 서비스 접근, 복구와 활동 유지를 둘러싼 기능을 제공합니다. 조직 수준의 반복은 각 작업자의 프롬프트에 들어 있으며, 부록 A에는 실제 지침을 공개합니다. §2.3
이 경계를 작게 유지하여 하네스별 어댑터로 Claude Code나 Copilot 등을 연결할 수 있도록 설계했습니다. 본 논문의 보고 실험은 Copilot을 사용합니다. 공유 작업 공간에는 Gitea, 메시지에는 Mattermost를 사용하고, 공유 문맥은 DeLM의 핵심 발상에 도구 형식과 작업자 지침을 조정했습니다. 이 장은 조직 구조를 설명하고, 다음 장은 같은 모델과 하네스를 유지한 채 조직 규모를 늘렸을 때의 결과를 검증합니다.
📖 Chapter 3: Scaling Multi-Agent Organization to 1,024 Agents
이 장은 먼저 과제의 의미와 규모를 정합니다. ProgramBench에서는 주어진 참조 소프트웨어의 동작을 처음부터 재현해야 하며 인터넷 접근이 차단됩니다. 다섯 과제는 200개 인스턴스 가운데 최첨단 모델들의 평균 테스트 통과율을 기준으로 가장 어려운 것들로 선정했습니다. 분야는 멀티미디어 처리, 분자 시뮬레이션, 문서 변환, 언어 해석, 코드 색인으로 나뉩니다. 아래 표는 재구성 대상의 복잡도를 설명하는 참조 저장소의 크기이며 에이전트에게 원본 소스를 제공했다는 뜻이 아닙니다. §3, Table 1
| 과제 | 참조 커밋 | 파일 수 | 코드 줄 수 | 코드 크기(MB) |
|---|---|---|---|---|
| FFmpeg | 360a402 |
10,090 | 1,549,005 | 75.51 |
| gromacs | 665ea4c |
8,982 | 815,539 | 47.30 |
| pandoc | 5caad90 |
2,767 | 104,336 | 4.86 |
| PHP-src | c891263 |
26,266 | 2,812,757 | 119.76 |
| ctags | 243595e |
7,313 | 246,228 | 9.15 |
원문 Table 1, PDF 6쪽의 값을 대조하여 옮겼습니다. 커밋은 원문에 제시된 축약 표기입니다.
3.1 Main Results
모든 구성은 GPT-5.6-sol(high), Copilot, 6시간 예산을 사용합니다. 작업자가 1, 8, 32, 128명일 때 다섯 과제 평균 최종 통과율은 각각 19.31%, 20.68%, 26.52%, 28.78%입니다. 1명에서 128명으로 늘렸을 때 차이는 9.47퍼센트포인트이며, 시작 값에 대한 상대 증가는 약 49%입니다. ‘49퍼센트포인트 증가’로 읽으면 결과를 크게 과장하게 됩니다. §3.1
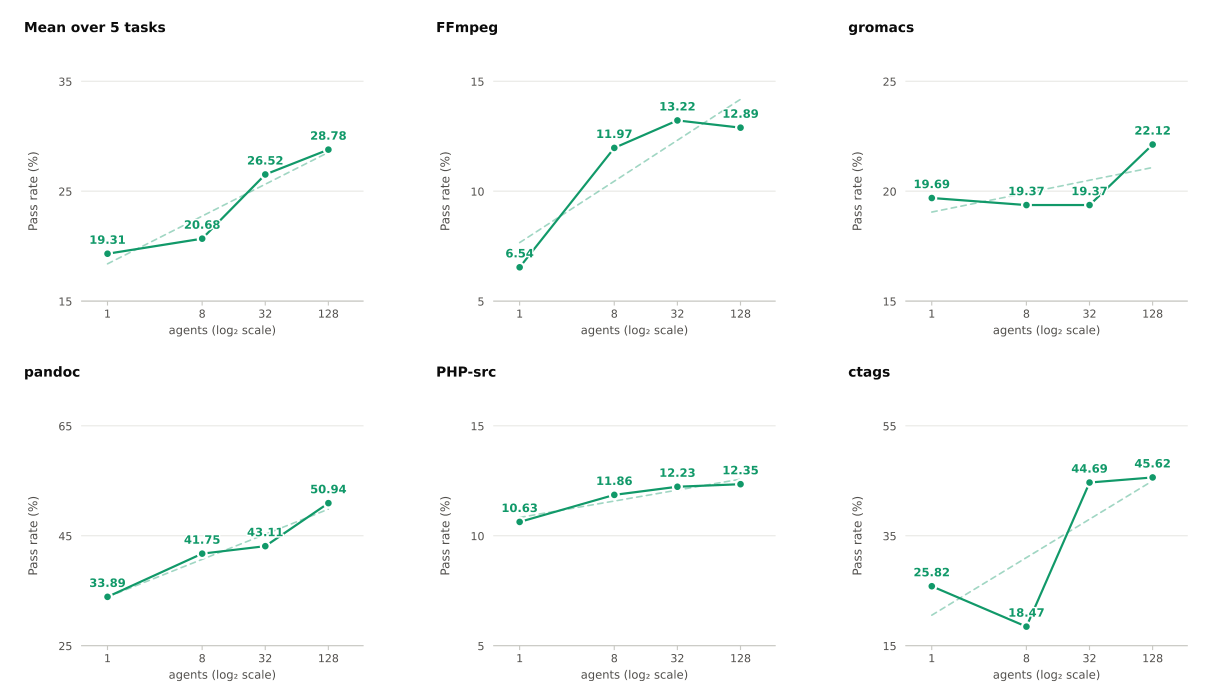
Figure 5, PDF 5쪽. 고정 버전 원문에서 여섯 패널을 함께 크롭했습니다. 축·범례·수치를 보존했으며 번역하지 않았습니다. 작은 수치를 읽을 수 있도록 아래에 원문 대조 표를 제공합니다.
| 과제 / 최종 통과율(%) | 1명 | 8명 | 32명 | 128명 |
|---|---|---|---|---|
| 다섯 과제 평균 | 19.31 | 20.68 | 26.52 | 28.78 |
| FFmpeg | 6.54 | 11.97 | 13.22 | 12.89 |
| gromacs | 19.69 | 19.37 | 19.37 | 22.12 |
| pandoc | 33.89 | 41.75 | 43.11 | 50.94 |
| PHP-src | 10.63 | 11.86 | 12.23 | 12.35 |
| ctags | 25.82 | 18.47 | 44.69 | 45.62 |
평균은 모든 확장 단계에서 증가하지만 각 과제가 모두 단조 증가하는 것은 아닙니다. ctags는 1명에서 8명으로 갈 때 하락하고, FFmpeg는 32명에서 128명으로 갈 때 소폭 낮아집니다. gromacs도 8명과 32명 결과가 단일 작업자보다 낮습니다. 원문의 ‘전반적인 증가 추세’는 이러한 개별 측정값을 포함하는 표현으로 읽는 것이 정확합니다. 원문은 이 하락들의 구체적인 원인을 분석하지 않으므로 조정 비용이나 충돌 때문이라고 단정하지 않습니다.
이어서 Figure 6은 같은 실행의 첫 2시간을 비교합니다. pandoc의 30% 통과율을 예로 들면 128명 구성은 30분 체크포인트, 32명은 60분, 8명은 90분에서 처음 기준을 넘습니다. 단일 작업자는 첫 2시간 내내 30% 미만입니다. 이는 정해진 관측 시점에서의 도달 결과이며, 실제로 임계치를 통과한 정확한 순간을 초 단위로 측정했다는 뜻은 아닙니다.
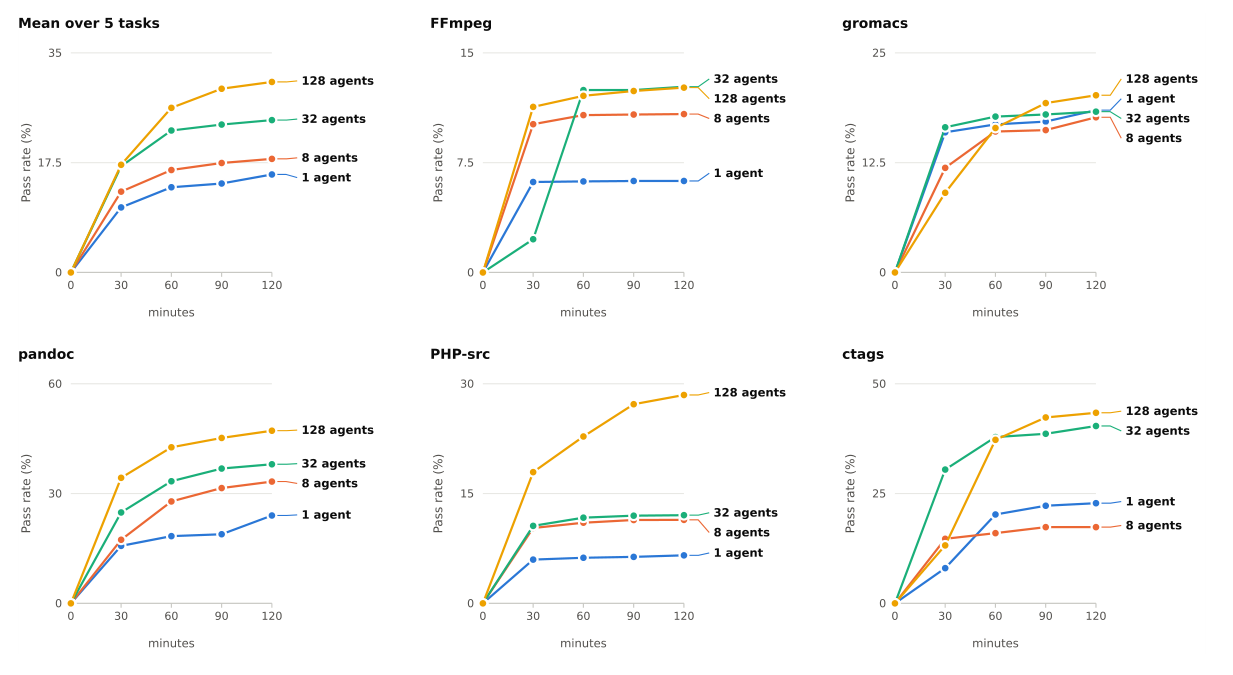
Figure 6, PDF 7쪽. 고정 버전 원문에서 그림 전체를 크롭했으며 축과 패널 배치를 보존했습니다. 번역하지 않았습니다.
마지막으로 pandoc를 1,024명까지 확장합니다. 단일 작업자 33.89%, 128명 50.94%, 1,024명 55.06%이므로 1,024명은 128명 대비 4.12퍼센트포인트, 단일 작업자 대비 21.17퍼센트포인트 높습니다. 이 실험은 천 명 이상의 협업 실행 가능성과 이 과제에서의 최종 결과 향상을 뒷받침합니다. 나머지 네 과제에 대해 1,024명 결과가 보고되었다고 확대 해석하지 않습니다.
3.2 Self-Organized Cooperation Emerges at Scale
8 agents: coordinating implementation with peers. 저자는 수치 이후 작업 이력을 살펴봅니다. gromacs에서는 작업자들이 모듈 인터페이스를 공지하고 그 규격에 맞는 명령 모듈을 각자 구현했습니다. FFmpeg에서는 담당 범위가 겹친 두 작업자가 논의한 뒤 한쪽이 범위를 바꾸어 보완적인 작업을 맡았습니다. 여기서 관찰한 협력은 사전 역할표의 실행보다 공통 인터페이스와 소유 범위를 동료끼리 조정하는 행동입니다. §3.2
32 agents: managing integration across multiple workers. PHP-src의 사례에서는 여러 동료가 기여를 승인한 뒤 다른 작업자가 구체적인 반례를 발견했습니다. 기존 승인은 철회되었고 작성자가 문제를 고친 뒤 다시 검토를 받아 동료가 병합했습니다. 승인을 한 번 받았다는 상태보다 새로운 검증 증거를 우선하여 의사결정을 수정한 사례입니다. 저자는 이 규모에서 통합 관리가 더 적극적이 되고 의사소통에 참여하는 동료의 범위도 넓어진다고 서술합니다.
128 agents: self-organized specialization and workflow standardization. 작업자들은 관련 경험에 따라 검토자를 선택하고 그 관계를 반복적으로 사용했습니다. 다른 동료에게 통합 책임을 넘기면 해당 동료가 충돌을 해결하고 결합된 결과를 검증하여 병합하는 형태도 나타났습니다. 이는 구현과 통합의 책임을 매번 동일한 사람이 맡아야 한다는 구조에서 벗어나는 관찰입니다.
pandoc에서는 처음에 작성자가 브랜치를 갱신하고 테스트한 다음 커밋 해시를 보내 동료가 검증·병합하는 절차를 합의했습니다. 다른 작업자들도 이 절차를 재사용했습니다. 이후 일부 실패를 거쳐 동료에게 갱신, 테스트, 확인, 병합의 전체 순환을 수행할 권한을 주는 방식으로 규약을 수정했고, 동료들이 이를 명시적으로 수용하여 새 PR에 적용했습니다. 논문은 실패의 세부 원인이나 빈도를 정량화하지 않으며, 이 사례를 절차가 협의를 통해 형성되고 개정된다는 근거로 사용합니다.
1,024 agents: role specialization at organization scale. pandoc에서는 여러 작업자가 통합 담당 역할을 맡았습니다. 작성자가 여러 후보에게 연락하고, 먼저 유효하게 응답한 통합 담당자를 선택하고, 다른 요청을 취소한 뒤 코드를 넘길 수 있었습니다. 동일한 기술 분야를 전문적으로 다루는 동료가 다른 작업자의 실패한 시도를 이어받는 모습도 관찰했습니다. 저자는 이런 역할 중복이 특정 개인에 대한 의존을 줄여 조직의 견고함을 강화한다고 해석합니다.
이 장의 협업 사례는 구현 조정, 공동 검토와 통합, 절차의 표준화, 여러 전문 역할의 공존으로 범위가 넓어집니다. 다만 이 서술은 공개된 대표 실행 이력에 대한 정성적 관찰입니다. 모든 작업자가 항상 같은 조직 형태로 수렴한다는 분포 분석이나 각 역할이 점수 상승을 얼마나 일으켰는지 분해하는 인과 실험으로 제시되지는 않습니다. 이 장의 핵심은 성능 변화와 실제 협업 양식의 관찰을 함께 보여준 것이며, 다음 장은 이런 구조가 기존 연구와 어디에서 이어지고 달라지는지 정리합니다.
📖 Chapter 4: Related Work
Multi-agent organization and cooperation harnesses. 원문은 Claude Code의 리드 세션 중심 팀 구성, Codex의 부모에게 결과를 반환하는 하위 작업자, Kimi Agent Swarm의 학습된 오케스트레이터를 비교 축으로 삼습니다. 이 설명은 논문이 인용한 시점의 관련 연구 정리입니다. Agensh에서 강조하는 차이는 과제 발견, 의존성 조정, 결과 통합의 책임을 지속적인 작업 순환에 참여하는 동료들에게 분산한다는 점입니다. 본문에는 이들 제품과 동일 조건으로 성능을 비교한 실험표가 없으므로 상대 제품보다 성능이 우수하다는 결과로 읽지 않습니다. §4
Shared context and decentralized coordination. DeLM은 비동기 작업자, 작업 큐, 공유 문맥을 결합하여 중앙 컨트롤러를 거치지 않고 진전을 활용하는 선행 연구로 소개됩니다. ChatCollab과 SlackAgents는 의사소통 공간 안에서 역할과 요청을 조정하는 접근입니다. Carlini의 컴파일러 구축 사례는 16개 에이전트가 Git과 과제 잠금 파일을 이용해 과제를 고르고 변경을 병합한 작업으로 연결됩니다. STORM은 공유 작업 공간의 상태 일관성과 오래되거나 충돌하는 편집의 탐지에 초점을 둡니다.
따라서 Agensh의 기여를 분산 협업 자체의 최초 제안으로 표현할 필요는 없습니다. 원문은 관련 아이디어를 명시적으로 인정하면서 협업 반복, 공용 서비스, 1,024명까지의 조직 실험을 묶습니다. 이 장은 새 시스템의 위치를 정리하고, 결론에서 설계와 관측 결과를 다시 연결할 준비를 합니다. 여기 언급한 참고문헌의 원문을 모두 별도로 검토한 것은 아닙니다.
📖 Chapter 5: Conclusion
결론은 과제 발견과 담당 선언, 발견의 교환, 기여 통합을 작업자들이 병렬·비동기로 수행한다는 설계를 다시 묶습니다. 저자는 중앙 관리자가 작업을 배정하고 작업자들을 관리하지 않아도 공유 작업 공간·메시지·문맥을 통해 개인의 진전이 공동 작업과 지식으로 쌓인다고 정리합니다. §5
실험 결과로는 다섯 과제 평균의 약 49% 상대 개선, 동일 수준에 더 일찍 도달하는 시간 추이, pandoc 1,024명 결과와 협업의 전문화를 다시 제시합니다. 결론의 핵심은 에이전트 수를 조직 수준의 확장 축으로 볼 수 있다는 저자의 주장입니다. 원문은 별도의 한계 및 향후 연구 절을 두지 않으므로 이 리뷰에서도 저자가 말하지 않은 한계 목록을 덧붙이지 않습니다. 이어지는 참고문헌 뒤에는 실제 작업자 지침과 실행·평가 조건을 보충하는 부록이 배치됩니다.
📖 Chapter A: Worker Prompt
부록 A는 1,024명 구성의 한 작업자에게 전달한 프롬프트를 제시합니다. 나머지 작업자는 ID만 달라집니다. 시작 부분은 Gitea의 이슈에 과제가 있으며 자신이 맡는 영역의 이슈와 PR을 생성한다는 작업 환경을 안내합니다. 내부 컨테이너에서 접근 가능한 Gitea 주소와 외부 URL의 차이, Mattermost의 정확한 작업자 핸들 형식도 명시합니다. 이는 추상적 협업 규칙뿐 아니라 실제 서비스 접근에서 발생할 수 있는 혼선을 줄이는 실행 지침입니다. 부록 A
다음으로 공유 문맥의 작성 규칙을 구체화합니다. 일반 항목은 100자, PATCH_SUMMARY는 300자로 제한하고 긴 내용은 detail에 넣어 board_unfold로 펼칩니다. board_read는 최근 2,000개 항목으로 잘린 최근 보드를 반환하고, board_grep는 전체 이력에서 키워드를 찾습니다. 검색은 대소문자를 구분하지 않으며 쉼표는 OR, &는 AND입니다. 이미 확인된 사실을 다시 유도하거나 실패로 기록된 접근을 반복하지 말라는 지침도 들어 있습니다. 짧은 항목의 즉시 전달과 필요한 세부 내용의 선택적 접근을 결합한 구조입니다.
팀 설명은 작업자들이 동등하며 무엇을 만들지, 어떻게 구현하고 병합할지, 다음에 무엇을 할지를 스스로 결정한다고 규정합니다. 구현 중에는 독립적으로 진행하되 병합 전에 최신 main을 동기화합니다. 모든 정보가 동료의 작업에 큰 영향을 주는 것은 아니므로 조정 도구는 타인의 작업에 의미 있게 영향을 줄 때 사용하라고 안내합니다. 이는 도구가 있다는 사실과 지속적으로 메시지를 보내야 한다는 의무를 구분하는 부분입니다.
과제의 목표는 /opt/pbench/executable에 마운트된 사전 컴파일 실행 파일을 관찰하여 같은 동작의 코드베이스를 만드는 것입니다. 바이너리는 실행할 수 있지만 바이트를 읽거나 디컴파일할 수 없도록 권한과 규칙이 설정됩니다. 참조 동작을 알아내는 정보원은 실행 관찰과 저장소의 문서·자산입니다. 원본 소스의 외부 획득이나 원격 패키지 설치는 차단되며, 이미 설치된 도구 체인을 사용합니다.
완료 조건은 특히 구체적입니다. 저장소 루트의 실행 가능한 compile.sh가 루트에 executable을 생성해야 합니다. 평가자는 저장소 HEAD를 새로 풀고 커밋된 실행 파일을 제거한 뒤 빌드 스크립트를 실행합니다. 따라서 작업자의 컨테이너에만 존재하는 바이너리가 정상 작동한다는 사실은 제출 조건을 만족하지 않습니다. 첫 행동 역시 아직 이해하지 못한 영역을 참조 프로그램으로 관찰하는 것입니다.
이벤트 설명 다음의 작업 순환에서는 참조 관찰, CLAIM, 현재 main을 바탕으로 한 구현, 동일 입력에 대한 참조와 자체 빌드 비교, PR과 병합, PATCH_SUMMARY를 차례로 요구합니다. 참조 실행 시 메모리 상한을 설정하는 구체적인 셸 지침도 포함됩니다. 평가 실행 위치가 저장소 루트와 다를 수 있으므로 필요한 데이터 경로는 실행 파일의 실제 위치를 기준으로 해석하라고 명시합니다. 이 부록의 기여는 본문의 협업 원칙을 재현 가능한 작업 규약 수준으로 내려놓은 데 있습니다. 다음 부록은 이 지침을 실행하는 작업자에게 이벤트가 어떻게 도달하는지 설명합니다.
📖 Chapter B: Implementation Details
B.1 Event-Driven Runtime
각 작업자는 중앙에서 정해 준 단계 일정 대신 이벤트에 의해 구동됩니다. 작업자와 짝을 이루는 라우터가 Gitea 저장소 활동과 Mattermost 메시지를 듣습니다. Gitea에서는 서버 전송 이벤트를 계기로 마지막 처리 지점보다 새로운 알림을 가져옵니다. Mattermost는 실시간 연결로 메시지를 받고 재연결 시 놓친 메시지를 보충합니다. 리스너는 새 활동을 영속 큐에 기록하고 디스패처를 깨웁니다. 이벤트의 고유 식별자는 중복 처리 방지에 사용합니다. 부록 B.1
디스패처는 대기 이벤트의 순서를 정하고 다음 프롬프트에 합쳐 지속 세션으로 보냅니다. 턴이 완료되면 전송 상태를 기록합니다. 일반적으로 턴 도중 새로 도착한 이벤트는 다음 턴을 기다리며, 전달이 실패하면 대기 시간을 늘려 재시도합니다. 라우터가 재시작되면 미완료 이벤트를 큐로 돌리고 가능한 경우 이전 세션을 복원합니다. 이런 기능은 개별 작업자의 협업 판단과 별도로 정보의 유실과 실행 중단을 관리합니다.
활동 유지 장치도 있습니다. 작업자가 10분 동안 유휴 상태이면 작업을 계속하라는 프롬프트를 보냅니다. 완료한 턴에서 공유 문맥 항목을 남기지 않았다면 유용한 발견을 게시하라는 후속 안내를 보냅니다. 이 구조에서 ‘자기 조직화’는 아무런 실행 지원도 없는 상태를 뜻하지 않습니다. 과제 판단은 동료에게 맡기되, 이벤트와 작업 지속을 지원하는 런타임 규칙이 존재합니다.
B.2 Shared Context Delivery
정보 전달에는 두 경로가 있습니다. 새 턴의 시작에는 대기 중인 작업 공간 알림, 메시지, 최근 공유 문맥을 프롬프트에 붙입니다. 진행 중인 턴에서는 인프라 도구 호출을 감싼 래퍼가 대기 중인 직접 메시지와 새 공유 문맥을 도구 반환값에 덧붙입니다. 부록 B.2
따라서 원문의 ‘턴 도중 전달’은 모델의 임의 실행이나 모든 운영체제 프로세스를 강제로 중단하는 기능이 아닙니다. 명시적으로 MCP 도구 반환 시점에서 작동합니다. MCP는 외부 도구를 연결하는 인터페이스이며, 여기서는 작업자가 기다리던 도구 응답과 함께 새 동료 정보가 들어오는 통로입니다. 이 구분은 긴 작업의 중간에 정보가 언제 반영될 수 있는지 이해하는 데 중요합니다. 부록 B는 추상적인 비동기 협업을 실제 큐와 전달 경로로 설명하고, 마지막 부록은 평가 조건을 확정합니다.
📖 Chapter C: Experiment Details
Task selection. 다섯 과제의 선정 기준은 ProgramBench 공식 확장 결과에 있는 최첨단 모델들의 평균 통과율입니다. 가장 어려운 과제를 택했다는 의미는 이 기준 안에서의 순위이며, 모든 소프트웨어 개발 업무 중 보편적으로 가장 어렵다는 주장과 다릅니다. 부록 C
Agent configuration. 모든 보고 구성은 같은 GPT-5.6-sol(high), 같은 하네스, 작업자 프로토콜, 평가 설정을 사용합니다. Copilot의 최대 입력 토큰 한도는 272,000, 최대 출력 토큰 한도는 128,000입니다. 이 수치는 최대 길이 설정이며 실제 실행 전체의 토큰 소비량을 뜻하지 않습니다.
Experiment setup. ProgramBench 방식으로 컨테이너를 준비하고 총 시간 예산을 6시간으로 두며 공식 평가를 실행합니다. 결과는 canonical-kept 통과율입니다. 원문의 프롬프트와 평가 설정은 어떤 목표와 제약을 주었는지 이해하는 근거가 되지만, 이 리뷰에서 해당 대규모 실행을 독립적으로 재현한 것은 아닙니다.
Large-scale deployment. 담당 범위의 경합을 줄이기 위해 모든 실험에서 작업자 활성화 시점을 엇갈리게 합니다. 첫 1시간에는 30초마다 한 명, 그 이후에는 3초마다 한 명씩 시작합니다. 최초 작업자의 활성화 시각을 기준으로 6시간이 지나면 모든 작업자를 종료하고 제출물을 내보냅니다. 따라서 ‘128명 구성’이나 ‘1,024명 구성’의 초기 체크포인트가 그 인원 전부의 동일한 활동 시간을 누적한 결과는 아닙니다. 시간 곡선은 이 순차 활성화 정책을 포함한 조직 구성의 결과입니다.
종료 45분 전 안내는 새 기능을 시작하는 일을 멈추고 루트 빌드와 기존 작업의 병합을 확인하도록 요구합니다. 병합할 수 없는 PR은 그 사실을 알리고 넘어가게 합니다. 5분 전에는 준비된 변경을 병합하고 멈추며 기본 브랜치에서 빌드와 실행이 가능한지 확인하게 합니다. 1,024명 실험은 16개 노드에 노드당 64명을 분산 배치했습니다. 이 값은 배포 규모의 설명이며 총 연산량을 고정한 비교를 뜻하지 않습니다.
Single-agent baseline. 저자들은 단일 에이전트 실행이 실제로 6시간 전체 동안 작업을 지속하기 어렵다는 점을 설명하며, 단일 작업자 기준선에 종료 훅(stop hook)을 추가합니다. 이전 계획의 범위에 갇히지 말고 참조 실행 파일에 아직 시험하지 않은 입력을 넣어 새 과제를 찾으라는 지침입니다. 다중 에이전트 구성에는 10분 유휴 감지 후 비슷한 지속 작업 안내를 보냅니다. 기준선은 처음 응답을 끝내자마자 종료되는 단순 일회성 호출이 아니며, 제한 시간을 활용하도록 보조하는 구성이 포함됩니다. 이 부록은 결과를 해석할 때 필요한 실행 조건을 마지막으로 보완합니다.
실험 결과 심층 분석
이 논문이 직접 지지하는 결과는 같은 모델과 공통 마감 시간 아래 조직 규모를 늘렸을 때 평균 통과율이 높아지고, 일부 수준에 더 이르게 도달했다는 것입니다. 19.31%에서 28.78%로의 변화는 9.47퍼센트포인트이자 약 49% 상대 개선입니다. 반면 128명에서 1,024명으로 확장한 pandoc의 추가 향상은 4.12퍼센트포인트입니다. 서로 다른 분모와 비교 범위를 가진 결과를 한 가지 배율로 합쳐 말하지 않아야 합니다. §3.1
과제별 표는 효과의 이질성을 보여줍니다. pandoc와 ctags의 최종 개선 폭은 PHP-src보다 크며, ctags는 8명에서 하락한 뒤 32명에서 크게 높아집니다. 다섯 과제 평균만 보면 보이지 않는 형태입니다. 또한 Figure 6은 첫 2시간을, Figure 5는 6시간 최종 시점을 보고하므로 중간 점수를 최종 점수와 섞지 않습니다. 이 연구를 운영 관점에서 읽을 때는 ‘얼마나 오래 기다릴 수 있는가’와 ‘어떤 수준의 결과가 필요한가’를 함께 보는 것이 유용하다는 해석이 가능합니다.
동일한 6시간은 동일한 총 연산량이나 비용을 뜻하지 않습니다. 작업자 수와 분산 노드가 늘어나며 활성화도 시간에 걸쳐 진행됩니다. 원문은 모든 구성에 대한 누적 토큰 사용량, 비용, 계산량을 정규화한 표를 보고하지 않습니다. 따라서 동일 비용 대비 효율이나 선형 속도 향상을 이 실험으로 계산하지 않습니다. 이는 논문이 제시한 비교 조건의 범위를 명확히 하는 것이며, 저자가 주장하지 않은 비용 결론을 덧붙이지 않기 위한 구분입니다.
반복 실행 수, 신뢰구간, 유의성 검정 결과는 논문에 보고되지 않았습니다. 표시된 차이는 관측 성능 차이로 기술하며 통계적으로 유의하다고 부르지 않습니다. 공유 문맥·메시지·Git 중 하나를 제거한 실험(ablation study)이나 중앙 오케스트레이터와의 동일 조건 직접 비교도 보고되지 않습니다. 그러므로 전체 구성의 관측 결과와 특정 구성요소의 독립 효과를 구별합니다. 협업 사례 역시 전문화의 모습을 설명하지만 그 빈도나 점수 기여를 정량화한 결과는 아닙니다.
재현 자료로는 부록의 작업자 프롬프트, 이벤트 전달 방식, 모델·하네스 설정과 배포 조건이 제공됩니다. 논문은 프로젝트와 코드 저장소 링크를 제시합니다. 이 리뷰의 분석 대상은 arXiv v1 본문과 PDF이며, 저장소의 현재 코드를 별도로 검증하거나 논문 실험을 재실행했다고 주장하지 않습니다.
기술적 함의와 응용
저자의 핵심 주장은 작업자 수가 다중 에이전트 조직의 확장 축이 될 수 있다는 것입니다. 이때 에이전트 증가는 동시에 더 많은 출력을 생성하는 것에 그치지 않습니다. 다른 작업자의 사실과 실패를 읽고, 작업 범위를 조정하며, 누군가의 결과를 다시 검증하여 공동 산출물로 통합하는 과정이 포함됩니다. 논문이 보고한 자기 조직화는 이런 구체적인 행동으로 이해할 수 있습니다. §5
리뷰어의 해석으로는 Agensh가 소프트웨어 에이전트 설계에 주는 학습 가치는 정보의 종류와 도착 시점, 기여의 통합 절차를 함께 설계해야 한다는 점입니다. 코드 저장소만으로 관찰과 실패의 재사용이 자동으로 해결되는 것은 아니며, 대화 채널만으로 검증된 실행 결과가 보존되는 것도 아닙니다. 이 논문은 산출물, 조정 대화, 재사용할 발견을 서로 연결하는 실행 구조를 구체적으로 보여줍니다.
원문이 제시하는 응용 맥락은 마감 시간이나 지연 제약이 강한 복잡한 작업입니다. 실제 결과는 인터넷이 차단된 참조 소프트웨어 재구성에서 얻었으므로 다른 산업 업무에도 같은 수치의 향상이 생긴다고 일반화하지 않습니다. 관측된 성능과 조직화 사례를 함께 보면, 이 연구의 의의는 더 많은 작업자가 공통 상태 위에서 지속적으로 기여할 수 있는 구조를 만들고 그 확장 가능성을 시험했다는 데 있습니다.