논문 개요와 전체 구조
Transformer의 attention은 query와 key로 어느 위치를 얼마나 참고할지 정하고, value를 가중합하여 다음 표현을 만듭니다. Jiale Kang의 Memory Attention(MA)은 이 가운데 value를 만드는 독립적인 선형 변환을 제거합니다. 대신 현재 문맥을 반영하는 key와 토큰 ID로 조회한 학습 가능한 메모리를 더합니다. 같은 토큰이라도 층마다 다른 메모리를 가지며, 문맥에 따라 달라지는 부분은 key가 담당합니다. 이 리뷰는 2026년 9월 23일 제출된 arXiv:2609.28399v1 원문을 기준으로 작성했습니다.
이 설계의 연구 질문은 메모리를 추가해 표현력을 높이는 데서 한 걸음 더 나아갑니다. 추가한 메모리가 기존 연산의 일부를 대체할 수 있는가를 묻습니다. MA는 더 많은 파라미터를 사용하면서 value 구성의 산술 연산을 줄이고, MA-Offload는 메모리 테이블을 CPU에 배치합니다. 실험에서는 동일한 학습 토큰 예산에서 언어 모델링과 평균 정확도가 개선되지만, 전체 파라미터 수까지 맞춘 비교는 아닙니다. MA-Recall은 과거 value를 재구성해 캐시를 줄이는 분석적 확장이며, 보고된 추론 지연 실험에는 포함되지 않습니다. 원문 §1, §3–4
원문은 별도 결론 장 없이 네 본문 장과 부록으로 구성됩니다. 아래 순서대로 상세히 살펴봅니다.
| 원문 순서 | 제목과 내부 전개 |
|---|---|
| 1 | Introduction |
| 2 | Background — Self-Attention → Value Embeddings → Per-Layer Embeddings → Engram |
| 3.1 | Memory-Based Value Construction |
| 3.2 | Connection to MLA through Attention Aggregation |
| 3.3 | Computation and Parameter Storage — Parameter capacity → Training computation → Inference computation |
| 3.4 | MA-Offload |
| 3.5 | MA-Recall: An Extension for Value Reconstruction |
| 4.1 | Experimental Setup — Training configurations → Evaluation benchmarks |
| 4.2 | Language Modeling — Retrieval and Context-Length Extrapolation |
| 4.3 | Training and Inference Efficiency — Training efficiency → Inference configurations → Measurement scope → Value-construction overhead → GPU parameter storage → Transfer overhead and overlap → Implementation scope |
| References | 본문이 참조하는 선행 문헌 목록 |
| Appendix A | Pretraining Settings — Data and optimization → Backbone and attention configurations → Memory configuration |
핵심 기여와 혁신성
언어 모델의 용량을 늘리면 보통 연산과 GPU 저장 비용도 증가합니다. 토큰별로 학습한 벡터를 조회하는 방법은 모든 파라미터를 매번 조밀한 행렬 곱에 참여시키지 않고 용량을 늘리는 접근입니다. 원문이 대비하는 Value Embeddings는 기존 value projection에 토큰 표현을 더하고, PLE와 Engram은 별도의 경로에서 메모리를 주입합니다. MA는 기존 key를 재사용해 value projection 자체를 대체한다는 점을 강조합니다. 원문 §2–3.1
기여는 표현 설계와 실행 방식에 걸쳐 있습니다. 첫째, 문맥 의존 key와 층별 토큰 메모리의 합으로 value를 구성합니다. 둘째, 추론 전에 정규화를 테이블에 반영하여 온라인 연산을 조회와 덧셈으로 줄입니다. 셋째, 조회 주소가 토큰 ID와 층 번호만으로 결정된다는 성질을 이용해 CPU 조회·전송을 미리 시작합니다. 별도의 MA-Recall 분석은 같은 표현에서 캐시 저장과 재구성 비용의 교환 관계를 도출합니다.
리뷰어 관점에서 이 논문의 학습 가치는 파라미터 용량, 산술 연산량, 파라미터가 상주하는 장치, 실행 지연을 분리해서 사고하게 한다는 점에 있습니다. 다만 품질 향상을 구조 변화만의 효과로 해석해서는 안 됩니다. 저자 역시 메모리 파라미터 증가와 구조의 기여를 이 실험만으로 분리할 수 없다고 명시합니다. 원문 §4.2
기술적 세부사항
표기를 먼저 정리하면 뒤의 비용 분석을 따라가기 쉽습니다. 여기서 메모리는 학습으로 갱신하는 파라미터 테이블이며, 외부 문서를 검색하는 데이터베이스를 뜻하지 않습니다. KV cache는 생성 과정에서 과거 토큰의 key와 value를 저장하는 실행 중 상태이므로 파라미터 테이블과 구분해야 합니다.
| 기호·용어 | 의미 |
|---|---|
| $N$, $d$ | 어휘 수, 모델의 hidden dimension |
| $H_{\mathrm{KV}}$, $d_h$ | KV head 수, head 하나의 차원 |
| $d_v=H_{\mathrm{KV}}d_h$ | 모든 KV head를 합친 key 또는 value 차원 |
| $L$, $B$, $T$ | MA로 교체한 층 수, batch size, 시퀀스·과거 문맥 길이 |
| $S$ | 새로 처리하는 토큰 수. prefill은 $BT$, 한 decoding step은 $B$ |
| $\mathbf E$, $\mathbf M$ | 학습 가능한 테이블, 조회 후 head별 정규화된 메모리 |
| Prefill / decoding | 입력 문맥을 한꺼번에 처리하는 단계 / 과거 캐시를 이용해 새 토큰을 처리하는 단계 |
| Perplexity(PPL) | 정답 토큰에 부여한 확률로 계산하는 언어 모델 지표. 낮을수록 좋습니다. |
전체 알고리즘은 토큰 ID로 각 층의 메모리를 조회하고, KV head별 RMSNorm을 적용한 뒤, RoPE 이전 key에 더하는 순서입니다. RMSNorm은 벡터의 제곱평균제곱근을 이용한 크기 정규화이며, RoPE는 위치에 따라 query와 key를 회전시키는 위치 표현입니다. attention 점수는 회전된 query/key로 계산하고, value는 회전 전 key를 사용합니다. 이후 attention의 가중치 계산 및 가중합 규칙은 유지됩니다. 원문 식 (7)–(9)
평가는 크게 품질, 검색, 효율의 세 축입니다. 품질은 zero-shot, 즉 과제별 예시를 제공하지 않는 설정에서 평가하고, 평균은 정확도 지표 일곱 개의 단순 평균입니다. 검색은 긴 입력 안에 삽입된 정보를 찾는 single-needle NIAH 세 과제이며, 효율은 목표 손실까지의 토큰 수와 특정 하드웨어에서의 forward-pass 지연으로 나누어 측정합니다. 평균 정확도, 학습 토큰 효율, 실제 시간은 서로 대체할 수 없는 지표입니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
이 장은 메모리를 기존 신경망의 보조 정보로 넣는 흐름에서 출발해, 메모리가 계산을 직접 대체할 수 있는지 질문합니다. Value Embedding, DeepEmbed, PLE, STEM, Engram처럼 조회 기반 표현으로 모델 용량을 늘리는 연구들을 먼저 배치합니다. 이들은 큰 테이블을 두어도 각 토큰이 필요한 항목만 읽을 수 있다는 장점이 있습니다.
이어 attention을 내용 기반 메모리 조회로 바라봅니다. query–key 상호작용은 정보를 선택하고 value는 선택되는 내용을 제공합니다. 표준 attention은 이 내용을 현재 hidden state에서 매번 독립적인 선형 변환으로 계산합니다. 저자는 이 가운데 토큰에 공통적인 내용은 저장된 벡터로 공급하고, 문맥에 따라 달라지는 내용은 이미 계산하는 key에서 얻을 수 있다는 가설을 세웁니다. 따라서 같은 단어가 언제나 동일한 value를 갖는 설계가 아닙니다. key에 포함된 문맥과 이전 층의 계산 결과가 계속 합쳐집니다.
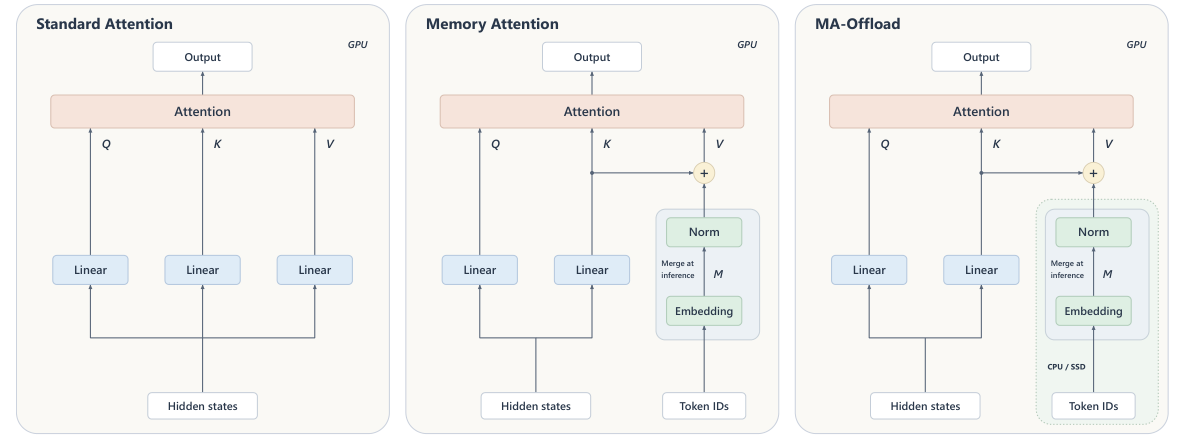
Figure 1, 원문 PDF 1쪽. 세 패널의 그림 영역만 크롭했으며 영문 표기를 유지했습니다. RoPE 등 일부 실험 구성요소는 원문 그림에서도 생략되어 있습니다. 그림에는 CPU/SSD가 표시되지만 §4.3의 실제 offload 측정은 CPU 메모리를 사용합니다.
왼쪽에서는 hidden state로부터 Q, K, V를 각각 계산합니다. 가운데에서는 V용 선형 층이 사라지고, K 경로와 토큰 ID 기반 embedding 경로가 덧셈에서 만납니다. 오른쪽에서는 embedding 경로를 GPU 밖으로 옮깁니다. 그림의 M 표기는 정규화 이전 조회 벡터를 가리키지만, 이후 수식 설명은 원문 식 (7)에 맞춰 정규화된 메모리를 M으로 정의합니다.
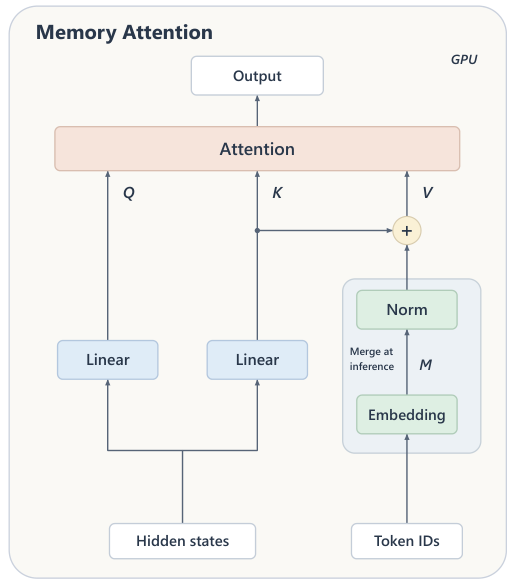
Figure 1 중앙 MA 패널 상세, 원문 PDF 1쪽. 원문에서 별도 크롭했으며 번역·재구성하지 않았습니다. 토큰 ID는 embedding 조회로, hidden state는 query/key 계산으로 들어갑니다. 전체 구조 그림 원본도 열어 비교할 수 있습니다.
서론 후반은 이 표현의 시스템적 결과를 연결합니다. 추론에서 정규화를 미리 계산하고, 토큰과 층을 알면 주소가 정해지는 성질로 선인출(prefetch)을 수행합니다. 또한 key와 토큰 ID를 보관하면 value를 다시 만들 수 있다는 관찰을 MA-Recall로 확장합니다. 이 장의 핵심은 표현과 저장 위치를 함께 바꾸는 문제 설정이며, 다음 장은 MA가 기존 메모리 주입 방법과 어떻게 다른지 정리합니다. 원문 §1
📖 Chapter 2: Background
Self-Attention. 표준 attention은 hidden state 행렬 X에 서로 다른 가중치를 곱해 Q, K, V를 만듭니다. 한 head의 출력은 다음과 같습니다.
원문 식 (1)–(2)입니다. $d_k$는 key 차원이며 분모의 제곱근은 점수의 크기를 조절합니다. $\mathbf C$는 미래 위치를 보지 못하게 하는 causal mask입니다. 행렬 A는 어느 토큰을 얼마나 참고할지 나타내고, V는 그 비율로 합칠 내용입니다. MA가 바꾸는 부분은 마지막에 들어갈 V의 생성 방식입니다.
Value Embeddings. 토큰 ID $s_t$로 테이블의 한 행을 읽어 $\mathbf v_{e,t}=\mathbf E[s_t]$를 만듭니다. 원문 식 (3)은 다음 혼합을 사용합니다.
$\lambda$는 토큰 embedding의 기여 비율입니다. 문맥 value와 토큰 메모리를 결합하지만 $\mathbf W_V$를 통한 원래의 투영은 남습니다. 이 존속 여부가 MA와 직접 대비되는 지점입니다.
Per-Layer Embeddings. PLE는 층별 테이블 조회와 입력 embedding의 투영을 먼저 더하고, 현재 hidden state에서 계산한 gate로 기여를 조절합니다. 원문 식 (4)–(5)의 구조는 다음과 같습니다.
$\mathbf x_t^{(0)}$는 입력 embedding, $\mathbf h_t$는 주입 위치의 hidden state입니다. P는 입력을 메모리 차원으로 옮기고, $\mathbf W_g$와 GELU는 문맥에 따른 gate를 만들며, $\odot$는 원소별 곱입니다. $\mathbf W_o$는 갱신량을 출력 차원으로 보냅니다. 원문도 층 인덱스, 정규화와 스케일링을 생략한 설명식임을 밝힙니다.
Engram. 단일 토큰 대신 인접한 n개 토큰의 패턴인 n-gram을 테이블 주소로 변환합니다. 원문 식 (6)의 $\mathbf E[h(s_{t-n+1},\ldots,s_t)]$에서 h는 로컬 토큰열을 주소에 대응시키는 함수입니다. 조회한 메모리는 문맥 gate를 통해 통합합니다. 저자는 전체 구조의 여러 조회를 하나로 추상화하여 설명합니다. 핵심 공통점은 hidden state가 계산되기 전에도 주소를 알 수 있어 선인출이 가능하다는 것입니다.
이 장의 기여는 비교 축을 분명히 한다는 데 있습니다. 무엇을 주소로 쓰는지, 문맥 정보를 어디에서 얻는지, 원래 value projection을 유지하는지 구분하면 다음 장의 MA를 단순한 embedding 추가와 혼동하지 않을 수 있습니다. 원문 §2, 식 (1)–(6)
📖 Chapter 3: Memory Attention
이 장은 표현 정의에서 출발하여 대수적 해석, 연산·저장 비용, CPU 배치, 캐시 재구성 순서로 논의를 확장합니다. 층 번호는 표기에서 생략하지만 각 층의 테이블과 학습 변환은 독립적입니다.
3.1 Memory-Based Value Construction
길이 T인 입력의 hidden state는 $\mathbf X\in\mathbb R^{T\times d}$, 토큰 ID열은 s입니다. 층마다 $\mathbf E\in\mathbb R^{N\times d_v}$를 두며, key와 value의 head 차원이 같다는 조건에서 다음을 계산합니다.
원문 식 (7)–(8)입니다. Norm은 각 토큰 벡터에 대해 KV head별로 독립적인 RMSNorm을 적용합니다. 테이블과 정규화 파라미터는 다른 모델 파라미터와 함께 학습됩니다. 한 층 안에서는 동일 토큰이 위치나 문맥에 무관하게 같은 M을 조회하지만, K는 해당 hidden state에서 계산됩니다. 따라서 V는 문맥에 따라 바뀌고, 서로 다른 층은 동일 토큰에도 다른 저장 표현을 줄 수 있습니다.
RoPE를 사용하면 점수 계산용 표현과 value 구성용 표현을 구분해야 합니다.
식 (9)의 위첨자 R은 위치 회전 후 표현입니다. attention 가중치는 $\mathbf Q^R$와 $\mathbf K^R$로 계산하지만 V에는 회전 전 K를 넣습니다. 이는 뒤의 MA-Recall에서 회전된 key만 캐시했을 때 역회전 작업이 필요해지는 이유입니다. 이 절의 기여는 독립 value projection을 제거해도 동적인 문맥 내용과 토큰별 저장 내용을 함께 전달하는 구체적인 규칙입니다. 원문 §3.1
3.2 Connection to MLA through Attention Aggregation
저자는 MLA(Multi-head Latent Attention)의 공유 잠재 표현과 비교해 MA의 논리를 설명합니다. 이 절은 단일 head에서 위치 성분과 mask를 생략합니다. MLA의 압축 잠재 표현을 C라고 하면 K와 V는 각각 C의 선형 변환입니다. 여기의 C는 앞 장 causal mask와 역할이 다른 기호입니다.
행렬 곱의 결합법칙으로 key 변환을 query 쪽으로, value 변환을 가중합 뒤로 옮길 수 있습니다.
원문 식 (10)–(12)의 재배치입니다. C에서 먼저 내용을 모은 뒤 $\mathbf W_V$로 변환해도 같은 출력이 됩니다. 공유 표현을 Z로 통일해 기능을 비교하면 식 (13)–(15)는 다음과 같습니다.
$\mathbf Z_{\mathrm{MLA}}=\mathbf C$, $\mathbf Z_{\mathrm{MA}}=\mathbf K$입니다. MLA는 집계된 공유 표현을 학습된 선형 변환에 통과시킵니다. MA는 key 자체를 집계하고 동일한 attention 가중치로 메모리도 집계합니다. 따라서 메모리의 한 행이 문맥과 무관하게 고정되어 있더라도, 어느 행을 얼마만큼 출력에 반영하는지는 문맥 의존적입니다.
이 비교는 역할상의 연결이며 두 방법의 표현, 차원, 가중치가 동일하다는 뜻이 아닙니다. 저자는 MA가 MLA의 대수적으로 동등한 재작성이라고 주장하지 않습니다. 이 절은 key가 점수 계산과 내용 제공을 함께 담당할 수 있다는 설계 근거를 제공하고, 다음 절은 그 대가와 이득을 계산합니다. 원문 §3.2
3.3 Computation and Parameter Storage
Parameter capacity. 비교 범위는 교체한 L개 층의 value 생성 경로이며, 양쪽에 공통인 key projection 등은 제외합니다. bias가 없는 표준 value projection은 $Ldd_v$개 파라미터를 갖습니다. MA는 $L(Nd_v+p_{\mathrm{norm}})$개이며, $p_{\mathrm{norm}}$은 층마다 학습하는 정규화 파라미터 수입니다. 어휘 수 N이 hidden dimension d보다 크면 MA의 용량과 총 저장량은 증가합니다.
Training computation. 표준 value projection은 forward, 입력 gradient, 가중치 gradient에 약 $6LSdd_v$ FLOPs를 사용합니다. MA의 head별 정규화, 덧셈, 접근한 항목에 대한 gradient 누적은 $\mathcal O(LSd_v)$ 산술 연산입니다. 이 비교는 optimizer update, gradient buffer 초기화, 메모리 이동을 제외합니다. 저자는 lookup을 쓴다는 사실만으로 gradient 저장이나 optimizer state가 희소해진다고 볼 수 없다고 명시합니다. 따라서 이 식만으로 학습 시간이나 학습 GPU 메모리 절감률을 도출할 수 없습니다.
Inference computation. 추론에서는 테이블과 정규화 파라미터가 고정됩니다. 각 행의 정규화가 다른 행과 독립이므로 미리 계산할 수 있습니다.
식 (16)–(17)의 막대가 붙은 E는 정규화까지 반영한 테이블입니다. 실제 실행에서는 필요한 행을 읽고 K에 더하기만 합니다. 원문 Table 1의 비교를 정리하면 다음과 같습니다.
| value 생성 경로의 비용 | Standard | MA |
|---|---|---|
| 학습 파라미터 | $Ldd_v$ | $L(Nd_v+p_{\mathrm{norm}})$ |
| 추론 저장 파라미터 | $Ldd_v$ | $LNd_v$ |
| 새 토큰의 추론 산술 FLOPs | 약 $2LSdd_v$ | $LSd_v$ |
곱셈과 덧셈을 각각 1 FLOP으로 셉니다. 표에는 lookup 비용, 메모리 이동, 과거 value 재구성이 들어 있지 않습니다. 새 토큰 처리에서 줄어드는 산술량과 전체 모델 대비 비율은 식 (18)–(19)입니다.
$F_{\mathrm{common}}$은 동일한 workload에서 바뀌지 않는 구성요소의 FLOPs입니다. value 경로에서 큰 폭으로 줄어도 분모의 공통 연산이 남으므로 전체 모델 절감률과 같지 않습니다. 또한 FLOPs는 메모리 접근, kernel 실행, 동기화 시간을 직접 나타내지 않습니다. 원문 §3.3, Table 1
3.4 MA-Offload
MA-Offload는 정규화된 테이블을 CPU 메모리에 놓습니다. 각 층의 hidden state가 준비되기 전에 토큰 ID와 층 번호로 조회 주소를 알 수 있으므로, 필요한 벡터를 미리 읽어 GPU로 전송하고 모델 계산과 겹칩니다. 이는 테이블 전체를 GPU에 둘 필요를 줄이지만 모델의 총 파라미터 수는 바꾸지 않습니다.
원문 식 (20)–(21)에서 $b_w$는 메모리 원소 하나의 바이트 수입니다. 첫 식은 GPU에서 CPU로 옮겨 상주시키는 테이블의 바이트 수이고, 두 번째는 캐싱·중복 제거가 없을 때 새 토큰을 위해 전송하는 논리적 데이터량입니다. 같은 토큰이 반복될 때의 중복 제거 이득을 자동으로 가정하지 않습니다.
통상적인 KV cache를 유지하면 과거 value는 이미 GPU에 캐시되어 있습니다. 한 decoding step에서는 새 토큰만 조회하므로 $S=B$이고 전송량은 $b_wLBd_v$입니다. GPU에는 조회·전송용 임시 buffer가 추가로 필요합니다. 저자는 CPU 조회 성능, 대역폭, 동기화, 계산과의 중첩 정도에 따라 지연이 결정된다고 설명합니다. 이 절의 결과는 GPU 파라미터 상주량 감소이며, 전체 GPU 메모리나 추론 지연이 반드시 줄어든다는 보장은 아닙니다. 원문 §3.4
3.5 MA-Recall: An Extension for Value Reconstruction
MA-Recall은 저장 위치 변경에서 한 걸음 더 나아가, 과거 V를 지속적으로 캐시하지 않고 필요할 때 만드는 확장입니다. 원문 식 (22)의 과거 구간을 아래에서는 하첨자 $1:T$로 명확히 표기합니다.
필요한 것은 과거 content key와 토큰 ID입니다. 다만 attention 점수는 위치 회전된 key를 사용합니다. 회전된 key만 저장하면 역회전하여 content key를 얻거나, content key만 저장하고 점수 계산 시 회전해야 합니다. 둘 다 위치 변환 비용을 수반하며 두 표현을 모두 보관하면 추가 저장량이 필요합니다.
key와 value의 차원·정밀도가 같고 캐시 원소당 바이트 수를 $b_c$라고 할 때, 일반적인 content KV cache는 $2b_cLBTd_v$바이트입니다. 위치마다 key 표현 하나만 보관하면 $b_cLBTd_v$바이트로 이 캐시 성분은 50% 감소합니다. 이 계산에는 토큰 ID, 위치 메타데이터, 임시 재구성 buffer와 추가 위치 key 저장이 포함되지 않습니다. 저자는 블록별 재구성으로 전체 value 이력을 한꺼번에 GPU에 만드는 일을 피할 수 있다고 설명합니다.
각 decoding step에서 시퀀스마다 재구성하는 과거 위치 수를 R이라 하면 추가 덧셈은 약 $LBRd_v$회입니다. 전체 causal attention에서는 $R=T$이며, 제한된 attention에서는 실제 재구성 위치 수에 따릅니다. 테이블도 CPU에 둔다면 다음 전송이 추가됩니다.
식 (23) 역시 캐싱·중복 제거를 제외합니다. 기존 MA-Offload는 새 토큰을 가져오지만 MA-Recall은 과거 R개 위치까지 다시 읽을 수 있다는 차이가 중요합니다. 이 절은 저장 공간과 반복 조회·전송·재구성의 교환 관계를 분석합니다. 이 확장은 §4의 추론 측정에 포함되지 않습니다. 따라서 50%라는 이론적 content cache 감소와 뒤의 지연 수치를 하나의 측정 결과로 묶어서는 안 됩니다. 다음 장은 실제 구현된 MA와 MA-Offload의 품질·효율을 평가합니다. 원문 §3.5
📖 Chapter 4: Experiments
4.1 Experimental Setup
Training configurations. 학습은 NVIDIA H800과 flash-linear-attention 프레임워크를 사용합니다. backbone은 attention block과 gated MLP로 구성되며 RoPE와 RMSNorm을 사용합니다. 같은 설정의 Standard–Memory 쌍에서는 학습 토큰 예산을 맞추지만 Memory 쪽에 추가 파라미터가 있습니다.
Evaluation benchmarks. lm-evaluation-harness로 zero-shot 평가를 수행합니다. LAMBADA와 WikiText에서 PPL을, LAMBADA에서 단어 예측 정확도를 측정합니다. 추가 과제는 ARC-Easy, ARC-Challenge, HellaSwag, PIQA, WinoGrande, OpenBookQA입니다. ARC-Challenge와 HellaSwag는 원문이 $\mathrm{Acc}_n$으로 표기한 normalized accuracy를 사용하고 나머지는 accuracy를 사용합니다. 평균은 PPL을 제외한 일곱 정확도의 비가중 평균입니다. 이 절은 뒤의 결과가 서로 다른 지표를 혼합해 만든 점수가 아니라는 해석 기준을 제공합니다. 원문 §4.1
4.2 Language Modeling
원문 Table 2는 24층·hidden size 1,024인 MHA, GQA, MQA, Gate의 네 쌍과 hidden size 2,048인 MHA 한 쌍을 보고합니다. 작은 모델은 10B 토큰·batch당 0.5M 토큰, 큰 모델은 20B·1M 토큰으로 표시됩니다. B는 십억, M은 백만 단위입니다. 아래 표는 Table 2의 언어 모델 지표와 평균을 옮긴 것입니다. 화살표는 Standard → Memory를 뜻합니다.
| 설정 | 총 파라미터(M) | LAMBADA PPL ↓ | WikiText PPL ↓ | 정확도 평균(%) ↑ |
|---|---|---|---|---|
| D1024 MHA | 373 → 1,135 | 44.35 → 42.78 | 31.55 → 28.64 | 40.68 → 41.39 |
| D1024 GQA | 349 → 729 | 50.46 → 43.68 | 31.71 → 29.45 | 40.90 → 41.51 |
| D1024 MQA | 336 → 526 | 50.38 → 45.93 | 31.84 → 29.82 | 41.11 → 41.34 |
| D1024 Gate | 398 → 1,160 | 41.88 → 36.60 | 29.67 → 27.48 | 41.40 → 42.88 |
| D2048 MHA | 1,364 → 2,836 | 18.59 → 18.15 | 21.52 → 20.79 | 49.06 → 50.22 |
MHA는 head마다 key/value를 두는 multi-head attention, GQA는 여러 query head가 KV head를 공유하는 grouped-query attention, MQA는 하나의 KV head를 공유하는 multi-query attention입니다. Gate는 Table 2의 설정 이름을 그대로 유지했습니다. 부록에는 Gate의 별도 구현 세부사항이 제시되지 않으므로 구체적인 gating 구조를 추정하지 않습니다.
다섯 쌍 모두 두 PPL과 평균 정확도가 개선됩니다. 평균 차이는 각각 0.71, 0.61, 0.23, 1.48, 1.16%p입니다. 그러나 모든 과제에서 개선되는 것은 아닙니다. 큰 MHA의 일곱 지표를 전부 펼치면 다음과 같습니다.
| D2048 MHA, 20B 토큰 | Standard(%) | Memory(%) | 차이(%p) |
|---|---|---|---|
| LAMBADA 정확도 | 40.50 | 41.59 | +1.09 |
| ARC-Easy 정확도 | 66.67 | 66.04 | -0.63 |
| ARC-Challenge 정규화 정확도 | 31.31 | 33.96 | +2.65 |
| HellaSwag 정규화 정확도 | 46.98 | 48.38 | +1.40 |
| PIQA 정확도 | 69.91 | 69.42 | -0.49 |
| WinoGrande 정확도 | 53.67 | 54.78 | +1.11 |
| OpenBookQA 정확도 | 34.40 | 37.40 | +3.00 |
저자는 이 결과가 보고한 예산에서 메모리 증가를 포함한 MA 전체 설계의 효과를 지지한다고 해석합니다. 구조의 효과와 추가 파라미터 효과는 분리하지 않습니다. Table 2 캡션은 sliding-window attention, linear attention, 더 큰 모델 및 MoE 실험이 진행 중이라고 밝히지만, 그 결과는 이 버전의 검증 결과로 제시하지 않습니다. 목표 loss에 이르는 토큰 수의 비율도 wall-clock 학습 속도와 구분하며, 메모리 접근·gradient 처리·optimizer update가 실제 시간을 좌우한다고 설명합니다. 원문 §4.2, Table 2
Retrieval and Context-Length Extrapolation. 검색 실험은 24층·D1024 모델을 10B 토큰, 문맥 길이 2,048로 학습한 뒤 single-needle NIAH 세 과제로 평가합니다. 1K와 2K는 학습 문맥 안이며, 4K는 두 배 길이로의 외삽입니다. 아래는 원문 Table 3의 0–1 점수를 백분율로 변환한 표입니다.
| 과제 | 길이 | Standard(%) | MA(%) |
|---|---|---|---|
| niah_single_1 | 1K / 2K / 4K | 99.8 / 84.4 / 41.4 | 100.0 / 99.4 / 51.0 |
| niah_single_2 | 1K / 2K / 4K | 85.6 / 91.4 / 23.2 | 94.0 / 100.0 / 45.4 |
| niah_single_3 | 1K / 2K / 4K | 62.4 / 70.4 / 13.0 | 98.2 / 91.0 / 29.4 |
MA는 아홉 조합 모두에서 높습니다. 세 과제 평균은 1K에서 82.6% → 97.4%, 2K에서 82.1% → 96.8%, 4K에서 25.9% → 41.9%입니다. 평균은 원문처럼 소수 첫째 자리로 반올림했습니다. 특히 세 번째 과제의 1K 점수는 62.4%에서 98.2%로 높아집니다. 그러나 학습 범위를 넘으면 두 모델 모두 큰 폭으로 떨어집니다. 저자는 이 결과가 평가한 과제와 2배 외삽에서의 개선을 보여 줄 뿐 더 긴 문맥의 견고한 검색을 입증하지는 않는다고 명시합니다. 원문 Table 3
4.3 Training and Inference Efficiency
Training efficiency. 목표 손실 $\ell$에 도달하는 학습 토큰 수로 효율을 정의합니다.
식 (24)에서 분자는 Standard, 분모는 MA가 해당 손실까지 사용한 토큰 수입니다. Figure 2의 선택된 operating point에서 D1024는 1.42배, D2048은 1.16배입니다. 이는 각각 약 29.6%, 13.8% 적은 토큰에 해당합니다. 파라미터 수가 더 많은 MA와 비교한 결과이며, 학습 시간이 1.42배 빨라졌다는 뜻은 아닙니다.
Inference configurations. Standard, GPU에 테이블을 둔 MA, CPU에 테이블을 둔 MA-Offload를 비교합니다. 두 MA 변형은 head별 RMSNorm을 추론 전 테이블에 반영합니다. 세 구성 모두 일반적인 KV cache를 유지하며 MA-Recall은 제외합니다. 단일 H800, BF16, PyTorch 2.9.1/CUDA 12.6, FlashAttention 2.8.3 환경입니다. 모델은 24층·D2048, query와 KV head 각각 32개, gated MLP 중간 차원 5,632, 어휘 32,000개이며 입력 embedding과 출력 head를 묶지 않습니다.
기준 workload는 batch size 8, prefill 2,048토큰, decoding의 캐시 이력 2,048토큰입니다. decoding 측정은 각 시퀀스에서 새 토큰 한 개를 처리합니다. offload group은 prefill에서 1개 층, decoding에서 4개 층이며 두 단계의 prefetch depth는 4입니다. GPU MA는 층별 lookup을 수행합니다.
Measurement scope. 시간 측정에는 입력 embedding, 모든 Transformer 층, 마지막 RMSNorm, 출력 head가 포함됩니다. prefill은 모든 입력 위치의 logits를 계산합니다. MA-Offload의 forward 중 메모리 조회와 전송도 포함하지만, 테이블 초기화, 정규화 사전 반영, decode prefix 구성, sampling, 토큰 ID의 GPU→CPU 전송은 제외합니다. 토큰 ID는 측정 전에 양쪽 장치에 준비되어 있습니다. 따라서 서비스의 요청 수신부터 결과 반환까지를 재는 end-to-end 지연이 아닙니다.
파라미터 저장량에는 정규화가 반영된 테이블 등 추론에 유지되는 모든 파라미터가 들어갑니다. KV cache, activation, 전송 buffer는 제외하므로 전체 또는 peak GPU 메모리 사용량이 아닙니다. 원문 Table 4를 두 표로 나누어 읽으면 측정 범위가 더 명확해집니다.
| 기준 workload | Prefill(ms) | Decode 1 step(ms) | 총 파라미터(M) |
|---|---|---|---|
| Standard | 90.970 | 17.636 | 1,364.298 |
| MA | 88.202 | 17.788 | 2,836.498 |
| MA-Offload | 90.686 | 17.189 | 2,836.498 |
| 기준 workload | GPU 파라미터(M) | CPU 파라미터(M) | GPU 저장(MiB) | CPU 저장(MiB) |
|---|---|---|---|---|
| Standard | 1,364.298 | 0.000 | 2,602.38 | 0.00 |
| MA | 2,836.498 | 0.000 | 5,410.38 | 0.00 |
| MA-Offload | 1,263.634 | 1,572.864 | 2,410.38 | 3,000.00 |
M은 $10^6$개 파라미터, MiB는 $2^{20}$바이트입니다. 저장량은 BF16 기준입니다.
Value-construction overhead. GPU MA는 prefill을 90.970ms에서 88.202ms로 3.04% 줄였지만 decoding은 17.636ms에서 17.788ms로 0.86% 증가했습니다. 총 파라미터가 약 2.08배인데 이 조건의 forward 지연은 비슷한 수준입니다. value 산술량 감소가 모든 단계의 지연 감소로 이어지지는 않는다는 관찰입니다.
GPU parameter storage. MA-Offload는 메모리 테이블 1,572.864M개, BF16 기준 3,000MiB를 CPU에 둡니다. GPU MA 대비 GPU 파라미터 저장은 5,410.38 → 2,410.38MiB로 55.45% 감소합니다. Standard 대비로는 value projection 제거에 해당하는 192MiB, 7.38% 감소입니다. 두 절감률은 기준점이 다르며 CPU에 추가로 3,000MiB를 사용합니다.
Transfer overhead and overlap. MA-Offload의 prefill과 decoding은 Standard 대비 각각 0.31%, 2.53% 낮게 측정되었습니다. 이 결과는 해당 workload에서 추가 전송을 수용하면서 순 forward 지연을 높이지 않았다는 관찰입니다. 저자는 이 시간이 value projection 제거, 메모리 접근, 전송, 스케줄링 효과를 합한 값이며, 통신이 공짜라거나 overlap만의 이득을 분리 측정한 결과가 아니라고 설명합니다.
Implementation scope. 구현은 저장량과 지연의 교환 관계를 조사하는 prototype입니다. 저자는 lookup, buffering, 전송 스케줄링의 추가 최적화 가능성을 언급하지만 이 논문에서 평가하지 않았습니다. 작은 시간 차이는 보고한 operating point의 측정으로 보아야 하며 모든 workload에서 일정한 속도 우위로 일반화하지 않습니다. Figure 3은 길이 2K에서 batch를 바꾸거나 batch 8에서 길이를 바꾼 prefill·decoding 결과를 보여 줍니다. 점은 중앙값, 오차 막대는 측정 round의 최솟값과 최댓값이며 신뢰구간이 아닙니다. 가로축은 밑이 2인 로그 눈금입니다. 이 장은 품질 이득과 저장 배치의 실행 가능성을 함께 제시하되 측정된 범위를 구체적으로 제한합니다. 원문 §4.3, Figures 2–3, Table 4
References
원문은 attention, lookup 기반 메모리, 평가 도구와 데이터셋 관련 문헌을 열거한 뒤 부록으로 이어집니다. 이 리뷰에서는 해당 목록이 본 논문에서 어떤 비교·평가를 뒷받침하는지 확인했으며, 인용된 모든 논문의 원문을 별도로 분석한 것으로 취급하지 않습니다.
📖 Chapter A: Pretraining Settings
이 부록은 본문의 품질 비교를 재현·해석하는 데 필요한 기본 학습 및 head 설정을 제공합니다.
Data and optimization. 데이터는 FineWeb-10BT이며, 별도 표기가 없는 기본 설정은 20,480 step, 시퀀스 길이 2,048, global batch 256개 시퀀스입니다. AdamW의 최대 학습률은 $3\times10^{-4}$, epsilon은 $10^{-15}$입니다. 처음 1,024 step을 warmup으로 사용하고 cosine schedule로 최대 학습률의 10%까지 낮춥니다. global gradient norm은 1.0에서 clipping하며 seed는 42입니다. 같은 backbone의 Standard와 MA는 같은 학습 설정과 seed를 사용합니다. 기본 설정의 토큰 수를 단순 곱하면 10,737,418,240이며, Table 2는 작은 모델 예산을 10B로 표시합니다. 큰 모델의 20B·batch 1M 조건은 Table 2의 별도 설정으로 읽어야 합니다.
Backbone and attention configurations. D1024 모델은 모두 24층입니다. Table 6의 head 구성을 정리하면 다음과 같습니다.
| D1024 설정 | MHA | GQA | MQA |
|---|---|---|---|
| query head 수 | 16 | 16 | 4 |
| KV head 수 | 16 | 8 | 1 |
| head 차원 | 64 | 64 | 256 |
| KV head당 query head 수 | 1 | 2 | 4 |
| 전체 KV 차원 $d_v$ | 1,024 | 512 | 256 |
MQA는 단순히 MHA에서 KV head만 줄인 것이 아니라 query head 수와 head 차원도 다릅니다. 따라서 backbone 간 비교에는 이 차이가 함께 들어갑니다. 반면 동일 backbone 안의 Standard–MA 비교에서는 같은 head 설정을 사용합니다. RoPE base는 10,000, RMSNorm epsilon은 $10^{-6}$이며 입력 embedding과 출력 head는 공유하지 않습니다.
Memory configuration. 메모리 테이블 폭은 해당 전체 KV 차원에 맞춰 각각 1,024, 512, 256입니다. 조회 벡터를 KV head별로 정규화하고 RoPE 이전 key에 더합니다. 같은 KV head를 공유하는 query head들은 그 head의 메모리 기여도 공유합니다. 층 사이에는 테이블을 공유하지 않고 전체 모델과 함께 학습합니다. 이 부록은 메모리 크기가 단순히 hidden dimension만이 아니라 KV 공유 방식에도 의존한다는 점을 구체화하며, 본문 방법과 실험 설정을 마무리합니다. 원문 Appendix A, Tables 5–6
실험 결과 심층 분석
품질 결과에서 가장 먼저 확인할 조건은 토큰 예산 일치와 파라미터 수 일치가 다르다는 점입니다. 작은 MHA는 373M → 1,135M, 큰 MHA는 1,364M → 2,836M으로 용량이 증가합니다. 따라서 모든 비교 쌍의 PPL 및 평균 정확도 개선은 추가 메모리를 포함한 설계의 결과입니다. 특정 값 생성식만 바꾼 순수한 구조 효과로 분해할 수 없다는 저자의 설명이 해석의 기준입니다. 원문 Table 2
평균만 보면 작은 Gate의 +1.48%p가 가장 크지만 설정 간 head·파라미터 차이를 함께 보아야 합니다. 큰 MHA의 OpenBookQA +3.00%p와 ARC-Challenge +2.65%p는 분명한 관측 차이인 반면 ARC-Easy와 PIQA는 감소합니다. 정확도 차이에 대한 통계적 유의성 검정과 신뢰구간은 논문에 보고되지 않았습니다. 같은 seed를 쓴 통제는 조건 일치에 도움을 주지만, 여러 seed에서의 변동 평가를 대신하지는 않습니다.
검색은 평균 정확도보다 더 큰 차이를 보이지만 범위가 한정됩니다. 2K 학습 모델의 4K 평균 41.9%는 baseline 25.9%보다 높아도, 학습 문맥 내 96.8%와 비교하면 큰 하락입니다. 이는 저자가 밝힌 대로 평가한 NIAH 과제의 개선이지 일반적인 장문 이해 능력이나 더 긴 문맥의 견고성을 확정하는 결과가 아닙니다. 원문 Table 3
효율 결과는 세 가지로 나누어 읽는 것이 정확합니다. 목표 loss까지의 토큰 효율은 학습 데이터 소비량입니다. FLOPs 식은 value 경로의 산술량입니다. Table 4는 단일 H800의 정해진 workload에서 측정한 forward-pass 시간과 파라미터 저장 위치입니다. 특히 CPU offload의 7.38%는 Standard 대비 GPU 파라미터 저장 감소이며, MA-Recall의 50%는 별도 분석의 content cache 성분 감소입니다. 두 숫자를 합쳐 총 GPU 메모리 절감이라고 계산할 수 없습니다. Figure 3의 min–max 막대 또한 속도 우위의 통계적 유의성을 입증하는 신뢰구간으로 해석하지 않습니다. 원문 §3.5, §4.3
기술적 함의와 응용
저자의 결과는 토큰으로 주소가 정해지는 학습 메모리를 통해 파라미터 용량을 늘리면서 value 생성의 조밀한 연산을 대체할 수 있음을 보여 줍니다. 리뷰어 관점에서는 모델의 표현 방식과 시스템 배치를 함께 읽는 사례입니다. 메모리 주소를 hidden state 계산 전에 알 수 있다는 성질이 선인출의 근거가 되고, 정규화의 행별 독립성이 사전 계산의 근거가 됩니다. 두 최적화는 각각 표현 정의의 구체적인 성질에서 나옵니다.
실제 적용을 해석할 때에는 논문이 측정한 조건을 유지해야 합니다. CPU 메모리를 더 사용해 GPU 파라미터 상주량을 낮추는 MA-Offload의 feasibility는 제시되지만, end-to-end serving 지연이나 전체 peak GPU 메모리는 측정 대상이 아닙니다. 원문 그림의 SSD 표기도 SSD 실행 성능의 검증을 뜻하지 않습니다. MA-Recall의 실용적 이득은 저자가 명시한 attention 패턴, key 저장 표현, 메모리 위치, 재구성 구현에 달려 있습니다. 원문 §3.4–3.5, §4.3
이 논문의 중심 결론은 문맥 key와 층별 토큰 메모리가 결합하면 독립 value projection을 대체하는 하나의 학습 가능한 경로를 만들 수 있다는 것입니다. 보고한 토큰 예산에서는 품질이 개선되고, CPU 배치를 이용한 prototype은 추가 용량을 GPU 밖에 두면서 기준 workload에서 baseline에 가까운 forward 지연을 유지했습니다. 이 결론은 추가 파라미터를 포함한 설계, 평가된 과제, 지정된 측정 범위 안에서 이해하는 것이 적절합니다.
분석 범위: v1의 본문 §1–4, 부록 A, Tables 1–6과 Figures 1–3의 설명을 검토했습니다. Figure 2–3 곡선의 모든 좌표를 수치화하지 않았고, Table 2의 작은 모델별 일곱 정확도를 모두 재전사하지는 않았습니다. 핵심 비교와 큰 MHA의 과제별 결과를 제시했습니다. 원문은 공개 구현 저장소를 연결하며, 리뷰 시점에 접근 가능한 것을 확인했습니다. 구현 저장소의 정적 분석·실행 재현과 인용 문헌 전체의 독립 검토는 수행하지 않았습니다.