논문 개요와 전체 구조
장시간 작업하는 에이전트는 코드를 작성하거나 실험을 실행하는 능력과 함께, 어느 방향에 다음 시간을 투자할지 고르는 판단력이 필요합니다. 이 논문에서 말하는 taste는 미적 취향이 아니라, 나중에 성패가 드러나는 기술적 선택을 현재의 정보만으로 잘하는 능력입니다. 당장은 타당해 보이는 구현이나 가설도 후속 작업에서 비용을 발생시킬 수 있기 때문에, 최종 과제 성공률만으로는 중간 선택의 질을 직접 설명하기 어렵다는 문제에서 출발합니다.
Wenbo Pan 등은 이미 수행된 에이전트 실행 기록을 이용해 이 능력을 측정합니다. 동일 과제에서 결과가 달라진 두 시도, 또는 한 실행 안에서 실패한 접근을 버리고 회복한 구간으로부터 결정 분기점(decision fork)을 찾습니다. 평가 모델에는 분기 이전의 기록과 두 후보만 보여 주고, 이후 실행 결과는 정답을 정하는 근거로 사용합니다. 이렇게 만든 Taste-Bench는 엔지니어링 390문항과 연구 112문항으로 이루어집니다. 이어 정답 방향을 아는 교사의 추론을 학생에게 증류하고, 학생 판단을 별도 실행 에이전트의 조언으로 제공했을 때의 효과를 조사합니다.
이 리뷰는 2026년 9월 23일 수정된 arXiv:2609.25804v2의 HTML과 33쪽 PDF를 기준으로 작성했습니다. 주요 결과의 59.7%는 두 순서에서 모두 맞혀야 정답으로 인정하는 정확도를 도메인별로 계산한 뒤 연구와 엔지니어링을 동일 비중으로 평균한 값입니다. 일반적인 한 번의 이지선다 정답률과는 다릅니다. 고정 버전 원문
원문의 전개 순서는 다음과 같습니다.
| 원문 구간 | 세부 구조와 역할 |
|---|---|
| 1. Introduction | 장기 과제의 중간 판단을 별도로 측정할 필요성 |
| 2. Measuring Taste via Long-Horizon Judgment | 분기점, 사후 근거, 정답과 판단력의 형식화 |
| 3. Taste-Bench | 3.1 병렬 실행, 3.2 우회 실행, 3.3 채굴·필터·구성, 3.4 평가 프로토콜 |
| 4. Experimental Results | 4.1 설정, 4.2 모델 정확도, 4.3 시간 지평, 4.4 추론 예산, 4.5 종단 간 벤치마크와 비교 |
| 5. Generalizing Taste through Distillation | 5.1 증류 방법, 5.2 미관측 과제 전이, 5.3 종단 간 평가 |
| 6. Related Work | 장기 과제 평가, 결과 이전 연구 판단, 과정 평가, 문맥 증류 |
| 7. Conclusion 및 선언문 | 결론, 재현성·윤리·AI 활용 선언, 참고문헌 |
| 부록 A–D | A 구성 상세, B 문항 사례, C 평가 상세, D 전체 결과 |
| 부록 E–H | E 판정자 일치, F 사람 검토, G 증류 상세, H 종단 간 실험 상세 |
핵심 기여와 혁신성
첫 번째 기여는 과제 완료 여부와 중간 판단을 구분하는 평가 단위입니다. 코드 수정에 성공했는지뿐 아니라, 동일한 상황에서 어떤 구현 방향을 선택해야 했는지를 묻습니다. 전문가가 모든 선택을 직접 평가하는 대신, 실행 기록에 남은 테스트 결과나 연구 점수를 감독 신호로 재사용합니다. 사후 정보로 정답을 만들되 평가 시에는 그 정보를 숨기는 구성이 핵심입니다. §1–2
두 번째 기여는 병렬 시도와 단일 실행의 우회를 함께 다룬 데이터 구성입니다. 병렬 시도는 에이전트가 끝까지 알아차리지 못한 잘못된 방향을, 우회는 에이전트가 나중에 수정한 잘못된 방향을 드러냅니다. 선택지의 표현만으로 풀리는 문항과 전체 결과를 보아도 정답이 분명하지 않은 문항을 서로 다른 필터로 제거합니다. 따라서 단순히 성공·실패 기록을 모으는 것보다 비교 가능한 기술적 선택을 만드는 과정에 연구의 무게가 있습니다. §3
세 번째 기여는 평가용 기록을 학습에도 연결했다는 점입니다. 정답 방향을 추가 문맥으로 받은 교사의 추론을 Qwen3.6-27B 학생에 증류하고, 학습에서 제외한 과제의 분기 판단과 별도 실행자의 성공률을 모두 측정합니다. 리뷰어의 해석으로는, 이 결과는 과제 실행 능력 외에 판단을 담당하는 모델을 따로 개선하고 활용할 수 있다는 실증입니다. 다만 종단 간 실험은 과거 기록에서 미리 만든 분기를 조언으로 제공하는 설계이므로, 실시간으로 새로운 분기를 발견하는 전체 시스템의 검증으로 확장해서 읽어서는 안 됩니다. §5, 부록 H
기술적 세부사항
이 논문의 입력은 단독 질문이 아니라 과제와 실행 문맥의 묶음입니다. 궤적(trajectory)은 관찰, 행동, 명령 결과와 수정 기록을 시간순으로 담은 실행 기록이며, 접두 기록(prefix)은 그중 선택 직전까지의 부분입니다. 후보는 그 시점에서 가능한 다음 기술적 방향을 중립적인 문장으로 나타냅니다. 사후 근거(hindsight evidence)는 선택 뒤에 관측된 결과로, 평가 모델의 입력과 정답 생성자의 입력을 분리하는 기준입니다.
원문 §2의 기호를 먼저 정리하면 다음과 같습니다.
$q$는 원래 과제, $t$는 분기 시점, $o$와 $a$는 각각 관찰과 행동입니다. $h_t$는 분기 이전의 기록이며, $c_1,c_2$는 두 후보 방향입니다. 평가 모델이 받는 $x$에는 이들만 들어가고 분기 이후의 기록은 들어가지 않습니다. 이 묶음은 원문의 입력 정의를 한 줄로 모아 쓴 것입니다. §2
원문 식 (1)은 실행이 끝난 뒤 관측된 결과로 정답 후보를 정합니다.
$E_i$는 후보 $i$를 따른 가지의 테스트 결과나 연구 점수 같은 근거이고, $U$는 이를 비교 가능한 결과 값으로 바꾸는 함수입니다. $y$는 더 좋은 결과를 낸 후보의 번호입니다. 원문이 기대하는 좋은 판단은 현재 문맥에서 $\mathbb{E}[U\mid h_t,c_i]$가 높은 방향을 선택하는 것이지만, 데이터의 정답은 실제 관측 결과로 그 기대를 추정합니다. 후속 실행 품질도 결과에 영향을 주므로, 저자는 결과 차이가 해당 판단과 명확히 연결되는 분기만 남기도록 필터링합니다. 관측 결과와 기대 결과가 같은 개념인 것은 아닙니다. 식 (1), §2–3
평가에서는 위치 편향, 즉 내용보다 A나 B라는 위치에 끌리는 현상을 제어합니다. 같은 문항을 한 번은 시드로 정한 순서로, 한 번은 역순으로 제시하고 모두 맞혀야 정답으로 계산합니다. 두 제시를 독립적으로 무작위 추측하면 정답 확률은 $\tfrac12\times\tfrac12=\tfrac14$이므로 기준선은 25%입니다. 항상 같은 위치를 고르는 모델은 0%입니다. 반면 mean accuracy는 두 제시 각각의 정답을 평균하므로 다른 지표입니다. Average는 연구 정확도와 엔지니어링 정확도의 1:1 평균입니다. 112 대 390의 문항 수 불균형 때문에 전체 문항을 한꺼번에 평균한 값과도 달라집니다. §3.4, §4.1, 부록 C
학습에서는 지식 증류(distillation), 곧 교사의 출력 분포를 학생이 따르도록 학습하는 방법을 씁니다. 교사는 정답 방향을 설명한 추가 문맥을 받고 학생은 일반 문항만 받습니다. 기반 모델은 같지만 입력 문맥이 다르며, 학생 쪽에서는 LoRA라는 저차원 어댑터를 갱신합니다. 논문은 추론 토큰과 최종 선택에 적용하는 토큰 수준 KL 손실을 서술하지만 별도의 번호 있는 손실식은 제시하지 않습니다. 여기서는 식을 새로 확정하지 않고 부록 G의 계산 범위·샘플링·보정 절차를 아래에서 설명합니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
도입부는 장기 과제를 수행하는 에이전트가 늘어나면서 중간 선택의 영향도 커진다는 배경을 제시합니다. 어떤 가설을 시험할지, 어느 구현을 바탕으로 확장할지, 다음 실험을 무엇으로 할지는 그 순간의 응답 품질만으로 판단하기 어렵습니다. 잘못된 선택도 당장에는 그럴듯하고, 예산을 상당 부분 사용한 뒤에야 문제가 드러날 수 있습니다.
기존 종단 간 벤치마크는 과제를 끝냈는지 측정하지만, 진행 중 선택이 적절했는지는 직접 알려 주지 않습니다. 저자가 설정한 문제는 이를 전문가의 대규모 주석 없이 측정할 수 있는가입니다. 해법은 이미 존재하는 실행 기록의 뒤쪽을 앞쪽 판단의 근거로 활용하는 것입니다. 같은 과제의 여러 시도가 중간에 갈라지고 결과가 달라졌다면, 그 갈림길을 평가 문항으로 만들 수 있습니다.
Figure 1의 연구 사례는 손상된 언어 모델의 임베딩을 직접 최적화할지, 전역 스케일만 조정할지 선택하는 상황입니다. 선택 때에는 뒤의 손실 값을 보여 주지 않습니다. 나중의 관측이 정답을 정하지만 모델은 앞부분만으로 방향을 골라야 한다는 점이 논문의 전체 구성을 예고합니다. 이 장은 문제 정의, Taste-Bench 공개, 증류와 실행 성능 개선이라는 세 기여를 제시하고, 다음 장에서 분기 판단을 형식화합니다. §1
📖 Chapter 2: Measuring Taste via Long-Horizon Judgment
이 장은 taste를 장기적 판단으로 정의합니다. 예를 들어 두 구현이 당장의 테스트는 모두 통과하더라도, 이후 변경을 쉽게 만드는 구현은 장기적으로 더 좋을 수 있습니다. 따라서 즉시 관측 가능한 정오 판정과 이후 작업에서 드러나는 우위를 구분합니다.
저자는 한 궤적의 결과만으로 판단 품질을 곧바로 알 수 없다고 설명합니다. 결과에는 판단뿐 아니라 실행 품질과 환경도 관여하기 때문입니다. 비교를 위해 동일 과제에서 분기 이전 문맥이 동등한 시도들을 찾고, 그 이후를 두 가지(branch)로 다룹니다. 샘플링으로 다른 판단이 나타난 비교를 이용하되, 이후 행동도 결과에 영향을 줄 수 있다는 점 때문에 명확한 연결이 있는 사례만 유지합니다.
앞서 설명한 식 (1)은 이 비교의 정답을 사후 결과로 정의합니다. 평가 모델 $\pi$는 질문 $x$에서 한 후보를 반환하며, 원문은 $\pi(x)=y$인 비율을 판단력의 추정값 $\widehat{T}(\pi)$로 설명합니다. 이어지는 실제 평가에서는 §3.4의 두 순서 정답 조건을 추가합니다. 이 장의 기여는 추상적인 판단력을 분기 이전 정보와 분기 이후 증거가 분리된 선택 문제로 바꾸는 데 있으며, 다음 장은 이 구조를 비정형 실행 기록에서 복원합니다. §2, 식 (1)
📖 Chapter 3: Taste-Bench
3.1 Forks from parallel trajectories
병렬 구성은 같은 과제의 서로 다른 시도 가운데 성공과 실패, 또는 더 좋은 연구 결과와 더 나쁜 결과를 낸 쌍을 맞춥니다. 생성자는 두 실행의 비교 가능한 분기점을 찾고 실제로 취한 행동을 후보로 기술합니다. 분기 이전의 동등한 부분이 접두 기록이 되며, 후보는 짧고 중립적인 문장으로 제시됩니다.
이 구성의 특징은 잘못된 방향을 택한 실행이 그것을 알아차리지 못한 채 끝날 수 있다는 점입니다. 후속 테스트나 연구 결과가 두 방향의 차이를 드러냅니다. 단순히 성공한 실행의 모든 행동을 좋은 행동이라고 붙이는 것이 아니라, 결과 차이를 낳은 기술적 선택을 찾는 것이 생성자의 역할입니다.
3.2 Forks from detour trajectories
우회 구성은 단일 실행 안에서 접근을 택하고, 실패를 관측하고, 다른 접근으로 회복해 과제를 완수한 순서를 찾습니다. 잘못된 방향을 택하기 바로 직전으로 분기를 옮기고, 먼저 시도한 접근과 나중의 회복 접근을 후보로 제시합니다. 평가 모델은 실행 에이전트보다 이른 시점에 실패를 예견할 수 있는지 시험받습니다.
회복 접근을 후보로 만들 때는 사후 정보 누출을 막는 조건이 중요합니다. 오류 메시지를 본 뒤에야 이름을 붙일 수 있는 수정은 제외하며, 당시의 접두 기록만 가진 유능한 엔지니어가 제안할 수 있었던 대안이어야 합니다. 접두 기록에는 실패나 최종 수정 내용이 노출되지 않아야 하고, 두 선택지 모두 그 시점에 실제로 고려할 만해야 합니다. 이 조건이 병렬 구성과 우회 구성 모두를 단순한 정답 회상 문제로 만들지 않는 장치입니다.
3.3 Mining, filtering, and composition
엔지니어링 원천은 SWE-bench Pro의 517개 과제에서 GPT-5.4와 GPT-5.5가 만든 2,677개 채점된 실행입니다. 연구 원천은 METR의 공개 실행 기록 MALT에서 가져온 RE-Bench와 HCAST 연구 부분의 47개 과제, 1,132개 실행입니다. 생성자는 원천 기록을 읽어 분기를 제안하고, 정해진 기준에 맞지 않는 사례를 거부합니다.
그다음 두 단계의 판정이 이어집니다. 쉬운 문항 필터는 과제나 기록 없이 두 후보만 보여 줬는데 모든 판정자가 정답을 고른 문항을 제거합니다. 선택지의 어투나 상식적 우열만으로 답할 수 있다면 실행 문맥에 대한 판단을 측정하지 못하기 때문입니다. 판정 불명확 문항 필터는 과제·후속 실행·최종 결과를 모두 보였을 때 모든 판정자가 레이블에 동의한 경우만 남깁니다.
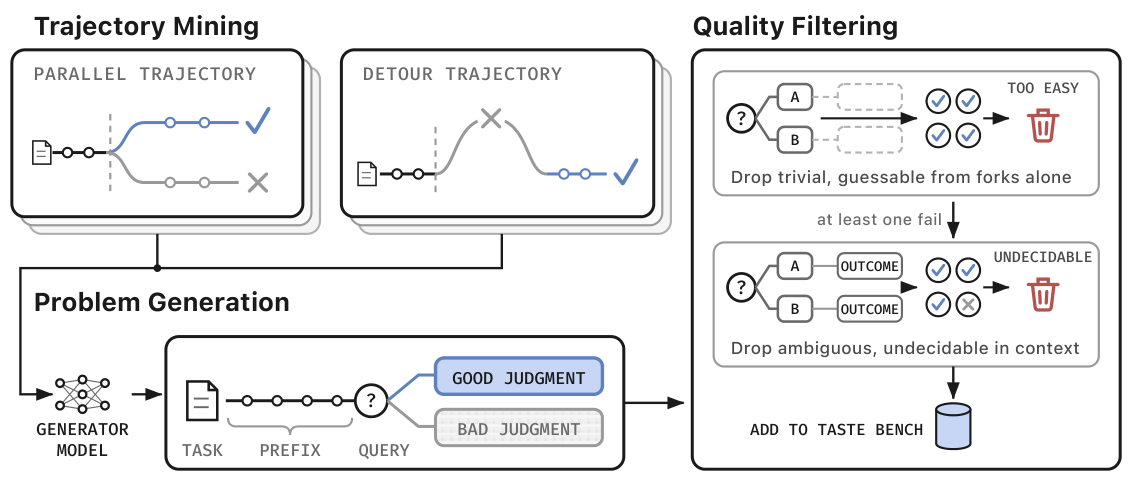
Figure 2, PDF 4쪽. 2609.25804v2 원본의 그림 영역만 크롭했으며 번역하거나 재배열하지 않았습니다.
그림 왼쪽은 두 가지 데이터 생성 경로를, 오른쪽은 서로 반대되는 정보 조건의 필터를 보여 줍니다. 후보만 볼 때에는 모든 판정자가 쉽게 맞히지 못하지만, 전체 결과를 볼 때에는 모두 같은 답을 지지해야 최종 문항으로 남습니다. 4,657개 최초 후보 중 502개, 약 10.8%가 최종 공개됩니다. 구성별·도메인별 문항 수는 병렬 엔지니어링 124, 병렬 연구 48, 우회 엔지니어링 266, 우회 연구 64입니다.
사람 검토는 별도로 수행합니다. 100문항을 두 사람이 검토하고 결과 공개 이후의 판단을 조사했을 때, 명시적인 A/B 응답 172개 중 170개가 채굴된 레이블과 일치했습니다. 98.8%는 이 조건부 일치율이며, 200개 전체 응답이나 결과를 보기 전의 선택 정확도가 아닙니다. 두 사람 모두 A/B를 고른 74문항에서는 73개가 일치하고 Cohen의 $\kappa$는 0.973입니다. 표본 구성과 제외 응답은 부록 F에서 다시 설명합니다.
3.4 Evaluation protocol
각 문항의 두 선택지를 시드 순서와 역순으로 제시합니다. 두 번 모두 정답인 문항 비율이 주 지표이며, 두 제시의 평균 정확도도 함께 보고합니다. 이 방식에서는 내용상 같은 후보를 일관되게 선택하는 능력까지 요구됩니다. 이 장은 실행 기록을 레이블과 평가 입력으로 변환하는 전체 절차를 제공하며, 다음 장에서 이 문항들이 모델과 시간 지평에 따라 어떤 차이를 드러내는지 조사합니다. §3
📖 Chapter 4: Experimental Results
4.1 Setup
총 14개 모델을 동일한 인터페이스와 토큰 예산으로 평가합니다. Claude, GPT, Grok, DeepSeek, GLM, MiniMax, Mistral 계열을 포함하며, 개별 추론 설정은 부록 C에 정리되어 있습니다. 모든 모델에 같은 수준의 추론 설정을 강제로 부여한 것은 아니므로, 동일 입력·출력 한도와 동일 추론 조건을 혼동하지 않아야 합니다.
주요 순위에 사용하는 Average는 두 도메인의 정확도를 1:1로 평균합니다. 문항 수가 많은 엔지니어링이 순위를 지배하지 않게 한 설계입니다. 정확도는 두 순서에서 모두 맞힌 비율이고 무작위 기준선은 25%입니다.
4.2 Accuracy of current models
GPT-5.6 Sol이 Average 59.7%, GPT-5.5가 59.5%를 기록합니다. Sol의 엔지니어링·연구 정확도는 각각 56.9%, 62.5%이고, GPT-5.5는 55.6%, 63.4%입니다. 따라서 최고 모델에서도 이 평가의 분기 판단이 안정적으로 해결되지는 않았다는 것이 저자의 해석입니다. Figure 3은 각 도메인의 순위를 별도로 정렬하며, 실선 막대는 두 순서 모두 정답, 점선 연장은 두 순서 평균 정확도를 나타냅니다.
이 둘의 차이는 위치를 뒤집었을 때 정답 선택이 유지되지 않는 문항을 반영합니다. 다만 상위 두 모델의 0.2%p 차이를 곧바로 우열의 통계적 증거로 읽어서는 안 됩니다. 원문은 문항 부트스트랩 95% 구간을 제공하지만, 이 두 모델 사이의 차이에 대한 별도 유의성 검정은 보고하지 않습니다.
4.3 Effect of the time horizon
시간 지평은 분기 시점에서 얼마만큼의 미래 정보를 알아야 정답을 명확히 정당화할 수 있는지를 뜻합니다. 이미 접두 기록에 결정적 사실이 있는 in prefix, 여러 단서를 종합하면 충분한 inferable, 다음 관측 한 번으로 밝혀지는 next step, 로컬 검증이나 더 많은 후속 작업이 필요한 more work로 나눕니다.
14개 모델의 평균 정확도는 이 순서대로 62.3%, 42.9%, 31.5%, 21.0%입니다. 마지막 범주는 무작위 기준선인 25% 부근까지 떨어집니다. 여기서 시간 지평은 경과 시간이나 토큰 수를 직접 잰 연속 변수가 아니라, GPT-5.5가 문항의 근거를 읽고 부여한 순서형 범주입니다. 모든 문항이 미래 증거를 필요로 하는 것도 아니며, 158문항은 이미 접두 기록에 결정적 근거가 있는 범주입니다.
Figure 4 왼쪽의 진한 선은 14개 모델의 평균이고 95% t 구간은 그 모델 평균의 구간입니다. Figure 3의 문항 부트스트랩 구간과 표본 단위가 다릅니다. 결과는 평균적으로 미래 근거가 더 필요한 분기가 어렵다는 관측을 뒷받침합니다.
4.4 Effect of the reasoning budget
저자는 어려운 분기를 더 오래 추론하면 해결할 수 있는지 보기 위해 Sol과 Luna에 각 세 가지 추론 설정을 적용합니다. 문항, 프롬프트, 토큰 한도와 채점 방식을 유지한 총 여섯 조건에서 6,024개 응답을 얻습니다. 가장 낮은 설정에서 가장 높은 설정으로 갈 때 전체 문항 정확도는 Sol에서 −0.2%p, Luna에서 +2.2%p 변합니다.
부록 D.4의 대응 문항 부트스트랩 95% 구간은 각각 [−3.2, +2.8]%p와 [−1.6, +6.0]%p로 0을 포함합니다. 추론 예산과 시간 지평의 상호작용 검정도 Sol $p=0.80$, Luna $p=0.82$입니다. 따라서 이 실험 범위에서 전체 정확도의 명확한 증가를 확인하지 못했다는 식으로 읽는 것이 정확합니다. 연구 도메인만 보면 Luna는 43.8%에서 54.5%로 증가한다는 별도 결과도 있으므로, 모든 하위 집단에서 변화가 전혀 없었다고 요약할 수는 없습니다.
추론을 사용하는 모든 설정에서 가장 많은 추론 토큰을 쓴 범주는 more work였지만 정확도는 가장 낮았습니다. 저자는 이를 모델이 어려운 분기를 인식해 오래 추론해도, 결정적인 근거가 후속 실행에 나타나는 경우에는 그것만으로 충분하지 않다는 관측으로 해석합니다.
4.5 Comparison with end-to-end benchmarks
Taste-Bench가 단순히 기존 과제 수행 순위를 되풀이하는지 확인하기 위해 SWE-bench Verified 공개 점수와 비교합니다. Vals AI의 공통 실행 체계(harness) 결과를 사용하며, 제시된 응답의 9% 초과가 파싱되지 않은 세 모델을 제외한 11개 모델이 비교 대상입니다.
Average와 SWE-bench Verified 사이의 Pearson 상관은 $r=+0.63$, 설명력은 $R^2=0.39$입니다. 엔지니어링 부분만의 상관은 $r=+0.37$입니다. SWE-bench Verified 상위 네 모델은 해당 벤치마크에서 4.0%p 범위에 모이지만 Taste-Bench Average에서는 10.7%p 차이를 보입니다. 이는 두 측정이 일부 관련되면서도 모델을 다르게 구분함을 보여 줍니다.
부록 D.2는 모델 수가 적어 상관의 95% 구간이 넓고, 모델별 추론 설정이 두 평가에서 모두 일치하지 않는다는 해석 조건을 명시합니다. 그러므로 이 결과를 완전히 독립적인 능력의 증명으로 단정하지는 않습니다. 이 장은 측정의 변별력을 보여 주고, 다음 장은 관측된 판단 부족을 학습으로 개선할 수 있는지로 이동합니다. §4, 부록 D
📖 Chapter 5: Generalizing Taste through Distillation
5.1 Distillation recipe
학습에는 엔지니어링 390문항을 사용합니다. 원천 과제가 겹치지 않는 두 폴드로 나누고, 한 폴드에서 학습한 학생을 다른 폴드에서 평가합니다. 폴드(fold)는 교차 평가를 위한 데이터 부분집합입니다. 같은 과제에서 생긴 여러 분기가 학습과 평가에 나뉘지 않도록 과제 단위로 분리한다는 점이 중요합니다.
저자는 이진 레이블만 직접 맞히는 방식은 중간 판단 과정을 제공하지 않으므로 정답을 외우는 방향으로 흐를 수 있다고 설명합니다. 대신 교사에게 정답 후보의 짧은 설명을 추가로 주고 추론과 최종 선택을 생성하게 합니다. 교사와 학생은 같은 Qwen3.6-27B 기반 모델이지만, 학생의 문맥에서는 정답 설명을 제거합니다. 교사가 만든 토큰 시퀀스에 대해 학생과 교사의 분포를 맞추는 SDPO 계열의 증류를 수행합니다.
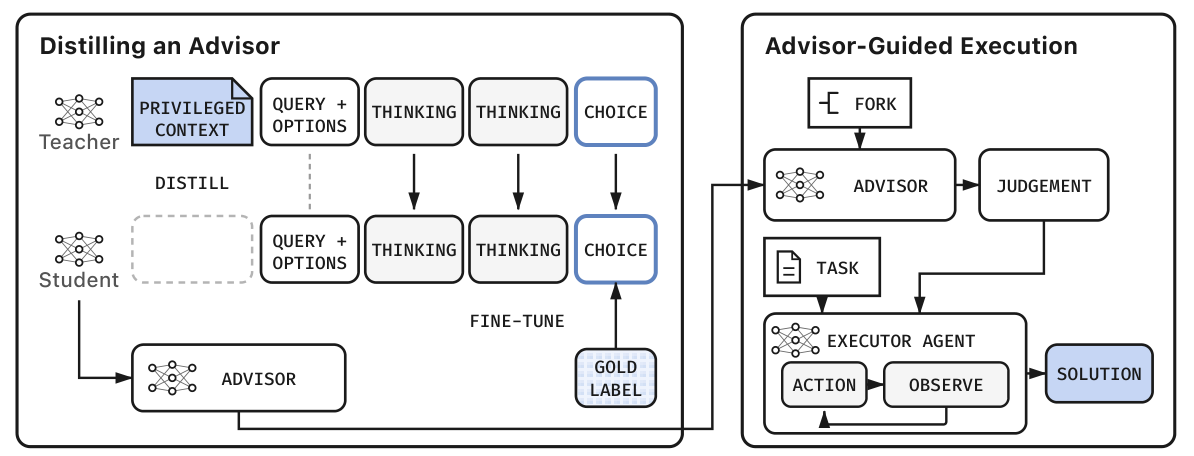
Figure 6, PDF 8쪽. 2609.25804v2 원본의 그림 영역을 크롭했으며 번역·재배열하지 않았습니다.
왼쪽 그림의 추가 문맥은 교사가 정답 방향을 알게 하는 학습용 정보입니다. 학생의 일반 문항에는 들어가지 않습니다. 오른쪽의 조언자와 실행자는 역할이 분리됩니다. 실제 §5.3 실험에서는 과거 실행에서 채굴한 분기에 대한 조언을 과제 시작 전에 문맥에 넣고 실행자는 독립적으로 작업합니다. 그림을 실시간 분기 발견·호출의 구현 증거로 해석하지 않아야 합니다.
5.2 Transfer to unseen tasks
학습 폴드에서 한 순서의 정확도는 48.6%에서 92.9%로 증가합니다. 그러나 이 수치는 학습 예제에서의 개선이므로 전이 성능을 판단할 핵심 증거는 별도 평가 폴드입니다. 과제가 겹치지 않는 평가를 합친 390문항에서는 두 순서 모두 정답인 비율이 기반 모델 30.0%에서 학생 47.9%로 높아집니다. 증가는 17.9%p이며 두 제시 평균 정확도는 42.7%에서 62.4%로 상승합니다.
여기서 미관측은 학습에서 제외한 과제를 뜻합니다. 두 폴드에는 같은 11개 저장소가 모두 포함되므로, 처음 보는 저장소에 대한 전이 실험은 아닙니다. 원문은 질문, 과제, 원천 궤적과 접두 기록이 폴드 간 겹치지 않음을 검사했다고 밝힙니다. 이 설계는 같은 과제의 답을 직접 학습한 효과와 과제를 넘어 전달된 판단 능력을 구분하는 데 기여합니다.
5.3 End-to-end evaluation
판단 개선이 실제 작업에도 도움이 되는지 보려고, 41개 학습 제외 SWE-bench Pro 과제에서 Qwen3.6-27B 실행자를 고정하고 세 조건을 비교합니다. 조언 없음, 모든 분기에 정답 방향을 적은 조언, 학생이 선택한 방향을 적은 조언입니다. 조언에는 분기 상황과 피할 방향·택할 방향을 넣습니다. 분기들은 이 과제들의 과거 실행에서 이미 채굴되어 새 실행 전에 이용 가능합니다.
성공률은 조언 없음 14.6%, 정답 조언 39.0%, 학생 조언 33.7%입니다. 학생 조언의 증가는 19.1%p이고, 정답 조언의 증가는 24.4%p입니다. 저자가 말하는 상한은 이 조언 제공 설정에서 모든 방향을 맞혔을 때의 비교값이며 모든 가능한 에이전트 성능의 절대 상한을 뜻하지 않습니다.
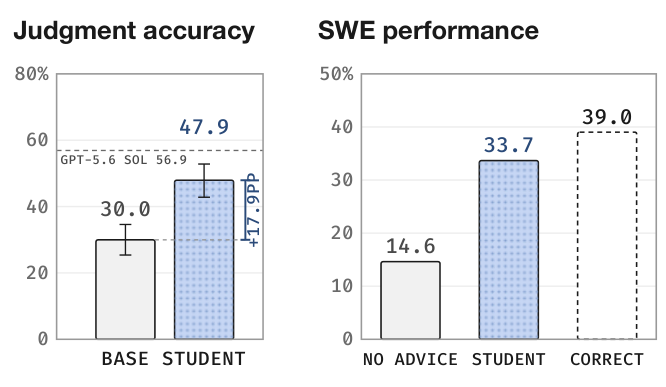
Figure 7, PDF 9쪽. 2609.25804v2 원본의 두 패널을 함께 크롭했습니다. 축·오차 막대·점선과 원문 수치를 보존했으며 번역하지 않았습니다.
왼쪽 패널은 판단 정확도이고 오른쪽은 공식 과제 평가가 패치를 받아들인 성공률입니다. 서로 분모가 다릅니다. 그림의 95% 문항 부트스트랩 구간은 왼쪽 판단 평가에 해당하며, 오른쪽 막대에 같은 통계 구간이 있다고 해석해서는 안 됩니다. 33.7%를 41개 과제의 정수 성공 건수로 역산하지도 않습니다. 원문은 해당 비율을 보고하지만 학생 조언 성공률의 반복 실행 횟수나 세부 집계 방식은 명시하지 않습니다.
이 장은 판단 학습과 실행 성과를 연결하며, 다음 장은 관련 평가·학습 방법 안에서 그 위치를 정리합니다. §5, Figure 6–7
📖 Chapter 6: Related Work
첫 소주제인 Long-horizon agent evaluation에서는 AgentBench, SWE-bench 및 SWE-bench Pro, MLAgentBench, RE-Bench를 과제 완료 여부를 측정하는 연구로 정리합니다. Taste-Bench는 그 과제 안에서 더 나은 방향을 선택했는지 묻는다는 차이를 둡니다.
이어 Judging research directions before the outcome에서는 실행 전에 연구 아이디어나 ML 해결책, AI 안전 연구 제안을 평가하는 연구를 다룹니다. 저자의 구분은 독립적인 제안끼리 비교하는 대신 실제 궤적 중간의 상황과 이후 기록된 결과를 함께 이용한다는 점입니다. 선택지의 품질만이 아니라 해당 시점의 문맥에 적절한지를 판단합니다.
Process evaluation and step-level judgment에서는 사람 레이블이나 후속 실행 결과를 이용한 과정 감독, 에이전트 행동의 선호 학습, 과정 보상 모델, 전체 궤적 평가와 실패 단계 추적을 함께 다룹니다. Taste-Bench의 평가자는 결과를 보기 전에 선택하고, 정답은 이후 기록에서 정해진다는 차이를 강조합니다. Distillation and internalizing context에서는 일반 지식 증류와 문맥 증류, STaR, LEAP, SDPO 및 조언 모델과의 연결을 설명합니다. 특히 SDPO에서 환경 피드백 자리를 정답 후보 시연으로 바꾸고 교사에서 목표 시퀀스를 샘플링한 구성이 자신의 선택이라고 설명합니다.
이 장은 새로운 평가 단위와 기존 증류 방법의 조합이 어디에 위치하는지 밝힙니다. 관련 문헌에 대한 서술은 이 논문의 비교를 요약한 것이며, 인용된 모든 원문을 독립적으로 재검토했다는 뜻은 아닙니다. 다음 장은 측정과 학습이라는 두 흐름을 결론으로 모읍니다. §6
📖 Chapter 7: Conclusion
결론은 결과를 보기 전에 더 좋은 방향을 고르는 능력을 기존 실행 기록으로 측정할 수 있다는 주장으로 돌아옵니다. 502문항의 Taste-Bench를 구성하고, 정답 방향을 아는 교사의 추론을 증류하면 미관측 과제의 판단과 조언을 통한 실행 성공률이 개선된다는 결과를 묶습니다. 저자는 이를 장기 에이전트의 판단력을 측정하고 학습하기 위한 실용적 토대로 제시합니다.
이어지는 Reproducibility Statement는 고정된 벤치마크 버전, 프롬프트, 긴 기록 처리, 채점, 기반 모델 버전과 시드·분할·추론 설정을 명시했다고 설명합니다. 논문은 데이터셋과 평가 코드·기록 결과의 공개 경로를 제공합니다. 이 리뷰에서는 링크가 원문에 제시됨을 확인했으며, 저장소 코드 실행이나 실험 재현을 수행한 것은 아닙니다.
Ethics Statement는 기술적 실행 기록과 두 사람의 검토를 사용하고, 모델에 보내기 전에 자격 증명 문자열을 제거하며, 장기 판단 능력 측정의 이중 용도 위험을 인식한다고 밝힙니다. AI Use Statement는 합성 데이터, 실험·방법 설계, 구현과 해석, 집필·번역·그림·문헌 검색 등에 생성형 AI를 활용했으며 최종 내용의 책임은 저자에게 있다고 명시합니다. 이후 참고문헌과 부록이 구성·평가·증류의 세부 근거를 제공합니다. §7 및 선언문
📖 Chapter A: Benchmark Construction Details
A.1 Source trajectories
엔지니어링 풀은 2026년 4–7월, 31번의 실행 묶음에서 수집한 11개 저장소의 517과제·2,677개 채점 기록입니다. 연구 풀은 원래 점수가 기록된 MALT 실행만 남긴 47과제·1,132개 기록이며 Claude 3.5 Sonnet, 3.7 Sonnet, Sonnet 4, Opus 4와 DeepSeek V3 에이전트가 생성했습니다.
연구 우회 구성은 첫 통과에서 896개, 두 번째에서 추가 입력 437개를 처리했다고 기록합니다. 이는 처리 입력 수이며 고유 원천 풀의 1,132개와 같은 종류의 수가 아닙니다. 연구 병렬 구성은 905개 후보 쌍 중 점수 비교가 불가능하거나 두 기록의 합이 생성자 문맥 한도를 넘는 쌍을 제외한 600쌍을 입력으로 사용합니다.
A.2 Statistics of the mined forks
병렬 쌍은 과제당 최대 여덟 개로 제한하고 같은 모델·같은 추론 설정의 시도를 먼저 짝짓습니다. 공개된 엔지니어링 병렬 124문항 중 111개는 같은 모델끼리, 13개는 GPT-5.5와 GPT-5.4의 실행을 비교합니다. 연구 병렬 48개는 모두 같은 모델의 실행 쌍입니다. 따라서 §2의 이상적인 동일 조건 비교가 실제 데이터에서 어떻게 구체화되었는지는 이 구성 정보와 함께 읽어야 합니다.
우회 구성은 잘못된 행동, 관측된 실패, 회복 행동, 성공 근거라는 네 발췌를 요구합니다. 발췌가 인용한 단계에 실제로 존재하는지, 시간 순서가 맞는지, 실패 신호가 있는지는 기계적으로 검사합니다. 단순한 개선 여지나 깨끗한 차이 목록을 실패로 간주하지 않습니다.
| 구성·도메인 | 문항 | 과제 | 원천 궤적 | 분기 이전 단계 수 중앙값 | 후보 단어 수 중앙값 |
|---|---|---|---|---|---|
| 병렬 엔지니어링 | 124 | 62 | 120 | 35 | 38 |
| 병렬 연구 | 48 | 8 | 32 | 56 | 27 |
| 우회 엔지니어링 | 266 | 133 | 266 | 47 | 23 |
| 우회 연구 | 64 | 22 | 64 | 30 | 22 |
원문 Table 1을 대조해 재작성했습니다. 셀 사이에 같은 과제가 포함될 수 있으므로 과제 수를 고유 과제 수처럼 단순 합산하지 않습니다.
A.3 Prompts of the generator and the judges
생성자는 GPT-5.6 Sol의 high 추론 설정입니다. 병렬 프롬프트는 과제·두 결과·두 전체 궤적을, 우회 프롬프트는 과제·실행 결과·전체 궤적을 받으며 JSON을 반환합니다. 병렬 생성 기준은 후보가 실제 행동을 나타내고, 비교 가능한 같은 하위 문제를 다루며, 분기 후 증거가 결과 차이를 설명하도록 요구합니다. 단순 오타·크래시·누락 의존성·제출 절차 차이 등을 좋은 판단과 나쁜 판단의 차이로 바꾸지 않도록 합니다. 점수 예측이나 파일 이름이 다를 뿐 실제 접근은 같은 사례도 제외합니다.
우회 프롬프트는 실패 이전 문맥으로도 회복 방향을 제안할 수 있어야 한다고 규정합니다. 이미 실패한 행동을 그대로 반복하는 선택지를 허수아비 대안으로 넣지 않습니다. 다만 환경 문제가 등장했다는 이유로 모든 사례를 버리지는 않습니다. 도구가 없음을 이미 알게 된 뒤, 호스트를 계속 탐색할지 고정 컨테이너를 쓸지 같은 실제 전략 선택이 다시 생기면 그 두 번째 순환에서 분기를 찾도록 합니다. 병렬 구성의 배제 기준과 우회 구성의 재배치 조건은 이렇게 구별됩니다.
판정자는 생성자와 겹치지 않는 Kimi K2.5, GPT-4.1, Llama 4 Maverick, Mistral Large 3의 네 모델입니다. 같은 패널을 네 셀에 적용하고 선택지 순서를 섞습니다. 첫 필터는 후보 텍스트만, 둘째 필터는 과제와 접두 기록, 양쪽 전체 후속 실행과 원래 평가기의 결과를 보여 줍니다. 프롬프트의 목적은 문장 표현으로 답을 유출하지 않으면서 결과로 정당화 가능한 분기를 남기는 것입니다.
A.4 Counts at each stage
Figure 8의 단계별 수는 4,657 → 1,809 → 729 → 502입니다. 각각 초기 후보, 생성자 기준 통과, 쉬운 문항 필터 통과, 최종 공개 문항입니다. Table 2에서 Proposed라고 부르는 1,809개는 최초 4,657개와 단계가 다릅니다. 엔지니어링 병렬은 562개 중 124개, 연구 병렬은 186개 중 48개, 엔지니어링 우회는 658개 중 266개가 공개됩니다. 연구 우회는 첫 통과 241개 중 40개, 둘째 통과 162개 중 24개입니다.
제거 예시는 필터의 목적을 구체화합니다. 세 개 문제의 답만 하드코딩한 접근과 일반 풀이 파이프라인을 비교한 문항은 선택지만으로 답할 수 있어 제외됩니다. 다른 예시는 희소 적대적 공격입니다. 접두 기록의 앙상블 성능은 성공률 0.80·평균 3픽셀이고 단일 픽셀 공격의 앞선 성공률은 0.43인데, 앙상블의 나중 시간 초과만으로 반대 레이블이 붙었습니다. 과제에 시간 예산이 명시되지 않아 전체 기록으로도 그 레이블을 지지하기 어렵다는 이유로 제거합니다. 이 부록은 결과만 보고 무조건 정답을 만들지 않는 기준을 보여 주며, 다음 부록은 통과한 문항을 사례별로 제시합니다. 부록 A, Table 1–2
📖 Chapter B: Example Questions
이 부록은 네 셀에서 한 문항씩, 과제·접두 기록 발췌·두 후보·정답을 지지하는 사후 증거의 순서로 보여 줍니다. 제시된 접두 기록은 지면상 단축된 예시이며 전체 평가 입력과 동일한 길이는 아닙니다.
병렬 엔지니어링 사례는 Element Web의 인증 탐색 결과를 검증된 설정으로 옮기는 작업입니다. 성공한 인증 블록에서 요구된 다섯 필드만 선택할지, 탐색 블록 전체를 그대로 대입할지 비교합니다. 후자는 SDK의 상태·오류 필드까지 포함하지만 숨겨진 테스트는 필요한 엔드포인트 필드만 포함하는 객체를 기대했습니다. 선택적 필드 구성은 통과하고 전체 블록 대입은 실패합니다. 겉보기로 간단한 전달 방식도 반환 객체의 계약을 보존하는지에 따라 결과가 달라집니다.
병렬 연구 사례는 GPT-2의 공유 토큰 임베딩만 손상된 모델을 복원합니다. 다른 파라미터를 고정한 채 손상된 임베딩을 OpenWebText에서 직접 학습하는 방향과 전역 배율을 더 촘촘히 탐색하는 방향을 비교합니다. 직접 학습은 200회 반복 후 검증 손실 7.3821을, 배율 탐색의 최선은 표준편차 0.032에서 10.1482를 기록합니다. 과제의 목적 함수는 $\log(\text{validation loss}-1.5)$로 낮을수록 좋습니다. 여기서 validation loss는 검증 손실이며 1.5를 뺀 뒤 로그를 적용합니다. 보고된 두 손실은 이 변환에서도 낮은 쪽의 순서가 유지됩니다.
우회 엔지니어링 사례는 Ansible 문서의 누락 메타데이터 표시를 다룹니다. 기본 요약·문서 도우미의 반환 구조를 확장하는 접근은 해당 함수를 직접 호출하는 기존 테스트에서 3개 실패·25개 통과를 냅니다. 기본 구조를 유지하면서 실제 문서 생성 호출 경로에 표시를 붙이도록 바꾼 뒤에는 28개가 통과합니다. 이 문항은 호환성 요구를 어느 계층의 변경으로 만족시킬지 묻습니다.
우회 연구 사례는 1,000개 데이터 행을 오차 $10^{-6}$ 이내로 맞추는 수식을 찾습니다. 접두 기록에서 $1/X4$가 강하게 관련되어 있고 잔차는 $X3$와 관련됩니다. 선형 회귀로 잔차를 탐색한 접근의 가까운 후보는 최대 절대 오차 약 0.54016으로 실패하지만, 허용된 단항 연산자를 순회해 찾은 식은 다음과 같습니다.
$X3$와 $X4$는 입력 변수이고, 역수항은 이미 찾은 주된 성분, 코사인항은 남은 잔차를 설명합니다. 이 식의 최대 절대 오차는 $5.13\times10^{-10}$이며 모든 행이 허용 오차를 만족합니다. 이 식은 논문의 새로운 일반 알고리즘이 아니라 부록 사례의 관측된 정답입니다. 네 예시는 분기 이후 결과가 어떤 형태로 정답을 지지하는지 보여 주며, 다음 부록은 이를 모델에게 일관되게 제시하는 방법을 설명합니다. 부록 B
📖 Chapter C: Evaluation Protocol Details
모든 평가 모델은 동일한 시스템·사용자 메시지를 받습니다. 시스템 메시지는 정확히 한 후보가 더 좋은 기술적 결정이라고 규정하고, 사용자 메시지는 과제·접두 기록·두 후보를 제시한 뒤 ANSWER: X 한 줄을 요구합니다. 내부 추론 사용 여부와 별개로 최종 선택을 쉽게 추출하기 위한 형식입니다. 한 글자만 반환한 응답도 인정하지만, 파싱되지 않는 응답은 오답입니다.
접두 기록은 단계별로 에이전트 메시지, 명령과 종료 코드·출력, 수정 경로를 표시합니다. 명령 출력이 700자를 넘으면 앞부분과 뒷부분을 유지하고 생략 문자 수를 표시합니다. 전체 프롬프트 한도는 65,536토큰이며 넘치면 과제 설정을 포함한 처음 25줄과 한도에 맞는 가장 긴 뒷부분을 남깁니다. 주 평가에서는 Claude Opus 5와 Sonnet 5 각각 한 문항만 이 프롬프트 한도에 도달했고 다른 모델에서는 없었습니다.
모든 모델의 출력 예산도 65,536토큰입니다. Sol·GPT-5.5는 xhigh, Mini·Nano·Grok 4.5·Mistral Medium 3.5는 high, DeepSeek V4 Flash와 GLM-5.2는 max를 사용합니다. Sonnet 5는 adaptive thinking이고 나머지 표기 모델은 기본값을 사용하며, GLM-5.2의 온도는 1.0입니다. Figure 3의 95% 구간은 각 도메인 안에서 문항을 재표집한 4,000회 백분위 부트스트랩으로 계산합니다. 이 부록은 점수를 해석하고 재현하는 입력·출력·채점 조건을 제공하며, 다음 부록은 전체 수치와 추가 분석을 제시합니다. 부록 C, Table 3
📖 Chapter D: Full Results
D.1 Results per model and per cell
Table 4는 14개 모델의 네 셀 정확도, 두 제시 평균, 그리고 두 응답의 결합 결과를 제공합니다. CC는 양쪽 정답, CW와 WC는 한 순서만 정답, WW는 양쪽 오답입니다. Sol은 502문항에서 CC 292, CW 25, WC 29, WW 156이며 파싱 실패는 없습니다. CC를 502로 나눈 전체 문항 정확도는 도메인 1:1 Average인 59.7%와 집계 방식이 다릅니다.
| 모델 | Average | 엔지니어링 | 연구 | 두 제시 평균 | 파싱 실패 / 1,004제시 |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 59.7 | 56.9 | 62.5 | 65.2 | 0 |
| GPT-5.5 | 59.5 | 55.6 | 63.4 | 64.6 | 0 |
| Claude Opus 5 | 55.5 | 46.7 | 64.3 | 60.3 | 0 |
| Grok 4.5 | 54.6 | 52.1 | 57.1 | 62.0 | 10 |
| GPT-5.6 Terra | 54.0 | 50.0 | 58.0 | 62.2 | 0 |
| GLM-5.2 | 53.9 | 47.9 | 59.8 | 64.0 | 17 |
| Claude Sonnet 5 | 51.6 | 44.4 | 58.9 | 60.7 | 0 |
| GPT-5.6 Luna | 49.0 | 43.6 | 54.5 | 58.9 | 0 |
| MiniMax M3 | 45.3 | 44.1 | 46.4 | 57.2 | 3 |
| DeepSeek V4 Flash | 43.3 | 38.5 | 48.2 | 54.9 | 2 |
| GPT-5.4 Mini | 40.1 | 25.6 | 54.5 | 49.5 | 112 |
| Mistral Medium 3.5 | 37.7 | 41.5 | 33.9 | 51.8 | 24 |
| GPT-5.4 Nano | 36.6 | 32.1 | 41.1 | 48.8 | 93 |
| Grok 4.20 Reasoning | 15.7 | 22.6 | 8.9 | 29.0 | 459 |
Table 4에서 해당 열을 대조해 재작성했습니다. 정확도 단위는 %이고 파싱 실패는 건수입니다.
셀별 14개 모델 평균은 병렬 엔지니어링 58.1%, 병렬 연구 50.9%, 우회 연구 50.8%, 우회 엔지니어링 35.9%입니다. 연구가 언제나 더 어려운 것은 아닙니다. 구성 방식 차이가 도메인 차이보다 크며, 특히 엔지니어링 우회는 실행 에이전트가 나중에야 알아챈 오류를 먼저 인식해야 하는 어려움을 보여 줍니다. 연구의 병렬·우회 평균은 거의 같으므로 모든 도메인에서 큰 우회 격차가 있는 것으로 확대하지 않습니다.
D.2 Comparison with SWE-bench Verified
DeepSeek V4 Flash는 비교 대상 11개 모델 중 SWE-bench Verified 5위, Taste-Bench 10위이며, GPT-5.5는 각각 8위와 2위입니다. 전자의 파싱 실패는 1,004개 중 2개뿐이므로 이 순위 변화 전체를 출력 형식 문제로 설명하지는 못합니다.
Average 상관의 95% 구간은 [+0.04, +0.89]이고 $p=0.04$입니다. 엔지니어링 상관 구간은 [−0.30, +0.79]입니다. 저자가 명시한 작은 비교 표본과 추론 설정 불일치라는 해석 범위를 함께 유지해야 합니다.
D.3 Time horizon annotation
주석 모델 GPT-5.5는 과제, 접두 기록, 두 후보와 정답을 보고 근거 한 문장과 점수를 반환합니다. 원래 프롬프트는 0–4의 다섯 단계를 사용합니다. 3은 간단한 로컬 검증, 4는 상당한 후속 작업인데, 4에 해당하는 문항이 13개뿐이어서 3의 56개와 합쳐 more work 69개로 보고합니다.
| 보고 범주 | 문항 수 | 14개 모델 평균 정확도 |
|---|---|---|
| In prefix | 158 | 62.3% |
| Inferable | 219 | 42.9% |
| Next step | 56 | 31.5% |
| More work | 69 | 21.0% |
Table 5–6을 대조했습니다. More work는 간단한 로컬 검증과 상당한 후속 작업을 합친 범주입니다.
Table 6은 개별 모델별 결과도 보여 줍니다. 예를 들어 Sol은 in prefix 79.7%에서 more work 21.7%로, GPT-5.5는 75.9%에서 23.2%로 변합니다. 모든 모델의 각 인접 단계가 엄밀히 단조 감소하는 것은 아니므로, 원문의 주요 결론인 모델 평균의 하락과 구분합니다.
D.4 Reasoning budget
Table 7의 전체 문항 정확도는 Sol low/xhigh/max가 56.2/55.6/56.0%, Luna none/high/max가 43.4/45.8/45.6%입니다. 이는 Figure 3의 도메인 균등 Average가 아니며, 별도의 추론 예산 실험 실행값입니다. 같은 xhigh 이름이 있다고 주 평가의 59.7%와 직접 같은 값으로 취급해서는 안 됩니다.
가장 낮은 설정과 가장 높은 설정의 차이는 문항을 함께 재표집하는 10,000회 부트스트랩으로 계산합니다. 앞서 설명한 신뢰구간과 로지스틱 상호작용 분석은 전체 개선이 뚜렷하지 않다는 해석을 뒷받침합니다. 6,024개 응답 중 토큰 한도에 도달한 것은 없고 파싱 불가는 한 개입니다. 따라서 이 실험에서 단순한 출력 예산 소진이 주된 설명으로 제시되지는 않습니다. 이 부록은 각 주장을 해당 집계·통계 조건에 연결하고, 다음 부록은 문항 선별 판정자들의 행동을 점검합니다. 부록 D, Table 4–7
📖 Chapter E: Agreement of the Judges
Table 8은 병렬 엔지니어링 셀에서 선택지만 보인 판정자의 정확도를 보고합니다. 제안 문항에서 Kimi K2.5, GPT-4.1, Llama 4 Maverick, Mistral Large 3는 각각 84.7%, 85.8%, 75.6%, 82.0%였지만 최종 공개 문항에서는 55.6%, 63.7%, 34.7%, 59.7%입니다. 공개 문항에서 판정자 쌍의 일치율은 51.7%입니다.
이는 후보 표현만으로 답할 수 있는 문항을 제거한 뒤의 변화를 보여 줍니다. 전체 기록을 보는 두 번째 필터에서 공개 문항의 판정자가 모두 정답을 고르는 것은 선택 기준 자체가 만장일치이기 때문입니다. 그러므로 이 만장일치를 독립적인 추가 검증 성능으로 세지 않습니다. 다음 부록의 사람 검토는 모델 필터와 별도로 레이블을 점검하는 자료입니다. 부록 E, Table 8
📖 Chapter F: Human Review
F.1 Sampling and annotation
사람 검토의 100문항은 공개 문항 70개, 쉬운 문항 필터로 제거된 15개, 판정자들이 만장일치로 레이블을 지지하지 않아 제거된 15개입니다. 공개 문항만의 무작위 표본 100개로 설명하면 안 됩니다. 네 구성·도메인 셀과 시간 지평을 고려해 표집하고 순서를 섞되, 두 검토자에게는 같은 후보 순서를 보여 줍니다.
첫 단계는 분기 시점에 어떤 방향을 고를지 묻고 A/B/모르겠음을 허용합니다. 두 번째는 기록된 후속 작업과 결과 요약을 공개한 후 어느 판단이 더 좋았는지 묻습니다. 이때 실질적 우열이 없거나 해당 선택으로 결과 차이를 설명할 수 없다는 응답도 허용합니다. 레이블 일치율은 두 번째 단계의 명시적 A/B 응답만 사용합니다.
검토자 1은 100개 중 87개를 명시적으로 선택했고 그중 86개가 레이블과 일치합니다. 검토자 2는 85개 중 84개가 일치합니다. 합치면 170/172, 98.8%입니다. 둘 다 A/B를 선택한 74문항에서는 73개, 98.6%가 서로 일치하며 Cohen의 $\kappa=0.973$입니다. $\kappa$는 우연히 같은 답을 고를 가능성을 보정하는 일치도 지표입니다. 이 결과는 결과를 본 뒤 명시적인 선택을 한 판단의 높은 일치를 보여 주며, 결과를 보기 전 사람의 예측 정확도나 모든 표본의 정답 확실성을 나타내지는 않습니다. 다음 부록은 레이블을 모델 학습에 사용하는 구체적인 절차로 이어집니다. 부록 F, Table 9
📖 Chapter G: Distillation Details
G.1 Recipe
교사와 학생은 같은 고정 Qwen3.6-27B 기반 모델에서 출발합니다. 학생 문맥은 과제·접두 기록·두 후보이며, 후보 순서를 뒤집은 두 뷰를 문항마다 만듭니다. 교사에는 정답 후보를 택하고 다른 후보를 피하라는 참조 설명을 별도 제목으로 앞에 삽입합니다. 교사는 온도 1.0, 새 토큰 최대 3,072개로 각 뷰의 추론을 생성합니다.
추론 블록이 올바른 형식이고 최소 32토큰일 때 유지하며, 한 문항의 두 뷰가 모두 유지되어야 학습 문항으로 남습니다. 두 폴드에서 각각 390개 뷰 중 328개와 311개 추론이 조건을 통과하고, 최종적으로 156·142문항, 즉 312·284개 학습 뷰가 남습니다. 교사의 정답 선택은 유지된 추론 기준 328/328 및 310/311입니다. 이 수치는 교사가 정답 설명을 이미 본 조건의 결과입니다.
손실은 추론 위치의 분포 정합과 최종 답 위치의 정합으로 구성되며 가중치는 각각 1입니다. 추론 위치에서는 학생의 상위 100토큰과 나머지 확률 질량을 합친 추가 항을 이용하므로 남은 질량을 버리지 않습니다. 긴 추론에서는 최대 512개 위치를 균등하게 골라 계산합니다. 답 위치의 KL은 두 답 토큰으로 제한합니다. KL은 두 확률분포 차이를 측정하는 양이며, 여기서는 학생이 교사의 판단 시퀀스를 따르도록 하는 학습 신호입니다. 원문은 이를 forward KL로 기술하며 학생·교사 문맥 차이를 교사 샘플에서 비교한다고 설명합니다.
교사에서 시퀀스를 샘플링하는 이유도 명시합니다. 추가 시연 문맥으로 교사의 예측이 달라지는 토큰이 학생의 자유 생성에서는 드물 수 있으므로, 학생 샘플만 사용하면 교사의 선호를 충분히 전달하지 못한다는 것입니다. 누출 제어는 답을 두 후보 중 하나로 닫고 최종 답에서 출력을 끝내 시연 설명 자체를 출력으로 복사하지 않도록 하는 구조입니다. 이는 학생 입력에서 정답 설명을 제외하는 조건과 함께 사용됩니다.
증류 뒤에는 학습 폴드에서 학생이 자유롭게 생성한 추론을 사용해 마지막 선택을 보정합니다. 정답 레이블의 교차 엔트로피를 답 위치에 적용하며 두 폴드에서 306·320뷰를 사용합니다. 저자는 이 보정이 학생 자신의 추론 아래에서 최종 선택을 조절하며 추론 분포는 바꾸지 않는다고 설명합니다.
Table 10의 LoRA는 rank 16, $\alpha=32$, dropout 없음이며 모든 attention·MLP 투영에 적용합니다. rank는 어댑터의 저차원 크기, $\alpha$는 LoRA의 스케일 설정입니다. 학습 파라미터는 79.7M, 즉 7,970만 개입니다. AdamW와 기울기 노름 1.0 클리핑을 사용합니다. 증류는 학습률 $10^{-4}$, 2에폭, 단계당 한 뷰로 624·568단계이고, 보정은 $10^{-5}$, 1에폭, softmax 온도 2.0으로 306·320단계입니다. 시퀀스는 최대 10,240토큰이며 학습 데이터에서는 잘림이 없었습니다. A100 80GB 한 장에서 최대 메모리 71GB, 폴드별 증류 시간 2.1시간과 1.8시간을 보고합니다.
G.2 Folds
각 폴드는 195문항이며 병렬 62개·우회 133개로 균형을 맞춥니다. 과제 수는 각각 86개와 72개이고 11개 저장소가 양쪽에 모두 있습니다. 질문·과제·원천 궤적·접두 기록의 중복이 없음을 학습 전에 확인합니다. 학생 두 개를 각각 반대 폴드에서 평가한 결과를 모으므로 모든 평가 문항은 자신을 학습하지 않은 학생의 답으로 채점됩니다.
이 설계는 문항을 단순히 무작위 분할하는 것보다 과제 수준의 중복을 엄격히 통제합니다. 동시에 저장소 분리는 아니므로 일반화의 단위를 정확히 과제로 유지해야 합니다. Table 11은 NodeBB, ansible, element-web, flipt, vuls, teleport, openlibrary, navidrome, webclients, qutebrowser, tutanota의 폴드별 문항 수를 공개합니다.
G.3 Transfer results
학생은 390문항 중 187개, 기반 모델은 117개에서 두 순서를 모두 맞힙니다. 학생만 새로 맞힌 문항은 104개이고 기반 모델이 맞혔으나 학생이 틀린 문항은 34개입니다. 따라서 순증 70문항이 17.9%p 개선으로 연결됩니다. 모든 문항이 일방적으로 좋아지는 것은 아니라는 사실도 이 전환 수로 확인할 수 있습니다.
Figure 7의 판단 정확도 구간은 4,000회 문항 부트스트랩으로 계산합니다. 부록에 적힌 $p\approx8\times10^{-9}$는 학습 폴드의 한 순서 정확도 48.6% → 92.9%에 대한 값입니다. 학습 제외 문항의 30.0% → 47.9% 검정값으로 옮겨 붙이지 않습니다. 학생의 엔지니어링 정확도 47.9%는 GLM-5.2와 같고, Sol 56.9%·Terra 50.0%보다 낮으며 Opus 5의 46.7%보다 높습니다.
조언에는 문항당 한 결정을 써야 하므로 별도 결합 규칙을 적용합니다. 두 제시에서 답 토큰에 부여한 로그 오즈를 후보 방향에 맞춰 합산하고 합이 지지하는 후보를 고릅니다. 로그 오즈는 두 후보 확률의 비율에 로그를 취한 값입니다. 이 규칙에서는 학생이 287/390, 기반 모델이 207/390에서 정답을 고릅니다. 한쪽 제시의 실수를 다른 쪽의 확신이 보완할 수 있으므로, 두 번 모두 맞혀야 하는 47.9%와 같은 지표가 아닙니다. 다음 부록은 이 결정을 조언으로 바꾸어 실행자에게 전달하는 조건을 설명합니다. 부록 G, Table 10–11
📖 Chapter H: End-to-End Experiment Details
종단 간 평가의 41개 과제는 엔지니어링 분기가 하나 이상 채굴된 SWE-bench Pro 과제이며 총 98개 분기를 포함합니다. 저장소별 과제 수는 ansible·openlibrary 각 8개, qutebrowser 6개, vuls·tutanota 각 4개, element-web 3개, flipt·teleport·webclients 각 2개, NodeBB·navidrome 각 1개입니다. 두 구성이 모두 있는 두 과제에는 병렬 분기를 사용합니다. 각 과제의 조언은 그 과제를 포함하지 않는 폴드에서 학습한 학생이 작성합니다.
실행자는 SWE-agent 1.1.0과 Qwen3.6-27B이며 thinking을 끕니다. 온도 0.7, top-p 0.8, top-k 20, presence penalty 1.5를 사용합니다. 과제당 최대 모델 호출은 75회, 명령당 제한은 600초, 전체 시간은 4,800초이고 공식 SWE-bench Pro 컨테이너에서 수행합니다. 성공은 공식 평가가 제출 패치를 받아들이는 경우입니다.
조언은 첫 사용자 메시지의 원래 문제문 앞에 들어갑니다. 각 메모는 과거 분기의 상황, 피할 후보, 택할 후보를 기록합니다. 원문 템플릿은 과거에 성공한 방향을 따라갔다는 사실이 현재 패치의 증거가 아니며, 현재 세션에서 실제 검증을 수행해야 한다고 명시합니다. 또한 메모 상황을 일부러 찾거나 그에 맞춰 계획 전체를 바꾸지 말고 해당 상황에 자연스럽게 도달했을 때 참고하도록 합니다. Teleport 예시는 여러 HSM/KMS 백엔드로 구성을 확장하면서 PKCS#11 전용 경고문 단언을 그대로 둘지, 백엔드에 중립적인 단언으로 바꿀지의 분기를 보여 줍니다.
학생은 이 98개 분기 중 77개에서 정답 후보를 선택합니다. Table 12는 41개 과제별 분기 수와 학생의 정답 수를 모두 제공하며, 이는 패치 성공 과제 수가 아닙니다. 학생 조언은 항상 정답인 조언이 아니라 학생이 선택한 후보를 권하는 메모입니다. 이 조언 조건에서 보고된 실행 성공률은 33.7%입니다.
부록 H의 정확 McNemar 검정 $p\leq0.004$는 정답 조언과 조언 없음의 비교에 해당합니다. 학생 조언의 33.7%와 조언 없음의 차이에 대한 같은 검정값으로 사용하지 않습니다. 이 부록은 과제 선택, 실행 예산, 메모 형식과 판단 정확도를 제공해 종단 간 결과의 적용 범위를 구체화합니다. 부록 H, Table 12
실험 결과 심층 분석
이 논문의 결과는 세 층으로 나누어 읽어야 합니다. 첫째는 측정의 어려움입니다. 502문항의 최고 Average 59.7%는 14개 비교 모델 가운데 가장 높은 도메인 균등 평균이며, 두 순서 모두 맞혀야 하는 조건입니다. 두 후보라는 이유만으로 50%를 무작위 기준으로 적용하면 점수 해석이 달라집니다. 출력 파싱 실패도 오답에 포함되므로, 특히 파싱 불가가 459/1,004에 이른 Grok 4.20 Reasoning의 결과는 지시·출력 형식 준수까지 포함한 관측값입니다.
둘째는 시간 지평과 추론의 관계입니다. in prefix에서 more work로 갈 때 평균 정확도가 62.3%에서 21.0%로 줄어드는 결과는 후속 근거가 필요한 선택의 어려움을 보여 줍니다. 그러나 범주는 모델이 주석한 것이며 more work에는 짧은 로컬 검증도 포함됩니다. 이를 곧바로 실제 작업 시간이 몇 시간 늘어날 때의 성능 저하로 해석해서는 안 됩니다. 추론 예산 실험도 두 모델·세 설정·동일 토큰 한도 범위에서 전체 개선의 뚜렷한 증거를 얻지 못한 결과이지, 추론 확장이 모든 판단 과제에서 무효라는 증명은 아닙니다. §4, 부록 D
셋째는 판단 학습의 전이와 활용입니다. 과제 단위 분리 평가에서 117/390 → 187/390으로 두 순서 정답 문항이 늘어났고, 학생이 조언하는 별도 실행자의 보고 성공률도 높아졌습니다. 실행자를 고정한 비교는 판단 정보를 제공하는 방식의 효과를 보는 데 유용합니다. 다만 그 정보는 해당 과제의 과거 실행에서 얻은 분기 구조에 의존하며, 처음 보는 과제에서 분기 생성부터 조언까지 자동 수행하는 결과와는 구분됩니다. §5, 부록 G–H
| 비교 | 관측 결과 | 통계·평가 조건 |
|---|---|---|
| 주 벤치마크 최고 모델 | Sol Average 59.7% | 연구·엔지니어링 1:1, 두 순서 모두 정답, 4,000회 문항 부트스트랩 |
| 시간 지평 | 모델 평균 62.3% → 21.0% | 14개 모델, in prefix → more work, Figure 4 왼쪽은 모델 평균의 95% t 구간 |
| 추론 설정 최저 → 최고 | Sol −0.2%p, Luna +2.2%p | 대응 문항 10,000회 부트스트랩, 95% 구간 모두 0 포함 |
| 학습 제외 판단 | 30.0% → 47.9% | 390문항, 과제 분리, 두 순서 모두 정답, 95% 문항 부트스트랩 |
| 별도 실행자에 학생 조언 | 14.6% → 33.7% | 41개 과제의 과거 분기를 시작 전 조언으로 주입; 해당 차이의 별도 검정은 보고되지 않음 |
| 별도 실행자에 정답 조언 | 14.6% → 39.0% | 같은 과제·고정 실행자; 정확 McNemar p ≤ 0.004 |
원문이 명시한 해석 조건은 보존해야 합니다. SWE-bench Verified와의 비교에서는 11개 모델이라는 표본과 일치하지 않는 추론 설정 때문에 상관 구간이 넓습니다. 사람 검토의 높은 일치는 결과를 보고 명시적인 선호를 낸 응답만의 수치입니다. 원문에 없는 일반적 결함이나 향후 과제를 덧붙이는 대신, 이러한 저자가 제시한 조건과 실제 보고 범위 안에서 기여를 평가하는 것이 적절합니다.
기술적 함의와 응용
저자의 중심 주장은 장기 에이전트의 판단을 기존 궤적에서 측정하고 학습할 수 있다는 것입니다. 최종 성공 여부를 넘어, 나중에 결과 차이를 만드는 중간 방향 선택을 평가 단위로 삼았습니다. 병렬 시도와 우회 기록을 함께 활용하고, 평가 시점과 정답 생성 시점의 정보를 분리한 구성은 이 주장을 구체적인 데이터셋으로 구현합니다.
리뷰어의 해석으로는 이 연구가 제시하는 실용적인 관점은 실행 기록을 테스트 성공 여부만 저장하는 로그에서 판단을 학습하는 자료로 읽는 것입니다. 같은 과제에서 어떤 선택이 서로 다른 결과로 연결됐는지, 회복 전에 어떤 실패가 관측됐는지, 그 대안을 당시에도 제안할 수 있었는지를 함께 살펴야 합니다. 논문이 제시한 필터와 사례는 이 관점의 구체적 기준을 제공합니다.
조언자와 실행자를 분리한 실험은 판단 개선을 기존 실행 과정의 문맥으로 전달할 수 있음을 보여 줍니다. 다만 현재 실험에서 확인한 것은 과제 분리 학습, 과거 실행에서 확보한 분기, 정해진 SWE-agent 예산이라는 조건 아래의 효과입니다. 이 범위를 유지하면 Taste-Bench의 기여는 좋은 선택을 측정하는 방식, 사후 근거를 학습 신호로 변환하는 방식, 그리고 판단 개선이 작업 결과에 연결되는지를 검증하는 방식으로 정리됩니다.
본문 1–7절과 부록 A–H의 모든 절·소절을 다루었습니다. 긴 생성·평가 프롬프트는 목적과 주요 조건으로 요약했으며, Table 4의 모든 결합 응답·셀별 열, Table 6의 모든 모델별 시간 지평 행, Table 11–12의 개별 저장소·과제별 세부 행은 전부 재전재하지 않았습니다. 원문 링크에서 전체 표를 확인할 수 있습니다. 실험을 재실행하거나 인용 문헌 전체를 독립 검증한 리뷰는 아닙니다.