논문 개요와 전체 구조
Downside-Controlled Online Forecast Combination under Delayed and Revised Outcomes는 다시 학습할 수 없는 시계열 예측기에 보정 계층을 붙일 때, 평균 정확도 향상과 개별 데이터에서의 성능 악화를 어떻게 함께 평가해야 하는지 다룹니다. Minkyoung Kim, Hyunjung Byun, Yohan Lee, Beakcheol Jang의 논문이며, 분석 대상은 2026년 9월 24일 제출된 arXiv:2609.29096v1입니다. 이 글의 작성일과 논문의 제출일은 구분됩니다. 원문의 본문 8개 절과 보충자료 S1–S14를 기준으로 읽었습니다.
핵심은 기존 예측, 정적 보정 예측, 온라인 보정 예측을 함께 유지하고, 예측 대상 구간 전체의 정답이 도착한 뒤에만 가중치를 갱신하는 것입니다. 단순히 좋은 보정기를 찾는 데서 끝나지 않고, 보정기가 잘못 작동할 때 원래 예측에 얼마나 가까이 머물 수 있는지를 묻습니다. 주 예측 길이 96에서 7개 데이터셋과 4개 기저 모델로 구성된 28개 조합의 최악 평균 악화는 0.15%, 최대 개선은 11.53%입니다. 다만 5회 실행을 각각 세는 140개 셀의 최악 악화는 0.46%이며, 이것은 평가한 실험에서 관측된 값입니다. 모든 시계열에 대한 무악화 보장은 아닙니다. 본문 §1·§5, Table S7
운영 사례는 유럽 전력계통 운영자(TSO)가 발표한 다음 날 전력 수요 예측입니다. 빠르게 공개되는 잠정 관측값과 수개월 후 정리되는 확정 관측값을 교차시켜, 무엇을 정답으로 학습했는지가 평가 결과를 바꾼다는 점을 보여 줍니다. 이 논문의 학습 가치는 시계열 보정, 온라인 전문가 결합, 지연 피드백, 정답 개정 이력을 하나의 평가 설계로 연결하는 데 있습니다.
원문의 전개 순서는 다음과 같습니다. 세부 소제목도 아래 챕터별 리뷰에서 같은 순서로 설명합니다.
| 순서 | 원문 절과 내부 구조 |
|---|---|
| 1 | Introduction |
| 2 | Related work → 2.1 Forecast combination and expert aggregation → 2.2 Correcting a frozen forecaster → 2.3 Base models, normalization and conditioning |
| 3 | Residual audit and ceiling test |
| 4 | Method → 4.1 Setting and maturation protocol → 4.2 Expert library → 4.3 Hedge gate with held-out warm start → 4.4 Calibrated intervals via online conformal tracking |
| 5 | Experiments → 5.1 Setup → 5.2 Downside control on trained and foundation base models → 5.3 Comparison with test-time adaptation methods → 5.4 Ranks, scale and statistical base models → 5.5 Intervals and ablations |
| 6 | Load forecasts with revised outcomes → 6.1 Data, zones and protocols → 6.2 Correcting the load forecast → 6.3 Intervals on the load forecast → 6.4 Learning and scoring on different outcome versions |
| 7 | Discussion → 7.1 Two failed extensions → 7.2 Three applicability conditions → 7.2.1 Expert stability → 7.2.2 Stream sufficiency → 7.2.3 Outcome alignment → 7.3 Limitations |
| 8 | Conclusions → Data and code availability → AI-assisted technologies declaration → References |
| S1–S4 | Terms, data regions, datasets and settings → Residual predictability audit → Ceiling test: full results → Reproducibility |
| S5–S9 | Gate variants and classical weighting → Scale-free measures and statistical base models → Sensitivity of the layout constants and the learning rate → Interval scores: native quantiles and load pinball → Zone selection and the load layout |
| S10–S14 | Short series → Longer horizons → Expert speed and the fourth expert → Alternative aggregation rules over the same experts → Rank test with the dataset as the block → References |
핵심 기여와 혁신성
문제의 출발점은 수정 가능성과 개선 가능성이 다르다는 데 있습니다. 외부 인터페이스로 제공되는 foundation model이나 기관이 발표하는 예측은 사용자가 재학습할 수 없습니다. 예측 오차를 학습하는 작은 보정 모듈은 이 제약을 우회하지만, 학습 시점에 존재했던 오차 구조가 바뀌면 오히려 정확도를 떨어뜨립니다. 따라서 저자들은 최고 개선율보다 기존 예측 대비 악화를 작게 유지하는 downside control을 설계 목표로 삼습니다.
첫 번째 기여는 방법 제안 전에 잔차를 진단한 것입니다. 잔차는 실제값에서 예측값을 뺀 오차입니다. 시간적 의존성이 있다는 사실과, 입력 창을 몇 개 통계량으로 요약하면 그 오차를 예측할 수 있다는 사실은 같지 않습니다. DLinear의 5개 데이터셋 진단에서는 전자가 나타나지만 후자는 나타나지 않습니다. 8차원 조건 벡터를 정답을 보며 최적화하는 oracle 실험도 사전 지정한 50회 최적화 예산에서 5%의 개선 문턱을 넘지 못했습니다. 이는 모든 입력 정보나 모든 조건부 보정 방식이 쓸모없다는 주장이 아니라, 시험한 요약 정보·인터페이스·예산의 범위에 관한 결과입니다.
두 번째 기여는 표준적인 Hedge 가중치 갱신에 지연 관측 프로토콜, 서로 다른 보정기, 분리된 warm start를 결합한 운영 설계입니다. Hedge 자체를 새로운 알고리즘으로 제안하지 않습니다. 예측 발행 당시의 전문가 출력을 저장하고, 완전히 도착한 정답으로 그 출력을 평가하며, 테스트가 시작되기 전에 별도 검증 구간에서 초기 가중치를 정합니다. 개선과 악화가 서로 다른 데이터에서 발생하는 단일 보정기를, 실제 성과에 따라 쓰거나 줄이는 구조입니다.
세 번째 기여는 적용 조건을 실패 실험으로 좁힌 것입니다. 빠르게 바뀌는 전문가, 너무 짧은 학습·평가 스트림, 학습값과 평가값의 버전 불일치에서 실패가 나타납니다. 리뷰어의 관점에서 특히 유용한 부분은 조건을 추상적인 주의사항으로 남기지 않고, Exchange의 긴 예측 길이, 네 번째 전문가 추가, 잠정·확정 전력 수요 교차 평가로 각각 연결했다는 점입니다. 본문 §3–§7
기술적 세부사항
예측 기준 시점인 origin을 $o$, 과거 입력 길이를 $L$, 미래 예측 길이를 $H$, 동시에 예측하는 채널 수를 $C$라고 하겠습니다. 고정된 모델 $f_\theta$는 입력 $x_o$에서 $H\times C$ 형태의 예측을 만듭니다. 원문 식 (1)–(2)는 다음과 같습니다.
두 번째 조건은 현재 시점 $t$에 origin $o$의 정답을 사용할 수 있는지를 결정합니다. 미래의 첫 몇 시점이 관측됐더라도 전체 예측 구간이 끝나지 않으면 학습에 쓰지 않습니다. 공개 지연이 추가되는 확정 전력 수요에서는 단위를 맞춘 뒤 $o+H+D\le t$로 확장합니다. 여기서 $D$는 추가 공개 지연입니다.
세 전문가 중 $E_0$는 원래 예측, $E_1$은 훈련 데이터로 한 번 학습하고 고정하는 보정기, $E_2$는 검증 데이터에서 초기화하고 성숙한 정답으로 계속 갱신하는 보정기입니다. 원문 식 (3)–(4)는 수정 폭과 결합 방식을 정의합니다.
$A$는 tanh 출력을 사용하는 깊이 2의 신경망이고, $\delta$는 각 출력 좌표의 최대 수정 폭입니다. ETT 계열에서는 0.01, 나머지에서는 0.1을 사용합니다. 가중치가 음수가 아니며 합이 1인 집합을 simplex라고 부릅니다. 따라서 결합 예측은 전문가 예측의 볼록결합이 됩니다. $K=2$는 $E_0,E_2$, 보고하는 기본 구성인 $K=3$은 세 전문가 전부를 포함합니다. 별도로 비교하는 held-out corrector는 $E_1$과 같은 구조를 검증 구간에 학습한 대조군이며 전문가 목록에는 없습니다.
가중치를 갱신하는 손실과 Hedge 규칙은 원문 식 (5)입니다.
$\mathcal M_t$는 이번에 정답이 성숙한 origin들의 집합입니다. $HC$로 나누면 예측 시점·채널 평균 제곱오차가 되고, 테스트 전에 고정한 기저 모델의 held-out MSE인 $\sigma_{\mathrm{ho}}^2$로 다시 나누어 데이터셋 사이의 크기를 맞춥니다. 손실이 큰 전문가일수록 지수 인자가 작아집니다. 갱신 뒤에는 가중치 합이 1이 되도록 정규화하며, 실험의 학습률 $\eta$는 0.1로 고정합니다.
원문 식 (6)의 표준 regret 관계는 다음 형태입니다.
Regret는 사후적으로 가장 좋았던 하나의 전문가보다 누적 손실이 얼마나 더 큰지를 뜻합니다. 이 표준식에는 유계 손실과 누적 평가 기간 $T$에 맞춘 학습률이라는 조건이 있으며, 고정 지연에서는 지연 크기에 따른 추가 비용이 생깁니다. 실제 실험은 학습률을 고정했고, 정규화한 제곱오차의 범위도 사전에 알려져 있지 않다고 원문이 명시합니다. 손실을 clipping했다는 구현 보고는 없습니다. 따라서 식 (6)을 실험의 원래 MSE에 대한 유한 구간 무악화 보장으로 읽어서는 안 됩니다. 기저 모델이 전문가에 포함된다는 사실은 동일 손실 조건의 누적 비교 기준을 제공할 뿐입니다. 본문 §4.3, 식 (5)–(6)
구간 예측은 점 예측과 분리됩니다. 채널과 예측 선행 시점별 반경 $q$를 두고 $[\tilde y-q,\tilde y+q]$를 출력합니다. 원문 식 (7)의 갱신은 다음과 같습니다.
$\alpha$는 목표 미포함 비율, $\gamma=0.005$는 반경 조정 속도입니다. 90% 구간에서는 $\alpha=0.1$이며 정답이 구간 밖이면 반경이 증가하고 안이면 감소합니다. 이 tracker도 성숙한 정답만 사용합니다. 원문이 인용하는 이론은 장기 평균 포함률에 관한 것으로, 유한 기간의 모든 지역에서 90%가 보장된다는 뜻은 아닙니다.
챕터별 상세 리뷰
📖 Chapter 1: Introduction
도입부는 재학습할 수 없는 예측기의 현실적인 제약에서 출발합니다. 모델 내부가 공개되지 않는 foundation model뿐 아니라, 변경마다 재검증이 필요한 운영 파이프라인도 frozen forecaster에 해당합니다. 작은 사후 보정 모듈을 붙이면 모델 자체를 수정하지 않고 오차를 줄일 수 있지만, 그 모듈이 언제 해로운지는 별도로 확인해야 합니다.
저자들은 DLinear에서 held-out 보정이 ETTm2를 약 7.5% 개선하지만 Weather를 5.2% 악화시키는 대조를 먼저 제시합니다. 뒤이어 예측 결합의 오랜 논의와 운영 시점의 두 문제를 연결합니다. 다중 시점 예측에서는 정답이 늦게 완성되고, 운영 데이터에서는 완성된 것으로 보였던 정답도 나중에 개정됩니다. 이 두 시간축을 구분해야 실무자가 당시 보유한 정보로 평가할 수 있습니다.
문제 진단은 잔차 구조 검사, 8차원 조건 인터페이스의 oracle 검사, 성숙 오차를 읽는 보정기 설계 순으로 전개됩니다. 정적 보정기는 풍부한 훈련 잔차에서 안정된 구조를 얻고, 온라인 보정기는 더 적지만 최신인 표본 외 잔차에서 변화를 따라갑니다. 게이트는 둘 중 어느 쪽을 선택할지 미리 지정하는 부담을 줄입니다.
마지막으로 28개 벤치마크 조합과 전력 수요의 7개 지역, 적응형 구간 예측, 세 적용 조건을 소개합니다. 이 절의 기여는 평균 개선만으로 보정의 가치를 판단하지 않는 평가 목표를 세운 데 있습니다. 다음 절은 이 목표가 예측 결합 및 잔차 보정 문헌과 어떻게 연결되는지 설명합니다. §1
📖 Chapter 2: Related work
2.1 Forecast combination and expert aggregation
저자들은 과거 오차에서 가중치를 구하는 예측 결합에서 시작해, 왜 단순 평균이 정교하게 추정한 가중치보다 나을 수 있는지 설명합니다. 가중치 자체의 추정 불확실성은 결합 오차에 추가 변동을 만듭니다. 두 전문가의 오차가 매우 비슷하면 최적 가중치 추정은 불안정해질 수 있고, 가중치를 음수가 아닌 범위로 제한하면 일부 편향을 감수하는 대신 변동을 줄일 수 있습니다.
이 논문은 공분산 행렬에서 최적 가중치를 직접 추정하지 않고 관측 손실로 곱셈 갱신합니다. 원문은 온라인 분포 결합, 조건부 최적 가중치, 최근 손실 할인, specialist 및 fixed-share를 차례로 연결합니다. 전력 수요의 온라인 전문가 결합 선행 연구와 가장 가까운 지점은 일별 운영 예측이며, 차이는 손실이 $H$ 이후에야 보이고 관측값이 나중에 개정된다는 데 있습니다.
이어 rolling-origin 예측의 안정성, 거시경제 자료의 vintage 문제, 표준 exponentially weighted average forecaster의 regret와 특정 기준 전문가를 보호하는 변형을 검토합니다. Vintage는 같은 시계열에 대해 어느 공개 시점의 값을 보유했는지를 뜻합니다. 마지막으로 적응형 conformal calibration을 붙이되 주장 범위를 장기 포함률로 제한합니다.
2.2 Correcting a frozen forecaster
이 소절은 최근 오차를 더하는 계량경제학의 intercept correction에서 신경망 사후 보정과 test-time adaptation으로 이동합니다. Intercept correction은 수준 편향을 오차의 이동평균으로 수정하는 방식입니다. 여기서 정적 보정기, 입력에 따라 달라지는 instance-aware 보정, 예측 발행 후 추가 학습하는 방법은 서로 다른 정보와 갱신 경로를 사용합니다.
저자들은 같은 성숙 정답 규칙 아래 기저 예측과 적응 예측을 결합하는 선행 접근도 인정합니다. 차이는 이 논문이 초기 가중치의 warm start, 정적·온라인 전문가의 혼합, 구간 예측, 조건 인터페이스의 진단까지 함께 평가한다는 데 있습니다. 선행 논문과 정규화 단위가 다르므로 최악 악화 수치를 직접 비교하지 않습니다.
2.3 Base models, normalization and conditioning
DLinear와 PatchTST 같은 데이터별 학습 모델, 사전학습 예측 모델, 정규화 계층을 차례로 설명합니다. RevIN처럼 입력과 출력의 평균·분산 변화를 완화하는 방식도 남은 잔차를 완전히 없애지는 않습니다. 이때 보정 계층의 대상은 그 잔차입니다.
마지막으로 언어모델이 수치 예측기나 제어 신호 생성기로 들어가는 연구를 검토합니다. 저자들의 질문은 언어모델의 능력 자체보다, 어떤 제어기가 만들더라도 동일한 저차원 인터페이스를 통과하는 신호가 얼마나 큰 개선을 낼 수 있는지입니다. 다음 절의 ceiling test는 이 경로를 직접 시험합니다. 인용된 선행 논문 전체를 별도로 재검증한 것은 아니며, 여기서는 이 논문이 제공한 관계를 정리합니다. §2
📖 Chapter 3: Residual audit and ceiling test
첫 번째 질문은 고정 모델의 잔차가 백색잡음인지입니다. DLinear와 ETTh1, ETTh2, ETTm1, ETTm2, Weather에서 held-out의 fit 구간을 사용합니다. Ljung–Box 검정은 모든 데이터셋·실행에서 백색성 가설을 기각하며, lag 24의 최대 p값도 0.0082입니다. 이는 시간에 따라 남는 구조가 있음을 뜻하지만 그 구조를 어떤 표현으로 예측할 수 있는지까지 알려 주지는 않습니다.
두 번째 진단은 입력 창의 추세·계절성·변동성 통계량으로 예측 구간 평균 잔차를 맞추는 ridge 회귀입니다. 시간상 연속된 5개 fold로 교차 검증한 $R^2$가 데이터셋별 채널 중앙값 기준 −0.149에서 −0.815로 모두 음수입니다. 평균을 기준으로 예측하는 것보다도 좋지 않았습니다. 반면 한 시점 전 잔차와의 상관은 Weather에서 0.675로 특히 큽니다. 잔차의 시간 의존성과 단일 창 요약의 설명력을 분리한 진단입니다.
세 번째 단계는 조건화 경로를 oracle로 검사합니다. 예측을 분해한 각 성분에 $\mathrm{Linear}(H,H)$를 적용하는 보정기에 8차원 $z$를 넣어 내부 값을 확대·축소·이동합니다. 실제 제어기라면 입력을 보고 $z$를 생성해야 하지만, oracle은 그 표본의 정답을 직접 보고 $z$를 최적화합니다. 사전 규칙은 5개 데이터셋 중 적어도 2개에서 MSE를 5% 넘게 줄이지 못하면 이 경로를 사용하지 않는 것이었습니다.
50회 최적화에서는 최대 개선이 ETTh1의 3.76%입니다. 2,000회로 늘리면 ETTh1 22.24%, ETTh2 5.40%, Weather 6.88%로 커집니다. 따라서 ceiling은 수학적으로 증명된 최댓값이 아니라 지정 예산에서 oracle이 도달한 개선입니다. 확장 예산에서는 $\lVert z\rVert$가 약 80–224에 이르고 정답을 이미 사용하므로, 이 수치를 배포 가능한 제어기의 성능으로 볼 수 없습니다.
이 절은 모든 입력 기반 보정을 부정하지 않습니다. 입력 창을 직접 읽는 보정기는 시험한 병목 경로 밖에 있습니다. 저자들의 결론은 시험한 요약 조건화 대신, 실제 오차가 시간에 따라 드러나는 순서를 활용하자는 것입니다. 다음 절은 그 관측 순서를 강제하는 시스템을 구성합니다. §3, Table S5–S6
📖 Chapter 4: Method
4.1 Setting and maturation protocol
이 절의 역할은 어떤 값을 언제 사용할 수 있는지 명확히 하는 것입니다. Origin $o$에서 발행한 예측은 $o+1$부터 $o+H$까지를 대상으로 합니다. 따라서 $o+H$가 지난 뒤에만 maturation buffer가 해당 정답을 내보냅니다. 게이트는 이때 저장돼 있던 전문가 예측을 채점하며, 온라인 보정기의 새 파라미터로 과거 예측을 다시 만들어 손실을 바꾸지 않습니다.
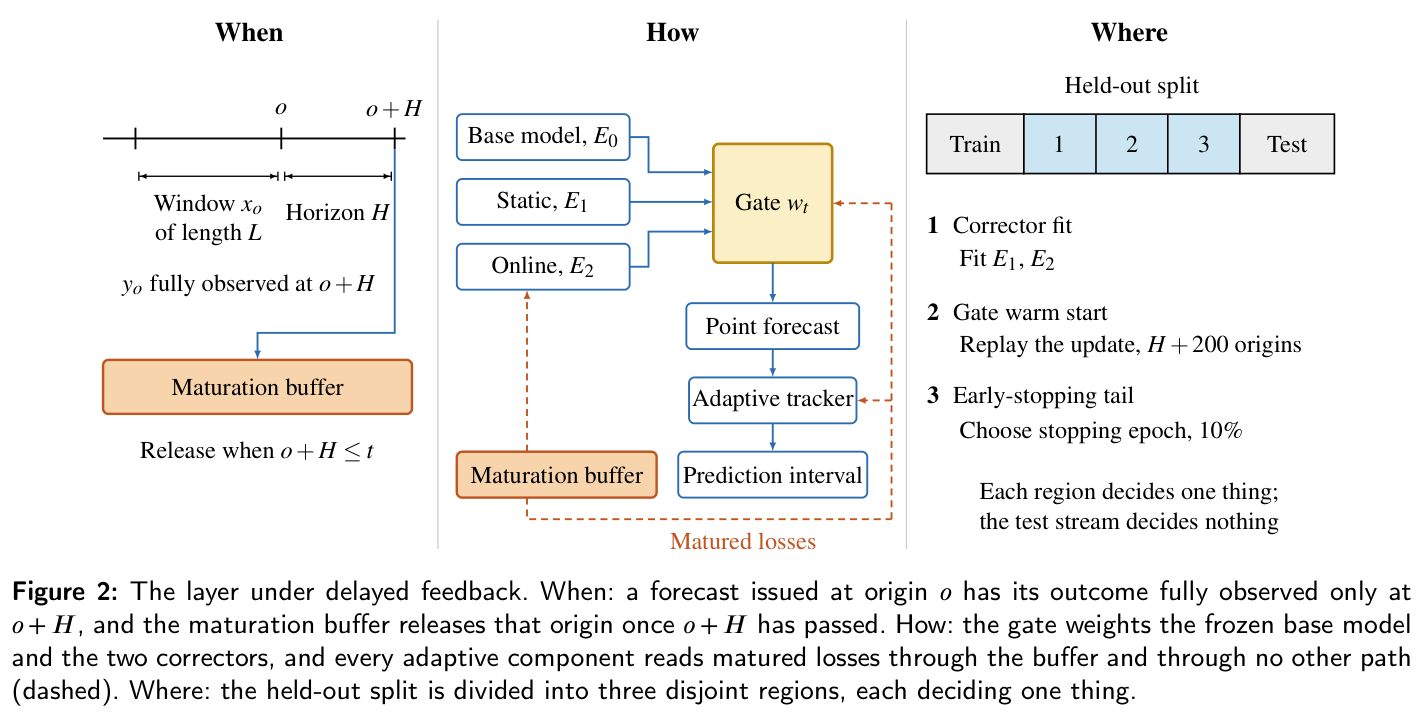
원문 Figure 2, PDF 7쪽. 2609.29096v1 PDF에서 그림과 영문 캡션을 크롭했으며 수치·표시는 수정하지 않았습니다. 한국어 설명은 본문 해설입니다.
그림의 왼쪽은 시간 조건, 가운데는 정보 흐름, 오른쪽은 데이터의 역할 분담입니다. 점선은 성숙 손실의 경로이며 구간 추적기는 점 예측에 피드백하지 않습니다. 그림의 fit 표시는 개략도이고, 정확한 학습 대상 구분은 Table 1 및 §4.2를 따라 읽어야 합니다. 정적 $E_1$은 훈련 잔차에서 학습하며 온라인 $E_2$의 초기 학습이 held-out fit 구간을 사용합니다.
부분 관측된 미래 구간을 쓰는 접근보다 보수적인 프로토콜입니다. 시간 순서의 묶음으로 처리하면 갱신이 추가로 늦어질 뿐이며, 저자들은 묶음 처리 여부에 따른 headline MSE 차이가 0.05% 미만이라고 보고합니다. 핵심은 연산 순서와 정답 가용성을 혼동하지 않는 것입니다.
4.2 Expert library
$E_0$는 아무것도 바꾸지 않는 선택지를 보존합니다. $E_1$의 tanh와 trust-region 반경은 개별 좌표 수정 폭을 제한합니다. 그러나 수정 폭을 제한한다고 항상 MSE가 작아지는 것은 아닙니다. 이미 좋은 예측에 작은 변경을 더해도 해로울 수 있다는 점은 전력 수요에서 확인됩니다.
$E_2$는 예측을 성분별로 변환하는 선형 경로와 입력 창을 읽는 경로를 갖고, 성숙 표본 묶음마다 한 번의 gradient step을 수행합니다. 두 보정기의 차이는 단순히 갱신 유무만이 아닙니다. $E_1$은 기저 모델이 학습했던 데이터의 in-sample 잔차를 많이 보고, $E_2$는 적지만 새로운 out-of-sample 잔차를 봅니다. 따라서 비교에는 데이터 양과 시점 차이도 포함됩니다.
4.3 Hedge gate with held-out warm start
게이트는 새 예측 모델이 아니라 이미 존재하는 예측의 배분 규칙입니다. 작은 성숙 손실을 낸 전문가의 가중치는 상대적으로 증가합니다. 정규화 상수와 학습률은 테스트 전에 고정되며, 동일한 규칙을 여러 데이터셋에 적용합니다.
표준 regret는 누적 손실을 사후 최선의 전문가와 비교합니다. $E_0$가 고정되어 있으므로 다른 전문가가 계속 학습한다고 해서 그 비교 대상 자체가 사라지지는 않습니다. 다만 지연된 손실은 과거 상태의 전문가를 평가하므로 현재 전문가 성능을 대표하지 못할 수 있습니다. 저자들은 이 실무적 문제를 뒤의 quasi-static 조건으로 다룹니다. 유계 손실 이론, 지연에 따른 추가 비용, 실제 정규화 MSE 결과는 이 절에서도 구분해야 합니다.
Warm start. 균등 가중치로 시작하면 정답이 처음 도착할 때까지 유해한 보정기를 줄일 수 없습니다. Exchange–PatchTST의 2전문가 구성에서 온라인 전문가 단독 악화는 약 65%입니다. Origin 96 전에는 새 손실이 없고, 균등 시작의 5회 평균 최종 악화는 5.78%입니다. 그림의 한 실행에서는 6.1%입니다.
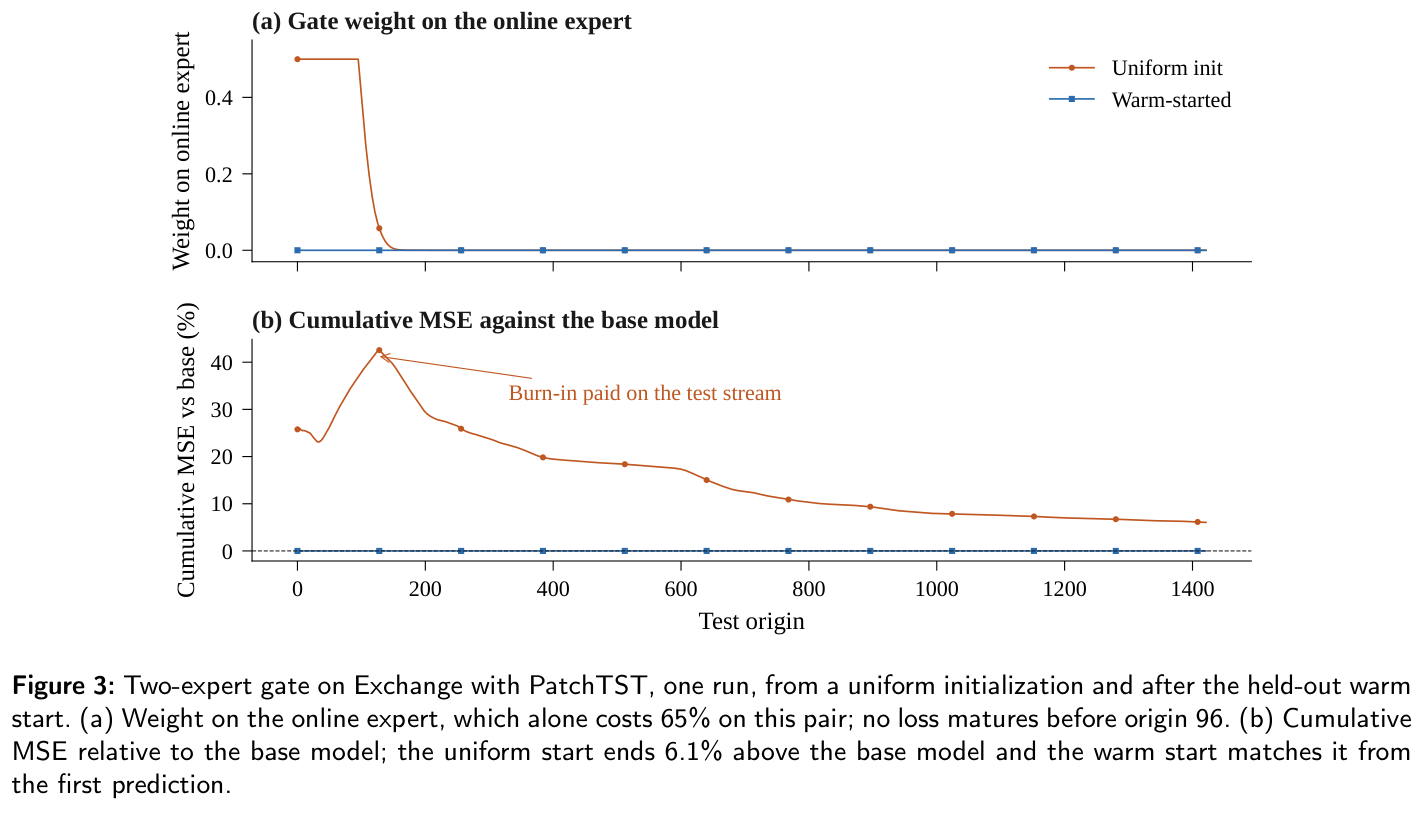
원문 Figure 3, PDF 9쪽. v1 PDF의 두 패널과 캡션을 크롭했습니다. 영문 축·범례와 단일 실행 수치를 그대로 유지했습니다.
Warm start는 early-stopping tail 직전의 별도 $H+200$ origin 구간에서 동일한 Hedge·정규화·성숙 규칙을 재생합니다. 마지막 가중치를 테스트의 시작점으로 사용하므로 초기 탐색 비용을 held-out 구간에서 지불합니다. 이 예에서는 온라인 전문가 비중이 거의 0에서 시작합니다. 하지만 잘못된 warm 구간 배분도 테스트로 전파될 수 있으며 §7은 바로 그 실패를 다룹니다.
Held-out tail은 10%입니다. 온라인 보정기의 학습 간격은 벤치마크에서 성숙 origin 64개당 한 step, 전력 수요에서는 더 짧은 기록에 맞춰 8개당 한 step입니다. 게이트의 가중치 갱신 속도와 보정기 파라미터의 학습 간격은 구분됩니다.
4.4 Calibrated intervals via online conformal tracking
점 예측 뒤에 붙는 tracker는 원문 식 (7)로 구간 반경을 조절합니다. 과거 포함 여부를 이용해 이동하는 오차 크기에 반응하지만, 조건부 오차 분산을 별도 모델로 예측하지는 않습니다. 예측 구간이 자주 정답을 놓치면 넓어지는 구조이며, 폭 증가의 비용은 Winkler score와 pinball loss로 함께 확인해야 합니다.
$\gamma$를 0.002, 0.005, 0.01로 바꾼 14개 학습형 기저 모델 조합에서 평균 Winkler 차이는 최대 1.2%, 평균 90% 포함률은 약 1%포인트 변합니다. 이것은 해당 grid의 민감도이지 데이터별 유한표본 보장 시험은 아닙니다. 다음 절은 점 예측·구간 예측·초기화의 기여를 나누어 평가합니다. §4
📖 Chapter 5: Experiments
5.1 Setup
ETTh1, ETTh2, ETTm1, ETTm2, Weather, Electricity(ECL), Exchange를 사용하며 기본 입력 길이는 384, 예측 길이는 96입니다. DLinear와 PatchTST는 각 데이터셋·실행에 맞춰 학습한 뒤 고정합니다. Chronos-Bolt Base 205M과 TimesFM 2.5 200M은 데이터셋별로 재학습하지 않는 zero-shot 기저 모델입니다. ILI는 짧은 시계열 조건을 따로 검토하며 주 결과의 7개 데이터셋에 들어가지 않습니다.
Runs and dispersion. 학습 요소를 5회 실행하고 $\pm$ 뒤에 표본 표준편차를 보고합니다. 표준편차의 분모는 $n-1$이며 신뢰구간이 아닙니다. MSE 변화율은 두 방법의 실행 평균 MSE의 비로 계산합니다. 실행별 변화율을 먼저 평균한 것과는 다르며, 기저 모델이 실행마다 다른 Exchange에서는 차이가 최대 1.6%포인트입니다. Dagger는 변화가 실행 간 변화율 표준편차보다 작다는 표시이지 유의성 검정의 대체물이 아닙니다.
Experimental units. Pair는 데이터셋 하나와 모델 하나의 조합, cell은 pair 하나의 실행 한 번입니다. 주 실험에는 28 pair와 140 cell이 있습니다. 전력 수요의 zone은 별도 연구 단위이며 7 zone, 35 zone-run cell입니다. 서로 다른 단위의 worst를 바꾸어 쓰면 위험을 축소하게 됩니다.
Significance testing. Diebold–Mariano(DM) 검정은 origin별 제곱오차 차이의 평균이 0인지 평가합니다. 인접 예측은 정답 구간을 공유하므로 Newey–West 추정량의 lag를 $H$로 정해 분산을 추정합니다. 통계량은 실행별로 보고하며 다중 비교 보정은 하지 않습니다. 따라서 다수의 개별 p값을 전체 우월성의 독립 증거처럼 세지 않습니다. 모든 오차는 훈련 구간 평균과 표준편차로 채널별 표준화한 척도에서 계산합니다.
Methods compared → Reproducibility → Data-region separation. 정적·온라인·held-out 보정기를 독립 대조군으로 두고, 동일 환경에서 bit 단위 재현을 위한 설정을 설명합니다. 훈련 구간은 기저 모델 및 정적 보정기, held-out fit은 온라인 보정기 초기화, warm slice는 게이트 초기 가중치, tail은 stopping epoch를 정합니다. 테스트에서는 미리 정한 규칙으로 성숙 손실에 따른 상태만 갱신합니다. 다만 §7.1의 느린 학습률 두 개는 결과를 본 뒤 추가한 진단임을 예외로 명시합니다.
5.2 Downside control on trained and foundation base models
Table 2는 모든 origin을 포함해 기저 모델 대비 MSE 변화율을 제시합니다. 학습형 모델 14 pair 중 13 pair가 개선되며, 나머지 PatchTST–ETTh2의 +0.03%는 표준편차 약 0.09 안에 있습니다. DLinear–Weather에서는 static이 −4.90%, online이 +0.40%, gate가 −4.76%입니다. DLinear–ETTm2에서는 static이 −0.87%에 그치고 online과 gate가 각각 −7.61%, −7.53%입니다. 전문가의 역할이 데이터에 따라 바뀝니다.
The static corrector alone. 정적 보정기는 28 pair 모두에서 개선되고 최악 pair도 −0.09%이므로, 벤치마크만의 최악값 기준으로는 게이트보다 더 안전합니다. 평균 개선은 static −2.24%, gate −3.99%입니다. 따라서 게이트의 기여를 모든 기준에서 static을 지배한다는 주장으로 바꾸면 안 됩니다. 변화하는 잔차에서 더 큰 개선을 얻고, 다른 운영 데이터에서도 악화를 작게 유지한 것이 주요 근거입니다.
Equal, fixed and adaptive weights. 세 전문가의 단순 평균은 24/28 pair에서 개선되지만 Exchange–PatchTST에서 +9.06% 악화됩니다. 나쁜 전문가에게도 1/3의 비중을 주기 때문입니다. 최근 200개의 같은 선행 시점 오차를 평균하는 intercept correction과 반감기 100 origin의 지수 오차 평균은 이 벤치마크에서 어떤 pair도 개선하지 못합니다. 잔차 구조를 읽는다는 표현만으로 단순 수준 편향 제거와 학습형 보정을 동일시할 수 없습니다.
고정 가중치를 비교하는 원문 식 (8)은 다음과 같습니다.
$M$은 평균을 빼지 않은 오차의 2차 모멘트 행렬, $\mathcal T$는 채점 대상의 성숙 origin 집합입니다. 대각 성분은 전문가별 MSE, 비대각 성분은 오차가 함께 움직이는 정도를 담습니다. 고정 $w$의 손실을 정확하게 계산하지만, 시간에 따라 바뀌는 $w_t$의 실제 손실과 평균 가중치를 대입한 값을 같다고 볼 수는 없습니다. Table S7B는 성숙 origin만 쓰므로 주 표의 모든 origin 기준과도 다릅니다.
최근 오차 역수 가중치는 단순 평균보다 낫지만 거의 균등한 배분에 머무는 경우가 많습니다. 동일 스트림에서 최적 가중치를 맞춘 in-sample optimum은 정답을 본 oracle이며 배포 가능한 대조군이 아닙니다. 그 oracle과 게이트의 차이는 더 나은 고정 배분으로 회수할 수 있었던 여지를 설명합니다.
Error correlation and the cost of the realized weight. 전체 연구의 415개 결합 실행에서는 전문가가 매우 닮을수록 최적 가중치를 맞추기 어렵지만 그 가중치를 정확히 맞추는 실익도 작았습니다. 가장 극단적인 셀은 잔차 상관 0.968에서 가중치가 30배 차이나도 손실 차이가 0.09%였습니다. 추정하기 어려운 수량이 반드시 결과에 민감한 수량은 아니라는 설명입니다.
Transfer to frozen foundation models. 보정기 구조·하이퍼파라미터·게이트 규칙을 다시 조정하지 않고 두 foundation model에 적용합니다. Chronos-Bolt–ETTm2의 −11.53%, TimesFM–ETTm2의 −10.46%가 큰 개선 사례입니다. 최악은 Chronos-Bolt–ETTh2 +0.15%이며 해당 표준편차 0.081%보다 큽니다. TimesFM–ETTh1 +0.04%는 표준편차 0.062% 안입니다. 사전학습 자료와 공개 벤치마크의 중첩 여부는 이 보정 계층의 작동과 별개로 zero-shot 기저 정확도 해석에 영향을 줄 수 있다고 저자들은 구분합니다.
5.3 Comparison with test-time adaptation methods
TAFAS와 PETSA를 동일한 DLinear 기저 예측 및 분할에서 재실행합니다. PatchTST는 해당 구현의 내부 모델과 결합돼 있어 고정 가중치를 그대로 쓰려면 방법을 수정해야 하므로 incompatible로 기록합니다. 이 공백을 비교 실패나 성능 열세로 해석하지 않습니다.
TAFAS와 PETSA는 각각 7 pair 중 3 pair에서 게이트보다 낮은 MSE를 얻습니다. Exchange에서는 −16.96%, −19.91%로 게이트의 −9.42%보다 큽니다. 반면 TAFAS의 최악 악화는 ETTm2 +7.29%, PETSA는 ECL +2.88%이고 게이트는 DLinear 7 pair 모두 개선합니다. TAFAS의 추가 갱신 파라미터는 1.1M–50.4M, PETSA는 64.8K–2.6M, 이 방법은 약 37.3K입니다. 비교에는 정확도와 함께 갱신 규모, 구간 제공 여부, 부분 정답 사용 여부가 포함됩니다.
PETSA의 부분 정답 갱신을 호출하지 않고 완전 성숙 규칙만 적용하면 Exchange 개선이 19.9%에서 3.3%로 감소합니다. 저자들은 부분 정답 사용을 무조건 누수로 비난하지 않습니다. 정당하게 이용 가능한 상황에서는 타당한 설계이며, 방법 차이와 피드백 프로토콜 차이를 나누어 비교해야 한다는 증거로 제시합니다.
5.4 Ranks, scale and statistical base models
여러 방법은 Friedman 순위 검정과 Nemenyi 임계거리(CD)로 비교합니다. 주 28 pair에서 gate의 평균 순위는 1.786, static은 1.893이며 차이는 CD 0.886보다 작습니다. 기저 모델과 나머지 방법은 구분되지만 gate와 static의 유의한 우열은 성립하지 않습니다. 4개 모델이 같은 데이터셋을 공유하므로 28개가 독립된 시계열이라는 해석도 피합니다. 데이터셋을 block으로 줄인 S14에서는 7개 block 기준으로 gate 대 base만 분리됩니다.
Scale-free measures. 기저 모델 대비 개선율은 원래 모델의 절대 수준을 알려 주지 않습니다. 원문 식 (9)의 계절 MASE와 RMSSE는 훈련 구간의 계절 naive 오차로 크기를 나눕니다.
$m$은 계절 주기이며 두 분모는 테스트가 아닌 훈련 데이터에서 계산합니다. 1보다 큰 MASE는 이 척도에서 기준 계절 naive보다 좋지 않음을 뜻합니다. ETTh2는 모든 방법의 MASE가 1보다 크고, Exchange의 $m=1$ 기준은 random walk이며 MASE가 대부분 7을 넘습니다. 이 경우 높은 상대 개선이 좋은 예측 시스템의 달성을 의미하지 않습니다. Weather–PatchTST는 MSE가 1.26% 줄지만 MAE가 1.81% 늘어 지표의 판단도 갈립니다.
Statistical base models. 일 단위 계절 주기가 명확한 네 데이터셋에서 계절 naive와 지수평활을 고정해 적용합니다. 8개 행의 게이트 개선은 21.4–91.3%이며 온라인 전문가 평균 가중치는 모두 0.989 이상입니다. 약한 기저 예측에서는 보정을 조금 더하는 동작보다 온라인 전문가로 사실상 대체하는 동작에 가깝습니다. 큰 개선율이 더 높은 최종 정확도를 뜻하지 않는다는 해석은 S6에서 다시 확인합니다.
5.5 Intervals and ablations
90% 구간을 비교할 때 같은 점 예측에 split calibration과 adaptive tracker를 붙이면 tracker가 14/14 pair에서 더 좋은 Winkler score를 냅니다. Tracker를 고정하고 점 예측만 보정하면 10/14 pair에서 나쁘지 않으며, Exchange 두 pair는 표시 정밀도에서 동률입니다. 전체 방법을 split-calibrated 기저 예측과 비교하면 13/14 pair에서 우수합니다. 구간 적응의 효과와 점 보정의 효과를 분리한 설계입니다.
Chronos-Bolt native quantile head의 가장 넓은 기본 구간은 80%이므로 비교도 80%로 맞춥니다. 평균 절대 포함률 오차는 native 0.056, tracker 0.020이지만, 9개 decile 평균 pinball loss는 native 0.112, tracker 0.116입니다. 잘 보정된 포함률과 좋은 확률 예측 점수가 항상 일치하지 않습니다. 포함률 검정은 다수의 시점·채널을 합친 대규모 표본에서 두 방법 모두 기각되어 방법 간 구분에 도움이 되지 않았습니다.
Warm start → Learning rate of the gate → Layout constants. Warm start의 제거는 앞서 설명한 Exchange 초기 비용을 만듭니다. 게이트 학습률의 6배 범위 변화에서 최대 MSE spread는 1.14%입니다. 최악 pair에서 배치·warm 길이·tail·trust radius를 각각 변경하면 일부 설정이 더 좋아지고, foundation 14 pair 전체에서 5% tail은 모두 개선됩니다. 반대로 20% tail은 Exchange–TimesFM을 +0.56%로 악화시킵니다. 보고 설정을 결과에 맞춰 최적으로 고른 것이 아니라는 근거이면서, 초기 데이터 배분이 실제 결과를 움직인다는 근거입니다. 다음 절은 동일 원칙을 기관 발표 예측과 개정되는 정답에 적용합니다. §5, Tables 2–5 및 S7–S14
📖 Chapter 6: Load forecasts with revised outcomes
이 절은 frozen이라는 제약을 실제 기관 발표 예측으로 옮깁니다. TSO는 지역 전력 수급을 운영하는 기관이며, 외부 사용자는 발표된 수요 예측의 파라미터를 다시 학습할 수 없습니다. Open Power System Data의 2019-06-05 패키지는 예측과 함께 잠정 수요, 확정 수요를 제공합니다. 잠정값은 운영 시간 이후 약 한 시간 안에 공개되는 Transparency Platform 계열이며, 확정값은 재계량 후 최대 약 3개월 뒤 공개되는 Power Statistics 계열입니다. 다만 패키지의 잠정값은 수집 당시 아카이브이므로 실제 첫 공개값과 완전히 같다는 보장은 없습니다.
6.1 Data, zones and protocols
36개 후보 zone에 결측률 1% 미만, 실제값의 연속 결측 3시간 이하, 예측이 동시 수요의 3배를 넘는 시간이 없다는 필터를 적용합니다. 처음 두 조건은 5개 pilot zone 밖을 보기 전에 고정했고, 예측 이상치 조건은 네덜란드 문제를 본 뒤 추가했습니다. 이 사후 요소를 숨기지 않습니다. 독일(DE), 헝가리(HU), 포르투갈(PT), 크로아티아(HR), 덴마크(DK), 이탈리아(IT), 벨기에(BE)가 통과합니다. 제외 29개는 결측 비율 19개, 긴 공백 8개, 예측 결함 2개입니다.
평가 끝은 확정값이 남아 있는 2019-01-31로 맞춥니다. 매일 00:00 UTC에 24시간 예측을 발행하고 과거 168시간을 입력으로 사용합니다. 지역별로 독립 학습하며 날씨·달력·다른 지역 정보를 추가하지 않습니다. 표준화는 훈련 기간 잠정값에서 계산한 하나의 평균·표준편차를 예측과 두 실제값 모두에 적용합니다.
| 프로토콜 | 학습 정답 | 평가 정답 | 해석 |
|---|---|---|---|
| L1 | 잠정 | 잠정 | 빠른 관측으로 학습하고 같은 값으로 평가 |
| L2 | 잠정 | 확정 | L1과 동일한 예측을 다른 정답으로 재평가 |
| L3 | 확정 | 확정 | 추가 공개 지연을 감수하고 평가 대상과 맞춰 학습 |
L3에서도 현재까지의 입력 창은 잠정값입니다. 확정값을 현재 시점까지 모두 아는 것처럼 입력하지 않습니다. $D=0$은 확정값이 즉시 도착한다는 가상 비교이고 $D=30$은 30일 지연 실험입니다. 문서상 최대 90일에서는 warm slice가 297개 held-out origin 중 291개를 차지하므로, 나머지 학습·조기 종료 구간을 확보할 수 없어 실행하지 않습니다. 벤치마크의 한 step과 여기의 하루 origin은 시간 단위가 다릅니다.
6.2 Correcting the load forecast
L1에서 3전문가 게이트는 7개 지역 평균 MSE를 모두 줄입니다. 최소 개선은 BE −0.09%, 최대 개선은 HU −57.34%이며, 35 zone-run cell 최악은 +0.37%입니다. 이미 TSO 예측이 가장 정확한 DK에서는 held-out 단독 평균 악화가 +101.96%, online은 +84.92%입니다. 개별 실행의 최악은 각각 +140.25%, +117.40%로 더 큽니다.
정적 보정기도 3개 지역에서는 평균 성능을 악화시킵니다. 벤치마크에서 28/28 개선했던 결과가 이 데이터에는 그대로 이어지지 않습니다. Gate는 DK에서 평균 −0.48%로 작은 수정을 하고, HU에서는 온라인 보정기에 대부분 배분합니다. 기저 오차와 기저 모델 가중치의 Spearman 상관은 −0.75지만 $n=7$의 정확 양측 p값은 0.066입니다. 경향과 5% 유의성을 구분해야 합니다.
Sensitivity to the zone screen. 제외한 NL을 추가 실행하면 잠정값 기준 15.0%, 확정값 기준 8.2% 개선됩니다. 이상 예측은 테스트보다 수년 전 훈련 기간의 5일에 집중돼 있습니다. NL 추가 후 8개 지역 평균은 0.2%포인트 미만 변하고 최악 지역은 그대로입니다. 이는 7개 지역의 주 결과를 바꾸는 조치가 아니라 사후 필터에 대한 민감도 검사입니다.
Classical weighting on the load data. 벤치마크에서 실패한 intercept correction이 여기서는 6/7 지역을 개선하고 평균 −18.07%로 gate의 −13.68%보다 좋습니다. 그러나 DK에서는 +23.37%이며, 지수 오차 평균은 +1,440.94%까지 악화됩니다. 이를 네 번째 전문가로 넣으면 평균은 −20.89%로 더 좋아지지만 DK +5.00%가 생깁니다. 평균 개선과 최악 악화 목표가 다른 선택을 요구하는 사례입니다.
6.3 Intervals on the load forecast
동일한 90% 목표와 tracker step을 적용합니다. 보정된 예측의 adaptive 구간은 split calibration보다 모든 지역에서 Winkler score가 작으며, 적응형 TSO 구간과 비교하면 DK는 표시 정밀도에서 동률입니다. 전체 평균 폭은 split보다 1.3% 넓지만 HU와 IT에서는 오히려 좁아집니다. 점 오차 감소와 구간 폭의 변화는 지역별로 해석해야 합니다.
PT의 포함률은 0.792입니다. 90% 명목 수준에 비해 약 0.11 낮으며, 전 지역 평균 절대 오차 0.033만 보면 이 문제가 감춰집니다. 원문의 장기 보장을 이 4년 창의 각 지역 보장으로 읽지 않아야 하는 직접적인 근거입니다. 9개 decile의 pinball loss에서는 보정 예측의 tracker가 7개 지역 모두 가장 좋습니다.
6.4 Learning and scoring on different outcome versions
L2는 예측을 하나도 바꾸지 않고 정답만 확정값으로 바꿉니다. 개선 지역은 7개에서 4개로 줄고 IT는 L1 −10.06%에서 L2 +6.20%로 뒤집힙니다. 이 방향 반전은 5회 실행 모두에 나타나고 저자들은 양쪽 방향의 DM 검정 결과도 보고합니다. Static 역시 −9.76%에서 +6.88%로 변하므로 문제는 가중치에 앞서 전문가가 학습한 정답에 있습니다.
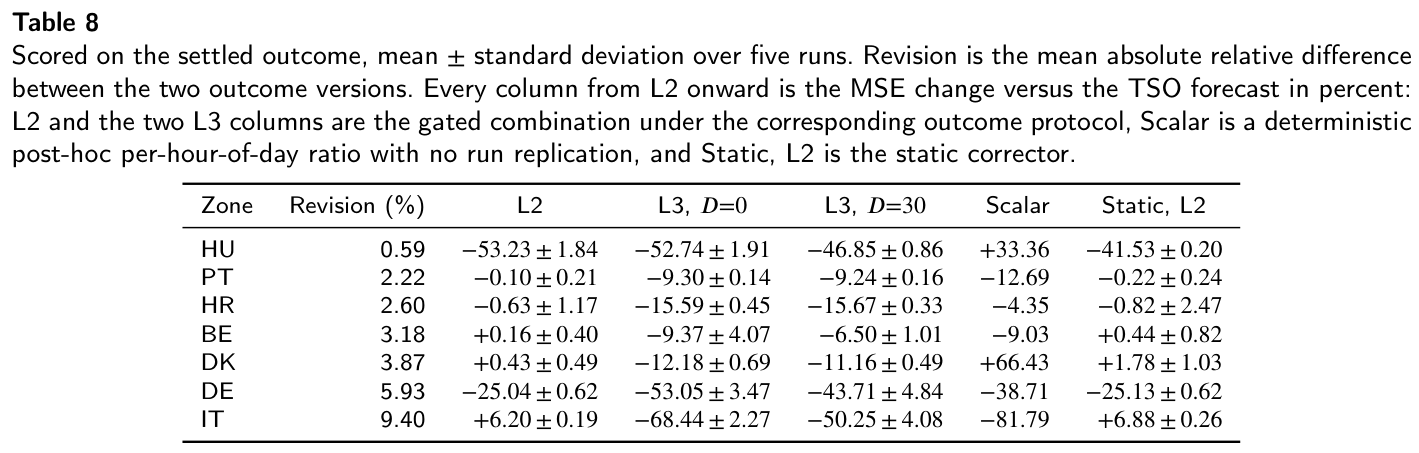
원문 Table 8, PDF 23쪽. v1 PDF에서 표와 설명을 크롭했습니다. 값·표준편차·단위는 원문 그대로이며 번역은 본문에서 제공합니다. Revision은 두 관측 버전의 평균 절대 상대 차이이며 나머지 성능 열은 확정값에 대해 평가한 TSO 대비 MSE 변화율입니다.
원문 식 (10)은 공통 가산 개정을 이상화하여 설명합니다.
$P$와 $S$는 잠정과 확정, $b$는 모든 전문가가 공유하는 정답 개정 항입니다. 가중치 합이 1이면 그 항은 그대로 남습니다. 전문가 간 비중을 조절하는 것만으로 모두에게 공통인 이동을 제거할 수 없다는 의미입니다. 가산 이동에는 intercept가 필요하며 단순히 가중치 합을 바꾸는 것과 다릅니다. 원문은 곱셈 개정에서는 배율에 맞는 합을 갖는 rescaling을 별도로 논의하지만, 실제 부하 개정은 시간에 따라 움직이는 비율이므로 식 (10)은 정확한 데이터 생성 모형이 아니라 설명용 이상화입니다.
L3에서 $D=0$과 $D=30$은 모두 7개 지역을 개선합니다. IT는 각각 −68.44%, −50.25%이고 DE의 30일 지연 결과는 −43.71%입니다. DE는 실행마다 static 또는 online에 집중하는 양상이 갈려 표준편차가 4.84%로 큽니다. 지연 자체가 개선을 줄일 수 있지만 이 표에서는 개선의 부호를 뒤집지는 않습니다.
Comparison with a level correction. 훈련 구간의 시간대별 확정/잠정 비율을 TSO 예측에 곱하는 사후 추가 baseline은 IT에서 −81.79%로 더 좋습니다. 하지만 HU +33.36%, DK +66.43%로 악화됩니다. DK에서는 훈련 기간 비율이 테스트 비율보다 약 3%포인트 커 이미 정확한 예측을 과도하게 보정합니다. 따라서 IT의 큰 L3 개선을 모두 복잡한 적응 학습의 필수성으로 설명하지 않습니다.
Pre-specified choices. 버전 교차와 처음 두 필터는 대응 실험 전에 정했지만 시간대별 비율 baseline과 훈련·테스트 비율 진단은 결과를 본 뒤 추가했습니다. Table 8의 Scalar에는 학습 난수가 없어 실행 반복 표준편차가 없습니다. 이 절의 기여는 정답 버전의 정렬과 보정 성능을 분리한 것입니다. 다음 절은 이런 결과와 다른 실패를 적용 조건으로 묶습니다. §6, Tables 6–8
📖 Chapter 7: Discussion
7.1 Two failed extensions
첫 번째 확장은 PETSA calibration을 완전 성숙 규칙으로 제한해 네 번째 전문가로 추가하는 것입니다. DLinear의 최악 pair는 −0.30%에서 +1.22%로 바뀌며 ETTh2에서는 결합이 각 전문가 모두보다 나쁩니다. 한 시점의 볼록결합 손실이 그 시점의 최악 전문가 손실보다 작다는 사실은 시간에 따라 가중치를 바꾼 누적 손실이 모든 고정 전문가보다 좋다는 뜻이 아닙니다.
저자들의 진단은 과거 손실로 현재 전문가를 평가하는 시차입니다. 네 번째 전문가의 학습률을 0.005에서 0.0005, 0.00005로 낮추면 게이트 변화율이 각각 +1.22%, −0.40%, −0.63%가 됩니다. 이 두 느린 학습률은 사후 진단용이며 추천 설정으로 제시되지 않습니다. 업데이트 간격은 전문가가 얼마나 움직이는지의 대리 척도이지 일반적인 안정성 측정량은 아닙니다.
두 번째 실패는 짧은 fit 구간입니다. Exchange–DLinear에서 $H=96$일 때 303개였던 fit origin이 $H=192$에서는 120개가 됩니다. Warm 구간에서는 online이 좋아 보여 5회 중 4회에서 초기 가중치가 0.96을 넘지만, 테스트에서는 잘못된 선택이라 평균 +23.03%를 냅니다. 게이트가 첫 사분기 안에 그 비중을 0으로 낮춰도 처음 192개 origin의 손실은 되돌릴 수 없습니다. $H=336$은 warm slice조차 들어가지 않아 거부됩니다.
전력 수요의 intercept 전문가 추가도 초기 배분의 전이 실패를 보여 줍니다. DK의 warm start는 해로운 intercept에 0.60을 주고 스트림 평균 비중은 0.004까지 감소하지만, 초기 손실 때문에 +5.0%가 남습니다. $D=30$에서는 BE +16.0%가 생깁니다. 전문가가 충분히 느리다는 조건만으로 초기 배분이 적절해지는 것은 아닙니다.
7.2 Three applicability conditions
이 조건들은 표준 regret 정리의 새 수학적 가정이라기보다, 평가한 스트림에서 작은 실용적 악화와 연결된 경험적 운영 조건입니다. 원문은 추상적인 누적 비교와 짧은 실제 스트림에서의 유용성을 구분합니다.
7.2.1 Expert stability. 전문가는 정답 성숙 지연 동안 거의 변하지 않는 quasi-static 상태여야 합니다. $E_0$와 $E_1$은 고정이고 $E_2$는 느리게 갱신합니다. 빠르게 바뀌면 과거 점수로 이미 사라진 상태의 전문가를 선호하게 됩니다.
7.2.2 Stream sufficiency. Warm slice와 tail이 들어가는 것만으로는 충분하지 않습니다. 남는 fit 구간에 최소 $H$개의 성숙 origin이 있어야 한다는 요구를 실패에서 도출합니다. 실제 실험의 layout guard는 fit 구간이 비어 있지 않은지만 검사했으므로 이 강화된 바닥 조건이 모든 실행에 사전 적용된 것은 아닙니다. Exchange의 120 대 192 실패는 이 차이를 보여 줍니다. ILI의 966행은 시험한 12개 구성 모두에서 표준 배치를 수용하지 못했고, 짧게 줄인 변형에서는 98–146개의 성숙 테스트 origin으로 게이트를 충분히 학습하지 못했습니다. 전력 수요에서 30일 지연 후 남는 34–36개의 일별 fit origin과 벤치마크의 step 수는 단위를 구분해서 읽어야 합니다.
7.2.3 Outcome alignment. 학습하는 정답과 평가하는 정답은 같은 버전이어야 합니다. 버전이 거의 일치하는 HU에서는 L2 개선이 유지되지만 IT에서는 크게 뒤집힙니다. 원문 식 (10)의 공통 개정 항 때문에, 관측한 잠정값에 대한 regret를 다른 확정값의 MSE 보장으로 이전할 수 없습니다.
7.3 Limitations
원문은 네 가지 범위를 명시합니다. 첫째, 볼록결합은 가장 좋은 한 전문가에 완전히 집중하지 않아 일부 pair에서 작은 차이를 남깁니다. 같은 전문가로 fixed-share와 Bernstein online aggregation을 재생해도 평가 근사 오차를 넘어서는 명확한 우위는 보이지 않았으며, sleeping expert와 채널별 가중치는 시도하지 않았습니다.
둘째, 부분 정답을 버리는 프로토콜은 정당하게 조기 피드백을 활용할 수 있는 경우 정확도 비용을 가집니다. 저자들은 부분 관측 변형을 열린 방향으로 남깁니다. 셋째, 구간 계층은 조건부 오차 크기를 모델링하지 않으며 PT의 0.79 포함률처럼 유한 기간 지역별 보장은 제공하지 않습니다.
넷째, 평가 범위는 표준 다변량 벤치마크와 재계량이라는 한 개정 기제를 갖는 전력 데이터입니다. 잠정 아카이브에도 플랫폼의 후속 수정이 섞였을 수 있으므로 진정한 first-release vintage와 정확히 일치하지 않습니다. 저자들이 언급한 후속 대상은 반복 개정과 체제 변화가 있는 역학 감시 및 상품 시장입니다. 이 밖의 한계나 미래 과제를 추가로 만들어 주장하지 않습니다. 다음 결론은 이러한 경계를 유지한 채 배포 판단을 정리합니다. §7
📖 Chapter 8: Conclusions
결론은 조건 벡터를 더 정교하게 만드는 질문에서, 언제 어떤 보정을 얼마나 쓸지 관측 성과로 결정하는 질문으로 이동한 과정을 정리합니다. 세 전문가, 지연된 손실, held-out warm start의 조합이 주 실험에서 작은 최악 악화와 더 큰 평균 개선을 함께 보였습니다. 약한 기저 모델에서는 거의 대체에 가까운 배분까지 가능하므로 같은 결합 규칙이 작은 수정과 큰 수정 양쪽을 포괄합니다.
동시에 원문은 실패와 연결된 확장을 명시합니다. 지연을 고려한 가중치 설계, fit-region 최소 길이를 실제 guard에 넣는 조치, 공통 개정 항을 직접 추정하는 방식, warm 구간 성능이 테스트로 옮겨 가지 않는 전문가를 초기부터 억제하는 방식입니다. 이들은 제안된 후속 방향이며 이미 검증된 해결책은 아닙니다. Simplex 바깥으로 나가 편향을 교정하면 현재 볼록결합이 갖는 성질과 교환이 발생할 수 있습니다.
Data and code availability. 벤치마크와 전력 자료는 공개 자료로 명시됩니다. 코드·저장 실행·표의 결과 파일은 논문 출판 시 영구 공개 저장소에 제공할 예정이라고 적혀 있습니다. 따라서 v1 본문만으로 코드가 이미 공개되었다거나 독립 재현이 완료되었다고 말할 수 없습니다. 그 다음의 생성형 AI 사용 선언은 Claude로 문장을 다듬었고 저자가 검토·책임을 맡았다는 보고입니다. 방법이나 실험 검증을 뜻하지 않습니다. 본문 뒤 References는 배경 문헌 목록이며, 이 리뷰는 그 문헌 전체를 읽었다는 주장을 하지 않습니다. 이어지는 보충자료는 주장의 실험 단위와 실패 경계를 더 구체화합니다. §8 및 Data and code availability
📖 Chapter S1: Terms, data regions, datasets and settings
Terms and data regions. Table S1은 expert, corrector, gate, pair, cell, origin, maturation delay, publication delay를 구분합니다. 예를 들어 corrector는 보정 작동을 가리키고 expert는 게이트가 가중치를 줄 수 있는 예측을 가리킵니다. 모든 corrector가 library에 포함되는 것은 아닙니다. Table S4의 held-out corrector와 intercept correction이 이 구분의 사례입니다.
Datasets and splits. Table S2는 ETT 계열 7채널, Weather 21채널, ECL 321채널, Exchange 8채널을 기록합니다. ETT는 관례적인 12·4·4개월 경계를 사용하고 나머지도 시간 순서대로 분리합니다. $L=384,H=96$의 입력·예측 설정과 표에 실린 분할 수를 함께 읽어야 하며, 실제 게이트에 들어갈 origin 수는 warm·tail·windowing을 반영한 Table S17과 구분됩니다.
Decomposition parameters. Audit와 ceiling은 공통 설정의 추세 kernel·계절 주기를 읽지만, online corrector의 분해 특징은 별도 설정을 씁니다. 특히 Weather의 online 특징은 주기 7·kernel 48이고, audit의 일 주기 설정은 144·145입니다. 예측 길이 96에서 계절 주기가 96 이상이면 phase당 한 값만 남아 irregular 경로가 학습 상수가 되는 경우가 있습니다. 주기를 24로 바꾼 재실행에서도 지정 예산 ceiling은 ETTm1 0.06%, ETTm2 0.01%, Weather 0.82%로 1% 미만입니다. 진단 결과를 지탱하는 구현 조건을 밝힌 부분입니다.
Static corrector settings. 정적 보정기는 depth 2, width 128, Adam 학습률 $10^{-4}$, 20 epoch, batch 64를 사용합니다. ETT의 trust radius 0.01과 나머지의 0.1을 제외하면 설정을 공통으로 유지합니다. 이 부록은 뒤의 진단 수치를 읽는 용어·설정 기준을 제공하며, S2는 실제 잔차 검사를 상세화합니다. Supplement S1
📖 Chapter S2: Residual predictability audit
S2는 Ljung–Box를 lag 10·24·48에서 실시하고 ridge penalty를 1로 고정합니다. 회귀 특징은 추세 기울기, 계절 진폭, 계절 지배도, 불규칙 성분 표준편차, 창 평균·표준편차입니다. 특징 표준화는 각 훈련 fold에서만 맞춥니다. 잔차의 한 시점 앞 시계열을 검사하는 통계량과 예측 구간 평균 잔차를 맞추는 회귀의 대상이 다르다는 점도 중요합니다.
Table S5는 Ljung–Box p값의 채널·실행 최대, lag-1 상관의 평균, ridge $R^2$의 채널 중앙값을 실행 간 평균하여 보고합니다. Weather의 일부 heavy-tail 채널과 거의 일정한 목표 fold가 채널 평균을 지배해 중앙값을 사용한 이유도 설명합니다. 따라서 −0.149 등은 임의로 전체 표본을 합쳐 얻은 하나의 $R^2$가 아닙니다. 진단은 의존성이 존재한다는 사실을 보이며, 다음 S3은 제어 경로에서 실제 회수 가능한 개선을 실험합니다.
📖 Chapter S3: Ceiling test: full results
Corrector substrate. 각 분해 성분의 $\mathrm{Linear}(H,H)$ 외에 과거 창의 평균 pooling 투영을 $\mathrm{Linear}(96,H)$로 보내는 네 번째 경로가 있습니다. 보정기의 규모는 약 28K–37K 파라미터입니다. FiLM은 조건 벡터로 중간 특징의 배율과 이동을 정하는 방식이며, 숨은 폭은 sequence corrector 48, pointwise corrector 64입니다.
Measuring the ceiling. Held-out fit의 앞 2/3에서 보정기와 표본별 embedding을 함께 학습하고, 그 내부에서 early stopping을 합니다. 마지막 1/3은 본 적 없는 probe 영역입니다. 그곳에서 보정기를 고정하고 $z=0$에서 Adam 학습률 0.05로 정답을 보며 $z$만 최적화합니다. Probe 크기는 ETTh 계열 각각 737, ETTm 계열 각각 3,329, Weather 1,454 origin입니다.
Result. 50회에서 ETTh1 3.76±1.03%, ETTh2 0.63±0.23%, ETTm1 0.14±0.19%, ETTm2 0.01±0.02%, Weather 0.80±0.76%입니다. 2,000회에서는 ETTh1이 5회 모두 5%를 넘고, ETTh2·Weather는 3회, ETTm1은 2회, ETTm2는 0회입니다. 평균 개선만 보면 확장 예산의 불안정성이 가려질 수 있습니다. 이 oracle은 진단이며 보고 방법의 테스트 성능에 포함되지 않습니다. S4는 이러한 실행을 재생하는 조건을 설명합니다.
📖 Chapter S4: Reproducibility
저자들은 난수원을 고정하고 결정론적 kernel을 켜며, 오차 공분산 파일을 저장 전에 canonicalize해 같은 기준 환경의 반복 실행이 bit 단위로 일치한다고 설명합니다. NVIDIA L40S 환경을 사용했고, 타사 baseline은 commit을 고정한 채 수정하지 않았으며 분할 정렬은 바깥에서 처리했다고 합니다.
이것은 저자의 환경 내 재현성 보고입니다. 다른 환경의 수치 허용 오차, run 기록, cache key는 코드와 함께 문서화한다고 적혀 있으나 이 리뷰에서 실제 코드 재실행으로 확인하지는 않았습니다. S5는 저장된 오차와 가중치로 비교한 결합 규칙들을 제시합니다.
📖 Chapter S5: Gate variants and classical weighting
Table S7A는 모든 origin 기준의 28 pair·140 cell을 요약합니다. Static의 worst pair −0.09%와 worst cell +0.08%, gate의 +0.15%와 +0.46%를 한 표에서 구별할 수 있습니다. Equal-weight는 평균 −1.54%지만 worst cell +11.74%입니다. 2전문가 gate는 mean −2.43%, worst pair +0.47%, worst cell +0.64%로, 세 번째 정적 전문가를 넣는 효과도 나타납니다.
S7B는 성숙 origin만으로 계산한 고정·오차 역수 규칙입니다. 최근 오차 역수는 $w_k\propto1/\bar\ell_k$이며 window 100, 500, 전체 성숙 기록을 비교합니다. 원문은 origin별 교차항을 저장하지 않아 이동 가중치의 실제 손실 대신 시간 평균 가중치의 $\bar w^\top M\bar w$를 사용했다고 명시합니다. 따라서 근사치라는 경계를 보존해야 합니다. S7A의 equal +9.06%와 S7B +9.72%는 채점 origin이 달라 같은 수치가 아닙니다.
Table S8은 전력 수요의 intercept 우위를 평균과 악화로 나누고, S9는 foundation model의 2전문가 gate, S10은 가장 큰 평균 비중을 받은 전문가를 기록합니다. ETTm2에서는 online, Weather·ECL·Exchange에서는 static이 주도하는 양상이 나타납니다. 마지막 공분산 분석에서 절반의 셀은 실현 가중치와 oracle 가중치가 0.2 넘게 다르지만 중앙값 분산 비용은 1.2%입니다. S6는 이제 상대 개선의 분모 자체를 점검합니다.
📖 Chapter S6: Scale-free measures and statistical base models
Table S11은 MASE를 실행별 값의 평균으로, RMSSE는 실행 평균 MSE의 제곱근으로 제시합니다. 뒤에 적힌 표준편차는 실행별 제곱근의 표준편차이므로 표시 평균과 표준편차 계산 순서가 같지 않습니다. 이 차이는 Exchange에서 최대 0.013, 나머지는 표시 마지막 자리보다 작다고 보고합니다.
계절 naive와 가산 감쇠 추세·가산 계절 지수평활을 네 데이터셋에 적용한 S12는 8행×3보정 방식×5회, 총 120개 corrected cell 모두 개선을 보입니다. 게이트의 ECL 지수평활 개선은 −91.29%이지만 초기 오차가 매우 큰 경우입니다. 네 통계형 비교 중 둘은 보정 뒤에도 같은 데이터의 모든 neural cell보다 오차가 큽니다. 큰 개선율은 약한 시작점을 반영하며 우수한 종착점을 자동으로 뜻하지 않습니다.
나머지 세 데이터셋은 계절 주기에 대한 두 관례가 공존하고 기저 오차를 크게 바꾸므로 통계형 비교에서 제외됩니다. 이는 전체 7개에 대한 검증이 아니라 명확한 주기를 가진 네 데이터의 결과입니다. S7은 보고한 설정의 민감도를 이어 점검합니다.
📖 Chapter S7: Sensitivity of the layout constants and the learning rate
Table S13A는 worst pair인 Chronos-Bolt–ETTh2에서 반경·warm 길이·tail·갱신 간격을 한 번에 하나씩 바꿉니다. 반경 0.5배는 +0.19%, 원래 값은 +0.15%, 2배는 +0.04%입니다. Warm 길이 $H+100$은 −0.08%, tail 5%는 −0.17%로 부호가 바뀝니다. 원래 설정을 여러 행에 반복하면 모두 +0.1463으로 돌아옵니다.
S13B는 14 foundation pair 전부에서 tail 5·10·20%를 비교합니다. 평균 변화는 −4.81·−4.74·−3.61%, worst는 −0.17·+0.15·+0.56%입니다. 이 결과를 보고 기본 설정을 5%로 교체하지 않았습니다. S13C는 세 명시된 cell에서 $\eta=0.05,0.1,0.3$을 비교합니다. 따라서 1.14% 민감도를 모든 가능한 데이터·학습률에 대한 전수 안정성으로 확장하지 않습니다. 다음은 구간 점수의 별도 근거입니다.
📖 Chapter S8: Interval scores: native quantiles and load pinball
Table S14와 Figure S1은 nominal level을 맞춘 포함률 비교입니다. Native Chronos-Bolt는 level 0.2에서 평균 0.014, level 0.8에서 0.056만큼 부족하게 포함하며 tracker의 평균 차이는 0.04 안에 머뭅니다. 하지만 tracker는 더 넓습니다. Frozen zero-shot 예측에 붙인 두 구간 방법에는 난수 요소가 없어 5회가 일치하므로 분산을 따로 보고하지 않습니다.
Table S15에서 전력 수요의 평균 pinball loss는 adaptive gate 0.05601, split gate 0.05795, adaptive TSO 0.06343입니다. HU·DE에서 점 보정에 따른 차이가 크고 HR·BE·DK에서는 작습니다. 구간 포함률과 적절한 확률 점수가 전력 자료에서는 같은 방향이지만, 앞의 native-head 비교에서는 달랐다는 점을 함께 읽어야 합니다. S9는 이 지역 표본이 어떻게 선택됐는지 공개합니다.
📖 Chapter S9: Zone selection and the load layout
Table S16은 36개 후보의 통과·제외 이유를 나열합니다. 공통 격자는 2015-01-05 00:00부터 2019-01-31 21:00 UTC까지 35,710시간입니다. 짧은 실제값 공백은 선형 보간하고, 예측의 긴 공백은 지역 전체보다 해당 origin을 제외하는 방식으로 처리합니다. 예측 결함 필터는 NL에는 사후이며 다른 30개 추가 검토 지역에는 사전입니다.
Table S17A는 시간 단위 혼동을 해소합니다. 일별 origin에서 warm slice는 $1+D+200$개입니다. 일반 6개 지역의 held-out은 297개이고 tail은 30개여서, $D=0$에는 fit 66개, $D=30$에는 36개가 남습니다. BE는 held-out이 2개 적어 64·34개입니다. $D=90$에서 slice 291개와 tail 30개는 함께 들어가지 않습니다. S17B는 벤치마크에서 horizon이 커질수록 fit이 줄어드는 별도의 배치를 제공합니다.
Table S18의 개정 상대 차이는 HU 0.592%에서 IT 9.401%까지입니다. IT의 확정/잠정 평균 비율은 1.0940이며 예측 정확도 순위는 잠정값 기준 두 번째에서 확정값 기준 두 번째로 낮은 쪽으로 바뀝니다. 이는 모델이 아니라 평가 대상 변경으로 생긴 차이입니다. S10은 데이터 길이의 반대 극단을 다룹니다.
📖 Chapter S10: Short series
966행의 주별 ILI에서 6:2:2 분할의 held-out origin은 $195-H$, 7:1:2에서는 $98-H$개입니다. 표준 warm 길이를 둘 공간이 부족합니다. 가장 유리한 분할과 짧은 horizon에도 최소 1,358행이 필요하다고 계산합니다. 이 실행 불가능성을 slice를 임의로 줄여 기본 실험처럼 보고하지 않습니다.
Table S19의 축소 실험은 같은 배치와 보정기를 유지하며 초기 가중치만 warm 대 uniform으로 비교합니다. Warm은 어떤 구성에서도 더 낫지 않고 최대 1.75%포인트 뒤집니다. 150개 변형 cell 중 최대 개별 악화는 0.24%로 작지만, 같은 배치에서 held-out corrector가 gate보다 50개 대응 비교 모두에서 1.01–5.46%포인트 더 좋습니다. 작은 악화만으로 결합이 필요한 방법이 되지는 않습니다. S11은 표본이 줄어드는 다른 원인인 긴 horizon을 봅니다.
📖 Chapter S11: Longer horizons
$H=192$에서 10 pair, $H=336$에서 9 pair를 평가합니다. 주 14 pair 중 일부는 두 horizon 모두 행이 없으므로 전체 horizon 일반화 시험이 아닙니다. 19개 구성 중 9개는 변화가 자신의 실행 표준편차보다 작습니다.
192에서 Exchange–DLinear +23.03±14.989%가 두드러지고, 다른 3개 악화는 자신의 실행 spread보다 작습니다. 336의 보고된 9 pair에는 악화가 없지만, Exchange는 layout guard가 거부해서 빠져 있습니다. 따라서 긴 horizon이 더 안전하다는 해석은 잘못입니다. 이 부록의 역할은 가용 fit 구간과 초기 배분의 관계를 보여 주는 것이며, 다음 S12는 전문가의 속도와 종류를 바꿉니다.
📖 Chapter S12: Expert speed and the fourth expert
Table S21A는 PETSA 전문가 학습률의 사후 진단입니다. 기본 0.005에서 전문가 단독 −0.11%인데 4전문가 gate는 +1.22%입니다. 느리게 만든 0.0005에서는 단독 −0.83%, gate −0.40%, 0.00005에서는 단독 −0.09%, gate −0.63%입니다. 좋은 전문가를 추가했다고 결합 결과가 자동으로 좋아지지 않으며, 시간에 따른 변화 속도가 중요합니다.
S21B는 intercept의 추가입니다. 벤치마크 worst pair는 +0.15%에서 +0.47%, L1 load worst zone은 −0.09%에서 +5.00%로 나빠집니다. L1 평균은 −13.68%에서 −20.89%로 좋아져 trade-off가 분명합니다. L3 30일 지연의 worst zone은 3전문가 −6.50%와 4전문가 +16.00%로 갈립니다. 이 결과를 다른 전문가까지 포괄하는 보편적 실패 정리로 확대하지 않습니다. S13은 전문가를 고정하고 갱신 규칙만 바꿉니다.
📖 Chapter S13: Alternative aggregation rules over the same experts
Fixed-share는 전문가 사이의 전환 가능성을 남기는 방식이고, Bernstein online aggregation은 손실 정보를 이용해 자체 학습률을 조정하는 방식입니다. 동일한 warm slice와 성숙 규칙으로 각 규칙을 재생하며 fixed-share 전환률은 0.01과 $1/T_m$을 모두 보고합니다. $T_m$은 성숙 테스트 origin 수입니다.
Table S22A는 주 28 pair에 통계형 8 pair를 더한 36 pair입니다. S22B는 7지역×3프로토콜의 21 zone-protocol cell이며, 여기의 cell은 주 결과의 개별 난수 실행 cell과 집계 수준이 다릅니다. 표 값은 각각 5회 평균입니다. 모든 규칙을 $\bar w^\top M\bar w$로 평가하므로 실제 스트리밍 MSE 표와 직접 이어 붙이지 않습니다.
같은 계산 기준에서 fixed-share $1/T_m$은 Hedge보다 평균 0.05%포인트 낮고 Bernstein은 0.15%포인트 높습니다. 원문이 보고한 평균 평가 방식 차이 0.52%포인트보다 작아 명확한 분리 근거로 삼지 않습니다. 또한 원문은 평균 가중치 평가가 이동 가중치 손실의 상계라고 서술하지만, 고정 가중치 식 (8)만으로 일반적인 시변 가중치에 대한 그 관계가 도출되지는 않습니다. 여기서는 그 표현을 추가 보장으로 채택하지 않고 동일한 대리 평가 기준에서의 비교로 한정합니다. Bernstein의 L3 30일 지연 비교에서는 일부 지역이 악화됩니다. 마지막 S14는 통계적 비교의 block 단위를 다시 점검합니다.
📖 Chapter S14: Rank test with the dataset as the block
28 pair를 독립 block처럼 보는 대신 같은 데이터셋의 여러 모델 변화율을 평균하고 데이터셋 7개를 block으로 사용합니다. 전체 기저 모델 집합에서 Friedman p값은 0.008, 학습형 모델 집합은 0.038이며 Nemenyi CD는 1.773과 2.306으로 넓어집니다. 두 집합 모두 남는 분리는 3전문가 gate와 frozen base 사이뿐입니다.
DLinear만의 7개 block은 처음부터 같은 단위였으므로 p=0.246, CD=3.405로 바뀌지 않고 방법 간 분리가 없습니다. 이 부록은 평균 순위 1위라는 서술과 다른 보정기보다 유의하게 낫다는 서술이 다름을 확인하며 상세 리뷰를 마칩니다. 보충 References는 이 부록에서 인용한 문헌 목록이며 별도 신규 실험 절이 아닙니다. Supplement S1–S14
실험 결과 심층 분석
결과를 읽을 때 먼저 기준 예측, 정답 버전, 채점 origin, 집계 단위를 고정해야 합니다. 다음 표는 서로 다른 분모를 섞지 않은 핵심 비교입니다. 음수는 해당 frozen base 또는 TSO 대비 MSE 개선입니다.
| 평가 범위 | 방법·조건 | 평균 변화 | 최악 변화와 단위 |
|---|---|---|---|
| 주 벤치마크 28 pair, 모든 origin, H=96 | Static | −2.24% | pair −0.09%, 140 run-cell 중 +0.08% |
| 동일 범위 | 3전문가 gate | −3.99% | pair +0.15%, 140 run-cell 중 +0.46% |
| 동일 범위 | Equal weights | −1.54% | pair +9.06%, run-cell +11.74% |
| Load 7 zone, L1, 모든 origin | 3전문가 gate | −13.68% | zone −0.09%, 35 run-cell 중 +0.37% |
| 동일 load 범위 | Intercept correction | −18.07% | zone +23.37% |
| 동일 load 범위 | Intercept 포함 4전문가 gate | −20.89% | zone +5.00% |
출처: Tables S7A, S8, S21B. Worst zone과 worst run-cell을 의도적으로 분리했습니다. v1 원문
이 표는 세 가지 서로 다른 결론을 지지합니다. 첫째, 벤치마크의 최악값만 목표로 하면 static이 더 좋습니다. 둘째, 게이트는 평균 개선과 최악 악화의 절충을 바꾸며, 벤치마크와 load에서 서로 다른 보정기가 실패해도 작은 관측 악화를 유지합니다. 셋째, 가장 좋은 평균을 주는 전문가를 더한다고 downside 목표도 자동으로 좋아지지는 않습니다. 이는 알고리즘의 우월성을 한 숫자로 정리하기보다 배포에서 허용할 목표를 명확히 하게 합니다.
Foundation 결과에서도 큰 개선과 작은 악화를 따로 봐야 합니다. Chronos-Bolt–ETTm2의 −11.53%는 static −0.68%보다 크지만, Chronos-Bolt–ETTh2 +0.15%는 실행 spread 밖의 작은 악화입니다. 반대로 +0.03%나 +0.04% 같은 항목은 자신의 spread 안에 있습니다. 작은 수치를 모두 0으로 취급하거나 모두 유의한 실패로 취급하는 것은 원문 보고보다 강한 판단입니다. 표의 $\pm$는 실행 표준편차이고 신뢰구간은 아닙니다. 이 리뷰에 옮긴 주요 변화율의 별도 신뢰구간은 원문에 보고되지 않았습니다.
통계적 결론의 범위도 제한됩니다. DM은 origin 의존성을 Newey–West lag $H$로 다루지만 다중 비교 보정은 없습니다. Friedman의 데이터셋 block 재분석에서 gate 대 base의 차이는 남지만 gate 대 static의 우월성은 입증되지 않습니다. Load의 기저 오차와 배분 상관 p=0.066 역시 작은 7지역 표본의 경향입니다. 모델·데이터셋·실행을 모두 서로 독립인 반복으로 취급하지 않는 것이 중요합니다.
정답 버전 실험은 동일한 예측을 다시 점수 매겨 평가 정의가 결과를 바꿀 수 있음을 보여 줍니다. L2의 IT +6.20%와 L3 30일의 −50.25%는 동일한 학습 조건의 알고리즘 두 개를 비교한 수치가 아닙니다. 전자는 잠정값으로 학습한 예측의 확정값 평가, 후자는 확정값을 지연시켜 학습한 결과입니다. 비율 baseline의 IT −81.79%도 함께 보면, 개정 구조를 맞추는 단순 보정이 어떤 지역에서는 강하지만 다른 지역에서는 위험하다는 점이 분명합니다.
구간 예측에서는 포함률, 폭, Winkler, pinball을 같이 읽어야 합니다. Tracker가 native quantile보다 더 정확한 포함률을 보이더라도 평균 pinball은 더 나쁠 수 있습니다. PT의 0.792 포함률은 평균적인 calibration 개선을 모든 지역의 명목 수준 충족으로 표현하지 못하게 합니다. 이 결과는 원문이 주장한 장기 특성과 관측 창의 실제 성능을 분리해서 보고해야 함을 보여 줍니다.
기술적 함의와 응용
리뷰어의 해석으로, 이 연구의 가장 재사용하기 좋은 부분은 모델을 바꿀 수 있는가보다 어떤 손실을 언제 관측할 수 있는가를 먼저 명세하는 방식입니다. 예측값을 저장하고 완성된 정답으로 그 당시의 예측을 채점하는 구조는, 모델 내부 접근이 없어도 보정 계층의 정보를 감사할 수 있게 합니다. 데이터 분할도 fit, 초기 배분, stopping epoch의 역할을 분리하므로 초기화가 테스트 성능에 끼치는 영향을 읽기 쉽습니다.
동시에 결과는 관측된 안전성과 이론적 보장을 구별할 것을 요구합니다. 손실 범위와 학습률 조건이 있는 표준 regret, 지연 피드백, 짧은 스트림의 초기 비용, 정답 버전 이동은 서로 다른 문제입니다. Simplex에 원래 모델을 포함했다는 사실만으로 모든 유한 스트림에서 MSE가 악화되지 않는다고 말할 수 없습니다. 실제로 긴 horizon, 빠른 전문가, 전이되지 않는 warm 배분, 다른 버전의 정답에서 저자들은 실패를 보고합니다.
산업적 적용 범위는 외부에서 재학습할 수 없는 기관 예측이나 고정된 예측 서비스를 보정하는 상황입니다. 다만 이 논문에서 확인한 운영 데이터는 전력 수요 한 종류입니다. 저자들이 제시한 지연 인지 가중치, fit 길이 guard 강화, 공통 개정 항의 직접 추정, warm 배분의 전이 실패 대응은 후속 연구 방향으로 남아 있습니다. 역학 감시나 상품 시장으로의 확장 역시 원문이 제안한 평가 대상이며 검증 결과가 아닙니다.
이 논문은 얼마나 많이 수정할지를 미리 정하는 대신, 성숙한 성과를 보고 수정 비중을 정합니다. 그 유용성은 전문가의 변화가 충분히 느리고, 학습·warm·평가에 필요한 기록이 남아 있으며, 학습 정답과 평가 정답이 정렬되어 있는 조건과 함께 읽어야 합니다.
검토 범위와 생략 범위. v1의 본문 §1–§8, Data and code availability, 보충 S1–S14를 모두 반영했습니다. Tables 1–8 및 S1–S23의 역할과 주요 판단 근거를 검토했으나 각 표의 모든 행과 Figure 1–8·S1 전부를 복제하지는 않았습니다. 원문 Figure 2·3과 Table 8을 직접 크롭해 수록했습니다. 인용 문헌 전체, 공개 예정인 실행 파일, 원 코드의 독립 재실행은 검토 범위에 포함되지 않습니다. 원문 실험의 미실행·거부 항목은 해당 챕터에 구체적으로 밝혔으며, 이를 성공한 평가로 세지 않았습니다.