논문 개요와 전체 구조
영상 세계 모델은 사용자 행동에 반응하는 그럴듯한 장면을 만들 수 있습니다. 그러나 장면 밖으로 사라진 인물이 여전히 존재하는지, 공격 이후 체력이 얼마나 남았는지, 이미 발생한 사건이 이후에도 유효한지는 영상만으로 관리하기 어렵습니다. Programmable World Model(PWM)은 이러한 세계의 사실을 명시적 엔진이 관리하고, 영상 모델은 그 상태를 시각화하도록 역할을 나눕니다.
연결 고리는 상태 정보를 덧붙인 3차원 방향성 경계 상자인 3D oriented bounding box(OBB)입니다. 상자는 객체의 위치·크기·방향을 표현하고, 엔진은 여기에 식별자·속성·관계·규칙을 연결합니다. 카메라 시점에 맞게 상자를 투영한 제어 신호가 생성 모델에 전달되므로, 프로그램이 정한 상태와 생성 영상 사이에 공간적 대응이 생깁니다. 본 리뷰는 2026년 9월 9일 제출된 arXiv:2609.10540v1의 HTML 전체 본문과 17쪽 PDF를 기준으로 작성합니다. 버전 고정 원문
원문에는 별도 목차 대신 다음 섹션 구조가 있으며, 부록은 없습니다.
- Introduction
- Representation Trade-offs
- Related Work: 3.1 Interactive Video World Models → 3.2 Explicit-state World Modeling → 3.3 Generative Rendering
- Method: 4.1 Problem Formulation → 4.2 Agent-Orchestrated Box World → 4.3 Control Compilation → 4.4 Generative Renderer(4.4.1 Conditional Video Generation, 4.4.2 Chunk-Autoregressive Long-Horizon Rendering) → 4.5 Automatic Training Data Pipeline
- Experiments: 5.1 Experimental Setup → 5.2 Quantitative Results → 5.3 Qualitative Results
- Conclusion, 이후 References
핵심 기여와 혁신성
저자가 강조하는 문제는 개별 객체를 지정하는 제어, 화면 밖 객체와 비시각적 속성을 포함한 지속적 상태, 반복 적용 가능한 실행 규칙의 부재입니다. 가령 “문을 열어라”라는 프롬프트는 장면을 유도하지만, 특정 열쇠를 가진 경우에만 문이 열린다는 규칙을 이후 모든 상호작용에 적용하는 장치와는 다릅니다.
PWM의 기여는 세 가지입니다. 첫째, 코딩 에이전트와 경량 엔진이 세계 상태를 구성·갱신하고, OBB와 결정적 컴파일러가 이를 영상 모델에 연결합니다. 둘째, 일반 영상에서 카메라·객체 추적·의미·운동 정보를 회수하는 자동 학습 데이터 파이프라인을 제시합니다. 셋째, 엔진 상태와 영상의 일치 여부를 평가하는 CombatStateBench를 구축합니다. 원문 §1
리뷰어 관점에서 핵심은 생성 모델의 기억 능력만 개선하는 것이 아니라, 무엇을 엔진의 확정 상태로 유지하고 무엇을 생성 모델의 시각적 완성에 맡길지 정했다는 점입니다. 다만 아래 정량 결과는 전투 장면의 전역적 객체 수·사망 상태에 대한 평가이므로, 모든 게임 규칙이나 물리 법칙의 정확성을 검증한 결과로 확대하지 않습니다.
기술적 세부사항
전체 흐름은 원문의 식 (3)으로 요약됩니다.
$s_t$는 현재 세계의 기준 상태, $a_t$는 플레이어 행동이며, $F$는 규칙을 실행하는 엔진입니다. $C_{t+1}$은 다음 카메라, $P$는 갱신된 상태를 시점에 정렬된 제어 맵 $M_{t+1}^{\mathrm{ctrl}}$로 만드는 결정적 컴파일러입니다. $G$는 관측 영상 $I_{t+1}$을 생성합니다. 예를 들어 공격 이후 사망 상태를 먼저 엔진에 기록하고, 바뀐 객체의 공간·운동 정보를 투영한 다음 영상을 생성합니다. 영상 결과로 엔진의 사실을 다시 추측하는 흐름이 아닙니다. 원문 §4.1, 식 (3)
영상 렌더러는 LingBot-World-v1을 기반으로 기존 카메라 제어 경로를 유지하고 Structured Spatial ControlNet을 추가합니다. 고정 길이 영상 생성 학습에서는 사전학습 본체와 카메라 경로를 동결하고 공간 제어 분기를 학습합니다. 장기 생성에는 완료된 청크의 시간 이력과 깊이·카메라를 이용한 공간 메모리를 결합합니다. 학습 영상은 HUD가 없는 Cyberpunk 2077, Forza Horizon 6, Grand Theft Auto V 플레이 영상이며, 평가는 50개 전투 클립으로 구성합니다. 비교 모델인 LingBot-World-V2와 기반 모델 v1은 구분해야 합니다. 원문 §4.4, §5.1
챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: 영상의 사실성과 실행 가능한 세계의 일관성이 서로 다른 요구임을 제시합니다.
저자의 서술 순서를 따른 상세 내용: 먼저 저자는 최근 모델이 행동과 시각 이력을 바탕으로 반응성 높은 영상을 생성한다고 설명한 뒤, 세 가지 요구를 제시합니다. 개별 객체를 직접 다루는 인터페이스, 현재 시점과 무관하게 접근할 수 있는 전역 상태, 사건의 결과를 지속적으로 결정하는 프로그램 규칙입니다. 체력이나 소지품처럼 눈에 보이지 않는 사실도 미래 행동을 좌우하므로 세계 상태에 포함되어야 합니다.
이어서 영상 모델과 상태 실행기를 연결할 표현의 선택으로 논의를 옮깁니다. 텍스트는 작성하기 쉽지만 기하학적 구속이 약하고, 2D 상자·마스크는 특정 시점에 종속됩니다. 반대로 세밀한 3D 구조는 학습 주석과 추론 시 구성 비용이 높습니다. 저자는 사람이 쓰러진다는 상태를 정하는 일과 모든 관절의 움직임을 정하는 일 사이의 차이를 예로 듭니다.
해결책인 상태 확장 OBB는 메시·재질·골격·사전 제작 애니메이션 없이 위치·크기·방향을 표현합니다. 식별자와 의미·동적 상태·외형 정보를 연결한 뒤, 컴파일러가 카메라 투영과 픽셀 대응을 계산합니다. 세밀한 형상과 관절 움직임은 영상 모델이 채웁니다. 마지막으로 단일 참조 이미지에서 초기 상태와 프로그램을 구성하고, 엔진 실행 → 제어 컴파일 → 영상 생성으로 이어지는 사용 흐름 및 세 가지 기여를 정리합니다.
챕터의 핵심 기여: 세계 상태를 영상 문맥에서 분리해야 할 이유를 명시합니다. 다음 챕터로의 연결: 이 분리에 적합한 표현이 왜 OBB인지 비용과 제어력의 관점에서 검토합니다. 원문 §1
📖 Chapter 2: Representation Trade-offs
챕터의 위치와 역할: OBB 선택을 단순한 구현 편의가 아니라 학습과 추론의 비대칭성에 대한 설계로 설명합니다.
저자의 서술 순서를 따른 상세 내용: 첫째, 가벼운 표현의 제어 범위를 살펴봅니다. 텍스트는 범주나 고수준 상태를 표현하지만 공유된 3D 좌표에서 위치·방향을 고정하지 않습니다. 2D 상자와 마스크는 카메라가 움직이면 위치·크기·가시 영역이 바뀌므로, 시점마다 관측을 제약하는 표현입니다. 재투영 가능한 세계 구조가 있으면 여러 카메라 관측을 같은 기준 상태에서 유도할 수 있습니다.
둘째, 구조가 풍부할수록 항상 유리하지는 않다고 설명합니다. 완전한 장면이나 관절 모델, 동적 기하는 세밀한 통제가 가능하지만 더 정밀한 학습 감독을 요구합니다. 추론 중에는 그 많은 자유도를 실제로 갱신해야 합니다. 쓰러지는 인물의 OBB는 위치·방향·점유 공간의 변화를 지정하면 되지만, 관절 모델은 자세·사지 운동·국소 변형까지 결정해야 합니다. 저자의 목표는 기존 애니메이션·물리 시뮬레이션 전체를 재구성하는 것이 아니라, 생성 모델이 가진 운동 사전지식을 활용하는 것입니다.
셋째, 식 (1)·(2)의 방향 차이를 설명합니다. 학습에서는 이미 실현된 운동 → 구조 표현을 추출합니다. 추론에서는 고수준 상태 전이 → 구조 표현 → 생성 운동을 만들어야 합니다. 따라서 영상에서 회수할 수 있는 표현이라도 프로그램이 미래 운동으로 쉽게 작성할 수 있다는 보장은 없습니다. 저자는 이 차이를 학습·추론 간 잠재적 불일치로 명시합니다.
마지막으로 OBB가 책임의 경계를 정합니다. 객체의 지속성·세계 좌표·상태 변화에 필요한 구조는 명시적으로 유지하고, 정확한 표면·재질·조명·관절·2차 운동은 생성 모델에 맡깁니다. 리뷰어 해석으로는 OBB가 상세 형상을 압축한 데이터라기보다, 엔진이 반드시 통제할 자유도의 계약에 가깝습니다.
챕터의 핵심 기여: 표현의 세밀함과 추론 시 실행 가능성을 함께 평가하는 기준을 제공합니다. 다음 챕터로의 연결: 기존 세계 모델과 생성 렌더링 연구를 이 역할 분담에 비추어 배치합니다. 원문 §2
📖 Chapter 3: Related Work
챕터의 위치와 역할: 관측 중심 모델, 명시적 상태 모델, 생성 렌더링의 세 연구 흐름에서 차별점을 설명합니다. 아래 비교는 저자의 문헌 해석이며, 인용 논문 전체를 독립 재검증한 결과는 아닙니다.
저자의 서술 순서를 따른 상세 내용: 3.1 Interactive Video World Models에서는 행동 조건 생성, 카메라 제어, 장기 생성의 발전을 소개합니다. 저자는 픽셀 중심 목적함수가 그럴듯한 관측을 감독하더라도 객체·관계·사건 결과를 실행 가능한 기준 상태로 조직하도록 직접 요구하지는 않는다고 설명합니다. 시간·공간 메모리도 관측의 일관성을 돕지만, 실행할 세계 사실을 보존하는 엔진과는 역할이 다릅니다.
3.2 Explicit-state World Modeling에서는 StatePlay와 MASS를 차례로 비교합니다. StatePlay는 관측과 게임 상태를 함께 예측하며, MASS는 권위 있는 공유 상태와 렌더링을 분리하지만 학습된 Logic Engine으로 상태를 전진시킵니다. 저자는 예측 기반 상태 갱신에는 전이 예측 오류가 발생할 수 있다고 지적하고, PWM은 명시적 규칙 실행으로 상태를 직접 편집·검증할 수 있다는 차이를 제시합니다.
3.3 Generative Rendering에서는 DiffusionRenderer의 G-buffer, AlayaRenderer 계열의 동적 세계 렌더링, Coarse-to-Real의 거친 3D 프록시를 순서대로 설명합니다. 상세한 표현일수록 구조적 통제가 강해지고, 가벼운 표현일수록 외형과 운동 완성을 생성 사전분포에 더 맡긴다는 연속선이 형성됩니다.
챕터의 핵심 기여: PWM의 차별성을 상태 예측 대신 규칙 실행, 상세 그래픽 대신 객체 단위 제어라는 두 축으로 정리합니다. 다음 챕터로의 연결: 이 개념적 분업을 상태·컴파일러·렌더러의 실제 인터페이스로 구체화합니다. 원문 §3
📖 Chapter 4: Method
챕터의 위치와 역할: 초기 관측에서 실행 가능한 세계를 만들고, 이를 장기 영상으로 변환하는 전체 시스템을 정의하는 핵심 장입니다.
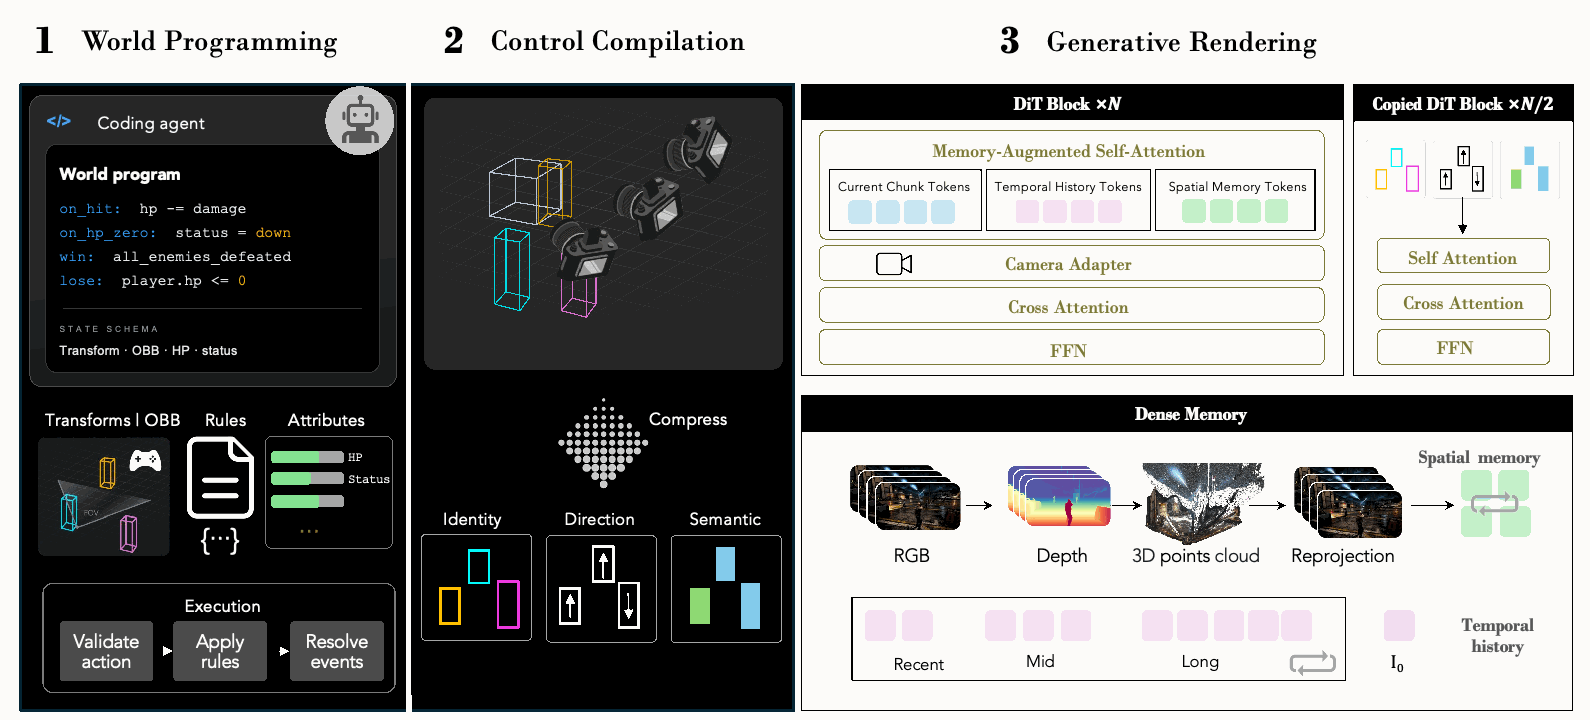
그림 3. Huang 외, Programmable World Model v1, PDF 6쪽의 Figure 3을 크롭했습니다. 영문 표기는 원문 그대로이며 아래 설명은 한국어 해설입니다. 버전 고정 원문
그림의 왼쪽은 에이전트가 구성한 세계를 엔진이 실행하는 단계, 가운데는 OBB 상태를 identity·direction·semantic 제어 맵으로 투영하는 단계, 오른쪽은 제어 분기와 Diffusion Transformer로 영상을 생성하는 단계입니다. 하단의 시간 이력과 공간 메모리는 장기 렌더링에 사용됩니다. 아래에서는 이 흐름을 원문의 소절 순서대로 살펴봅니다. 그림을 누르면 원본 크기로 확인할 수 있습니다.
4.1 Problem Formulation: 저자는 초기 관측 $I_0$와 행동 $a_t$를 정의하고 앞서 설명한 식 (3)의 처리 순서를 제시합니다. 엔진은 상태를 갱신하고, 컴파일러는 갱신된 상태를 읽으며, 렌더러는 해당 조건에서 관측을 만듭니다. 이 분리는 세계 좌표의 상태와 카메라 좌표의 시각 신호를 혼동하지 않게 합니다.
4.2 Agent-Orchestrated Box World — World representation and initialization: 세계는 지속적인 객체와 그 OBB, 속성, 관계, 규칙을 함께 저장합니다. 원문의 식 (4)는 다음과 같습니다.
$\mathcal{E}_t$는 객체와 3D 자세, $\mathcal{A}_t$는 의미·기능 속성, $\mathcal{Q}_t$는 객체 간 관계, $\mathcal{R}_t$는 실행 규칙입니다. 가령 인물의 OBB는 객체 집합에, 체력·진영은 속성에, 적대 관계는 관계 집합에, 공격 피해와 사망 조건은 규칙에 대응합니다. 초기 이미지에서 기존 3D 검출기가 보이는 객체의 상자와 식별자를 회수하여 기하 상태를 초기화합니다.
Agent-orchestrated world programming: 에이전트는 검출된 배치와 자연어 설명을 결합해 엔진이 읽을 프로그램을 만듭니다. 식별자로 객체와 프로그램을 연결하고, 초기 속성·지원 행동·사건 트리거·목표·전역 조건을 정의합니다. 전투 예에서는 진영·체력·공격 가능 관계를 지정한 뒤 사격의 피해, 사망, 목표 갱신을 규칙화합니다. 세밀한 3D 자산을 제작하는 대신 작은 기하 상태에 상호작용 의미를 부여합니다.
Engine execution: 식 (5)의 $s_{t+1}=F(s_t,a_t)$에 따라 엔진은 행동의 유효성을 검사하고 효과를 적용하며 연쇄 사건을 처리합니다. 체력·소지품·진영처럼 현재 화면에 드러나지 않는 값도 저장합니다. 중요한 순서는 세계 상태를 먼저 확정하고, 그중 시각화에 필요한 부분만 다음 단계로 넘긴다는 점입니다. 원문 §4.2, 식 (4)·(5)
4.3 Control Compilation — From world states to spatial controls: 컴파일러는 식 (6)의 $M_{t+1}^{\mathrm{ctrl}}=P(s_{t+1},C_{t+1})$를 계산하면서 세계 상태 자체는 바꾸지 않습니다. OBB를 목표 카메라에 투영하여 어느 화면 영역에 어떤 객체가 나타나야 하는지 정합니다. 화면에서 상자가 이동했다는 사실만으로 실제 객체 운동을 알 수는 없습니다. 카메라 이동도 같은 현상을 만들기 때문에 객체의 세계 속도를 별도로 사용합니다.
Structured projected-box controls: 투영 영역에는 세 종류의 신호를 담습니다. Identity map은 같은 객체에 같은 학습 가능한 식별 슬롯을 부여합니다. 학습 시 서로 다른 슬롯을 샘플 안의 객체들에 균등 배정하고, 샘플 간에는 무작위화하되 한 시퀀스 안에서는 고정합니다. 특정 슬롯이 특정 외형이나 범주와 우연히 결합되는 것을 방지하려는 설계입니다. 추론 중에도 객체가 가려지거나 화면 밖으로 나가더라도 슬롯은 유지됩니다.
Semantic map은 의미 레이블을 사전학습 텍스트 인코더로 변환하여 상자의 가시 영역에 배치합니다. 같은 범주의 객체는 의미 특징을 공유하되 식별 슬롯으로 구별합니다. 초기 관측에 없거나 외형 참조가 불확실한 객체에 특히 도움이 된다고 설명합니다. 상자가 겹치면 깊이에 따른 가시성 처리를 하고 배경은 0 특징을 사용합니다.
Direction map은 엔진의 세계 속도를 카메라 좌표로 회전한 뒤 forward·backward·left·right·static·up·down의 일곱 상태로 양자화합니다. 카메라 때문에 화면 위치만 바뀐 정지 객체는 여전히 static입니다. 마지막으로 식 (10)에 따라 채널 방향으로 결합합니다.
각 항은 각각 어느 객체인지, 어떤 범주인지, 객체 자체가 어느 방향으로 움직이는지를 담는 동일 공간 정렬 맵입니다. $\mathrm{Concat}$은 이 특징들을 채널 차원으로 이어 붙이는 연산입니다. OBB의 투영 기하와 카메라 경로가 여기에 결합하여 위치·가시성·시점 조건을 형성합니다. 원문 §4.3, 식 (6)–(10)
4.4.1 Conditional Video Generation: LingBot-World-v1의 기존 카메라 경로는 전역 시점을 제어하고, 추가 ControlNet은 객체 단위 조건을 처리합니다. 제어 시퀀스를 영상 잠재표현 해상도로 인코딩하여 노이즈가 있는 영상 잠재표현과 함께 처리합니다. 각 층의 제어 특징 $r^{(\ell)}$를 본체 특징 차원에 맞춘 뒤 $h_{\mathrm{main}}^{(\ell)}\leftarrow h_{\mathrm{main}}^{(\ell)}+r^{(\ell)}$로 주입합니다. 여기서 $\ell$은 층 번호이며, 덧셈은 해당 층의 생성 표현에 공간 제어를 반영하는 방식입니다.
식 (13)의 생성 함수는 다음과 같습니다.
$T$는 한 렌더링 창의 프레임 수, $I_{1:T}$는 생성 클립, $I_0$는 외형을 제공하는 초기 관측, $\mathcal{C}$는 목표 카메라 궤적입니다. $M_{1:T}^{\mathrm{ctrl}}$는 프레임별 객체 제어이며, $\theta$는 동결된 사전학습 본체, $\phi$는 학습할 공간 제어 분기 파라미터입니다. 이를 적용하면 카메라 궤적과 객체 상태를 각각 통제하면서 상자로 지정하지 않은 표면·재질·조명·관절 움직임을 생성 사전지식이 채웁니다.
4.4.2 Chunk-Autoregressive Long-Horizon Rendering: 긴 영상은 청크 단위 자기회귀 생성으로 확장합니다. 청크 내부의 노이즈 제거는 양방향이지만, 청크 사이의 정보는 완료된 과거에서만 전달됩니다. 첫 청크는 초기 이미지로 시작하고 시간 이력은 0으로 채우며 공간 메모리는 사용하지 않습니다. 이후 청크에는 시간 이력과 공간 메모리를 추가하고, 식 (14)의 $\psi$가 청크 간 시각 조건을 위한 추가 학습 파라미터를 나타냅니다.
먼저 Temporal history는 최근·중간·장기 이력을 다른 해상도의 토큰으로 보존합니다. 가까운 이력은 세밀하게, 먼 이력은 거칠게 표현하고 초기 이미지의 잠재표현도 기준점으로 유지합니다. 학습에서는 실제 이전 영상의 이력에 잡음·특징 손상·일부 제거를 적용하여 불완전한 자기회귀 문맥에 견디도록 합니다. 추론에서는 생성이 끝난 청크의 잠재표현을 이력에 넣습니다.
이어서 Geometry-aligned spatial memory는 유한한 시간 창에서 오래된 관측이 사라지는 문제를 다룹니다. AlayaWorld의 방식을 이용하여 완료된 RGB 프레임을 추정 깊이·카메라로 세계 공간에 올립니다. 다음 청크의 목표 시점에 관련 과거 관측을 재투영하고 공간 잠재 토큰으로 인코딩합니다. 저자는 큰 시점 변화·가림·재방문에서 시각 내용이 누락되거나 변하는 상황을 동기로 명시하며, 현재 청크의 미래 프레임을 메모리에 사용하지 않습니다. 원문 §4.4, 식 (11)–(14)
4.5 Automatic Training Data Pipeline: 이 절은 위 인터페이스에 필요한 주석을 일반 영상에서 만드는 순서를 설명합니다. Camera-parameter estimation에서 ViPE로 내부 파라미터·카메라 자세·미터 단위 깊이를 추정하여 프레임들을 공유 3D 좌표에 연결합니다. Semantic-category discovery에서 Qwen3-VL 기반 에이전트가 전체 영상 캡션과 셀 수 있는 객체 범주를 정합니다. 특정 도메인에서는 미리 정한 어휘로 대체할 수 있습니다.
Instance segmentation and tracking에서는 발견한 범주를 SAM3에 입력하여 마스크·2D 상자·범주·지속 추적 ID를 만듭니다. 너무 작거나 심하게 가려져 가시 면적이 부족한 마스크는 버립니다. Object-trajectory recovery에서는 WildDet3D에 추적된 2D 상자·RGB·깊이·내부 파라미터를 주어 프레임별 3D OBB를 추정합니다. 식 (15)의 상자 $b_i^t=(\mathbf{p}_i^t,\mathbf{d}_i^t,\mathbf{R}_i^t,\ell_i,k_i)$는 중심·크기·회전, 의미 레이블, 추적 식별자로 구성됩니다. 카메라 자세로 상자를 세계 좌표로 변환한 뒤 동일 ID를 이어 객체 궤적을 구성합니다.
연속 프레임의 세계 좌표 중심 차이에서 운동을 구하면 카메라에 의한 겉보기 이동을 제거할 수 있습니다. 이를 다시 현재 카메라 좌표로 회전하여 일곱 방향으로 양자화하며, 작은 변위는 임곗값으로 정지 처리합니다. 마지막 Conditioning-map generation은 OBB를 각 카메라로 투영하고 z-buffer로 겹침의 가시성을 해결한 뒤 식별·의미·방향 맵을 만듭니다. 이 순서로 실제 영상에서 추출한 감독 신호가 추론 시 엔진에서 생성하는 제어 형식과 연결됩니다.
챕터의 핵심 기여: 자연어 프로그램에서 영상까지 상태와 신호의 전달 경로를 구체화하고, 같은 인터페이스를 학습 데이터에서 회수하는 방법을 제시합니다. 다음 챕터로의 연결: 생성 결과가 실제로 엔진 상태에 맞는지 측정합니다. 원문 §4.5, 식 (15)
📖 Chapter 5: Experiments
챕터의 위치와 역할: 상태 일치와 영상 품질을 분리하여 평가하고, 정성 사례로 시점·범주·길이의 확장을 보여줍니다.
5.1 Experimental Setup — Training Data: Cyberpunk 2077은 1인칭, Forza Horizon 6와 GTA V는 다양한 시점의 3인칭 영상을 수집합니다. HUD가 없는 영상을 데이터 엔진으로 처리하여 영상과 제어 신호의 쌍을 만듭니다. Benchmark인 CombatStateBench는 첫 프레임에서 초기 3D 배치를 회수하고, AI 에이전트가 배치와 게임 규칙을 바탕으로 짧은 전투 상태 시퀀스를 전개한 50개 클립으로 구성됩니다. 초기 화면 밖 객체와 다양한 카메라·객체 운동을 포함하며, 사망한 객체는 해당 상태로 전환된 뒤 장면에 남습니다.
자동 검증기는 초기 프레임 재투영, 깊이 일치, 상자 기하, 지면 접촉, 시간 연속성, 지정된 카메라·객체 운동, 전이 지속성을 검사합니다. 모든 검사를 통과한 시퀀스만 평가에 남깁니다. 이 과정은 잘못 만든 제어 시퀀스와 렌더러 오류가 섞이지 않게 하려는 실험 설계입니다.
5.2 Quantitative Results — Baselines: LingBot-World-V2와 YUME에는 동일 초기 관측과 벤치마크 전이를 제공하되, 각 모델의 원래 조건 입력 경로를 유지합니다. 두 모델은 외부 인스턴스 상태 인터페이스가 없으므로 사건마다 환경 설명과 행동 설명을 바꾸는 prompt switching을 사용합니다. 따라서 이 비교는 동일한 구조 제어를 넣은 모델끼리의 통제 실험이 아니라, 명시적 엔진·공간 제어가 있는 시스템과 프롬프트 기반 시스템의 비교입니다.
VLM-based Evaluation: 판정기는 Qwen3.6-27B이며 생성 RGB만 봅니다. 정답 상자·식별자·기대 객체 수·사망 위치는 주지 않습니다. Count Accuracy는 클립당 무작위 8프레임, 총 400프레임에서 화면에 살아 있는 인물 수가 엔진 기록과 정확히 같은 비율입니다. State Accuracy는 사망 사건마다 전이 이후 균등 추출한 3프레임 중 적어도 하나에 사망 인물이 보이는지를 묻고, 총 50사건에서 성공 비율을 구합니다. 어느 인물이 어디에서 죽었는지를 식별해야 하는 지표는 아닙니다.
Video Quality: 원문 표 1의 모든 값은 백분율로 보고됩니다. Imaging은 프레임 선명도·노출·잡음 등의 품질, Subject Consistency는 전경 객체의 외형·구조·정체성 지속성, Background Consistency는 배경의 프레임 간 안정성입니다. Temporal Stability는 VBench의 temporal-flickering 점수에 기반하며 높을수록 깜박임이 적습니다.
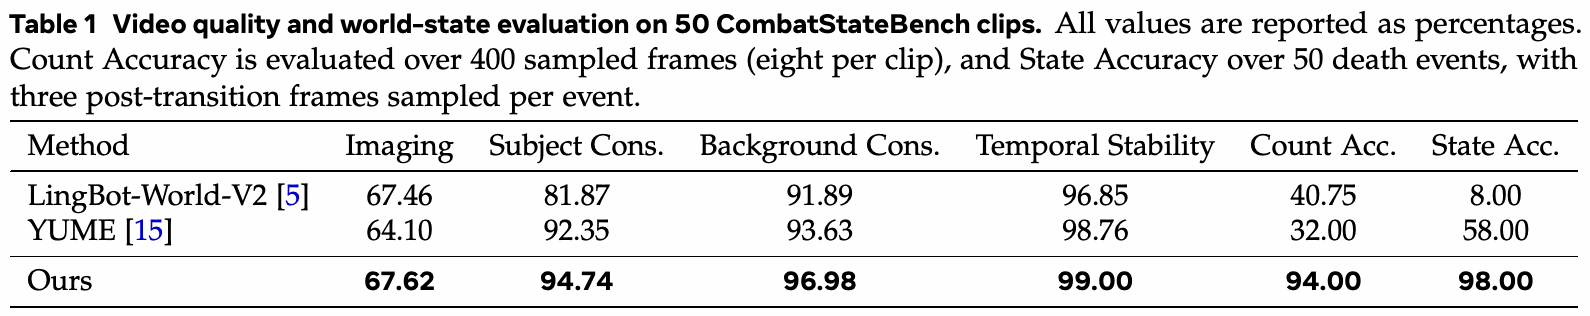
표 1 원본. Huang 외, Programmable World Model v1, PDF 12쪽의 Table 1과 평가 조건 캡션을 크롭했습니다. 수치·열 이름·영문 캡션은 번역하거나 수정하지 않았습니다. 버전 고정 원문
원본 표의 앞 네 열은 영상 품질, 마지막 두 열은 엔진 상태와 영상의 일치도를 평가합니다. 아래는 같은 수치를 읽기 편하도록 옮긴 표입니다. 원본 이미지의 캡션에서도 객체 수는 400프레임, 상태 정확도는 50개 사망 사건을 기준으로 평가했음을 확인할 수 있습니다.
| 방법 | Imaging | Subject Cons. | Background Cons. | Temporal Stability | Count Acc. | State Acc. |
|---|---|---|---|---|---|---|
| LingBot-World-V2 | 67.46 | 81.87 | 91.89 | 96.85 | 40.75 | 8.00 |
| YUME | 64.10 | 92.35 | 93.63 | 98.76 | 32.00 | 58.00 |
| PWM | 67.62 | 94.74 | 96.98 | 99.00 | 94.00 | 98.00 |
PWM은 상태 지표에서 큰 차이를 보이며 영상 품질 네 지표도 가장 높습니다. 다만 Imaging에서 LingBot-World-V2와의 차이는 0.16%p로 작습니다. 상태 정확도의 증가와 모든 영상 품질의 대폭 향상을 같은 주장으로 묶어서는 안 됩니다. 표의 열·분모·수치는 PDF 12쪽 표 1과 대조했습니다. 원문 §5.2, 표 1
5.3 Qualitative Results: 그림 4는 정적 카메라 및 움직이는 카메라·객체 조건에서 사망 상호작용을 비교합니다. 저자는 베이스라인에서 살아 있어야 할 인물이 사라지거나 사망 인물이 움직이고, 엔진 사건 없이 인물 수가 바뀌는 사례를 명시합니다. PWM은 지정된 사망과 남은 객체를 더 잘 유지하는 예를 제시합니다.
그림 5는 원문의 (a)→(e) 순서로, 새로운 미노타우로스 장면, 큰 카메라 회전에 따라 초기 시야 뒤의 인물 세 명이 드러나는 장면, 레이싱, 사람과 차량의 혼합, NPC가 점차 들어오는 897프레임 자기회귀 장면을 제시합니다. (b)·(e)의 첫 프레임은 학습에서 보지 않은 GTA V 영상이고, (a)·(c)·(d)는 GPT Image 2로 생성했습니다. 897프레임은 해당 정성 예제의 길이이며 평균 처리 속도나 모든 장면의 보장 길이가 아닙니다.
챕터의 핵심 기여: 전역적으로 관측 가능한 상태 일치의 개선과 다양한 생성 예를 함께 제시합니다. 다음 챕터로의 연결: 실험을 세계의 사실과 외형을 분담하는 설계 원칙으로 정리합니다. 원문 §5.1, §5.3
📖 Chapter 6: Conclusion
챕터의 위치와 역할: 논문의 전제를 다시 제시하고 결과의 의미를 종합합니다.
저자의 서술 순서를 따른 상세 내용: 저자는 생성 세계가 무엇이 사실인지 기억하는 일을 영상 생성에만 의존해서는 안 된다고 정리합니다. 먼저 명시적 상태를 유지하고 영상 모델을 주로 렌더러로 사용하는 설계를 되짚은 뒤, 상태 일관성 개선과 장기 생성·새 객체·시각 스타일·상호작용 도메인의 예를 요약합니다. 마지막으로 상태는 실행·검증 가능하게 유지하고 외형은 생성적으로 만드는 방향을 제시합니다.
이 결론은 논문의 실험 범위 안에서 읽어야 합니다. 새로운 스타일과 장르에 대한 근거는 정성 예이고, 정량 측정은 CombatStateBench의 제한된 상태 지표입니다. 별도 한계점 절이나 추가 연구 과제 목록은 제시하지 않으므로 본 리뷰도 임의의 한계·향후 과제를 덧붙이지 않습니다.
챕터의 핵심 기여: 시스템의 분업 원칙을 명확하게 마무리합니다. 이후에는 References가 이어지며, 별도의 본문 챕터나 부록은 없습니다. 원문 §6
실험 결과 심층 분석
두 상태 지표의 계산은 원문 식 (17)·(18)을 따라 구분해야 합니다.
$N$은 샘플 프레임 수 400, $\hat n_i$는 VLM이 센 가시 생존 인물 수, $n_i^{\mathrm{eng}}$는 엔진 기록입니다. 지시 함수 $\mathbf{1}$은 두 수가 같을 때만 1입니다. 94%는 인물 검출 재현율이나 전체 객체 식별 정확도가 아니라 프레임 단위 개수의 정확 일치율입니다.
분모는 50이며, 분자는 사건 후 세 프레임 중 하나라도 사망 인물을 보여 준 사건 수입니다. PWM의 98%는 49/50에 해당하지만, 특정 대상의 사망 위치나 개체 대응을 맞췄다는 뜻은 아닙니다. 저자도 두 지표가 거친 전역 속성만 평가하고 인스턴스 대응을 직접 보상하지 않는다고 명시합니다. 원문 §5.2, 식 (17)·(18)
Count Accuracy 개선은 LingBot-World-V2 대비 53.25%p, YUME 대비 62.00%p이고, State Accuracy 개선은 각각 90.00%p, 40.00%p입니다. 이는 지정된 전투 전이를 화면의 인물 수와 사망 표현에 연결하는 실용적 개선입니다. 반면 입력 인터페이스가 다르므로 이 표만으로 OBB, 식별 맵, 방향 맵, 두 메모리 각각의 기여를 분리해 추정하지 않습니다.
통계적 유의성 검정과 신뢰구간은 논문에 보고되지 않았습니다. 한 클립에서 여러 프레임을 뽑은 평가이므로 400프레임을 400개의 독립 시나리오와 동일하게 취급하지 않습니다. VLM 판정의 결과를 사람이 검증한 정확도로 바꾸어 표현하지도 않습니다. 정성 결과는 메커니즘을 이해하는 사례이며 성공 확률의 별도 추정치는 아닙니다.
재현성 관점에서 원문은 데이터 출처, 주석 도구, 조건 신호, 판정 모델, 샘플 수와 지표를 설명하여 평가의 의미를 파악할 수 있게 합니다. 다만 본 리뷰에서 읽은 v1 본문에는 학습 클립 총량, 학습률·스텝 등 완전한 학습 설정과 반복 실험 분산이 제공되지 않습니다. 이는 결과 재현에 필요한 정보 범위를 확인한 것이며 방법 자체의 결함으로 단정하지 않습니다. 원문에는 프로젝트·코드 링크가 기재되어 있으나, 연결된 코드의 동작이나 공개 범위는 이번 논문 리뷰에서 검증하지 않았습니다.
기술적 함의와 응용
저자가 제시한 방향은 세계 상태를 실행·검증 가능하게 유지하면서 외형은 생성적으로 만드는 것입니다. 이는 문 열림 조건, 전투 체력, 사건 트리거처럼 규칙을 명시할 수 있는 상호작용에 특히 자연스럽습니다. 실제 논문은 전투 상태를 정량 평가하고 레이싱·혼합 객체·초기 시야 밖 객체를 정성 예로 보여 줍니다.
리뷰어 해석으로는 이 설계가 응용에서 요구하는 보장 범위를 나누는 데 의미가 있습니다. 엔진이 규칙대로 상태를 유지하는지와 렌더러가 그 상태를 화면에 얼마나 정확히 나타내는지는 각각 확인할 문제입니다. PWM은 그 둘 사이에 OBB 제어 신호라는 관측 가능한 인터페이스를 놓았고, CombatStateBench는 그 연결의 일부를 측정합니다. 따라서 “플레이 가능한 세계”라는 주장은 생성 영상의 외형뿐 아니라 상태와 관측의 대응을 함께 읽을 때 정확하게 이해할 수 있습니다.
분석 범위: v1의 본문 §1–§6 및 모든 하위 절을 원래 순서로 반영했습니다. 부록은 없으며, 핵심 식 (3)–(18)의 의미를 중심으로 설명하되 식 (7)–(9)의 임베딩 집합 표기와 중복되는 식 (11)·장기 생성 식 (14)의 전체 전사는 생략했습니다. 그림 1–5는 본문 설명과 캡션을 반영했으며 표 1은 PDF와 대조했습니다. 참고문헌 24편의 개별 원문과 외부 프로젝트의 동영상·코드는 분석 범위에 포함하지 않았습니다.