1. 논문 개요와 전체 구조
Show-Harness: Just a VLM Agent Can Play Robots는 시각과 언어를 함께 처리하는 Vision–Language Model(VLM)이 로봇을 조작할 때, 모델과 로봇 사이에 어떤 행동 인터페이스를 두어야 하는지 연구합니다. Show Lab의 Yanzhe Chen 등은 방향 이동·회전·잡기처럼 의미가 분명한 작은 행동을 모델에 노출하고, 로봇별 해석기가 이를 실제 제어 명령으로 변환하는 Show-Harness를 제안합니다. 본 리뷰는 2026년 9월 9일 공개된 arXiv v1을 분석합니다. 수치는 저자 보고값이며 독립 재현 결과가 아닙니다. 논문 정보
원문의 구조는 다음과 같습니다. 상세 리뷰에서도 이 순서를 유지합니다.
| 원문 챕터 | 하위 구조 |
|---|---|
| 1. Introduction | 문제 설정과 기여 |
| 2. Related Work | 2.1 Foundation Models for Robot Manipulation → 2.2 Agentic Robot Systems |
| 3. Show-Harness | 3.1 Overview → 3.2 Physically Grounded Semantic Action Interface → 3.3 Embodied Harness Architecture → 3.4 Two Modes on One Interface |
| 4. GUMI: A GUI-based Manipulation Interface | 사람·에이전트·정책 학습의 공통 인터페이스 → 유연한 데이터 수집 |
| 5. Experiments | 5.1 설정 → 5.2 일반화 → 5.3 물리적·의미적 적응 → 5.4 절제 실험 → 5.5 정성 분석 |
| 6. Conclusion and Limitations | 결론과 저자가 명시한 한계 |
| References | 관련 연구의 출처 |
| 7. Appendix | 7.1 미세조정 → 7.2 시연 데이터 → 7.3 정성 비교 → 7.4 실행 프롬프트 |
2. 핵심 기여도와 기존 연구와의 차이
논문의 출발점은 의미적 판단과 물리적 실행의 연결입니다. Vision–Language–Action(VLA)은 관측과 지시를 로봇 동작으로 연결하는 모델 계열입니다. 저자는 로봇별 연속 제어 신호에 맞춘 학습이 필요하다는 점과, 반대로 고수준 에이전트가 하위 제어기에 실행을 맡기면 실제 움직임과 의미적 판단의 연결이 간접적이 된다는 점을 문제로 설정합니다. 이는 이 논문이 기존 접근을 바라보는 관점이며, 모든 VLA나 계층적 시스템이 동일하게 동작한다는 뜻은 아닙니다. 1절, 2절
핵심 제안은 MV_LEFT, MV_DOWN, GRASP와 같은 작고 해석 가능한 행동 단위입니다. 모델은 다음 단위를 결정하고, 로봇별 해석기가 이동 거리·좌표 변환·제어기를 처리합니다. 고수준 작업 전체를 숨겨진 실행기에 넘기는 대신, VLM이 세밀한 행동 선택을 반복합니다. 같은 인터페이스를 대형 모델의 zero-shot 제어와 소형 모델의 미세조정에 사용하며, 사람이 키보드로 시연을 수집하는 GUMI에도 적용합니다.
리뷰어의 해석으로는, 이 연구의 독창성은 새로운 대형 정책 모델 자체보다 행동 표현과 실행 책임의 분할에 있습니다. 모델 능력, 제어기, 데이터 수집 인터페이스를 한꺼번에 바꾸지 않고 연결할 수 있다는 점이 기술적 의미입니다. 아래 실험은 이러한 설계의 효과를 평가하지만, 비교한 모델·로봇·작업 범위 안에서 읽어야 합니다.
3. 기술적 세부사항의 핵심
전체 계산은 관측을 문맥으로 정리하고, 행동을 고른 뒤, 실제 로봇 명령으로 바꾸는 세 단계입니다. 원문 식 (1)~(3)을 함께 쓰면 다음과 같습니다.
여기서 $\ell$은 작업 지시, $o_t=(\mathcal I_t,p_t)$는 여러 카메라 영상과 로봇의 내부 상태를 포함한 현재 관측, $h_t$는 최근 상호작용 이력입니다. $\Phi_{\mathcal P}$는 활성화된 플러그인으로 문맥 $c_t$를 구성합니다. 정책 $\pi$는 행동 집합 $\mathcal A$에서 $a_t$를 선택합니다. $g_E$는 로봇 형태 $E$에 맞는 해석기이며, 내부 목표 상태 $s_t$를 이용해 실행 명령 $u_t$를 만듭니다. 실행 후 새 관측이 들어오므로 결과를 보고 수정하는 폐루프입니다. 3.1절, 식 (1)~(3)
적용 예를 설명하면, 모델이 왼쪽 이동이라는 의미를 선택했을 때 실제 좌표계에서 어느 방향으로 얼마만큼 움직일지는 해석기가 처리합니다. 이 예는 수식의 설명이며 저자가 제시한 실행 로그를 재현한 것은 아닙니다. 물리적 변환 수식과 학습 목적함수는 다음 챕터 리뷰에서 원래 등장 위치에 맞추어 설명합니다.
4. 원문 순서를 따른 챕터별 상세 리뷰
📖 Chapter 1: Introduction
챕터의 위치와 역할: VLM의 일반적 지능이 로봇 조작으로 바로 이어지지 않는 이유를 인터페이스 문제로 정리합니다.
- 기존 연결 방식의 대비: 저자는 로봇별 저수준 행동을 학습하는 VLA와, 하위 작업·프로그램을 출력하는 계층적 접근을 차례로 설명합니다. 전자는 운동 신호에 대한 적응, 후자는 판단과 실제 실행 사이의 간접성이 주요 논점입니다.
- 의미적이면서 세밀한 행동 공간: 방향별 한 걸음 이동과 그리퍼 동작을 노출하고, 해석기가 이를 제한된 물리 변화로 연결합니다. 매 행동 후 결과를 반환하여 모델이 수정할 수 있도록 합니다.
- 두 운영 방식: 대형 VLM을 추가 학습 없이 사용하거나, 작은 VLM을 같은 행동 공간에 맞추어 학습합니다. 두 방식의 비용과 역할은 다르지만 인터페이스는 공유합니다.
- GUMI와 기여 정리: 사람이 조작하는 GUI도 동일한 행동을 사용하므로 인간 시연과 에이전트 실행을 같은 데이터 형태로 모을 수 있습니다.
챕터의 핵심 기여: 인터페이스를 모델 능력과 물리 제어 사이의 핵심 설계 대상으로 제시합니다. 다음 챕터로의 연결: 기존 로봇 기반 모델과 에이전트 시스템에서 이 설계가 차지하는 위치를 설명합니다. 1절
📖 Chapter 2: Related Work
챕터의 위치와 역할: 관련 연구를 저수준 정책, 중간 의사결정, 에이전트 시스템이라는 흐름으로 배치합니다.
2.1 Foundation Models for Robot Manipulation
먼저 저수준 정책으로 사용하는 기반 모델을 다룹니다. 연속 행동 chunk, 이산 운동 token, 공간 격자 행동, 잠재 행동 표현과 video–action 모델을 소개합니다. 이후 다양한 작업·로봇을 포괄하는 기반 정책과 적응 방법을 설명하고, 운동 표현에 맞춘 학습이 의미적 지식의 활용과 어떤 긴장을 갖는지 논의합니다.
다음은 중간 의사결정자로 사용하는 기반 모델입니다. VLM이 subgoal, keypoint, affordance, 공간 제약 등을 정하면 하위 제어기가 실행합니다. Affordance는 여기서 물체의 손잡이처럼 특정 행동에 적합한 부분이나 사용 가능성을 가리킵니다. 저자는 장기 실행에는 피드백과 실패 복구가 필요하다는 점을 통해 에이전트 시스템으로 논의를 연결합니다.
2.2 Agentic Robot Systems
- Agentic architectures: 프로그램 생성, 사전 정의 skill 호출, VLA에 언어 목표 전달, 계획기·최적화기 활용을 차례로 분류합니다. 작업 문맥, 기억, 실행 감시와 재계획도 harness의 역할로 설명합니다.
- Interfaces for embodied execution: 어떤 primitive를 모델에 제공하는지가 성능에 영향을 준다고 정리합니다. Show-Harness는 작업 전체보다 작은 이동 단위를 제공해, VLM이 구체적인 움직임 선택에 관여하도록 설계합니다.
- From digital interfaces to physical manipulation: 마우스·키보드·게임 입력처럼 사람과 모델이 함께 다룰 수 있는 이산 인터페이스를 로봇 조작으로 확장합니다. 실제 로봇에서는 높은 차원과 정밀도가 문제이므로 해석기를 통한 물리적 연결이 필요합니다.
챕터의 핵심 기여: Show-Harness를 단순한 프롬프트 모음이 아니라 실행 인터페이스 설계로 위치시킵니다. 다음 챕터로의 연결: 그 인터페이스와 폐루프 구조를 수식과 모듈로 구체화합니다. 2절
📖 Chapter 3: Show-Harness
챕터의 위치와 역할: 관측부터 실제 행동까지의 데이터 흐름, 물리 변환, 플러그인, 학습 방식을 정의합니다.
3.1 Overview
작업 지시, 다중 시점 영상, proprioception을 문맥으로 구성합니다. Proprioception은 로봇 자신의 위치·그리퍼 상태·접촉 상태 등에 관한 내부 감각 정보입니다. VLM은 위 식 (1)~(3)의 흐름대로 행동을 선택하고, 실행 결과를 다음 판단에 반영합니다. 모델이 숫자로 된 모터 명령을 직접 출력하는 구조는 아닙니다. 3.1절
3.2 Physically Grounded Semantic Action Interface
Semantic action space: 기준 카메라 시점에 대해 전후·좌우·상하 이동 여섯 개를 제공합니다. 회전이 필요한 작업에는 축과 함께 ROTATE_CW, ROTATE_CCW를 사용합니다. GRASP, RELEASE, DONE은 잡기·놓기·완료를 의미합니다. 저자는 작은 변화의 누적, 로봇 형태와 분리된 의미 표현, 영상에 근거한 방향 정의를 세 가지 성질로 제시합니다.
Embodiment grounding: 원문 식 (4)는 행동을 6자유도 Cartesian 목표 자세에 적용합니다.
$\mathbf{x}_t$는 3차원 위치, $Q_t$는 회전행렬, $s_t=(\mathbf{x}_t,Q_t)$는 목표 자세입니다. $d_a$는 이동 방향, $r_a$는 회전축과 방향을 표현합니다. 이동 행동에서는 $r_a=0$, 회전 행동에서는 $d_a=0$입니다. $\sigma_t$와 $\theta_t$는 이동 거리와 회전 각도이며, $R_E$는 의미적 방향을 해당 로봇의 좌표계로 변환합니다. $[\cdot]_{\times}$는 벡터를 반대칭행렬로 바꾸는 연산이고, 행렬 지수 $\exp$는 이를 회전으로 변환합니다. $\Pi_E$는 작업 공간과 단계별 이동·회전 제한을 적용합니다.
따라서 이동 간격을 바꿀 때는 $\sigma_t$를 조정하고, 로봇을 바꿀 때는 좌표 변환과 하위 제어를 담당하는 해석기를 교체합니다. 그리퍼 행동은 이 자세 갱신을 우회해 열기·닫기 명령으로 연결됩니다. Franka는 접촉 시 힘과 움직임의 관계를 조절하는 impedance control, AgileX는 목표 자세에서 관절값을 구하는 inverse kinematics와 관절 목표 스트리밍을 사용한다고 설명합니다. 작업 공간과 테이블 높이 제한에 어긋나는 행동은 실행 전에 차단하도록 구성합니다. 이 제한은 논문이 제시한 구현 장치이며 모든 물리 위험에 대한 보장을 뜻하지 않습니다. 3.2절, 식 (4)
3.3 Embodied Harness Architecture
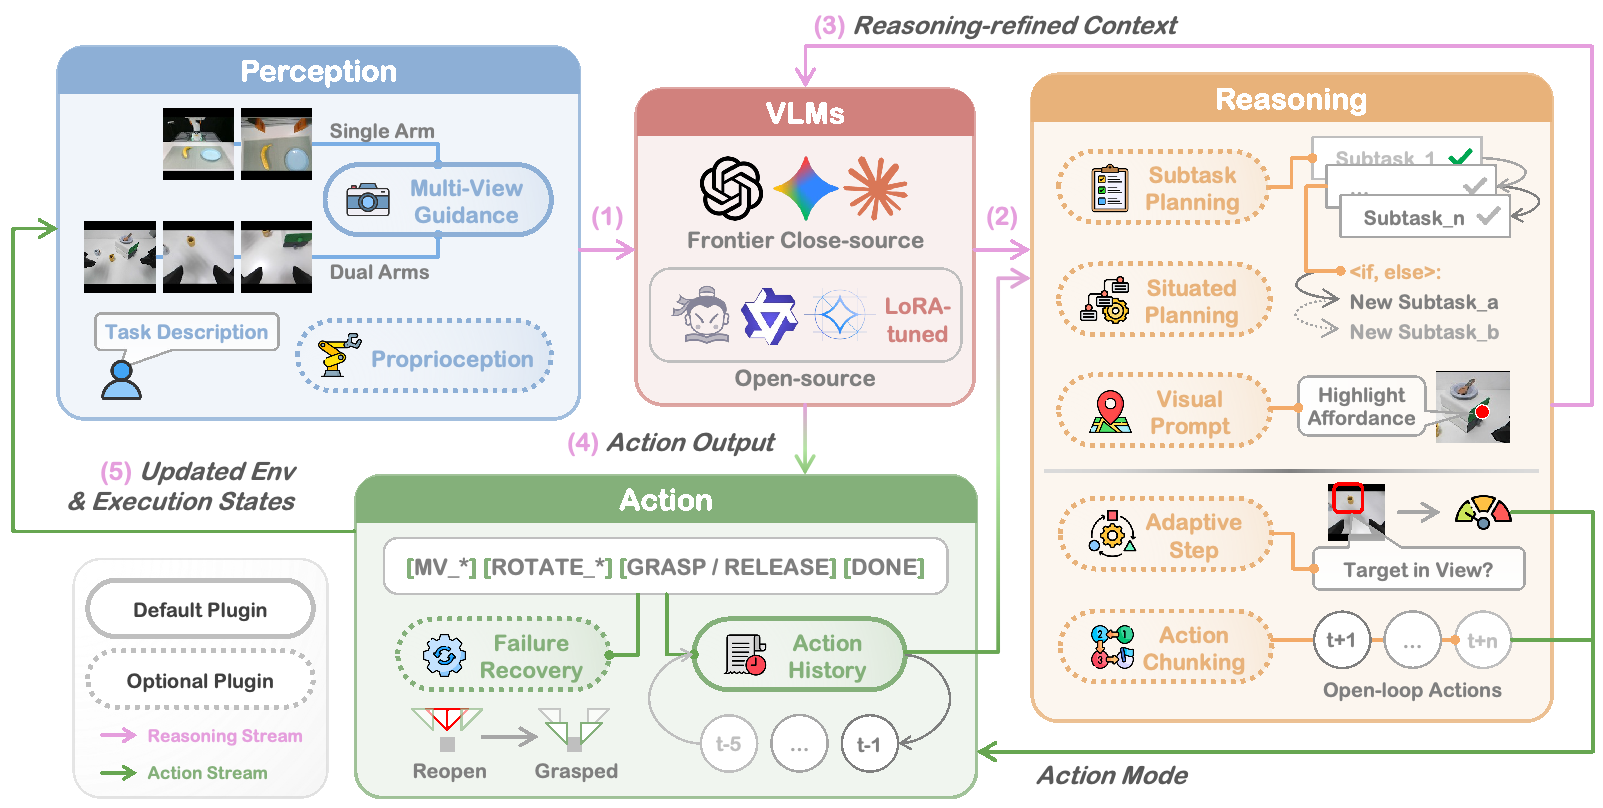
그림 3. Yanzhe Chen 등의 Show-Harness 아키텍처. arXiv 2609.10522v1, Figure 3, PDF 5쪽에서 그림 영역만 크롭했습니다. 원본 영문 표기·화살표·범례를 보존했으며, 캡션과 아래 해설은 한국어로 작성했습니다. 이미지를 누르면 확대할 수 있습니다.
그림의 보라색 화살표는 관측을 받은 VLM이 추론 플러그인을 거쳐 정제된 문맥을 다시 받는 흐름을, 초록색 화살표는 행동 출력과 실행 상태가 다음 관측으로 돌아오는 흐름을 표시합니다. 실선과 점선 테두리는 기본·선택 플러그인을 구분합니다. 오른쪽의 계획·보폭 조정과 아래쪽의 행동 이력·복구가 한 루프에 결합되어 있으므로, 아래 설명에서도 각 기능이 어느 시점의 정보에 개입하는지를 구분합니다.
Perception: Multi-View Guidance는 전체 장면과 손목 카메라의 역할을 알려 줍니다. Proprioception은 높이·이동량·접촉·그리퍼 상태를 짧은 텍스트로 전달합니다. 영상만으로 깊이나 잡기 상태를 판단하기 어려운 경우를 보완하려는 구성입니다.
Reasoning: 원문 순서대로 다섯 플러그인을 둡니다.
- Subtask Planning: 작업을 순서 있는 하위 목표와 영상으로 확인 가능한 완료 조건으로 나눕니다. 다음 단계로 넘어갈지는 모델이 관측을 보고 결정합니다.
- Situated Planning: 아직 보이지 않는 정보에 대한 결정을 미루고, 실행 중 증거가 생겼을 때 남은 계획을 갱신합니다.
- Action Chunking: 목표가 멀 때 짧은 행동 열을 한 번에 출력해 모델 호출을 줄입니다. 그 구간은 다음 관측 전까지 open-loop로 실행됩니다.
- Adaptive Step: 멀리서는 큰 보폭, 가까이서는 작은 보폭을 사용해 효율과 정밀도를 조절합니다.
- Visual Prompt: 언어로 특정하기 어려운 상호작용 위치를 별도 모델 호출로 표시하고 그 시각적 표식을 판단에 활용합니다.
Action: Action History는 최근 행동을 다음 문맥에 넣어 좌우 왕복 같은 진동을 줄입니다. Failure Recovery는 잡기 실패를 감지하면 그리퍼를 재설정하고 해당 잡기 단계로 돌아갑니다. 즉, 성공률은 행동 어휘만 아니라 관측·계획·복구가 함께 작동한 결과입니다. 3.3절과 표 1
3.4 Two Modes on One Interface
Frontier VLM as zero-shot agents (ZS mode): 사전학습된 대형 VLM을 미세조정 없이 harness에 넣습니다. 여기서 zero-shot은 로봇 작업용 추가 모델 학습이 없다는 의미이며, 로봇별 해석기와 프롬프트까지 필요 없다는 뜻은 아닙니다.
Fine-tuning small VLMs (FT mode): 소형 VLM은 시연에서 의미 행동을 예측하도록 학습합니다. 원문 식 (5)는 다음과 같습니다.
$\mathcal D$는 지시·관측·최근 이력·정답 행동으로 구성된 시연 데이터입니다. $\theta$는 학습하는 모델 파라미터이며, $\mathcal P_{\mathrm{min}}$은 최소 문맥 구성입니다. 정답 행동의 조건부 확률을 높이도록 음의 로그확률을 줄이는 token 수준 교차 엔트로피 목적함수입니다. 모델의 기존 어휘를 사용하므로 전용 action head나 새로운 special token을 도입하지 않습니다. 기본 FT에서는 복잡한 planner 없이 지시·영상·짧은 이력을 사용합니다. 3.4절, 식 (5)
챕터의 핵심 기여: 동일한 의미 공간으로 대형 모델 추론과 소형 모델 학습을 연결합니다. 다음 챕터로의 연결: 이 행동을 사람이 조작하고 학습 데이터를 수집하는 GUI로 확장합니다.
📖 Chapter 4: GUMI: A GUI-based Manipulation Interface
챕터의 위치와 역할: 제어 인터페이스를 시연 수집 인터페이스로 재사용합니다.
- A shared interface for humans, agents, and policy learning: 행동 단위를 GUI 버튼·키 입력에 대응시킵니다. 사람은 키보드로, computer-use agent는 GUI로, 일반 VLM agent는 행동 단위를 직접 예측해 조작합니다. 실행 전 관측과 행동 $(o_t,a_t)$를 저장하며, 대응하는 저수준 명령과 궤적도 보존할 수 있습니다. 같은 시연으로 의미 행동 정책과 연속 제어 정책을 학습시키는 비교가 가능해집니다.
- Flexible and reusable data collection: 단계별 조작, 행동 대기열, 단일·양팔 조작, 에이전트 실행에 대한 인간 개입을 지원합니다. 전용 원격조종 하드웨어 없이 같은 인터페이스를 시뮬레이션과 실제 로봇에서 사용하도록 설계합니다. 저자는 디지털 접근성에 따른 원격 수집 가능성도 설명합니다.
챕터의 핵심 기여: 실행과 시연의 표현을 일치시키고 비교 실험의 공통 데이터 기반을 제공합니다. 다음 챕터로의 연결: 이 방식으로 모은 데이터와 로봇 환경을 이용해 성능을 평가합니다. 4절
📖 Chapter 5: Experiments
챕터의 위치와 역할: 기본 성능부터 물리·의미 적응성, 각 설계 요소의 기여까지 순차적으로 평가합니다.
5.1 Experimental Setup
- Hardware: 7자유도 Franka Research 3에는 외부·손목 카메라를, 두 개의 6자유도 AgileX 팔에는 공유 시점과 손목별 카메라를 둡니다. 모두 parallel-jaw gripper를 사용합니다. 로컬 모델 추론은 RTX 5090 한 장, 대형 모델은 API로 수행합니다.
- Tasks and metrics: 물체 다섯 종류와 plate·bowl 두 목적지의 조합으로 10개 작업을 구성합니다. 블록·바나나·테니스공은 FT 시연에 포함되고, 곰인형·체스 말은 분포 밖(OOD) 평가용입니다. 기본적으로 작업당 무작위 배치 10회, 최대 50단계이며 timeout은 실패로 셉니다. 성공률과 episode당 평균 단계를 평가합니다.
- VLM agents and harness: 기본 ZS는 Gemini-3.1 Pro, medium thinking effort입니다. 손목 시야에 목표가 보이면 2cm, 아니면 4cm를 사용하며 최근 행동 다섯 개를 유지합니다. Situated Planning과 Visual Prompt는 필요할 때만 켭니다. FT는 Qwen3.5-2B에 적은 수의 저차원 파라미터로 적응하는 Low-Rank Adaptation(LoRA)을 rank 64로 적용하고 vision encoder와 multimodal projector를 고정합니다. 갱신 파라미터는 약 3%입니다.
- Baselines: VLA인 $\pi_{0.5}$·GR00T, VLA 중심 에이전트 H-VLA·G-VLA, 프로그램/API 기반 CaP-X·RATS를 비교합니다. 학습 가능한 VLA와 FT는 같은 시연에서 변환한 연속 궤적 또는 의미 행동으로 학습합니다.
- Demonstration data collection: 실제 로봇은 164 episode, 시뮬레이션은 230 episode를 수집합니다. FT와 VLA는 두 실제 로봇의 시연을 함께 학습합니다. sim-to-real 비교에는 시뮬레이션 시연만 사용합니다. 5.1절
5.2 Main Results: Generalization across Task, Environment, and Embodiments
먼저 cross-task는 물체·목적지 조합, cross-environment는 배경·조명·시점·방해 물체·sim-to-real, cross-embodiment는 Franka와 AgileX를 평가합니다. FT의 로봇 간 평가는 두 로봇 시연을 공동 학습한 뒤 각 로봇에서 평가한 것이므로, 학습에 전혀 없던 로봇으로의 zero-shot 전이와 구분해야 합니다.
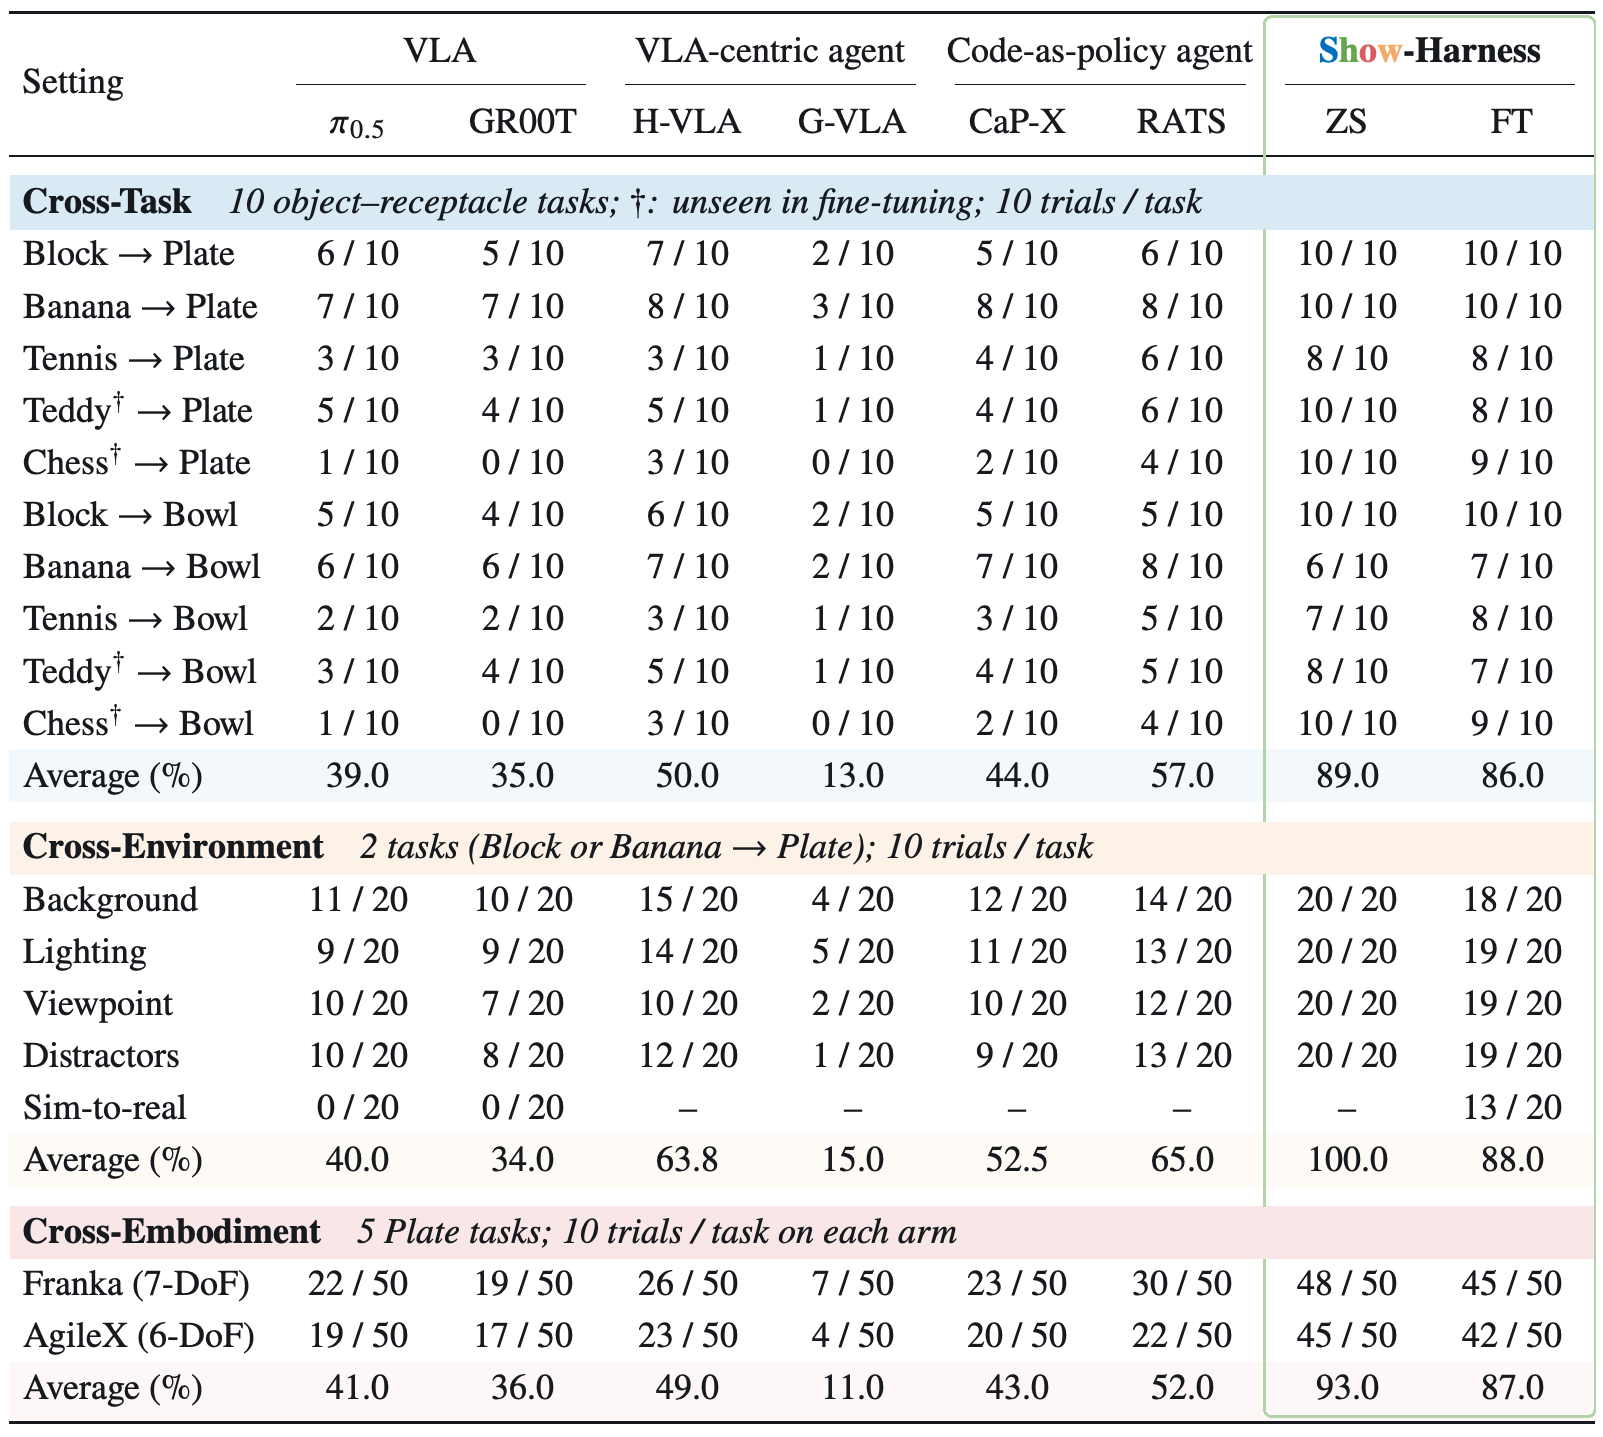
표 2. Yanzhe Chen 등의 실제 로봇 일반화 평가. arXiv 2609.10522v1, Table 2, PDF 11쪽에서 표 전체 영역을 크롭했습니다. 원본 영문 표기·수치·단위·주석을 보존했으며, 캡션과 해설은 한국어로 작성했습니다. ZS는 Gemini-3.1 Pro의 medium thinking effort, FT는 Qwen3.5-2B입니다. 이미지를 누르면 확대할 수 있습니다.
각 셀의 분수는 성공 횟수/시도 횟수이고 Average 행은 백분율입니다. †는 미세조정 시 보지 못한 물체를, 대시는 미보고 결과를 뜻합니다. 위에서부터 작업 조합, 환경 변화, 로봇 형태 변화의 평가이므로 서로 다른 묶음의 평균을 합치지 않고 읽어야 합니다.
HTML에서 표 2가 누락되어 동일 버전 PDF 11쪽의 표를 확인했습니다. 10개 작업 평균은 ZS 89%, FT 86%, $\pi_{0.5}$ 39%, GR00T 35%, H-VLA 50%, G-VLA 13%, CaP-X 44%, RATS 57%입니다. 다만 banana→bowl에서는 ZS가 6/10으로 RATS의 8/10보다 낮습니다. 평균 우세가 모든 개별 작업의 우세를 의미하지는 않습니다.
sim-to-real에서 FT는 13/20, $\pi_{0.5}$와 GR00T는 각각 0/20입니다. 나머지 방법은 해당 행에 결과가 없으므로 0점으로 취급하지 않습니다. 환경 평균 역시 방법별로 포함된 조건이 달라, ZS 100%와 FT 88%를 동일한 다섯 조건의 평균처럼 비교하면 안 됩니다. ZS는 앞의 네 조건에서 각각 20/20이고 sim-to-real은 미보고입니다. 로봇별 평가에서 ZS는 Franka 48/50·AgileX 45/50, FT는 45/50·42/50입니다. 5.2절, PDF 표 2, 11쪽
5.3 Capability Analysis: Physical and Semantic Adaptability
5.3.1 Physical Adaptability
원문은 다음 다섯 실험을 차례로 제시합니다.
- Fine-grained control: 블록 쌓기·peg insertion에서 보폭을 2cm에서 1cm로 줄이면 ZS는 60→82%, FT는 40→65%로 개선됩니다. 같은 시연으로 학습한 $\pi_{0.5}$는 18%, 추가 정밀 시연 학습 후 62%입니다. 의미 행동을 유지한 채 실행 해상도를 바꾼 실험입니다.
- Action composition: 직교 방향 두 단위를 대각선 변위로 결합해 단계 수를 줄이며, 저자는 뚜렷한 성공률 저하 없이 실행할 수 있다고 보고합니다.
- Rotation extrapolation: 15도씩 회전하는 단위를 사용합니다. 0도·45도 시연으로 학습한 FT는 보지 못한 90도 당근 방향에서 70%, $\pi_{0.5}$는 20%입니다. 작은 행동의 반복 조합으로 큰 회전 차이를 처리하는지 평가합니다.
- Workspace shift: 중심 25%부터 경계에 가까운 90% 영역까지 작업 공간을 확장합니다. 저자는 Show-Harness의 감소가 상대적으로 작다고 해석합니다.
- Multi-arm coordination: 테이블 정리와 바나나 전달을 각각 20회 평가합니다. 독립적인 두 단일 팔 정책보다 양팔 행동을 공동 결정하는 정책이 더 높은 성공률과 충돌 없는 결과를 보였다고 보고합니다. 5.3.1절과 그림 6
5.3.2 Semantic Adaptability
Reasoning-intensive tasks: 컵 아래 숨은 블록 찾기와 문자 “SHOW” 배열에서는 Situated Planning을 쓰는 ZS가 85%, FT 단독 10%, $\pi_{0.5}$ 단독 0%입니다. 동일한 Gemini 하위 지시를 주면 FT는 70%, $\pi_{0.5}$는 5%가 됩니다. 작은 제어 모델 자체의 계획 능력과, 외부 계획을 수행하는 능력을 구분해 보여 줍니다.
In-context learning from video: 세 물체를 시연 순서대로 정리하게 합니다. 순서가 명시되지 않은 “tidy up” 지시만으로 ZS는 20%이고, 사람 또는 로봇 영상 시연을 주면 각 출처에서 20/20을 달성합니다. 동일 planner가 추출한 작업 개요를 받는 FT는 95%입니다. 시연 없는 조건은 목표 순서 정보도 없으므로, 이 차이에는 정보 제공 효과가 함께 포함됩니다. 5.3.2절
5.4 Ablation Studies
5.4.1 Frontier VLM Choice and Thinking Effort
다섯 Plate 작업과 체스 말 배치에서 모델·추론 예산을 비교합니다. 강한 모델이 대체로 유리하지만 thinking effort 증가는 주로 불필요한 행동을 줄이고 성공률 개선은 작습니다. GPT-5.6-sol의 경우 wall-clock 비용이 3.4배가 되는 사례를 보고합니다. 유효한 행동 출력은 98% 이상이며 오류는 계획보다 세밀한 잡기·놓기에 집중됩니다. 목표 bounding box 제공이 도움이 된다는 결과는 출력 형식 준수와 정확한 시각적 위치 판단이 별개의 능력임을 보여 줍니다. 5.4.1절
5.4.2 Fine-Tuned Backbone Scaling
2B에서 이미 높은 성능을 보이며 큰 모델의 이득은 쌓기·삽입 같은 정밀 작업에서 두드러집니다. 1B급 모델은 목표 근처에서 잦은 미세 조정으로 episode가 길어집니다. 반면 움직이는 테니스공에서는 빠른 수정이 중요해 작은 모델이 큰 모델을 앞서는 사례가 있습니다. 저자는 2B를 정밀도와 반응성의 균형으로 해석합니다. 5.4.2절
5.4.3 Harness Plugins
기본 플러그인은 하나씩 제거하는 leave-one-out 방식으로 평가합니다. Visual Prompt와 Situated Planning은 별도 필요 시나리오에 추가합니다. 원문의 설명 순서는 다음과 같습니다.
- Multi-View Guidance: 작은 물체 정렬에 손목 시야가 유용합니다.
- Proprioception: 시각적으로 모호한 높이·접촉 판단에 내부 상태가 도움이 됩니다.
- Subtask Planning: 제거하면 성공률 60%이며, 들어 올리지 않고 물체를 끄는 행동이 나타납니다.
- Action Chunking: 사용하지 않아도 96% 성공하지만 호출이 늘어납니다. 항상 사용하면 74%로 내려갑니다.
- Adaptive Step: 작게만 움직이면 timeout, 크게만 움직이면 overshoot가 생깁니다. 적응적 방식은 96%, 평균 30단계를 보고합니다.
- Visual Prompt: 손잡이를 의식한 잡기에서 40→85%입니다. 표식 자체보다 지시와 접촉 위치의 연결이 핵심이라고 설명합니다.
- Situated Planning: 숨은 물체 탐색에서 35→85%입니다. 관측 전 결정을 유보하는 방식의 효과입니다.
- Action History: 제거 시 반대 방향 왕복과 timeout이 늘어납니다.
- Failure Recovery: 제거하면 72%입니다. 빈 잡기를 인식하지 못하고 다음 단계로 진행하는 실패를 저자가 설명합니다.
같은 작업의 플러그인 제거와 전용 작업의 추가 실험을 섞어 순위를 매기지는 않아야 합니다. 5.4.3절과 그림 9
5.4.4 Action-space Representation
이동 단위 여섯 개의 표기만 바꾸는 $2\times2$ 설계입니다. 의미 이름+동작 규칙, 의미 이름만, 임의 기호+규칙, 임의 기호만을 비교합니다. 규칙이 있으면 임의 기호도 기본 방식에 근접하지만, 기호만 주어 스스로 동작을 추론하게 하면 1/20 성공과 23.3%의 매핑 정확도를 보고합니다. 저자의 결론은 명시적 물리 규칙이 grounding의 대부분을 제공하고 의미 이름은 유용한 사전지식으로 작동한다는 것입니다. 5.4.4절
5.5 Qualitative Analysis
새 물체, 배경·조명 변화, 혼잡한 장면, 공간 추론, 양팔 제어를 그림 11로 보여 줍니다. 문자 재배열과 양팔 서랍 조작은 같은 행동 인터페이스가 다른 작업 구조에도 쓰이는 예입니다. 정성 사례는 동작 양상을 설명하는 자료이며 추가적인 성공률 표본으로 계산하지 않습니다. $\pi_{0.5}$와의 정성 비교는 부록 7.3으로 이어집니다. 5.5절
챕터의 핵심 기여: 인터페이스·관측·계획·물리 실행 해상도의 효과를 여러 비교로 분리합니다. 다음 챕터로의 연결: 결과의 요지와 저자가 명시한 적용 범위를 정리합니다.
📖 Chapter 6: Conclusion and Limitations
챕터의 위치와 역할: 의미 행동과 반복 피드백을 통한 제어, GUMI를 통한 시연 수집을 종합합니다.
저자는 적절한 인터페이스를 통해 기반 VLM의 embodied 능력을 활용할 수 있다는 결론을 내립니다. 이어 평행 그리퍼를 사용하는 단일·양팔 조작 중심의 평가라는 범위를 명시합니다. 저자가 제안한 향후 방향은 humanoid·dexterous hand와 같은 복잡한 로봇 형태로의 확장, 그리고 촉각·힘 피드백을 추가한 접촉 중심의 정밀 상호작용입니다. 본 리뷰는 이 두 방향 외에 새로운 한계나 연구 과제를 저자의 주장처럼 추가하지 않습니다.
챕터의 핵심 기여: 결과의 적용 범위와 저자 자신의 향후 방향을 명시합니다. 다음 내용으로의 연결: 참고문헌 뒤 부록에서 학습·데이터·프롬프트의 구체적 조건을 제공합니다. 6절
References: 참고문헌의 역할
참고문헌은 본문과 부록 사이에 있습니다. VLA·에이전트 구조·LoRA·시뮬레이터·모델의 출처를 연결합니다. 개별 참고문헌의 결과를 이 리뷰에서 독립 검증한 것으로 취급하지 않으며, 참고문헌 전체를 재요약하지 않습니다. References
📖 Chapter 7: Appendix
챕터의 위치와 역할: 재현 조건과 데이터 구성, 실제 모델 입력 형식을 보완합니다.
7.1 VLM Fine-Tuning Details
40 epoch, 학습률 $10^{-4}$, cosine schedule, warmup ratio 0.1, bf16, $256\times256$ 영상, 유효 batch size 32를 사용합니다. 24GB급 GPU에서 학습 가능하다고 설명하며, Qwen3.5-2B는 H200 한 장에서 2시간 미만이라고 보고합니다. 24GB급 GPU에서도 2시간 미만이라는 의미는 아닙니다. 이 절은 학습 표본을 7.9K로 표현하고, 표 3은 실제 로봇 행동 단계를 7,774로 제시하므로 두 표기를 임의로 동일 숫자로 고쳐 쓰지 않습니다. 7.1절
7.2 Demonstration Data
표 3은 Franka 101 episode·4,969단계, AgileX 63 episode·2,805단계, 합계 164 episode·7,774단계를 기록합니다. 시뮬레이션은 ManiSkill 100 episode·5,840단계와 RoboLab 130 episode·7,683단계로 합계 13,523단계입니다.
실제 로봇 시연은 Franka 9개, AgileX 10개 작업을 포함합니다. 매 단계의 외부·손목 영상, 행동, 측정된 end-effector 자세, 그리퍼 너비를 저장하고 episode마다 DONE terminal sample을 추가합니다. Franka의 19 episode·594단계는 빈 잡기 후 들어 올려 다시 접근하는 복구 구간을 별도로 담습니다.
다음으로 시뮬레이션 수집을 설명합니다. 두 시뮬레이터 모두 의미 이동 한 단위를 2cm로 맞추고 배포와 같은 영상 입력 형식으로 변환하지만, 렌더링·장면·로봇 외형의 차이는 유지합니다. ManiSkill은 블록과 coaster, RoboLab은 다양한 물체·목적지의 12개 작업입니다. 저자는 데이터 공개 위치도 제시합니다. 이 리뷰에서는 공개 여부를 실행·다운로드로 검증한 것으로 간주하지 않습니다. 7.2절과 표 3
7.3 Qualitative Comparison
동일 시연을 학습한 Qwen3.5-2B 기반 FT와 $\pi_{0.5}$를 체스 말·테니스공·곰인형에서 비교합니다. 저자는 후자의 잡기·물체 상호작용 실패를 표시합니다. 같은 데이터 기반이라는 통제와, 선별된 사례라는 자료의 성격을 함께 확인해야 합니다. 7.3절
7.4 Runtime Prompts
모든 로봇·backend별 변형 대신 역할별 대표 프롬프트를 제시합니다. 작업·측정·이력 등의 필드를 실행 직전에 채우며, 영상은 API의 별도 입력입니다. 회전 동작은 필요한 작업에서만 활성화합니다.
7.4.1 Frontier VLM Agent
원문은 다음 순서로 프롬프트 구성과 역할을 설명합니다.
- Controller prompt: 작업, 단계, 목표, affordance, 완료 조건, 그리퍼 상태를 전달합니다. 목표가 손목 시야에 있는지에 따라 주 시점을 바꾸며, 영상으로 완료가 확인되어야
DONE을 출력합니다. - Atomic action output contract: 행동 하나와 짧은 시각적 이유를 JSON으로 출력하는 기본 경로를 제시합니다. 추론형 backend는 동일 행동 집합을 사용하되 응답에서 최종 단위를 복원합니다.
- Default plugin injections: 높이·보폭·접촉 징후, 손목 시야 확인, 먼 목표의 행동 계획, 최근 이동, 반대 방향 왕복 방지, 빈 잡기·잡기 손실·불안정한 그리퍼 상태의 복구 문맥을 삽입합니다.
- Subtask Planning prompt: 잡기·들기·이동·배치·놓기·후퇴를 시각적 단계로 나눕니다. 접근·정렬·내림·닫기는 하나의 잡기 단계로 묶고, 들어 올리기는 분리하며, 놓기 뒤 후퇴를 추가합니다. Affordance는 눈에 보이는 특정 부분 하나로 정하고 완료 조건도 영상으로 판단 가능하게 만듭니다.
- 양팔 및 선택적 역할: 양팔은 같은 구조를 팔별로 구성하고 공동 행동을 예측하며, 쉬는 팔에는
STILL을 추가합니다. Situated Planning·Visual Prompt의 전체 구현은 코드 저장소를 참조하도록 되어 있습니다. - Video-conditioned in-context planning: 시간순 영상 프레임을 분석하는 별도 역할이 물체·잡는 부분·목적지를 작업 개요로 변환합니다. planner는 이를 입력받아 시연 순서를 실행 계획으로 재사용합니다.
7.4.2 Fine-Tuned Lightweight VLM Agent
FT는 기본적으로 별도 planner 없이 제어기로 동작합니다. 작업, 두 시점 관측, 최근 행동, 공유 행동 어휘를 받아 설명 없이 행동 token 하나를 출력합니다. 원문은 전체 시점에서 목표를 찾고 손목 시점에서 미세 정렬하며, 물체가 목적지에 있고 그리퍼가 벗어났을 때 완료하도록 안내합니다. 즉, FT와 ZS의 동일 행동 공간이 동일한 추론 절차를 뜻하지는 않습니다. 7.4절
챕터의 핵심 기여: 학습 설정뿐 아니라 모델이 실제로 받는 의미 규칙과 상태 정보를 공개합니다. 마지막 챕터이므로 후속 챕터는 없습니다. 프롬프트 전문·참고문헌 개별 항목·모든 그림의 개별 좌표값은 복제하지 않았으며, 본문과 부록의 모든 번호 섹션 및 주요 소주제는 위 순서대로 반영했습니다.
5. 실험 결과의 심층 해석과 재현성
표 2의 같은 10개 작업을 기준으로 보면, FT 86%와 $\pi_{0.5}$ 39%의 차이는 47퍼센트포인트, ZS 89%와 비교군 중 가장 높은 RATS 57%의 차이는 32퍼센트포인트입니다. 이는 표의 보고값에서 계산한 절대 차이입니다. FT와 VLA에 같은 시연을 사용한 설계는 데이터 수집량 차이의 영향을 줄이지만, 서로 다른 모델과 학습 표현을 모두 동일하게 만든 실험은 아닙니다. PDF 표 2
성공률 외에 단계·모델 호출·실제 시간도 함께 읽어야 합니다. Chunking 제거 시 성공률을 유지하면서 호출이 늘고, 강제 chunking은 성공률이 낮아집니다. 높은 thinking effort가 단계 수를 줄여도 실제 시간이 늘 수 있습니다. 따라서 더 적은 행동 수만으로 더 빠른 시스템이라고 결론내릴 수 없습니다. 5.4.1절, 5.4.3절
통계적 유의성 검정과 신뢰구간은 논문에 보고되지 않았습니다. 기본 작업당 10회이므로 개별 작업의 성공 한 번 차이는 10퍼센트포인트입니다. 이 관찰은 표본의 해석을 위한 설명이며 별도의 유의성 검정 결과가 아닙니다. 한편 손목 영상·내부 상태·복구 제거 실험과 행동 표현의 $2\times2$ 비교는 어떤 구성요소가 결과에 기여하는지 살펴보는 근거가 됩니다.
재현성 측면에서는 하드웨어, 시연 규모, LoRA 설정, 학습률·epoch, 행동 규칙과 대표 프롬프트가 제시되어 있습니다. 다만 논문 자체가 모든 로봇별 프롬프트와 선택적 역할의 구현을 열거하지 않고 코드로 연결하므로, 논문 텍스트만으로 모든 실행 세부사항을 확정할 수는 없습니다. 이는 공개 자료의 제공 범위를 평가한 것이며 구현 부재를 주장하는 것은 아닙니다. 이 리뷰에서는 저자 코드를 실행하거나 로봇 실험을 재현하지 않았습니다. 부록 7.1, 부록 7.4
6. 기술적 함의와 응용
리뷰어의 해석으로는, Show-Harness는 모델이 이해하는 행동과 로봇이 실행하는 단위를 어떻게 연결하느냐가 성능의 중요한 변수임을 보여 줍니다. 특히 임의 기호라도 물리 규칙이 주어지면 잘 작동한 실험은, 자연어처럼 보이는 이름 자체보다 동작 효과를 일관되게 정의하는 일이 중요하다는 근거입니다. 5.4.4절
적용 시에는 로봇별 해석기, 좌표 보정, 보폭과 작업 공간 제한, 카메라 구성, 모델 호출 비용을 함께 검토해야 합니다. 이는 논문에 제시된 시스템 구성과 실험 결과에서 도출한 적용상의 해석입니다. GUMI는 동일 의미 행동을 사람·에이전트·정책 학습이 공유한다는 점에서 시연 수집과 모델 비교의 연결을 제공합니다. 3.2절, 4절
저자가 명시한 확장 방향은 복잡한 로봇 형태와 촉각·힘 피드백입니다. 현재 결과의 중심은 평행 그리퍼 기반 단일·양팔 조작입니다. 이 범위 안에서 논문은 의미적 행동 공간, 세밀한 피드백, 물리 해석기를 결합해 기반 VLM의 능력을 실제 조작에 연결하는 구체적 설계와 실험 근거를 제시합니다. 6절