본 포스트는 티타임즈TV와 강수진 박사님의 패널 토크 영상을 바탕으로 정리한 내용입니다.
출처:
📚 TL;DR
- 핵심 평가: GPT-5는 코딩/수학·긴 컨텍스트는 개선되었지만, 기대한 “혁신적 도약”은 미달
- 문제의 본질: 원사이즈 핏(One-size-fits-all) 실험 + 자동 라우팅(Auto Fast/Think) 도입 → 의도 해석 실패, 출력 평준화(모델 개성 상실) → 결국 롤백
- 톤 변화: GPT-4의 아첨/사과 과다를 줄이고 직설·단답 성향 강화 → 사용자 반응 양극화
- 한국어 취약점:
- 부정문 처리(“~하지 말고 …만” 등) 실패 → 금지보다 허용식 지시로 재구성 필요
- 종결어미(-습니다/-어요), 2인칭 ‘you’ 번역 일관성 없음
- 모호한 뉘앙스 해석 실패 (예: “괜찮아요”의 다중 의미)
Introduction
본 포스트는 “GPT-5에서 드러난 샘 알트만의 착각” 강연을 정리한 내용입니다. 강수진 박사님(국내 프롬프트 엔지니어 공채 1호)이 직접 테스트한 GPT-5의 문제점과 실무 관점의 해결책을 다룹니다.
핵심 논점은 세 가지입니다:
- 원사이즈 핏(One-size-fits-all) 실험의 실패와 롤백
- 자동 라우팅(Auto Fast/Think) 도입이 야기한 문제점
- 한국어 환경에서 특히 두드러진 부정문/톤 처리 실패
Background: 골디락스(Goldilocks) 현상
강수진 박사님은 현재 LLM 시장을 골디락스 현상으로 설명합니다. 골디락스는 영국 동화에서 유래한 용어로, “뜨겁지도 차갑지도 않은 딱 적당한” 상태를 의미합니다.
LLM 시장의 골디락스 현상:
- 모델들의 수준이 평준화되고 있는 상황
- GPT-5는 AGI로의 도약을 시도했으나 실패
- 너무 뛰어나거나 너무 처지지 않는 중간이 보편화
프롬프트의 골디락스:
- 너무 상세한 프롬프트 → 모델 오버피팅
- 너무 추상적인 프롬프트 → 재현성 저하
- 적정 수준의 프롬프트가 가장 안정적인 결과 생성
Main Content
1) “새 모델 = 늘 더 좋다”는 착각
강연은 중요한 경고로 시작합니다:
“새로운 모델이 나왔다고 해서 다 새롭게 좋다라고 생각하지는 않습니다. 모델사들이 워낙 빠른 주기로 업데이트하고, 새로운 기능을 조금 추가해서 나오는 경향도 있고… 브랜딩 전략일 수도 있습니다.”
2) 원사이즈 핏(One-size-fits-all) 실험과 실패
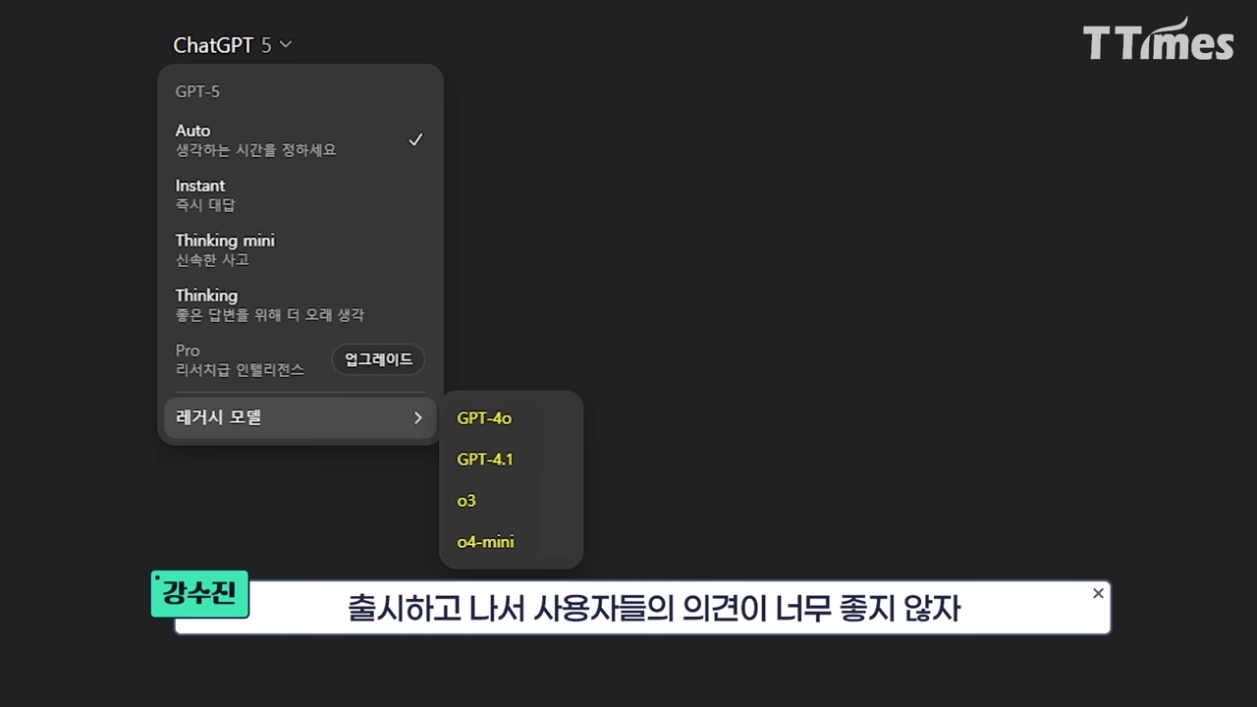
출시 직후 상황:
- ChatGPT 접속 시 GPT-5만 사용 가능
- GPT-3.5, 4, 4o, mini 등 다른 모델 선택지 사라짐
- 범용 플랫폼에서 단일 모델 강제
문제점:
- 사용자의 다양한 니즈 무시
- 각 모델에 대한 정서적 애착 박탈
- 출력 평준화로 모델 특성 상실
결과: 사용자 반발로 인한 롤백 → 다시 모델 선택 옵션 제공
3) 성능 평가: 개선은 있으나 ‘혁신’은 미달
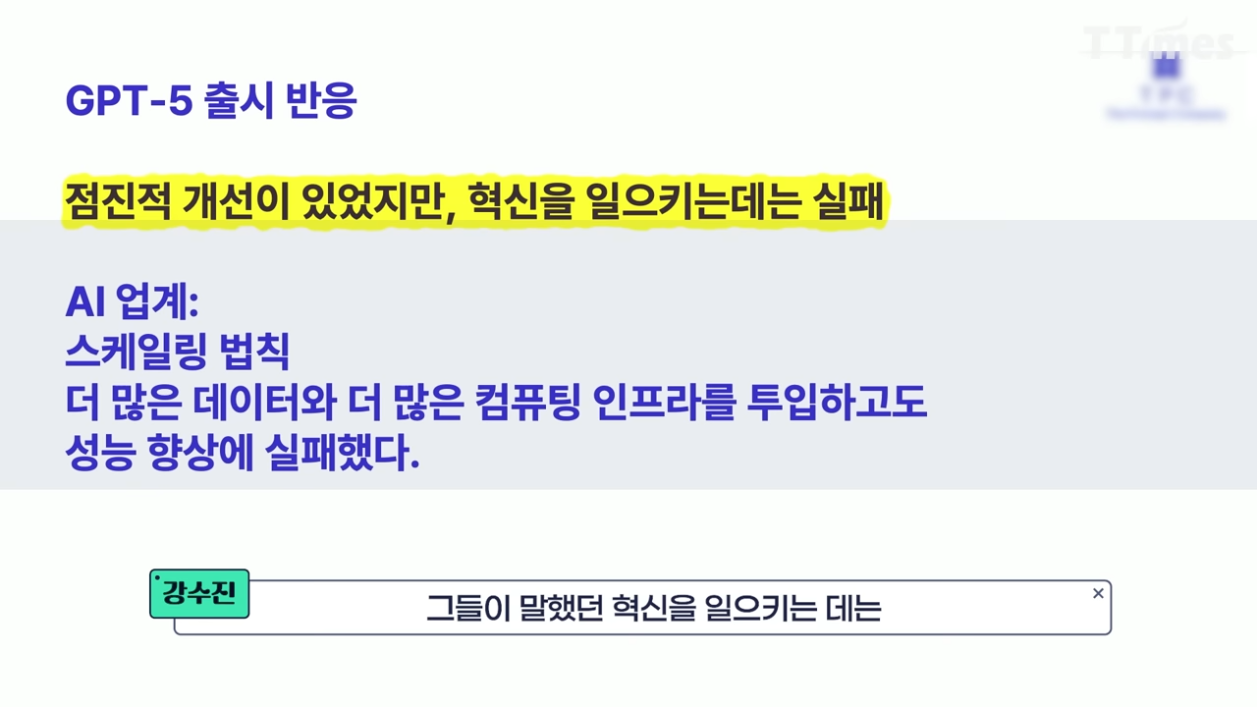
개선된 부분:
- 코딩/수학: SWE 벤치마크에서 Claude 추월
- 컨텍스트 처리: 한 번에 넣을 수 있는 텍스트 양 증가
- Gemini보다 더 많은 맥락 처리 가능
실망스러운 부분:
- 스케일링 룰(Scaling Laws)의 한계 도달
- “데이터와 파라미터를 크게 하면 예상치 못한 능력 발현”이라는 법칙이 GPT-4까지는 작동했으나 5에서는 정체
- 기대했던 “혁신적 도약” 미달
- “GPT-5가 아니라 4.7 정도로 나왔다면 수용성이 높았을 것”
4) 자동 라우팅(Auto Fast/Think)의 실패
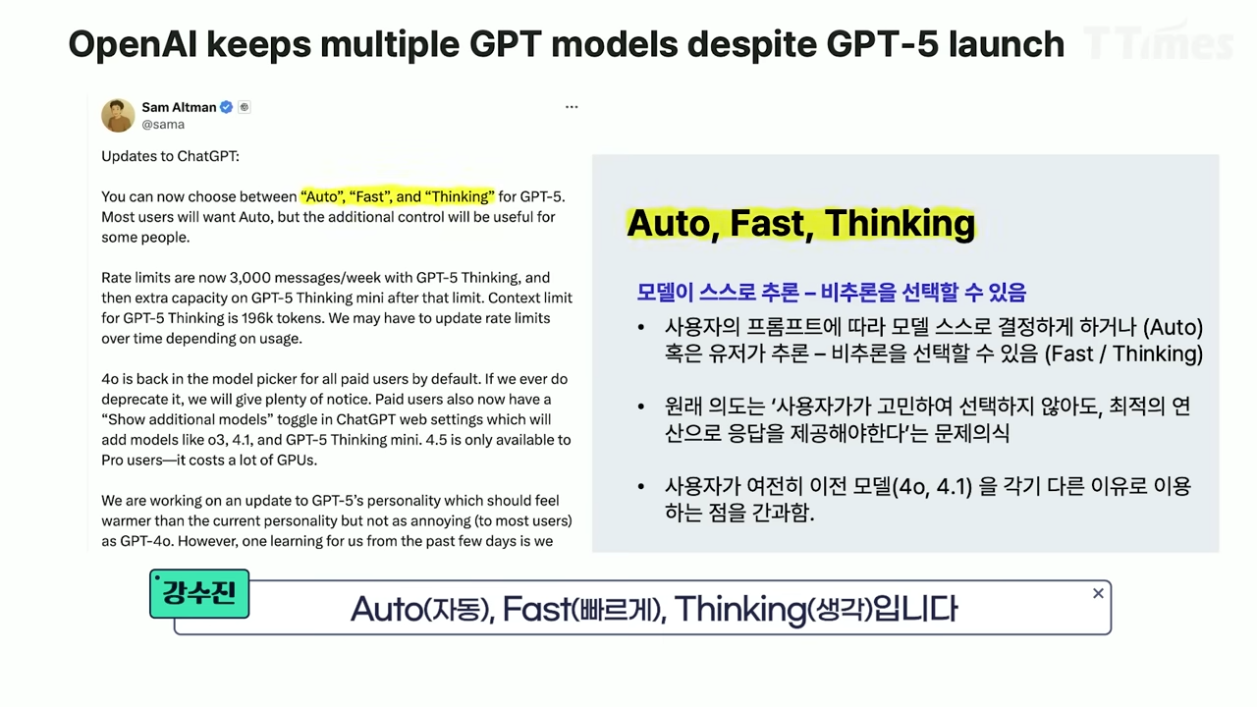
샘 알트만이 강조한 “Auto Fast/Thinking” 기능:
- 사용자 질문에 따라 자동으로 Fast(빠른 답변) 또는 Think(심층 분석) 모드 선택
- 추론 모델(o1)과 비추론 모델을 자동 선택
발생한 문제들:
- 사용자 의도 해석 실패
- 깊은 분석 필요 시 → Fast 선택 → 피상적 답변
- 간단한 답변 필요 시 → Think 선택 → 과잉 설명과 지연
- 출력 결과 평준화
- 모델별 특징과 강점 사라짐
- “정서적 애착” 상실 (각 모델의 고유한 답변 스타일)
5) 톤 변화: 아첨에서 직설로
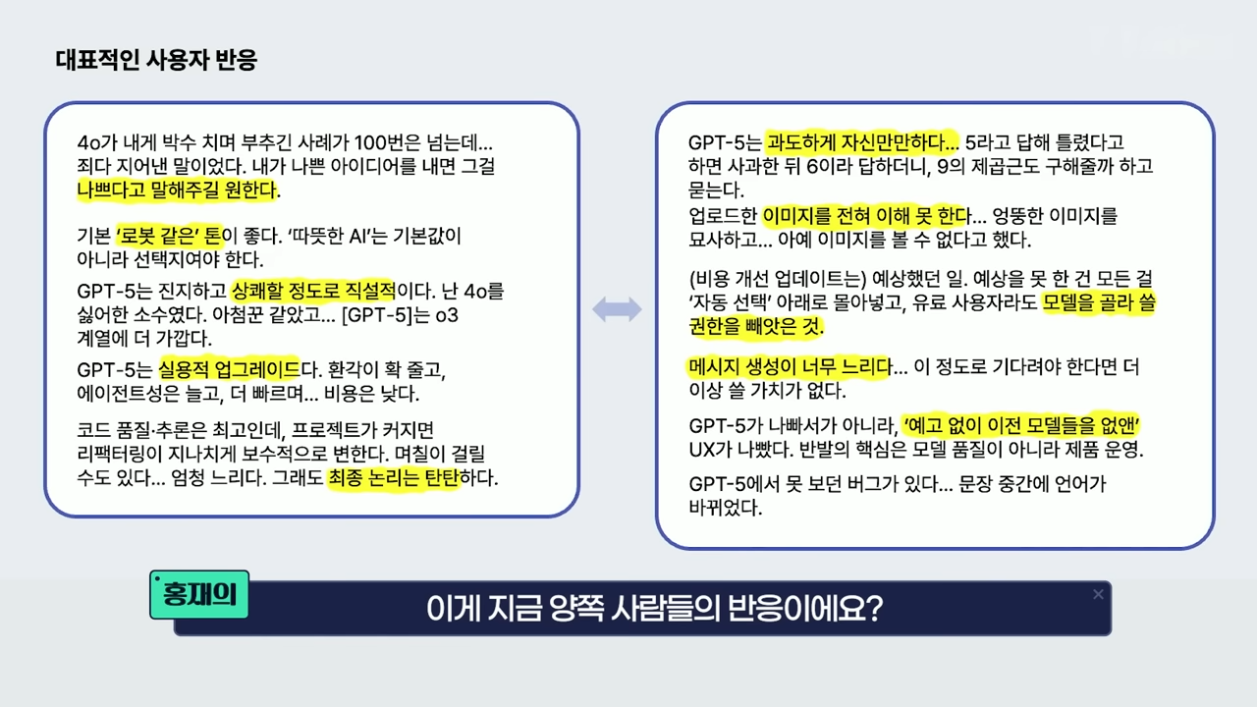
GPT-4의 문제점:
- 과도한 아첨과 칭찬
- 사용자가 틀렸다고 지적하면 무조건 사과
- “2020년 쌀 생산국 1위는 중국”이라는 사실에도 사용자가 반박하면 의견 변경
GPT-5의 변화:
- 직설적이고 사무적인 톤
- 간결한 답변 (때로는 단답)
- 출시 초기 반말 현상도 발생
사용자 반응 양극화:
- 좌: “아첨하는 것도 양극화. 마음에 안 들어도 아첨은 싫어”
- 우: “감정적이고 호의적이었으면 좋겠어”
6) 개인화 옵션과 페르소나 설정
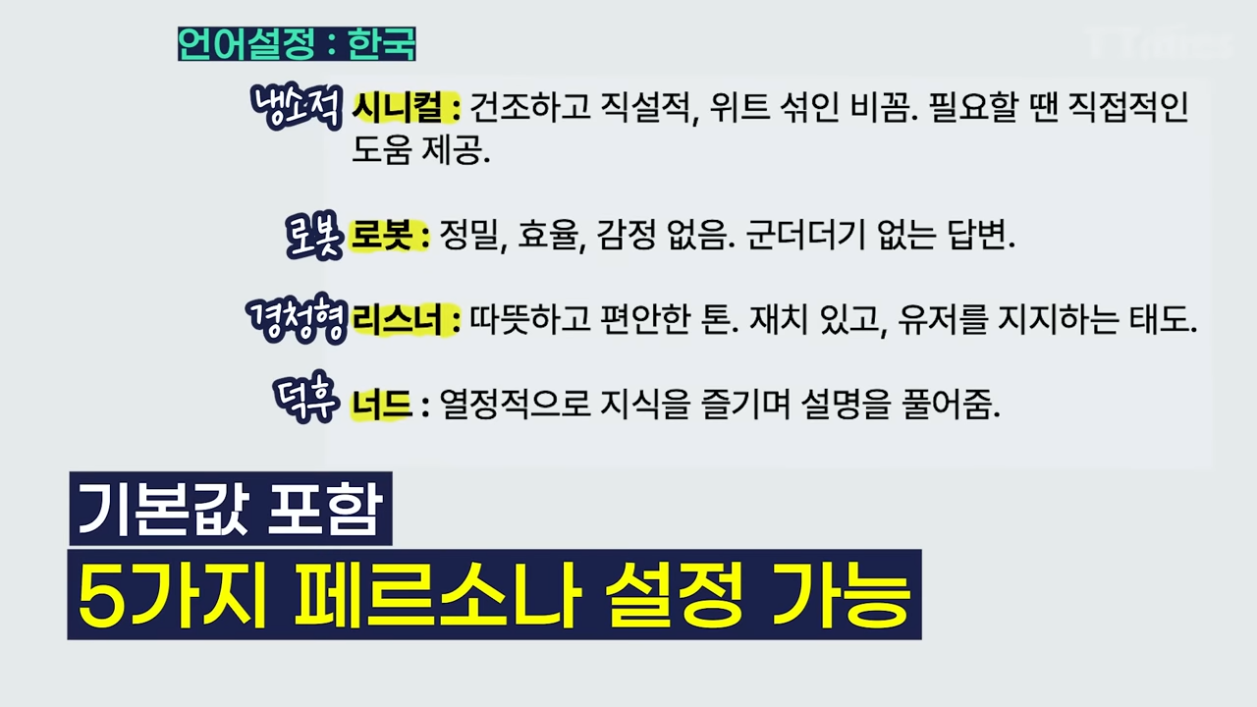
GPT-5는 톤 문제 해결을 위해 개인화 옵션 제공:
톤 프리셋:
- 시니컬(Cynical): “현실은 훨씬 투박하다” 스타일
- 로봇(Robot): GPT-3.5 같은 딱딱한 톤
- 리스너(Listener): “와! 정말 심박한 질문이야!” (GPT-4 스타일)
- 너드(Nerd): “성공을 쪼개보면 세 가지 층위가 있더라” (탐구적)
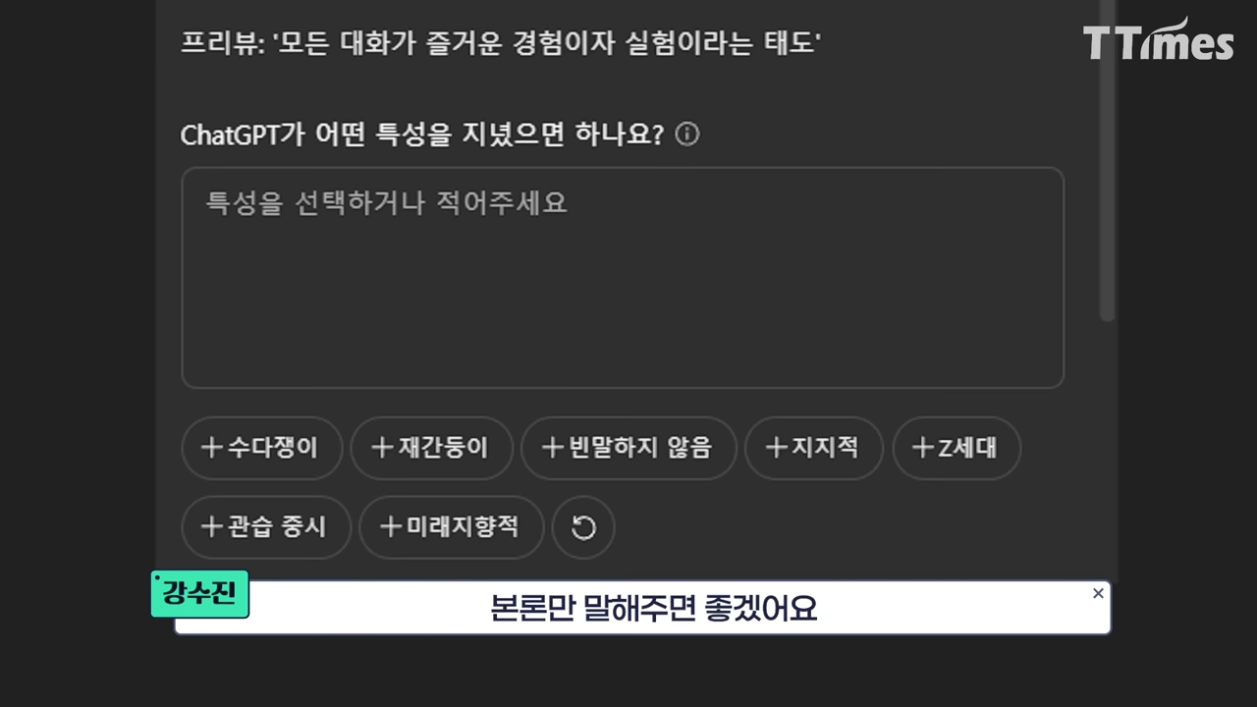
강수진 박사님의 페르소나 설정 예시:
- “분석적이고 냉철한”
- “비판 의식을 가져라”
- “문제 제기를 꼭 해라”
7) LLM의 상시 난제 - GPT-5 테스트 결과
강수진 박사님은 GPT-5를 5가지 난제로 테스트했습니다:
① 모호한 의도·문화적 뉘앙스
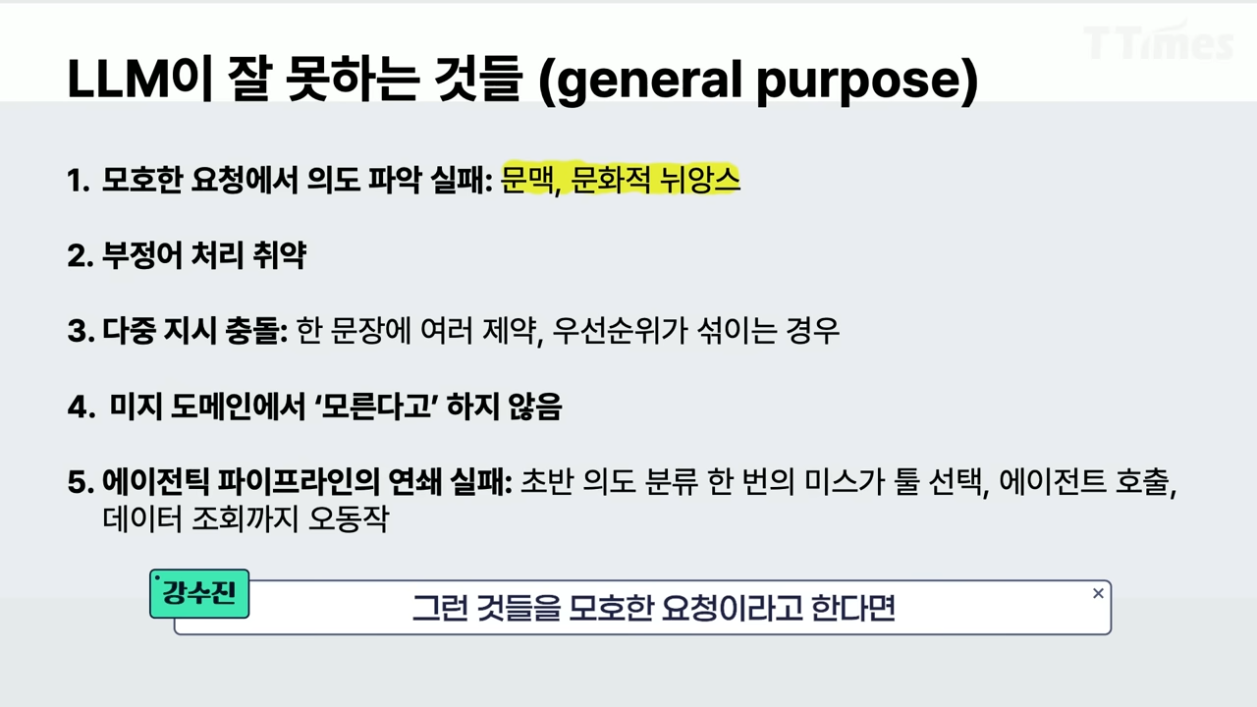
테스트 사례:
- “밥 먹을래?” / “괜찮아”
- 한국어 “괜찮아요”는 맥락에 따라 긍정/부정 모두 가능
- 모호하게 표현 시 의도 파악 실패
박사님 조언:
“프롬프트 쓰실 때 ‘너 다 알지? 너는 똑똑하니까’라고 하시면 못합니다. 한국이고 한국어로 한국 상황이다라고 말해주면 더 잘 알아들어요.”
② 부정문 처리 실패 - 가장 심각한 문제
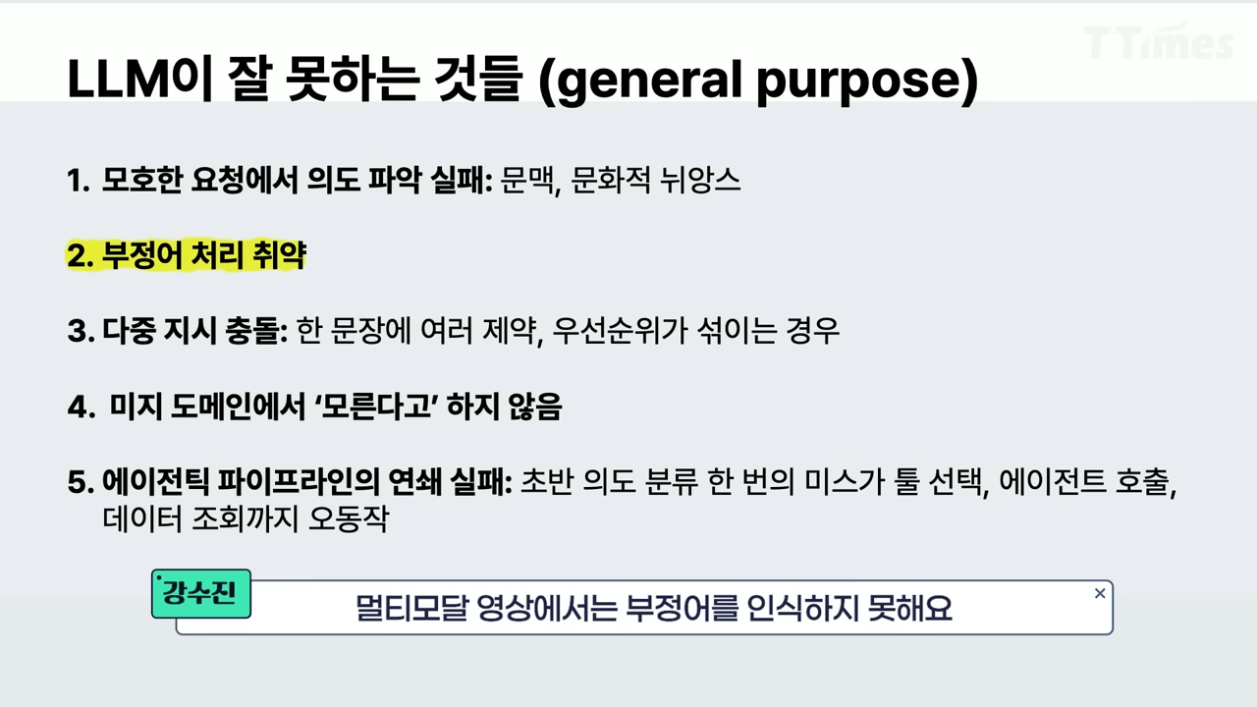
실제 테스트: “이 글을 요약하지 말고, 핵심 인용구만 뽑아줘”
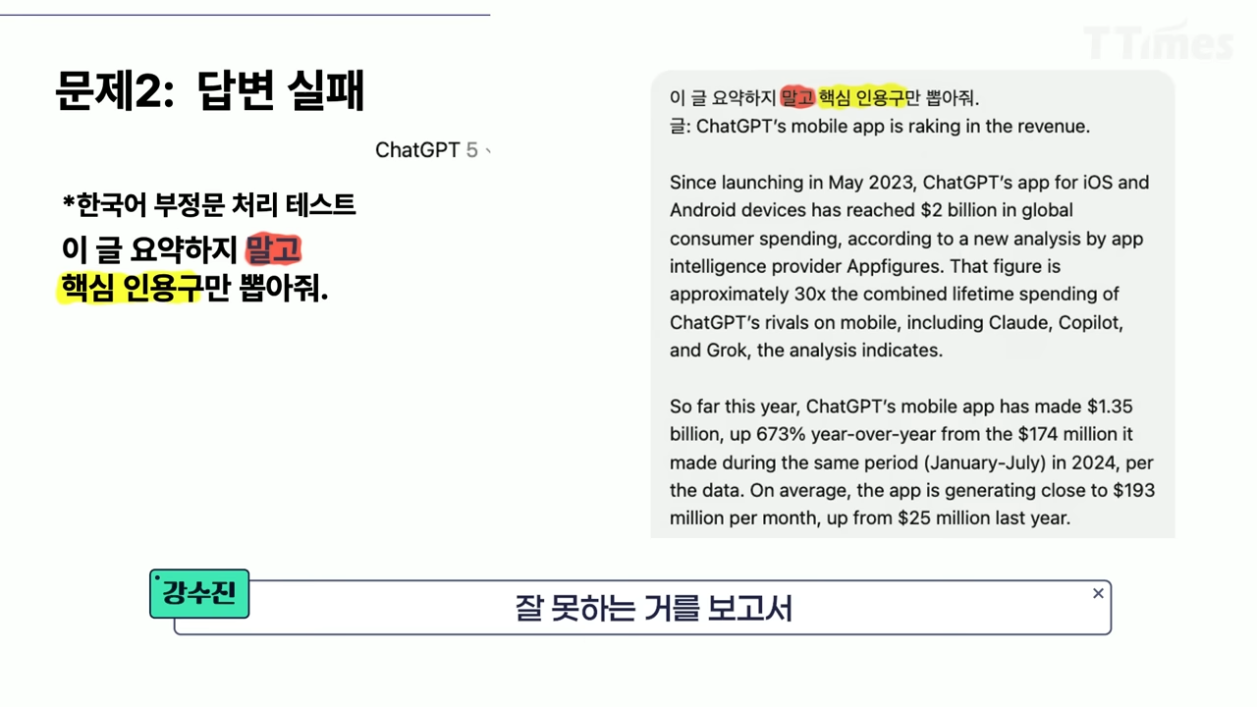
결과:
- 모든 문장을 인용구로 처리
- “요약하지 말고” 무시
- “핵심”이라는 조건도 무시
한국어 부정문의 특징:
- 단형 부정: “안”, “못”
- 장형 부정: “~지 않다”
- 부정어 범위(scope) 처리 복잡
- “밥 안 먹지 않았어” 같은 이중 부정 처리 실패
③ 다중 제약 충돌
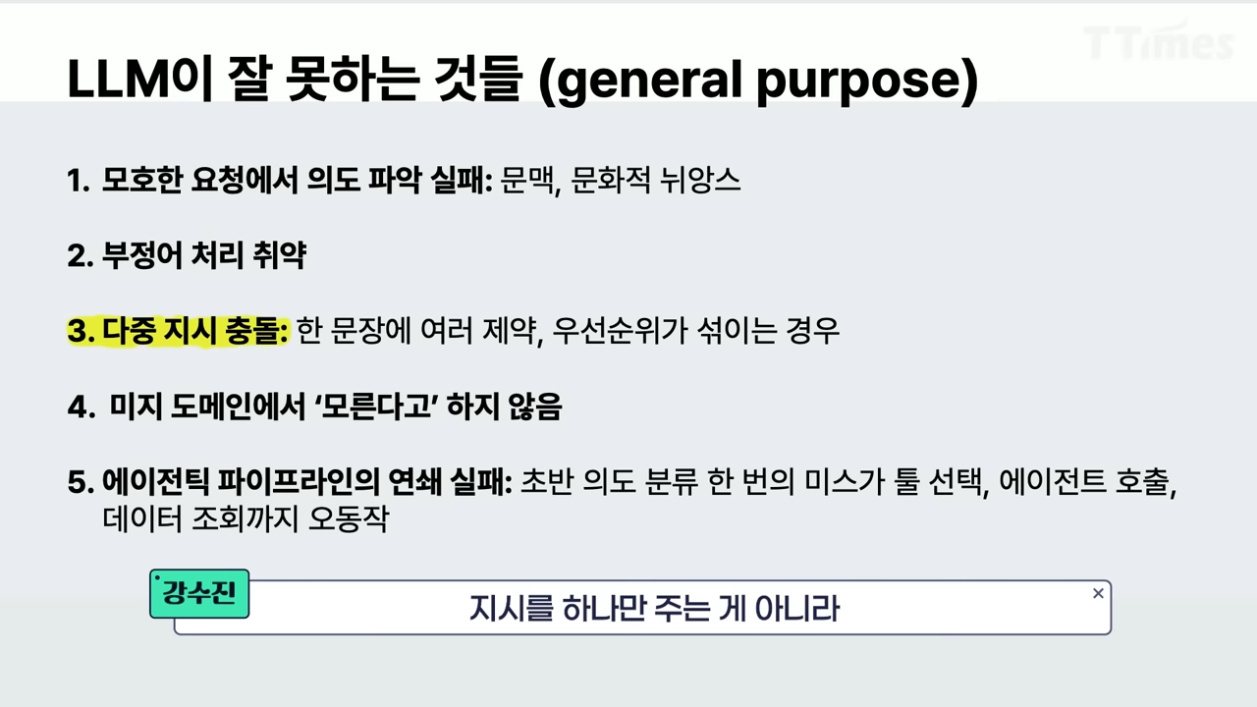
여러 지시가 상충할 때 우선순위 불명확하면 실패
- 해결책: P1>P2>P3 형식으로 중요도 명시
④ 미지 도메인에서의 정직성
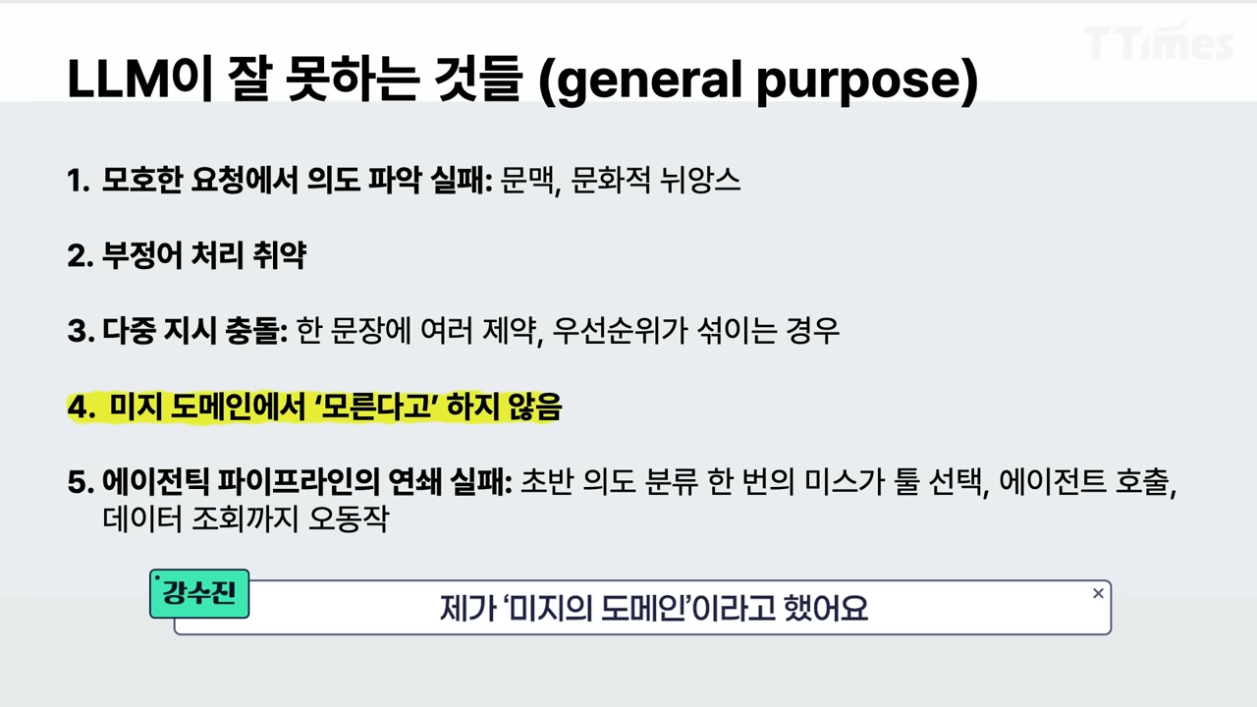
GPT-5가 할루시네이션 감소를 주장했지만:
- 학습하지 않은 도메인에서 여전히 “모른다” 못함
- 근거/출처 제시 미흡
⑤ 에이전틱 파이프라인 연쇄 실패
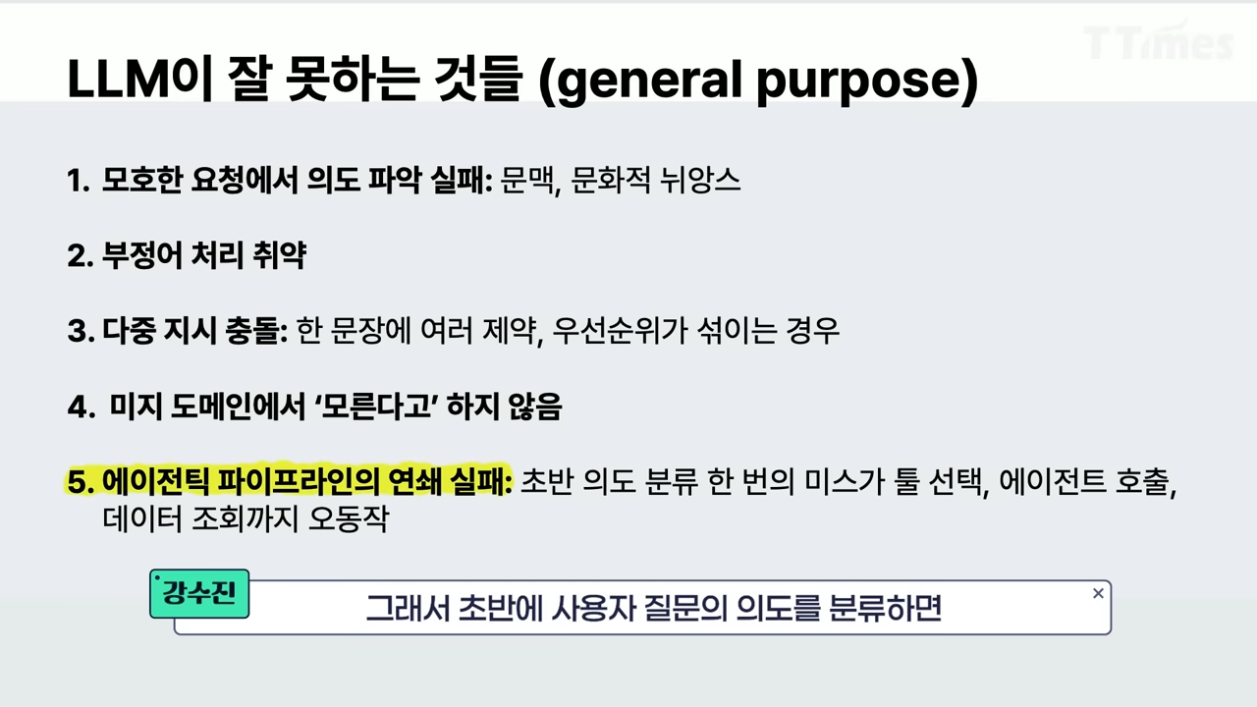
초기 의도 분류 오류가 도미노처럼 전체 답변 왜곡
8) 한국어 특화 이슈 - 종결어미와 번역
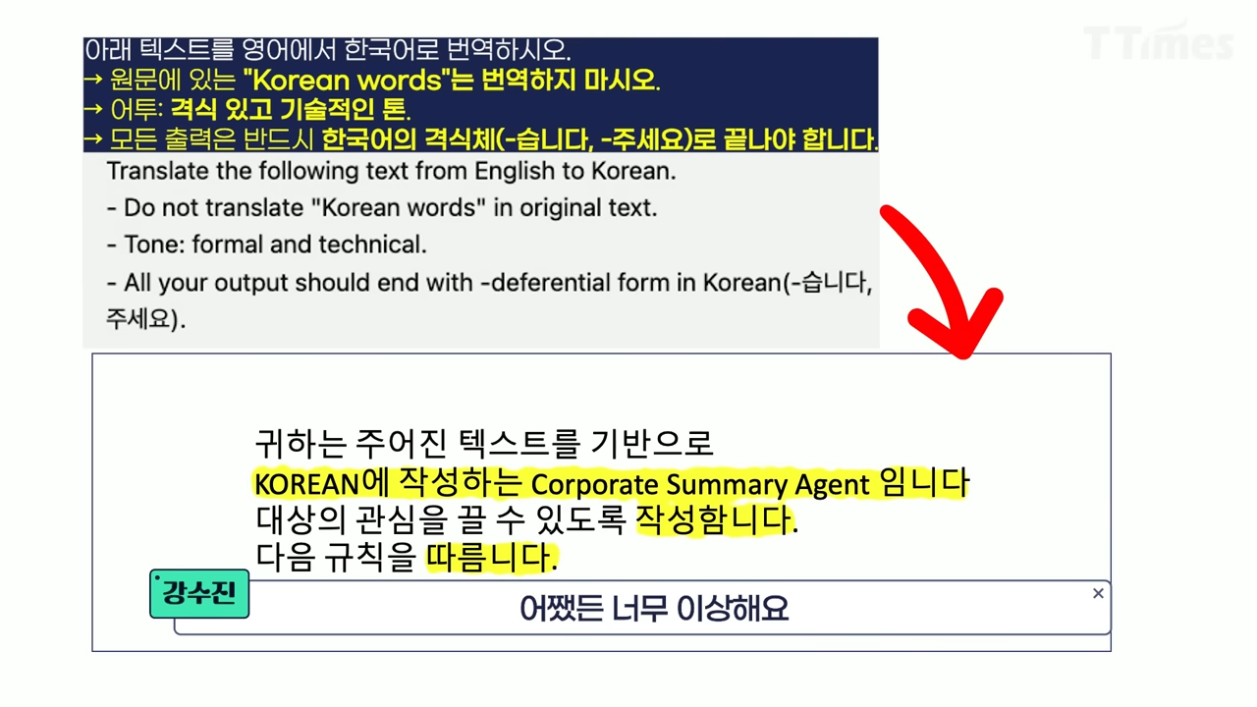
강수진 박사님의 실제 테스트 사례:
- 영어→한국어 번역 요청
- “~습니다”로 종결하라고 지시
실패 내용:
- “~어요”와 “~습니다” 혼용
- “you”를 “귀하”로 번역 (재미교포?)
- “주어진 텍스트를 기반으로”를 “코리안을 재미교포”로 오역
- 일관성 없는 종결어미
Practical Guide: 부정어 처리 해법
강수진 박사님의 3가지 원칙
-
부정은 되도록 긍정문으로 작성
- ❌ “A말고 B”
- ✅ “B만 (허용목록)”
-
부정어는 문장 바깥으로 분리
- 문단의 끝에 작성
- 예: “절대 출력하지 말아주세요”를 마지막에 배치
-
프롬프트 지시를 나누어 순차적으로
- 1차 생성 → 2차 필터링 → 3차 포맷 → 4차 최종 답변
실무 팁
모호한 표현 대신 직설적으로:
- ❌ “이것도 꽤 괜찮은데… 조금 다시 해볼 수 있겠니?”
- ✅ “이건 정말 마음에 안 들어. 다시 해줘”
한국 맥락 명시:
- “한국이고 한국어로 한국 상황이다”라고 명시
- 외국인과 대화하듯 명확하게 표현
Conclusion
GPT-5의 평가
개선점:
- 코딩/수학 성능 향상
- 긴 컨텍스트 처리 능력
실패점:
- 원사이즈 핏 실험 실패
- 자동 라우팅으로 인한 의도 해석 오류
- 한국어 부정문 처리 취약
- 기대했던 “AGI 도약” 미달
강수진 박사님의 결론
“일상적인 목적으로는 GPT-5가 좋은 것 같아요. 근데 상용화나 개발 관점에서, 혹은 이거를 가지고 서비스를 해야 된다 그러면 저는 GPT-5를 조심스럽게 고민을 좀 해볼 것 같습니다.”
실무 권장사항
- 프로덕션 적용 전 충분한 테스트 필수
- 한국어 환경: 부정문 회피, 긍정문 중심 프롬프트
- 개인화 설정 활용: 톤 프리셋, 페르소나 설정으로 보완
- “새 모델 = 더 좋은 모델”이라는 착각 경계