OpenAI가 o3와 o4-mini 모델을 공개하며, 이제 AI는 단순한 생성기에서 벗어나 복잡한 문제를 능동적으로 해결하는 합리적 추론 시스템으로 발전하고 있습니다.
기본 GPT 시리즈와 달리, o-시리즈는 문제 해결에 있어 ‘도구를 활용한 깊이 있는 사고’를 기본 전제로 하며, 반복적인 툴 호출을 통해 진화형 추론을 수행하는 것이 특징입니다.
이 글에서는 발표된 LIVESTREAM 흐름을 중심으로 기술적 배경, 데모, 성능 지표 및 활용 사례, 전망을 종합 정리합니다.
1. 왜 o-시리즈인가?
OpenAI는 단순한 언어 생성 이상의 기능을 수행할 수 있는 새로운 AI 모델군인 o-시리즈를 통해, 진정한 의미에서의 에이전트 기반 추론 시스템을 제안하고 있습니다.
- GPT 시리즈를 넘어서: 기존 GPT 모델들이 주로 자연어 생성에 초점을 맞췄다면, o 시리즈는 능동적으로 문제를 구조화하고, 필요 시 외부 도구를 불러와 복합적인 작업을 수행합니다.
- 인간처럼 ‘생각하고 도구를 쓰는’ 방식으로 설계되어 있으며, 실제로 o3는 하나의 문제 해결을 위해 600번 이상의 툴 호출을 실행한 사례가 존재합니다.
📌 핵심 메시지: o3/o4-mini는 단순 LLM이 아니라, 도구 기반 추론을 자동화하는 AI 시스템, 즉 ‘AI 작업자’의 첫 사례라 볼 수 있습니다.
2. 기술 철학과 모델 아키텍처
🧠 인간처럼 ‘단계적으로 사고하고 행동하는’ 구조
- 멀티모달 통합 추론: 텍스트, 코드, 이미지, 외부 도구를 결합하여 사고 체계를 구성합니다.
-
툴 기반 연쇄 추론(Chain-of-Tool Use): 문제를 단계적으로 나누고, 도구를 호출하여 각 단계를 해결하는 방식은 인간의 분석적 문제 해결 방식과 유사합니다.
- 예시: 논문 포스터 이미지 → 이미지 분석 → 그래프 값 추출 → 관련 논문 검색 → 결과 비교 → 요약 리포트 생성까지 전 과정 자동화 가능.
- LangGraph 기반의 Agentic Architecture와 유사: 상태 기반 흐름과 반복적 툴 호출을 통해 점진적으로 목표를 향해 나아감.
3. 성능 지표 및 벤치마크 성과
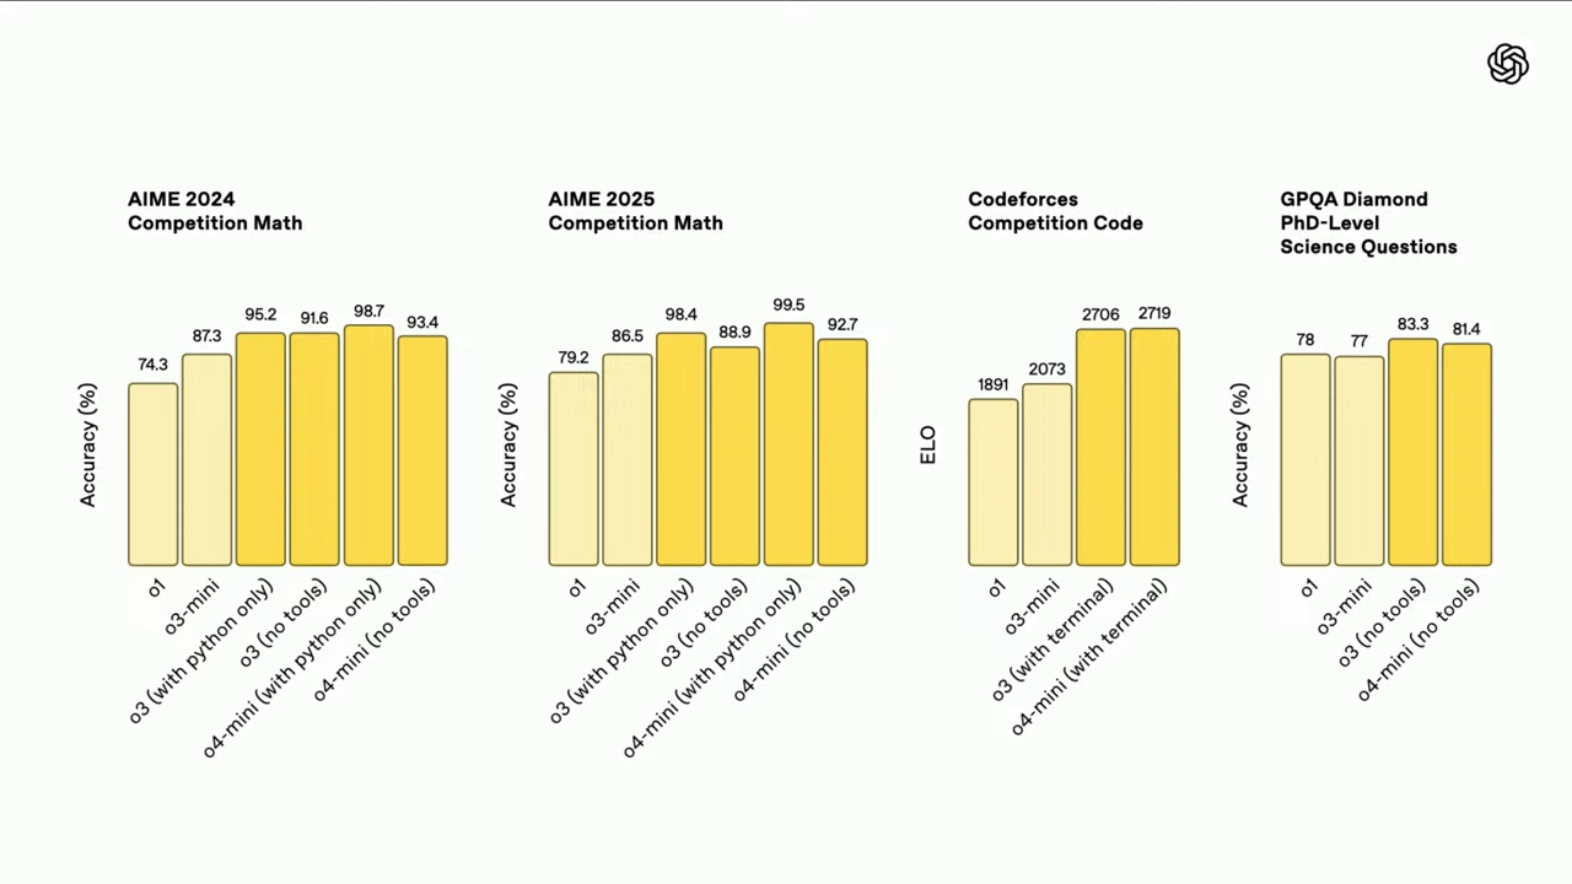
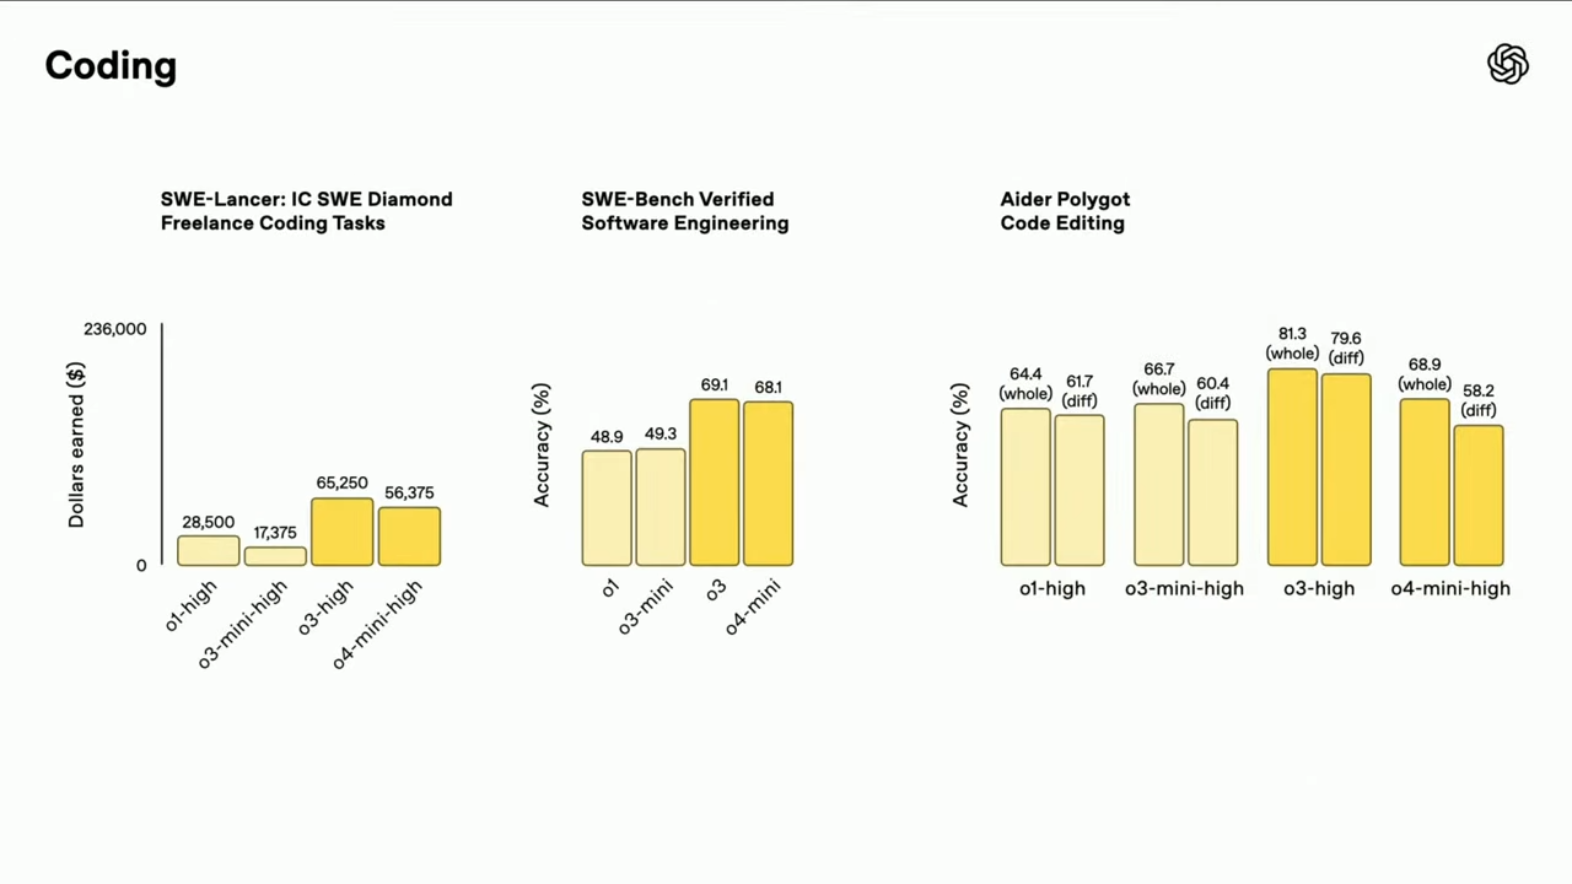
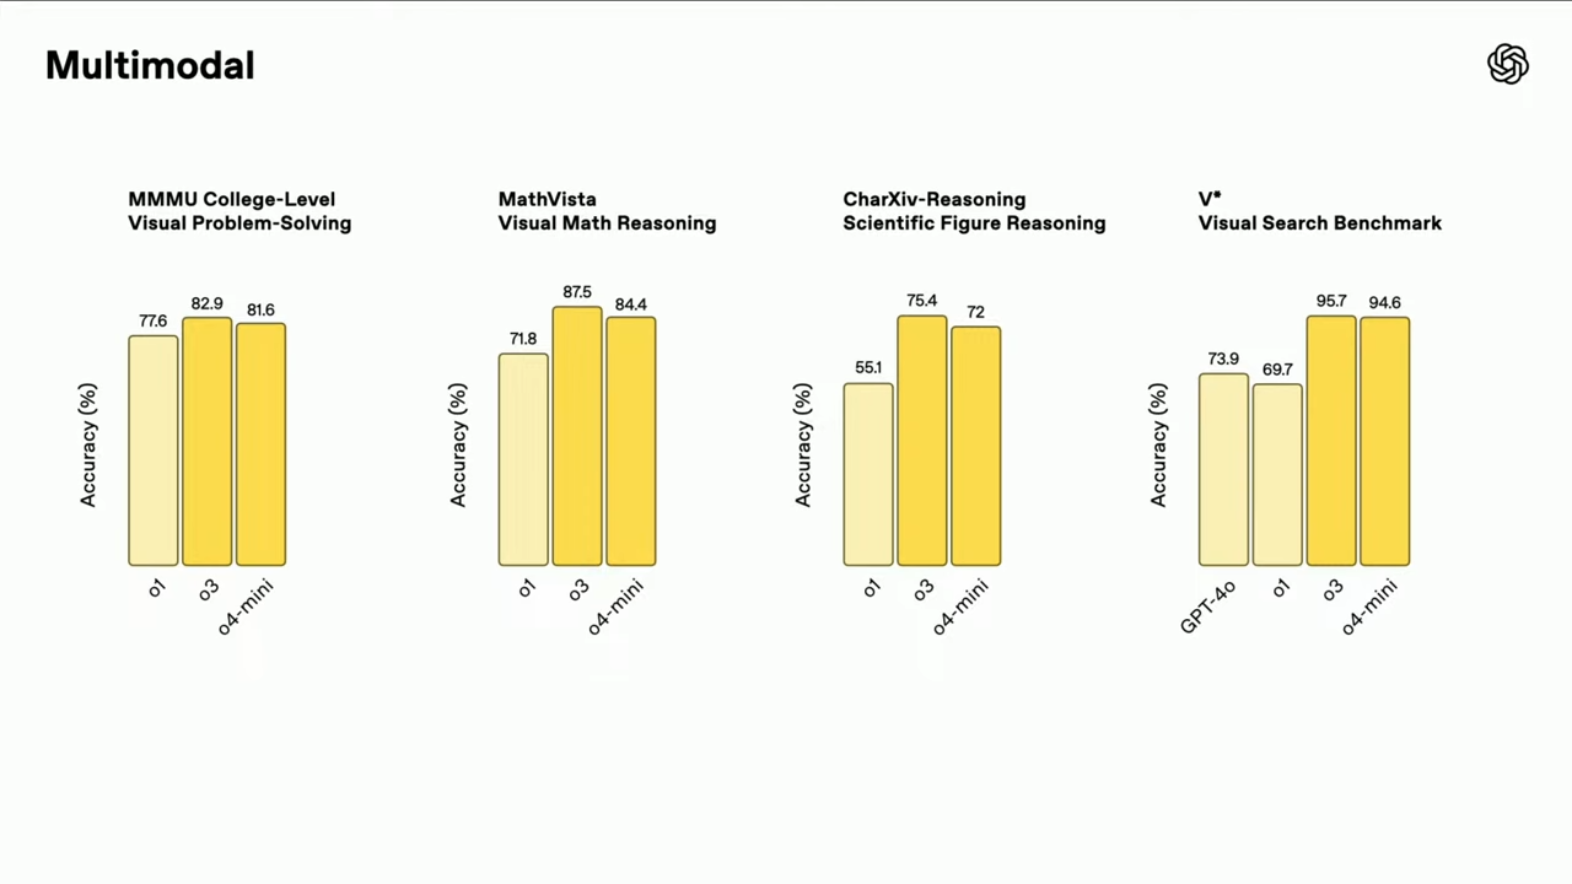
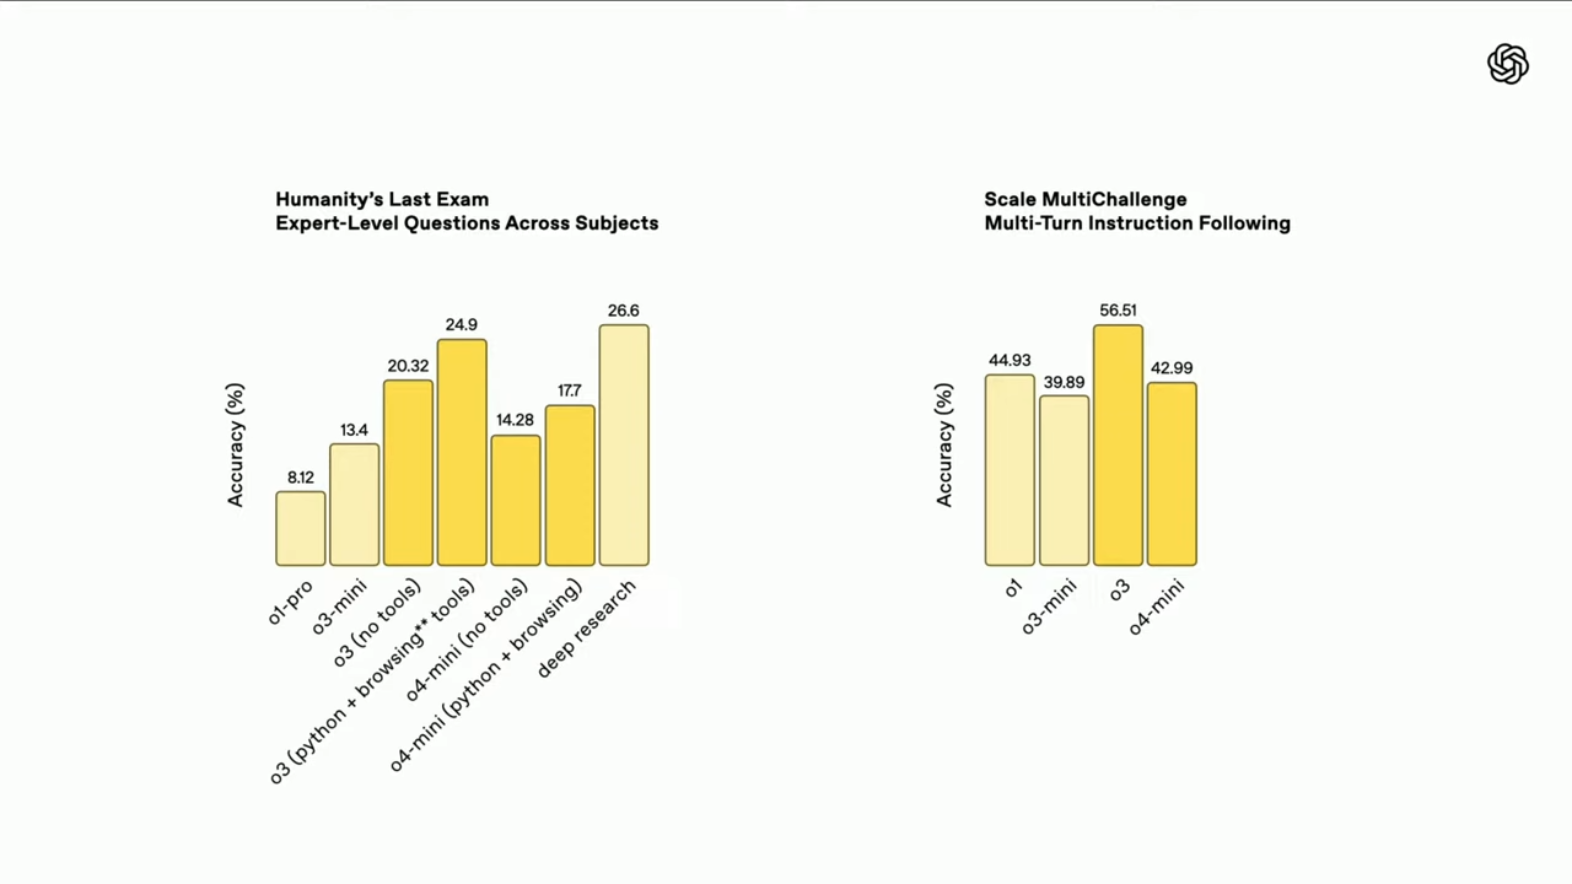
벤치마크 성능표
| 모델 | 주요 성능 | 설명 |
|---|---|---|
| o4-mini | AIME 99% | 미국 고급 수학 경시대회 정답률 99%, 고난이도 수학 문제에서 SOTA |
| o3 | Codeforces 2,700+ | 세계 최고 수준 알고리즘 실력, 상위 200위권 수준 |
| o3 | GPQA 83% | 박사급 과학 문제 해결 정확도, 추론 능력 극대화 |
| o4-mini | SWE-bench SOTA | GitHub 기반 자동 버그 수정에서 최고 성능 |
| o4-mini | 멀티모달 SOTA | 수학+이미지 복합 평가(MMMU, MathVista 등) 전 영역 우수한 성적 |
4. 실제 데모 사례
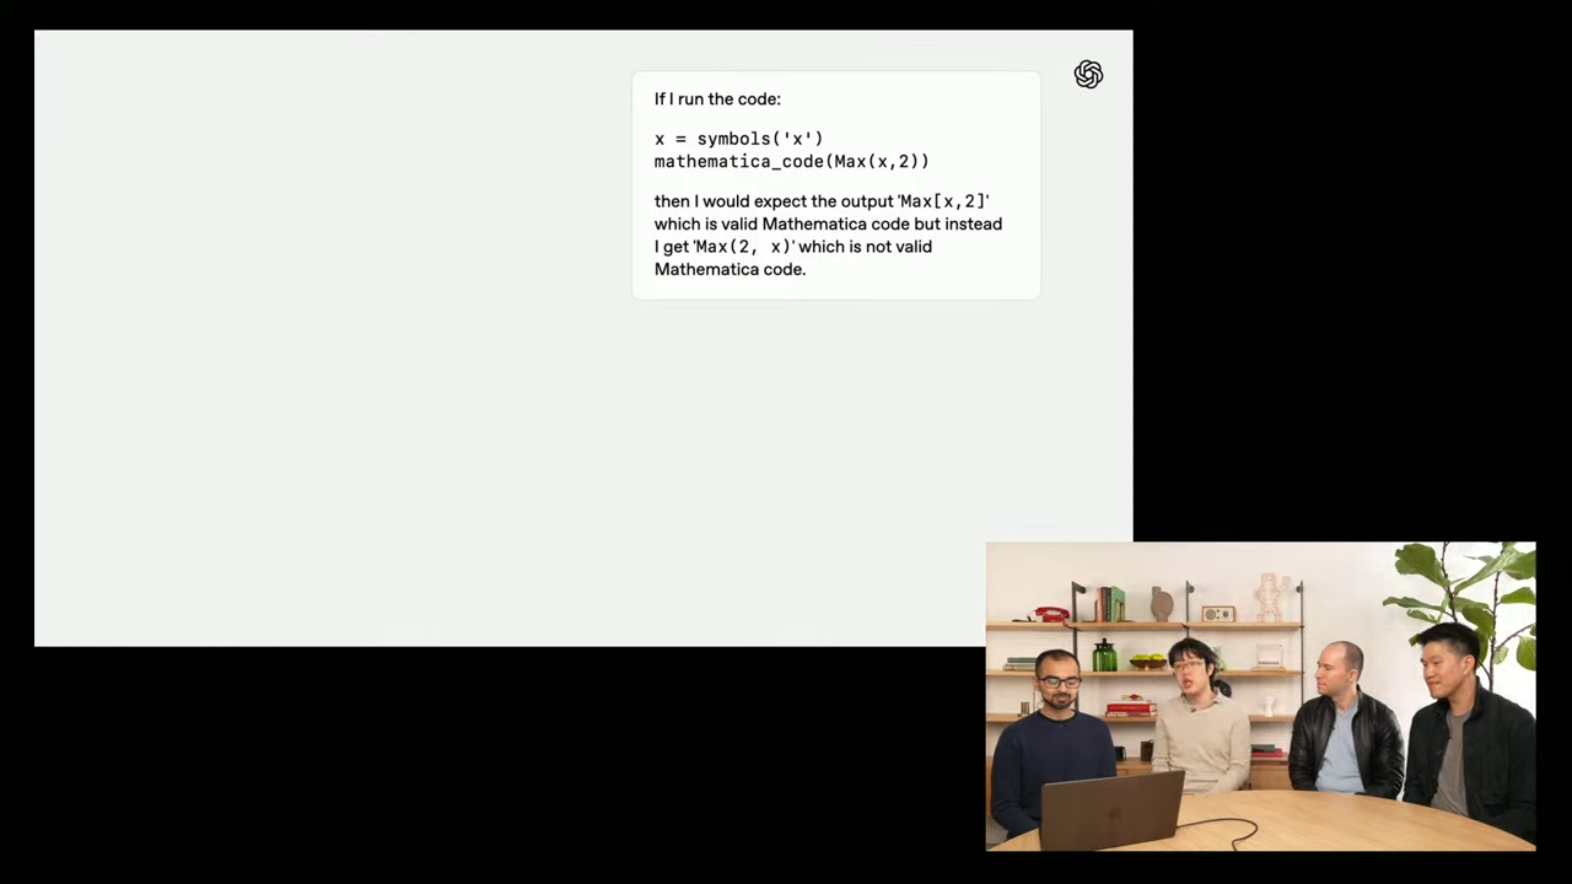
💻 1) 버그 수정 자동화 (SymPy 저장소)
- CLI 환경에서 오픈소스 저장소 불러오기 → 구조 파악 → 오류 진단 및 해결 코드 생성 → 유닛 테스트 실행 → PR 초안 자동 작성.
- 인간이 하듯 오류의 발생 경로(MRO) 추적 후, 적절한 패치 작성 및 검증.
- 예:
Max(2, x)를Max[x, 2]로 자동 교정하는 Mathematica 표현식 디버깅 사례 포함.
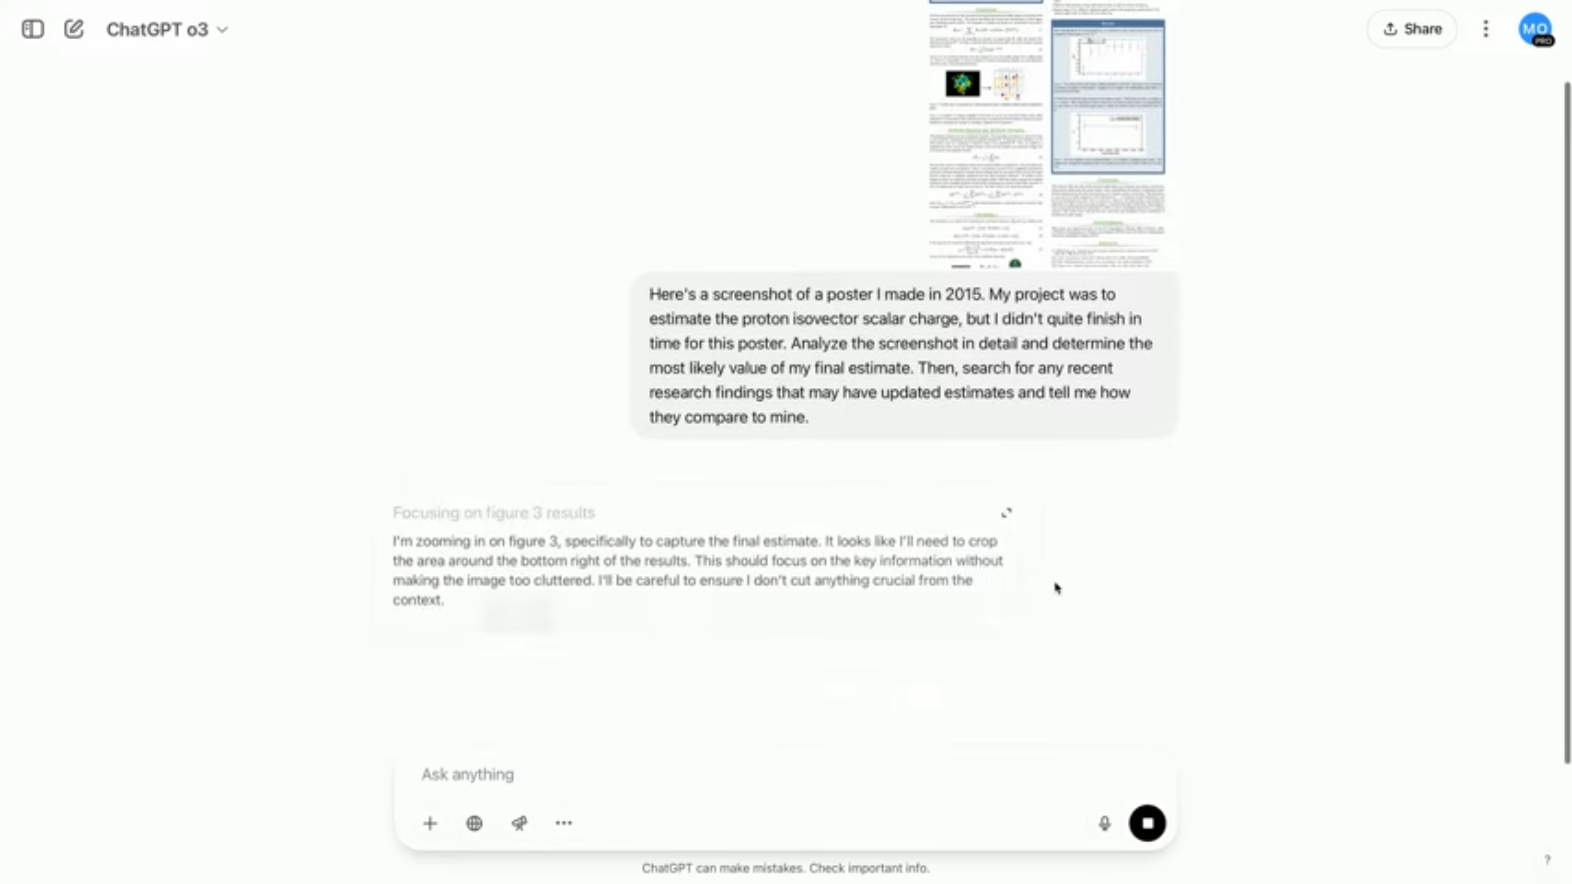
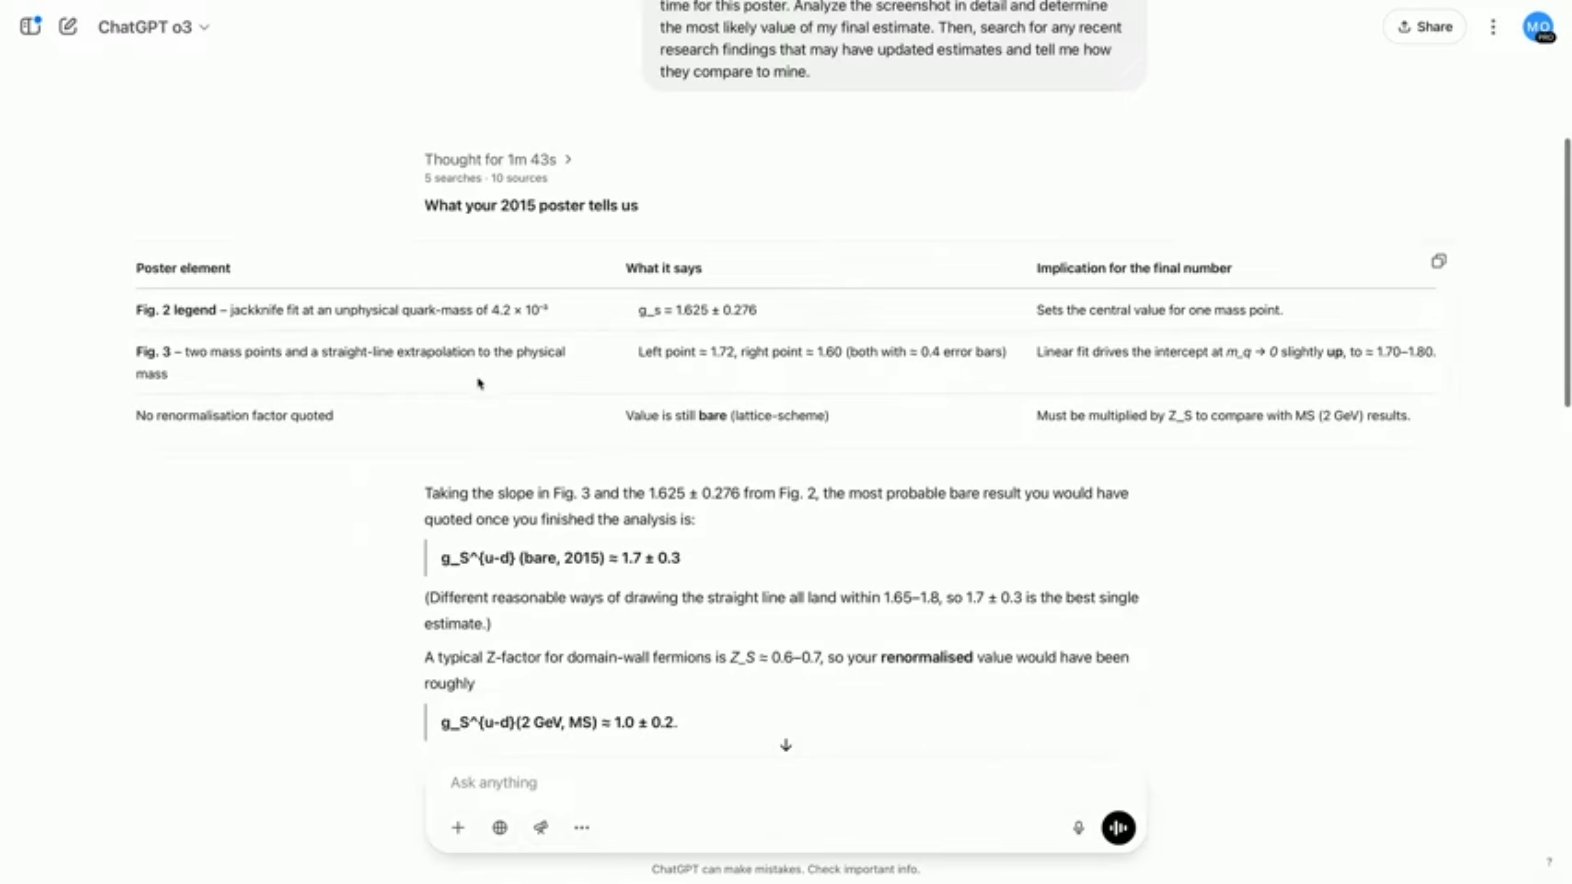
📊 2) 연구 포스터 분석 보조
- 대학원생 논문 포스터 PDF를 업로드 → 차트 이미지 분석 → 값 추정 → 관련 논문 검색 → 자신의 결과와 비교.
- 비전공자도 학술 정보 탐색과 비교 평가까지 가능.
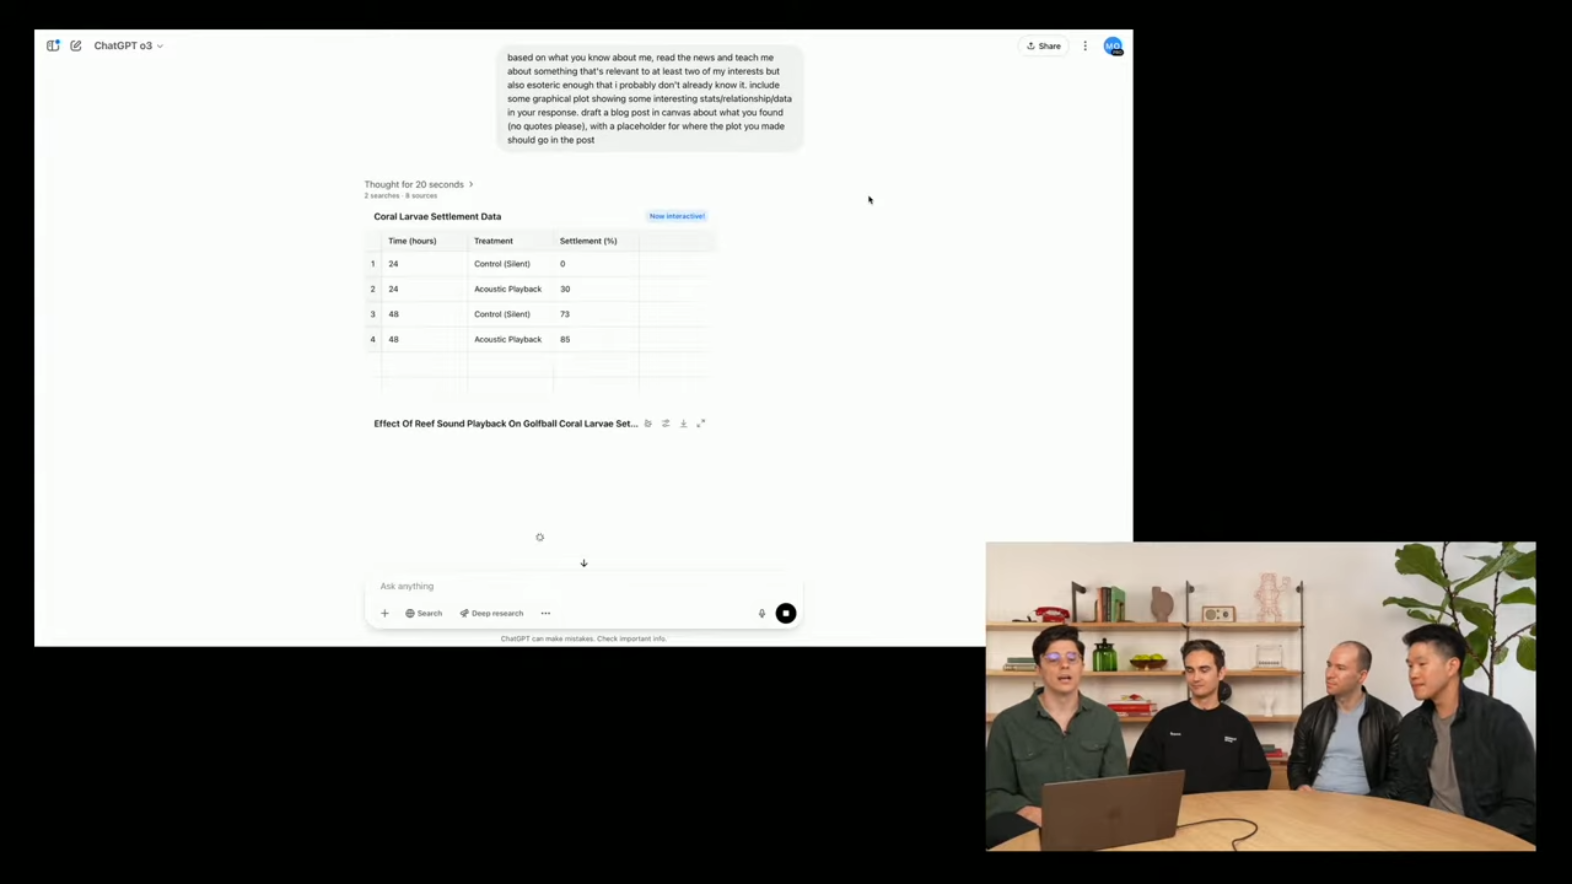
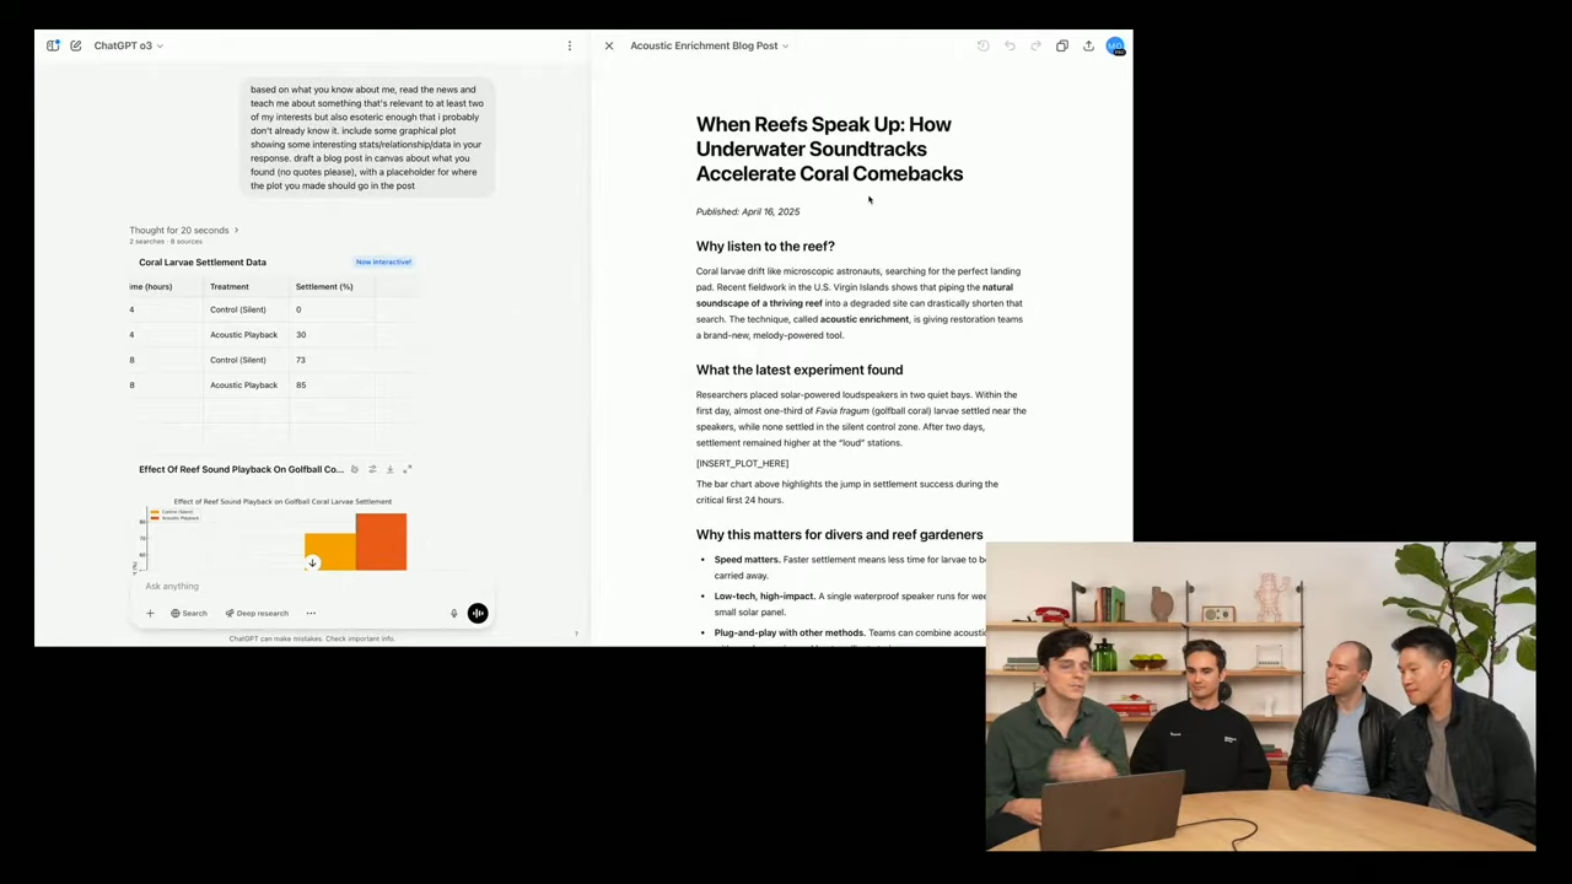
📰 3) 맞춤형 정보 탐색
- 사용자의 취미나 연구 관심사를 기반으로 뉴스 요약 및 최신 연구 소개.
- 예: 내가 관심있을 만한 정보 탐색
→ AI가 관련 블로그 초안과 그래프 생성.
🎨 4) 멀티모달 앱 생성
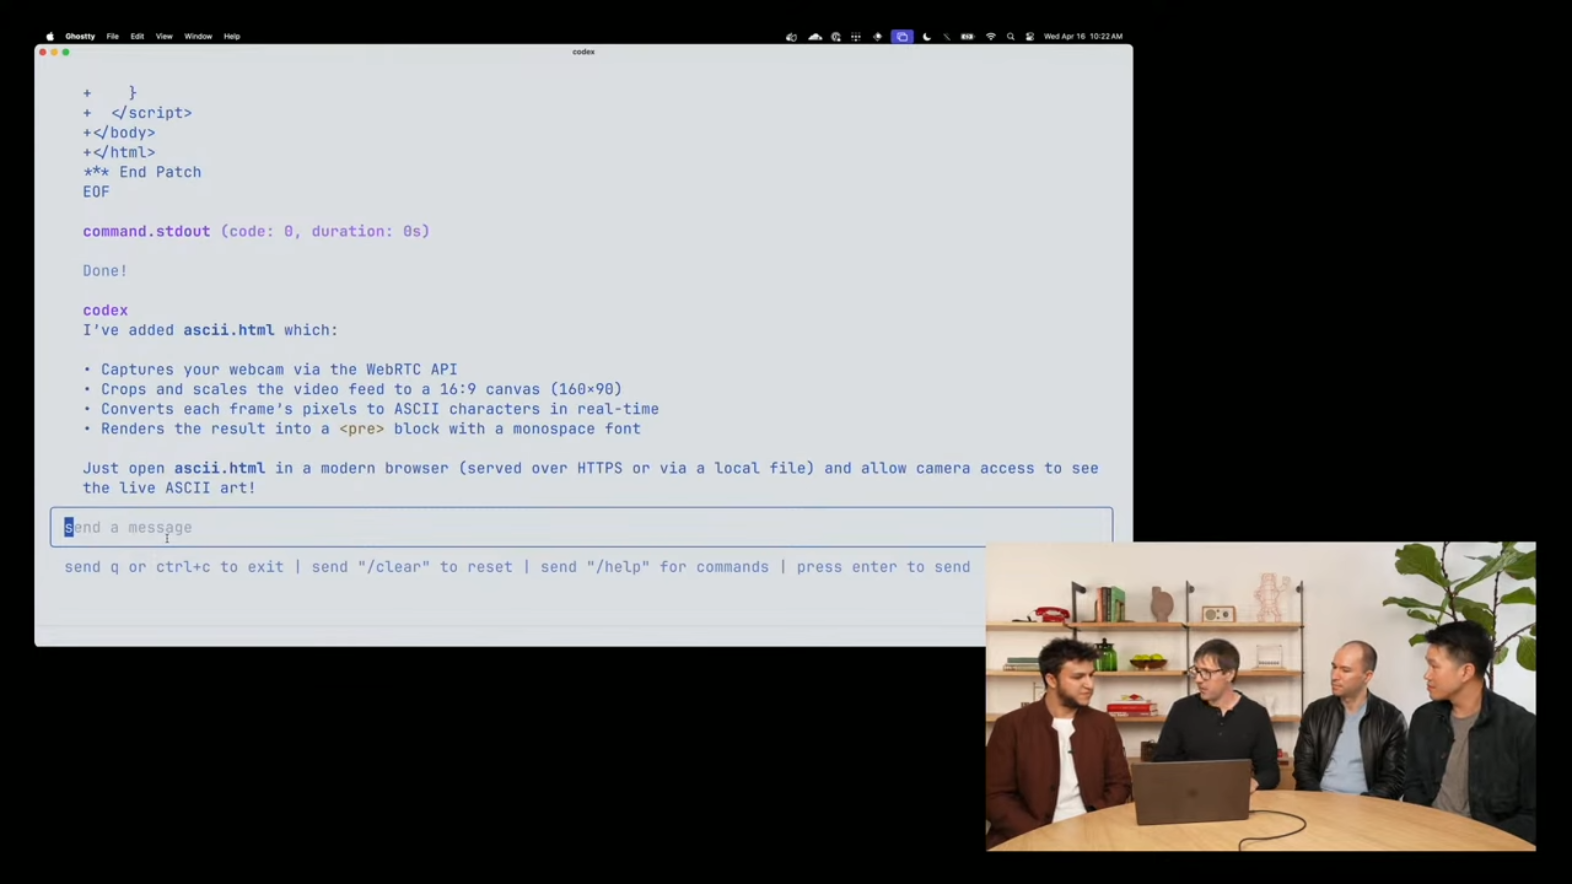
- macOS의 Photo Booth 필터 화면을 캡처하여 CLI에 입력.
- Codex는 이를 분석하여 웹앱 구조 생성 → 웹캠 API 연동 → HTML + JS 기반 페이지 자동 구성.
📌 단순한 UI 캡처만으로 완성도 높은 웹앱을 자동 생성하는 능력은 진정한 Agentic UX 개발의 첫 사례로 주목됩니다.
🧮 5) 수학 문제 브루트 포스 해결
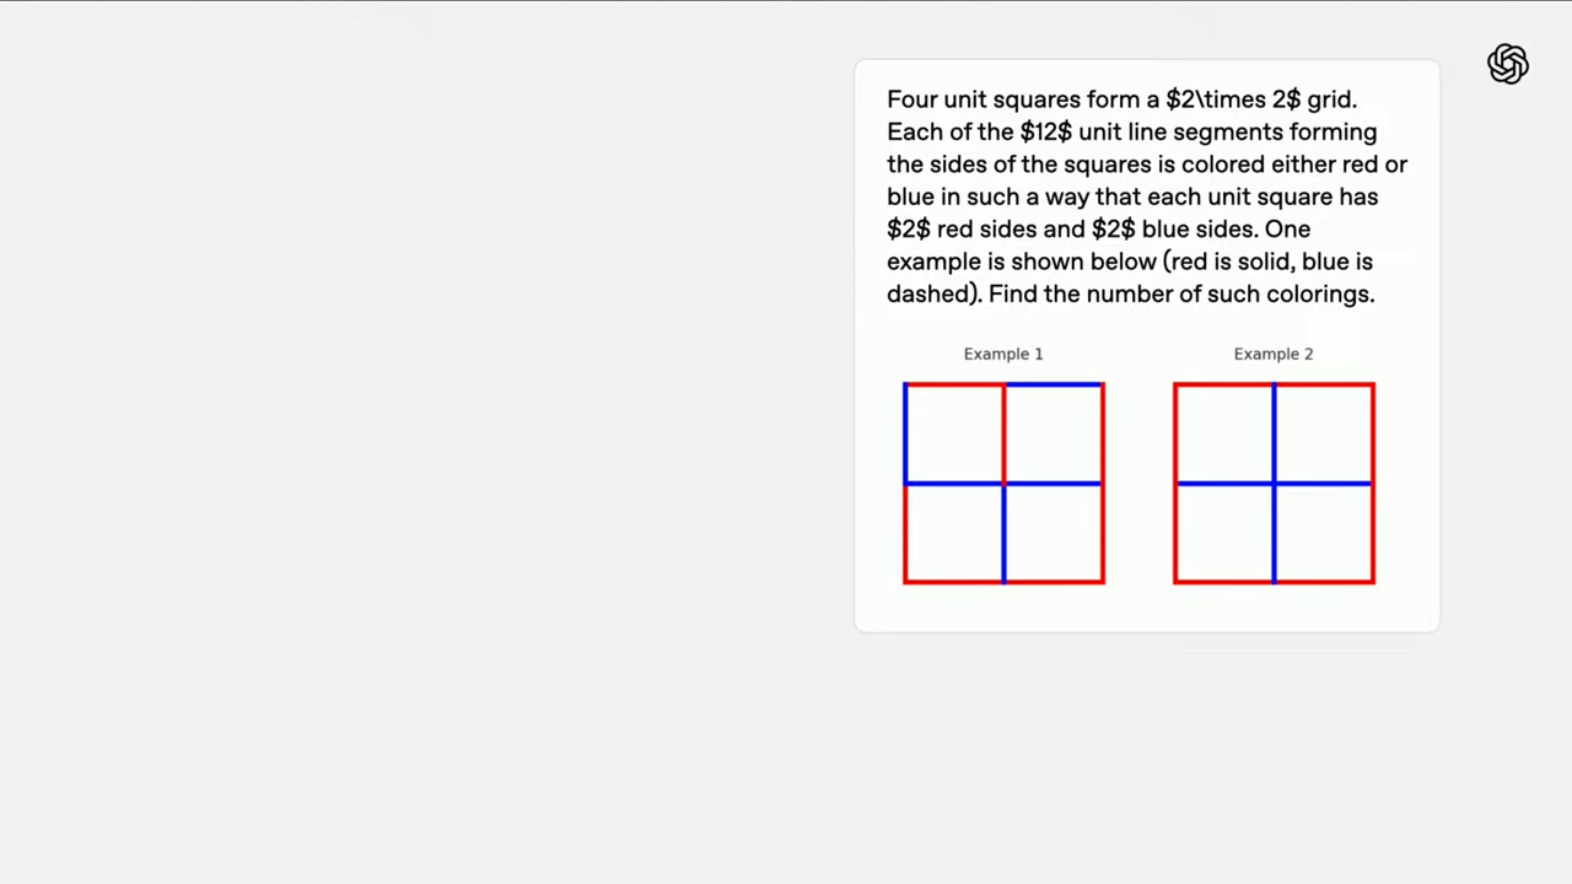
- 2×2 격자에 있는 4개의 정사각형의 테두리를 빨간색과 파란색으로 색칠하는 문제.
- 각 사각형은 정확히 2개의 빨간 변 + 2개의 파란 변을 가져야 하며, 전체 조건을 만족하는 색칠 방법의 수를 계산.
-
o3 모델은 이 문제를 Python 브루트 포스 코드로 해결:
- 12개의 선분 각각에 대해 빨간색/파란색 할당을 0 또는 1로 설정.
- 모든 경우의 수(2¹² = 4096)를 탐색하여 조건에 맞는 경우만 필터링.
- 유효한 조합은 총 82가지로 출력됨.
1
2
3
4
5
6
7
8
9
count = 0
solutions = []
for a in [0, 1]:
 for b in [0, 1]:
  ...
   for l in [0, 1]:
     if 조건을 만족:
         count += 1
         solutions.append((a,b,...,l))
- 단순 계산 이상으로, 모델은 문제 정의 → 변수 설정 → 반복 구조 → 조건 구성 → 결과 해석까지 완전한 사고를 수행했으며, 이후 이 코드를 리팩토링해 더 효율적인 방식도 제안함.
📌 이 데모는 o3의 수학적 추론 + 코드 생성 능력이 결합된 대표 사례로, Agent형 모델이 문제 해결 능력을 실제로 어떻게 보여주는지를 입증합니다.
5. 비용 대비 추론 효율성 비교 (Cost-Efficient Reasoning)
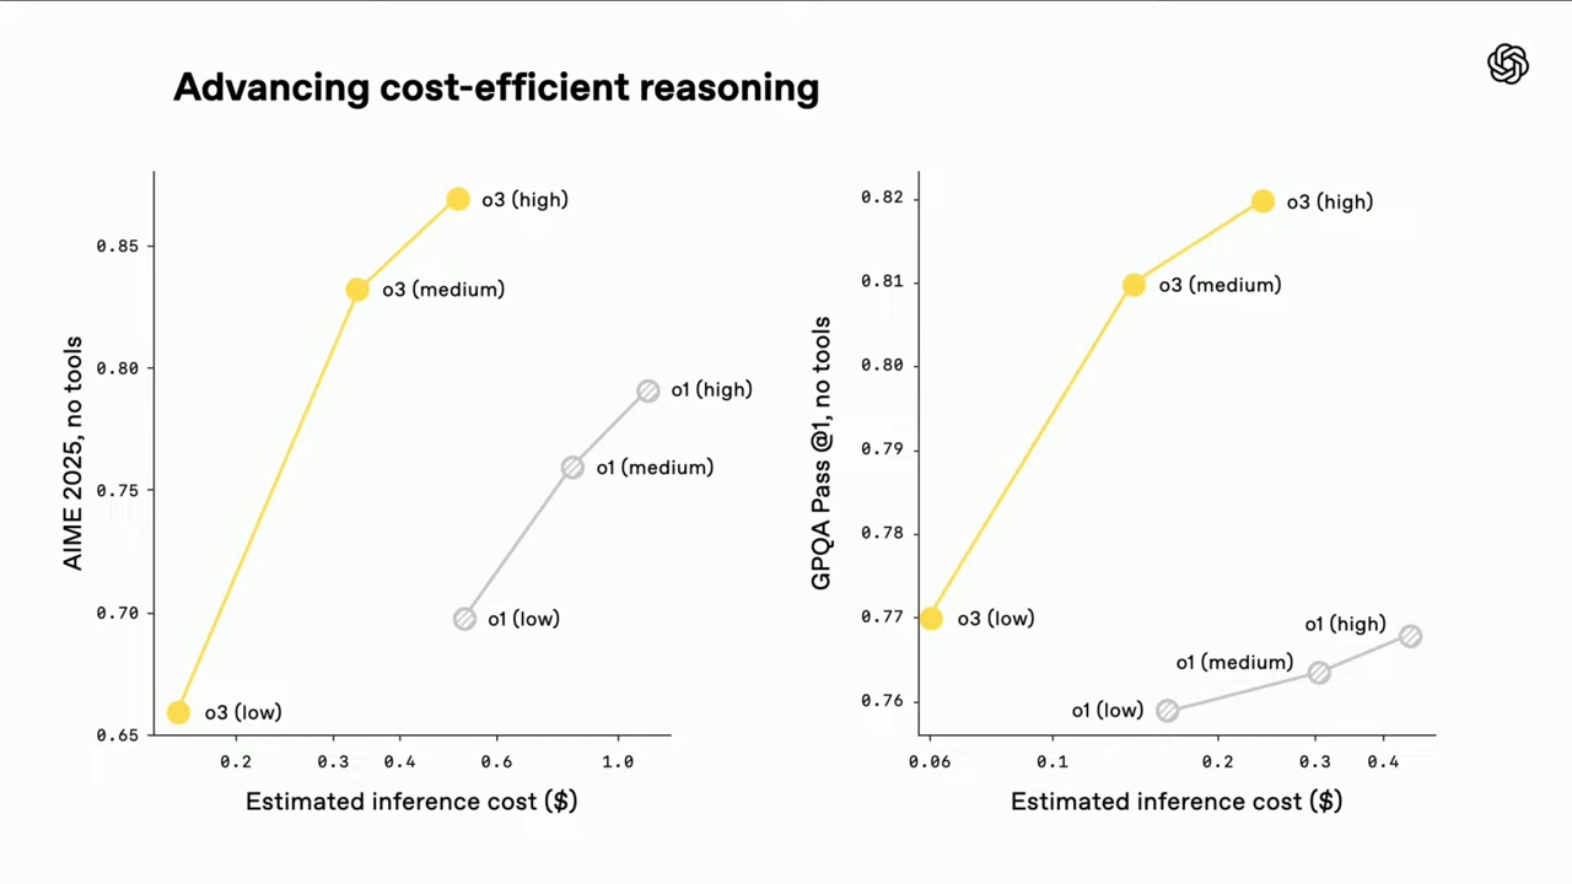
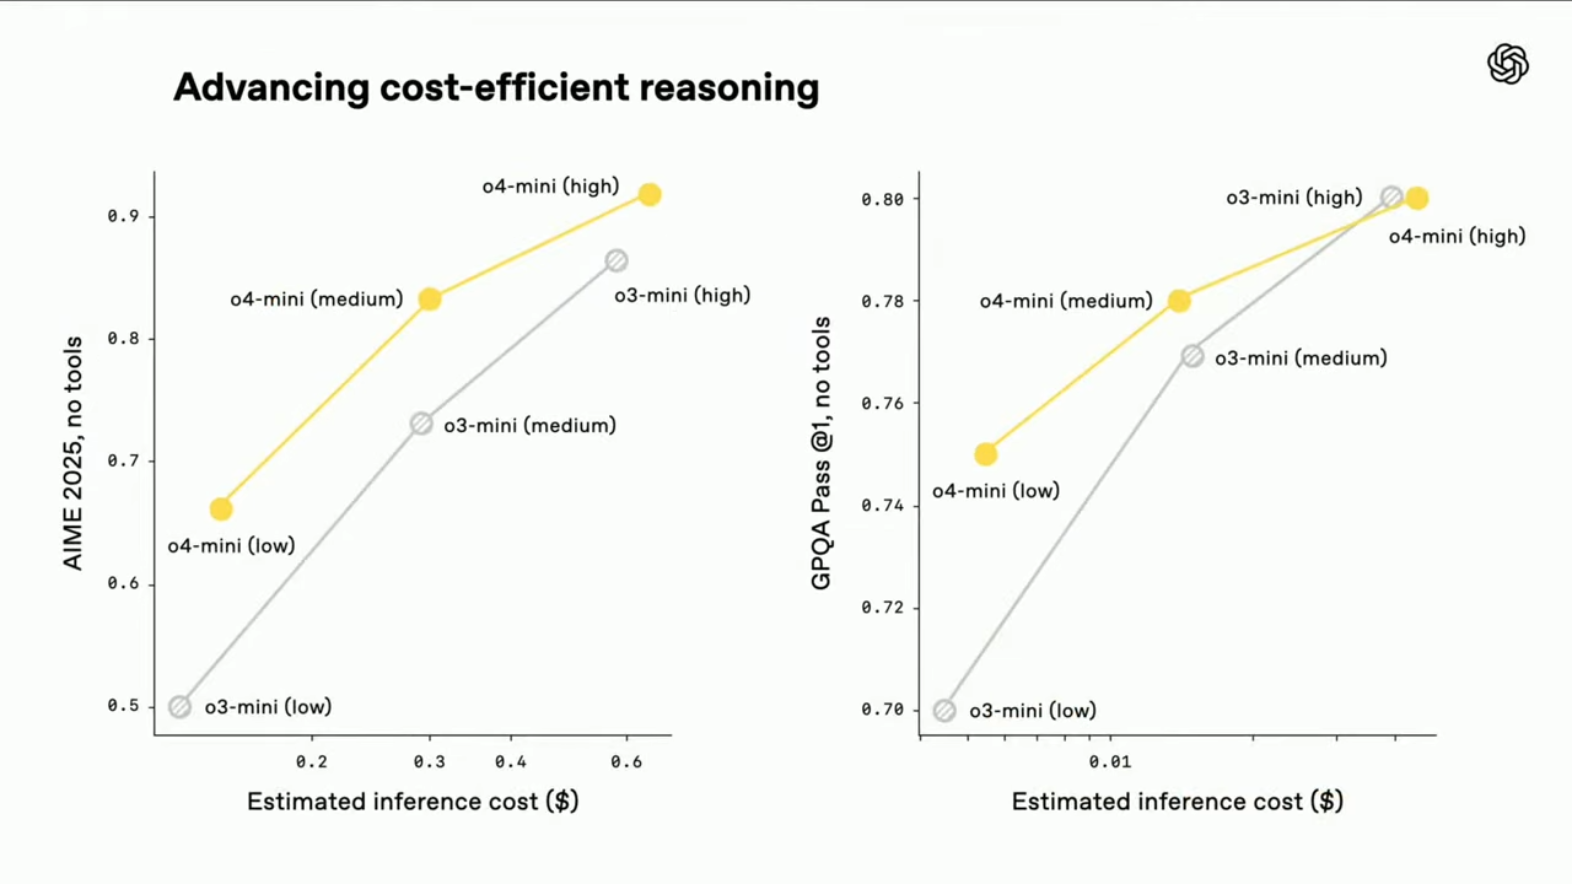
공개된 그래프를 통해, OpenAI는 o4-mini, o3, o1 등 각 모델의 추론 정확도 vs 비용 곡선을 비교하며, o-시리즈 모델이 특히 저비용 고정확도 추론에 유리하다는 점을 강조합니다.
(참고) AIME (American Invitational Mathematics Examination)는 미국 고등학생을 대상으로 한 수학 경시대회 중 하나로, AMC (American Mathematics Competitions) 시리즈의 상위 라운드에 해당합니다.
AIME (미국 수학 경시) 기준
- o4-mini는 low→medium→high로 갈수록 정확도 상승.
- 동일한 조건에서 o3-mini 대비 빠른 성능 향상 곡선.
GPQA (과학문제 정확도) 기준
- o4-mini와 o3-mini 모두 툴 없이도 높은 정확도를 달성.
- o1 대비 동일 성능에서 비용이 절반 이하.
종합 비교
- o4-mini는 전체 모델 중에서 가장 빠른 성능 향상을 보이며, 특히 medium/low 단계에서 비용 대비 성능 우위가 뚜렷하게 나타남.
- o3는 성능 면에서는 최고지만 비용은 상대적으로 높음.
📌 inference 효율성과 정답률 사이에서 o4-mini는 최고의 균형점으로 포지셔닝됩니다.
6. AIME 성능 향상 그래프 (학습 중 변화)
해당 그래프는 OpenAI 모델들이 훈련 중 AIME 수학 문제에 대한 Pass@1 정확도가 어떻게 변화했는지를 나타냅니다.
- X축: 사용된 연산 자원(Compute) (로그 스케일)
- Y축: Pass@1 정확도 (단 한 번 시도로 정답 맞춘 비율)
그래프 해석
- o1 → o3로 갈수록 동일 compute 수준에서도 성능이 비약적으로 향상됨
- o3는 약 90%의 정확도로 AIME 2022/2023 문제를 해결 가능함
- 점진적 훈련을 통해 추론 능력을 점차적으로 고도화하는 학습 방식이 효과적이었음을 보여줌
AIME란?
- American Invitational Mathematics Examination의 약자로, 미국 수학 경시대회의 상위 라운드
- 문제 난이도가 매우 높고, 추론 능력과 논리적 사고력을 중점적으로 평가
- LLM 성능 평가 지표로 사용되기 적합 (단순 상식이 아닌 사고 기반 문제 해결 요구)
🎯 해당 결과는 o-시리즈 모델이 단순한 텍스트 예측이 아닌, 지속적인 훈련을 통해 추론 중심의 문제 해결 능력을 획득해 나가는 과정을 데이터로 입증한 것입니다.
7. Codex CLI: 진짜 코딩 동료의 등장
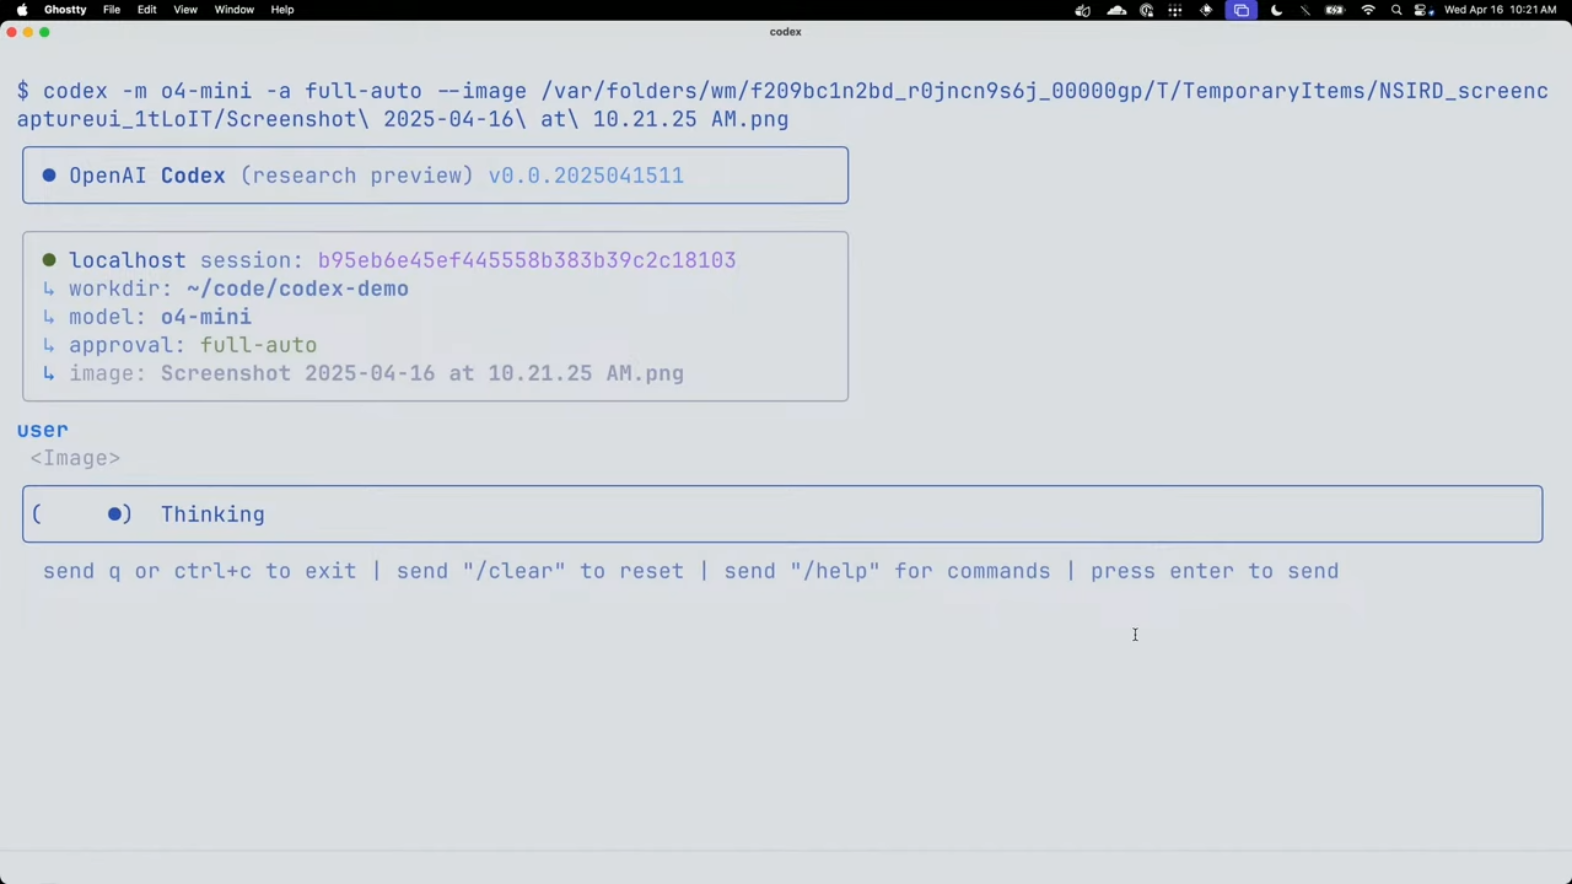
OpenAI는 Codex CLI를 통해 로컬에서 실행 가능한 가벼운 코딩 에이전트를 공개했습니다.
- GitHub MIT 오픈소스 라이선스: 누구나 자유롭게 사용 및 확장 가능
→ 코드 보기 - 다양한 모델 지원: GPT-4.1, o3, o4-mini 호환
- 로컬에서 코드 편집·실행·파일 변경·테스트까지 가능
- 풀 오토 모드 지원: 사용자가 아무 입력 없이도 프로젝트 탐색, 수정, 실행까지 자동화 가능
- 보안 설정: 네트워크 비활성화 + 샌드박스 디렉터리로 안전 확보
| 기능 | 설명 |
|---|---|
| 실행 환경 | 로컬 터미널, API 키만으로 실행 가능 |
| 지원 모델 | GPT-4.1, o3, o4-mini 모두 지원 |
| 멀티모달 입력 | 스크린샷 + 명령어 → 코드 생성 및 기능 구현 |
| 보안 | 자동 네트워크 차단 + 작업 폴더 보호 |
🧠 Codex CLI는 단순한 CLI 툴이 아니라, 터미널에서 작동하는 개발자용 Copilot + 멀티모달 Reasoning Agent입니다.
8. 모델 가격 및 비교 (2025.04 기준)
| 모델 | 입력 1M | 출력 1M | Context | Max Tokens | Knowledge Cutoff |
|---|---|---|---|---|---|
| o4-mini | $1.10 | $4.40 | 200K | 100K | 2024.06 |
| o3 | $10.00 | $40.00 | 200K | 100K | 2024.06 |
| o3-mini | $1.10 | $4.40 | 200K | 100K | 2023.10 |
| gpt-4.1 | $2.00 | $8.00 | 1M+ | 32K | 2024.06 |
- o4-mini는 성능·속도·비용의 최적 균형점을 제공하며, 고도화된 멀티모달 추론까지 가능
9. 향후 전망 및 구조적 변화
🧩 Agentic RAG & 자동화 워크플로우
- o4-mini와 Codex CLI의 조합은 검색 → 분석 → 요약 → 코드 작성 → 시각화 → PR 생성까지 이어지는 워크플로우를 자동화
- 특히 RAG 파이프라인에서 단순 텍스트 답변 생성이 아니라, 도구를 통한 실행 기반 응답이 가능
📚 교육 및 연구 보조 민주화
- 논문 요약, 실험 설계, 코드 생성까지 자동화 → 학습자가 탐색과 창의성에 집중할 수 있도록 지원
🧑💻 개발자 생산성 혁신
- 반복적이고 비효율적인 작업은 CLI가 대체 → 개발자는 로직 및 아이디어에 집중
- 개인 개발자가 팀 단위의 협업 수준까지 생산성을 향상 가능
🎯 Codex CLI는 단순한 LLM 기반 터미널 도구를 넘어, 코드 생성·수정·구현 전체를 자동화하는 AI 기반 운영체제의 전조로 이해될 수 있습니다.
✍️ 마무리 및 시사점
o3 및 o4-mini는 단순한 LLM이 아니라 능동형 AI 시스템의 방향을 제시합니다. 도구와 추론의 연결을 바탕으로, AI는 단순 대화 파트너를 넘어 진짜 작업 동료가 되어가고 있습니다.
- Codex CLI와 함께하는 새로운 멀티모달 추론 및 앱 생성 환경은 특히 로컬 환경 중심의 개발자들에게 생산성 혁신을 제공하며, 향후 개인화된 AI 협업 도구의 본보기가 될 것입니다.
앞으로의 API 개방과 오픈소스 생태계 확장은 AI와 인간의 협업 시대를 본격적으로 열 것이며, 이 흐름의 중심에는 o 시리즈가 있을 것이라고 생각됩니다.
읽어주셔서 감사합니다!