안녕하세요 :) 오늘 블로그 포스팅으로 다뤄볼 내용은 얼마 전에 흥미롭게 읽어보았던 “Transferring Inductive Bias Through Knowledge Distillation”이라는 논문인데요! 해당 논문은 Knowledge Distillation을 이용하여 과연 Inductive Bias를 전달할 수 있을 까를 다룬 논문입니다. 아쉽게도 이번 ICLR2021에서 Accept되진 못했지만 다양한 실험과 Knowledge Distillation을 이용하여 Inductive Bias를 Student모델에게 전달하려고 시도한 첫 논문이기 때문에 그만큼 흥미롭게 읽은 논문인 것 같습니다.
본격적인 논문 리뷰를 하기 전에 이번 장에서는 중요한 개념인 Knowledge Distillation과 Inductive Bias에 대하여 이야기하고 다음 장에서는 논문에서 진행한 다양한 실험들에 대해 다루어 보고자합니다.
What is Knowledge Distillation
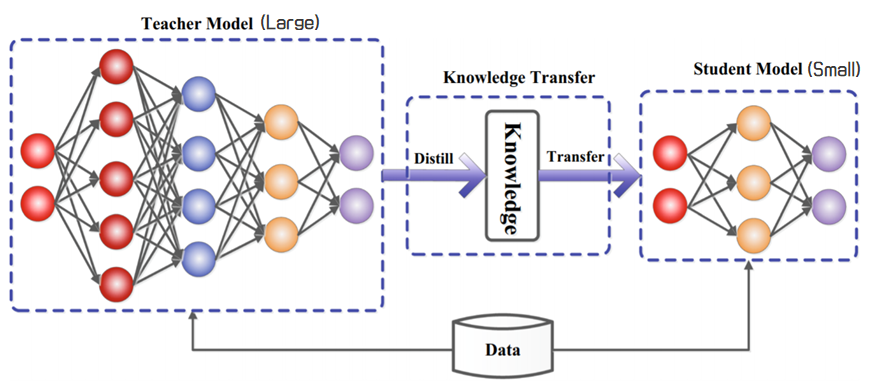
Image from “Knowledge Distillation: A Survey (2020)”
Knowledge Distillation(KD)는 Teacher 모델에서 Student 모델로 지식을 이전하는 과정을 말하며, 여기서 Teacher 모델의 결과(Logit 값)이 Student 모델을 훈련시키는 데 사용됩니다. Knowledge Distillation(KD)는 모델 경량화(압축)에 효과적인 방법으로 가장 잘 알려져 있습니다.
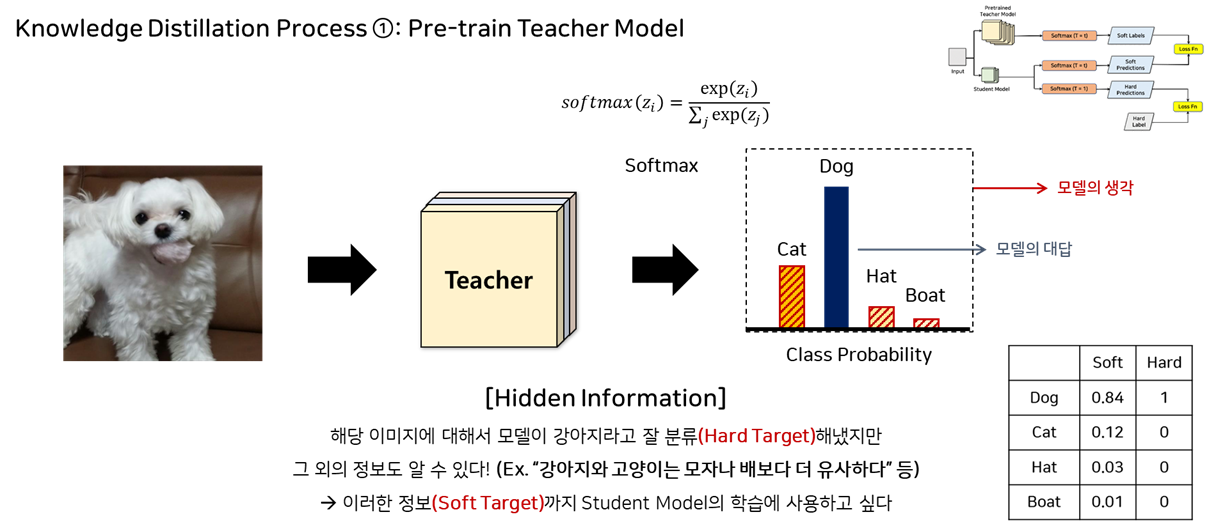
Knowledge Distillation은 크게 다음과 같이 2가지 단계로 구성이 되는데요.
(1) Pre-train Teacher Model : 선생(Teacher)가 되는 모델을 학습합니다.
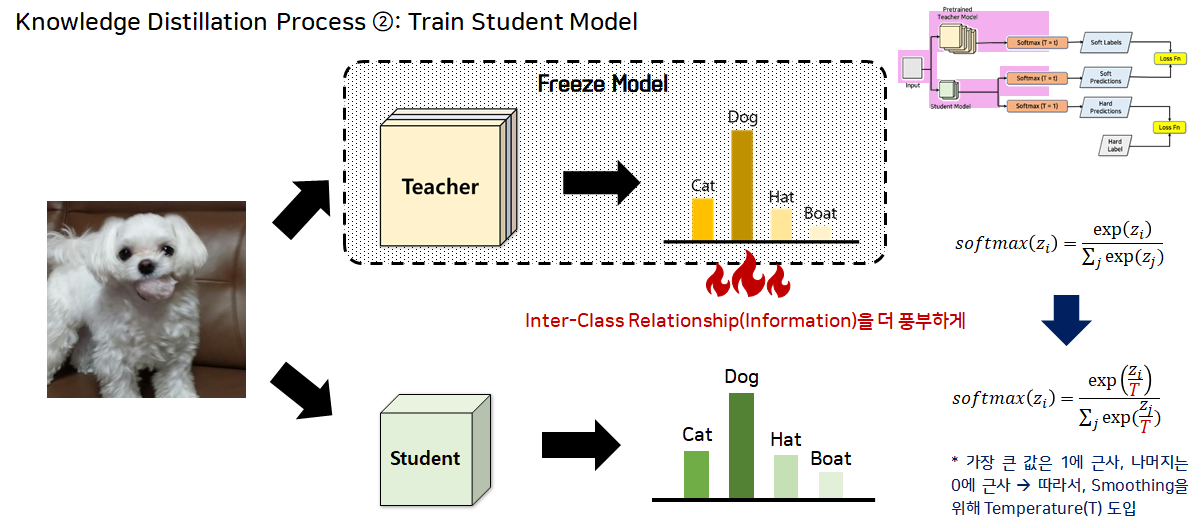
(2) Train Student Model : 학생(Student)이 되는 모델을 학습합니다. 이때 Student 모델은 선생 모델로 부터 반환하게 되는 소프트맥스 값(로짓)과 유사한 값을 갖도록 학습을 수행하게 됩니다. 이를 소프트 라벨이라고 하며, 단순한 로짓을 사용할 수도 있지만 좀 더 분포를 완만하게 해주기 위해 온도(Temperature, T)라는 개념을 도입하게 됩니다.
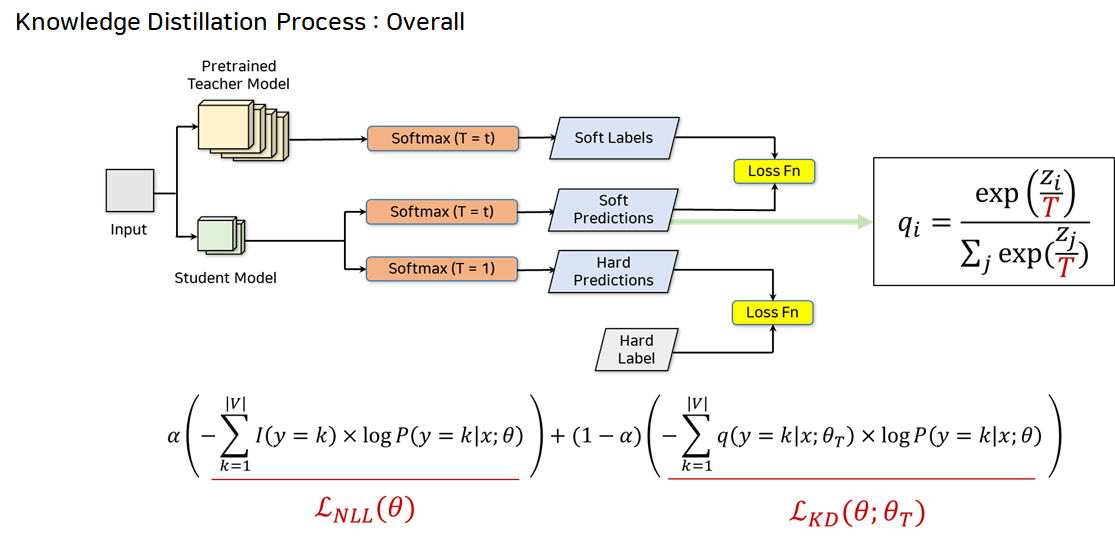
전반적인 프로세스는 아래 그림처럼 표현할 수 있습니다. 아래 식은 Knowledge Distillation(KD)의 Loss Function입니다. 식의 앞 부분은 실제 학생 모델이 우리가 원하는 라벨 값을 잘 예측하는 가에 대한 Loss이며, 뒷 부분은 학생 모델이 선생 모델과 얼마나 유사하게 학습되는 가에 대한 Loss입니다.
Knowledge Distillation(KD)은 다음과 같이 분류가 될 수 있는 데요. 각각의 분류들은 서로 독립적인 것이 아니라 각 주제에 대한 분류로 이해하시면 될 것 같습니다.
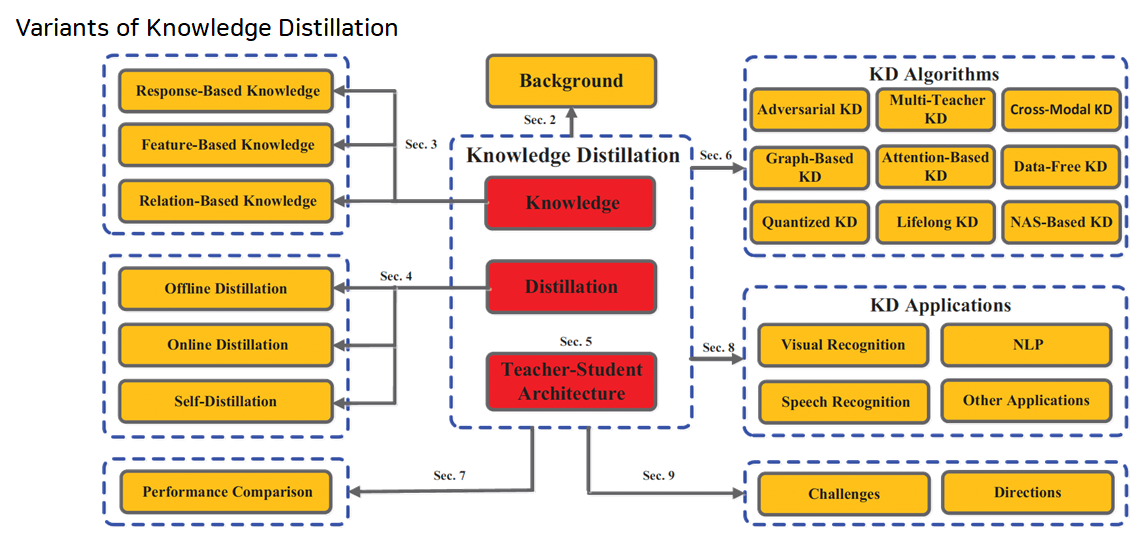
Image from “Knowledge Distillation: A Survey (2020)”
위 그림에서 Knowledge와 Distillation을 기준으로 분류된 항목들이 Knowledge Distillation(KD)의 가장 기본이 되는 개념이기 때문에 해당 부분에 대해서 설명드리도록 하겠습니다. :)
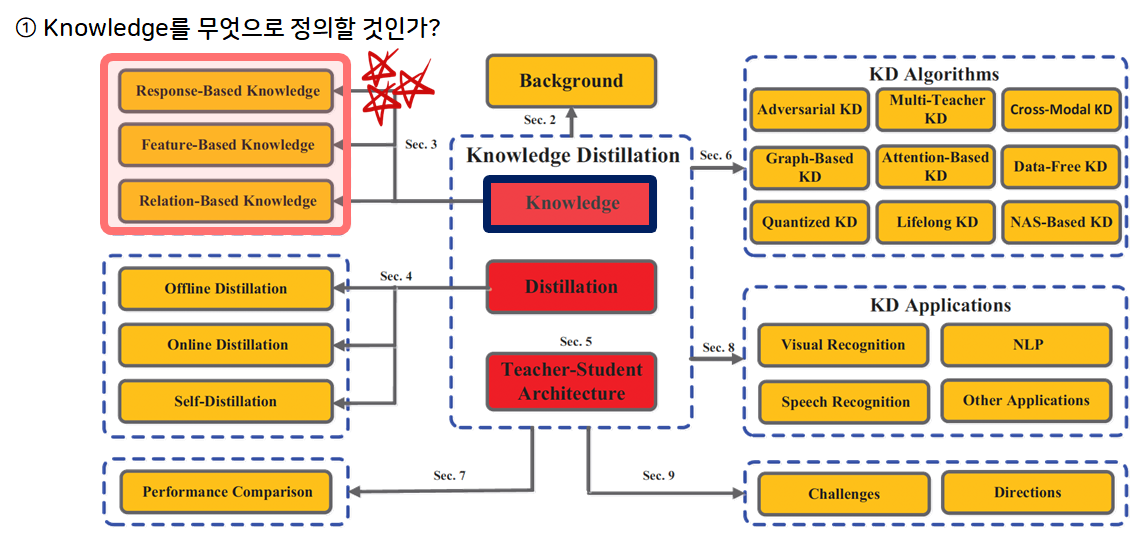
가장 먼저 전달하는 Knowledge를 기준으로 분류를 하면 아래와 같이 총 3가지로 분류가 됩니다.
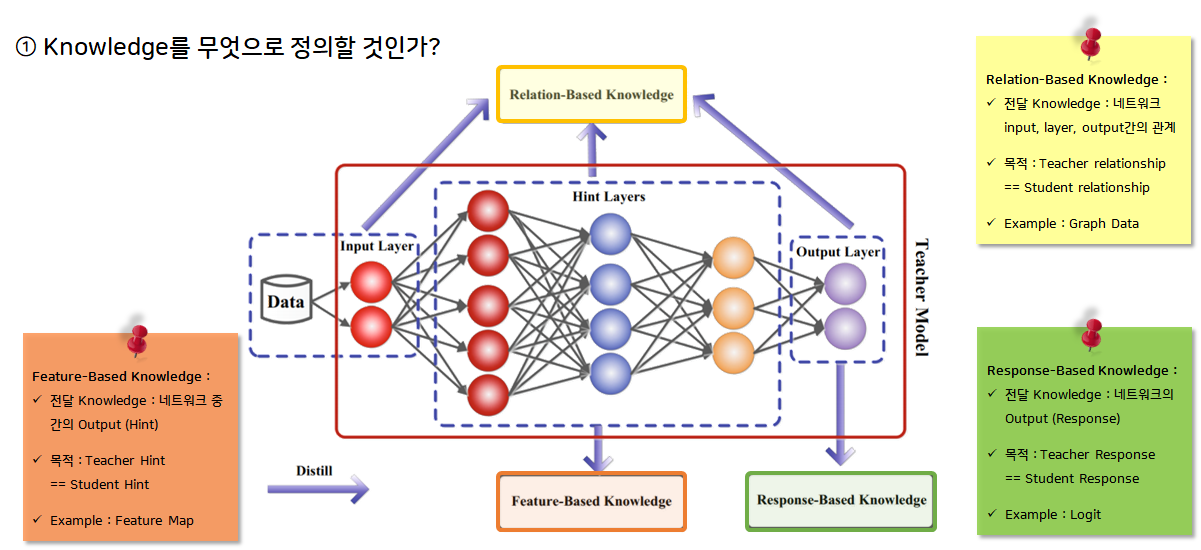
(1) Relation-Based Knowledge는 선생 모델의 input, layer, output간의 관계를 학생 모델이 학습하게 하는 것을 목적으로 합니다. 예를 들어 Graph 모델의 경우 이러한 관계를 학습하게 하는 것이 중요합니다.
(2) Response-Based Knowledge는 선생 모델의 output(response) 정보를 학생 모델이 학습하게 하는 것을 목적으로 합니다. 예를 들어 분류 모델의 Logit을 학습하게 하는 것이 중요합니다.
(3) Feature-Based Knowledge는 네트워크 중간의 layer(hint) 정보를 학생 모델이 학습하게 하는 것을 목적으로 합니다. 예를 들어 이미지의 특성을 학습하는 것이 중요한 모델의 경우 모델 중간의 Feature Map을 학습하는 것이 중요합니다.
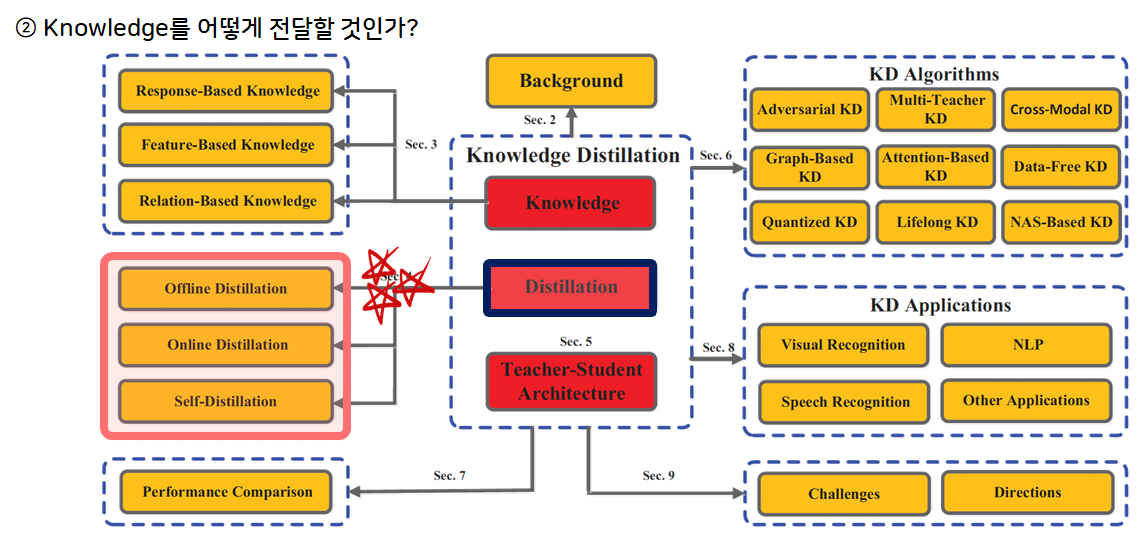
다음으로 어떻게 Knowledge를 전달하는가인 Distillation을 기준으로 분류를 하면 아래와 같이 총 3가지로 분류가 됩니다.
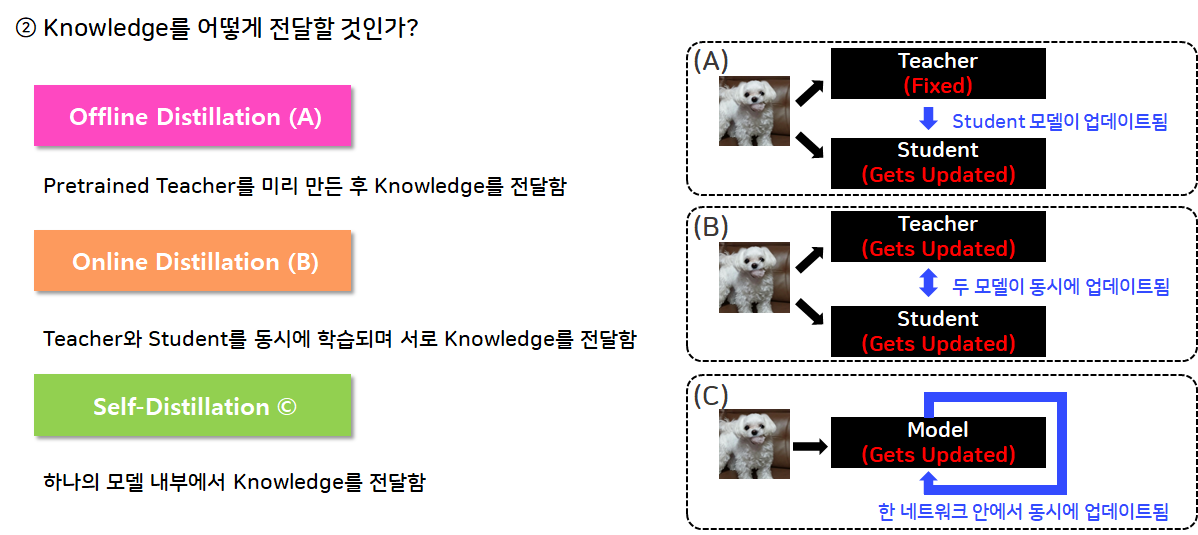
(1) Offline Distillation : Pretrained Teacher를 미리 만든 후 Knowledge를 전달함
(2) Online Distillation : Teacher와 Student를 동시에 학습되며 서로 Knowledge를 전달함
(3) Self-Distillation : 하나의 모델 내부에서 Knowledge를 전달함
What is Inductive Bias
Inductive Bias란, 데이터와 무관하게 일반화 동작에 영향을 미치는 학습 알고리즘의 특성으로, 학습 알고리즘이 특정 솔루션까지 수렴할 수 있도록 도와줍니다. 적당한 Inductive Bias는, 우리가 제한된 데이터나 컴퓨팅 파워를 가지고 모델을 학습하거나, 학습에 사용된 Train 데이터가 Test 데이터를 완벽하게 대표(perfectly representative)하지 못할 때 중요하게 작용하게 됩니다. 만약, Inductive Bias가 존재하지 않는다면, 모델은 local minima에 빠질 가능성이 존재하며, 모델의 initial state와 학습 데이터의 순서에 따라서도 수렴 값이 바뀔 수 있습니다.
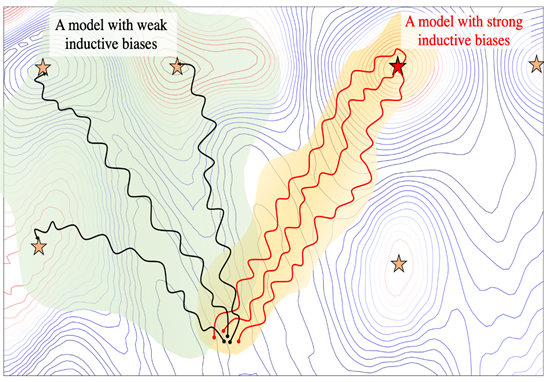
Image from “Transferring Inductive Biases through Knowledge Distillation (2020)
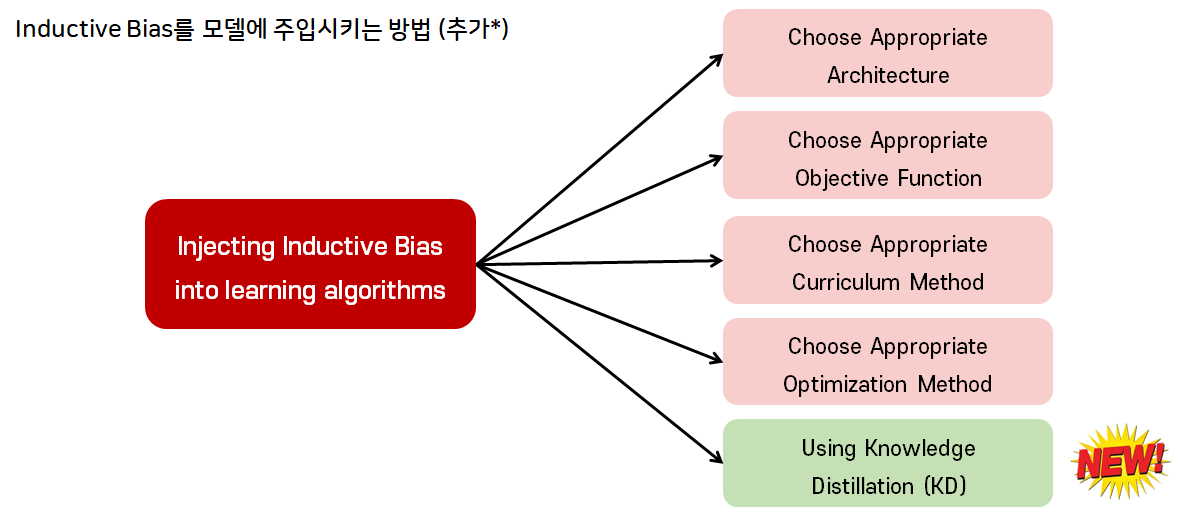
일반적으로 Inductive Bias를 모델에 주입시키는 방법은 4가지로 각각 다음과 같이 정의됩니다.
(1) Choose Appropriate Architecture : 적절한 모델 구조의 정의를 통해
(2) Choose Appropriate Objective Function : 적절한 목적 함수를 통해
(3) Choose Appropriate Curriculum Method : 적절한 커리큘럼을 통해
(4) Choose Appropriate Optimization Method : 적절한 최적화를 통해
본 논문에서는 여기서 한가지를 추가하여 Knowledge Distillation(KD)를 통해서도 Inductive Bias를 모델에 주입시킬 수 있다고 이야기하고 있습니다.
Inductive Bias에 대해 더 궁금하신 분들은 제 이전 포스트를 참고하시면 될 것 같습니다.
논문 개요
아이디어
본 논문은 Knowledge Distillation(KD)가 일반적인 장점인 모델 경량화 이외에도 다른 모델들을 혼용해서 쓸 수 있다는 점을 이야기하며, 이를 활용하여 선생 모델의 Inductive Bias를 학생에게 전수할 수 있지 않을까 이야기합니다. 아래 그림은 논문에서 말하는 본 연구의 목적입니다. Knowledge Distillation(KD)가 처음 소개된 논문에서 이제 선생 모델이 학생에게 전달하는 지식을 dark knowledge라고 칭하는데, 이러한 dark knowledge에 Inductive Bias가 포함되어 있지 않을까라는 의문점을 제기합니다.
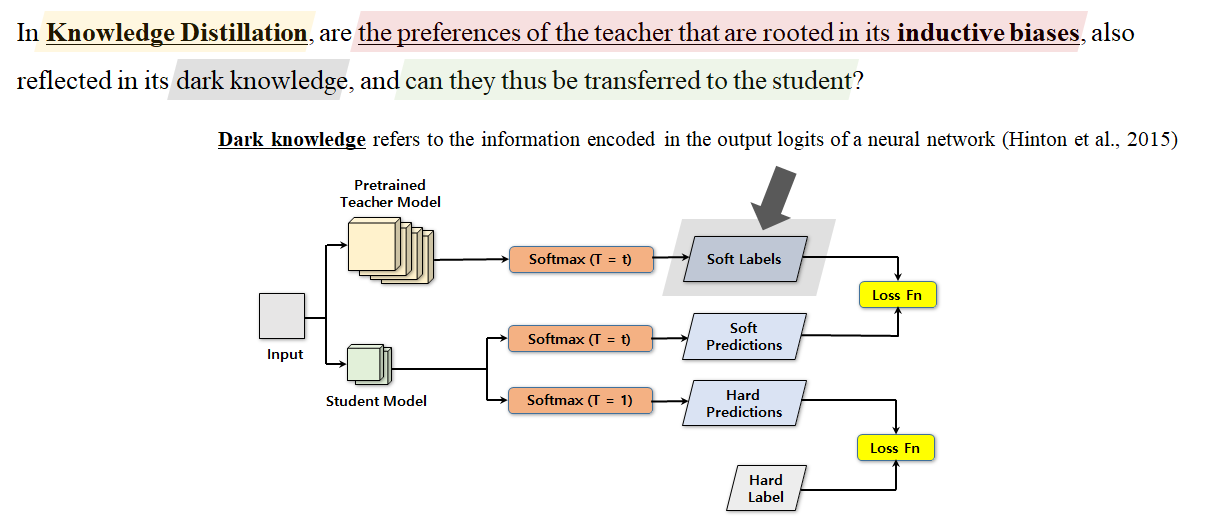
이를 증명하기 위해 저자들은 아래와 같은 두가지 시나리오를 가지고 실험을 전개합니다. 먼저 첫 번째 시나리오는 RNNs(선생 모델)과 Transformers(학생 모델), 그리고 두 번째 시나리오는 CNNs(선생 모델)과 MLPs(학생 모델)으로 실험을 진행합니다. 본 실험은 (1) 정말 선생 모델들이 가지고 있는 Inductive Bias가 얼마나 유의미한가를 보여주가, (2) 선생 모델에게 지식은 전수 받은 학생 모델이 정말 선생 모델과 유사한 학습의 결과물을 보여주는 가를 목적으로 앞에 소개한 두 시나리오를 배경으로 실험을 전개하였습니다.
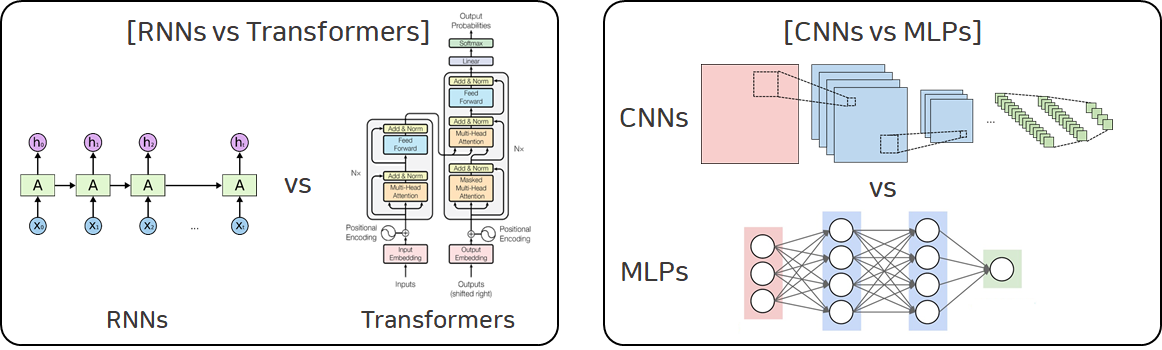
각각의 시나리오들에 대해 자세히 설명하는 글로 조만간 찾아오도록 하겠습니다.
긴 글 읽어주셔서 감사합니다! :)